多數人以為,只要文法跑得動、畫面顯示正常,AI 寫的 WordPress 程式碼跟工程師手刻的沒什麼兩樣,頂多貼到正式站測一下就好。但兩份分別來自業界與學術界的研究,得出的結論恰好相反。用 AI 輔助寫程式的開發者,寫出來的程式碼明顯更容易藏著安全漏洞,而這群人卻反而更相信自己交出去的東西是安全的。信任超前於實際表現,這個落差正是接下來要處理的核心問題。
如果你曾經在後台外掛編輯器裡貼上一段 AI 生成的程式碼,改個欄位名稱就按下更新,那你已經在做現在被稱為「vibe coding」的事。這代表你讓語言模型生成整段邏輯,自己沒有逐行審查就直接推上線。這種做法省下的時間確實可觀,原本要花好幾天的功能,AI 幾分鐘就能寫出能動的版本。但 AI 寫 WordPress 程式碼這件事能不能信、信到什麼程度,取決於你有沒有把接下來幾個判準當一回事,而不是取決於程式碼看起來順不順眼。
去年整個 WordPress 生態系的漏洞數字暴增,資安業者的年度報告也直接點名這種不經審查就上線的習慣是原因之一。
開發者對 AI 生成程式碼的信任超前於實際安全表現
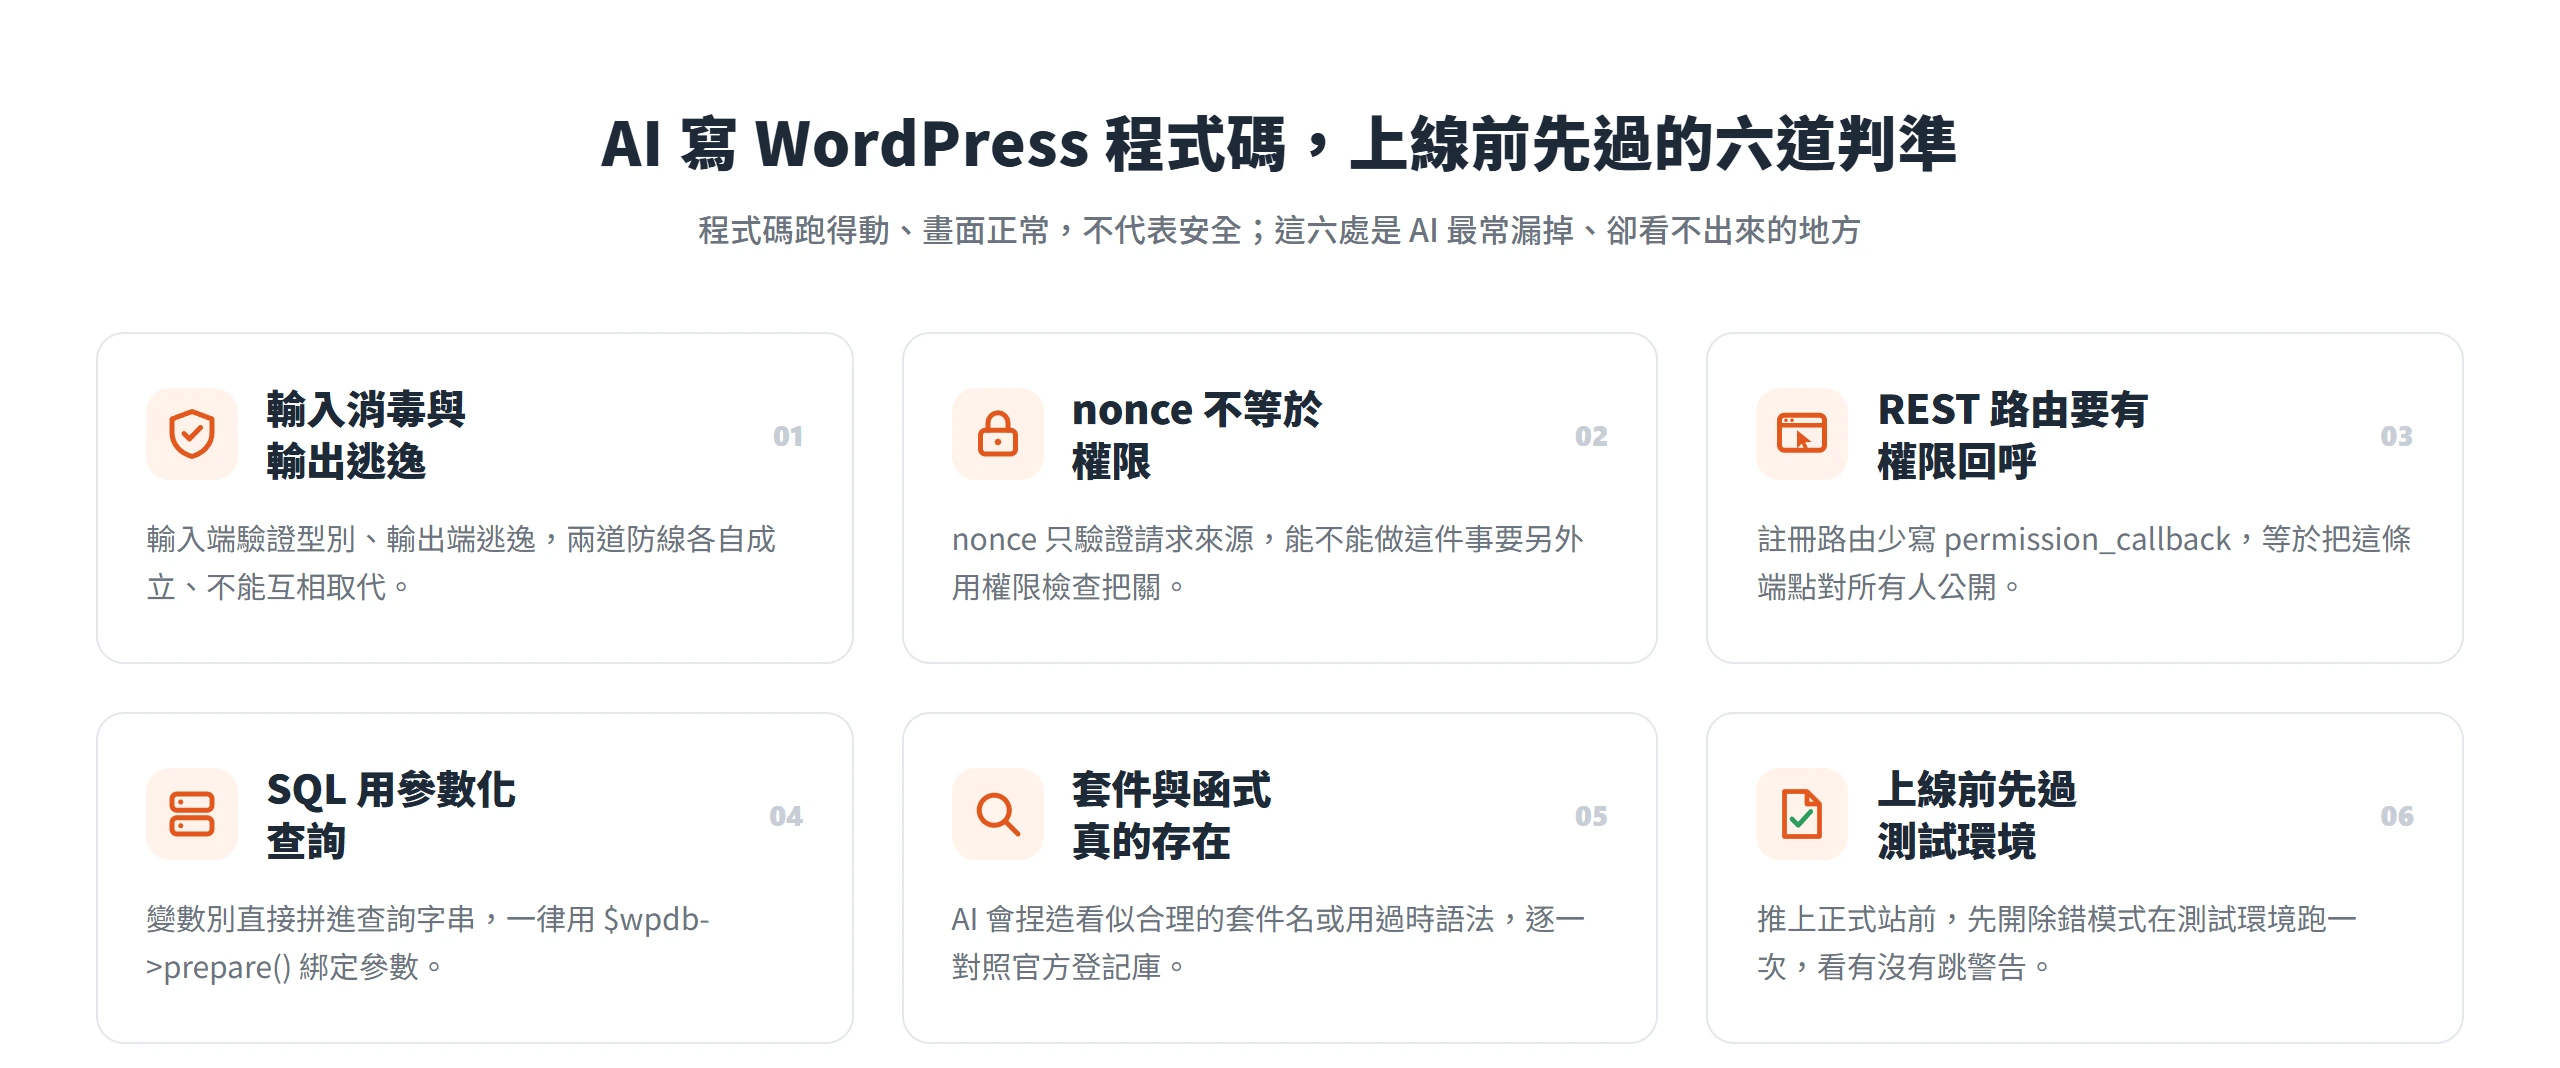
Snyk 針對開發者實際使用 AI 寫程式的調查發現,96% 的開發者已經在工作裡用 AI 輔助寫程式,這個比例幾乎等於「幾乎所有人都在用」。但同一份調查裡,75.8% 的開發者相信 AI 生成的程式碼比自己手寫的更安全。這個信念跟接下來要談的研究證據恰好相反。
史丹佛大學一份題為〈Do Users Write More Insecure Code with AI Assistants?〉的研究做了更嚴謹的對照實驗,讓一組開發者用 OpenAI 的 Codex 模型輔助寫程式,另一組不用,任務涵蓋字串加密、SQL 查詢、檔案路徑處理等常見情境。結果是,有 AI 輔助的那一組寫出的程式碼明顯較不安全,但這群開發者反而更相信自己寫的是安全的,信心與實際安全程度成反比。研究也發現,對 AI 輸出保持懷疑、願意重新調整提示詞而不是照單全收的人,寫出的漏洞明顯比較少。這代表落差不是無解的,關鍵在於你把 AI 的輸出當成「需要驗證的草稿」,還是當成「可以直接用的成品」。
這個落差放到 WordPress 生態系裡,數字更直接。Patchstack 在〈State of WordPress Security in 2026〉白皮書裡統計,2025 年 WordPress 生態系新增了 11,334 個漏洞,比 2024 年的 7,966 個成長 42%;其中屬於高風險、有可能被大規模自動化攻擊利用的漏洞占 17%,年增幅達 113%,2025 年新發現的高風險漏洞數量甚至比前兩年加起來還多。91% 的新漏洞出在外掛,只有 6 個出在 WordPress 核心本身,問題集中在第三方與客製化程式碼,不是核心系統。報告明確點名「vibe coding」是漏洞加速增加的原因之一。開發者用大型語言模型生成外掛程式碼,卻沒有能力或沒有花時間審查模型實際寫出了什麼,就直接把它推上線,漏洞因此在無聲無息中上線。
這兩份材料合起來說的是同一件事。AI 生成程式碼的能力確實在進步,但進步的速度跟開發者對它的信任程度,走的不是同一條曲線。真正危險的,是那些「AI 常常漏掉、但看起來完全正常」的地方——程式碼能跑、畫面正常,漏洞卻已經悄悄留在裡面。
輸入消毒與輸出逃逸兩道防線
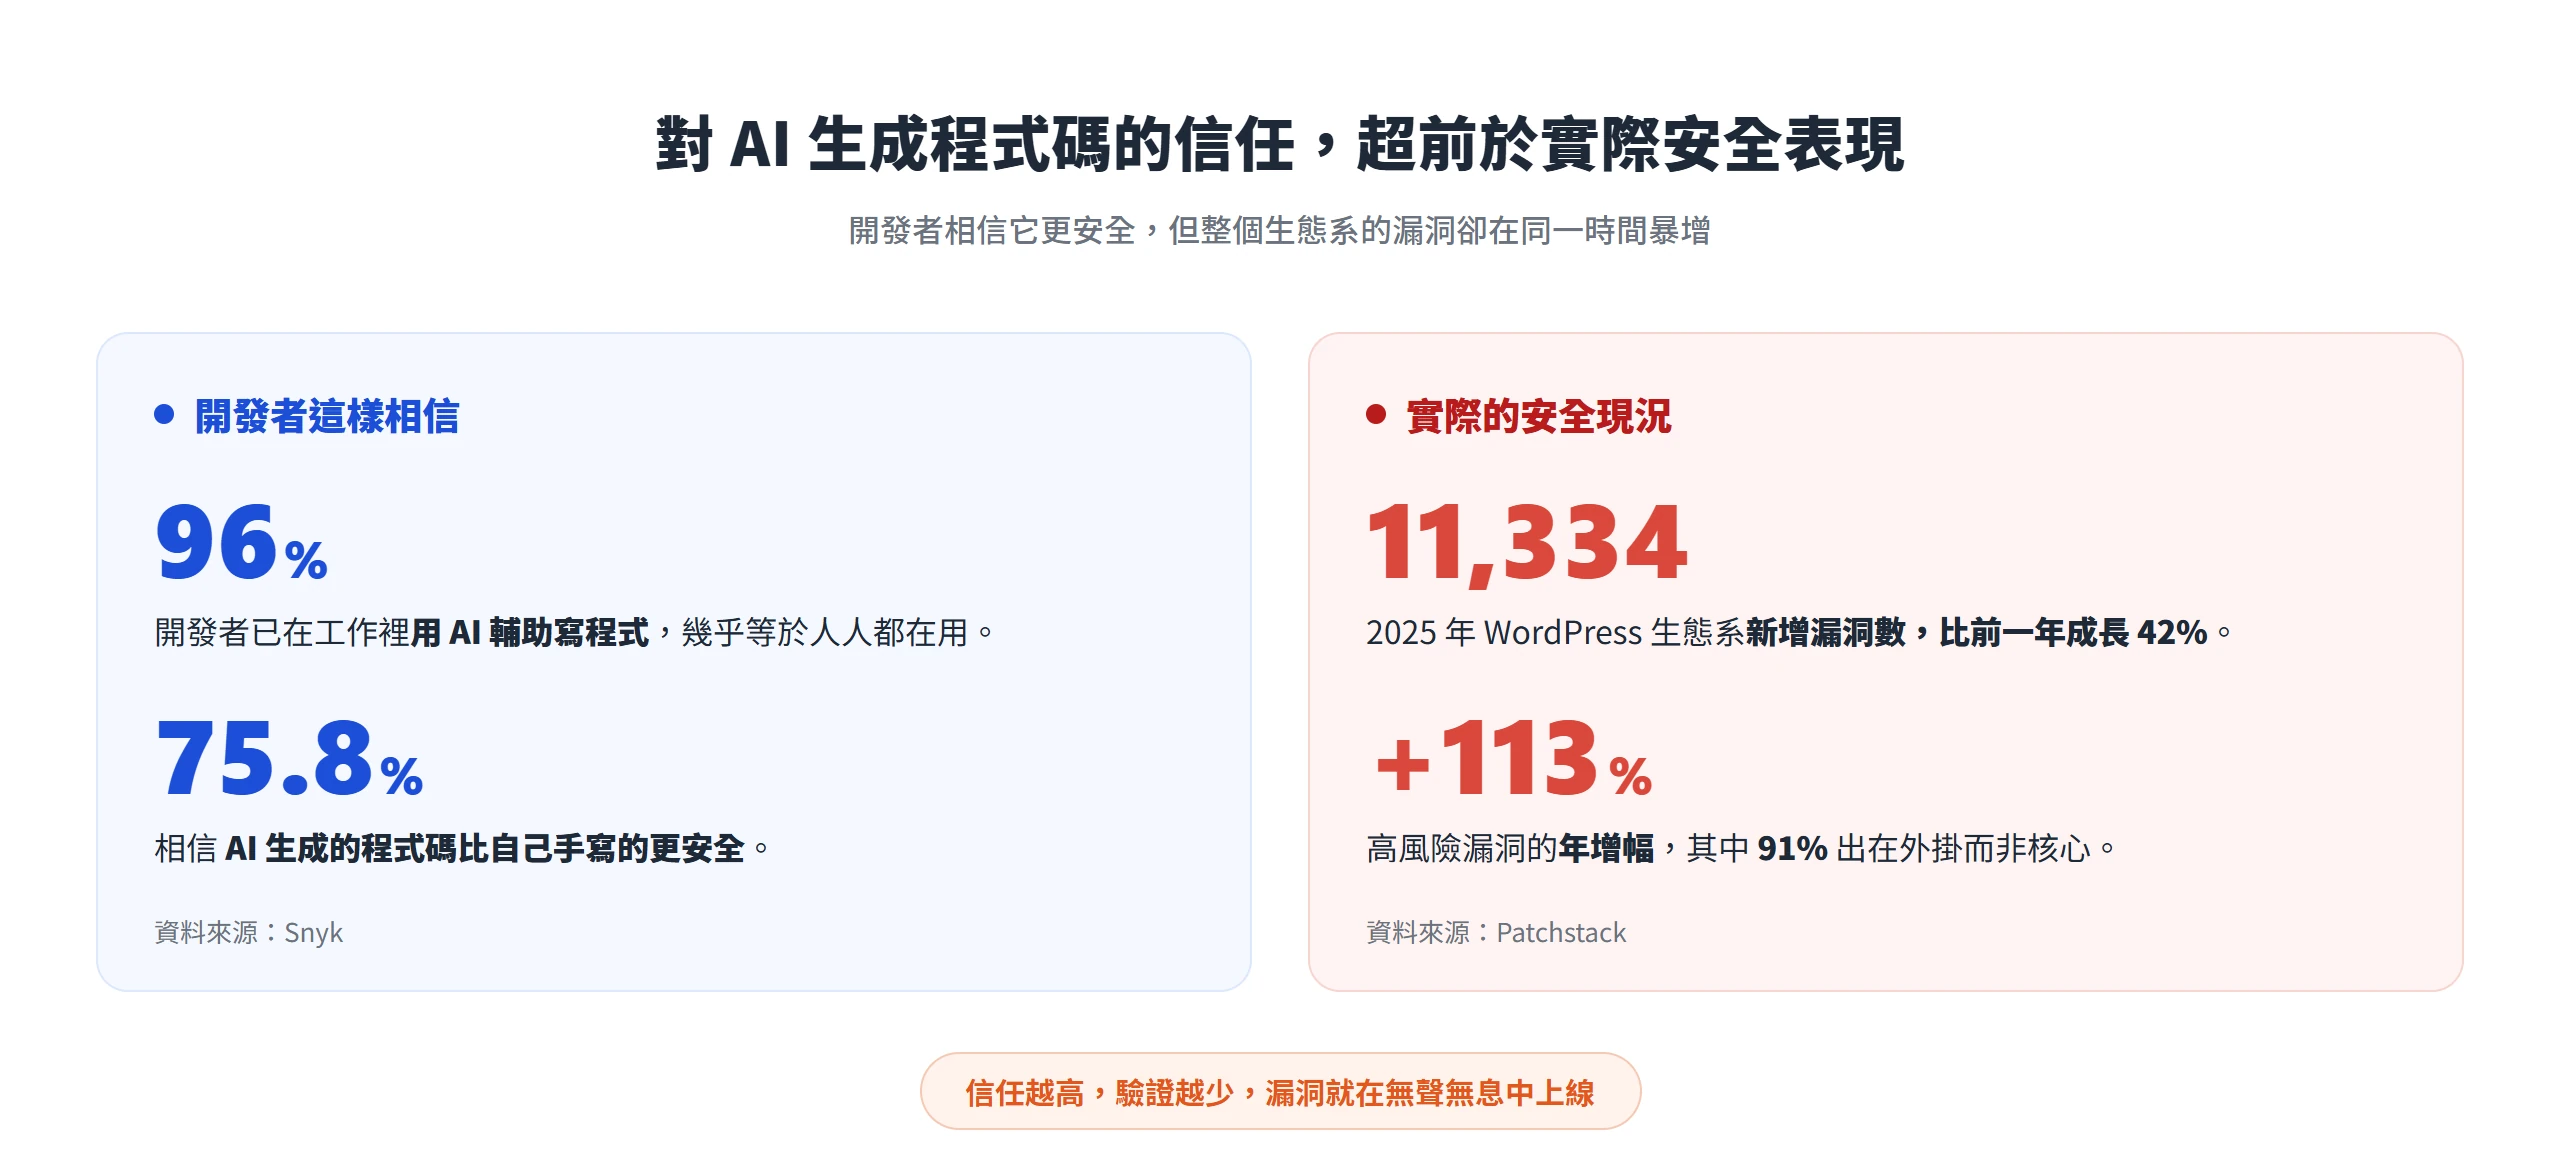
WordPress VIP 官方技術文件〈Validating, sanitizing, and escaping〉開宗明義揭示的原則,是絕不信任使用者輸入。文件把驗證要盡早做、逃逸要盡晚做寫成硬性指導,理由是逃逸拖到最後一刻,程式碼審查時才能一眼判斷這個變數安不安全,也才能避免它在賦值後、輸出前被意外改動,同時方便自動化掃描工具檢查。這份文件也把驗證與消毒明確拆成兩件不同的事:驗證是核對資料型別是否符合預期,例如郵遞區號要用 absint() 轉成非負整數再核對長度;消毒則是用 sanitize_text_field()、wp_kses() 這類官方函式清掉不該有的內容。
這個框架之所以重要,是因為 AI 生成程式碼常常只做半套,可能是做了輸入檢查,卻漏掉輸出時的逃逸;也可能是逃逸函式套對了,輸入端卻只信任前端的表單限制。兩邊各自成立、不能互相取代。這也是後面談 nonce 與 SQL 查詢時,都會用到的共同基礎。
輸入驗證與消毒不能只靠前端表單限制
前端的 maxlength 這類限制只是使用者體驗,攔不住存心搗亂的輸入。WP VIP 文件舉了一個郵遞區號欄位的例子,前端只限制輸入 5 個字元,卻沒限制字元類型,11221 能通過,eval( 這種字串一樣能通過。伺服器端一定要再做一次驗證,用 absint() 這類函式把值轉型、核對長度,不符合規則就丟棄、存空值。這就是 WordPress 提倡的「safelist 哲學」,只允許使用者輸入這個欄位原本該有的型態,而不是等發現異常字元才逐一排除。
// 表單提交後的伺服器端驗證,而不是只信前端 maxlength
$zip = isset( $_POST['zip'] ) ? absint( $_POST['zip'] ) : 0;

if ( strlen( (string) $zip ) === 5 ) {
    update_post_meta( $post_id, 'zip_code', $zip );
} else {
    update_post_meta( $post_id, 'zip_code', '' );
}Code language: PHP (php)
AI 生成的表單處理程式碼,很容易在這一步偷懶,可能只在前端加了限制,或是後端籠統呼叫一次 sanitize_text_field() 就當作處理完畢,沒有針對這個欄位「本來該長什麼樣子」去驗證型別。類似的觀察也出現在其他技術分析裡:AI 在處理表單相關程式碼時,比較常記得做輸入驗證,但消毒步驟經常做得不夠完整。真正該問的問題是,這個欄位如果被塞進不該有的字元或型別,後端有沒有一道獨立的關卡把它擋下來,而不是只信賴前端畫面上看起來合理。
輸出逃逸函式要挑對情境,不能只用一種
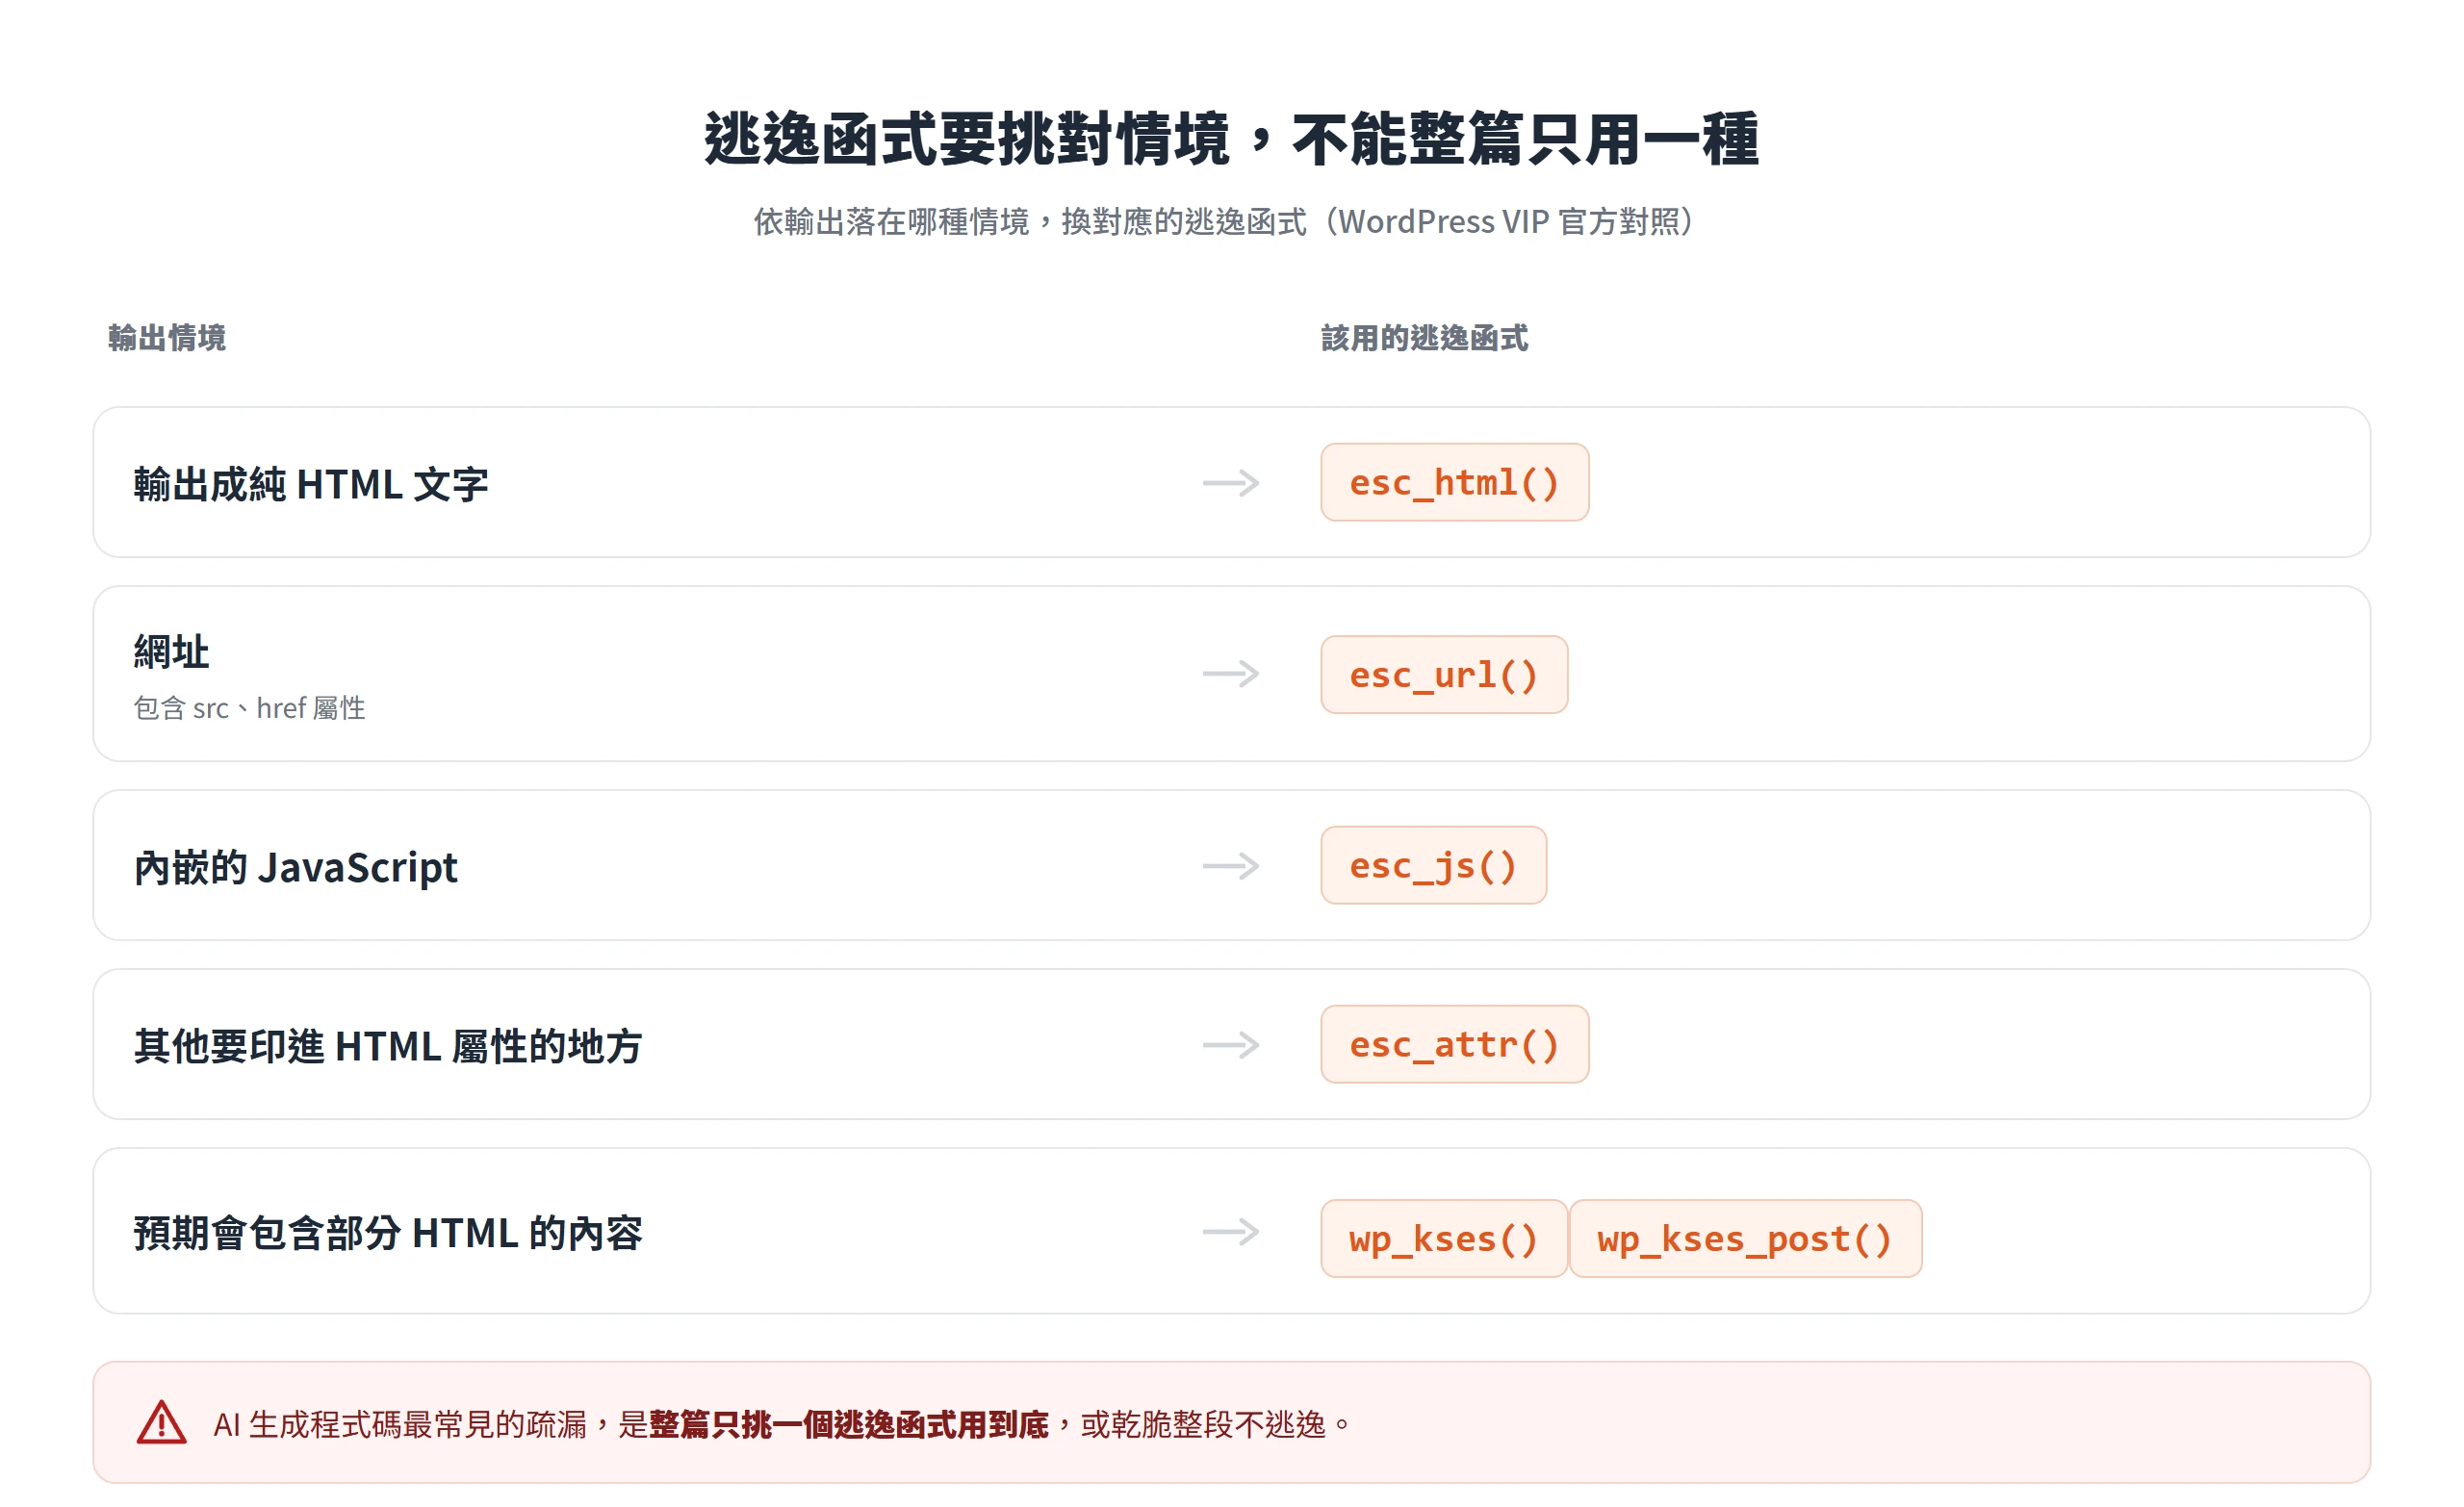
逃逸不是套用同一個函式就能一路用到底,依輸出情境不同要換不同函式。WP VIP 文件列出了對應關係:esc_html() 用在輸出成純 HTML 文字的時候;esc_url() 用在所有網址,包含 src、href 屬性;esc_js() 專門給內嵌 JavaScript;esc_attr() 用在其他所有要印進 HTML 屬性的地方;wp_kses() 與 wp_kses_post() 則用在預期會包含部分 HTML 的內容,wp_kses_post() 允許文章內容通常允許的標籤。文件也提醒,組網址參數要用 rawurlencode() 而不是 urlencode(),兩者處理空白與特殊字元的方式不同。
// 依輸出情境挑對應的逃逸函式,不能整篇只用一種
echo '<a href="' . esc_url( $link ) . '">' . esc_html( $title ) . '</a>';
echo '<div data-id="' . esc_attr( $post_id ) . '">' . wp_kses_post( $content ) . '</div>';Code language: PHP (php)
AI 生成程式碼最常見的疏漏,是整篇只挑一個逃逸函式用到底,比較常見的是全部用 esc_attr(),或乾脆整段輸出都不逃逸。用錯情境的代價不小,例如把該用 esc_url() 的地方換成 esc_html(),網址裡的特殊字元不會被正確處理;或是把該用 esc_js() 的地方漏掉,攻擊者能把自己的程式碼塞進頁面裡執行。拿到一段 AI 生成的輸出程式碼,先看它印出來的內容落在哪種情境(純文字、網址、屬性、內嵌指令碼、允許部分標籤),再核對用的逃逸函式對不對,是比通篇讀邏輯更快抓到問題的方法。
驗證通過 nonce,不代表使用者真的有權限
WordPress 官方開發者部落格在〈Understand and use WordPress nonces properly〉這篇文章裡,開門見山點出一個最危險的誤解,也就是把通過的 nonce 當成權限本身。使用者可以持有一個有效的 nonce,卻不代表他應該能改設定、刪內容或操作別人的帳號。權限與存取控制不是 nonce 負責的事,要另外檢查。文件給出的正確安全模式順序是:先檢查權限,再驗證 nonce,接著消毒輸入,然後執行動作,最後在輸出時逃逸。
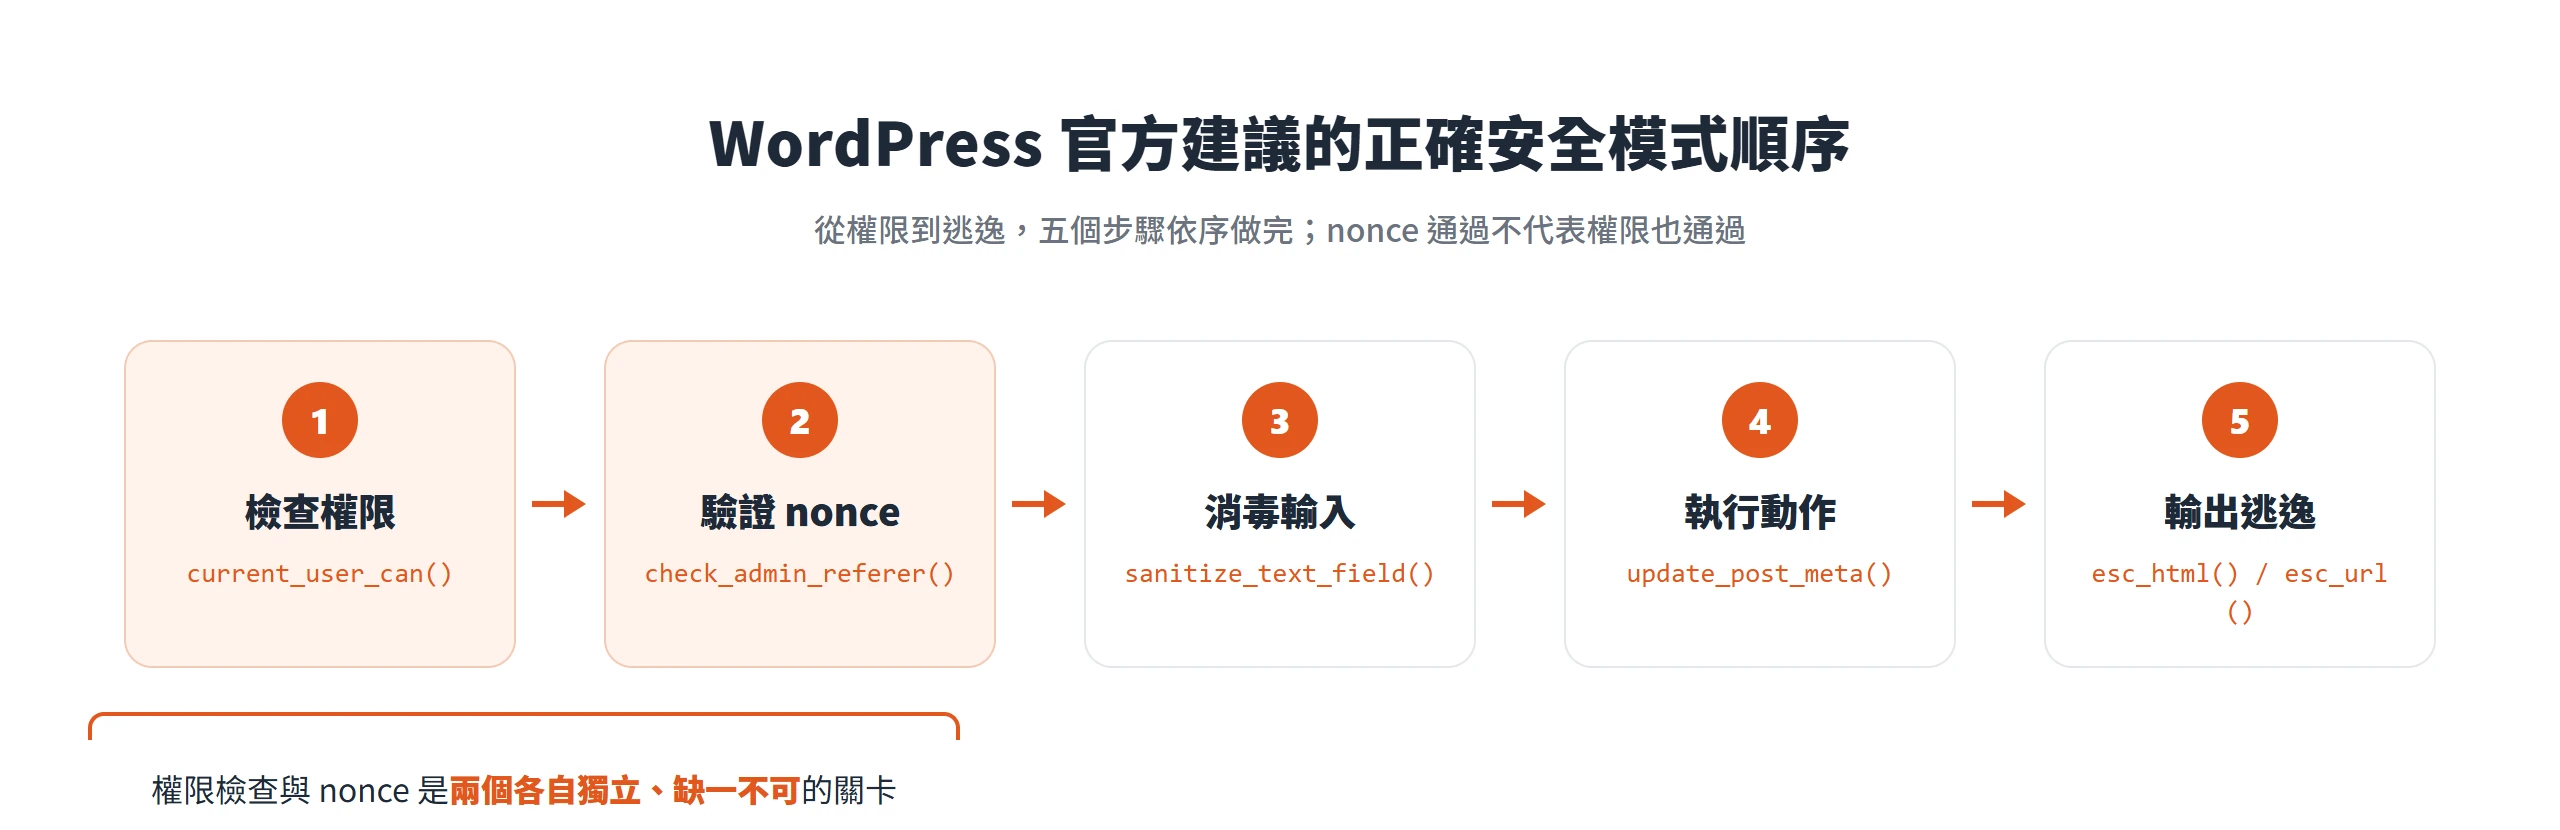
這是 AI 生成程式碼最容易搞混、也最常被誤解的一個環節,因為只寫 nonce 檢查、看起來程式碼已經「有安全機制」,很容易就被當成安全已經到位。實際上 nonce 跟權限判斷是兩件完全獨立的事,缺一不可。
nonce 只驗證來源,權限判斷要另外處理
nonce 的設計目的是防止跨站請求偽造,也就是確認這個請求真的來自你自己網站上的表單或連結,而不是被人從別的網站騙來的偽造請求。這跟「這個使用者該不該被允許做這件事」是完全不同的問題。同一篇官方文章明講,nonce 檢查與 current_user_can() 權限檢查要視為兩個各自獨立、缺一不可的關卡,不能把其中一個省略,也不能假設通過其中一個就代表另一個也成立。
// 正確順序:先權限,再 nonce,最後才執行動作
if ( ! current_user_can( 'edit_post', $post_id ) ) {
    wp_die( '沒有權限執行此操作' );
}

check_admin_referer( 'update_custom_field_' . $post_id );

update_post_meta( $post_id, 'custom_field', sanitize_text_field( $_POST['value'] ) );Code language: PHP (php)
AI 生成的程式碼常見的寫法,是只放了 check_admin_referer() 或 wp_verify_nonce() 這一行,就直接往下執行更新資料庫的動作,完全沒有呼叫 current_user_can()。拿到這類程式碼,先找有沒有獨立的權限檢查那一行,而不是看到 nonce 檢查就假設安全已經到位。文件同時提醒,nonce 本身不驗證資料是否安全,那是消毒的工作,也不要在 init 掛勾觸發之前呼叫 wp_create_nonce(),否則產生的 nonce 可能失效。
REST API 少了 permission_callback 等於公開
REST API 是「AI 沒有明確寫某個安全參數,結果等於預設開放」這種疏漏最具體的案例。WordPress 官方核心部落格在〈REST API changes in WordPress 5.5〉說明,5.5 版之前,註冊 REST API 路由若沒有指定 permission_callback,這條路由會被視為公開,任何人都能存取;5.5 版之後,官方無法判斷「沒寫」是刻意要公開還是漏寫,因此改成沒有明確指定就會觸發 _doing_it_wrong 提示。
// 明確寫出公開端點,而不是整段省略 permission_callback
register_rest_route( 'myplugin/v1', '/public-data', array(
    'methods'             => 'GET',
    'callback'            => 'myplugin_get_public_data',
    'permission_callback' => '__return_true',
) );

// 需要限制的端點,callback 內做能力檢查
register_rest_route( 'myplugin/v1', '/settings', array(
    'methods'             => 'POST',
    'callback'            => 'myplugin_update_settings',
    'permission_callback' => function () {
        return current_user_can( 'manage_options' );
    },
) );Code language: PHP (php)
這種疏漏會發生,跟 AI 訓練資料裡新舊寫法混雜有很大關係。舊版可以省略的參數,在新版行為已經改變,模型卻可能沿用舊的省略寫法生成程式碼。官方文件明講,真的要做成公開端點,要明確寫上 __return_true 作為 permission_callback,而不是整段直接省略這個參數,同時建議在 callback 內做該路由對應的能力檢查,而不是隨便回傳 true 了事。拿到 AI 生成的 REST API 註冊程式碼,第一件事就是確認每一條路由都有 permission_callback 這個鍵,而且它的邏輯真的對應到這條路由該有的存取限制。
SQL 查詢用參數化而非字串直接拼接
SQL Injection 是最老、也最容易驗證的一類問題,但這個老問題在 AI 生成的程式碼裡一樣會發生。常見的疏漏模式是,AI 生成的登入或查詢相關程式碼,直接把使用者輸入的 $username 這類變數拼進 SQL 查詢字串,沒有用參數綁定的預備語句,因而帶著 SQL Injection 風險。這類程式碼往往幾分鐘就能生成、畫面跑起來一切正常,漏洞卻悄悄留在裡面,不會跳出任何錯誤訊息提醒你。
// 錯誤:字串直接拼接,攻擊者能操控查詢邏輯
$username = $_POST['username'];
$sql = "SELECT * FROM {$wpdb->users} WHERE user_login = '$username'";
$user = $wpdb->get_row( $sql );

// 正確:用 $wpdb->prepare() 做參數化查詢
$username = sanitize_text_field( $_POST['username'] );
$user = $wpdb->get_row(
    $wpdb->prepare( "SELECT * FROM {$wpdb->users} WHERE user_login = %s", $username )
);Code language: PHP (php)
WordPress 官方〈Make WordPress Plugins〉審核清單,把「資料庫查詢一律要用 $wpdb 搭配 prepare()」列為強制項目,不是可有可無的建議,任何要被官方目錄收錄的外掛都得通過這一項。這也是判準裡少數能用最短時間確認的一項:拿到任何一段涉及資料庫查詢的程式碼,先搜尋有沒有 $wpdb->prepare() 這個函式,如果查詢裡的變數是直接用字串串接或雙引號內插的方式塞進 SQL 語句,不管其他邏輯寫得多完整,這段程式碼都不該直接上線。
套件名稱、函式版本都要對照到真的存在
AI 生成程式碼還有一種不同類型的風險:看起來完全合理,內容卻根本不存在或已經過時。Snyk 一篇談〈Package Hallucination〉的文章解釋了成因。AI 模型會依統計上「像真的」的命名模式生成套件名稱,例如常見字首加上常見字尾的組合,因為模型在生成當下無法即時對照 npm、Packagist 這類真實的登記庫,只能靠機率猜測。這代表 AI 幻覺捏造出看似真實的套件或函式名稱,可能被有心人冒名註冊植入惡意內容;同時因為訓練資料存在時間落差,已經被取代的舊寫法也會反覆被生成出來。
幻覺套件名稱是可被冒名註冊的破口
這種幻覺不只是「AI 有時會出錯」這種抽象警語,而是一個可以被攻擊者利用的具體攻擊手法,業界稱之為「slopsquatting」。做法是 AI 自信推薦一個實際不存在的套件名稱,開發者不查證就直接寫進專案,攻擊者則監控 AI 常生成哪些幻覺名稱,搶先用那個名字註冊一個帶惡意程式碼的套件,等其他開發者複製貼上就中招。
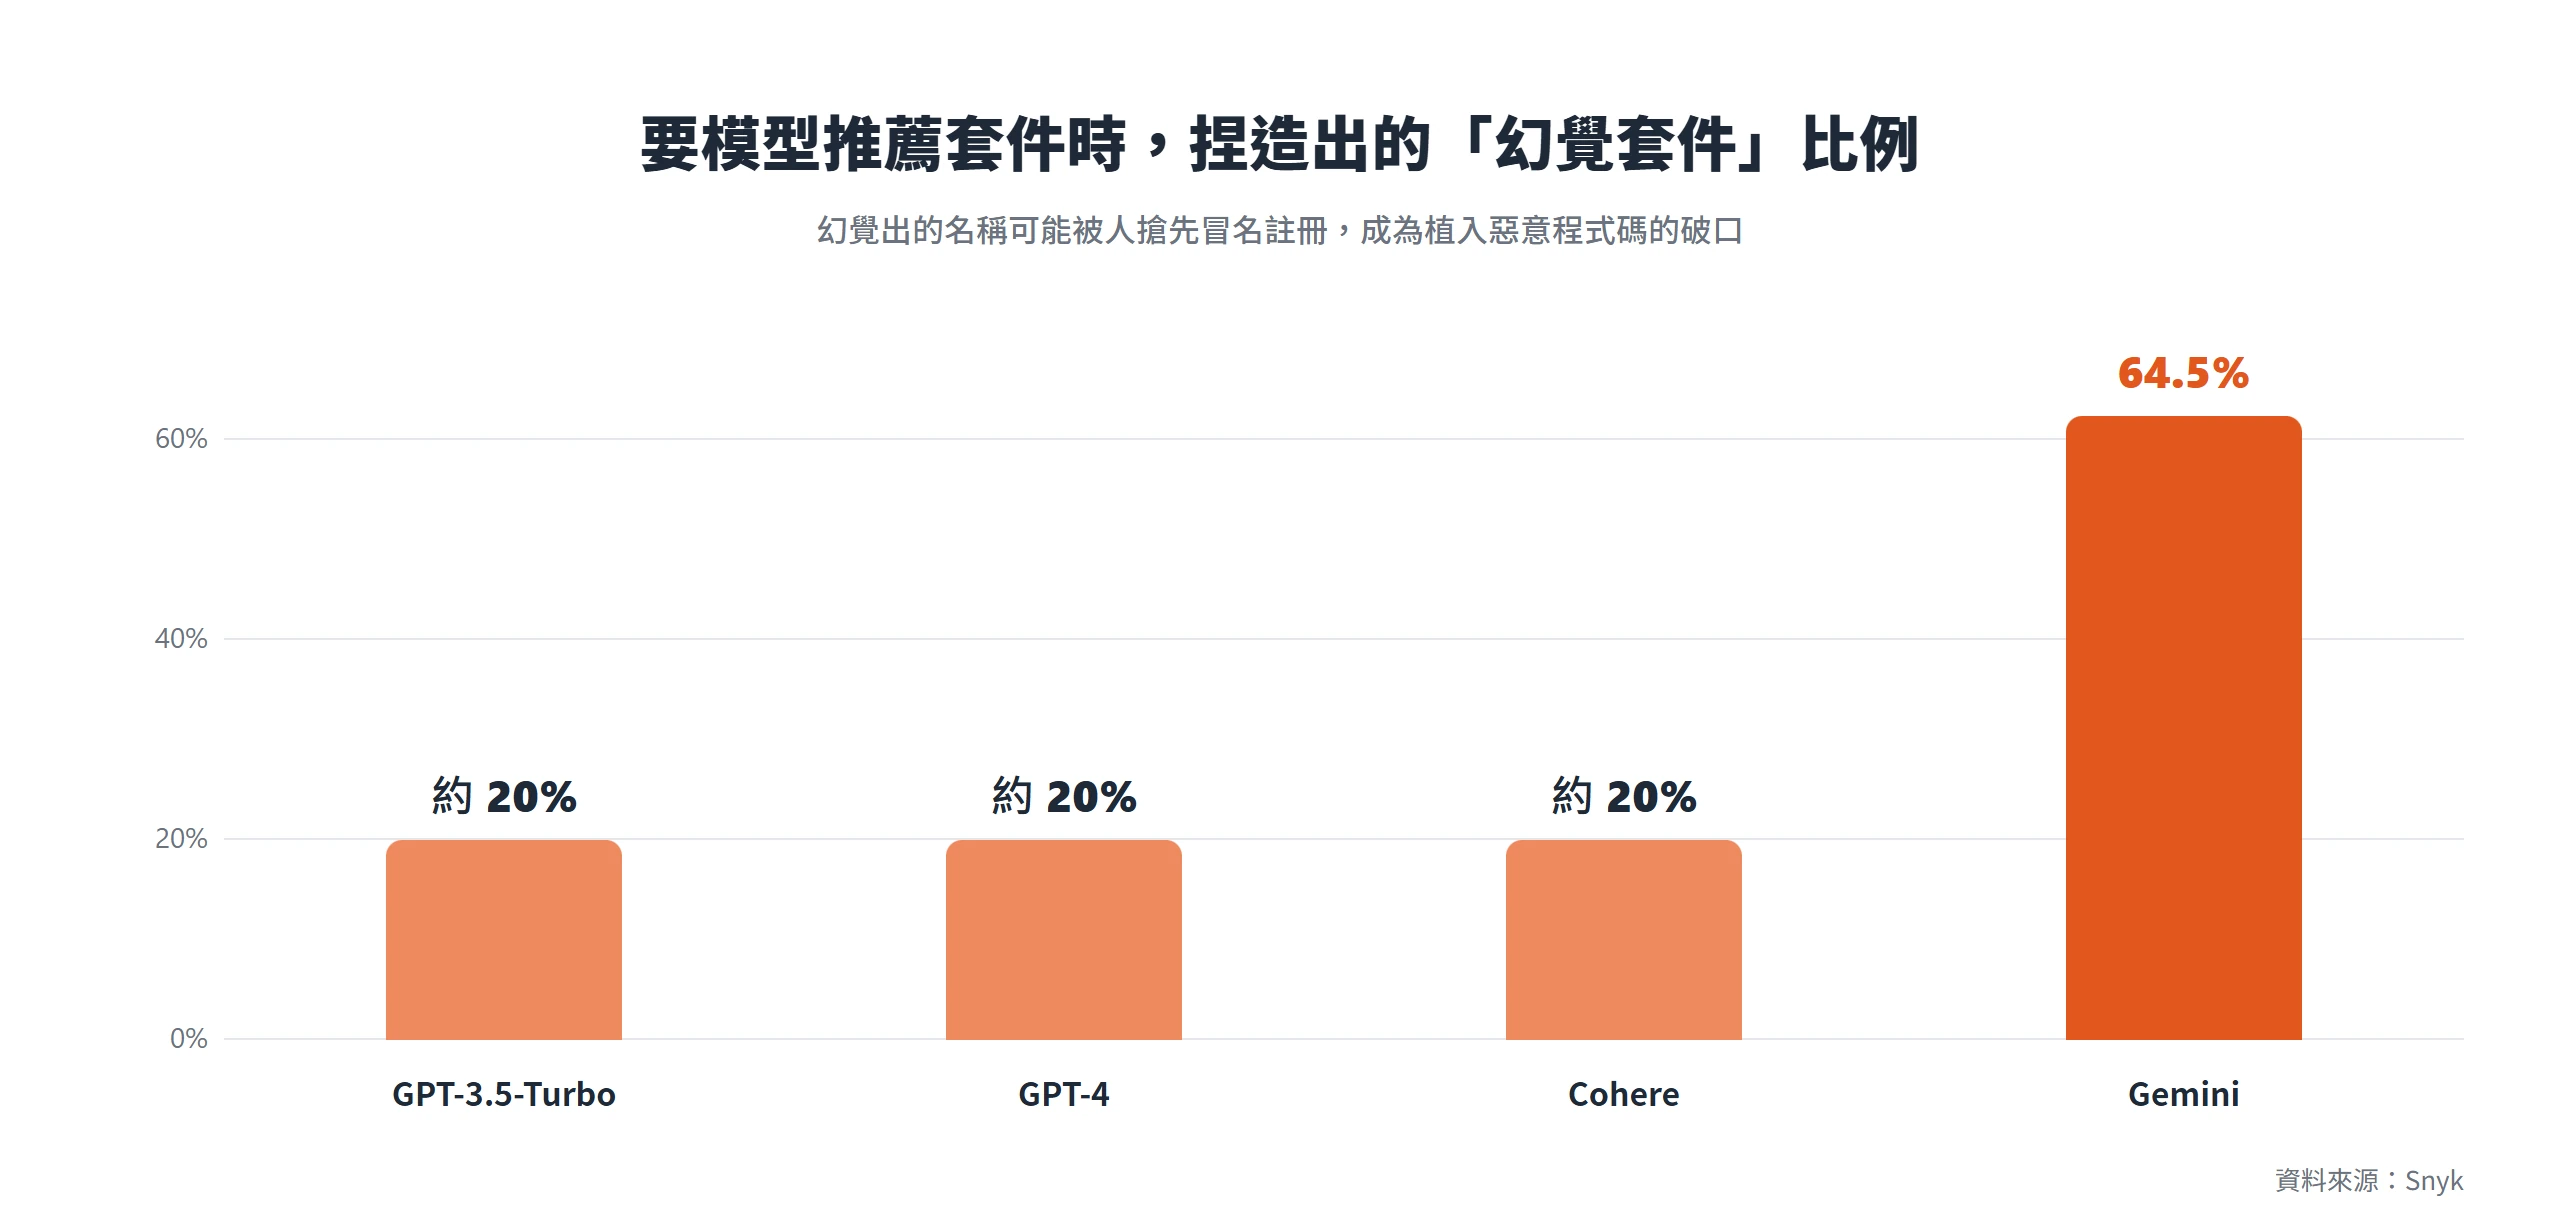
Snyk 引用研究者 Bar Lanyado 在 2023 年做的實驗當作證據:他上傳一個空的、名叫「huggingface-cli」的套件,模擬一個曾被 AI 幻覺出的名稱,結果三個月內被下載超過 3 萬次,證實幻覺名稱確實會被大量開發者不加查證地拿去用。同一篇文章也引用測試數字,要求多個模型推薦套件時,GPT-3.5-Turbo、GPT-4、Cohere 出現幻覺套件的比例約 20%,Gemini 則高達 64.5%。這個案例雖然以通用程式語言的套件庫為主,但邏輯同樣適用於 WordPress 生態系裡 AI 建議的 Composer 套件或外掛名稱,做法是對照官方登記庫,確認這個名字真的存在、真的是那個功能,而不是看起來眼熟就直接相信。
訓練資料的時間差讓過時語法反覆出現
AI 特別容易寫出「能執行但是舊寫法」的程式碼,原因不是模型「不知道」新寫法,而是舊寫法在訓練資料裡出現的次數壓倒性地多。這對 WordPress 這種有二十多年歷史包袱的生態系尤其明顯,區塊編輯器相關的新寫法,訓練資料裡的樣本數遠不如舊版經典編輯器的寫法多。
一份題為〈LLMs Meet Library Evolution: Evaluating Deprecated API Usage in LLM-based Code Completion〉的學術研究,測試了 7 個大型語言模型、涵蓋 8 個常用函式庫的 145 組「已棄用 API 對照替代寫法」,總共跑了 28,125 次生成請求,結果已棄用用法比例落在 25% 到 38% 之間。反直覺的是,規模較大的模型反而更常生成已棄用的寫法,例如 CodeLlama-7b 的已棄用比例達 34.2%。研究解釋了這個現象的成因:函式庫演進之後,舊寫法與新寫法會同時留在開放原始碼社群裡,教學文、討論串、範例專案都還在使用舊版,訓練資料是從這些原始碼裡撈出來的,模型自然學到兩種寫法,而且舊寫法的樣本數往往還比較多。拿到 AI 生成的程式碼,遇到看起來能動但寫法眼熟的函式,值得花一分鐘確認它是不是已經被官方標記為棄用,而不是單純看它有沒有跳出錯誤。
上線前一定要先過測試環境這一關
前面每一項判準都個別驗證過,仍然值得把 AI 寫出來的東西,在正式站之外的環境跑過一次,看有沒有跳出錯誤或警告。這不是額外的謹慎,而是 WordPress 官方自己對外部提交程式碼的第一道審核步驟。Trend Micro 一份研究〈Security Vulnerabilities of ChatGPT-Generated Code〉明講,ChatGPT 缺乏對「開發情境」的理解,不知情的使用者可能在沒發現的情況下,把帶有嚴重安全漏洞的 AI 生成程式碼用進正式環境;因此建議把 AI 定位成輔助角色,程式碼本身仍需要人類開發者複查與最佳化才能上線。
WordPress 官方審核也把測試環境列為必要步驟
WordPress 生態系本來就有這樣的既定做法。〈Make WordPress Plugins〉官方審核清單,把「在安全的環境中測試」寫成審核任何外掛前必做的一步,審核人員的標準工作流程明列具體驗收項目:啟用 WP_DEBUG 之後不能跳出任何 PHP 或 JS 錯誤,官方建議搭配 Query Monitor、Debug Bar 這類除錯外掛檢查;所有處理過的資料都要驗證、消毒、逃逸;資料庫查詢要用 $wpdb 搭配 prepare()。
這些是外掛要被官方目錄收錄前的強制門檻,拿來類比自己的網站也很直接,把 AI 寫的程式碼推上正式站之前,至少也該做到同樣程度的檢查,而不是把「先在測試站跑過一次」當成多花時間的額外步驟。啟用除錯模式、觀察後台與前台有沒有跳出任何警告,是最低成本、也最容易被跳過的一關。
Plugin Check 這款官方工具能先抓出基本疏漏
前面談的每一項判準,都需要花時間逐一核對,這往往就是「知道要驗證,但不知道怎麼開始驗證」的門檻。〈Plugin Check〉收錄在 WordPress.org 官方外掛頁上,是官方開發的檢測工具,可以在 WP 後台或用 WP-CLI 對任何外掛跑一次自動檢查,涵蓋國際化、無障礙、效能與安全性等多個面向。
從官方公布的更新紀錄可以看到它逐步補進的檢查項目,剛好對應到前面幾節談的判準:偵測不安全的 wp_verify_nonce() 使用方式、偵測直接呼叫資料庫查詢卻沒有用 WordPress 官方函式、偵測缺少輸入消毒的設定儲存程式碼、偵測使用了超出宣告最低 WordPress 版本的函式、偵測正式環境下的 PHP 錯誤回報設定。官方文件同時明講這個工具不能取代人工審查流程,只是幫忙先抓掉常見疏漏,讓後續複查能更快聚焦在真正需要判斷的地方。對於自己動手驗證每一項判準有困難的人來說,先跑一次這款工具,是把抽象規則變成具體可執行動作最快的方式。
風險層級不同,AI 能放手的程度也不同
前面每一項判準都各自成立,回到一開始的問題,所有程式碼都要這樣逐項驗證,那 AI 還能不能用來寫程式。答案不是一刀切地全信或全不信,而是依程式碼牽涉的風險等級,決定放手的程度。單純的畫面顯示、樣式調整、內容排版這類程式碼,出錯頂多是畫面跑掉,重新整理或回頭調整就能修正;涉及金流、使用者權限、個人資料存取、跨站身份驗證這類程式碼,出錯的代價是資安事件,可能是資料外洩,也可能是整個網站被植入惡意程式。
Patchstack 白皮書裡的兩個數據點,強化了這個分級的急迫性。2025 年最容易被大規模攻擊的漏洞類型是權限控管失效,這類漏洞特別難被傳統防火牆攔截,因為攻擊流量看起來就像正常登入使用者的操作,沒有明顯異常特徵可以比對。同一份報告也指出,遭大量攻擊的漏洞,從公開到首次被鎖定攻擊的加權中位時間只有 5 小時,其中 20% 在公開後 6 小時內就被攻擊,70% 在 7 天內遭殃。這代表權限與存取控制相關的程式碼一旦出錯,暴露的時間窗口極短,屬於前面談過的判準裡最需要人工逐項驗證,甚至該考慮乾脆不讓 AI 碰的那一類。
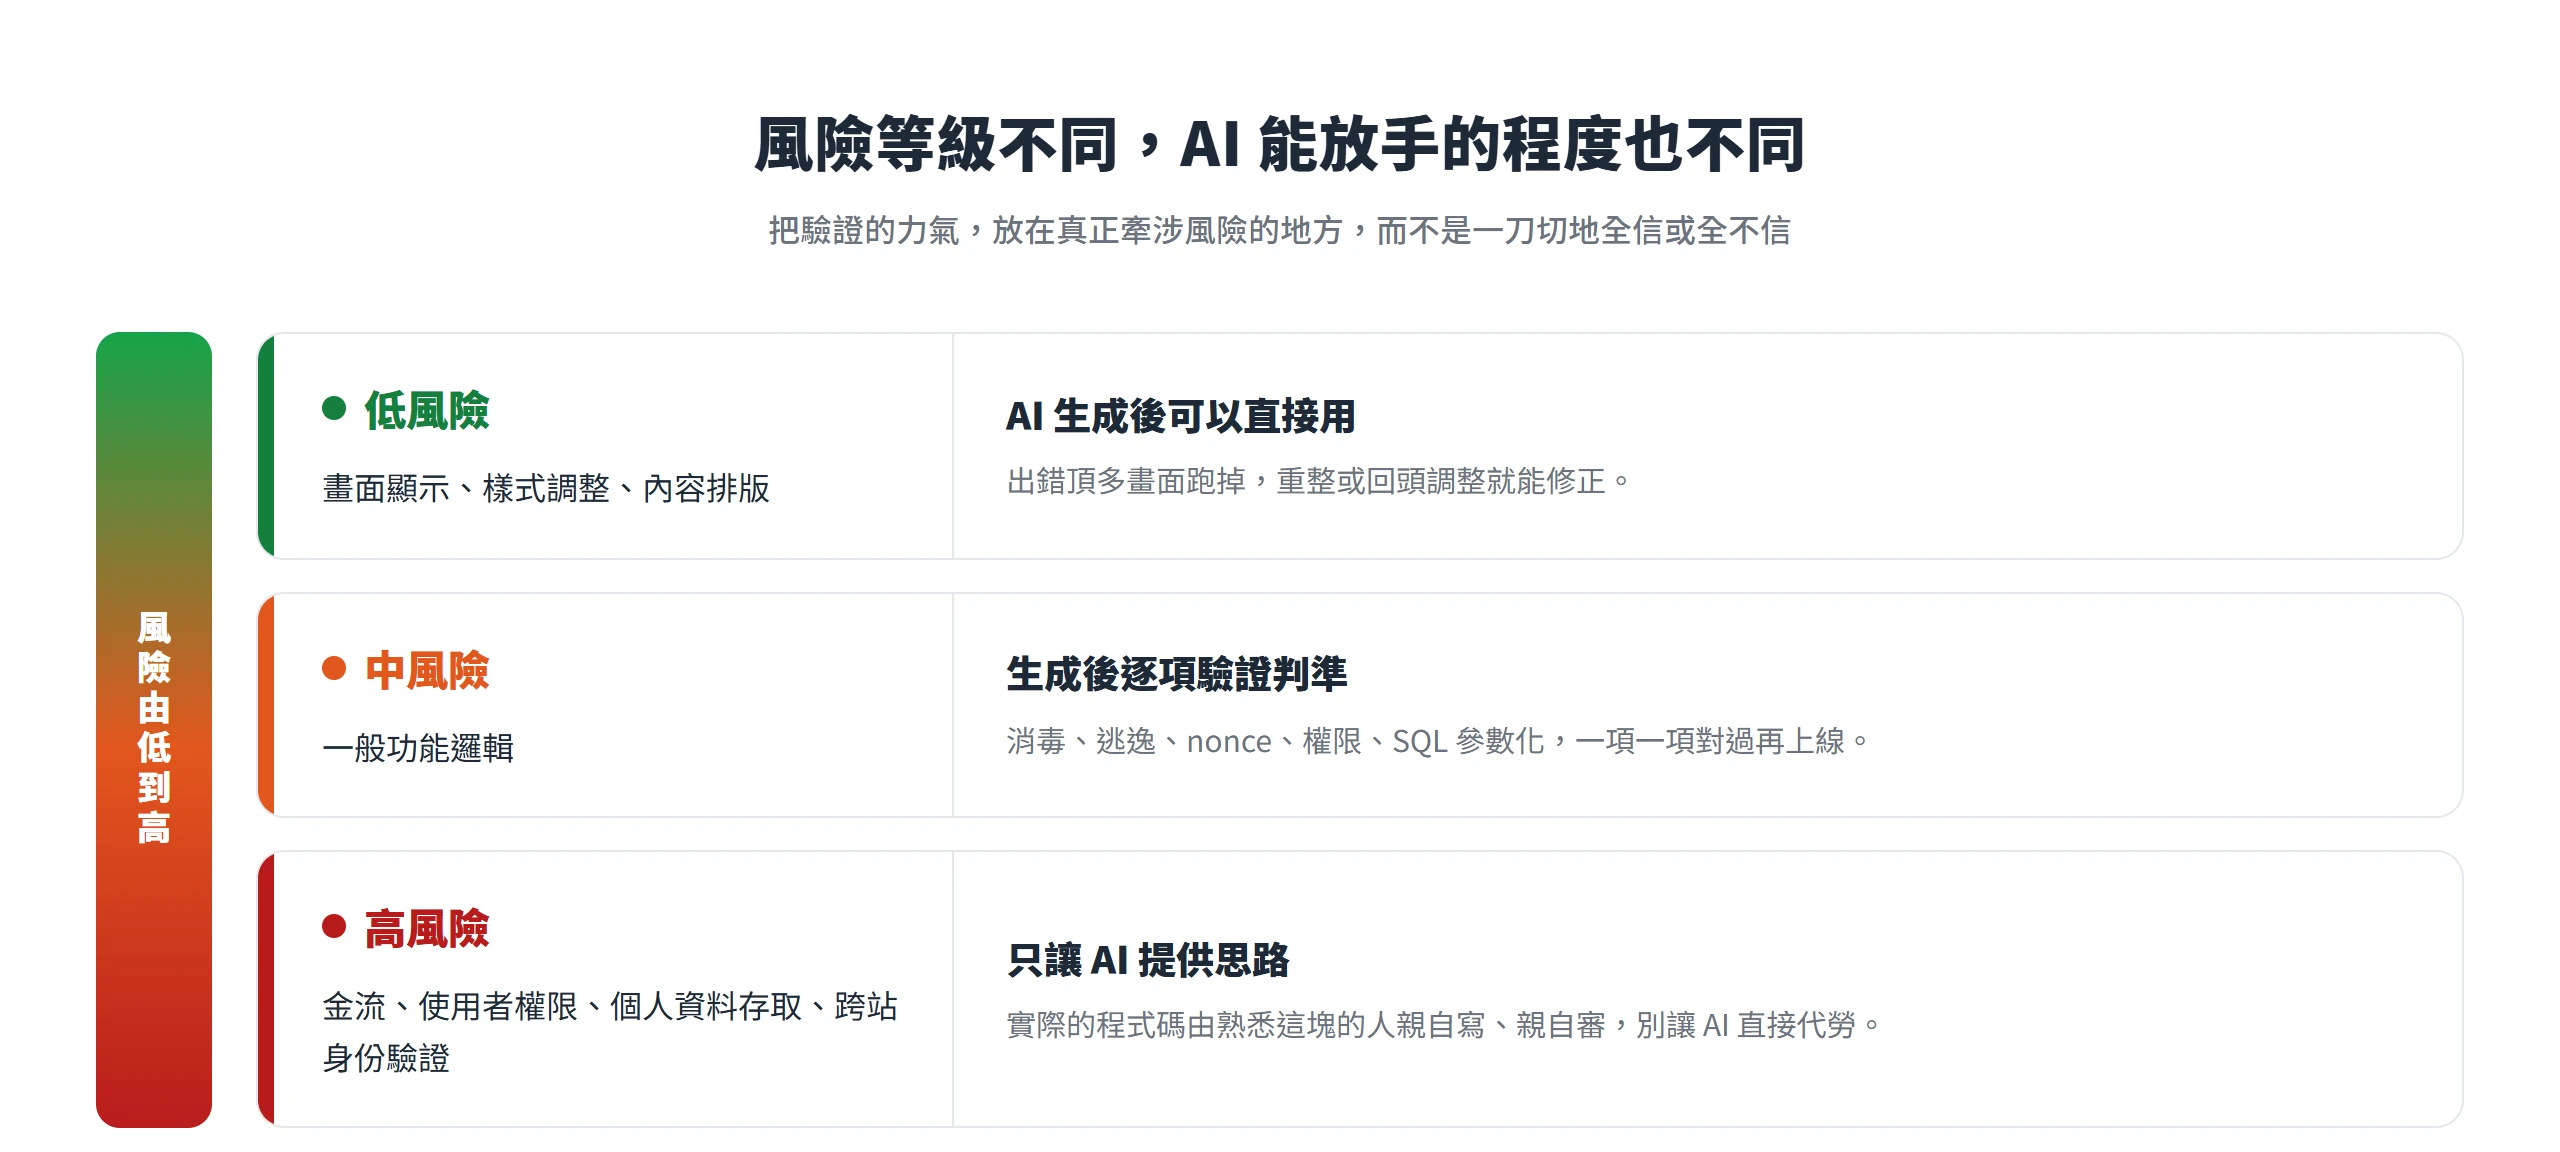
三種處理方式,可以對應到不同的風險等級:畫面顯示與樣式調整這類程式碼,AI 生成後可以直接用;一般功能邏輯,生成後要逐項驗證前面談過的判準;涉及金流、權限、個資存取的核心邏輯,最好只讓 AI 提供思路,實際的程式碼由熟悉這塊的人親自寫、親自審。信心與實際安全表現之間的落差確實存在,但這不代表要放棄用 AI 寫程式,而是把驗證的力氣,放在真正牽涉風險的地方。