官方發布新一代影像模型的公告,幾乎都在講「更清晰、更快、更準」,這幾個形容詞每次改版都會重複出現一次,光看文字很難判斷這次差異在哪裡。OpenAI 在 2026 年 9 月 8 日推出的 GPT Image 2.5(對話框裡顯示為 ChatGPT 圖像 2.5)也不例外,官方主打細節更清晰、生成更快、編輯更準,但這種形容詞放在任何一次改版公告都說得通,真正有用的判斷方式只有一個,就是拿它去做幾個刁鑽到會露餡的測試。這代模型取代了 2025 年推出的 ChatGPT 圖像 2.0,官方公布的數字顯示,每週透過 ChatGPT 圖像與 API 生成的圖片已經超過 30 億張,使用規模夠大,這一代模型進步了多少,才值得認真談。
新在哪裡值得先弄清楚,再拿七個現場出的題目逐一驗證更準;文章裡放的每一張圖,都是這次實測當場生成的結果,不是官方公布的範例圖。
一、GPT Image 2.5 是什麼?跟上一代的差異
GPT Image 2.5 是 OpenAI 目前主力的影像模型,直接取代 2025 年推出的 ChatGPT 圖像 2.0,不管是在 ChatGPT 對話框裡生圖,還是透過 API 串接,用的都是同一套底層模型。跟上一代相比,官方公告點出四項加強:光線與質感更自然,參考照片裡的主體與特徵更能保留,多輪編輯的一致性更穩定,加上生成延遲最多降低 50%。
這四項加強不是各自獨立,背後其實牽動同一件事,那就是模型聽不聽得懂指令,又守不守得住不該變動的地方。光線質感影響的是單張圖好不好看,參考照片與多輪編輯一致性影響的是能不能連續修改而不跑掉,延遲降低則直接決定它能不能放進真正要出圖的工作流程,而不只是拿來玩玩。
ChatGPT 介面裡的新功能
介面端這次新增幾個實用的小工具。在對話框輸入「@Sketch」可以把手繪草圖轉成完整圖像,對還不擅長打字描述畫面的人很方便;內建的範本功能整理了「海報」「商品」這類熱門格式,不用從零想版型。生成完一張圖之後,還可以直接在圖片上留言,標註要局部修改的地方,不用重新打一長串文字指令;完成的圖片也能連同提示詞一起分享出去,對方直接拿去套用,不用自己猜關鍵字怎麼下。
這幾項功能不限特定方案,免費與付費的 ChatGPT 使用者,以及 ChatGPT 工作、Codex 的使用者,不管是桌面版、行動版還是網頁版都能用到。安全機制延續前一代的做法,生成的圖片會帶 C2PA 中繼資料與隱形浮水印,用來標示這是 AI 生成的內容,方便平台或第三方工具辨識。
給開發者,API 的 Flare 與 Sunburst
對要透過 API 串接的開發者,GPT Image 2.5 分成兩款模型,差別在於要快還是要準。
| 模型 | 定位 |
|---|---|
| GPT-Image-2.5 Flare | 預設選擇,品質高於前代 GPT-Image-2,延遲降低 50%,適合一般日常出圖、大量生成、快速做原型 |
| GPT-Image-2.5 Sunburst | 生成時間較長,換取多次編輯後更高的精準度,適合可以直接投入製作的活動素材、精緻產品圖 |
規格上,這代解析度最高來到約 4K,單邊最大 3840 像素,總像素落在約 65 萬到 830 萬之間;長寬比支援 1:3 到 3:1,常見尺寸則是 1024×1024、1536×1024、1024×1536。畫質分成 low、medium、high、xhigh、max、auto 六個等級,其中 xhigh 與 max 是這一代才新增的選項;輸出格式可以選 PNG、JPEG 或 WebP。
定價方面,根據科技媒體整理的資訊,兩款模型價格相同:影像輸入每百萬 token 8 美元、影像輸出每百萬 token 30 美元、文字輸入每百萬 token 5 美元,官方文件本身並沒有逐一列出這幾個數字。參考圖片的張數上限也是社群整理出來的資訊:生成端點最多可以放 10 張參考圖,編輯端點則最多 16 張。
在 ChatGPT 介面裡不用自己選模型,系統會自動套用最新的 2.5;上面這些參數是給用 API 串接的開發者調整用的,一般使用者感覺不到差別。
二、實測方法
七個測試全部在 ChatGPT 網頁版現場生成,每一題各開一個新對話,避免同一個對話累積的上下文影響結果;只有測試編輯能力那一題需要在同一個對話裡連續生成多輪,才能驗證「改一處、其餘不動」做不做得到。
評分的重點不是「圖畫得漂不漂亮」,而是它有沒有照指令做到,文字有沒有寫對、數量顏色位置對不對、要求不要動的地方有沒有真的守住。這幾個維度比美感更能反映一個影像模型在實務上好不好用,尤其對要拿去做提案、素材、社群圖的人來說,照做比好看更關鍵。
測試 1,中文海報文字排版
這題丟給它的指令是做一張直式活動海報,台灣夜市插畫風,暖橘配深藍;標題寫「龐果設計講座」,副標「AI 生圖實戰工作坊」,底部小字標明「2026 年 10 月 18 日 台北 免費入場」。中文排版一直是 AI 生圖公認的痛點,這題算是先丟一個硬仗開場。
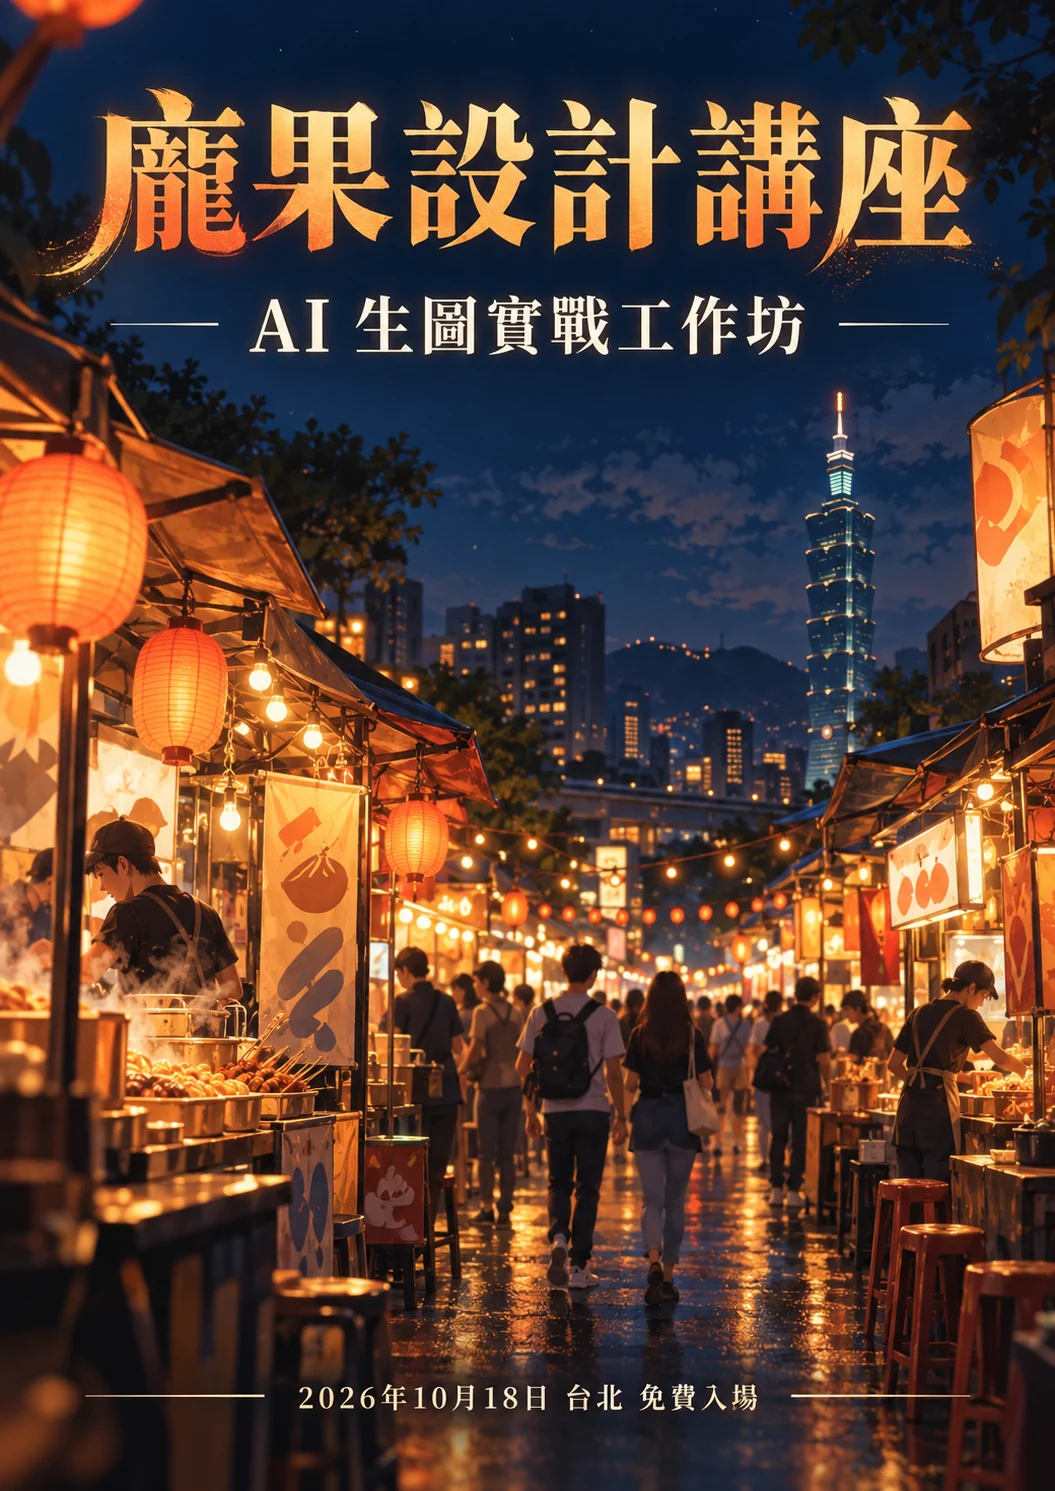
結果讓人意外:標題、副標、底部日期地點三處的中文與數字全部逐字正確,連金色書法風格的標題字都沒有糊掉。指令裡只寫了「台灣夜市」,沒有指定地標,它自己補上台北 101 的天際線當背景,情境理解算是到位;攤位的裝飾招牌大多用圖案呈現,沒有出現亂碼假字,這正是舊一代模型最常見、也最容易露餡的破綻。整體來看,這張圖是很有說服力的開場。
測試 2,寫實產品情境照
這題要求是一張寫實產品情境照,燙金 logo 的白色名片斜放在深色胡桃木桌面上,旁邊擺一杯冒著熱氣的拿鐵,光源設定成左側自然晨光,淺景深,整體質感要拍得高級。
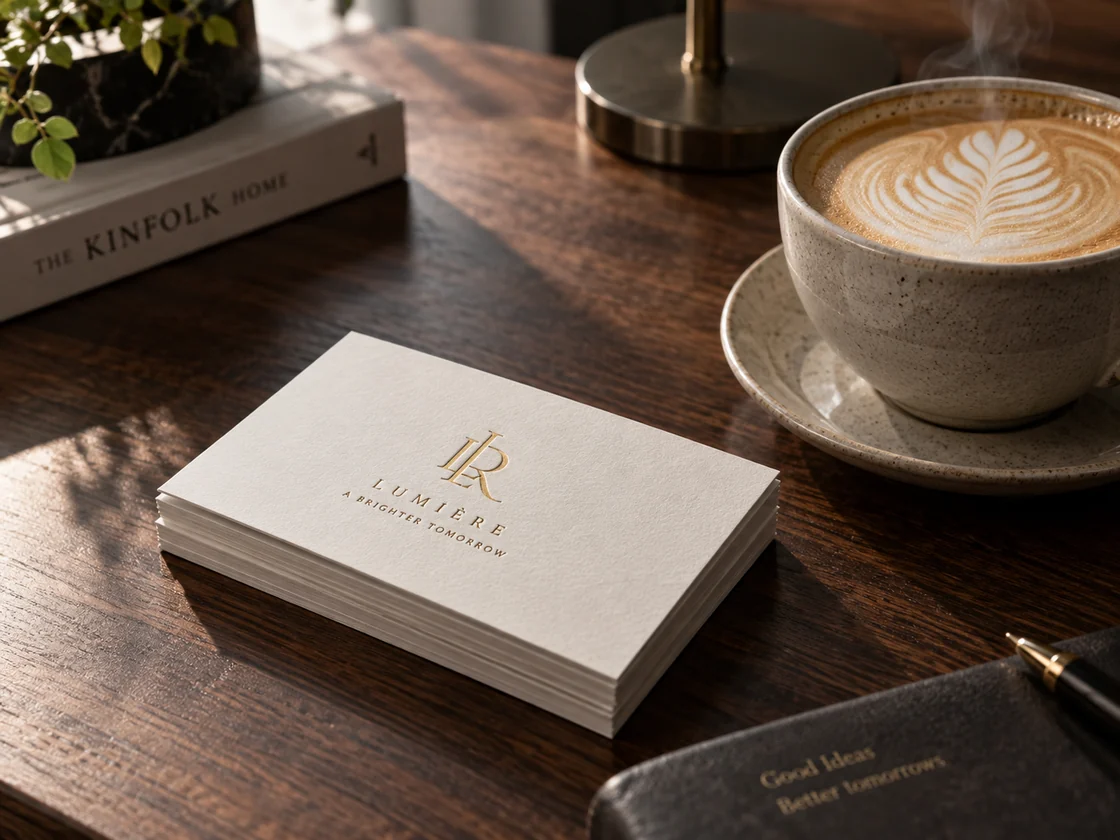
出來的結果幾乎跟真實商業攝影分不出差別。名片上燙金 logo「LUMIÈRE」連重音字母 È 都清楚保留;拿鐵的拉花與蒸氣、胡桃木的木紋、窗光灑下的光斑、陶杯表面的顆粒質感、名片紙張的壓紋全部到位,景深散景也做得自然。它甚至自己在畫面裡擺了一本真實存在的攝影書《The Kinfolk Home》當道具,細節考慮得比預期多。官方公告主打的「光線更自然、質感更豐富」,在這種寫實照片題材上確實看得出差異。
測試 3,複雜指令遵循
這題測的是多重約束能不能同時守住,純白背景平拍,正中央放一台闔上的銀色筆電,左上角橫放三支馬克筆,顏色由左到右依序是紅、黃、藍,右下角疊一疊黃色便利貼,正下方放一副黑框圓形眼鏡,所有物件之間不能重疊。
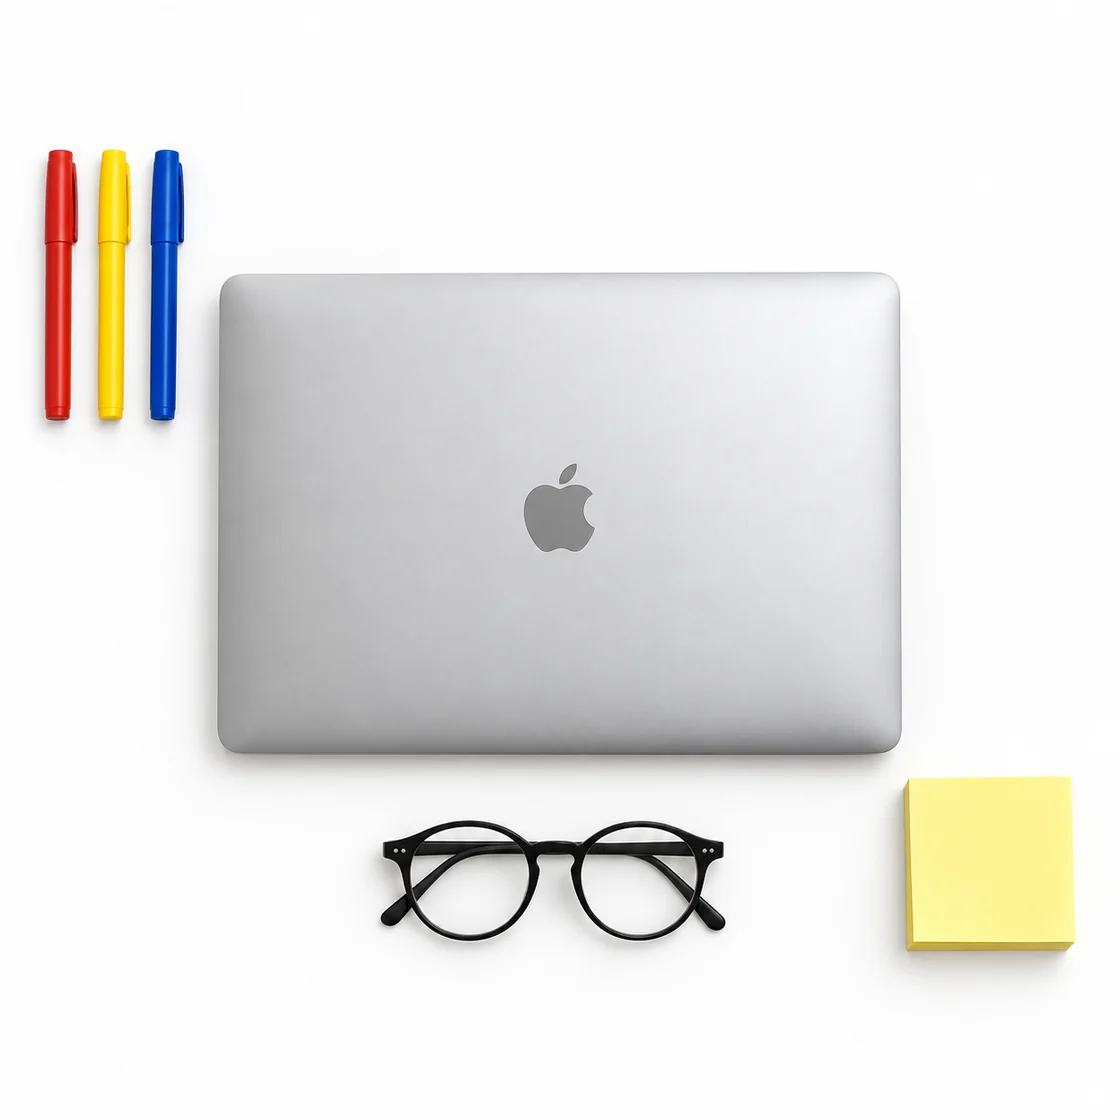
每一個條件它都命中,三支筆的數量正確,顏色順序紅到黃到藍,由左到右一字不差;筆電置中、便利貼在右下、圓框眼鏡在正下方、背景維持純白、物件之間完全沒有重疊。過去的 AI 生圖模型最容易在「數量加顏色加方位」這種多重約束疊在一起時出錯,不是多畫一支筆就是顏色排錯順序,這張圖交出來的結果算是乾淨俐落。
測試 4,精準編輯只改一處
這題測的是編輯能力,而不是從零生成。先請它生成一張基底圖,一個戴眼鏡、綁馬尾、穿橘色上衣的女生捧著一杯珍珠奶茶;接著在同一個對話裡要求「只把上衣改成綠色,臉、眼鏡、髮型、珍奶、雙手姿勢、背景全部不要變」。
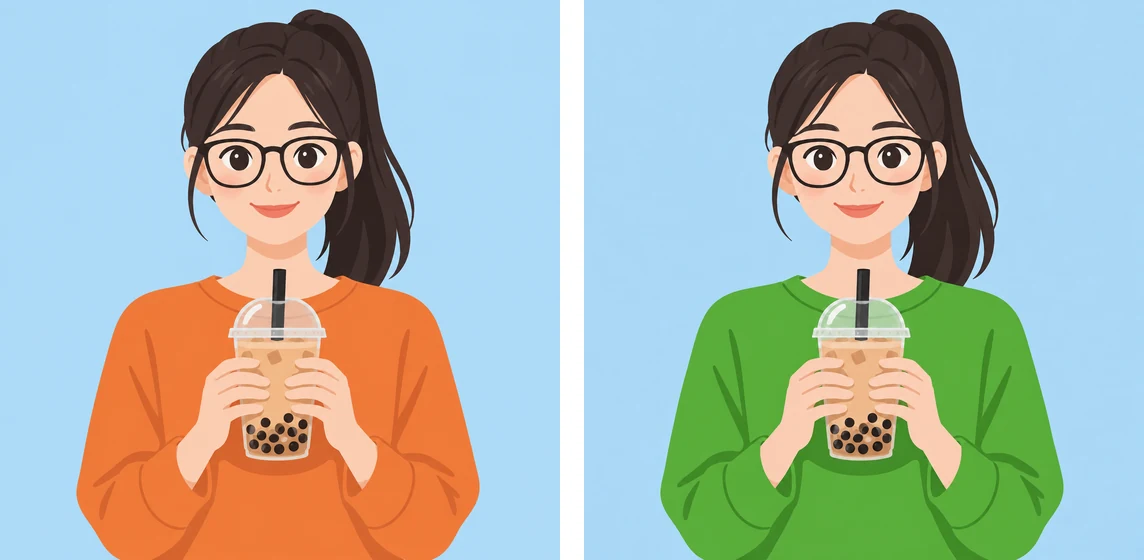
把前後兩張圖並排比對,結果稱得上教科書等級:除了上衣顏色變綠,五官、黑框眼鏡、馬尾、珍奶杯(連冰塊、珍珠、吸管的位置都沒動)、握著杯子的手勢、淺藍背景全部維持一致。「改一處、其餘不動」正是實務上最常見的需求,也是舊模型最難做到的地方。以前只要改一小處,常常整張重畫,連臉都會跟著變掉;這題的表現,是七題裡實務價值感覺最直接的一個。
測試 5,資料型資訊圖表
這題找它做一張資料型的長條圖,呈現五個社群平台的使用率,刻意指定一組假數據來測試它照不照抄指令:LINE 90%、YouTube 88%、Facebook 82%、Instagram 65%、Threads 40%,並要求每根長條都要標上名稱與數字。
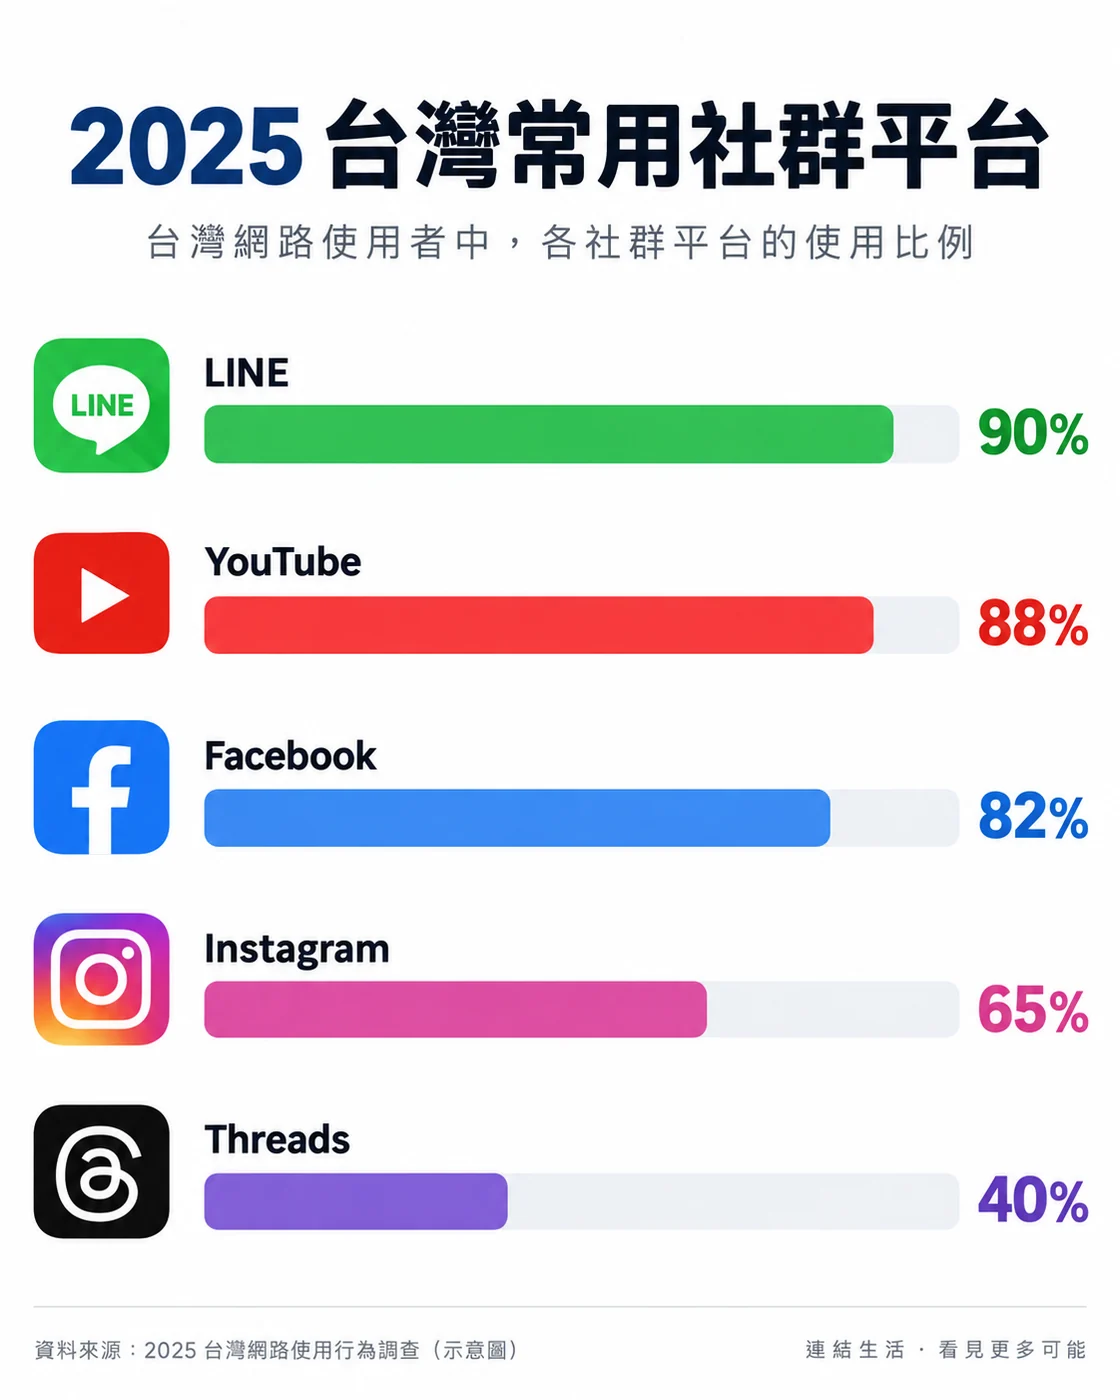
標題、副標、五個平台名稱、五個數字全部逐字正確,長條的長度也跟數值成正比;五個品牌 logo 都畫對,中文排版也乾淨清楚,這部分表現是強的。但這題也踩到一個要注意的雷,即使指令裡完全沒有要求,它自己在圖表底部補了一行文字,寫著「資料來源:2025 台灣網路使用行為調查(示意圖)」,這個調查名稱是它自己捏造出來的,雖然貼心地加註了「示意圖」三個字,但沒有仔細檢查就直接拿去用,等於掛了一個不存在的來源。這件事提醒得很清楚,用 AI 生資訊圖表,自動補上的來源、註腳一定要逐字看過再用;也要說明清楚,這張圖裡的數字是為了測試模型能力隨手指定的假值,不是真實的統計結果。
測試 6,密集中文文字的菜單壓力測試
這題要測的是密集中文字的穩定度,手寫粉筆風的咖啡菜單黑板,直式構圖,標題寫「龐果咖啡 MENU」,底下列出六個品項與價格,分別是美式咖啡 90 元、拿鐵 120 元、卡布奇諾 120 元、抹茶拿鐵 140 元、珍珠奶茶 130 元、檸檬氣泡飲 110 元。
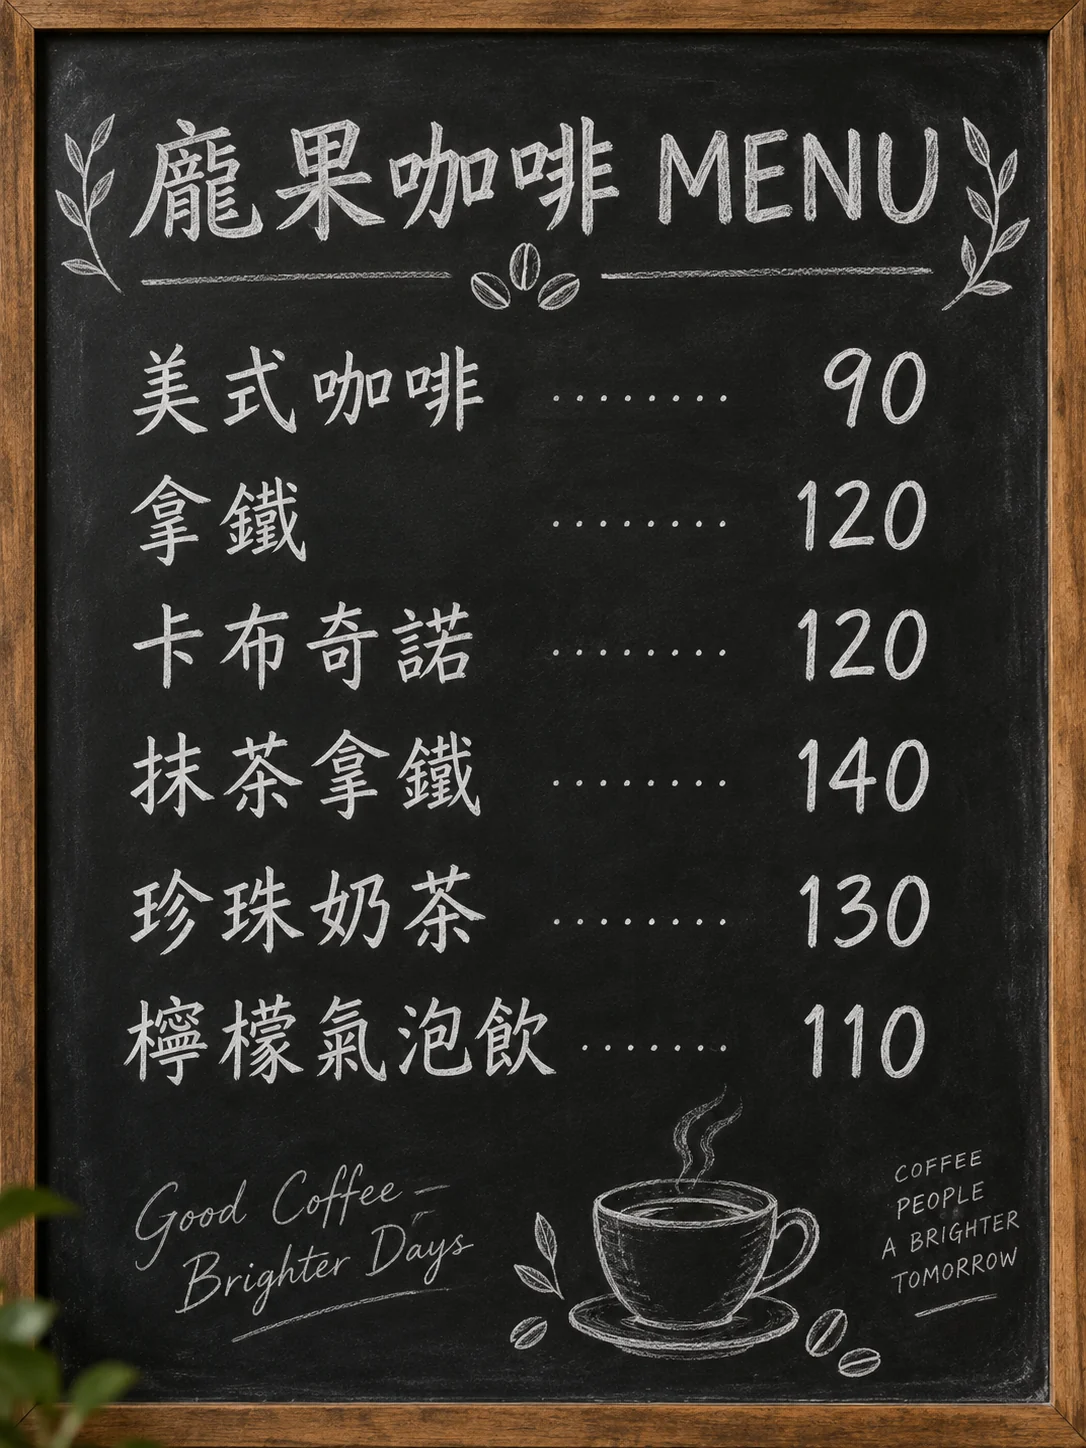
放大逐字核對後,標題加六個品項、六個價格全部正確,沒有出現任何亂碼;連「卡布奇諾」「檸檬氣泡飲」「抹茶拿鐵」這些筆畫比較多的字都寫對了,而且手寫筆觸本身就比印刷體更難生成,二十幾個中文字沒有一個崩掉。這代模型在中文文字渲染上的穩定度,確實跨過了一個明顯的門檻。
測試 7,透明背景去背
這題要它做一張扁平風的柴犬吉祥物貼圖:戴耳機、比讚手勢,背景要求透明,也就是 PNG 去背,而且周圍不能留下任何背景色塊或方框。
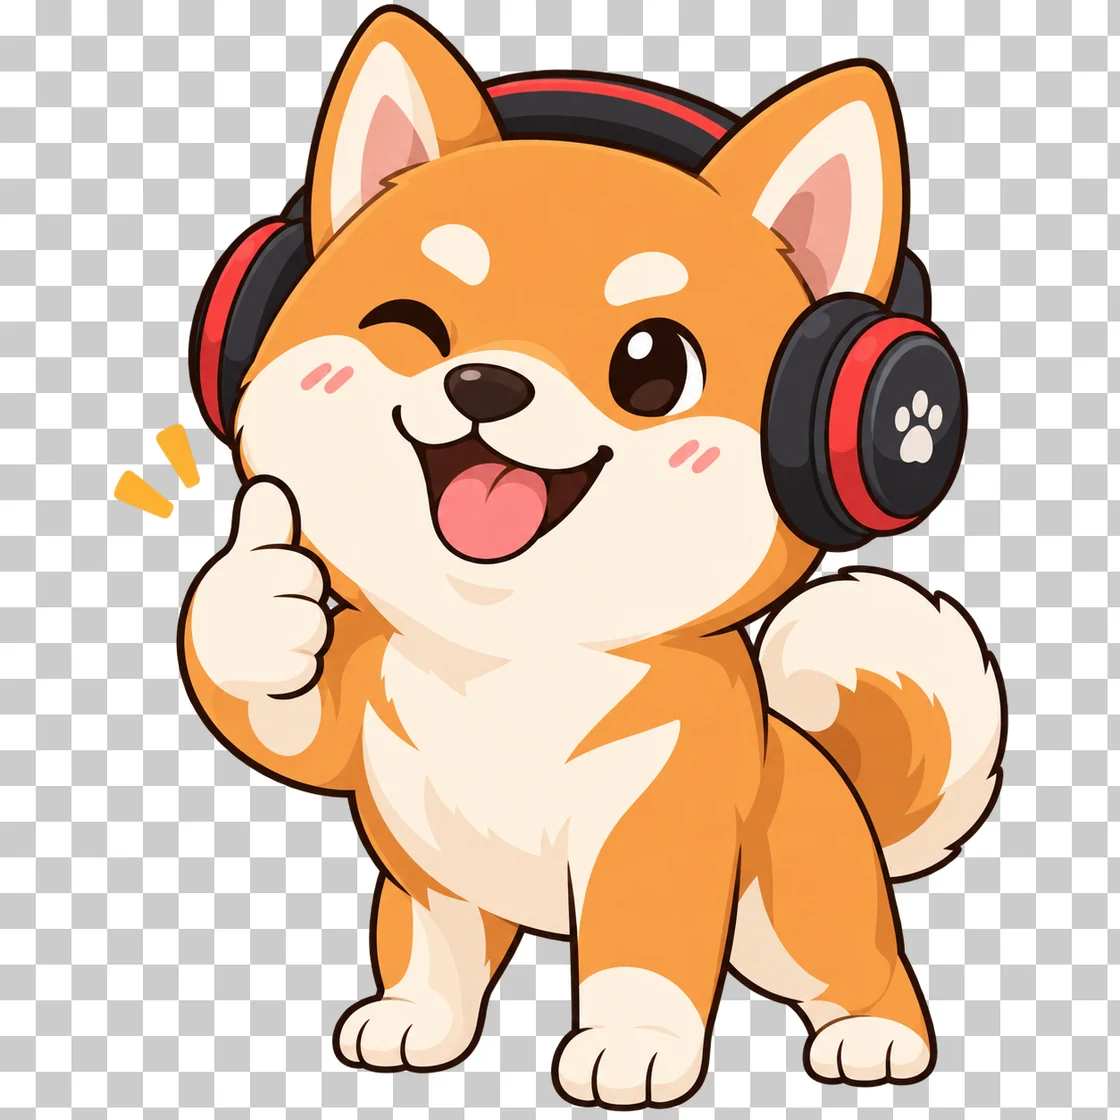
輸出的 PNG 檔案是真正的 RGBA 透明檔,不是白底貼上去的假去背。實際用程式檢查像素,角色以外、四個角落的區域裡,大約 46% 的像素 alpha 值都是 0,也就是完全透明。對需要做貼圖、logo 或去背素材的人來說,這個功能很實用,可以省掉再開一次修圖軟體去背的時間。
三、優點與限制總結
把七個測試放在一起看,GPT Image 2.5 明顯變強的地方集中在幾件事上。
- 中文與數字的文字渲染:海報、資訊圖表、密集手寫菜單三個題型全部過關,是相對前一代最有感的一次躍進。
- 指令遵循的命中率高:數量、顏色、方位這類硬約束疊在一起時,依然守得住。
- 精準局部編輯:只改指定的地方,其餘完全不動,前後圖高度一致,是實務上價值最高的能力。
- 照片級質感與真正的透明去背:兩者都做到位,拿去做情境照或素材圖都堪用。
不過也有幾個地方要留意。
- 會自動「腦補」沒被要求的內容:最典型的例子就是資訊圖表那題自己捏造出來的資料來源,凡是圖裡出現數據、來源、機構名稱,務必逐字查核過再用。
- 圖裡的文字寫對,不代表內容為真:測試 5、測試 6 用的數字都是為了測試能力隨手指定的假值,模型能把字排得整整齊齊,不代表那些內容經過查證。
- 圖片帶有隱形浮水印與 C2PA 標記:這是 OpenAI 的溯源機制,圖片可以被辨識為 AI 生成,商用之前要留意各平台對 AI 內容標示的規範。
- 細節仍需要人眼複查:手部、極小的字、複雜的透視偶爾還是會出現瑕疵,不是每次都完美。
四、給行銷與內容工作者的實務建議
對每天要出圖、手邊不一定有設計師的行銷與內容工作者,GPT Image 2.5 拿來做提案初稿、情境示意、社群配圖、貼圖素材已經很夠用,尤其是需要中文海報,或是要局部改字、改色的情境,這代模型的表現特別明顯。
想改一小處的時候,善用「精準編輯」會比整張重新生成省時間得多,只要直接說「只改哪裡,其他都不要動」,模型就能守住已經滿意的部分,不用擔心改完整張圖的氛圍全變。
要放數據、來源、法遵資訊的圖,一律要人工複查一遍;模型很會把字排得像回事,但內容是不是真的,還是得靠人把關。需要透明素材的時候,直接在指令裡要求「透明背景 PNG 去背」就好,可以省掉再開一次修圖軟體的工夫。
如果要做的是需要精修、能控制細節的商用大圖,可以考慮走 API 的 Sunburst;日常需要快速出圖,用介面版當下的 Flare 品質已經夠用,不用每次都糾結該選哪一款。
這一代 GPT Image 2.5 真正站得住腳的進步,不是畫得更漂亮,而是更聽得懂指令,也更守得住指令:中文字寫得對、要改哪裡就真的只改哪裡、要透明就是真的透明。對每天要出圖的行銷與內容工作者來說,這幾件事省下來的時間,比畫面好不好看更實際。
唯一要一直提醒自己的是,它把字寫對,不代表那句話是真的。把 AI 當成一支反應極快的美術手可以,但最後的事實核對與品質把關,還是得留在人這一邊。