想像你進了一間只供應套餐的餐廳,菜色、份量、上菜順序早就排定,你能做的只有照順序吃完。WordPress 的每個頁面背後其實都在跑一份類似的套餐:首頁列出最新文章、分類頁列出該分類底下的文章,順序與筆數都照系統的預設規則排好,這份套餐在 WordPress 裡叫做「主查詢」。可是想在頁面裡插一段不一樣的菜色,像是單篇文章下方多秀三篇同分類的文章,或做一個能篩選、排序的作品集列表,主查詢這份套餐就滿足不了你了。
這時候要用的是 WP_Query,等於自己跟廚房點菜:要哪種文章類型、抓幾篇、依什麼順序上桌,一項一項自己決定,不必被套餐綁住。它是 WordPress 核心內建的 PHP 類別,負責把「要顯示哪些文章」的條件轉換成資料庫查詢,再把查出來的結果交給樣板迴圈輸出成畫面。不少人第一次寫自訂查詢只顧著抄範例,沒搞懂它跟主查詢是兩份互不相干的查詢,也常常忘記查完要收拾善後,結果頁面上其他地方顯示的文章資料整個錯位。
先搞懂它跟主查詢的分工在哪,再把常用的查詢參數一項項兜起來。
WP_Query 是什麼?
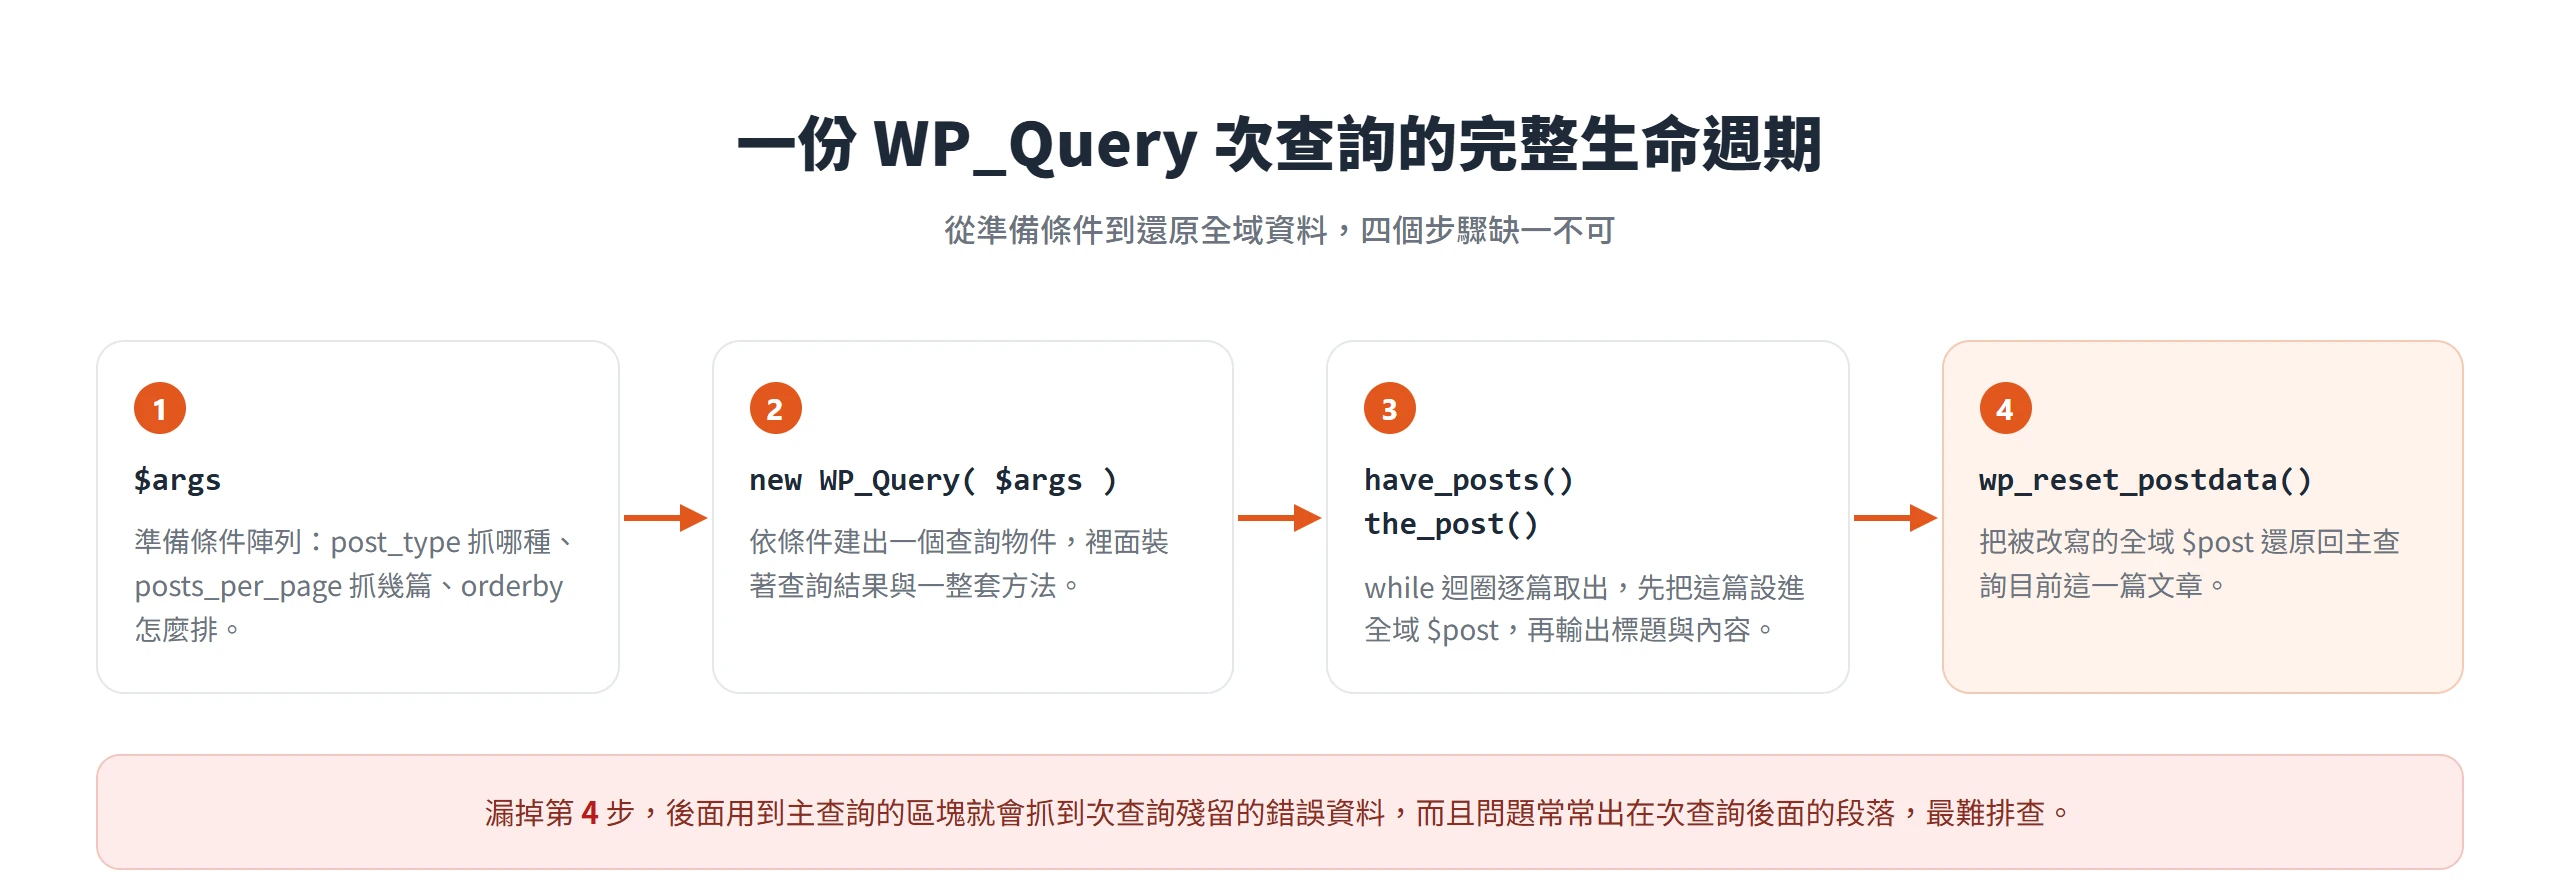
WP_Query 是一個類別(class),不是函式(function)。每次要建立一份查詢,語法是 new WP_Query( $args ),先準備一組描述查詢條件的陣列 $args,交給 WP_Query 建構出一個查詢物件,這個物件裡才裝著查詢結果與一整套可以呼叫的方法。跟函式一次呼叫就回傳結果不同,類別建出來的物件會一路帶著查詢狀態(目前跑到第幾篇、總共幾頁),後面判斷有沒有下一篇、要不要換頁,都是靠呼叫這個物件身上的方法完成的。
每個 WordPress 頁面背後都已經有一個系統自動建立好的 WP_Query,叫做「主查詢」:首頁的主查詢抓最新文章、分類彙整頁的主查詢抓該分類的文章、單篇頁的主查詢就是那一篇文章本身。開發者自己寫的 new WP_Query() 是另外再建立一個獨立的「次查詢」,兩者是各自獨立的物件,互不干擾。次查詢跑迴圈時會暫時把全域的文章資料改成自己的內容,跑完沒有還原,後面用到主查詢資料的地方就會抓錯文章,這正是 wp_reset_postdata() 存在的原因。
另外常會看到 get_posts() 這個函式,它其實是 WP_Query 的簡化包裝,背後一樣是建立一個 WP_Query 物件去查資料,只是回傳的直接是文章陣列,而且預設不會覆寫全域的 $post、也不影響分頁判斷。想抓一小批資料自己處理(不需要跑進 WordPress 迴圈、不需要顯示分頁)的場合,get_posts() 比較省事;要走完整迴圈、顯示分頁,或需要 have_posts()/the_post() 這套機制,就得直接用 new WP_Query()。
決定查詢範圍的三個核心參數,文章類型、數量與排序
每次寫 new WP_Query(),幾乎都會用到同一組基本參數,決定這次查詢要抓什麼、抓幾篇、怎麼排。
第一個要決定的是文章類型,post_type 沒特別指定的話,預設只抓標準文章(post),不會抓到頁面或任何自訂文章類型(例外是用 tax_query 篩自訂分類法時,沒指定 post_type 會改成抓所有掛了該分類法的文章類型)。如果要抓的是商品、案例作品這類自訂文章類型,就要明寫它的 slug,例如 'post_type' => 'product';要同時抓好幾種類型,把 slug 包成陣列傳進去即可,例如 'post_type' => array( 'post', 'product' )。
第二個是要抓幾篇,posts_per_page 是一個整數,沒設定的話會沿用後台「閱讀設定」裡「每頁顯示文章數」那個全站共用的值。這個參數還可以設成 -1 代表不限筆數,但這是個效能地雷,先記住有這個選項就好,不建議隨手就用。
第三件事是排序,靠 orderby 和 order 兩個參數搭配。orderby 決定依哪個欄位排,常用值有 date(發佈日期)、title(標題)、menu_order(手動排序的順序值)、rand(隨機)、meta_value 與 meta_value_num(依自訂欄位的值排序,前者當文字比對、後者當數字比對);order 決定方向,ASC 由小到大、DESC 由大到小,沒指定時預設是 DESC。三個參數兜起來,一段抓自訂文章類型 product、每頁 9 篇、依標題排序的查詢長這樣:
$args = array(
    'post_type'      => 'product',
    'posts_per_page' => 9,
    'orderby'        => 'title',
    'order'          => 'ASC',
);
$query = new WP_Query( $args );Code language: PHP (php)
這組 $args 就是疊加其他條件的基礎,篩選自訂欄位用 meta_query、篩選分類用 tax_query,都是在這組陣列裡再加一個 key。
用 meta_query 篩選自訂欄位裡的資料
想篩選的條件如果是儲存在自訂欄位裡的資料,像商品的庫存數量、活動的舉辦日期,post_type 和 orderby 這組基本參數就不夠用了,得加上 meta_query。
meta_query 是一個陣列,裡面每個子陣列代表一個篩選條件,各自帶四個 key:key 是自訂欄位的名稱、value 是要比對的值、compare 是比較運算子(預設 =,常用的還有 !=、>、>=、<、<=、LIKE、NOT LIKE、IN、NOT IN、BETWEEN、NOT BETWEEN、EXISTS、NOT EXISTS,另外也支援 REGEXP 這類正規表示式比對)、type 是資料型別(常見的有 NUMERIC、CHAR、DATE)。type 這個 key 特別容易被漏掉,自訂欄位在資料庫裡預設是以文字儲存,如果要做數字比大小(像庫存大於 0),沒有標明 type => 'NUMERIC',WordPress 會把它當成字串逐字元比對,結果數字排序或大小判斷就會出錯。如果同時要滿足兩個以上的條件,子陣列外面還要加一個 relation 指定用 AND 或 OR 串起來。
篩選「庫存數量大於 0」的商品,寫法是這樣:
$args = array(
    'post_type'  => 'product',
    'meta_query' => array(
        array(
            'key'     => '_stock',
            'value'   => 0,
            'compare' => '>',
            'type'    => 'NUMERIC',
        ),
    ),
);
$query = new WP_Query( $args );Code language: PHP (php)
這個範例只有一個條件,所以不需要 relation;要再加一個「上架中」的狀態篩選,就在 meta_query 陣列裡多放一個子陣列,並在最外層補上 'relation' => 'AND'。
用 tax_query 篩選分類與標籤
分類法(內建的分類、標籤,或自訂分類法)的篩選邏輯跟 meta_query 很像,但比對的目標不一樣。每個子陣列帶 taxonomy(分類法的 slug,例如 category、post_tag,或自訂分類法的 slug)、field(用什麼欄位比對,預設是 term_id,也可以指定 slug、name、term_taxonomy_id)、terms(要比對的詞,可以是單一值或陣列)、operator(比對方式,預設 IN,也支援 NOT IN、AND、EXISTS、NOT EXISTS)。跟 meta_query 一樣,多個分類法條件要同時滿足時,外層加 relation 指定 AND 或 OR。
抓「案例分享」分類底下、同時標了「品牌設計」標籤的文章,寫法是:
$args = array(
    'tax_query' => array(
        'relation' => 'AND',
        array(
            'taxonomy' => 'category',
            'field'    => 'slug',
            'terms'    => 'case-study',
        ),
        array(
            'taxonomy' => 'post_tag',
            'field'    => 'slug',
            'terms'    => 'brand-design',
        ),
    ),
);
$query = new WP_Query( $args );Code language: PHP (php)
如果只是要篩單一個分類或標籤,不需要動用完整的 tax_query,WordPress 提供更簡單的簡寫參數:cat 直接傳分類 ID、category_name 傳分類 slug、tag 傳標籤 slug。這幾個簡寫參數在只篩一種條件時夠用了,真正需要 tax_query 完整結構的場合,是像上面這種要跨分類法組合條件(同時卡分類又卡標籤)的時候。
迴圈裡逐篇取出並顯示文章內容
$args 組好、new WP_Query() 建出查詢物件之後,接下來要把查到的每一篇文章實際顯示出來,靠的是一套固定的迴圈骨架。
have_posts() 判斷迴圈裡還有沒有下一篇文章可以取,搭配 while 使用;每跑一輪先呼叫 the_post(),把目前這一篇文章的資料設進全域的 $post,這一步很關鍵,因為 the_title()、the_excerpt()、get_the_permalink() 這些範本函式,都是讀取全域 $post 的資料在運作,沒有先呼叫 the_post(),這些函式會抓不到正確的文章、甚至整段報錯。查無結果的情況也要處理,不能讓畫面留白,通常用 else 分支顯示一句「目前查無符合的文章」之類的提示。
完整骨架長這樣:
$query = new WP_Query( $args );

if ( $query->have_posts() ) {
    while ( $query->have_posts() ) {
        $query->the_post();
        the_title( '<h3>', '</h3>' );
        the_excerpt();
    }
} else {
    echo '目前查無符合條件的文章。';
}Code language: PHP (php)
這裡呼叫的是 $query->have_posts() 而不是全域函式 have_posts(),用 new WP_Query() 建立的次查詢,要透過查詢物件本身呼叫這些方法,才不會不小心動到主查詢的狀態。
查詢跑完後,用 wp_reset_postdata() 還原全域文章物件
前一節提到 the_post() 會把全域 $post 改成次查詢目前這一篇文章的資料,這個動作其實動到的不只 $post,連 $id、$authordata 這類跟著文章走的全域變數也會一併被改寫成次查詢的內容。次查詢的迴圈跑完之後,如果沒有把這些全域變數還原,它們就會停留在次查詢的最後一篇文章上;這時候如果頁面上其他地方還接了主查詢的迴圈,或又用到 the_title() 這類範本函式,抓到的就會是次查詢殘留下來的錯誤資料,而不是原本該顯示的內容。
這個坑最麻煩的地方在於後果不會馬上跳出來,次查詢那一段畫面通常顯示得好好的,問題是出在它後面的區塊,排查起來容易找錯方向。解法是查完立刻呼叫 wp_reset_postdata(),把全域 $post 還原回主查詢目前這一篇文章。一個常見的插入點是單篇文章頁下方接一段「同分類最新 3 篇」的次查詢:
$related = new WP_Query( array(
    'post_type'      => 'post',
    'posts_per_page' => 3,
    'category__in'   => wp_get_post_categories( get_the_ID() ),
    'post__not_in'   => array( get_the_ID() ),
) );

if ( $related->have_posts() ) {
    while ( $related->have_posts() ) {
        $related->the_post();
        the_title( '<h4>', '</h4>' );
    }
    wp_reset_postdata();
}Code language: PHP (php)
跑完這段次查詢立刻呼叫 wp_reset_postdata(),再往下的內容才能正常抓回這篇文章自己的資料,不會被剛才那三篇相關文章污染。另外要注意的是還有一個名字很像的 wp_reset_query(),那是搭配 query_posts()(已經不建議使用的舊寫法)用的還原函式,跟 wp_reset_postdata() 是兩個不同的東西,別把兩者搞混,也別再用 query_posts() 這種會直接改寫主查詢的舊寫法。
分頁要接對頁碼參數,才能顯示正確的換頁連結
自訂的 WP_Query 如果要支援分頁,除了前面提到的 posts_per_page,一定還要再傳一個 paged 參數,告訴查詢現在該抓第幾頁的資料。這個頁碼不能自己從 1 寫死,要用 get_query_var( 'paged' ) 去讀目前網址上實際的頁碼,在第一頁時它會回傳 0,所以要自己補成 1。
這裡有一個很多人會找不到方向的陷阱,如果這個次查詢放在設為「靜態首頁」的頁面模板裡,讀頁碼要改用 get_query_var( 'page' ),不是 paged。原因是 WordPress 對「靜態頁面本身往下翻的子頁碼」用的查詢變數就是 page,跟一般彙整頁用的 paged 是分開的兩組變數,兩者搞混,結果就是分頁連結點了頁面卻沒有換。
換頁連結不建議自己手刻上一頁、下一頁的超連結,直接用官方的 paginate_links() 函式,帶入 total => $query->max_num_pages 就能產生完整的頁碼列表:
$paged = get_query_var( 'paged' ) ? get_query_var( 'paged' ) : 1;

$args = array(
    'post_type'      => 'post',
    'posts_per_page' => 10,
    'paged'          => $paged,
);
$query = new WP_Query( $args );

echo paginate_links( array(
    'total' => $query->max_num_pages,
) );Code language: PHP (php)
max_num_pages 是 WP_Query 執行完之後自動算出來的總頁數,直接傳給 paginate_links() 用,比自己算總筆數除以每頁筆數省事,也比較不容易算錯。
打造一份支援排序、篩選與分頁的自訂文章列表
前面幾節的參數多半是各自獨立示範,實際情境常常是好幾個一起用,比如一個作品集或案例列表頁,訪客可以用下拉選單切換排序方式、用篩選表單挑分類,同時整個列表還要維持正常分頁。這種頁面把 tax_query、orderby/order、paged 全部兜在一起,篩選與排序的條件還要透過網址查詢字串($_GET)在使用者的選擇和查詢參數之間傳遞,而且一定要做安全處理,不能把使用者送進來的值原封不動塞進查詢陣列。
會這樣要求有兩個理由。先講安全,$_GET 裡的值來自使用者的瀏覽器,理論上什麼字串都可能被送進來,如果沒有經過 sanitize_text_field() 這類函式清理、也沒有拿它跟一份白名單比對,查詢條件就等於直接被訪客操控,有心人可以嘗試傳入不存在的分類或欄位名稱去試探查詢行為。再講體驗,篩選條件走網址查詢字串,代表使用者選好篩選之後,網址本身就能複製、分享、加書籤,重新整理或按上一頁也不會把篩選狀態弄丟,這是後端寫死條件做不到的好處。使用者選好的分類,得先轉換成合法的查詢條件才能送進 tax_query。
篩選表單選項轉成對應的 tax_query 條件
表單這端用 <select name="category"> 或核取方塊列出可選的分類,以 GET 方法送出,這樣選好之後網址就會帶上 ?category=某個slug。PHP 端接的時候讀 $_GET['category'],但不能直接把這個值塞進 tax_query 的 terms,先要通過一次白名單檢查,確認送進來的值真的是這個分類法底下存在的 term slug(可以用 term_exists() 或先取得所有合法 term slug 的陣列做比對),避免抓到一個不存在的分類值,結果查詢條件形同沒篩選、把全部文章都撈出來。
檢查通過後才組進查詢:
$category = isset( $_GET['category'] ) ? sanitize_text_field( $_GET['category'] ) : '';

$args = array( 'post_type' => 'post' );

if ( $category && term_exists( $category, 'category' ) ) {
    $args['tax_query'] = array(
        array(
            'taxonomy' => 'category',
            'field'    => 'slug',
            'terms'    => $category,
        ),
    );
}Code language: PHP (php)沒有選任何分類、或傳進來的值不合法時,$args 就維持沒有 tax_query,查詢自然會回到「顯示全部」的預設狀態,不會因為一個不合法的值就查不到任何文章。
排序下拉選單切換的是 orderby 和 order 兩個參數
排序的下拉選單同樣不能把使用者選的字串直接塞進 orderby,那等於允許訪客自己指定要依哪個資料庫欄位排序,有機會查詢到不該公開排序依據的欄位。正確做法是每個選項對應一組固定寫死的 orderby/order 組合,例如「最新發佈」對應 date/DESC、「標題 A-Z」對應 title/ASC,PHP 端拿一個白名單陣列去比對使用者選的值,命中了才套用那組固定組合,沒命中就套用預設值。
$sort_options = array(
    'newest' => array( 'orderby' => 'date',  'order' => 'DESC' ),
    'title'  => array( 'orderby' => 'title', 'order' => 'ASC' ),
);

$sort = isset( $_GET['sort'] ) ? sanitize_text_field( $_GET['sort'] ) : 'newest';
$sort = isset( $sort_options[ $sort ] ) ? $sort : 'newest';

$args['orderby'] = $sort_options[ $sort ]['orderby'];
$args['order']   = $sort_options[ $sort ]['order'];Code language: PHP (php)
這樣寫,使用者能選的永遠只有這份白名單裡已經定義好的幾種組合,不會有機會把任意欄位名稱送進 orderby 參數。
分頁連結串接時,要保留篩選與排序的查詢字串
paginate_links() 產生分頁連結時,會自動把目前網址上已經帶的查詢字串(像 ?category=xxx&sort=title)併進每一個分頁連結,所以篩選、排序條件走 $_GET 的話,一般換頁不會把條件弄丟。會出問題的是篩選條件不在目前網址上的情況,例如表單改用 POST 送出,這時分頁連結就不會帶上篩選字串,使用者好不容易選好篩選條件,一點下一頁,篩選就被重置回全部文章。
遇到這種情況,或想把要帶的參數明確寫出來,可以用 paginate_links() 的 add_args 參數,可以傳入一個關聯陣列,讓產生出來的每一個分頁連結都額外附加上指定的查詢字串:
echo paginate_links( array(
    'total'    => $query->max_num_pages,
    'add_args' => array(
        'category' => $category,
        'sort'     => $sort,
    ),
) );Code language: PHP (php)
把目前使用者實際選的 $category、$sort 傳進 add_args,產生出來的第 2、3、4 頁連結網址就會自動帶上這兩個查詢字串,篩選與排序的狀態就能在整個分頁瀏覽過程裡維持一致。
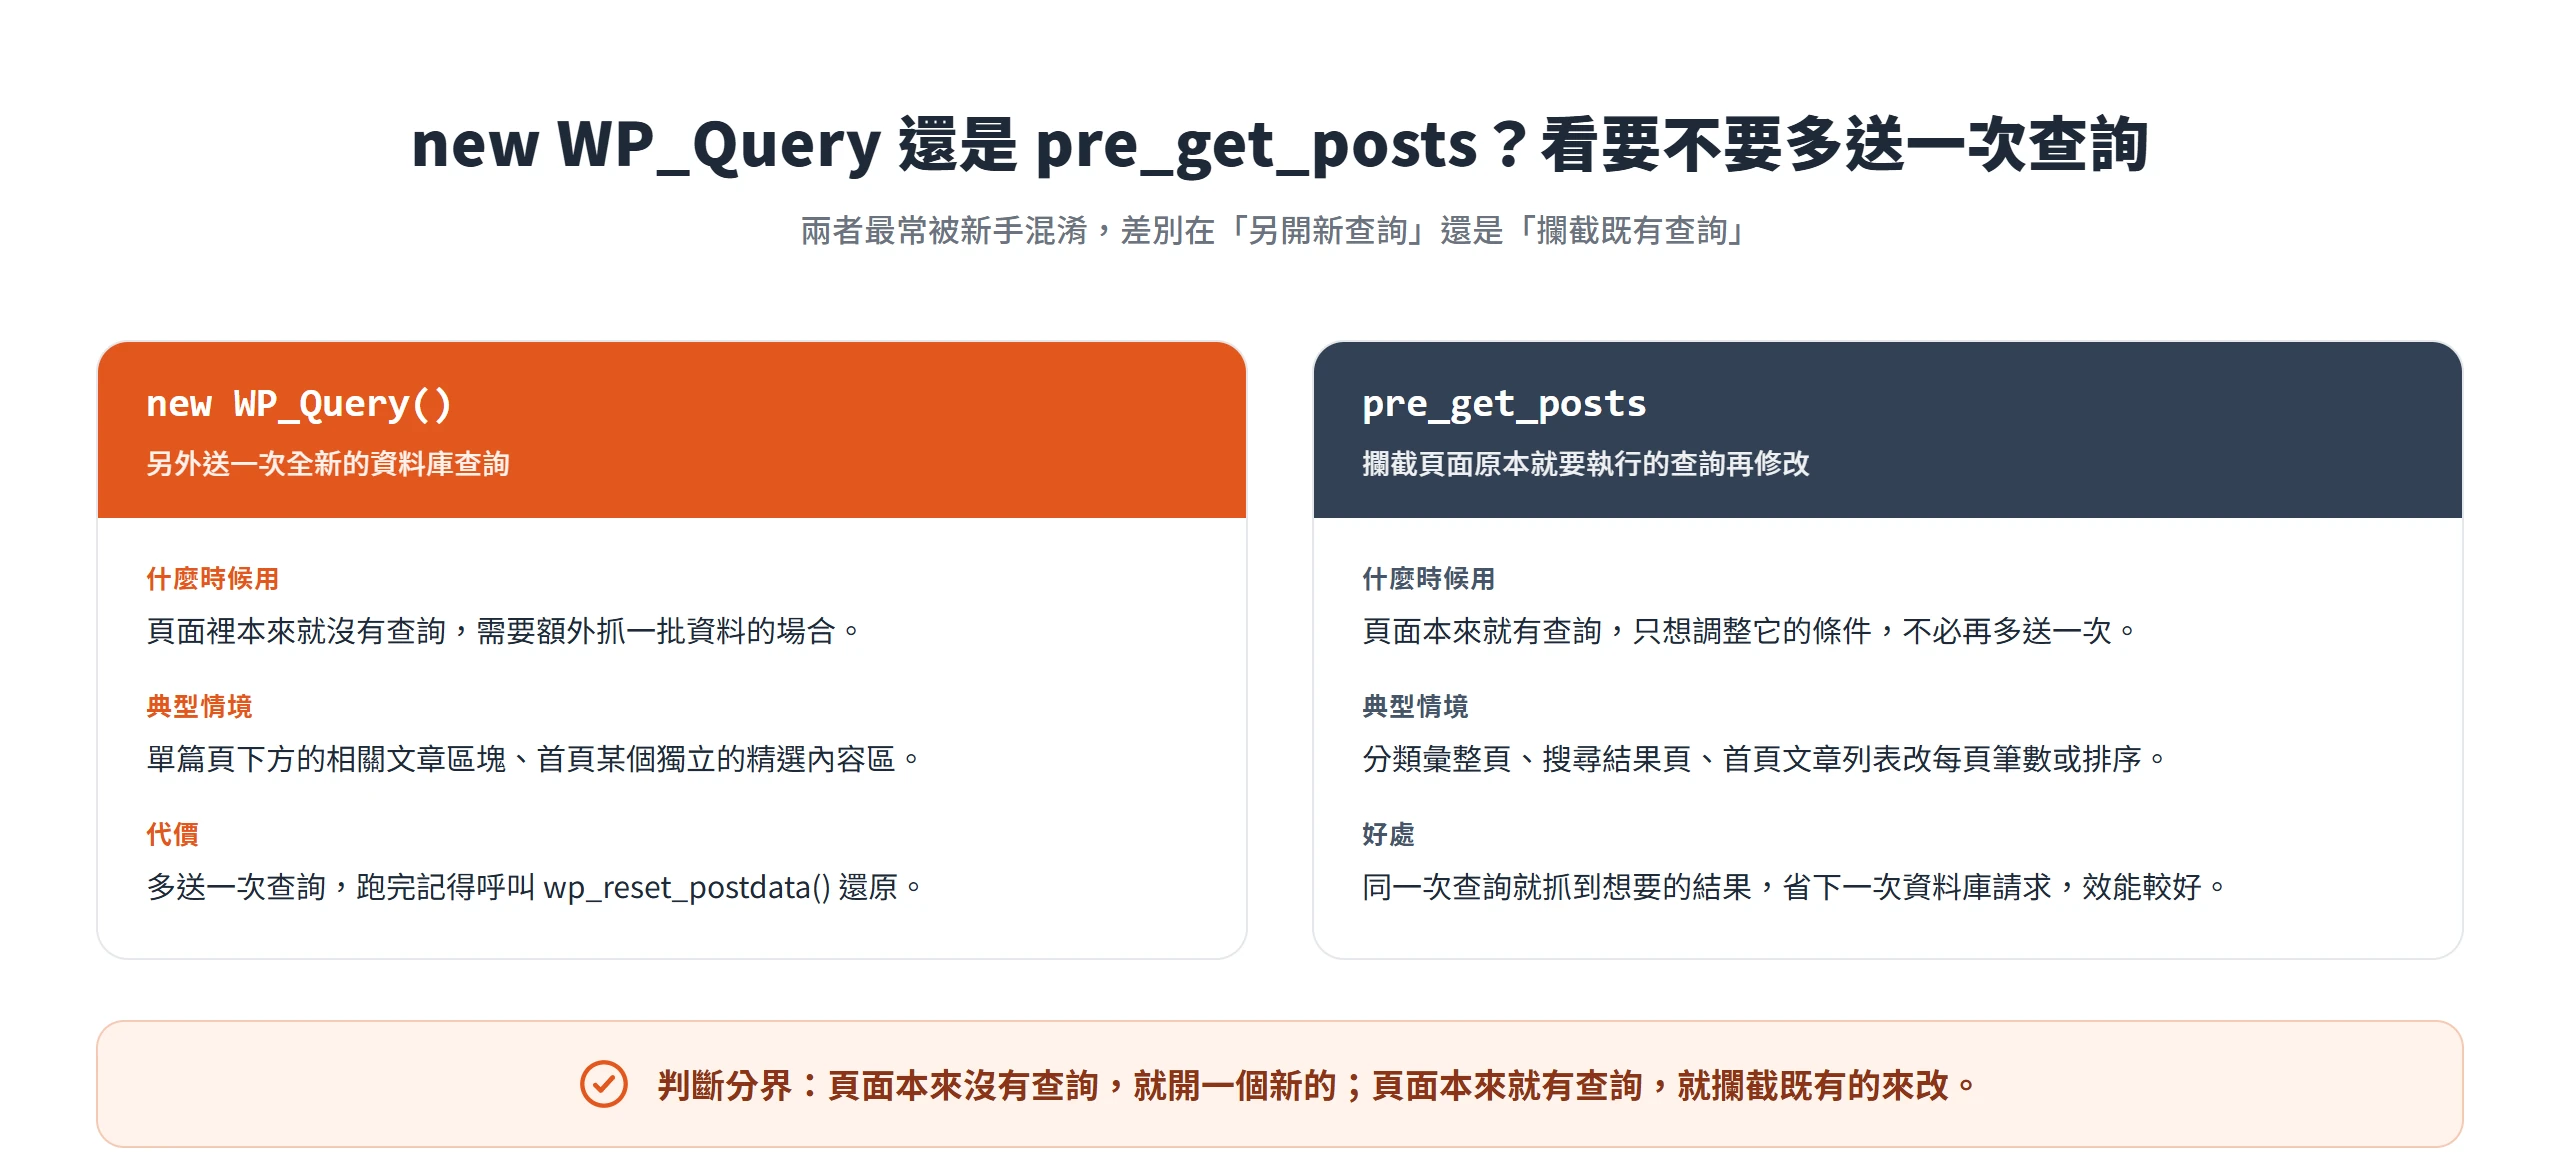
WP_Query 與 pre_get_posts 的差別,在於要不要送出新的資料庫查詢
前面談的都是自己動手 new WP_Query(),但還有另一種完全不同的做法,攔截、修改頁面裡本來就會執行的那個查詢,而不是另外再送一次。這也是新手最常混淆的地方,什麼時候該開新查詢、什麼時候該用鉤子攔截既有查詢。
new WP_Query() 是另外送一次全新的資料庫查詢,適合用在頁面裡本來就沒有查詢、需要額外抓一批資料的場合,比如單篇頁下方的相關文章區塊、首頁某個獨立的精選內容區。pre_get_posts 則是一個動作鉤子(action hook),在 WordPress 原本就要執行的查詢(分類彙整頁、搜尋結果頁、首頁的文章列表)真正送出資料庫請求之前被觸發,可以在這個時間點攔下來修改查詢條件,讓同一次查詢就抓到想要的結果,不必再多送一次查詢。因為省下了一次資料庫請求,pre_get_posts 在這類「調整既有查詢」的情境下,效能會比另開一個 WP_Query 好。
用 pre_get_posts 有一件事一定要做,掛上鉤子的函式裡要用傳進來的 $query 物件呼叫 is_main_query()(寫成 $query->is_main_query()),而不是呼叫全域函式 is_main_query()。因為 pre_get_posts 這個鉤子每一次查詢(包含側邊欄小工具、頁面裡其他次查詢)執行前都會被觸發,如果沒有先判斷「這次被攔到的是不是主查詢」,寫的修改邏輯就會連小工具的次查詢也一起改到,產生完全沒預期到的結果。
讓某個分類彙整頁把每頁顯示的文章數從預設值改成 20,寫法會放在主題的 functions.php:
function pongo_custom_archive_query( $query ) {
    if ( ! is_admin() && $query->is_main_query() && is_category( 'news' ) ) {
        $query->set( 'posts_per_page', 20 );
    }
}
add_action( 'pre_get_posts', 'pongo_custom_archive_query' );Code language: PHP (php)
這段程式只在前台、而且是主查詢、而且是「news」這個分類彙整頁時才生效,其他情境下 pre_get_posts 被觸發時這個函式什麼都不會改動。
posts_per_page 設成 -1 是常見的效能地雷
posts_per_page 除了設成正整數,也可以設成 -1 代表不限筆數,看起來很方便,不用猜要抓幾篇,反正全部撈出來就對了。文章數量還少的時候,這樣寫確實沒什麼感覺,問題會等到內容成長到成千上萬篇之後才爆發,一次把全部符合條件的文章都撈出來,資料庫查詢的負擔與 PHP 記憶體用量會一起飆高,嚴重時整個頁面請求逾時,甚至把主機資源整個吃滿,拖累到同一台主機上其他網站的回應速度。
比較穩妥的做法是改設一個正整數的合理上限,依實際情境判斷這個區塊大概需要顯示多少篇文章就好,不要用 -1 圖一時方便。如果真的有「抓全部」的需求(比如批次匯出、後台跑一次性的資料整理),應該改用分頁批次抓取或排到背景排程處理,不要放在前台使用者每次請求都會觸發的查詢裡一次抓完。
還有一個順帶可以做的優化,如果這個次查詢本身不需要分頁(不會顯示頁碼、也不需要知道總共查到幾篇),可以額外傳入 no_found_rows => true,讓 WordPress 跳過計算「符合條件的文章總筆數」這道額外的 SQL 運算,有助於提升查詢效能。
$args = array(
    'post_type'      => 'post',
    'posts_per_page' => 5,
    'no_found_rows'  => true,
);Code language: PHP (php)
像側邊欄「最新文章」這種只顯示固定 5 篇、不需要換頁的小工具區塊,就是 no_found_rows => true 最適合派上用場的地方。
區塊編輯器的 Query Loop 區塊,一種不寫程式的替代做法
前面講的整套 WP_Query 都是寫在 PHP 裡的做法,但現行 WordPress 的區塊編輯器與全站編輯(FSE)已經內建一個叫做「Query Loop」的區塊,WordPress 官方文件把它定位成一個進階區塊,能依指定的參數顯示文章,就像不用寫程式的 PHP 迴圈,白話講,就是透過介面上的設定選項,不寫一行程式碼也能做到跟前面章節差不多的效果:選文章類型、設定排序方式、篩選分類、接上分頁區塊。
適合用 Query Loop 區塊的情境,是只想在頁面或版型裡插一段自訂的文章列表,而且需求就是「選文章類型、排序、篩一個分類」這種介面上有對應選項的組合,不需要另外寫程式、也不需要維護 PHP 檔案。但它的彈性有限,遇到比較複雜的查詢就顯得不夠用,像前面講的 meta_query 那種依自訂欄位數值篩選的條件、需要用 OR 串起不同分類法條件的 tax_query,或是前台讓訪客自己選篩選條件的互動式表單,這些介面上都沒有對應的設定選項,遇到這類需求還是得回到 PHP 自己寫 WP_Query。
判斷要不要動用程式碼的分界線很清楚,純粹靜態設定好、之後不會再變的查詢條件,交給 Query Loop 區塊處理就夠了;查詢邏輯需要動態組合、需要接使用者輸入,或條件複雜到介面表達不了,才需要回到自己寫 WP_Query 這條路。
回到最前面那個點餐的比喻,WP_Query 本質上就是給開發者一份完整的菜單,能點的東西遠比套餐的預設組合豐富,但也代表每一項都要自己確認合不合胃口,類型抓對了沒、數字比對有沒有標型別、次查詢跑完有沒有把全域資料還原。真的要動手寫一個查詢之前,先想清楚這個場合是「頁面裡本來沒有查詢,我要另外開一個」,還是「頁面本來就有查詢,我只是想調整它」,這個判斷對了,後面該用 new WP_Query() 還是 pre_get_posts,答案自然就出來了。