
多數網站主把 robots.txt 裡的 GPTBot、ClaudeBot 這些規則設定好、Allow 或 Disallow 都填清楚,就當作「AI 爬不爬得到我」這件事已經處理完畢。但 robots.txt 從頭到尾只是網站單方面貼出的一張告示,寫的是「我允許誰進來」,不是「誰真的走進來過」,遵不遵守,決定權其實在對方手上。更麻煩的是,GA4 和 Google Search Console 這類分析工具幾乎看不到 AI 爬蟲的造訪,因為它們不執行 JavaScript,而分析工具靠的正是那段追蹤指令碼,AI 爬蟲一來就完全隱形。
想知道 AI 有沒有真的讀過你的網站、讀了哪些頁面、讀了多少次,唯一靠得住的證據不是後台報表,而是伺服器原始存取日誌(access log),每一支爬蟲、每一次請求,都老實記在那裡。但在動手翻日誌之前,robots.txt 本身算不算已經造訪過的證據,得先弄清楚。
robots.txt 允許 AI 爬蟲,等於已經被造訪過嗎?
robots.txt 能做的事情很單純:宣告你歡迎誰、拒絕誰。它管的是禮貌,管不了誠實。任何請求端只要不理會這份告示,一樣可以直接把頁面整批讀走,網站主完全看不到違規紀錄,因為 robots.txt 本身不具備任何強制力,也沒有回報機制。設定完成的那一刻,只代表你的立場表達清楚了,不代表對方真的照做。
更容易被忽略的是分析工具的局限,GA4、GSC 這類分析平台靠的是瀏覽器載入頁面後執行一段追蹤指令碼,把使用者行為回傳給後台。AI 爬蟲多半是用程式直接發出 HTTP 請求,把伺服器回傳的原始 HTML 抓下來就走,從頭到尾不會啟動瀏覽器引擎,也不會執行任何 JavaScript。追蹤指令碼沒被執行,這些造訪自然就從分析報表裡消失,不是流量真的沒發生,是你手上的量尺量不到。
Cloudflare 在 2025 年的一份分析裡,把 AI 爬蟲流量依用途拆開來看:屬於訓練用途的爬取,占了將近 80%;由使用者觸發、或用途未聲明的流量,合計不到 5%。這個比例背後的意思是,多數 AI 爬蟲此刻在做的事,是把你的內容收進未來模型的訓練資料庫,跟「這篇文章有沒有被 ChatGPT 讀出來引用」是兩件可以分開驗證的事。
各家 AI 公司派出的爬蟲,身分與任務並不相同
認識這些爬蟲,是看懂日誌的第一步。同一家 AI 公司底下常常不只一支爬蟲,訓練用、搜尋引用用、即時使用者查詢用是三種完全不同的任務,各自在日誌裡留下不同的 user-agent 字串,也各自對應 robots.txt 裡不同的攔截效果。擋掉負責訓練的那一支,不代表另外兩支也跟著停下來,這是最容易被誤判的地方。
各家官方都公開了自己旗下爬蟲的來源 IP 清單,格式多半是 JSON,日後核對真偽時可以直接拿來比對。這裡先把幾家主要 AI 公司的爬蟲身分認清楚,才看得懂後面篩出來的每一行紀錄,是誰、在做什麼。
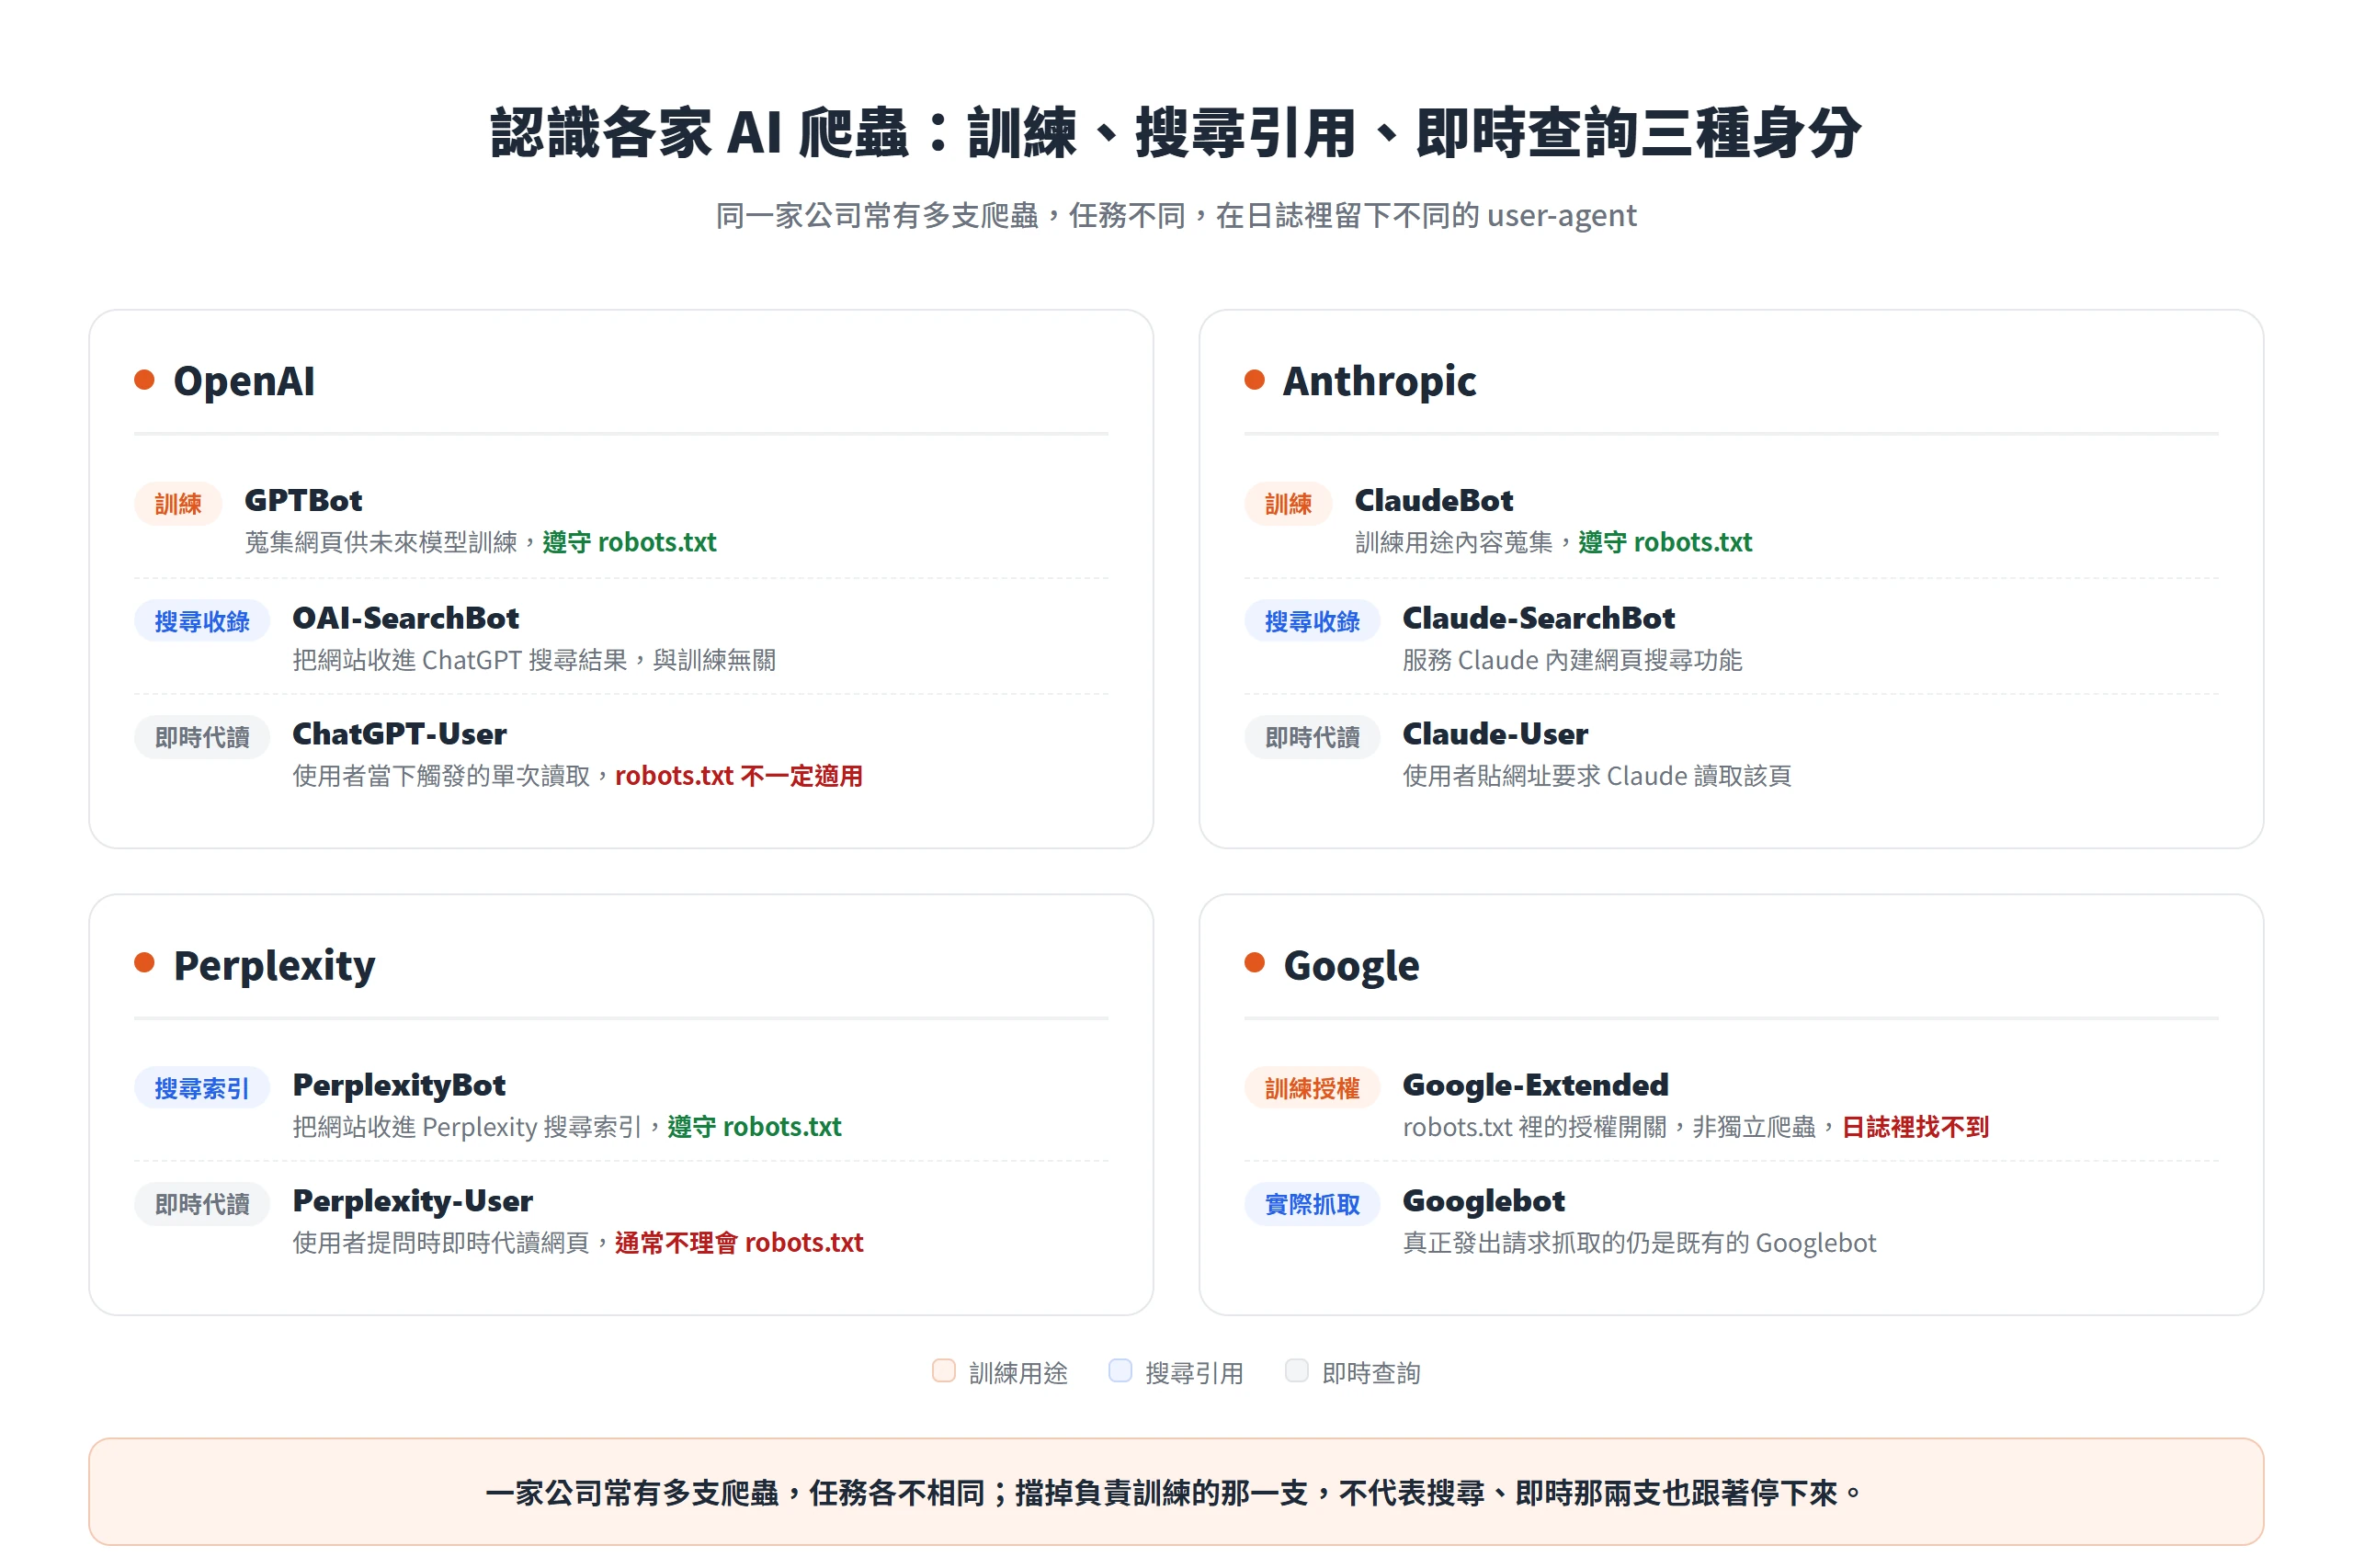
OpenAI 旗下的 GPTBot、OAI-SearchBot 與 ChatGPT-User
GPTBot 負責把網頁內容蒐集起來,供未來模型訓練使用,它的完整 user-agent 字串如下:
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbotCode language: plaintext (plaintext)OpenAI 官方公開了這支爬蟲的來源 IP 清單,網址是 openai.com/gptbot.json。
OAI-SearchBot 是另一回事,它負責把網站收進 ChatGPT 的搜尋結果,跟訓練無關。就算擋掉 GPTBot,只要留著 OAI-SearchBot,網站依然可能出現在 ChatGPT 的搜尋回答裡,只是內容不會被拿去訓練模型。它的 user-agent 帶有 OAI-SearchBot 字樣,IP 清單放在 openai.com/searchbot.json。
ChatGPT-User 又不一樣,它不是排程去爬網站,而是使用者在對話裡貼上一個網址、或叫用某個外掛工具時,由 ChatGPT 當下即時代為讀取那一頁。因為每一次都是人親自觸發的單次請求,robots.txt 的規則不一定適用在它身上;官方文件也明講這支爬蟲的行為模式跟前兩支不同。它的 IP 清單在 openai.com/chatgpt-user.json。另外,這幾支爬蟲讀 robots.txt 檔案時,UA 尾端有時會多帶一個 robots.txt 標記字樣,這在日誌沒有記錄請求路徑時,也能幫忙分辨那筆請求是在讀規則,還是在讀內容頁。
Anthropic 旗下的 ClaudeBot、Claude-SearchBot 和 Claude-User
Anthropic 同樣把角色拆成三支。ClaudeBot 負責訓練用途的內容蒐集,官方支援文章說得很明確,封鎖 ClaudeBot,代表這個網站往後的內容會被排除在訓練資料集之外,不會再被納入。它的 user-agent 通常長這樣:
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; ClaudeBot/1.0; [email protected])Code language: plaintext (plaintext)Claude-SearchBot 服務的是 Claude 內建的網頁搜尋功能,封鎖它會降低網站在 Claude 搜尋結果裡的能見度,跟訓練資料無關。Claude-User 對應的是使用者在對話裡貼出網址、要求 Claude 讀取該頁的情境,封鎖它影響的是使用者導向請求時的可見度。三支各自遵守標準 robots.txt 裡的 Disallow 與 Crawl-delay 指令,擋一支不會連帶影響另外兩支的判斷邏輯。
三支爬蟲共用同一份公開 IP 清單,網址是 claude.com/crawling/bots.json,要核對來源真偽時直接比對這份清單就好,不必分開找三個網址。
PerplexityBot、Perplexity-User,以及沒有專屬爬蟲的 Google-Extended
PerplexityBot 是把網站收進 Perplexity 搜尋索引的爬蟲,遵守 robots.txt 的規則,它的 user-agent:
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)Code language: plaintext (plaintext)IP 清單放在 perplexity.com/perplexitybot.json。
Perplexity-User 對應的是使用者向 Perplexity 提問、系統即時代為讀取某個網頁的情境,官方文件註明它通常不理會 robots.txt,理由跟 ChatGPT-User 一樣,都是人觸發的單次請求,不是排程性的自動化爬取。它的 IP 清單在 perplexity.com/perplexity-user.json。
Google-Extended 是最常被誤會的一個——它並不是一支會自己發出請求、在日誌裡留下專屬紀錄的爬蟲。它其實是 robots.txt 裡的一個授權開關,管的是 Googlebot 原本已經抓到的內容,能不能被拿去訓練 Gemini 或用在 Vertex AI 這類生成式模型上,跟一般 Google 搜尋的排名結果無關。實際負責抓取的仍然是既有的 Googlebot,所以打開日誌去找一個叫做 Google-Extended 的 user-agent,注定找不到,它從來不會以獨立爬蟲的身分出現在存取紀錄裡。
從主機後台或 CDN 儀表板取得原始存取紀錄
篩日誌之前,得先知道日誌放在哪裡。多數台灣中小企業網站用的是虛擬主機加 cPanel 這種組合,也有不少網站前面掛了 Cloudflare 這類 CDN,兩種情境找日誌的地方完全不一樣,得先確認自己是哪一種,才知道該往哪裡拿資料。
容易被忽略的是,多數主機商的原始日誌不會無限期保留,通常會定期輪替,或只留幾天到一個月份。想長期觀察 AI 爬蟲的造訪模式,就得養成固定下載保存的習慣,不是查一次就永遠有得看。
多數虛擬主機的 cPanel,藏著 Raw Access Logs 下載入口
登入 cPanel 後,在「Metrics」這個區塊裡找到「Raw Access」,就是原始存取日誌的下載入口。裡面通常有個選項可以勾選,讓系統在每個月底把當月日誌封存到自己的家目錄,這樣就不必擔心日誌被輪替後找不回來。下載下來的檔案是 gzip 壓縮格式,解壓縮之後用文字編輯器或指令列工具就能打開,看到逐行的存取紀錄。
如果網站掛在比較陽春的主機、沒有 cPanel 這層介面,直接問主機商客服要 Apache 或 Nginx 的 access log 路徑或下載方式即可,多數業者都能提供,不是什麼特殊需求。這份原始日誌通常包含來源 IP、時間戳記、請求方法與路徑、HTTP 狀態碼、回應大小、Referer、User-Agent 這幾個欄位。
使用 Cloudflare 代理時,日誌不在主機而在儀表板
如果網站的 DNS 設定是那朵橘色雲朵,代表流量先經過 Cloudflare 的邊緣節點才轉進主機,AI 爬蟲的請求其實是先打到 Cloudflare,來源主機看到的 IP 位址很可能已經變成 Cloudflare 自己的,除非另外設定把真實使用者端 IP 透過標頭寫回主機日誌,否則直接啃主機日誌看到的來源會失真。
這種情況下,比起自己去啃原始日誌,更快的做法是直接進 Cloudflare 儀表板的「Security」→「Analytics」,切到「Bot analysis」分頁看已驗證機器人的分類與流量占比。Cloudflare 會自動把 GPTBot、ClaudeBot 這些主流 AI 爬蟲歸類清楚,但這層 Bot Analytics 儀表板只有 Business 以上的方案才看得到,免費與 Pro 方案沒有這個分頁;企業方案則另外多了依 bot 分數分層、完整機器人清單查詢等更進階的選項。
用 grep 或 GoAccess 篩出 AI 爬蟲的造訪紀錄
拿到原始日誌之後,第一件事是把資料變成看得懂的東西。最基本的做法是用指令列工具依關鍵字過濾出特定 user-agent 的整行紀錄,不需要另外安裝軟體,多數主機環境都內建。
用 grep 篩選時,可以一次比對多個爬蟲名稱:
grep -Ei "gptbot|claudebot|perplexitybot|oai-searchbot|chatgpt-user|claude-user|claude-searchbot|perplexity-user" access.logCode language: Bash (bash)-i 代表不分大小寫,-E 讓多個關鍵字可以用直線符號一次比對,不用跑好幾次指令。如果日誌檔是被輪替後留下的壓縮檔,得先解壓縮,或直接用 zcat 邊解壓邊篩:
zcat access.log.gz | grep -Ei "gptbot|claudebot|perplexitybot"Code language: Bash (bash)不想碰指令列的話,GoAccess 是另一條路。它是開源、免費的即時網頁日誌分析工具,可以在終端機直接看報表,也能輸出成能在瀏覽器打開的 HTML 頁面,或匯出 JSON、CSV 格式。設定好日誌格式字串之後,就能依 user-agent、來源 IP、請求路徑這些維度統計流量,不用自己寫一行行的篩選指令,對不熟指令列的網站主來說門檻低不少。
一筆存取紀錄裡,狀態碼、請求路徑和時間節奏代表的意思
篩出來的一整行紀錄,乍看是一串沒有斷句的英數字,但它其實照固定順序排列:來源 IP、時間戳記、請求方法與路徑、HTTP 狀態碼、回應大小、Referer、User-Agent。看懂這幾個欄位在講什麼,才看得出這支 AI 爬蟲做了什麼事。舉例來說,一行常見的紀錄長得像這樣:
203.0.113.45 - - [13/Sep/2026:10:15:32 +0800] "GET /articles/example-post HTTP/1.1" 200 15234 "-" "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot"Code language: plaintext (plaintext)狀態碼是判斷結果最直接的線索:200 代表爬蟲真的成功讀到那個頁面的內容;404 代表它撲了個空,要抓的頁面根本不存在;403 則代表請求被伺服器擋下來,可能是主機層的規則生效,也可能是防火牆介入。光看狀態碼還不夠,請求路徑同樣重要:它抓的是哪一頁,還是只讀了 robots.txt 或 sitemap.xml,兩者的意義完全不一樣,前者代表內容真的被讀走,後者只代表它在確認規則、盤點你有哪些頁面。
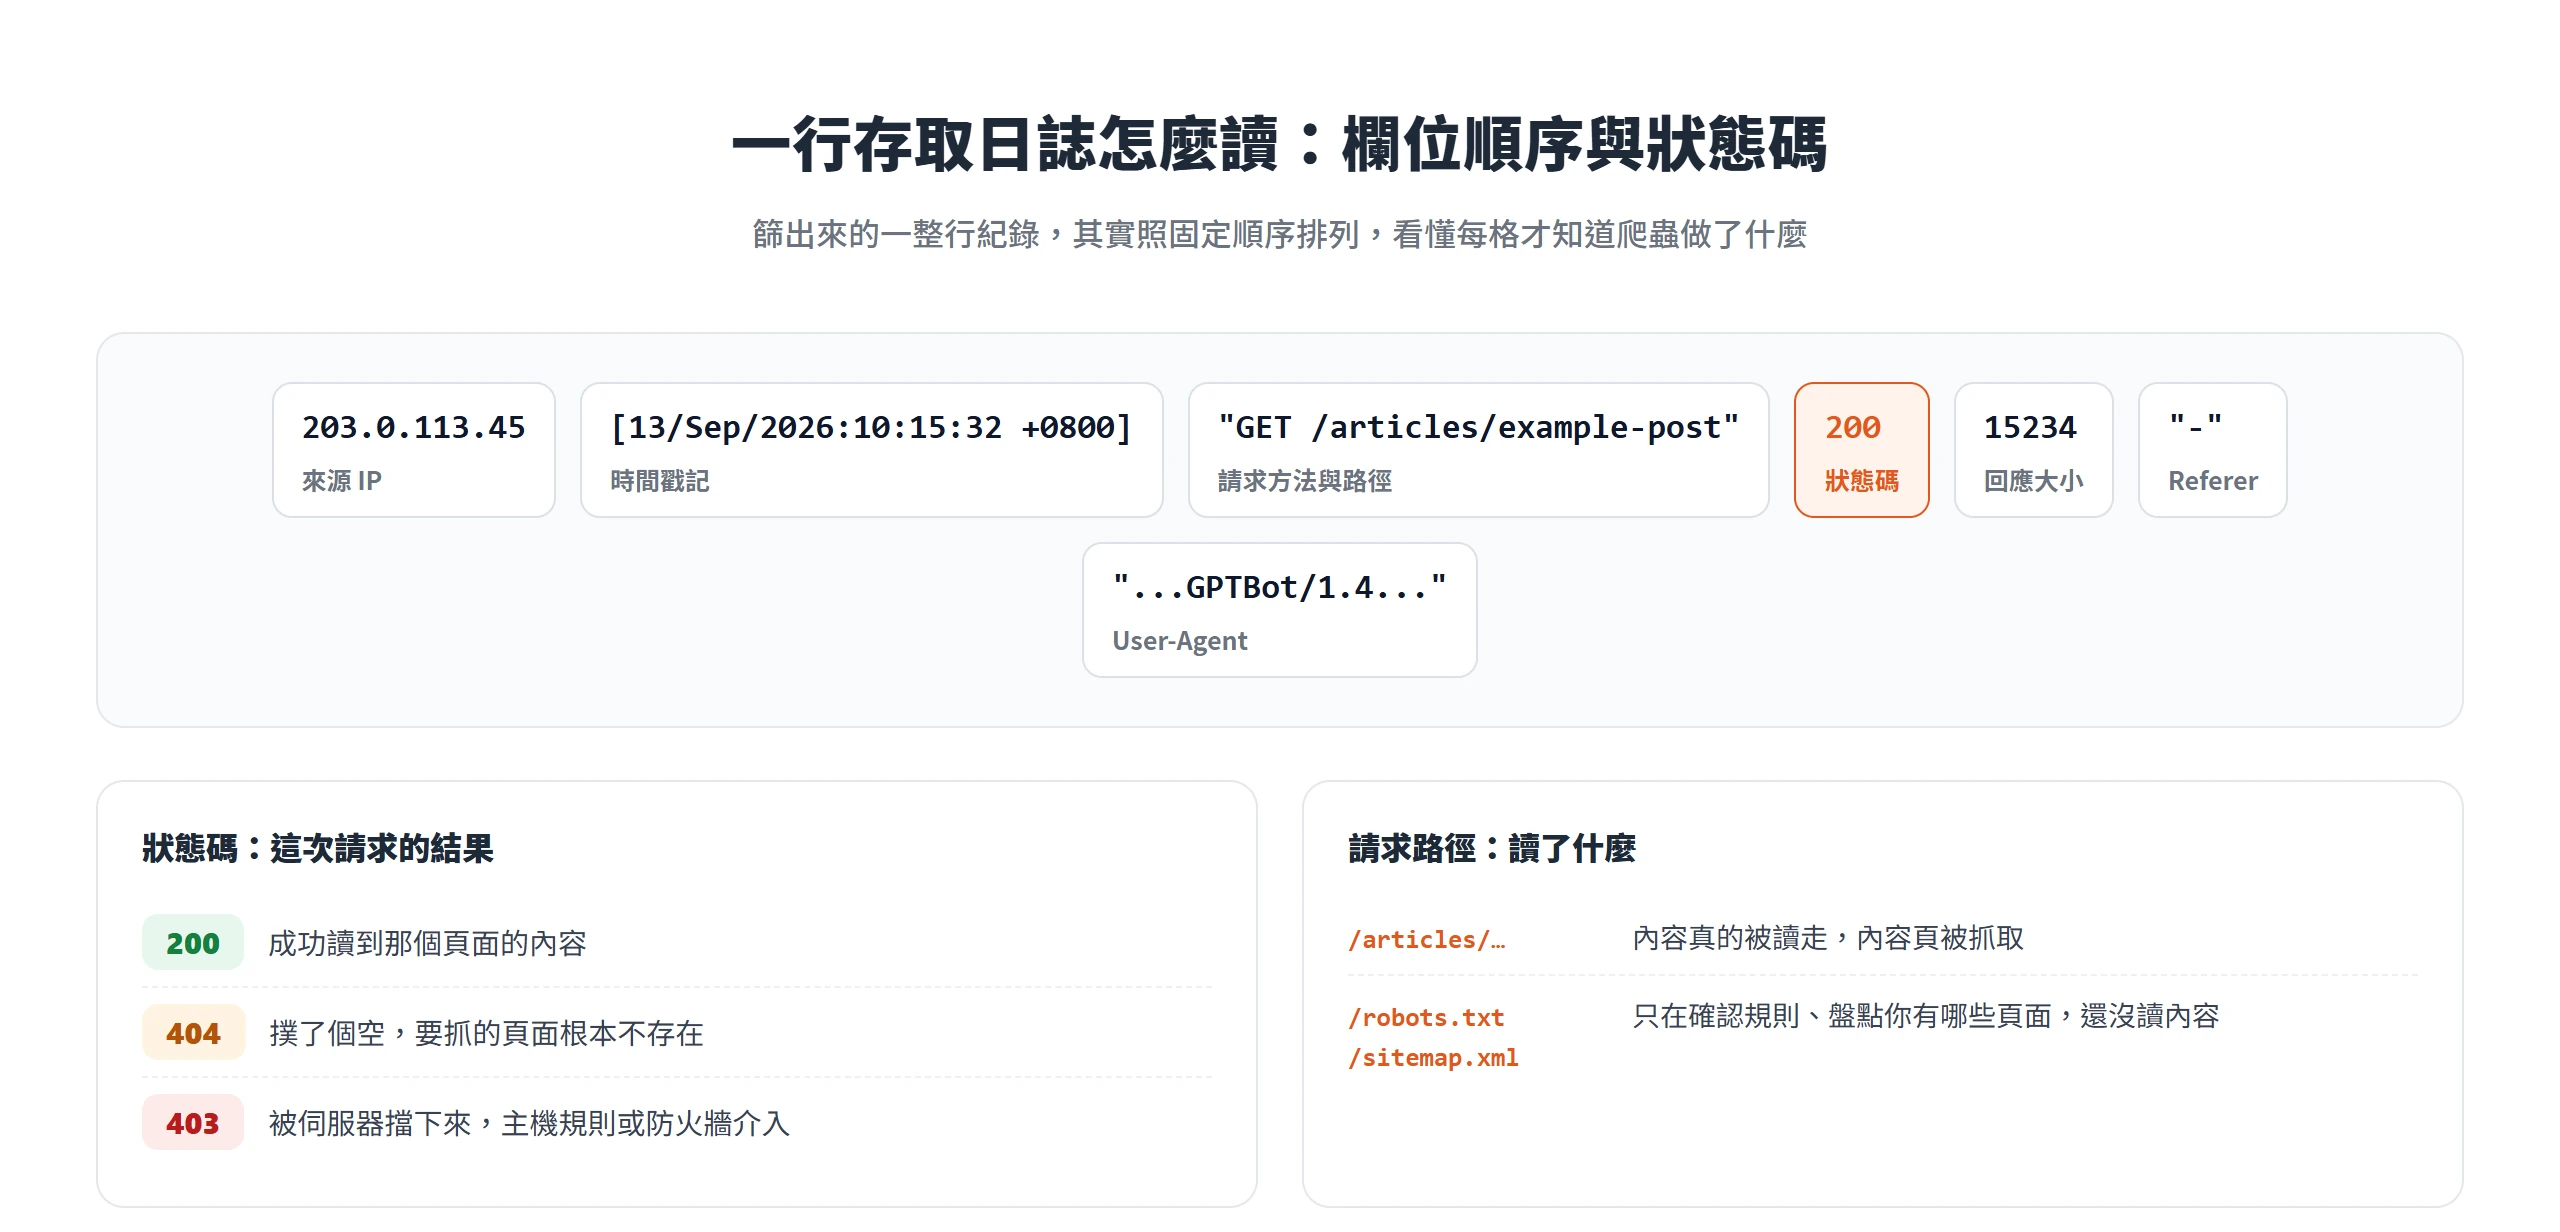
時間戳記則透露造訪的節奏。同一支爬蟲的請求是每天穩定出現幾次,還是短時間內忽然湧入一大批,反映出兩種完全不同的行為模式:前者比較像固定巡檢,後者比較像正在針對這個網站啟動一波密集抓取。
官方 IP 清單與反向 DNS,戳破偽造的 AI 爬蟲流量
user-agent 字串只是請求端自己在標頭裡宣稱的一段文字,任何工具都能夠把自己偽裝成同樣的字樣,這代表光看 user-agent 不能證明來訪者真的是它自稱的那支爬蟲。要確認真偽,有兩種可重複驗證的做法:比對官方公布的 IP 清單,或做正向確認的反向 DNS 查詢。
各家官方都公開了自己旗下爬蟲的 IP 清單,格式多半是 JSON,方便寫程式自動比對:OpenAI 的 GPTBot、OAI-SearchBot、ChatGPT-User 分別在 openai.com/gptbot.json、openai.com/searchbot.json、openai.com/chatgpt-user.json;Anthropic 的三支爬蟲共用一份清單,在 claude.com/crawling/bots.json;Perplexity 的兩支爬蟲分別在 perplexity.com/perplexitybot.json 與 perplexity.com/perplexity-user.json。把日誌裡的來源 IP 拿去對這幾份清單,就能快速判斷是不是官方名單內的位址。
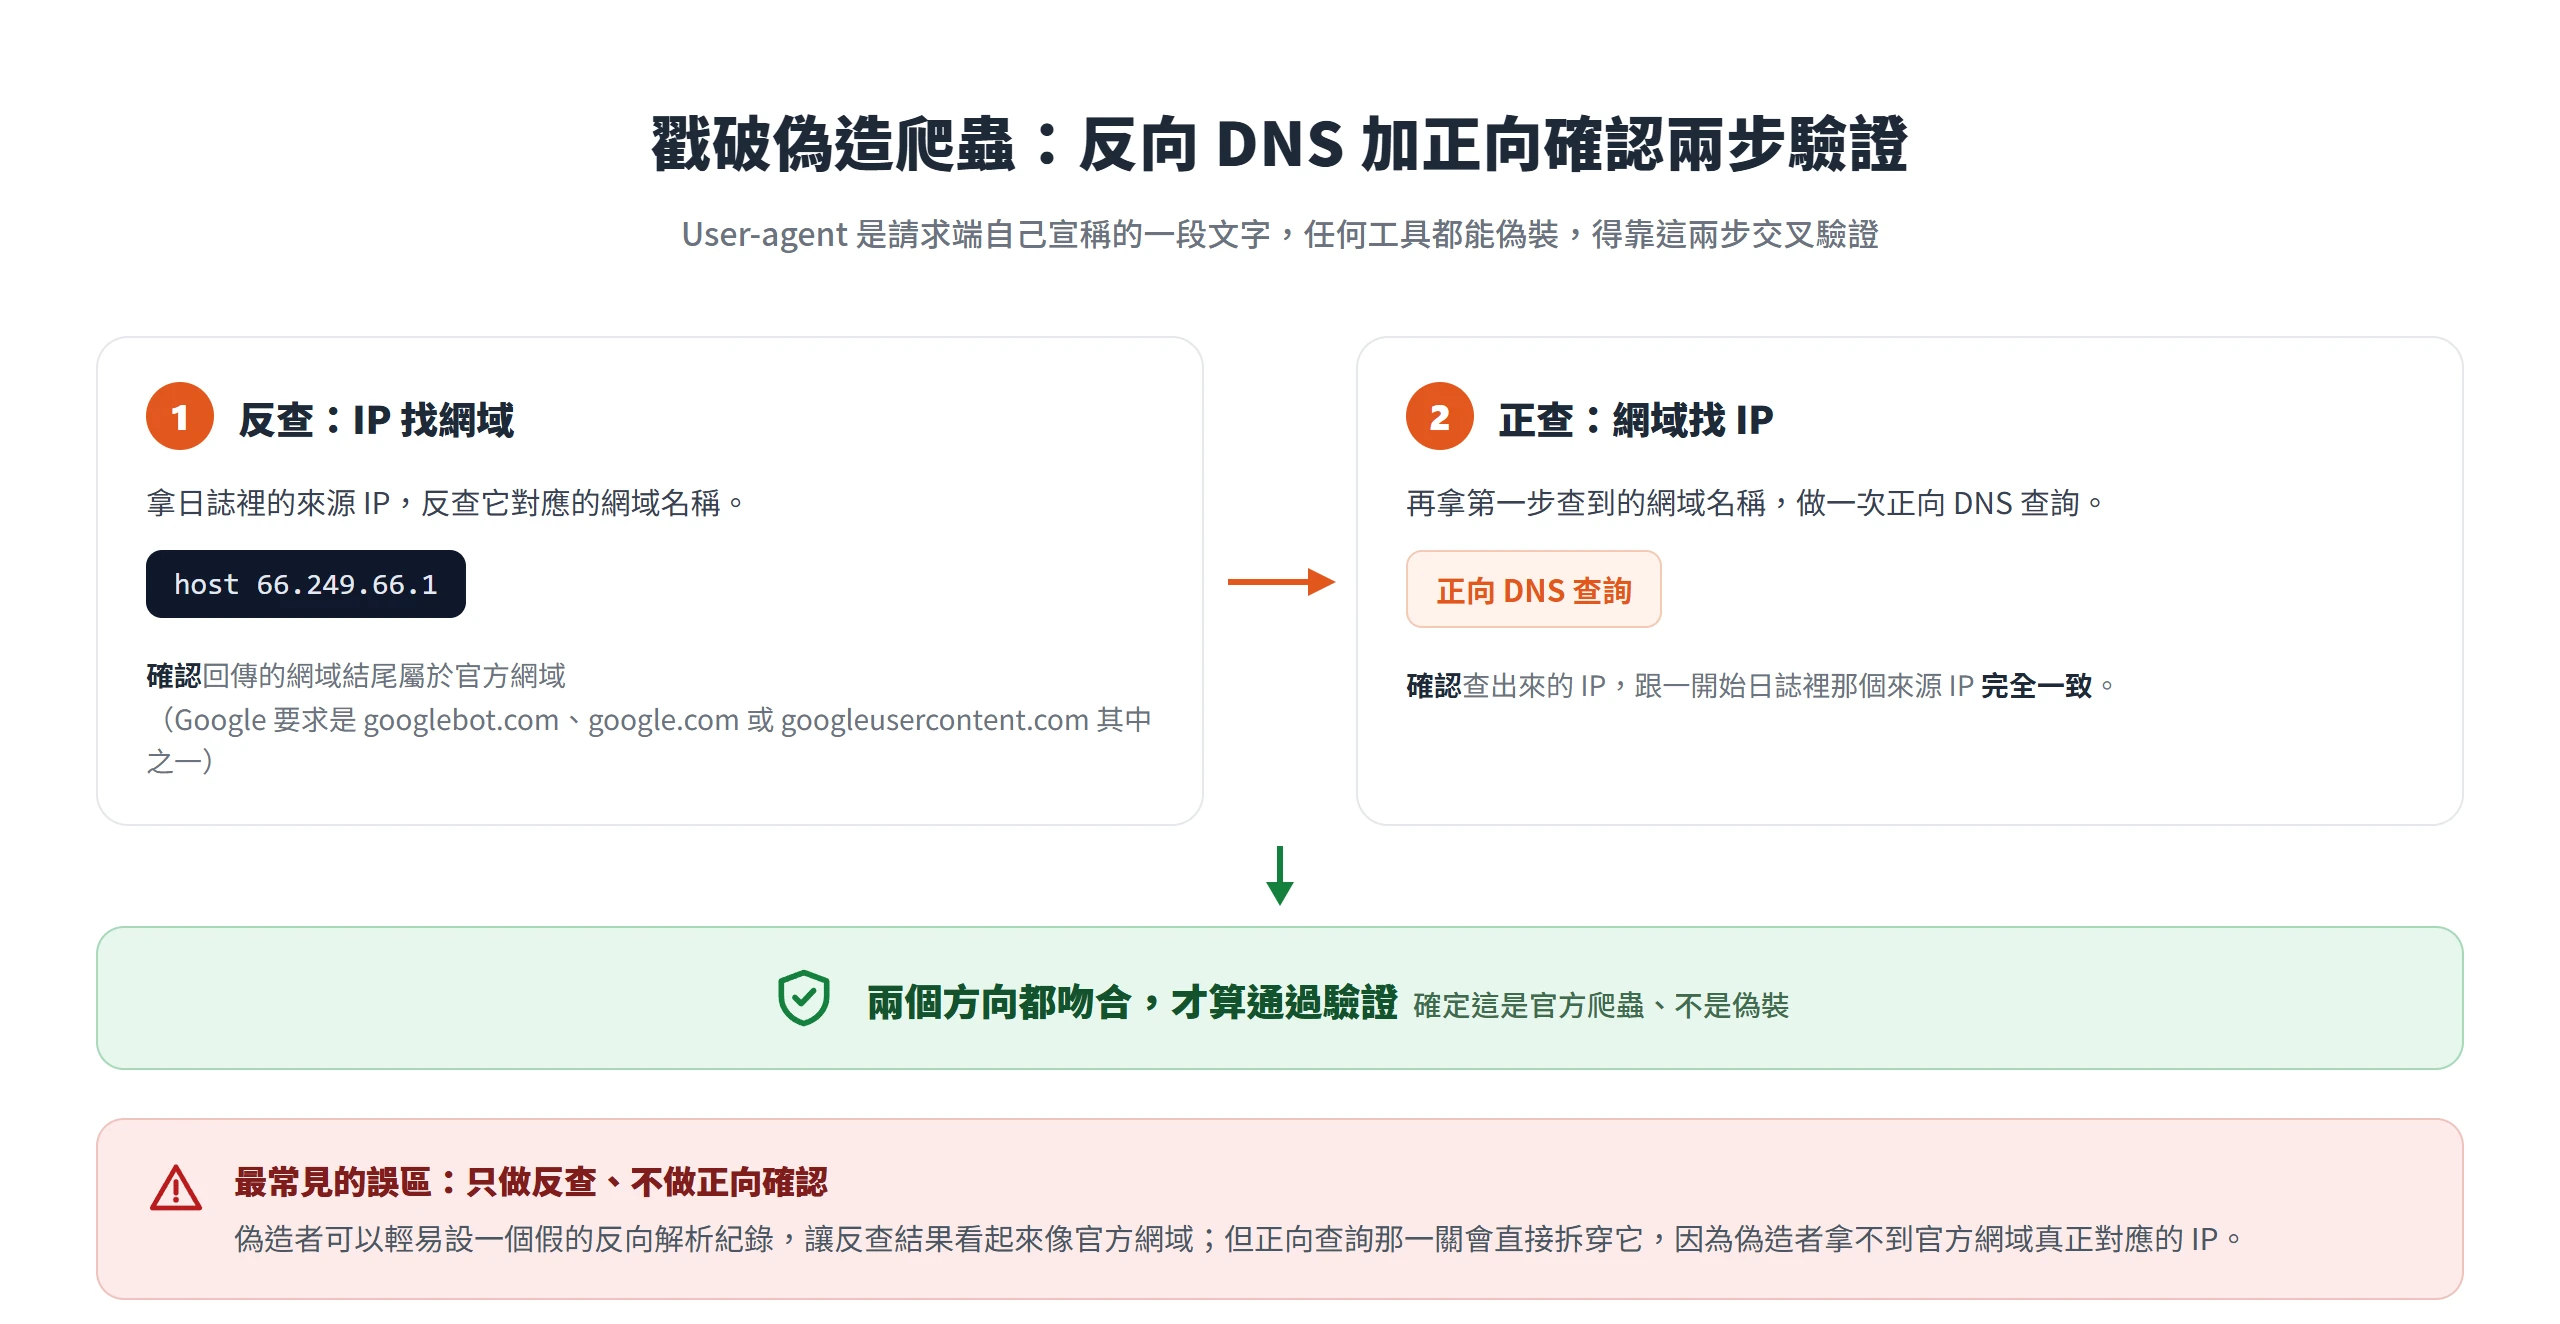
沒有現成清單可查、或想再多一層確認時,可以做正向確認反向 DNS 查詢(forward-confirmed reverse DNS,FCrDNS),做法分兩步:第一步用來源 IP 反查網域名稱,例如:
host 66.249.66.1Code language: Bash (bash)確認回傳的網域結尾屬於官方網域(Google 官方要求是 googlebot.com、google.com 或 googleusercontent.com 其中之一);第二步再拿查到的網域名稱做一次正向 DNS 查詢,確認查出來的 IP 跟一開始的來源 IP 一致。兩個方向都吻合,才算通過驗證。只做反查、不做正向確認是最常見的誤區,偽造者可以輕易設定一個假的反向解析紀錄,讓反查結果看起來像官方網域,但正向查詢那一關會直接拆穿它,因為偽造者拿不到官方那個網域真正對應的 IP。這一整套反向查詢加正向確認的原理,同樣可以套用在其他 AI 爬蟲身上,只是換成各家自己的官方網域與上面列出的 IP 清單。
只查過 robots.txt,不代表內容已被拿去訓練
篩出一堆某支 AI 爬蟲的紀錄,不代表它已經把你的內容整批讀走了。這是全篇最容易被誤判的一步,很多網站主看到日誌裡出現大量 GPTBot 或 ClaudeBot 的請求就直接下結論,卻沒有先確認那些請求實際落在哪個路徑上。
如果幾乎全部的請求都是在讀 robots.txt 或 sitemap.xml,而落在真正內容頁面的請求極少甚至掛零,這代表這支爬蟲目前只在盤點,還沒有真正把內容抓進去。反過來,如果同一支爬蟲曾在短時間內對站內大量文章路徑發出成功的 200 回應,那才是真的把內容讀進去了。前面提到的 wislr.com 那份 48 天日誌分析裡就有清楚的對照:ClaudeBot 有 85% 的請求集中在讀取 robots.txt,真正落在內容頁面的比例很低;GPTBot 則相反,67% 的請求落在文章頁面。這是單一網站的個案樣本,不代表全網通則,但拿來理解同樣是爬蟲流量、落點不同代表的意義完全不一樣,很有幫助。
同一份分析也觀察到一個現象,GPTBot 原本沒什麼動靜,直到某個時間點才忽然出現大量請求,單週就衝到 187 次,其中八成以上集中在 3 分鐘內。該篇作者的解讀是,GPTBot 不太像持續巡爬每一個網站,而是等內容在 OpenAI 的生態系裡累積到一定聲量,才會啟動大量抓取,這是該分析作者依觀察提出的推論,不是官方定論。相對地,OAI-SearchBot 的造訪就規律得多,每天固定造訪 robots.txt 三到六次。同一支爬蟲的行為不是查一次就永遠固定的結論,原本沒來的爬蟲,幾個月後可能忽然開始大量造訪,值得定期重新檢查,而不是查過一次就束之高閣。
依照造訪結果調整 robots.txt 開放範圍的三種情境
把前面查到的證據收斂起來,就會落入三種情境之一,各自對應不同的下一步。日誌查核不是查一次就結束,而是拿真實造訪情況回頭檢查目前的 robots.txt 設定,跟自己想要的結果對不對得上。
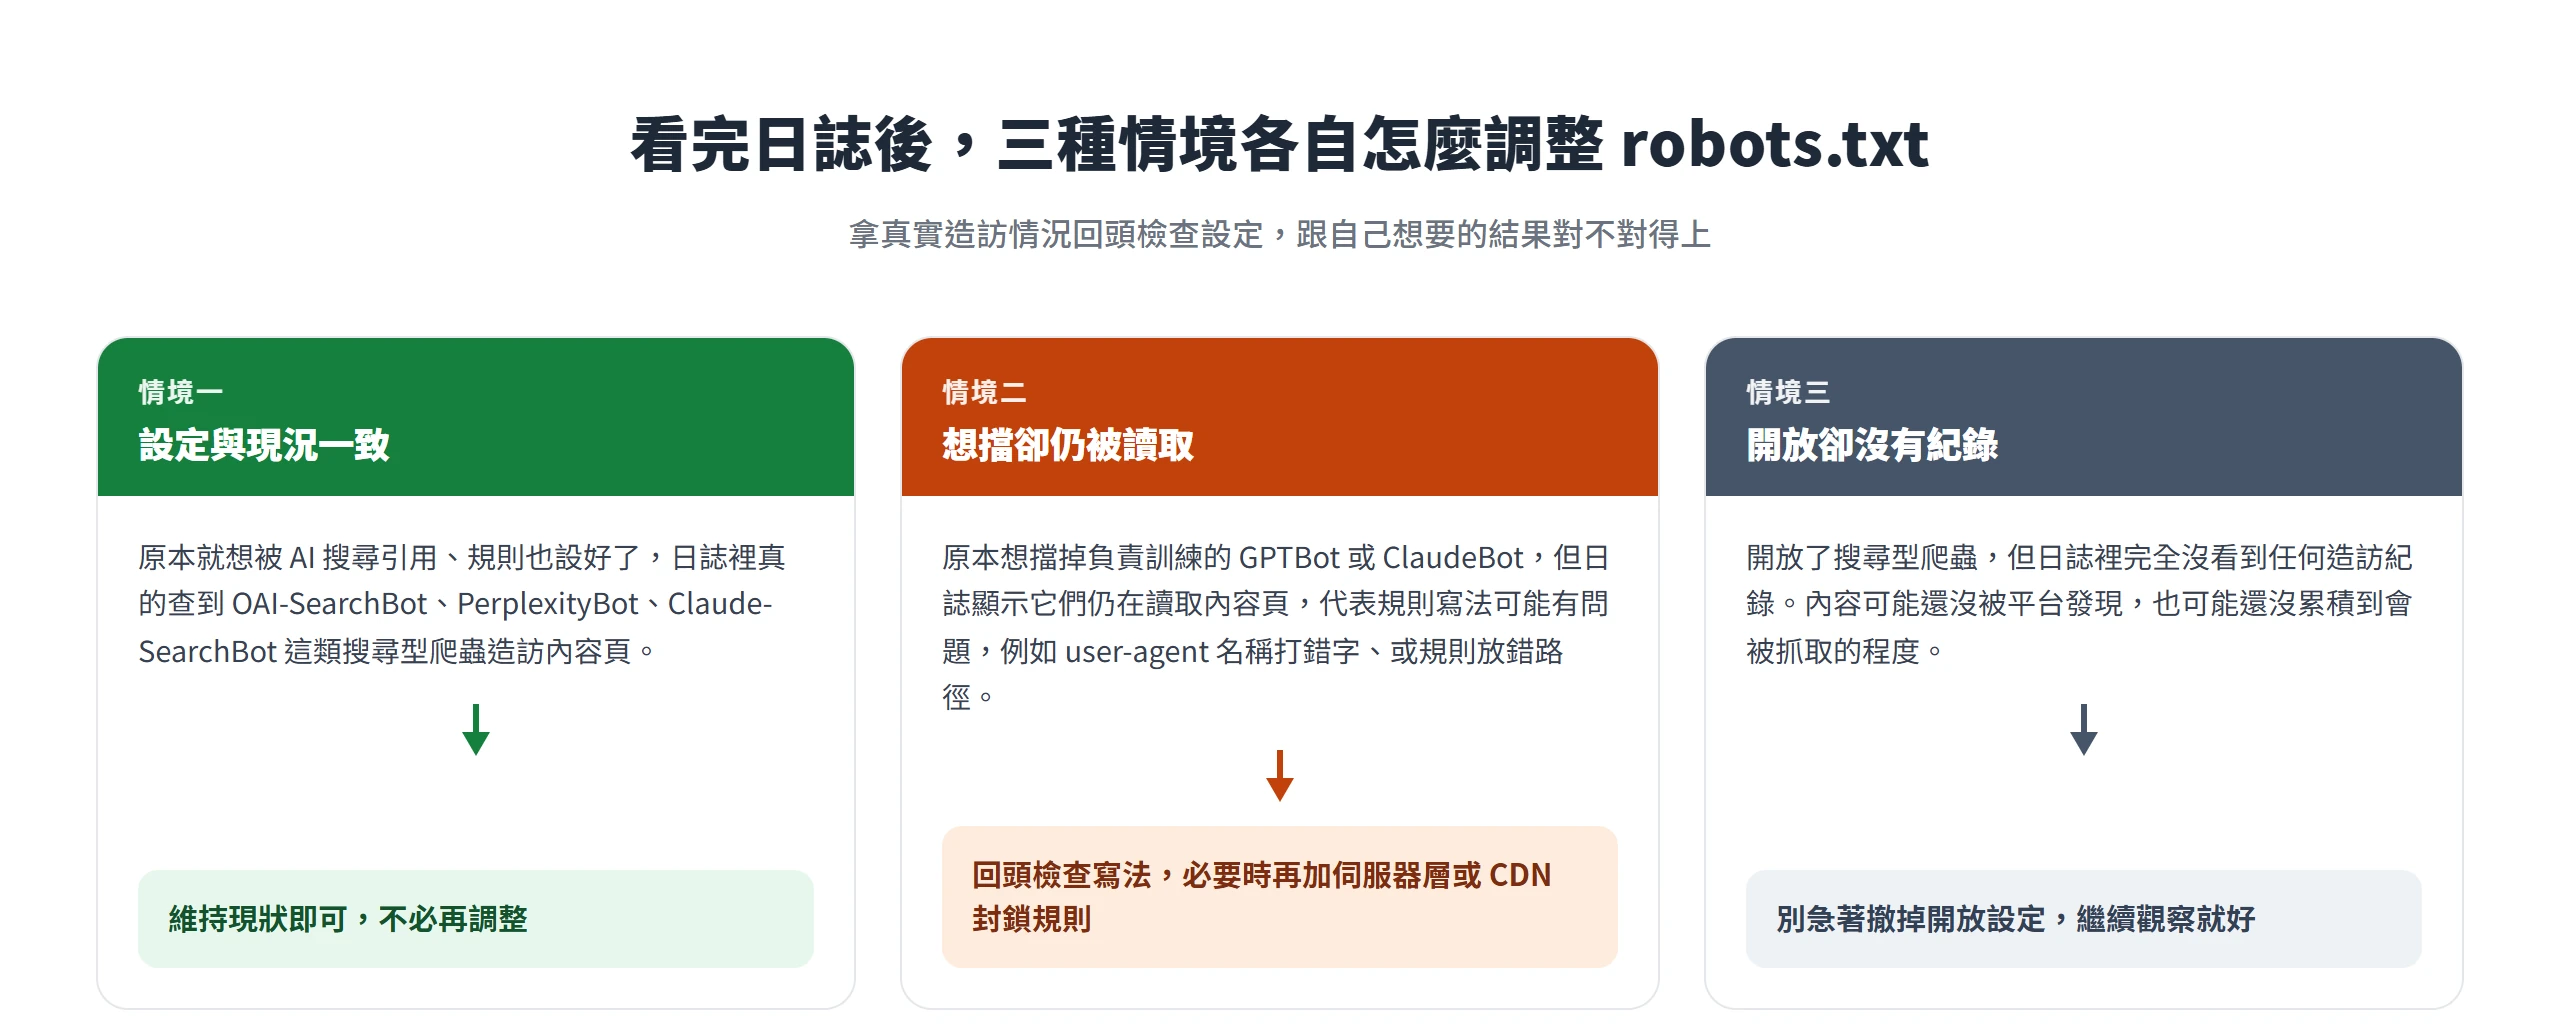
第一種情境,是原本就想被 AI 搜尋引用,也把規則設好了,日誌裡也真的查到 OAI-SearchBot、PerplexityBot、Claude-SearchBot 這類負責搜尋引用的爬蟲造訪內容頁,這代表設定跟現況一致,維持現狀即可,不必再調整。
第二種情境,是原本想擋掉負責訓練的爬蟲,像 GPTBot 或 ClaudeBot,但日誌顯示它們仍然在讀取內容頁,這代表 robots.txt 的規則寫法可能有問題,例如 user-agent 名稱打錯字,或規則放錯了路徑,需要回頭檢查;必要時再搭配伺服器層或 CDN 的封鎖規則加強,單靠 robots.txt 這份聲明式的告示,擋不住不理會規則的請求端。
第三種情境,是開放了搜尋型爬蟲,但日誌裡完全沒看到任何造訪紀錄,這時不必急著撤掉開放設定。內容可能還沒被該平台系統發現,也可能還沒累積到會被抓取的程度,比較合理的做法是繼續觀察,而不是把暫時沒來誤判成設定沒有用。
沒有主機權限時查核 AI 爬蟲造訪的替代做法
不是每個網站主都能拿到 cPanel 或 SSH 權限,有些網站託管在代管型服務裡,主機商完全不提供日誌下載。
如果網站掛在 Cloudflare 這類代理服務後面,前面提過的儀表板 Bot analysis 分頁就是現成的替代方案,不需要主機端日誌也能看到分類結果。完全沒有主機或 CDN 後台權限的情況下,最直接的做法是聯絡主機商或代管服務商,請對方協助提供或代查特定期間的原始存取紀錄。多數業者都能做到這件事,只是通常需要主動提出需求,主機商不會自己想到要給你這份資料。
robots.txt 能表達的只有立場,真正發生過的事情都留在伺服器日誌裡。把這份日誌定期調出來看一次,你會比多數只看 GA4 報表的網站主更早知道,自己開放的規則跟實際造訪的落差在哪裡,也才有機會在 AI 真的大量讀取內容之前,先確認這是不是自己想要的結果。