
多數人以為把資料備份好,網站出意外時就有底氣救回來。這句話只對了一半,備份保住的是資料本身,沒有處理「意外發生的那一刻,先救哪個系統、多久之內要救回來、由誰點頭啟動」這一整套判斷。這一層沒有寫下來,不少中小企業其實是靠臨時找人、臨時決定,賭事情不會挑在半夜或連假發生。
災難復原計畫(Disaster Recovery Plan,DRP)要處理的正是這一層。它不是另一份技術文件,而是一份寫清楚「誰在什麼時限內做什麼」的作業程序:先盤點哪些系統關鍵、訂出各自能忍受停多久,再把復原的具體步驟與決策權責都寫下來,讓備份真的在關鍵時刻派上用場。少了這一層,再完整的備份也可能因為沒人知道該不該動手、該聯絡誰而白白浪費掉。
災難復原計畫是什麼?備份之外還要準備的作業程序
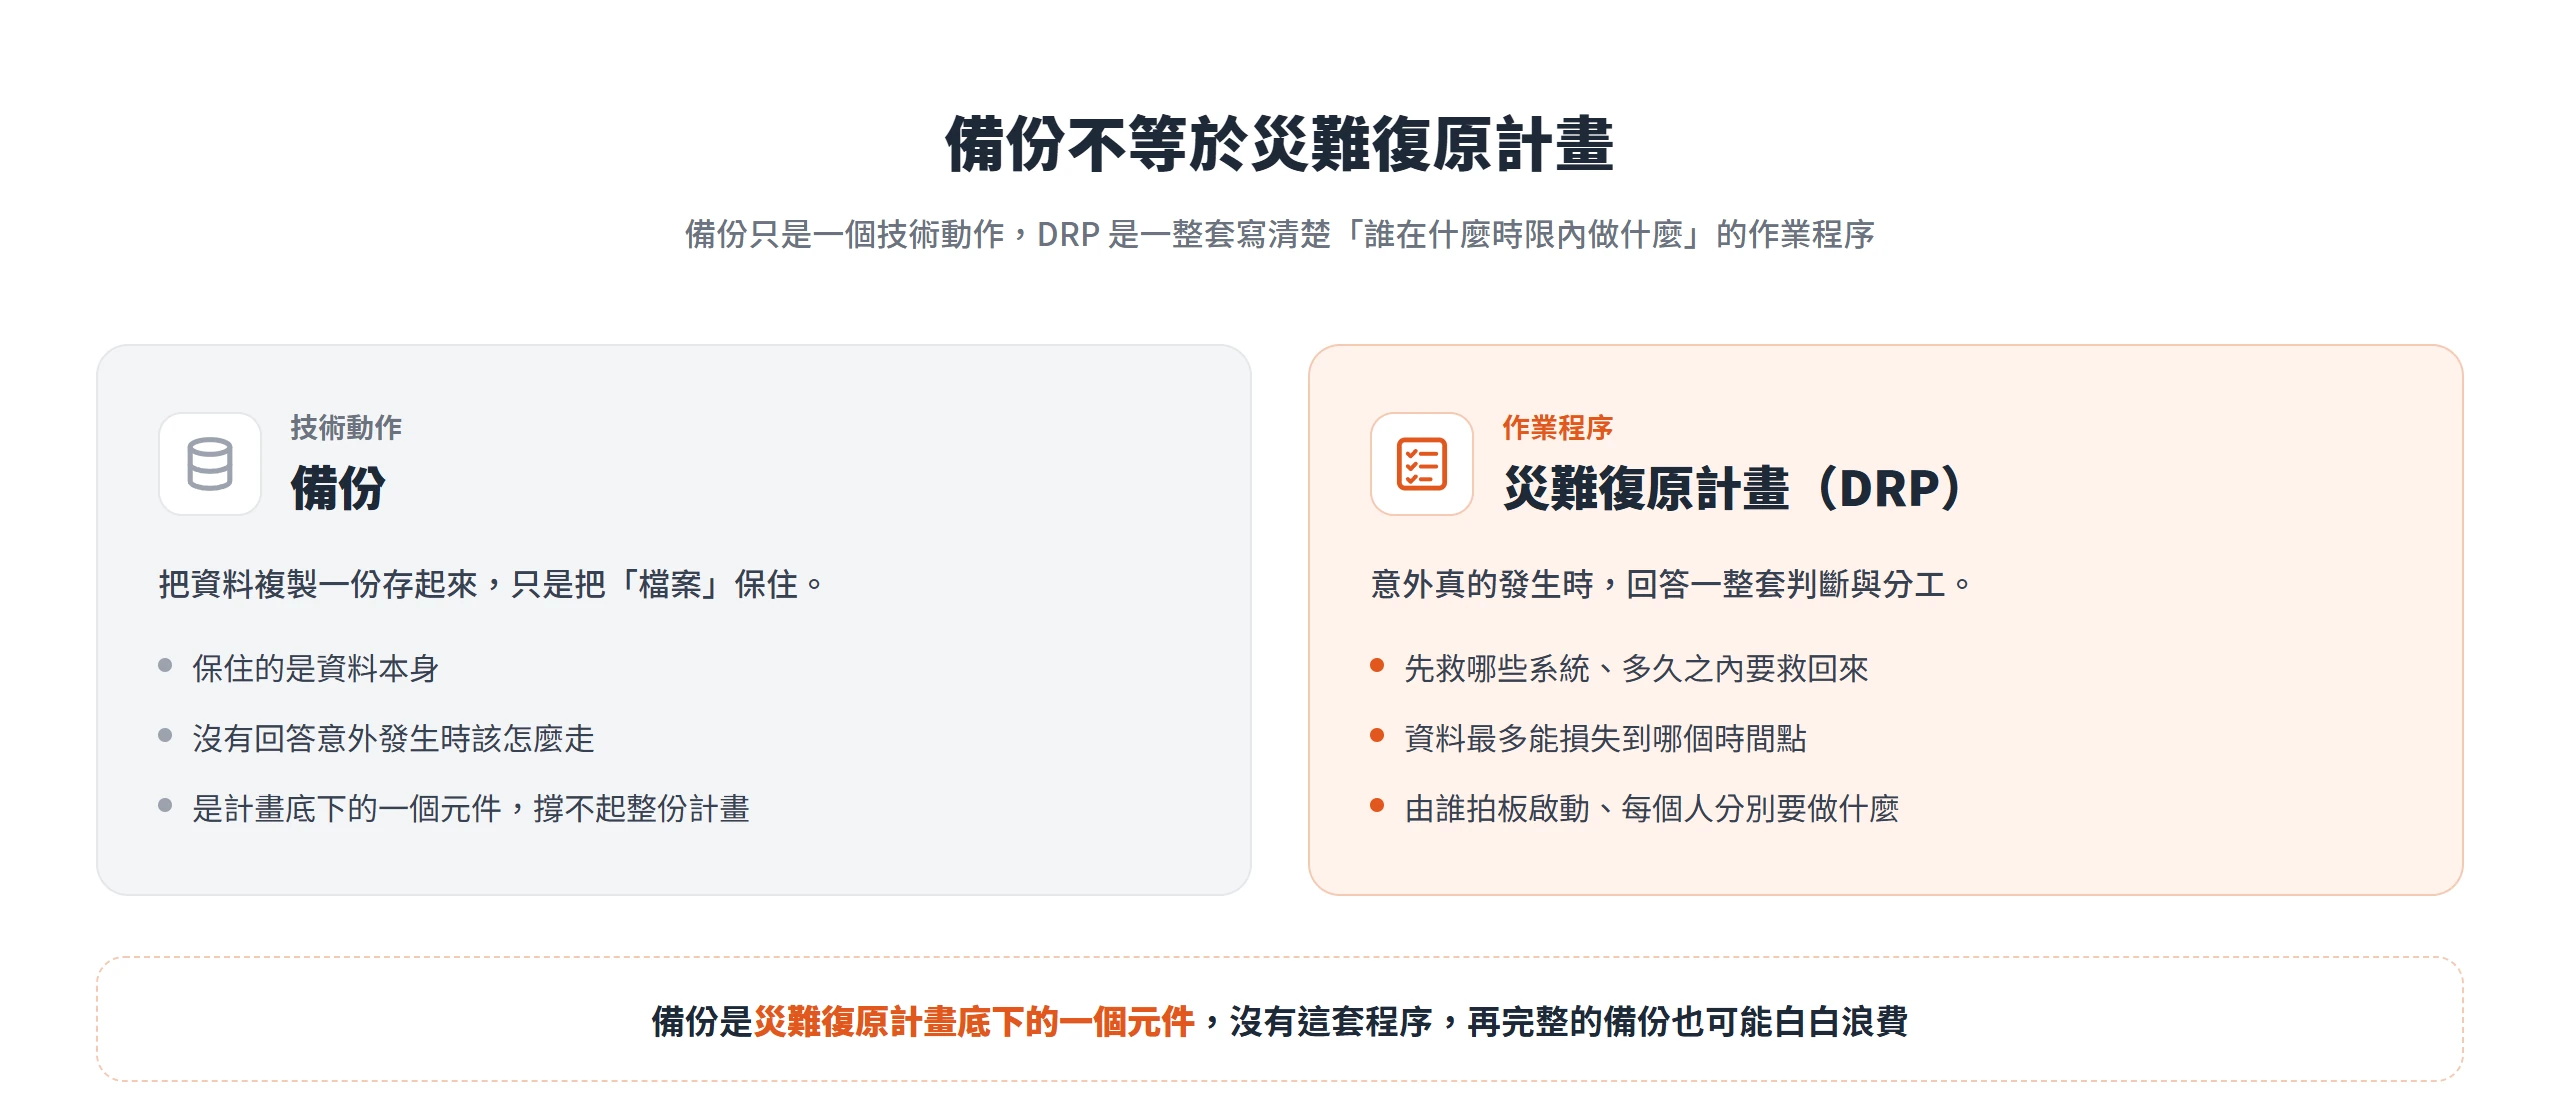
把「備份」跟「災難復原計畫」畫上等號,是多數中小企業對這件事最常見的誤解。備份只是一個技術動作,把資料複製一份存起來;DRP 則是一整套作業程序,回答的是意外真的發生時該怎麼走:先救哪些系統、多久之內要救回來、資料最多能損失到哪個時間點、由誰拍板啟動、每個人分別要做什麼。備份是這套計畫底下的一個元件,撐不起整份計畫。
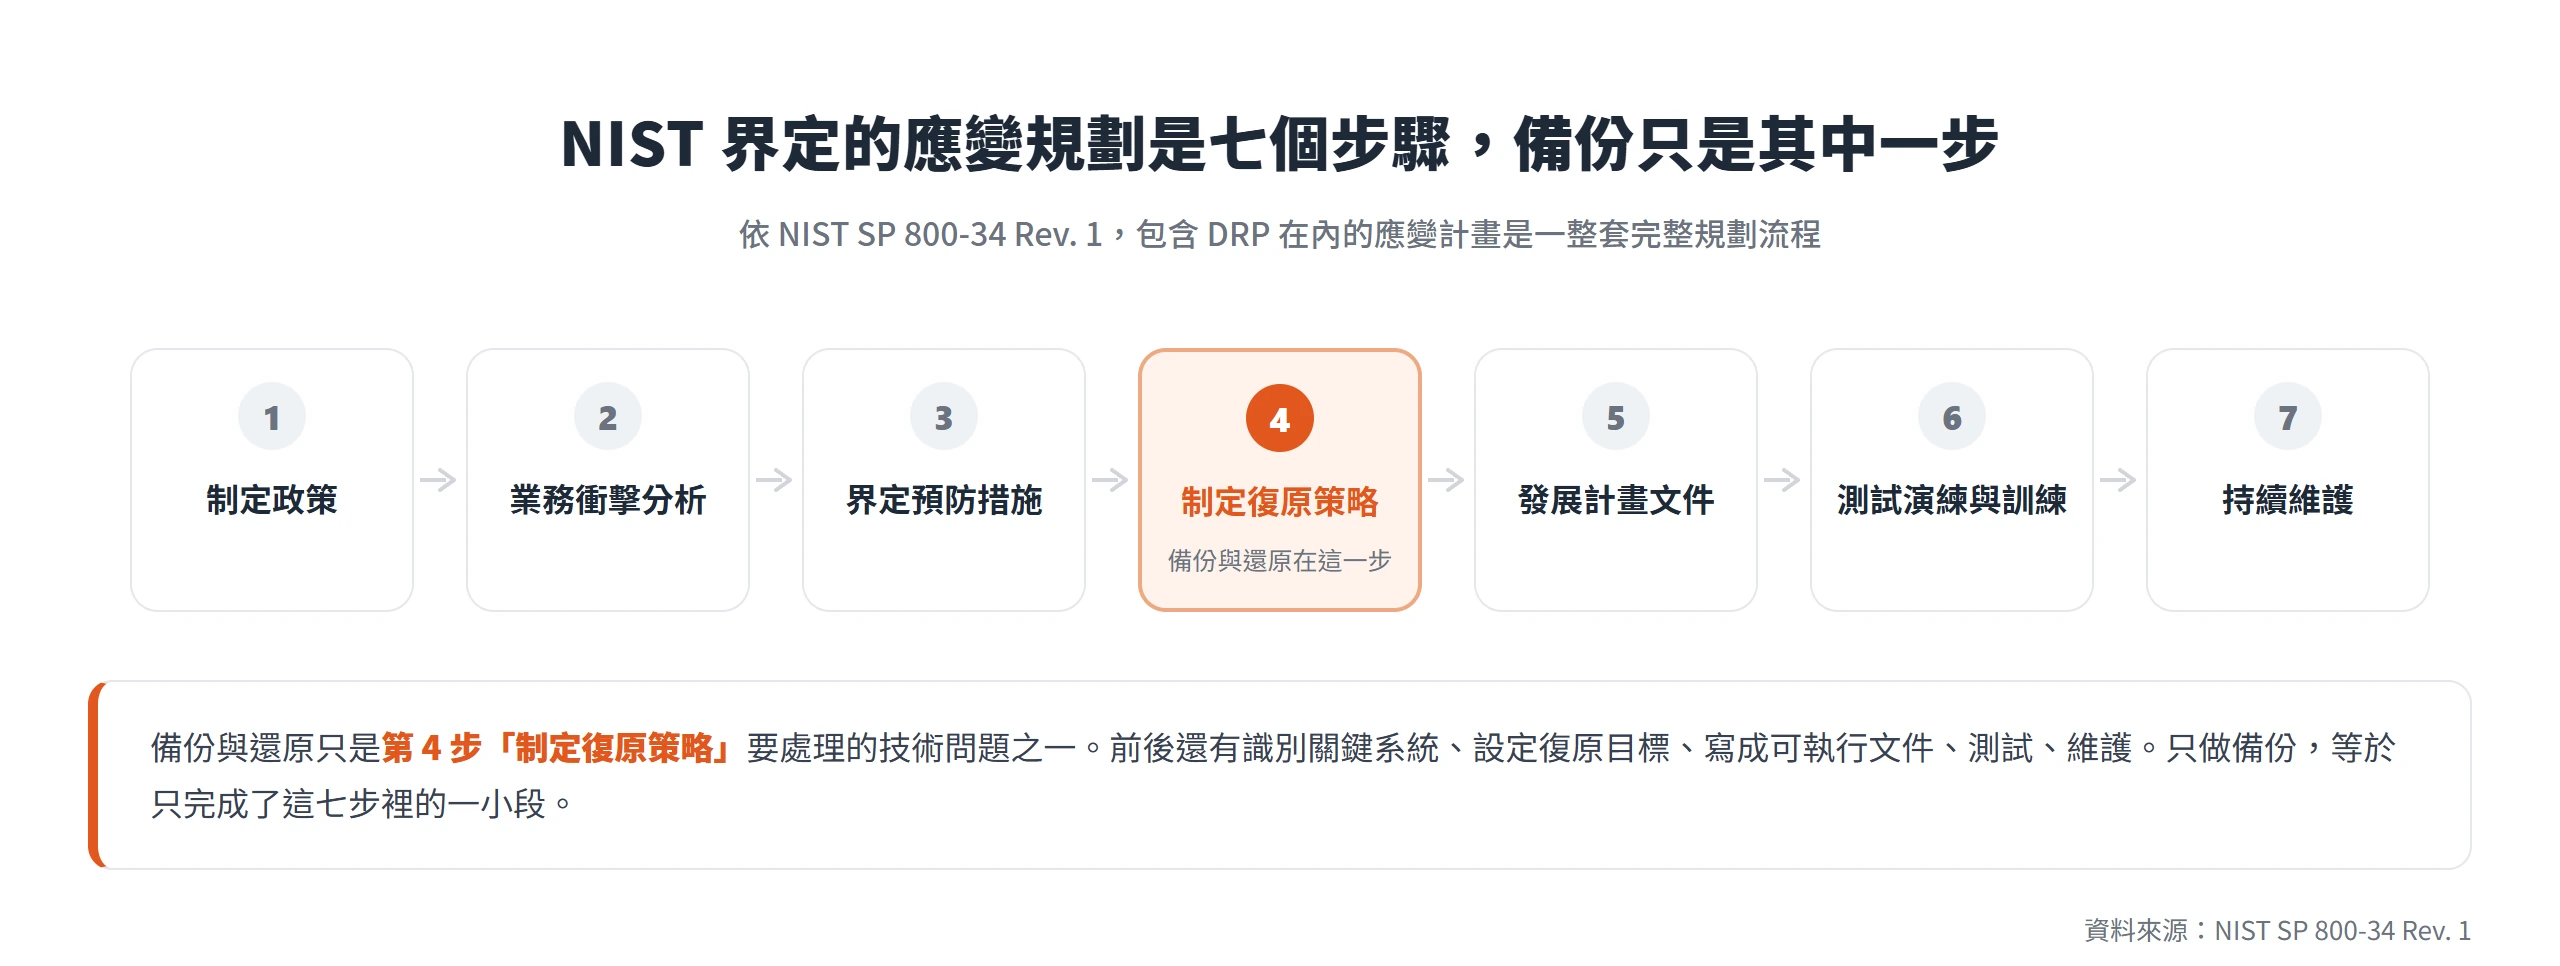
美國國家標準暨技術研究院(NIST)在《SP 800-34 Rev. 1》這份聯邦資訊系統應變規劃指引裡,把包含 DRP 在內的應變計畫定義成一套涵蓋 7 個步驟的完整規劃流程:制定政策、進行業務衝擊分析、界定預防措施、制定復原策略、發展計畫文件、測試演練與訓練、持續維護。備份與還原只是「復原策略」這一步要處理的技術問題之一,前後還有識別關鍵系統、設定復原目標、寫成可執行文件、測試、維護等步驟。換句話說,只做備份等於只完成了這 7 個步驟裡的一小段。
這也是為什麼 DRP 該被當成「營運持續」思維的技術落地,而不是另一份丟給工程師的技術文件。它回答的問題不是「資料有沒有存起來」,而是「公司多久之內能重新運作」,這件事牽涉到誰有權下決定、客戶怎麼被告知、金流怎麼確認沒出錯,不是單靠一套備份工具就能解決。
中小企業網站中斷,沒有大公司的備援人力能分攤
大公司出狀況時,通常還有其他部門、其他分店、備援的技術團隊可以先頂著。中小企業不是這樣運作的:常常是一個人,或極少數幾個人,同時身兼架站、維運與客服,懂後台的那個人一旦請假、離職或聯絡不到,整套系統就沒人能動。規模小不代表風險小,反而是「沒有備援人力」這件事本身就是風險,而且這個風險平常不會顯現,只有出事的那一刻才會被看見。
網站對多數中小企業來說往往是唯一或主要的對外接單與客服管道,沒有其他部門或分店可以先接手撐著。中小企業也因為沒有專職資安人力、防護相對薄弱,容易成為攻擊者眼中阻力最小的入口。這幾件事疊在一起,讓中小企業的網站中斷比大公司同樣的事件更難消化,也更需要事先寫好誰在什麼情況下要做什麼。
半夜或假日網站出狀況,通常只有一個人能處理
意外不會挑上班時間發生,半夜或連假期間網站掛掉,如果沒有事先寫好「誰要被叫醒、要做什麼」,往往要等到隔天上班才會發現,中間的營收與信譽損失已經造成。數位發展部資通安全署 2026 年 4 月發布的〈中小企業基本資安防護指引〉就指出,沒有專職資安人力的中小企業很容易成為阻力最小的入口,並具體舉例:一組重複使用的密碼、一台三年未曾更新的桌機,看似日常,卻可能讓一間企業整週無法接單出貨。
這句話點出的其實是同一個問題,平常沒人專職盯著,出事那一刻自然也沒人第一時間知道該怎麼辦。DRP 要解決的,就是把「半夜掛了誰負責」這件事提前寫下來,而不是等事情發生才在群組裡問「這個誰懂」。
官網、訂單、會員與信箱各自停擺的代價並不相同
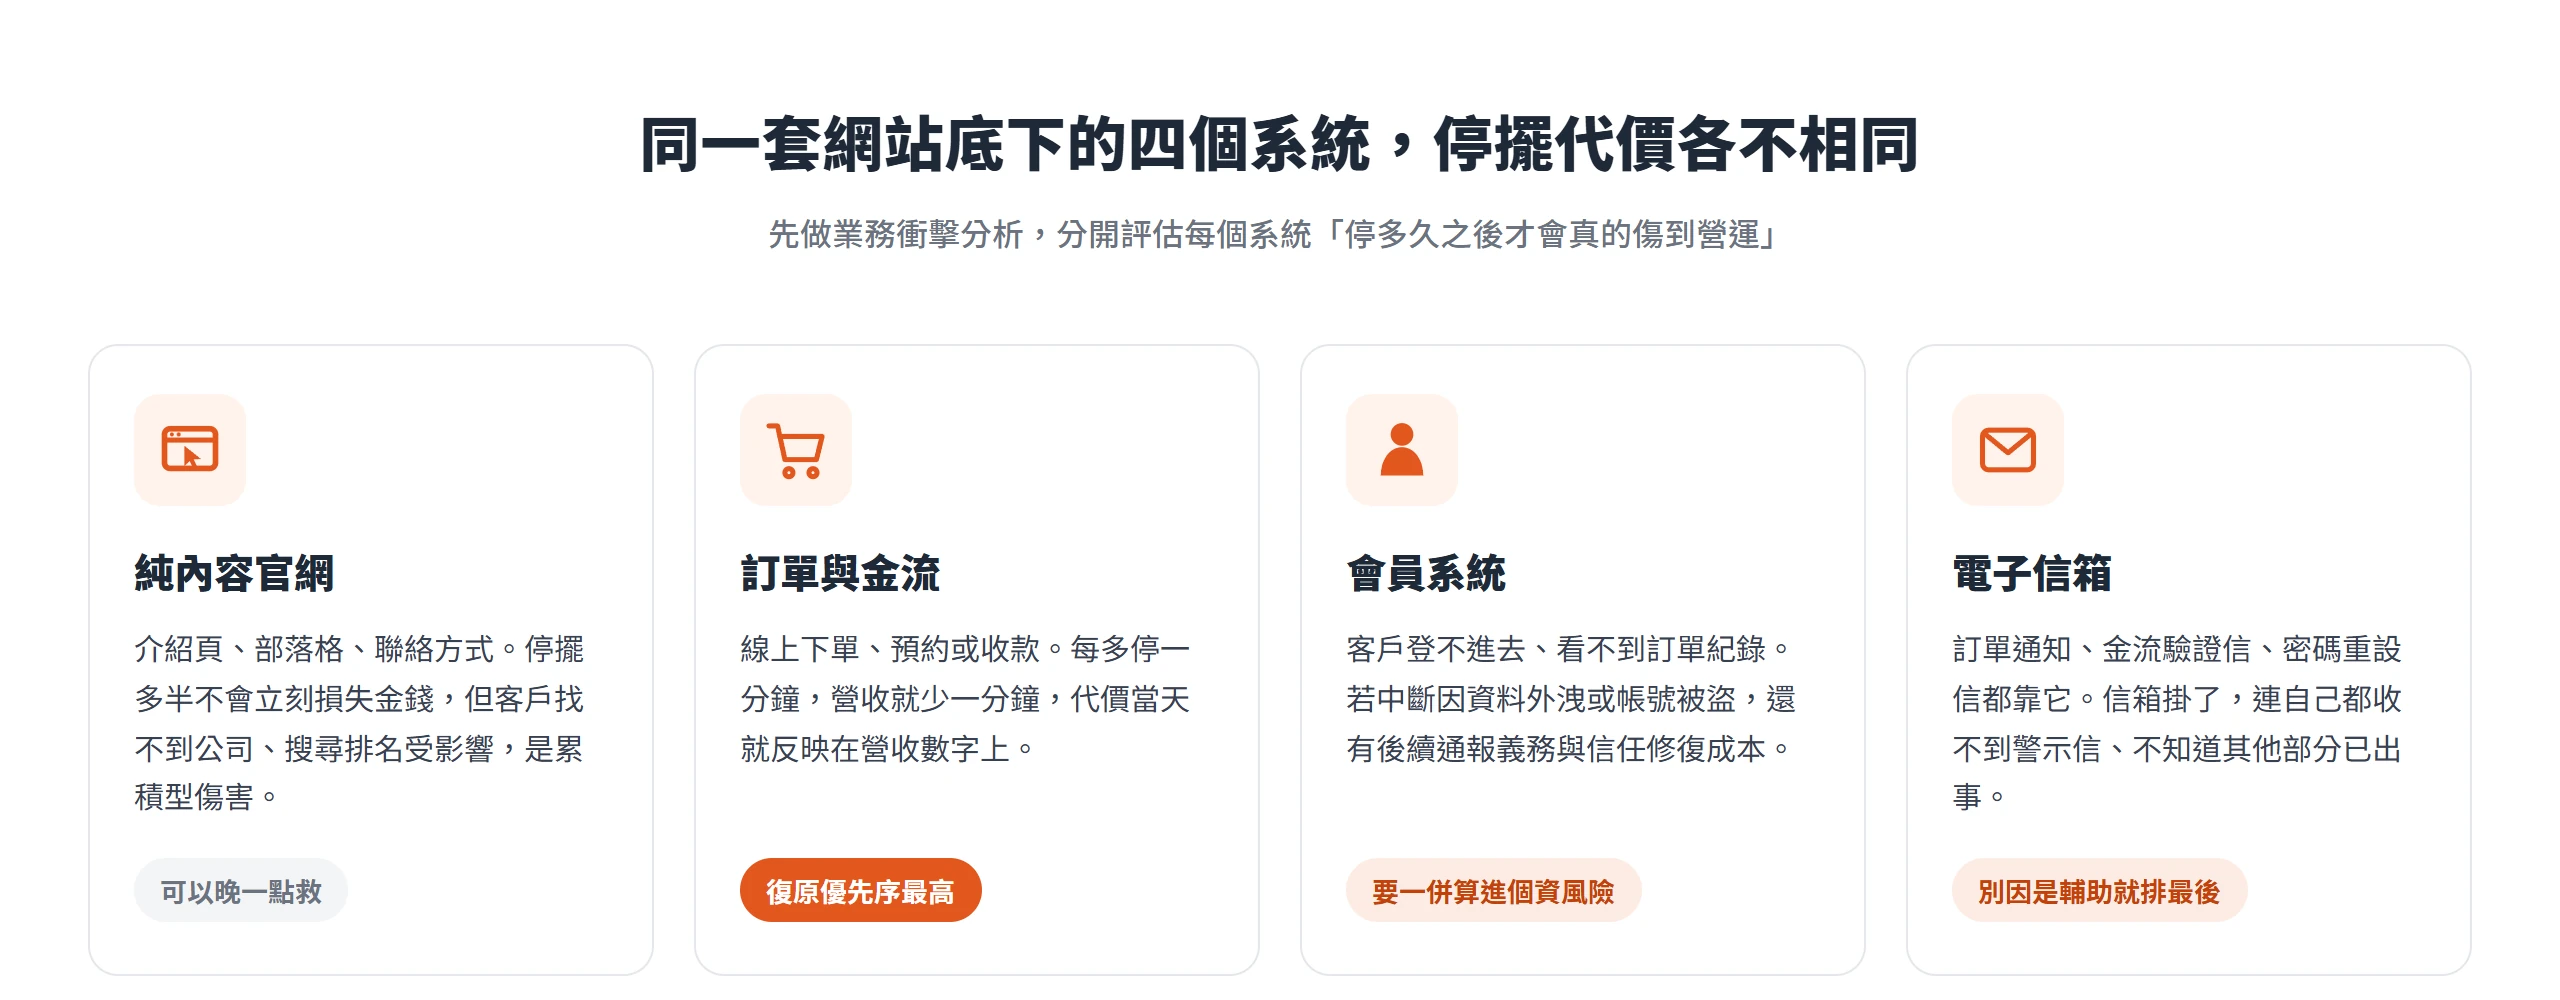
在訂復原目標之前,先要做一份簡化版的業務衝擊分析(Business Impact Analysis,BIA)。這一步問的不是「要不要備份」,而是「這個系統現在停了,公司會怎樣」。判準是「停多久之後才會真的傷到營運」,不是「哪個系統聽起來比較重要」這種主觀感覺,因為同一套網站底下其實藏著好幾個獨立系統,每一個停擺的代價與可以忍受的時間都不一樣,得分開評估才準。
NIST SP 800-34 Rev. 1 的 BIA 方法論指出,BIA 的目的是把資訊系統跟它支撐的業務流程連起來,逐一判斷「這個流程停了會有什麼後果、多快會出事、復原需要什麼資源」,最後產出一份「流程對系統」的優先順序表。系統之間的依賴關係也要標出來,舉例來說,訂單系統依賴的資料庫若復原較慢,訂單系統實際能恢復的時間就會被拖慢到資料庫的水準,這是規劃復原時間目標之前必須先做的一步。
官網中斷,首先傷到的是形象與導流
純內容型官網,也就是介紹頁、部落格、聯絡方式這類頁面,停擺多數情況下不會立刻造成直接金錢損失,但會讓客戶找不到公司、搜尋排名受影響、原本在考慮下單的人轉頭找別家。這種影響是累積型的,不是當下爆炸型的,這也是為什麼它通常可以排在「可以晚一點救」的等級。
訂單與金流系統中斷最先反映在營收數字上
只要網站有線上下單、預約或收款功能,這個系統的中斷就是每多停一分鐘、營收就少一分鐘的直接損失。這類系統通常是全站裡復原優先順序最高的一塊,也是復原時間目標與復原點目標要設得最緊的地方,因為停擺的代價會直接反映在當天的營收數字上,不需要等一週才看得出來。
會員系統牽涉個資保護,停擺代價不只是不方便
會員或登入系統除了功能面的不便,比如客戶登不進去、看不到自己的訂單紀錄,背後還牽涉個人資料保護。如果中斷的原因是資料外洩或帳號被盜,代價就不只是暫時不能用,還有後續的通報義務與信任修復成本。判斷這一塊的優先順序時,要把這層風險一併算進去,不能只看功能面的影響。
電子信箱停擺等於切斷對外聯繫與各種驗證通知
企業信箱是最容易被忽略的一環,但訂單通知、金流驗證信、客戶回信,甚至其他系統的密碼重設信都靠它運作。信箱掛了往往不只是少了一個溝通管道,更麻煩的是連自己都不知道網站其他部分已經出事,因為連警示信也一起收不到。這也是為什麼企業信箱值得單獨拉出來評估,不能因為它看起來只是輔助工具就排在最後面。
為每個系統訂出 RTO 和 RPO,數字要能落地
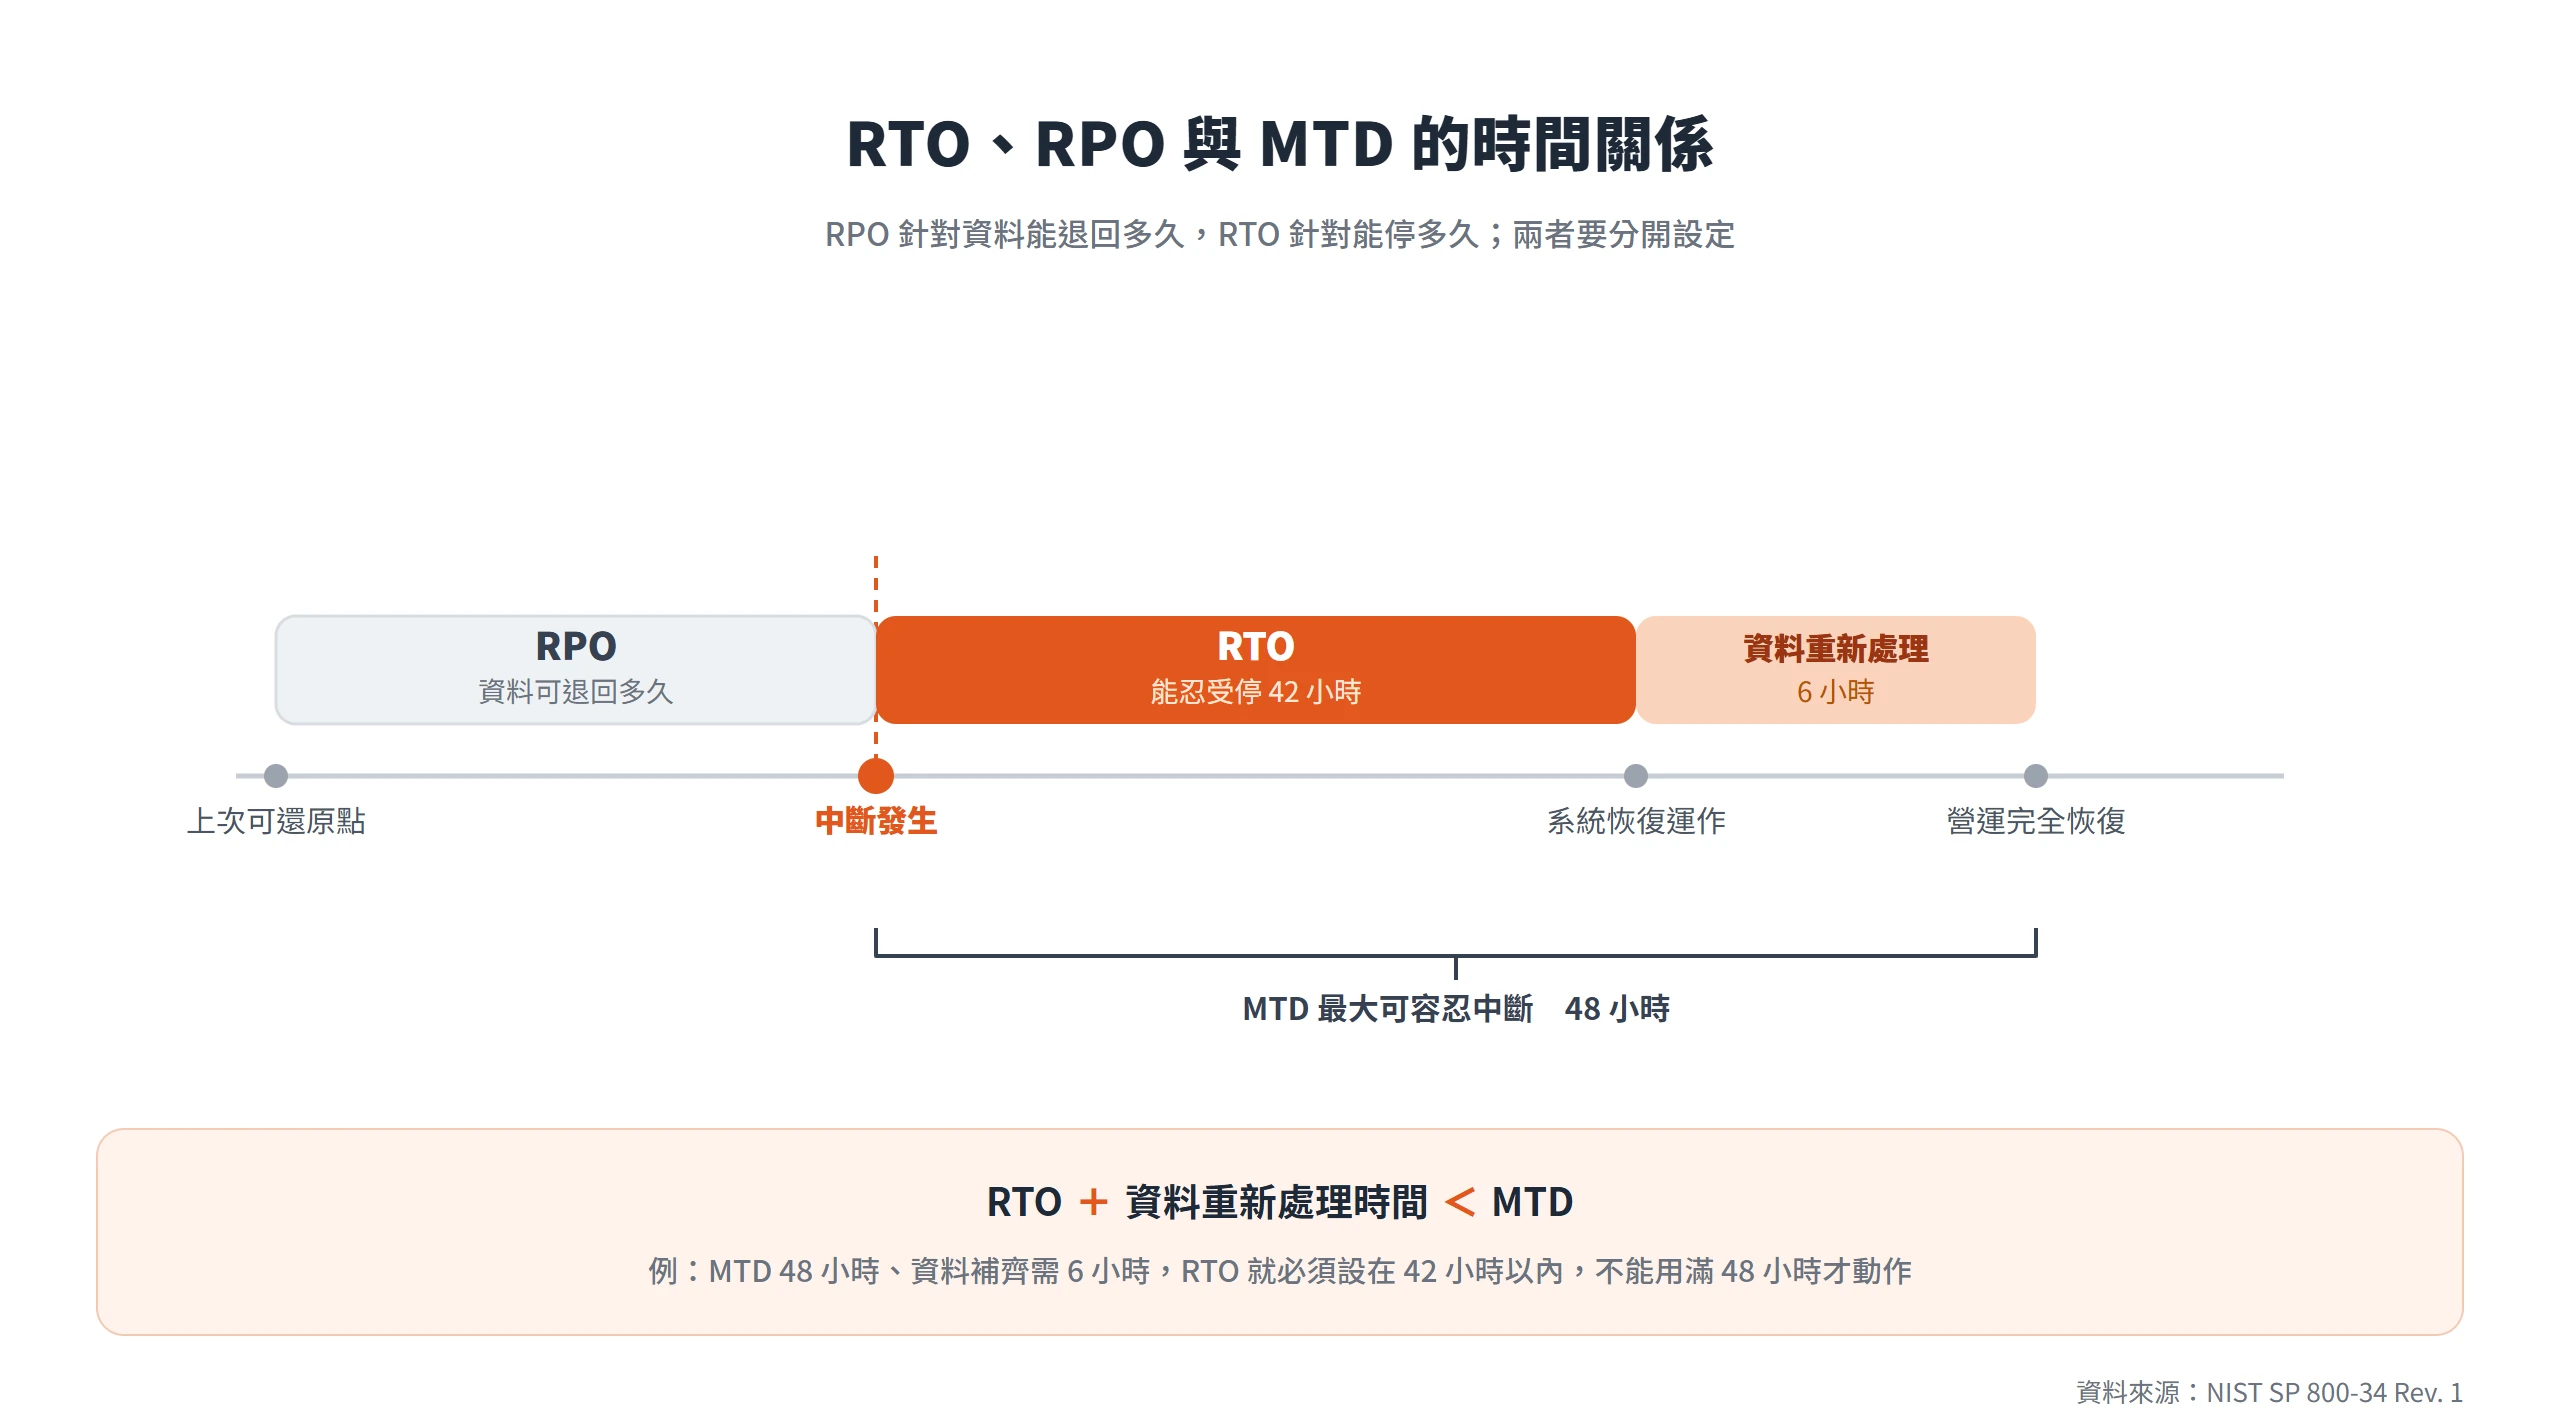
把上一節排出的優先順序,換成兩個具體數字,是這一步要做的事:復原時間目標(Recovery Time Objective,RTO),也就是能忍受停多久;以及復原點目標(Recovery Point Objective,RPO),也就是能接受資料退回到多久以前的狀態。兩者要分開設定,也不能每個系統都設成「越短越好」,重點是從「多停一小時會虧多少」反推出合理的目標,而不是憑感覺定數字。
NIST SP 800-34 Rev. 1 對 RTO 與 RPO 的關係有明確界定:RTO 是特定系統資源可以中斷多久,而不至於超過最大可容忍中斷時間(Maximum Tolerable Downtime,MTD);RPO 則是純粹針對資料,衡量復原當下資料最多可以退回到多久以前。兩者的關係是,RTO 加上復原後的資料重新處理時間,必須小於 MTD。舉例來說,如果 MTD 是 48 小時,復原後還需要 6 小時把資料補齊,RTO 就必須設在 42 小時以內,不能整整用滿 48 小時才開始動作。
同一份文件也提出了成本平衡點的概念,主張中斷持續得越久,對企業造成的損失越大;但把 RTO 與 RPO 設得越短,需要投入的復原基礎設施成本也越高,兩條曲線的交會點才是該系統合理的目標,不是無限逼近零。找到公司真正付得起、也真正需要的那個點,比追求「每個系統都要最快」更務實。
建置成本隨 RTO、RPO 縮短而墊高
越快、越即時不是免費的。把 RTO 壓到接近零,代表要有隨時可以接手的備援環境,不能只靠單純的備份檔案;把 RPO 壓到接近零,代表資料要接近即時同步,而不是定期備份就夠。中小企業多數系統不需要衝到這個等級,重點是先把系統分好等級,把有限預算放在真正撐不起停擺的那一兩個系統上,其餘系統可以接受相對寬鬆的目標,把資源留給真正吃緊的地方。
復原步驟要寫成任何人都能照做的清單
有了優先順序與 RTO、RPO 目標之後,接下來要把「真的發生事情時,具體怎麼做」寫下來,而不是停留在某個人的腦子裡。這份清單要寫到換一個沒那麼熟系統的人來看,也能照著執行的細節程度:去哪裡拿最近一份備份、換主機的流程是什麼、網域名稱系統(DNS)要去哪裡改、誰有那些帳號的存取權限。這裡的 3-2-1 備份原則,也就是 3 份備份、2 種媒介、1 份異地,是這整份清單能成立的前提;清單真正要補上的,是備份做完之後、沒人寫下來的那段執行細節。
不同的中斷原因,復原的第一步並不一樣,設備故障、被入侵、人為誤刪這三類要分開寫清楚,混在一起寫反而讓現場的人不知道該從哪一步開始。數位發展部資通安全署 2026 年 7 月發布的〈資安事件應變處理行動指引〉,把資安事件的應變程序拆成準備階段、偵測與應變處理、通報與外部溝通、復原與持續改善四個核心階段,並針對中小企業最常見的六種威脅情境,也就是設備受感染異常、帳號被盜、網路釣魚、商業支付詐欺、勒索軟體攻擊、阻斷服務攻擊,分別提供處理重點,設計給非技術背景的中小企業人員也能照著操作。
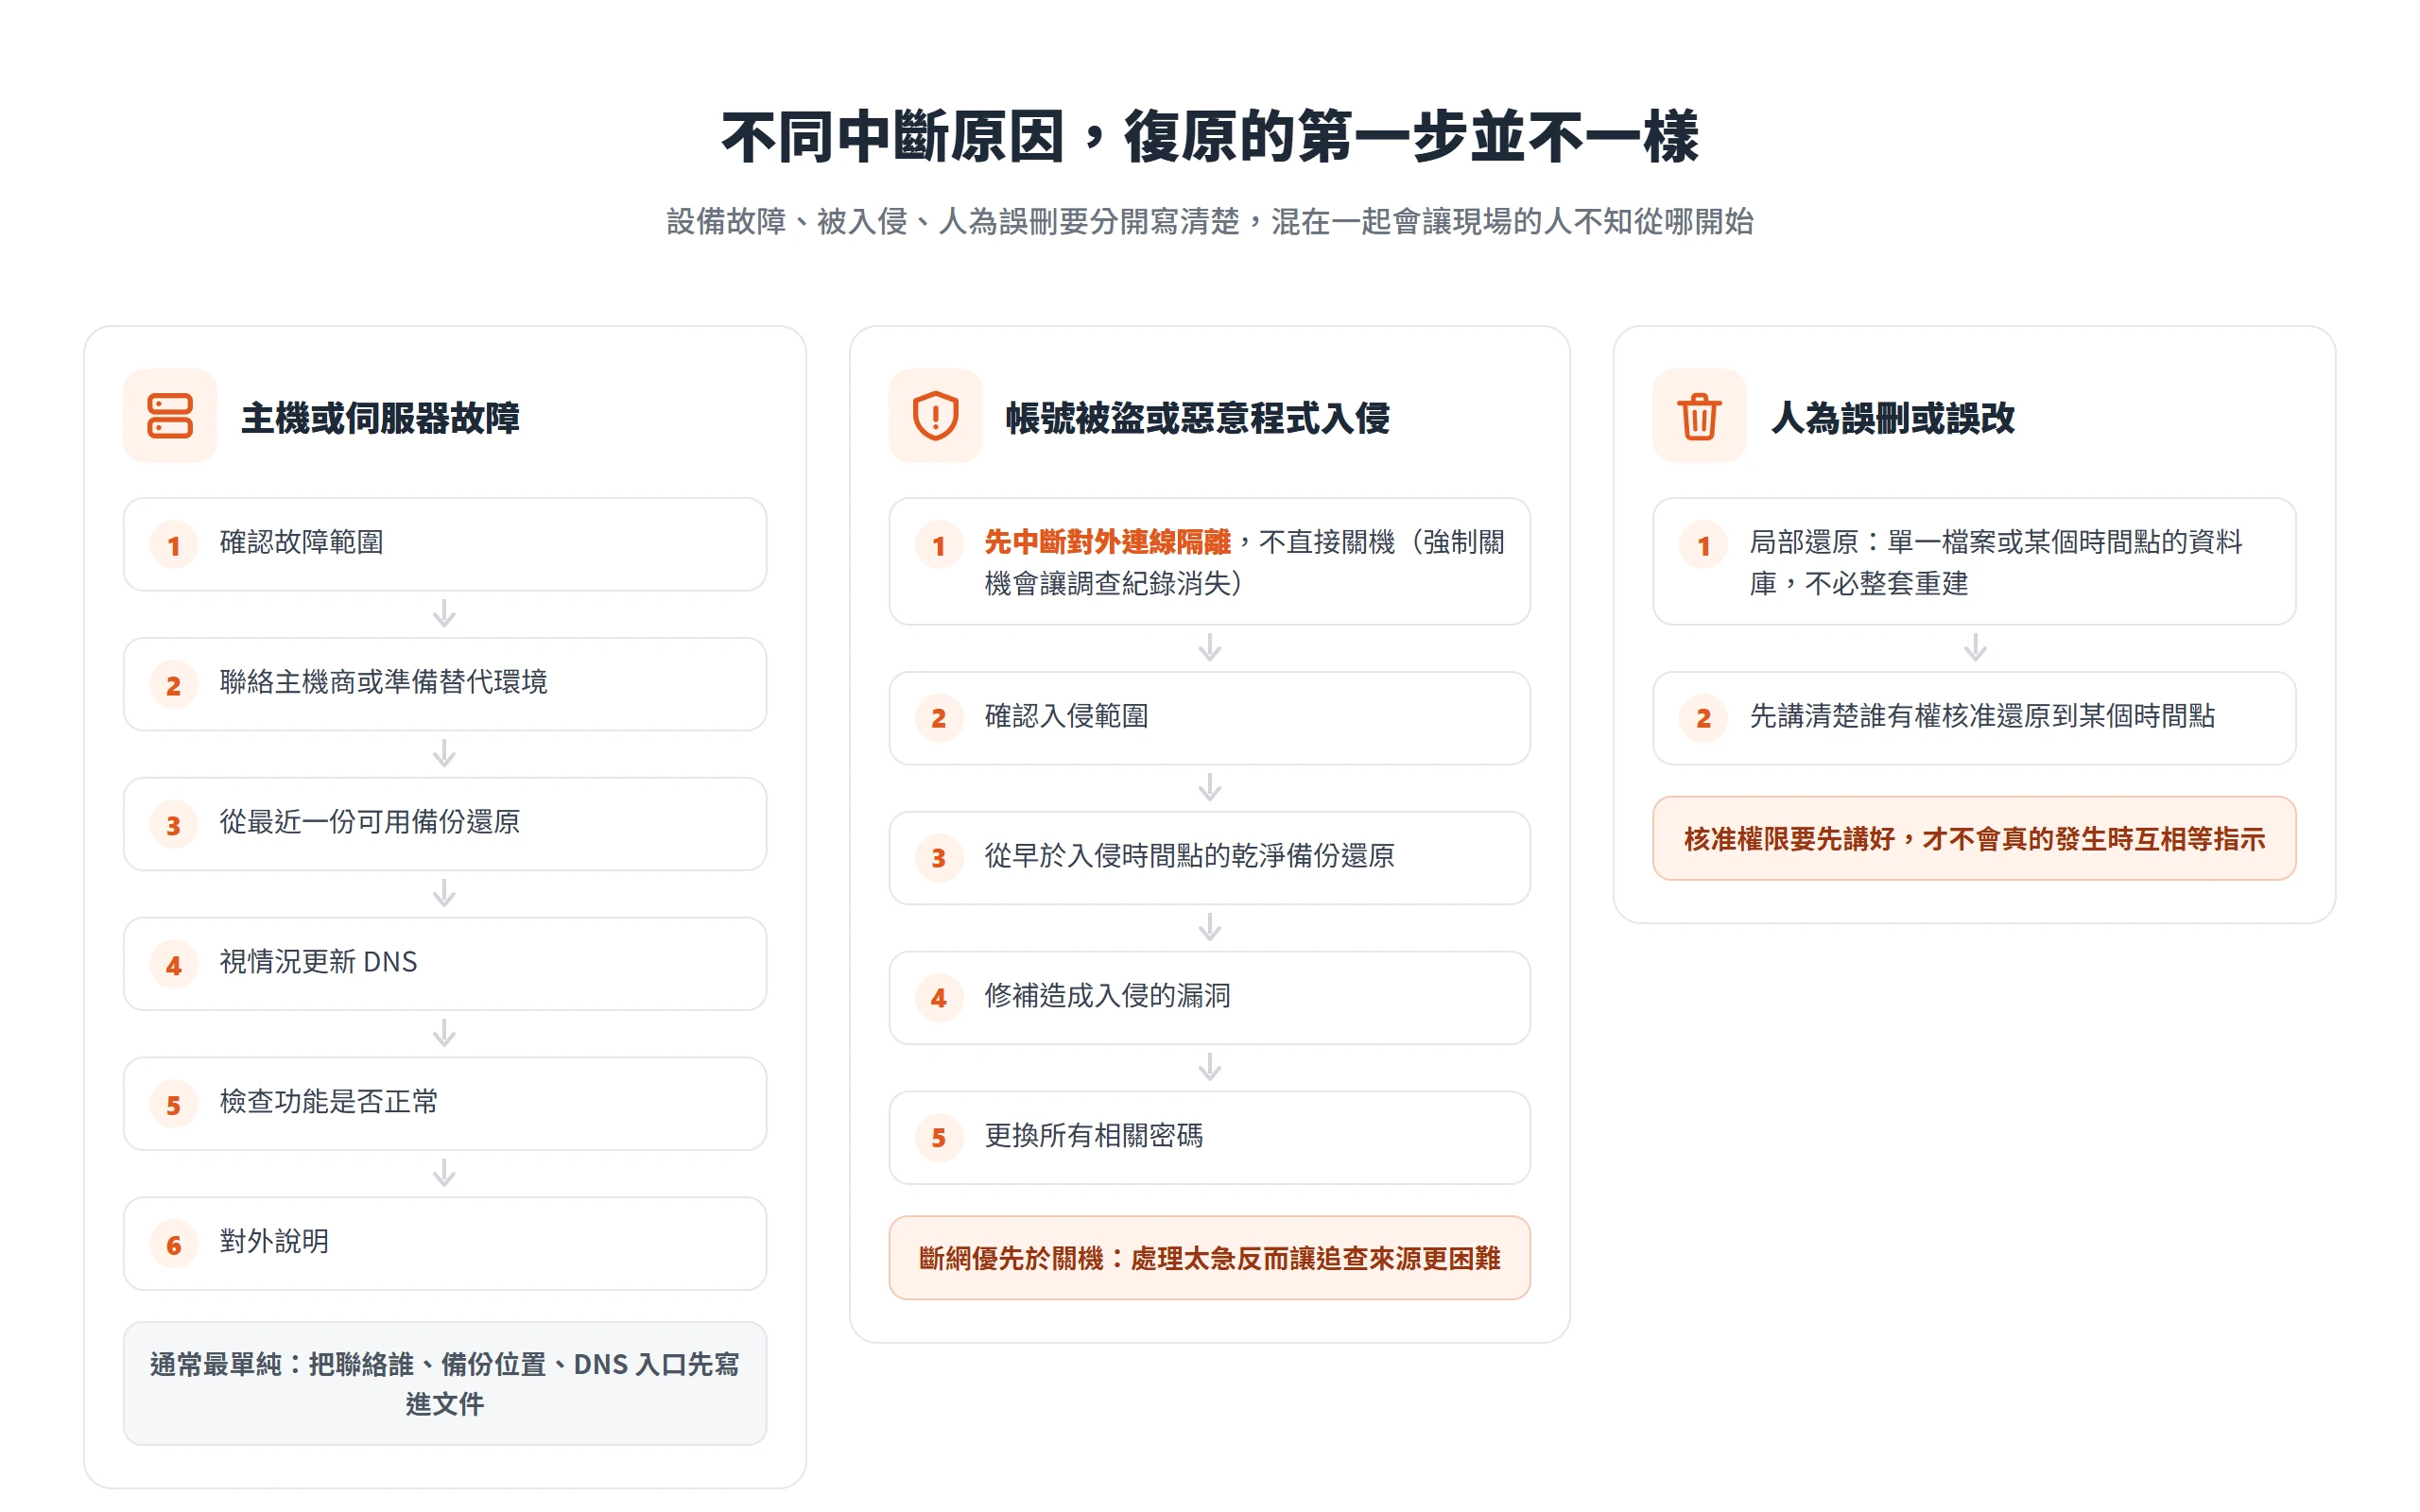
主機商或伺服器故障的復原順序
這類狀況通常最單純,順序是先確認故障範圍,接著聯絡主機商或準備替代環境,再從最近一份可用備份還原,視情況更新 DNS,然後檢查功能是否正常,最後對外說明。重點是把聯絡誰、備份存放位置、DNS 管理入口這些具體資訊先寫進文件,真的發生事情時不必臨時去翻信箱找帳號密碼。
帳號被盜或惡意程式入侵,斷網優先於關機
這類跟單純硬體故障不一樣,第一步不是急著修復,而是先隔離、留住線索。應該先中斷該系統對外連線,而不是直接關機,因為強制關機可能讓調查所需的紀錄跟著消失。接著才是確認入侵範圍,從一份確定乾淨、早於入侵時間點的備份還原,修補造成入侵的漏洞,並更換所有相關密碼。這個順序的關鍵在於,處理得太急反而可能讓後續追查入侵來源變得更困難。
人為誤刪或誤改的復原方式與核准權限要先講好
員工不小心刪錯檔案、改壞設定,是最常見卻最容易被忽略的一類。這類復原通常只需要局部還原,也就是單一檔案或某個時間點的資料庫,不必整套重建,但要先講清楚誰有權限核准還原到某個時間點,避免真的發生時大家互相等指示,反而拖慢了原本很簡單的復原動作。
啟動復原的決策權,要在平時就指定好
整份計畫最容易被忽略的一塊,是技術上知道怎麼還原,不代表知道現在該不該啟動。要先指定誰有權宣告啟動復原程序,通常是負責人或明確授權的代理人,內部要在多久之內讓誰知道,需要對外溝通客戶、合作的金流或銀行、主機商時由誰負責發言。這不只是資訊人員的責任,而是經營決策層級要親自參與、平時就核可過的事,事件發生的當下才能立刻跨部門調度資源。
數位發展部資通安全署〈資安事件應變處理行動指引〉建議企業訂出具體的應變里程碑時限:內部初步通報建議在 15 分鐘內完成,1 小時內陳報管理階層;若事件涉及金流詐欺,應把握 30 分鐘內聯繫銀行圈存匯款。指引同時強調資安治理不再只是資訊部門的單一責任,而是公司經營決策階層的核心商業治理責任,企業的應變計畫必須由管理階層親自參與審查與核可,事件發生時才能跨部門調度資源、妥善即時應處。
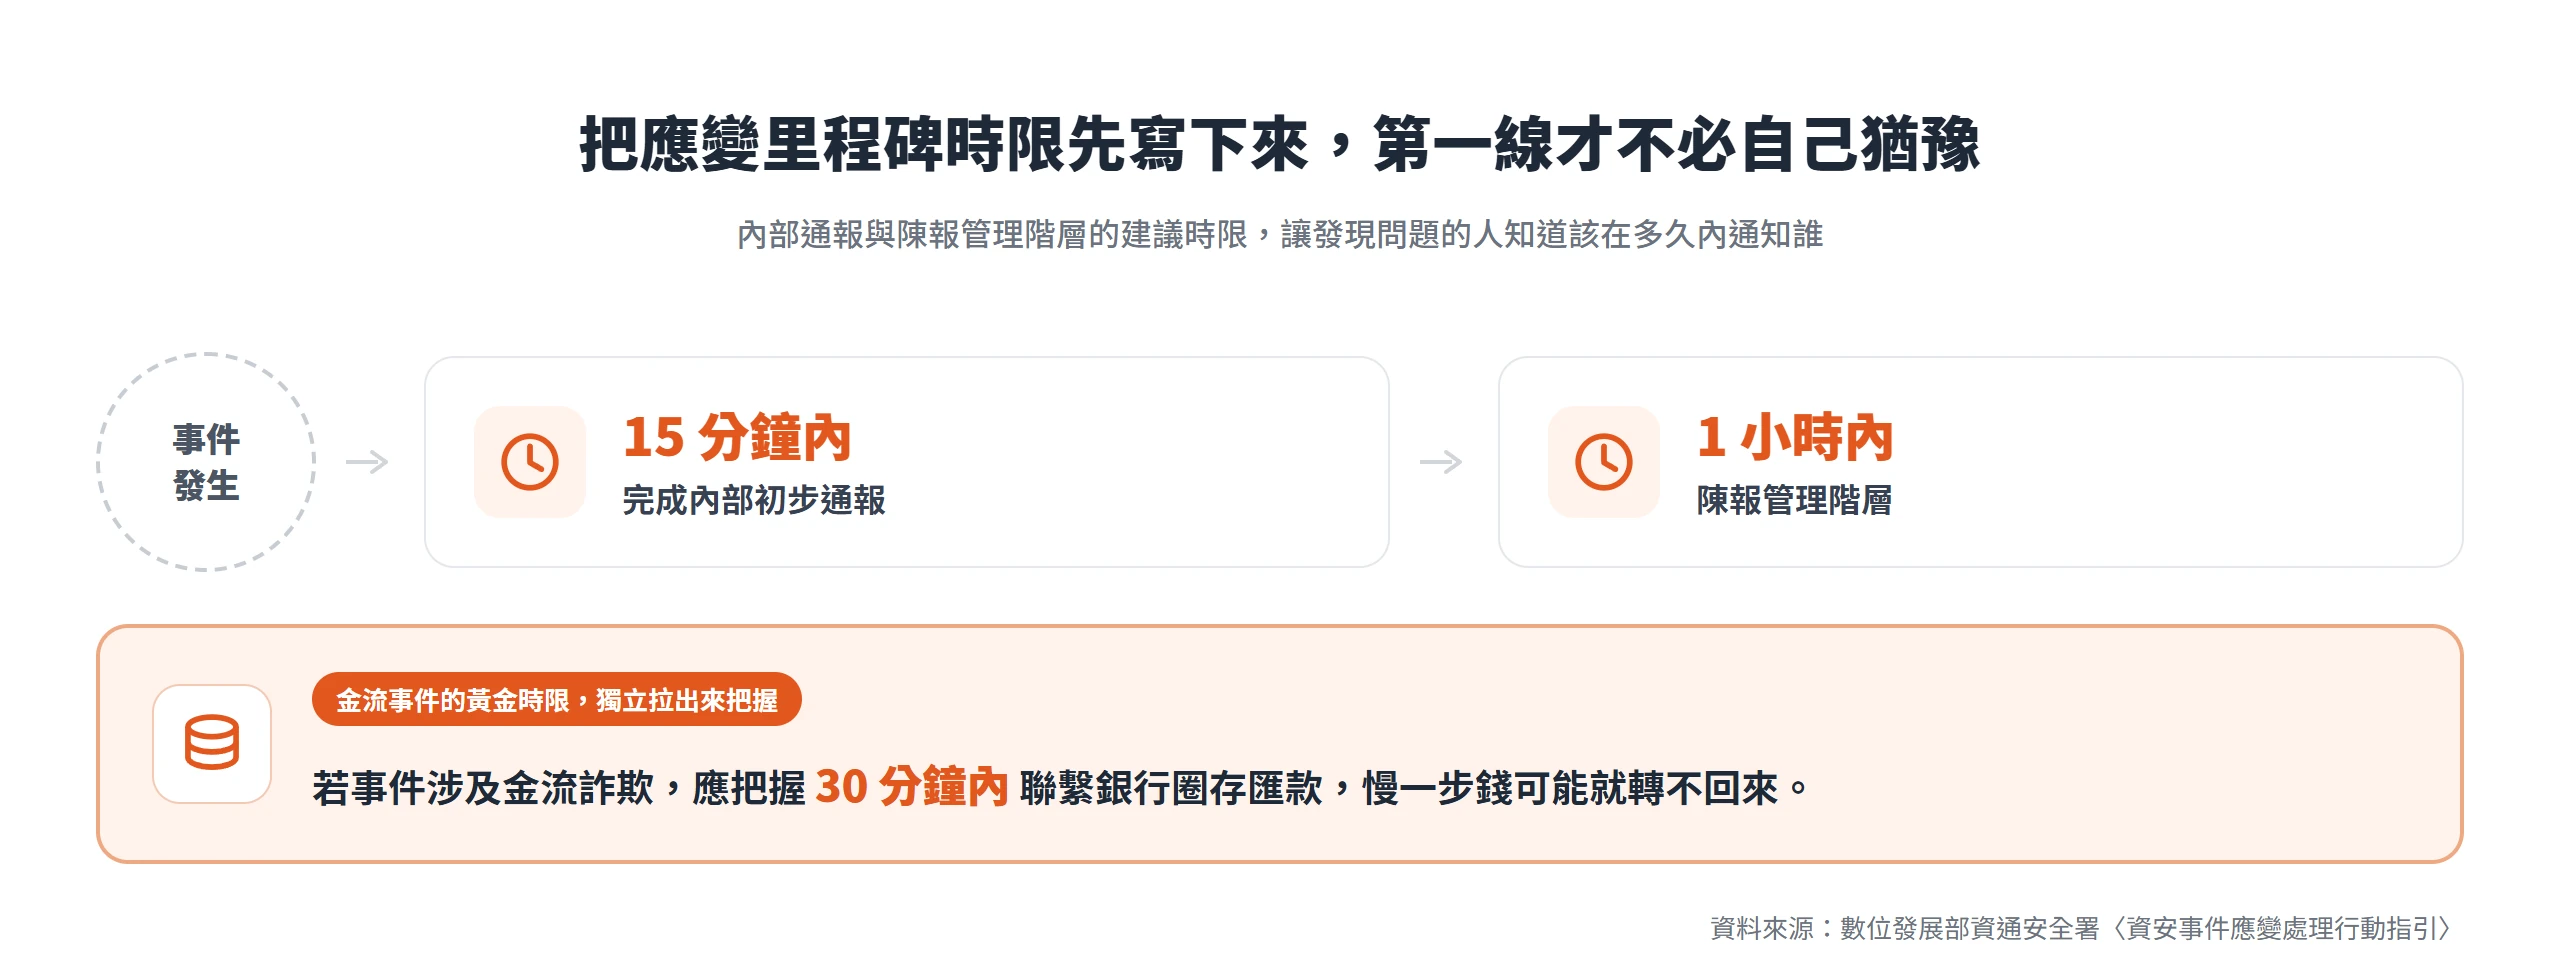
內部通報與陳報管理階層的建議時限
15 分鐘、1 小時這兩個數字,重點不在於它們對每家公司都剛好合用,而是要有一個寫下來的時限,讓第一線發現問題的人知道自己該在多久內通知誰,不必自己判斷這件事嚴不嚴重、要不要吵醒負責人。少了這個時限,第一線的人往往會多想一步、多等一下,而這一等就是復原時間被拖長的開始。
金流相關事件要另外把握的圈存時限
如果中斷牽涉到金流,比如訂單系統被入侵、疑似有異常扣款或轉帳,就要把「30 分鐘內聯繫銀行圈存匯款」這個動作特別拉出來強調。這類事件的黃金處理時間比一般系統復原短得多,慢一步錢可能就轉不回來,值得在計畫裡獨立寫成一條,而不是混在一般復原步驟裡容易被漏掉。
沒有演練過的復原計畫等同紙上談兵
計畫寫完不代表真的能用。文件裡假設備份是好的、聯絡人接得到電話、還原花的時間符合 RTO,這些假設沒有實際測試過,往往在真正出事時才發現不成立。演練不是走過場,而是用來找出計畫裡的漏洞,比如聯絡人早就離職、備份其實沒有真的可還原,這些問題只有實際跑一次才會浮現。
演練可以分層次做:從對著文件討論每一步做不做得到,到真的把備份還原到測試環境、實際計時,難度與投入的資源逐步拉高。Uptime Institute 這個國際數位基礎設施研究機構在 2025 年發布的〈Annual Outage Analysis〉指出,近三年內近 4 成組織曾因人為疏失發生重大停機事故,其中 85%源自員工未遵循既定程序,或流程本身設計有缺陷,而且這個比例逐年上升。這個數字說明,多數因人為疏失造成的長時間停機,根源不是技術不到位,而是計畫沒被驗證過、程序沒被真正遵守,這正是定期演練要解決的問題。數位發展部資通安全署〈資安事件應變處理行動指引〉也建議企業每年至少舉辦一次應變或營運持續演練,重大異動後,比如換主機商、換系統,要額外加測一次。
計畫定案後的存放位置、檢討週期
這份計畫不需要寫成幾十頁的正式文件,重點是意外發生時真的找得到、看得懂、能照著做。存放的地方不能是網站掛了就一起打不開的位置,比如只放在網站主機本身,或只存在會員信箱裡,因為那正好是最可能同時出事的地方。建議搭配密碼管理工具,或另一個獨立管道,存放聯絡資訊與存取憑證,讓計畫本身在網站出事的時候仍然打得開。
固定檢討週期也要跟著訂下來,至少每年檢討一次,遇到換主機商、換系統或人員異動時要額外更新。NIST SP 800-34 Rev. 1 對持續維護這個步驟的界定,正是計畫需要隨系統、人員與環境變動定期更新,不是寫完一次就結案。把這份計畫當成活的文件持續維護,備份與復原步驟才不會在真正需要的那一刻,發現早已跟現況對不上。