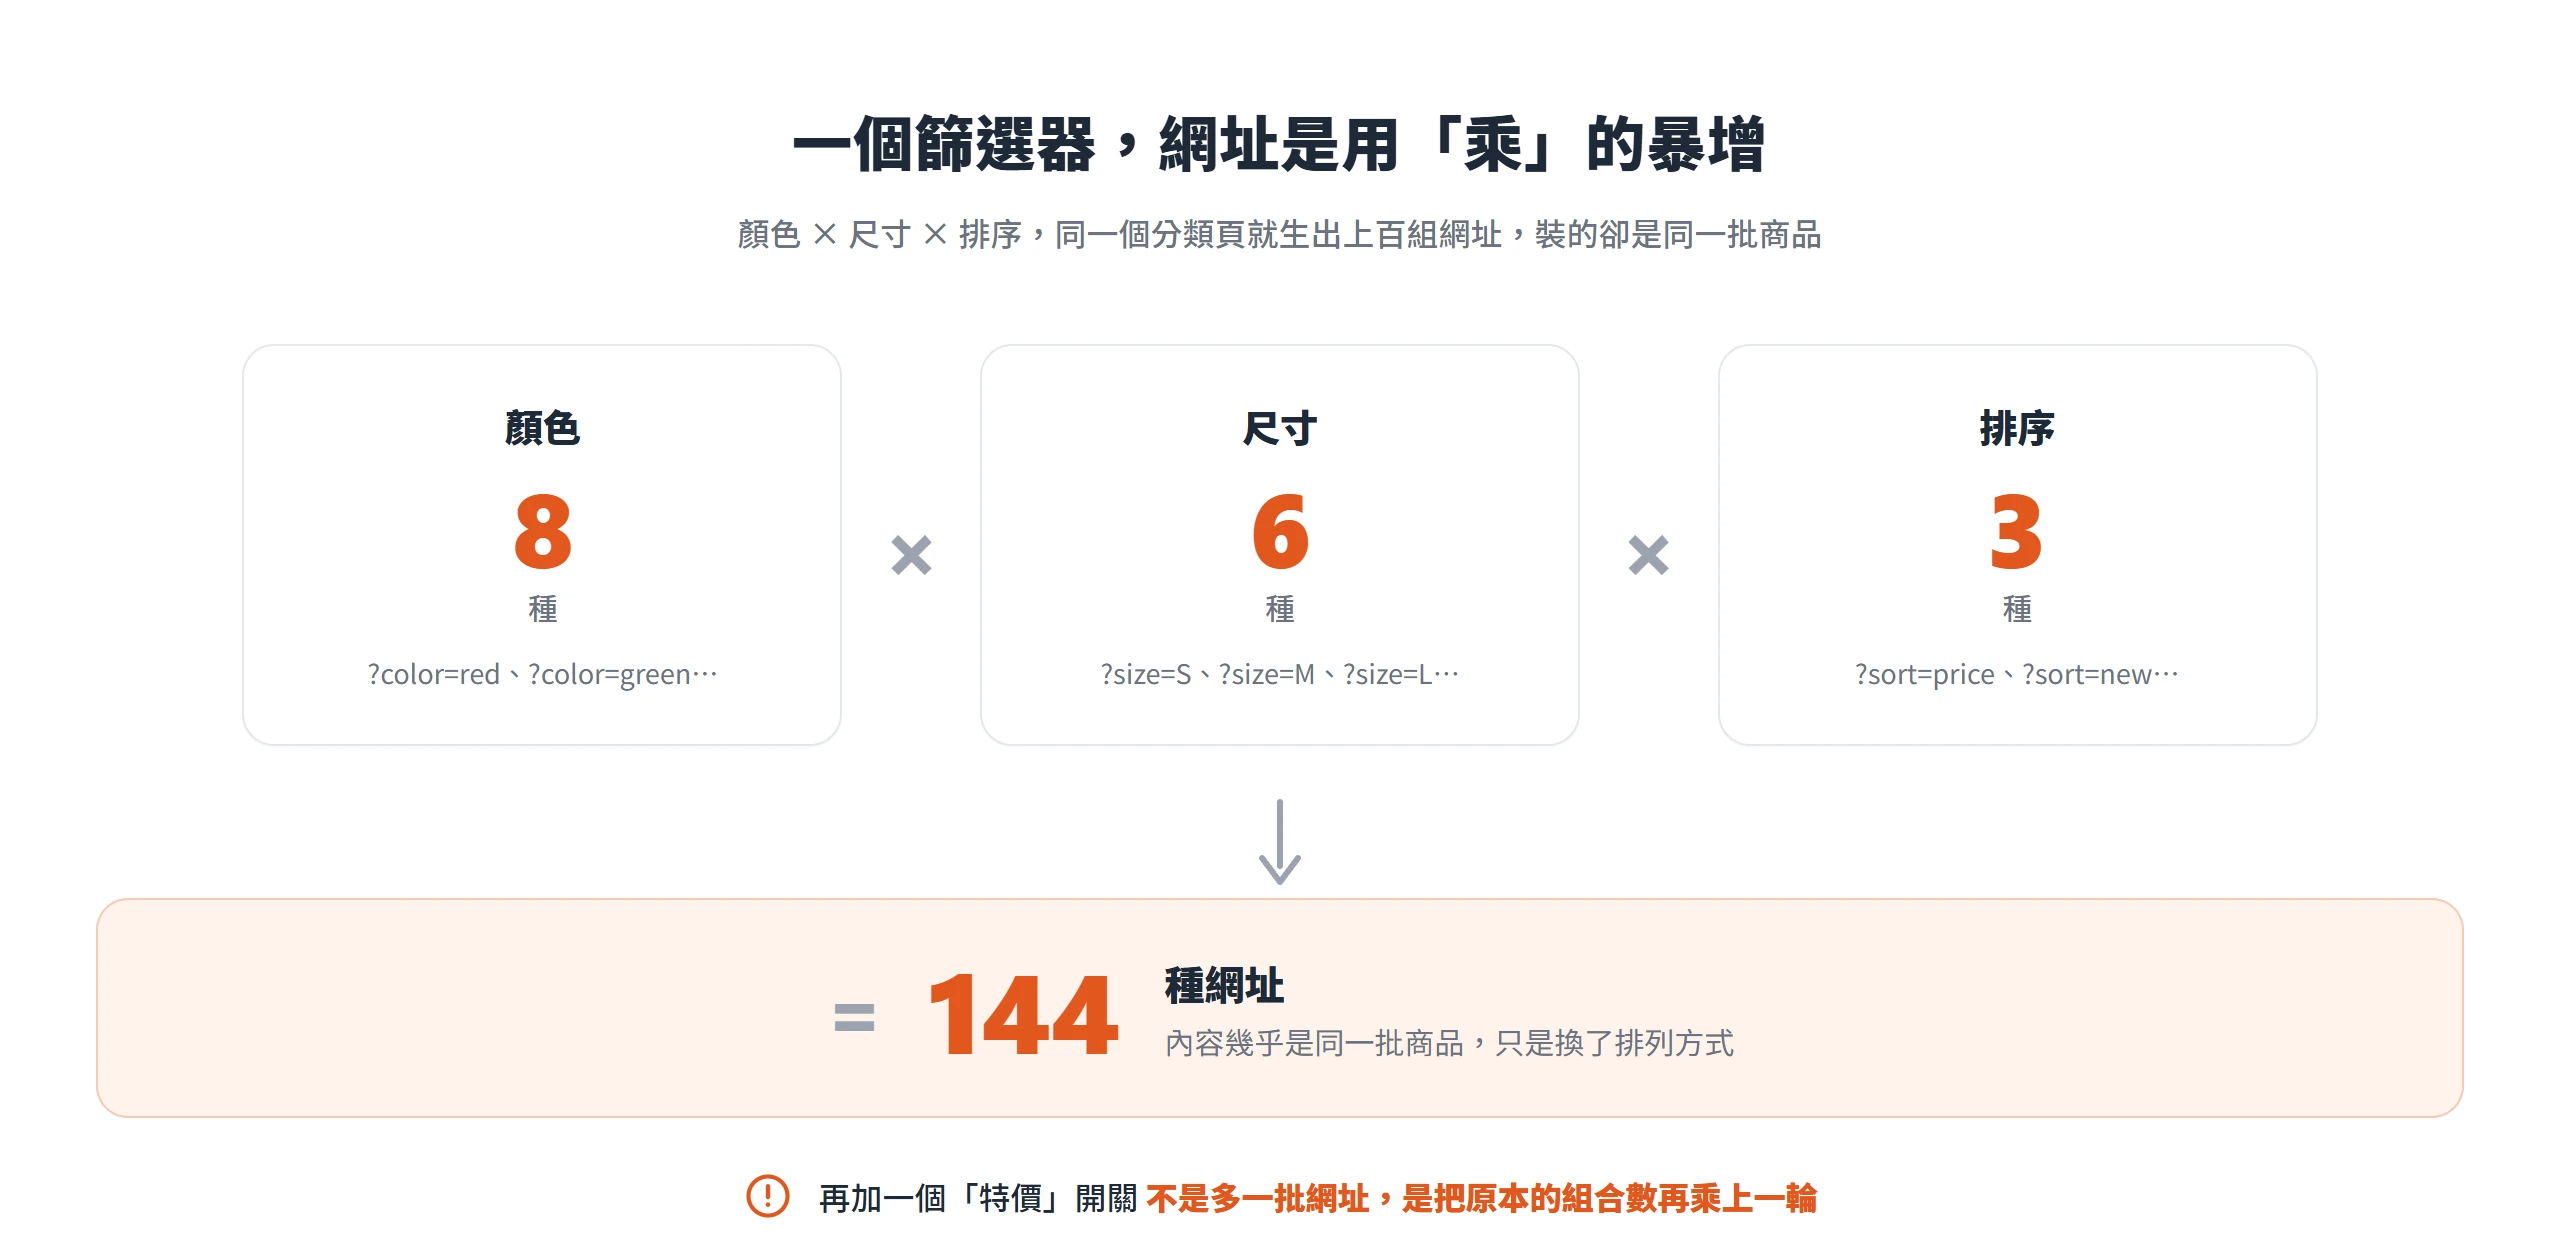
多數人以為,電商分類頁開放的篩選條件越多,等於幫搜尋引擎多鋪了幾百條路——顏色選得到、尺寸挑得到、還能照價格排序,怎麼看都是內容變豐富了。實情卻剛好相反,光是「顏色」「尺寸」「排序」三種篩選湊在一起,一個分類頁就能自己生出上百組網址,而這些網址裝的其實是同一批商品,只是換了個排列方式。舉例來說,8 種顏色、6 種尺寸、3 種排序方式排列組合起來就是 144 種網址,這還沒算進跨分類頁、跨篩選層級疊加的情況。
這種由篩選與排序功能產生大量網址的現象,只要列表頁有篩選或排序功能就躲不掉,電商、房仲、求職平台都一樣。多數網站的第一反應是把這些網址全部加上 noindex,覺得這樣能幫搜尋引擎省事,這個直覺其實有一半是錯的,noindex 能拿掉索引,卻省不下抓取次數,Google 仍然得先造訪過那個網址,才知道上面寫著 noindex。要判斷這些網址該擋還是該留,得先弄清楚它們是怎麼冒出來的,又造成什麼實際的麻煩。
一個篩選器就能把網址撐出上百種組合
這種網址通常長兩種樣子。一種是加在網址後面的查詢字串,例如 ?products=fish&color=radioactive_green&size=tiny,每多勾一個篩選條件,就在問號後面多接一段參數;另一種是把篩選條件寫進網址路徑本身,例如 /products/fish/green/tiny,看起來像一層一層的分類,其實裝的還是同一組篩選邏輯。走路徑式網址的網站要特別注意一件事,篩選條件在路徑裡出現的順序必須永遠一致,也不能同一個篩選條件重複出現兩次,否則同一個篩選結果會被拆成好幾個不同的網址,等於自己把重複問題疊加一次。
真正讓人低估這件事嚴重性的,是這些組合是用乘的,不是用加的。同一個分類頁只要開放顏色、尺寸、排序三種篩選,8 種顏色乘 6 種尺寸乘 3 種排序方式,就是 144 種網址;如果這個網站有 20 個分類頁都開放同樣的篩選功能,數字會再往上翻好幾倍。多加一種篩選維度,例如再加一個特價開關,不是多出一批網址,而是把原本的組合數再乘上一輪。
而且這不是只有大型電商才要擔心的事。任何一個列表頁只要有篩選或排序功能,都會產生一模一樣的現象,房仲網站的坪數與格局篩選、旅遊訂房網站的日期與星級篩選、求職平台的地區與薪資篩選,邏輯都相同,篩選條件越多,網址數量越是用乘的往上翻。規模小的網站受影響的網址數量少一點,但問題的性質完全一樣。
換個排序,內容幾乎是同一批商品
篩選網址數量驚人只是第一層問題,更根本的是這些網址裝的內容高度重疊。同一個分類頁換個排序方式,或多勾一個篩選條件,頁面上出現的商品清單九成以上是同一批,只是排列順序或篩選範圍有差。搜尋引擎看到的不是一百多個各有價值的新頁面,而是同一份內容被複製了一百多份。
Google 把這種情況定義得很清楚,「標準化」(canonicalization)指的是從一段內容裡選出一個代表性網址(標準網址)的過程,目的是讓同一份內容在搜尋結果只顯示一次。造成重複內容的常見原因有好幾類,包括地區變體、裝置版本、通訊協定差異,以及網站功能,分類頁因排序與篩選功能而產生的多個網址,正是被明白點名的其中一類。
值得先講清楚的是,重複內容本身不是違規,Google 不會因此處罰網站。它要處理的問題是選代表,同一群重複頁面,該讓哪一個網址代表整群出現在搜尋結果裡。而且這個代表不一定是站方原本預期的那一個,如果站方沒有明確表態,Google 會自己判斷哪個版本比較完整、比較有用,選出來的結果未必是站方想要的那一頁。針對同一分類頁因不同篩選產生的多個網址,做法是用 rel="canonical" 指定站方偏好的標準網址。
抓取資源被分走,新品反而更晚被發現
網址數量膨脹、內容又高度重疊,接下來的後果是搜尋引擎花在這些組合上的抓取時間,會排擠到真正該被優先抓取的頁面,尤其是剛上架的新商品或新內容。爬蟲沒辦法在造訪之前就判斷哪個參數組合有實際內容價值,結果就是把大量抓取資源花在效果不明的組合上,這種現象叫做過度抓取(overcrawling)。網站規模越大、篩選維度越多,這個問題越嚴重;規模小的網站不是不會發生,只是還沒明顯到讓人有感。
有一個細節常被忽略、也最容易讓人誤判,那就是幫這些篩選網址加上 noindex,並不會替網站省下抓取資源。Google 明白指出,對頁面下 noindex 之後,Googlebot 還是得先造訪這個網址一次、看到回應裡的 noindex 標籤,才會決定把它從索引裡丟掉,這個先抓再丟的順序,沒有省掉任何一次抓取。真正想省抓取預算,Google 給的優先順序是先合併重複內容,讓抓取聚焦在真正獨特的內容而不是獨特的網址;做不到合併,才用 robots.txt 直接擋掉這些不重要的頁面;如果是已經永久下架、不該再存在的頁面,則回傳 404 或 410 狀態碼。這三步的順序不能顛倒,尤其不要把 noindex 當成省抓取的手段。
抓取資源被大量無意義的網址佔走,跟內容重複稀釋掉排名信號,是兩件各自獨立的事,卻常常一起發生在同一批篩選網址上。
三種攔截做法擋得住的範圍不一樣
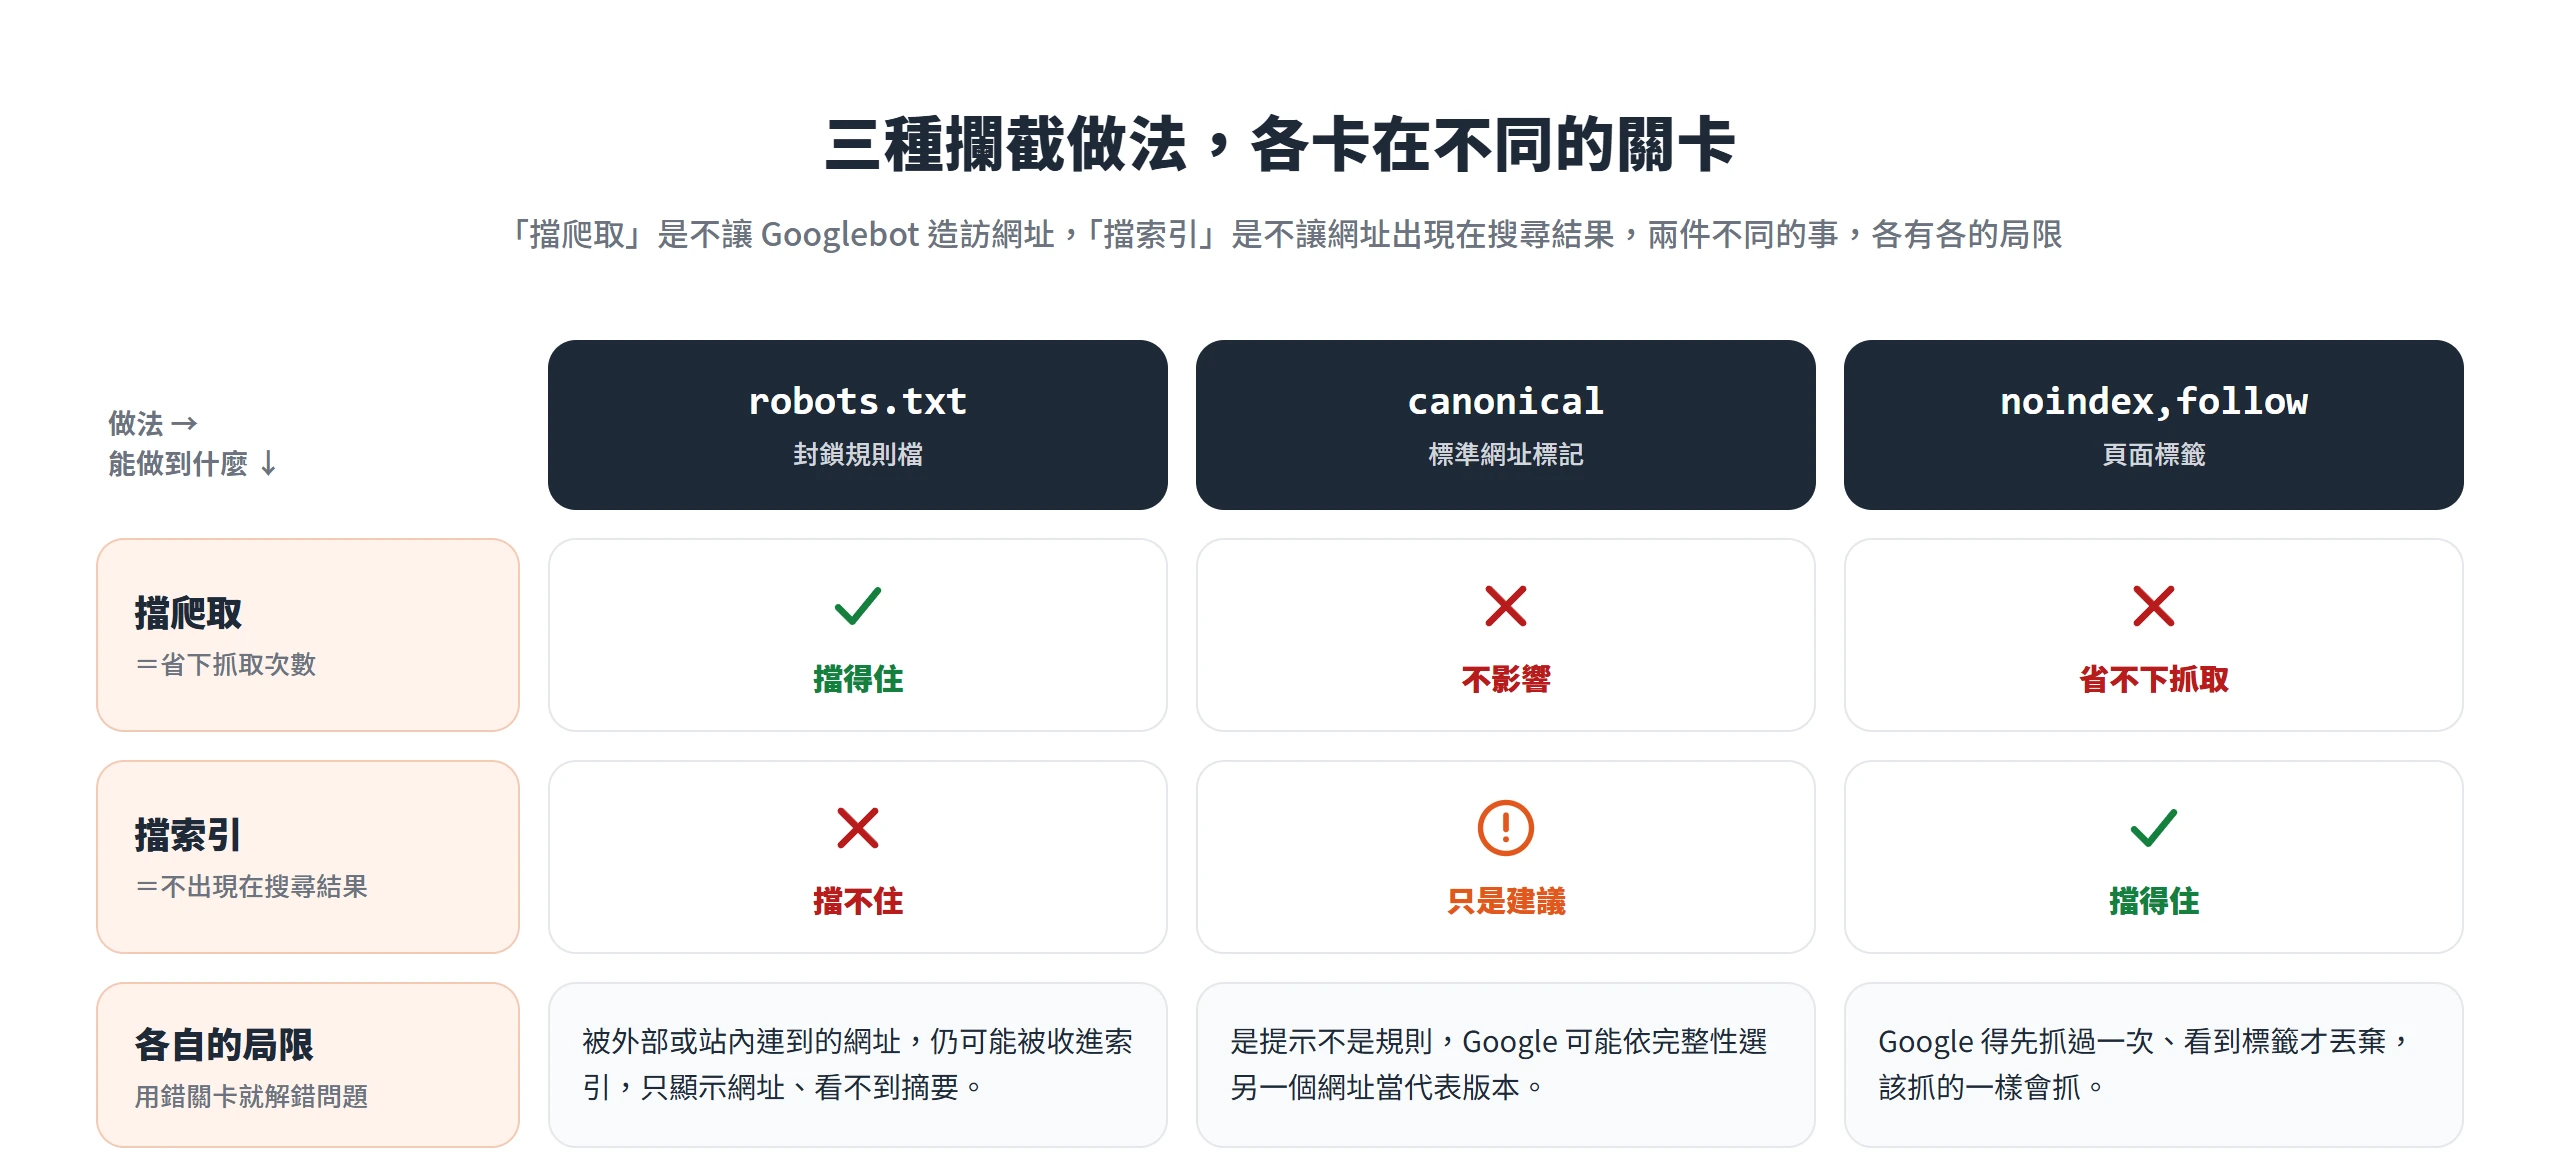
先把兩個常被混為一談的關卡分清楚,「擋爬取」是不讓 Googlebot 造訪某個網址,「擋索引」是不讓某個網址出現在搜尋結果裡,這是兩件不同的事。市面上常聽到的 robots.txt、canonical、noindex,follow 這三種做法,分別卡在不同的關卡上,也各自有各自的局限,搞混了關卡就會用錯工具處理錯的問題。
robots.txt 擋得住爬取,擋不住連結帶來的索引
robots.txt 能做到的是擋爬取,只要在規則裡列出符合篩選參數的網址樣式,Googlebot 就不會主動去抓這些網址,抓取資源因此省下來。舉例來說,如果不想讓顏色、尺寸這些篩選網址被抓取,規則可以寫成 disallow: /*?*color=、disallow: /*?*size=,同時用 allow: /*?products=all$ 這種寫法,把真正想留下的那個組合排除在封鎖之外。
但 robots.txt 擋不住的是連結帶來的索引。如果外部網站,或站內其他頁面,連到一個被 robots.txt 封鎖的網址,Google 仍然可能把這個網址收進索引,只是因為爬蟲從來沒進去讀過內容,搜尋結果會顯示網址本身,卻看不到摘要說明。這正是「robots.txt 設好就等於處理完」這個常見誤解最容易踩空的地方,它管得住抓取,管不住索引,兩者是各自獨立的關卡。另外還有一個做法能從源頭避開這個問題,把篩選條件放進網址的 # 片段而不是 ? 查詢字串,因為 Google 對網址片段本身不會納入抓取與索引的判斷範圍,等於這些組合從一開始就不會進到爬取這一關。
canonical 指向未篩選版本,是建議不是強制指令
canonical 的本質是站方對 Google 提出的建議,「這是我認為的標準網址」,不是一道非遵守不可的指令。做法是在每個篩選網址上,用 rel="canonical" 指回那個未篩選的分類頁,告訴 Google 這群重複頁面該由哪一個代表。
問題在於,就算每個篩選網址都乖乖標好這個建議,Google 仍然可能選擇另一個網址當代表版本。Google 自己的文件把這句話寫得很直白,指定標準偏好是一種提示,不是規則,Google 可能依自己判斷的完整性或實用性,選出跟站方指定不同的網址。這也是為什麼「設了 canonical 就等於解決重複內容問題」是一種過度信賴單一標籤的心態,canonical 能拉高 Google 選中站方偏好版本的機率,但不保證結果,也完全不影響 Googlebot 有沒有花時間造訪過那個被標記的網址一次。
noindex,follow 拿掉了索引,卻省不下抓取次數
noindex,follow 做的是另一件事,明確告訴 Google 這個網址不要收進索引,但頁面上指向商品頁的連結仍然可以被繼續追蹤,不會因為這個標籤讓商品頁失去這個入口。對於「這頁本身不值得出現在搜尋結果,但頁面上的連結還有用」的情況,這是三種做法裡最直接的一種。
但呼應前面談抓取資源時已經點出的那件事,noindex,follow 完全不影響 Googlebot 有沒有花時間造訪這個網址,該抓的還是會抓一次,抓完才看到 noindex 標籤再丟棄。三種做法各管一段,robots.txt 省得下抓取、換不到索引的保證;canonical 是索引階段的建議、換不到抓取上的節省;noindex,follow 能確保不被索引,一樣換不到抓取次數的減少。沒有一種是萬靈丹,用哪一種要看真正想解決的是抓取問題還是索引問題。
紅色洋裝這類搜尋需求,值得留一頁單獨索引
前面談的都是該擋掉什麼,但不是每個篩選組合都該被擋。「紅色洋裝」是一個好例子,這是真的有人在搜尋引擎打的詞,背後有明確的購物意圖,如果篩選出來的那批商品跟其他版本比起來有實質差異,把它做成一個乾淨、可以被索引、有自己標題與說明文字的落地頁,反而比繼續丟給一串參數網址將就,划算得多。
判斷值不值得留下索引,看的不是這個篩選功能技術上做不做得到,而是兩件事,有沒有人真的在搜這個組合,以及這個組合的商品清單跟其他版本比起來,有沒有實質差異、能不能為它寫出真正獨特的標題與說明。同樣是顏色篩選,「紅色洋裝」跟「紅色、M 號、特價中」不是同一個等級的組合,單一屬性的組合通常商品範圍夠大、搜尋需求也夠明確,多屬性疊加出來的組合,商品清單常常薄到只剩幾件,也很少有人真的照那麼細的條件去搜。
決定要留下索引之後,把這個頁面做乾淨還有幾個實作上的細節不能省,網址參數要用業界標準的 & 字元連接;如果走路徑式網址,篩選條件的邏輯順序要固定、不能重複出現同一個條件;某個篩選組合剛好沒有任何商品符合時,要讓伺服器回傳 HTTP 404 狀態碼,而不是顯示一個看起來正常、實際上空空如也的頁面。這幾點做不到,留下索引反而會製造新的重複或錯誤訊號,等於把問題換了個位置留著。
兩個問題能判斷這組篩選網址該擋還是該留
把前面「該擋」與「該留」兩條線收成一個判準,這組篩選網址值不值得單獨索引,只問兩個問題,有沒有人在搜這個組合,以及這個組合撐不撐得起一個獨立主題。兩個問題都答「是」才值得留;只要有一個答「否」,就該用前面談的工具把它擋掉,不用猶豫。
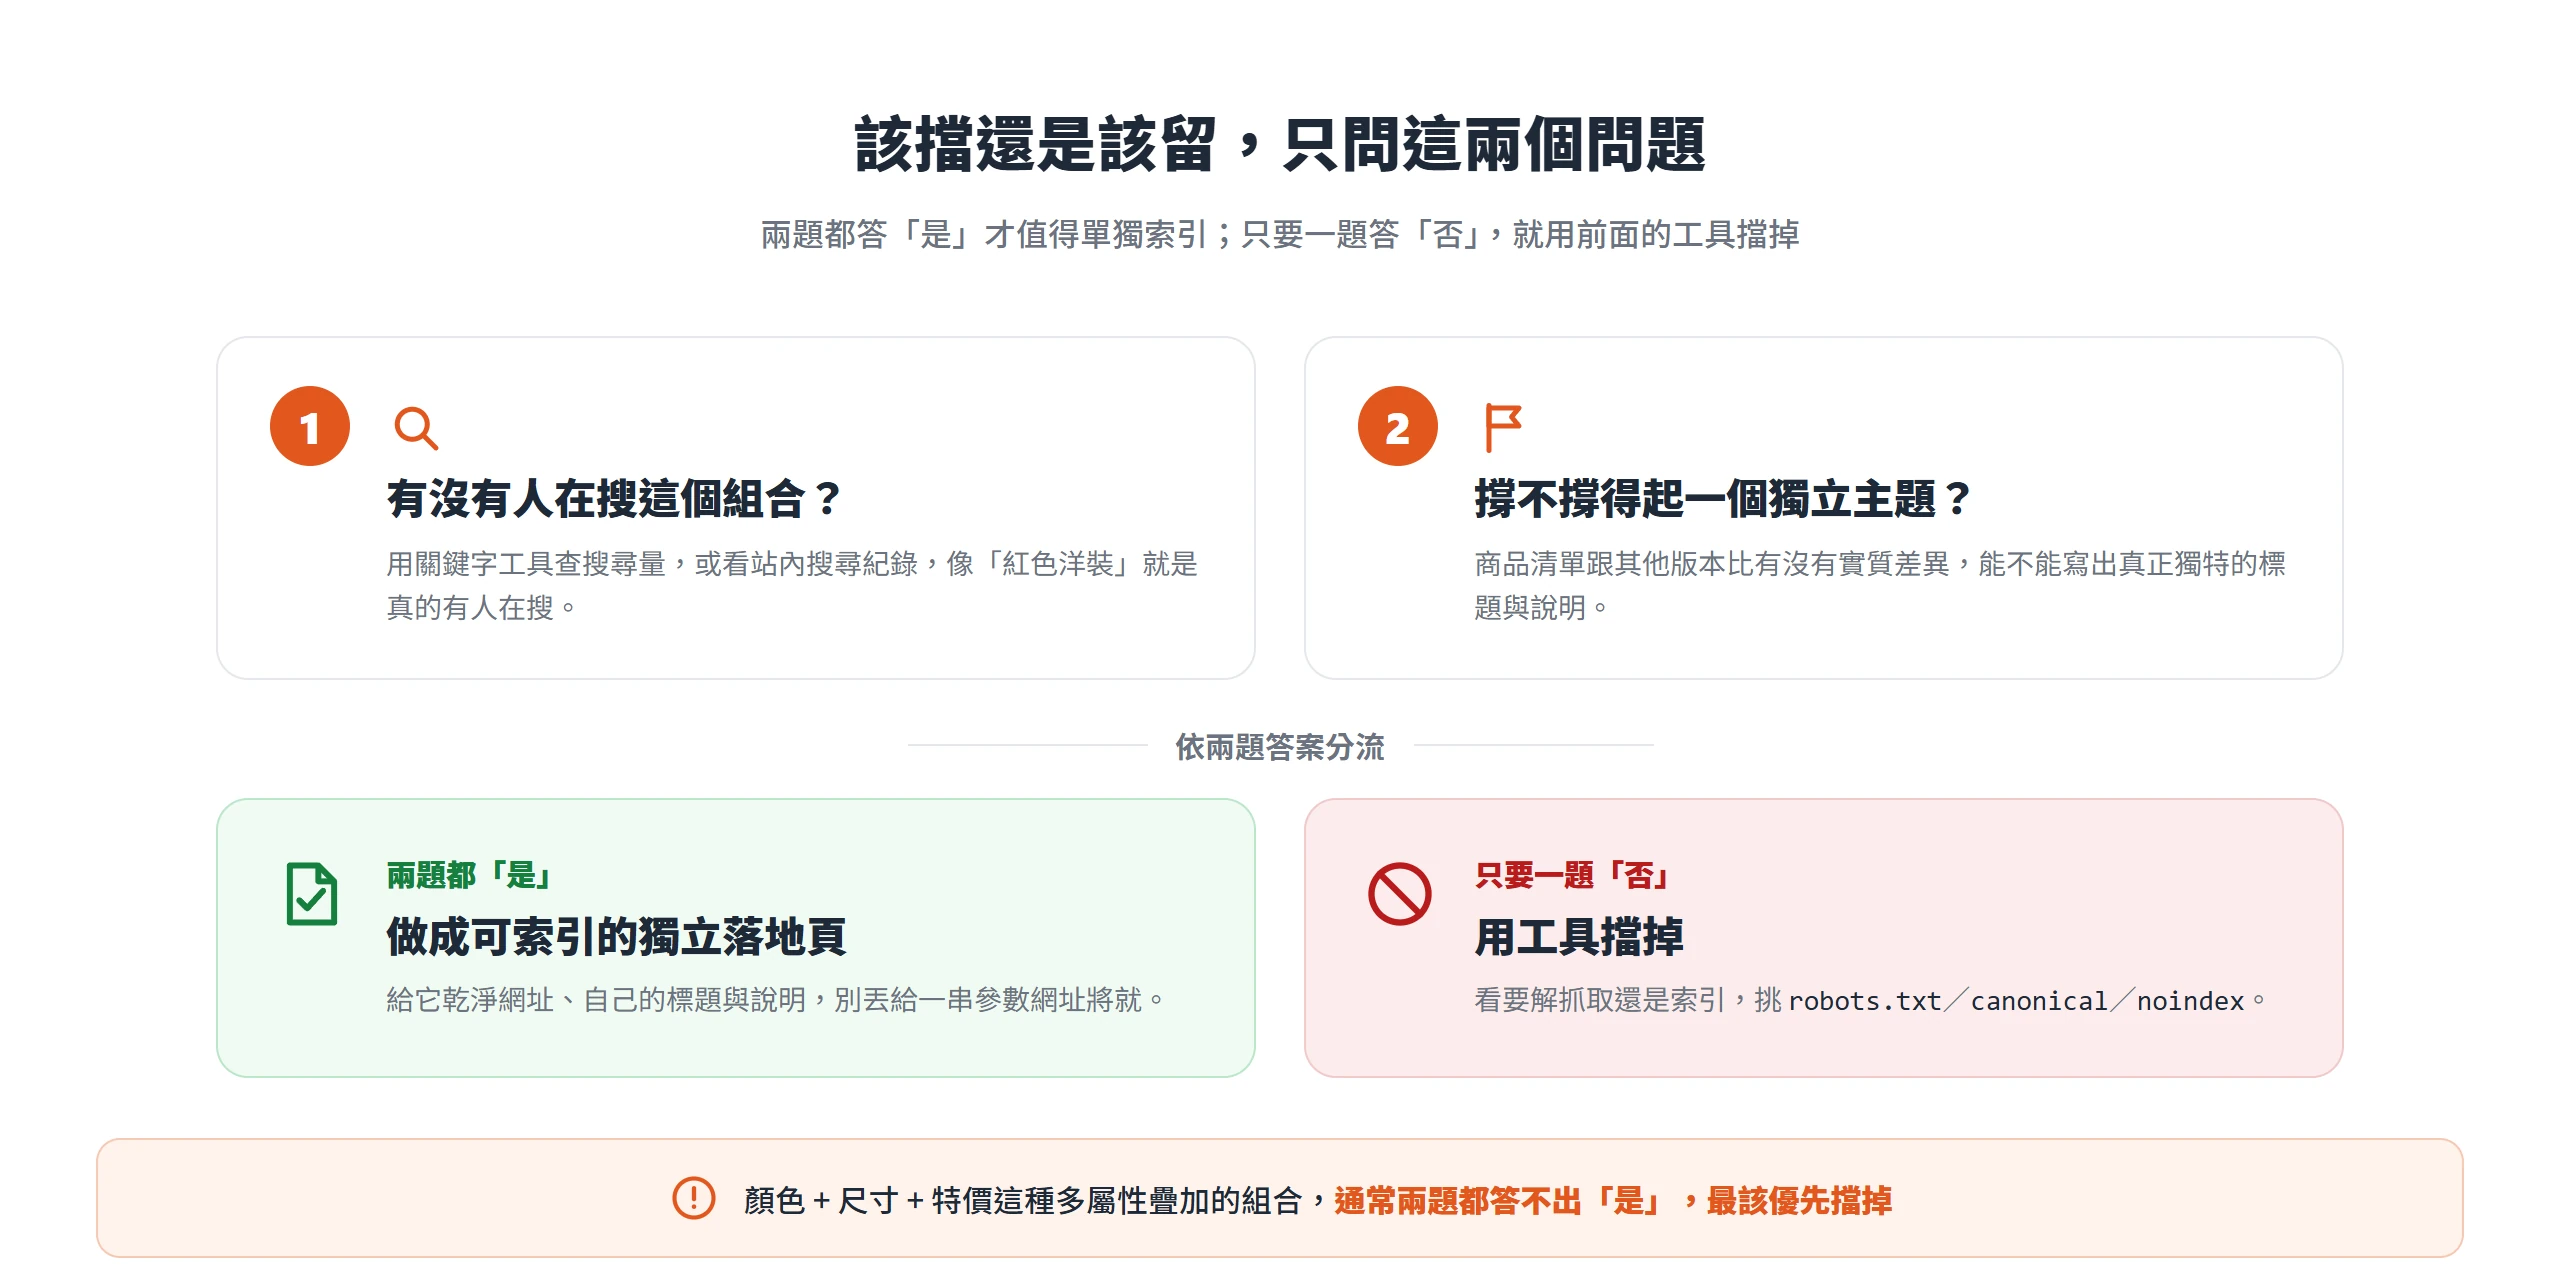
第一個問題不是用猜的,關鍵字查詢工具能查到某個篩選組合有沒有實際搜尋量,網站自己的內部搜尋紀錄也是很直接的線索,如果站內搜尋常常出現「紅色洋裝」這種組合詞,代表這個需求是真的存在。第二個問題比較主觀,但也有具體的檢查方式,這個組合的商品清單跟其他版本比,內容差異夠不夠大,能不能寫出一段真正描述這批商品、而不是套模板換個顏色詞的說明文字。
多屬性疊加的組合,也就是顏色加尺寸加特價同時開三個篩選,通常兩個問題都答不出「是」,搜尋量分散到近乎零,商品清單也薄到寫不出獨特內容,這類是最該優先擋掉的一批。這個判準不只是電商的事,同一套邏輯套用到房仲網站的坪數與格局篩選、求職平台的地區與職缺類型篩選,一樣成立,先問有沒有人在搜,再問這個組合能不能站得住一個獨立主題,這組篩選網址該擋還是該留,答案自然浮現。
篩選與排序功能本來是為了讓使用者更快找到想要的東西,網址暴增只是這個功能運作起來的副作用,不是設計錯誤。真正該花心力的,不是把每一組篩選網址都想辦法擋光或放行,而是先分清楚擋爬取跟擋索引是兩個不同的關卡,再回頭問那兩個簡單的問題,有沒有人在搜,值不值得單獨成頁。想清楚這兩件事,篩選網址從一團要清理的雜訊,才會變成一份可以拿在手上、逐條做決定的清單。