每次在瀏覽器打上一個網址、按下 Enter,畫面顯示內容之前,其實已經有一份簡短的「回條」先傳回來,告訴瀏覽器這次請求辦得怎麼樣。這份回條就是 HTTP狀態碼(HTTP status codes),伺服器放在回應開頭的 3 位數字,用來標示這次請求的處理結果。
多數人第一次真正注意到狀態碼,通常是網站出問題的時候。瀏覽器跳出「找不到網頁」或畫面整個打不開,想查原因才發現背後藏著一組數字。狀態碼不是工程師才需要懂的細節,它會直接影響網站經營的 2 件事,使用者能不能順利看到內容,以及搜尋引擎會不會把這個網址收進索引、要不要把排名信號轉移到新網址。用錯一個狀態碼,可能讓一次正常的網站改版,變成排名平白流失的意外。
看懂這 3 位數字代表什麼,平常巡檢網站、判斷改版或搬家該怎麼設定重新導向,才有依據,不必憑感覺猜。狀態碼依第一位數字分成 5 個大類,各自對應不同的處理邏輯。
HTTP狀態碼是什麼?
打開瀏覽器的開發者工具,切到 Network 分頁重新整理一次頁面,清單裡每一筆請求都會夾帶一組代碼,樣子像 HTTP/1.1 200 OK。這一整行叫做狀態列(status line),排在伺服器回應的最前面,200 就是狀態碼,OK 則是它對應的簡短說明文字。狀態碼由伺服器產生,瀏覽器收到之後,依這組數字決定接下來要顯示成功的畫面、跳出找不到網頁的提示,還是自動跳轉到另一個網址。
訂這套規則的不是某家瀏覽器廠商,而是負責制定網際網路標準的國際組織 IETF(Internet Engineering Task Force)。目前 HTTP狀態碼的正式規格寫在 RFC 9110《HTTP Semantics》裡,這份文件在近年取代了舊版的 RFC 7231,把狀態碼的語法與 5 個分類的語意都定義清楚。也就是說,狀態碼不是各家伺服器軟體自己發明的行為,而是有一份共同遵守的規格,這也是為什麼不論網站架在 Apache、Nginx 還是任何一種主機環境上,404 永遠代表找不到、500 永遠代表伺服器出錯,意義不會因為主機不同而改變。
狀態碼由伺服器決定,瀏覽器只負責顯示對應畫面
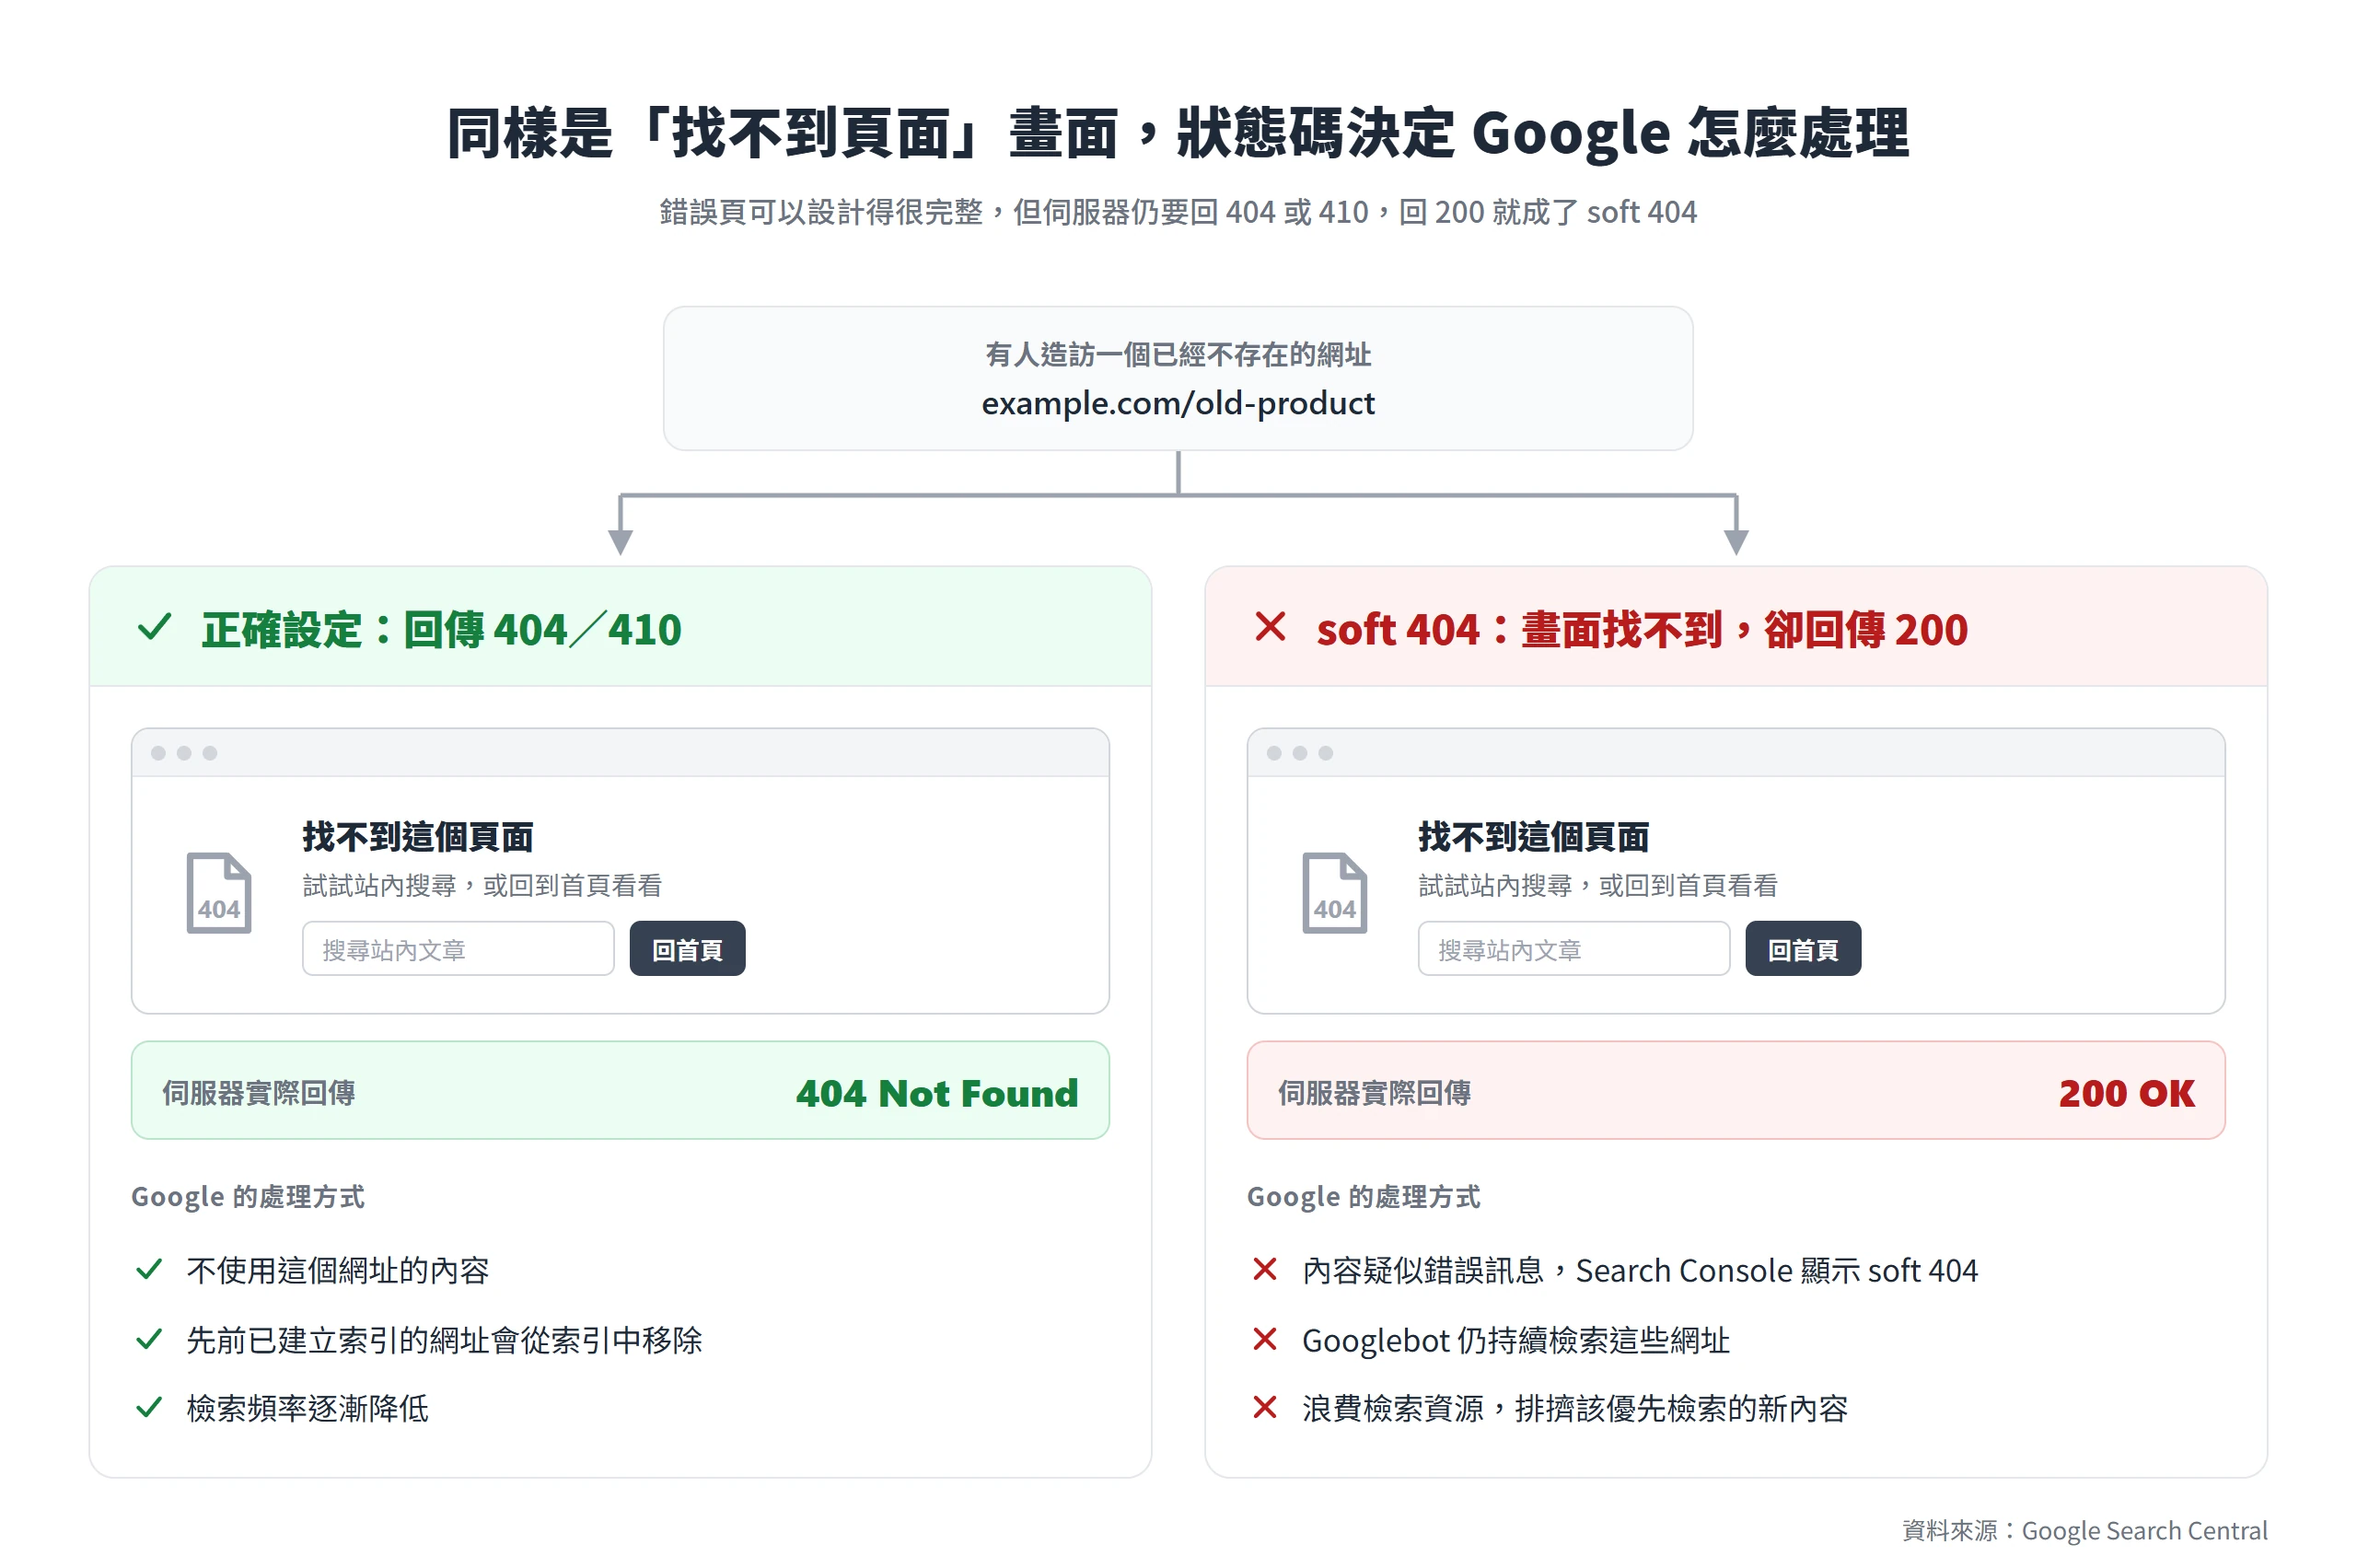
使用者平常看到的畫面文字,跟伺服器實際回傳的狀態碼,其實是兩件不同的事。網站可以自己設計一個好看的「找不到頁面」畫面,搭配插圖、搜尋欄、回首頁按鈕,這些都是網站自訂的內容,但畫面背後那個 3 位數字,是伺服器依協定回報的判斷結果,兩者不一定對得起來。
依 RFC 9110 的定義,狀態碼描述的是這次請求的處理結果,回應內容(representation,也就是那一頁 HTML)則是用來說明這個狀態的附帶內容,兩者本來應該對得上,但內容寫什麼由網站自己決定,協定不會替網站檢查有沒有寫錯。實務上最常見的落差,就是畫面寫著「找不到」,狀態碼卻回傳 200。這種狀態碼跟內容對不上的情況,是不少網站在 SEO 巡檢時最容易漏掉的地雷。判斷一個網址是否真的存在,看畫面文字不準,得看狀態碼本身。
三位數字的第一碼把狀態碼分成五個類別
狀態碼雖然多達數十種,但只要看第一位數字,就能立刻判斷它屬於哪一大類。依 MDN 與 RFC 9110 的定義,狀態碼分成 5 個類別,100 到 199 是 1xx 資訊回應、200 到 299 是 2xx 成功回應、300 到 399 是 3xx 重新導向訊息、400 到 499 是 4xx 用戶端錯誤、500 到 599 是 5xx 伺服器錯誤。
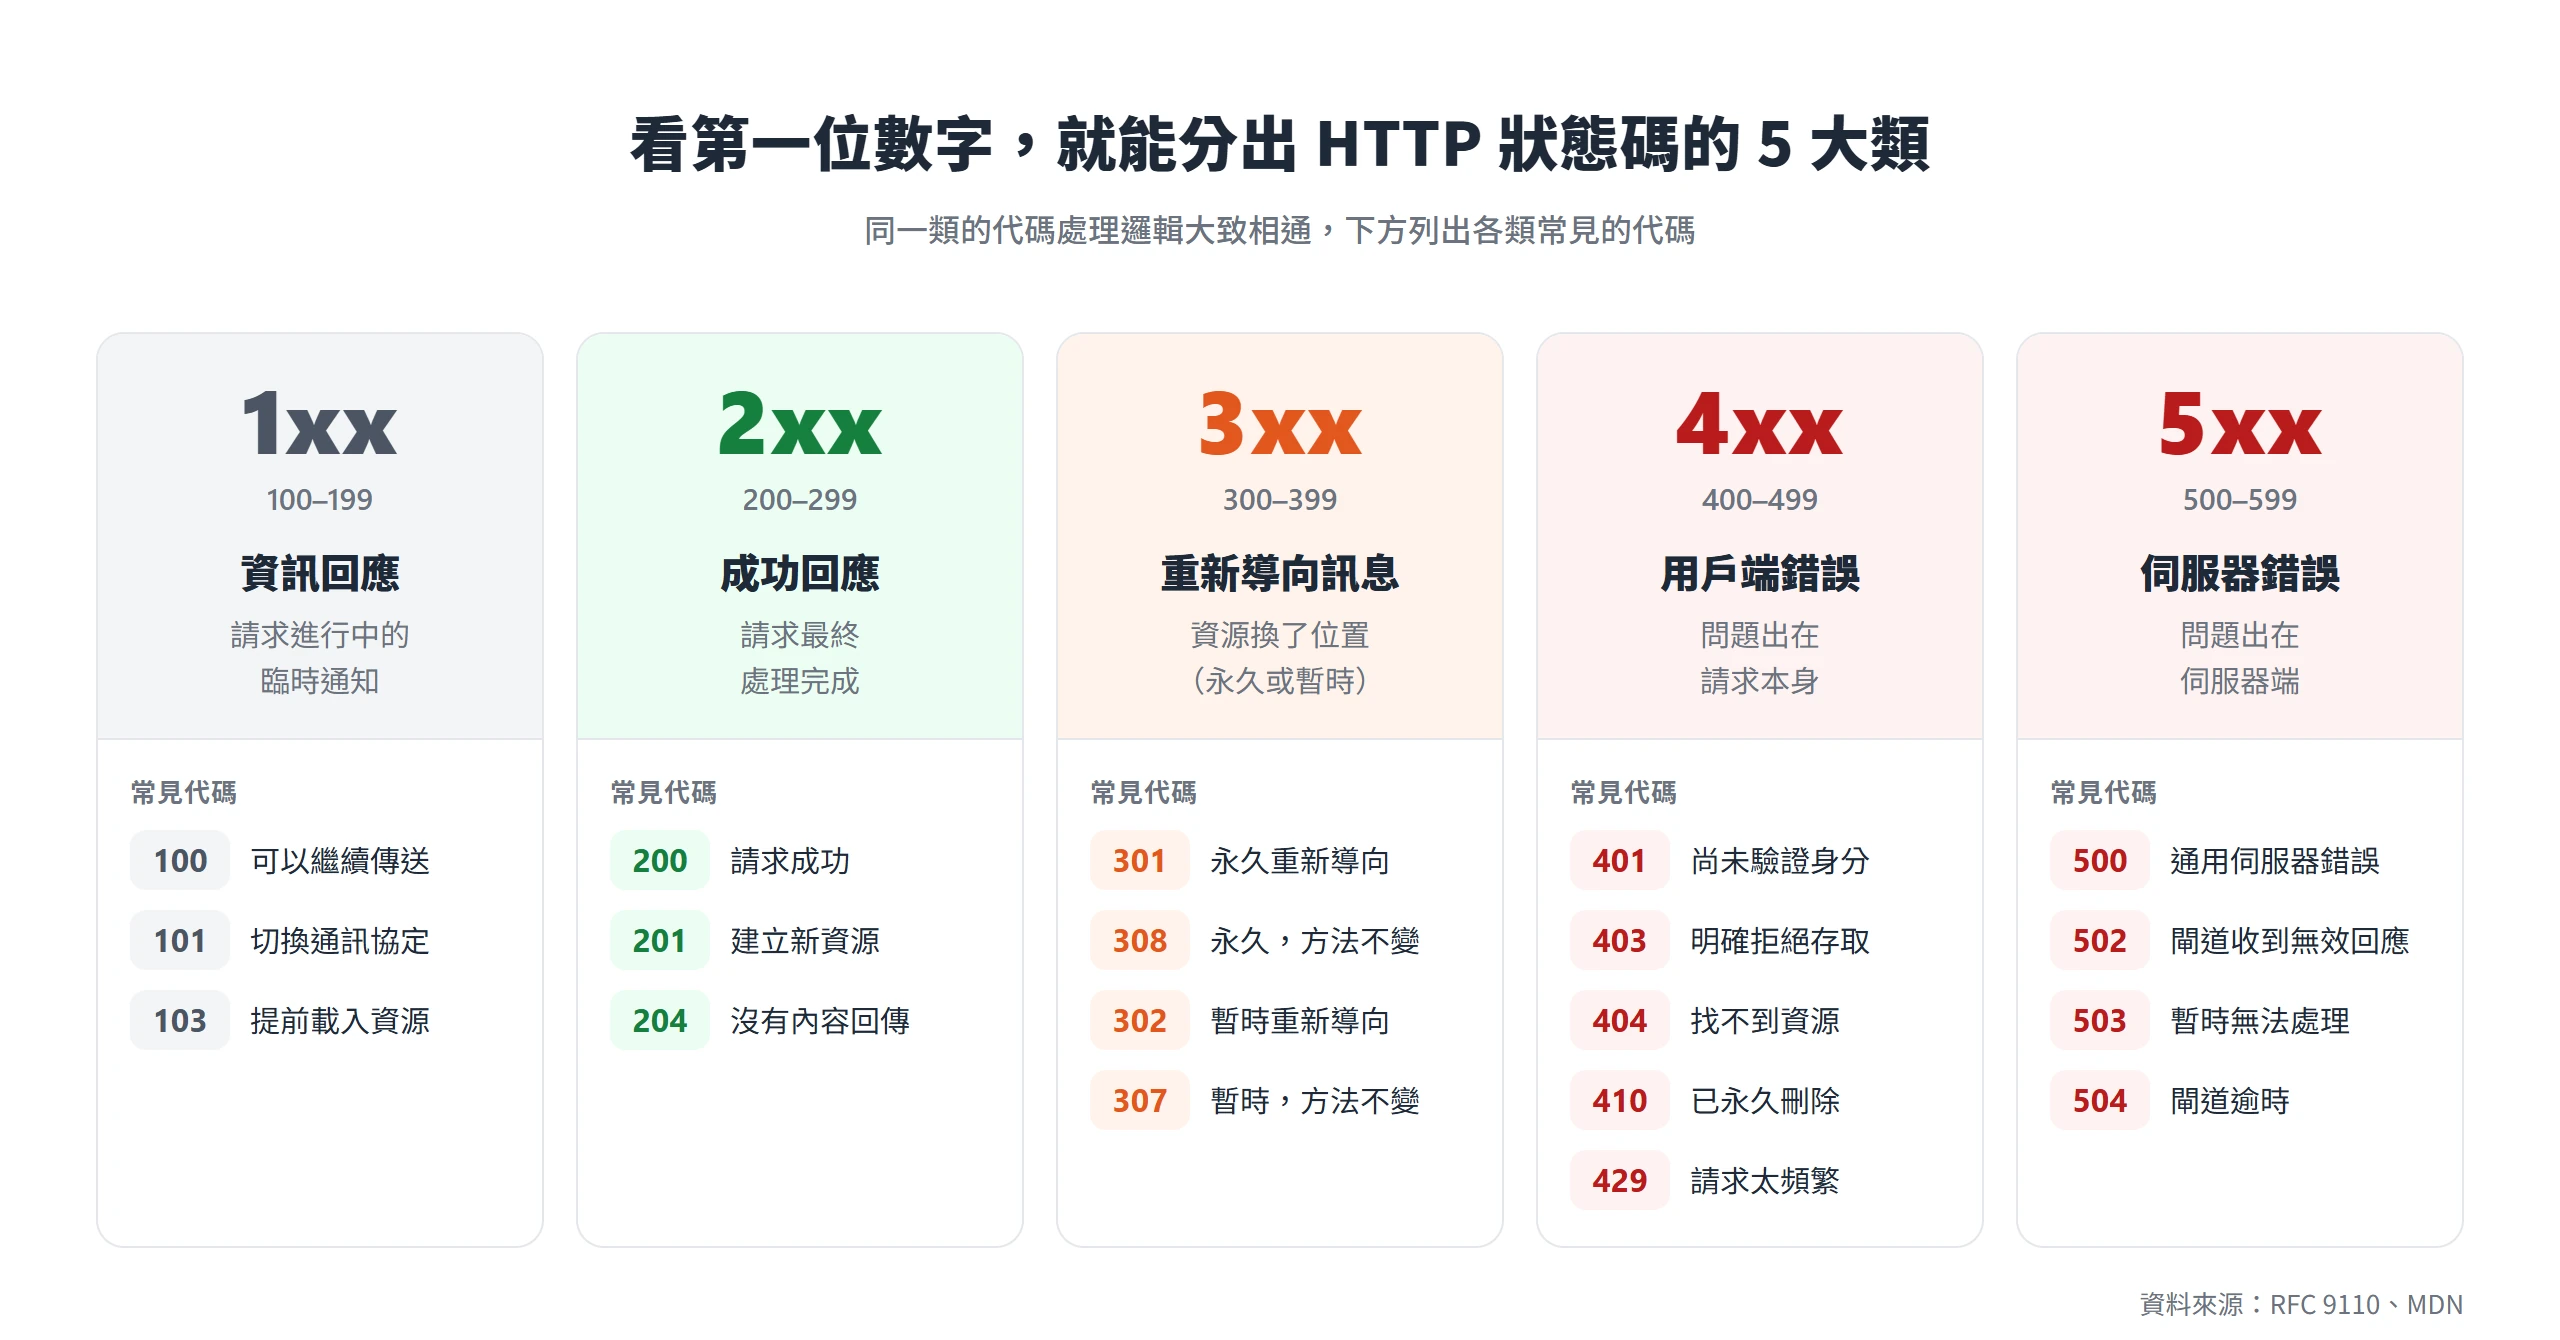
同一個大類底下的代碼,處理邏輯大致相通,差別多半在細節與適用情境,例如所有 4xx 都代表問題出在請求本身,所有 5xx 都代表問題出在伺服器端,先抓住這個大方向,遇到陌生的代碼也能猜出七八分。MDN 也特別提醒,如果收到一組不在它狀態碼列表上的代碼,那是非標準的回應,可能是伺服器軟體自訂的,遇到這種情況該優先確認的是伺服器端的設定,而不是急著查文件對照意思。
1xx 資訊回應與 2xx 成功回應的層次差異
1xx 與 2xx 都是「請求正常進行」的訊號,差別在於進度,1xx 是過程中的臨時通知,2xx 才是最終處理完成的結果。日常瀏覽網頁時,1xx 幾乎不會被使用者感知到,但它們是不少現代網頁效能技巧背後真正在運作的機制。
依 MDN 的定義,常見的 1xx 代碼有 3 個:100 Continue 告知用戶端可以繼續傳送請求本文,或者若請求已經完成,直接忽略這個回應就好;101 Switching Protocols 是伺服器回應用戶端的 Upgrade 標頭,宣告接下來要切換到哪一種通訊協定;103 Early Hints 則搭配 Link 標頭使用,讓瀏覽器能在伺服器準備正式回應的同時,就先預先載入或預先連線之後會用到的資源。2xx 這一類最常見的是 200 OK,代表請求成功,實際回傳什麼內容依方法而定,GET 會拿到資源本體、HEAD 只拿到標頭、POST 或 PUT 則多半回傳處理結果;比較少被注意到的還有 201 Created,常見於 POST 之後,代表請求成功且建立了一筆新資源,以及 204 No Content,代表沒有內容要回傳,但回應的標頭仍然有效,用戶代理可以拿新的標頭去更新快取。
100 與 103 讓瀏覽器提前準備,通常不會被使用者看見
100 Continue 常出現在上傳大檔案的情境。用戶端在正式送出整個請求本文之前,可以先問伺服器願不願意接受,伺服器回 100 表示可以繼續傳,省下白白上傳一個大檔案卻被拒絕的時間。這個過程完全發生在瀏覽器與伺服器之間,使用者感覺到的只有上傳進度條正常跑,不會意識到中間多了一次確認。
103 Early Hints 則是近幾年才被廣泛應用的效能技巧,原理是伺服器在準備正式回應的同時,先送出一個帶著 Link 標頭的暫時提示,讓瀏覽器提前開始載入頁面稍後會用到的樣式表、字型或提前建立連線,等到正式的 200 回應送達,不少資源其實已經預先準備好了。對讀者來說,這反映在網頁載入速度變快,但畫面上完全看不到 103 存在的痕跡。
200 代表有內容回傳,204 代表沒有內容但標頭仍有效
200 OK 是網路上最常見的狀態碼,幾乎所有正常瀏覽的網頁都靠它撐起來,但成功並不是只有這一種樣子。201 Created 專門用在新增資源之後,例如透過表單送出一筆新訂單、或用 API 建立一筆新的資料列,伺服器處理完成、真的多出一筆新資源時,回 201 比回 200 更精確,也讓串接系統的另一端能明確分辨這是「新增成功」還是普通的「查詢成功」。
204 No Content 則用在確實做完了某個操作,但沒有內容需要回傳的情境,例如刪除一筆資料成功之後,伺服器不必再多回傳一份被刪掉的內容,只要標頭仍然有效即可。分清楚這 3 個代碼的差別,對串接第三方系統或維護自家 API 的人特別重要,全部都用 200 打天下,前端或串接方就得另外靠回傳的內容格式去猜這次操作做了什麼,201 與 204 則是把這個資訊直接寫在狀態碼裡,省掉一層猜測。
新增與刪除這類 2xx 的細節,多半只有工程師或串接系統的人會在意,一般網站經營者感受不到差別。但接下來的 3xx 重新導向不一樣,一個代碼選錯,就可能讓搜尋結果裡顯示的網址,跟真正想要的完全不同。
3xx 重新導向,301 與 302 決定搜尋引擎最終採認的網址
3xx 這一整類都代表「資源換了位置」,差別出在換的位置是永久還是暫時,而這個差異,恰好就是搜尋引擎判斷要不要把舊網址累積的排名信號轉移到新網址的關鍵依據。Google Search Central 的官方文件對這 2 種重新導向的處理方式,寫得相當明確。
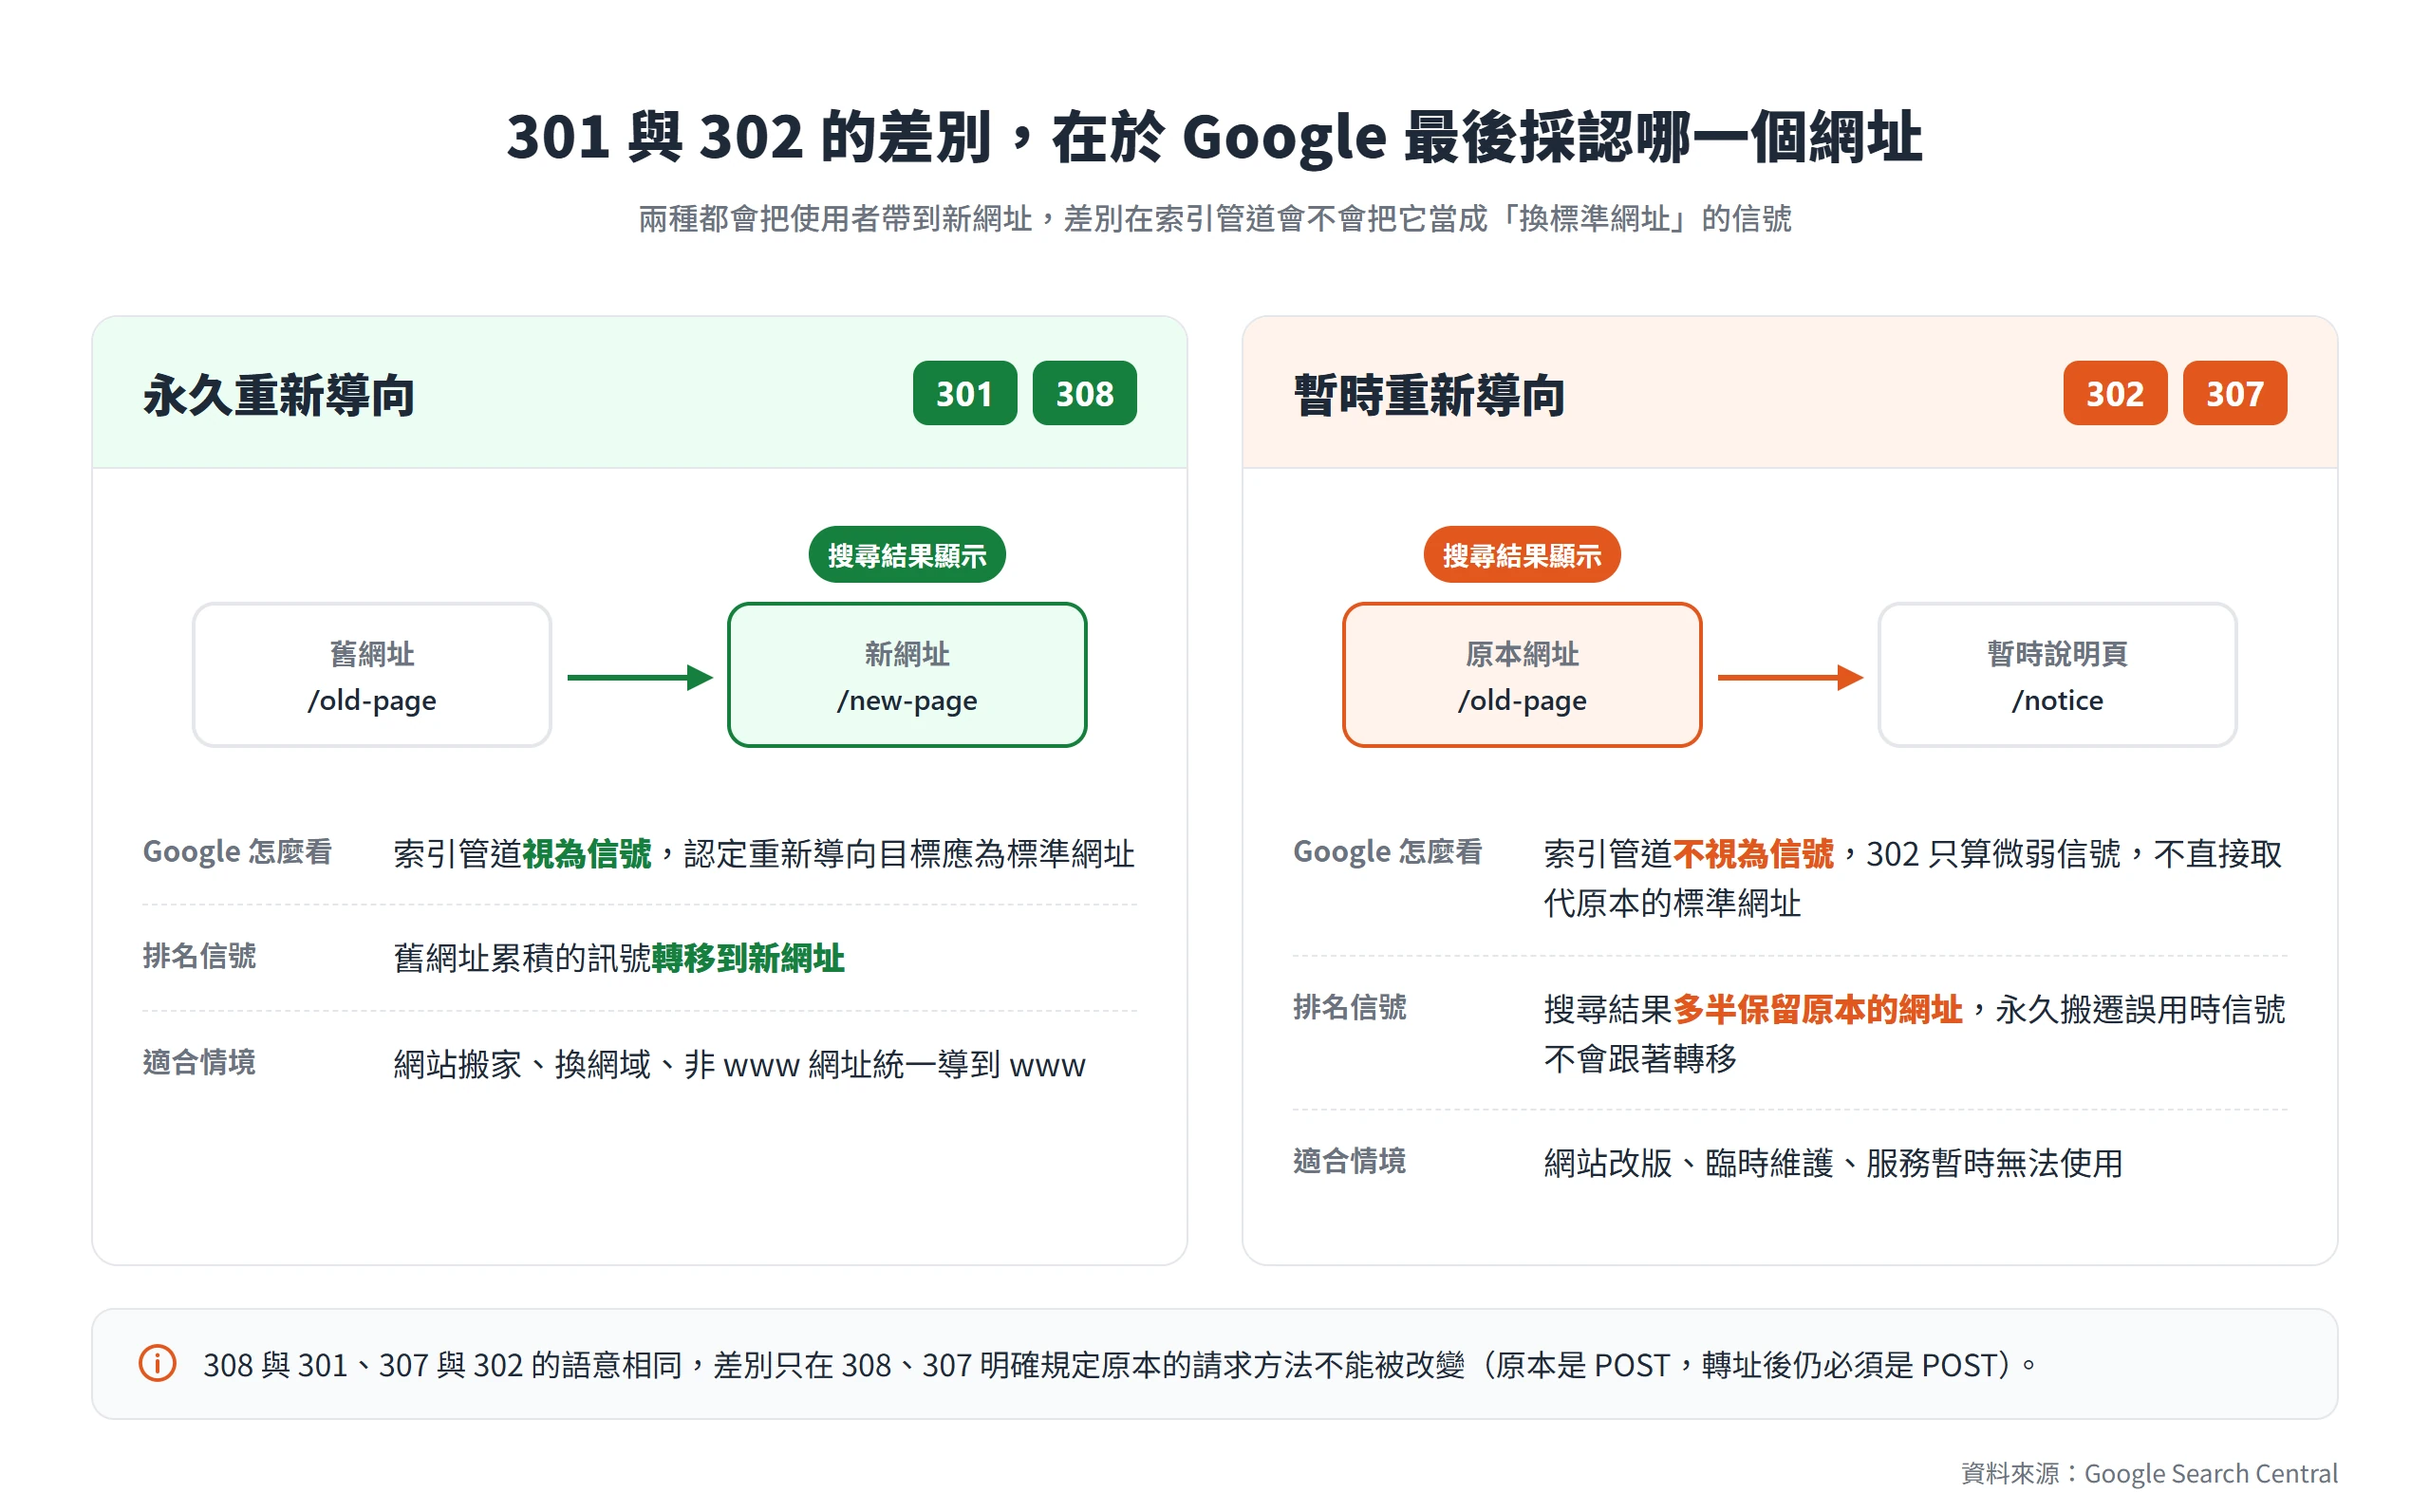
永久重新導向的情況,Google 官方文件寫道:「Googlebot 會遵循重新導向,而且索引管道會將重新導向視為信號,表示重新導向目標應為標準網址。」換句話說,搜尋結果最終顯示的會是新網址,舊網址在索引裡累積的訊號會跟著轉移過去。暫時重新導向則完全相反:「Googlebot 會遵循重新導向,但索引管道不會將重新導向視為信號,據此認定重新導向目標為標準網址。如果存在其他標準化信號,目標網頁仍可能會編入索引。」也就是說,用暫時重新導向,搜尋結果多半還是會保留原本的網址,除非有其他線索讓 Google 自己判斷該換。
301 與 308 把搜尋引擎的排名信號轉移到新網址
301 與 308 語意相同,都代表這項資源已經永久搬到新位置,差別只在一個技術細節上,308 明確規定使用者代理絕對不能把原本的請求方法換掉,如果原本是 POST,轉址後的請求也必須維持 POST;301 在部分舊瀏覽器的行為裡,則可能把方法悄悄改成 GET。308 就是為了修正這個模糊地帶而新增的代碼,語意跟 301 完全一致,只是把「方法不能變」這件事講得更明確。
網站搬家、換網域、把非 www 網址統一導到 www 版本(或反過來),這類真正屬於永久性質的調整都該用 301 或 308。伺服器端的設定並不複雜,PHP 只要 2 行就能完成:
header('HTTP/1.1 301 Moved Permanently');
header('Location: https://www.example.com/newurl');Code language: PHP (php)
Apache 在 .htaccess 裡用一行 Redirect 301 /old-page /new-page 就能設定,Nginx 則是在設定檔裡寫 return 301 https://example.com/new-page;。3 種寫法邏輯相同,都是明確告訴瀏覽器與搜尋引擎,這裡不會再改了,以後請直接認新網址。
302 與 307 讓搜尋結果暫時保留原本的網址
302 與 307 用在真正短期的情境,例如網站進行改版或臨時維護,把使用者導去一個說明頁面,但不希望搜尋結果因此換掉,變成長期顯示那個臨時頁面。Google 官方文件對這種情境給出明確建議:「如果只想暫時將使用者傳送到其他網頁,請使用暫時重新導向,這種做法也能確保 Google 不會受到重新導向影響,有助於在搜尋結果中保留原本的網址。」文件並舉例,如果網站提供的服務暫時無法使用,可以設定暫時重新導向,把使用者帶到說明當下情況的頁面,而不必捨棄搜尋結果中原本的網址。
307 與 302 的關係,就跟 308 與 301 的關係一樣,語意相同,差別只在請求方法會不會被悄悄改變。Google 在另一份文件裡把兩者的處理方式寫得更直白,302 會被 Google 系統視為「微弱信號」,表示應處理重新導向目標,力道遠不如 301 的「強烈信號」;307 則等同於 302。要把 302 換成 307,只需要把上面 PHP 範例裡的狀態碼數字換掉,header('Location: ...') 那一行完全不用動。
網址搬遷若誤用 302,排名信號不會跟著轉移
實務上最常見的誤用,是網站真的做了永久搬遷,例如換了新網域、改了整個網址結構,工程端卻因為 CMS 預設值或習慣沿用 302,結果 Google 遲遲不把新網址當成標準版本。舊網址持續留在搜尋結果裡不動,新網址即使內容已經完全轉移過去,也收不到原本累積的排名權重,對經營者來說,等於白白多花一段時間流量斷層。
差別的關鍵就在「視為信號」與「不視為信號」這兩句官方原文的對比,301 與 308 會被 Google 拿來判斷標準網址該換成誰,302 與 307 則不會。反過來說,也別因為聽說 302 比較保守安全,就每一種重新導向都用 302 應付。真正屬於永久搬遷的網址,用 302 反而是在阻止排名信號正常轉移,拖到後面要花更久時間才能讓 Google 把權重挪過去。
重新導向處理的是「網址換了位置」,4xx 用戶端錯誤處理的則是完全不同的情境,問題出在請求本身,不是伺服器把資源搬去了哪裡。
4xx 用戶端錯誤裡最容易混淆的四個代碼
4xx 代表問題出在請求端,不是伺服器出狀況,常見情境包括網址打錯、頁面真的被刪除、或存取權限不足。Google 官方文件對整個 4xx 類別給出一致的處理邏輯:「Google 不會使用傳回 4xx 狀態碼的網址內容。如果網址先前曾使用過,但現在會傳回 4xx 狀態碼,Google 系統會逐漸停止使用該網址……索引管道會將先前已建立索引的網址從索引中移除,同時也不會處理新檢索的 404 網頁。檢索頻率會逐漸降低。」
這份文件把 401、403、404、410 這幾個代碼都歸在同一種處理方式裡,對 Google 來說都是「這個網址不存在或不能看」的訊號,差別只在原因不同;429 雖然名義上也掛在 4xx 底下,Google 卻是當成伺服器端限流的訊號來對待,跟其他 4xx 代碼分開處理。
401 與 403 都是權限問題,差別在於身分是否已被伺服器辨識
401 Unauthorized 名稱容易讓人誤會成「沒有授權」,但依 MDN 的定義,它真正的語意其實是「尚未驗證身分」,用戶端必須先證明自己是誰、提供帳號密碼或其他憑證,才能拿到原本要的回應。常見情境是進入需要登入的會員專區或後台管理頁面,系統還不知道請求者是誰,先擋下來要求登入。
403 Forbidden 則是伺服器已經知道請求者的身分,卻明確拒絕存取,例如登入了一般會員帳號,卻試圖打開只有管理員能看的頁面。MDN 也提到一個實務上常見的做法,有些伺服器會刻意用 404 取代 403,對沒有權限的用戶端隱藏「這個資源其實存在」這件事,避免洩漏檔案結構或內部路徑,讓對方連猜都猜不到有這個頁面存在。
404 沒有暫時或永久之分,410 才明確代表永久移除
404 Not Found 依 MDN 的定義,代表伺服器找不到要求的資源,在瀏覽器裡意味著這個網址不被認得,在 API 情境裡也可能代表端點本身有效,只是資源不存在。410 Gone 則更明確,代表要求的內容已經從伺服器永久刪除,而且沒有轉送位址,用戶端應該清除自己對這個資源的快取與連結。RFC 9110 也說明,410 常見的情境是「限時的促銷活動」與「已不再隸屬該網站的個人所留下的頁面」這類本來就預期會消失的內容,並註明伺服器擁有者不必把每一筆永久下架的資源都特地標成 410、也不必堅持標多久,要不要用,由伺服器擁有者自行判斷。
很多人以為 410 一定比 404 更能加速 Google 把頁面從索引移除,實際上兩者差別不大。Google 官方部落格對這件事的立場相當直白:「目前 Google 處理 410(Gone)與 404(Not Found)的方式相同,因此無論您是傳回哪一個都差別不大。」Google 說明檢索器如何處理狀態碼的文件,也把 404 與 410 歸在同一種處理方式,已建立索引的網址都會從索引中移除。同一篇部落格文章也澄清,網站上有部分網址已不存在或傳回 404 錯誤,不會影響網站其他傳回 200 狀態碼的網址在搜尋結果中的表現。也就是說,真正該花心力判斷的不是「選 404 還是選 410 才能加速索引移除」,而是這個網址該不該回傳成功以外的代碼,這件事判斷對了,404 與 410 之間怎麼選其實影響有限。
429 代表請求太頻繁,Google 視為伺服器過載的訊號
429 Too Many Requests 依 MDN 的定義,代表使用者在一定時間內送出過多請求,也就是常說的速率限制(rate limiting)。這個代碼在 API 串接或大流量網站特別常見,例如同一支程式短時間內重複呼叫同一個 API 端點,伺服器判斷請求頻率超過負荷,就會回傳 429 擋下多餘的請求。
Google 的處理方式跟其他 4xx 明顯不同,官方文件寫道,「Google 檢索器會將 429 狀態碼視為伺服器超載的信號,並判定為伺服器錯誤」,而不是歸在「這個網址不存在」那一類。這也解釋了不少人會遇到的困惑,網站流量一多,Search Console 的檢索狀態報表就跳出大量 429,其實不代表這些頁面出了什麼內容問題,而是 Google 的檢索器暫時被伺服器擋在門外,伺服器端該優先檢查的是主機資源或速率限制的門檻設得會不會太緊。
同樣是錯誤代碼,4xx 要看的是使用者送出了什麼樣的請求,5xx 要看的則是伺服器那一端有沒有把工作完成,兩種代碼查故障的方向完全不同。
500 到 504 分別反映的伺服器故障環節
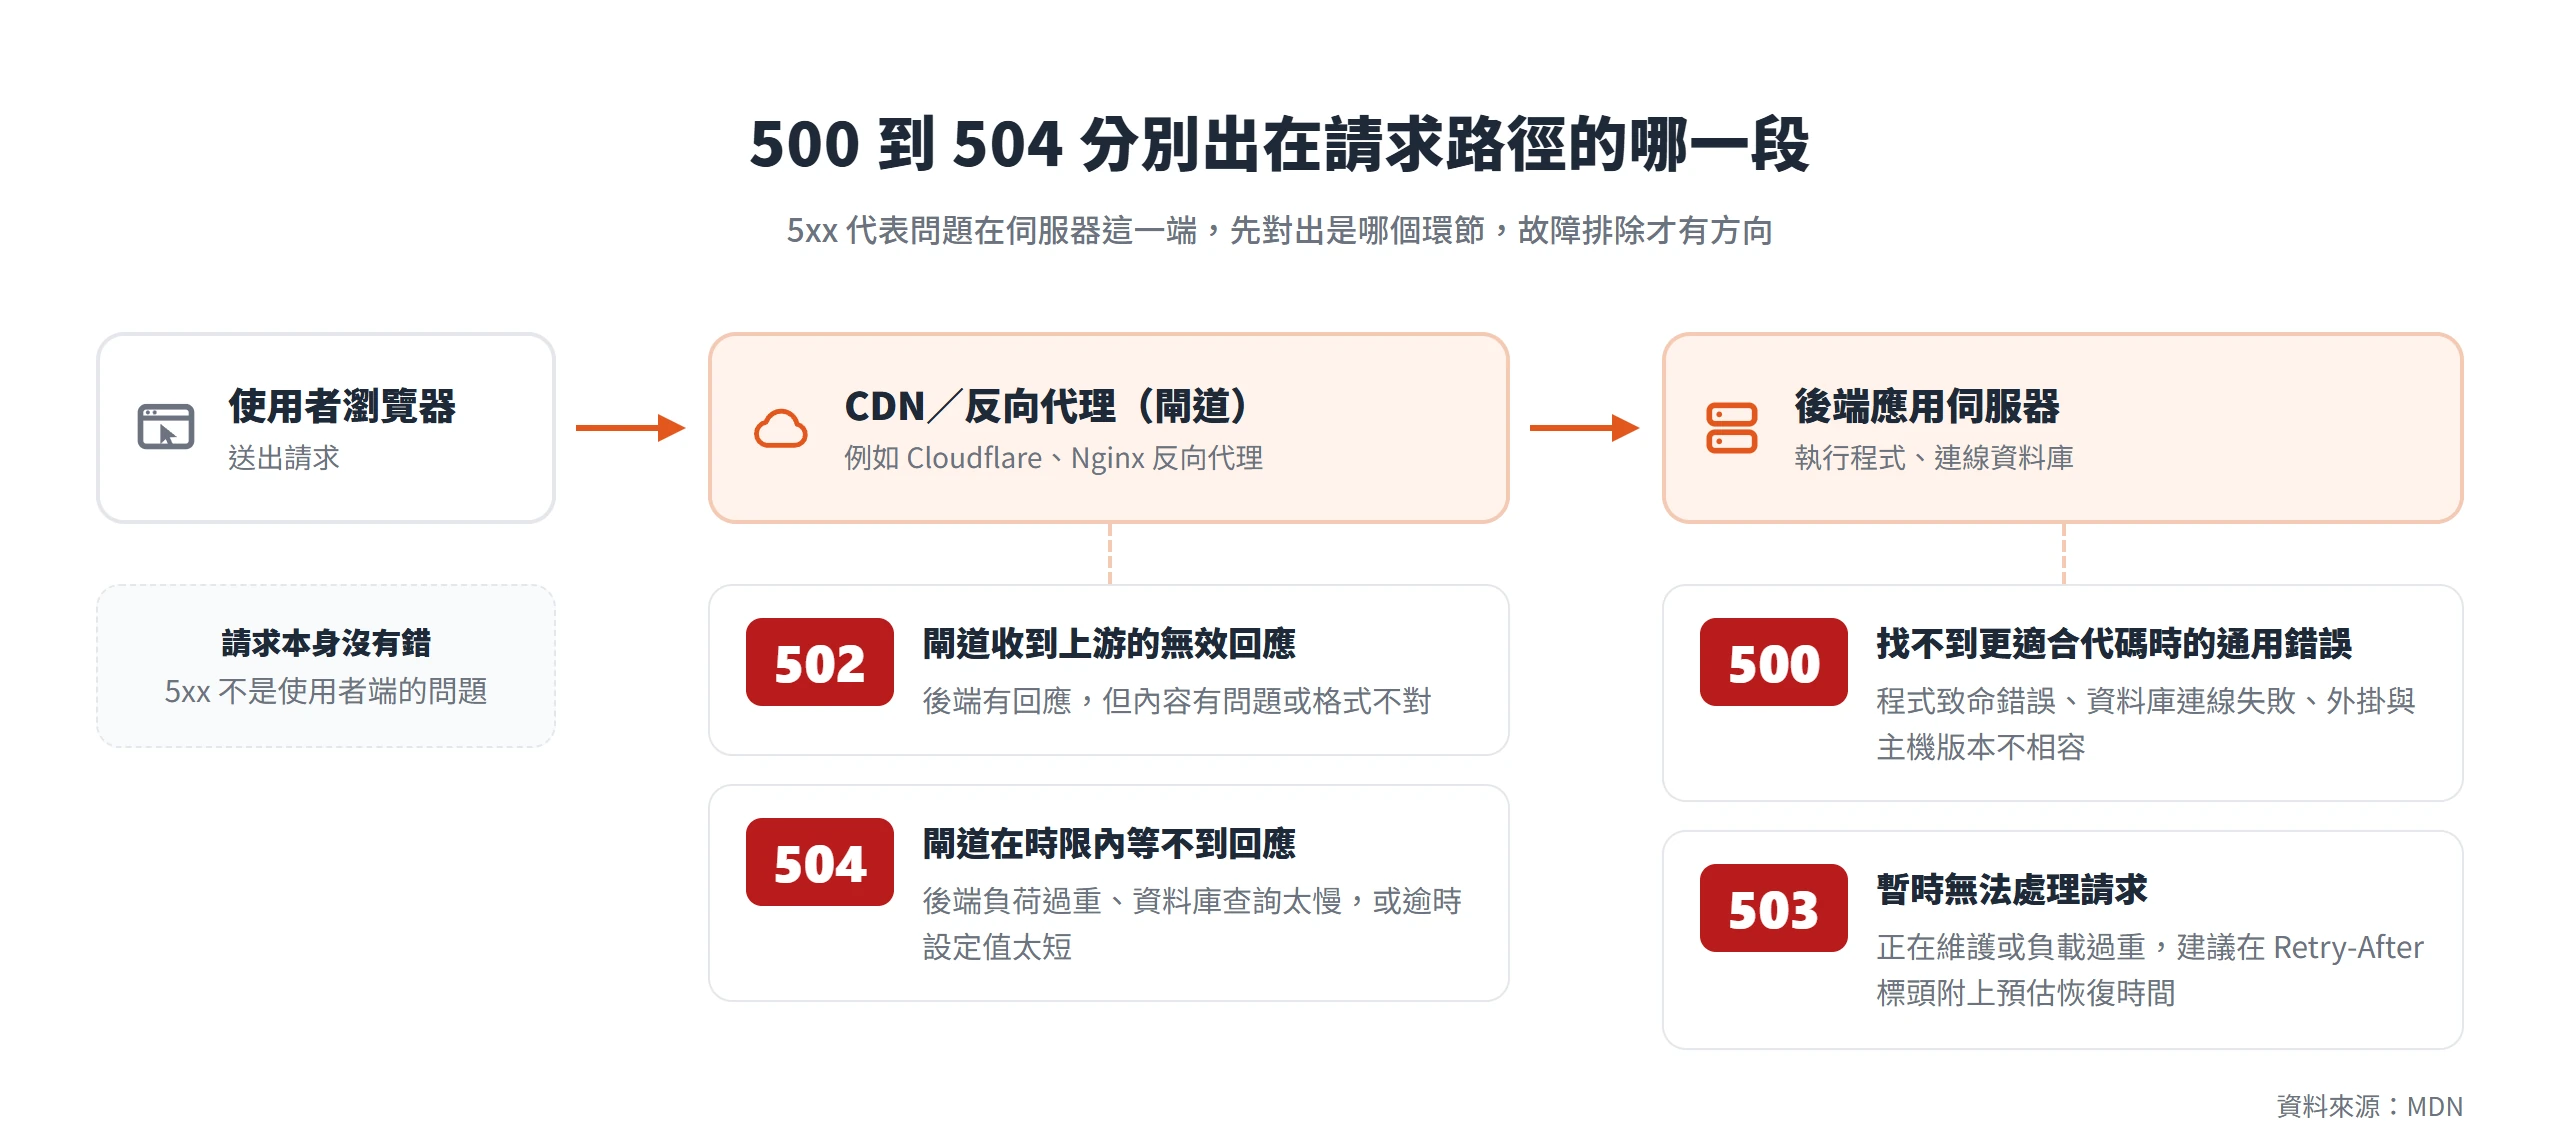
5xx 代表問題出在伺服器這一端,不是使用者的請求有錯,常見情境包括程式本身出錯、反向代理或 CDN 層發生異常,或是伺服器暫時因維護、過載而無法處理請求。這幾個代碼各自對應不同的故障環節,先分清楚哪個代碼對應哪個環節,故障排除時才不用把所有可能都試一遍。
Google 官方文件對整個 5xx 類別的處理邏輯寫得很清楚:「5xx 和 429 伺服器錯誤會促使 Google 檢索器暫時降低檢索頻率。對於 Google 搜尋,系統會將已建立索引的網址保留在索引中,但最終會予以移除。系統會忽略 Google 從傳回 5xx 狀態碼的網址收到的所有內容……伺服器開始傳回 2xx 狀態碼後,Google 會逐步提高網站的檢索頻率。」換句話說,短暫的 5xx 不會立刻讓網頁被踢出索引,但如果拖得太久,一樣會走向被移除的結果。
500 是沒有更適合代碼可用時的通用伺服器錯誤
500 Internal Server Error 是最籠統的伺服器錯誤代碼,依 MDN 的定義,代表伺服器遇到不知道該如何處理的情況,而且找不到更適合的 5xx 狀態碼可以回應。常見成因包括程式碼本身的致命錯誤、資料庫連線失敗,或是外掛與主機環境版本不相容,伺服器軟體找不到更精確的代碼可以歸類,就統一回傳 500。
因為 500 幾乎是「什麼都可能」的萬用錯誤,單看這個代碼本身通常查不出真正原因,得回頭看伺服器的錯誤紀錄檔(error log)才找得到線索。這也是為什麼 500 的成因分布特別廣,同一支網站在不同時間跳出 500,背後的問題可能完全不一樣,不能套用同一套排除方式。
502 與 504 通常出在反向代理或上游伺服器逾時
這 2 個代碼特別常出現在架構前面掛了 CDN、反向代理或負載平衡器的網站,例如網站前端接了 Cloudflare,或是用 Nginx 當反向代理轉發請求到後端的應用伺服器。依 MDN 的定義,502 Bad Gateway 代表伺服器作為閘道去取得處理請求所需的回應時,收到了無效的回應;504 Gateway Timeout 則是伺服器作為閘道,卻無法在時限內取得回應。
對一般網站經營者來說,看到 502 或 504,該先查的是站台前面有沒有掛額外的代理層,而不是先懷疑主機本身壞掉。502 多半代表後端伺服器有回應,但回應內容本身有問題或格式不對;504 則代表後端伺服器根本沒有在時限內回應,常見原因是後端負荷過重、資料庫查詢太慢,或是逾時設定值訂得太短,一個原本正常但比較慢的請求就被判定逾時。
503 代表伺服器暫時無法處理請求,通常因為維護或過載
503 Service Unavailable 依 MDN 的定義,代表伺服器還沒準備好處理這個請求,常見原因是伺服器正在維護,或是負載過重。MDN 也建議,這個回應應該同時附上讓使用者理解狀況的頁面說明,而且這個狀態應該用於暫時性的情況,若可能,應該在 Retry-After 標頭附上服務恢復的預估時間。
另外要注意的是快取設定。MDN 特別提醒,網站管理者必須注意這個回應附帶的快取相關標頭,因為這類暫時性狀況的回應通常不該被快取。如果一個排程維護用的 503 頁面被快取機制記住,等到維護結束、伺服器恢復正常,使用者或搜尋引擎的檢索器卻可能還在讀取那份被快取住的 503 回應,原本只該持續幾分鐘的暫時狀態,結果被拖成長時間看起來「網站掛了」。
5xx 反映的是伺服器真的當機或過載,監控後台通常抓得到;soft 404 卻不一樣,伺服器其實一切正常運作,只是回錯了狀態碼,而且不會有任何錯誤紀錄提醒這件事發生了。
soft 404 是網頁其實找不到卻仍回傳成功狀態碼的常見誤設
soft 404 是一個實務上很容易犯、卻很難自己發現的錯誤。Google 官方部落格對它的定義很直接:「soft 404 是指網路伺服器針對不存在的網址,傳回 404(或 410)以外的回應代碼的情況。常見的例子是,網站擁有者希望傳回 404 網頁時一併為使用者提供實用資訊,而且認為如果要向使用者提供內容,就必須傳回 200 回應代碼。但事實並非如此!」
這句話點出 soft 404 最常見的成因,很多人誤以為「要讓使用者看到內容」就一定要搭配 200,於是自訂了一個設計精美、附帶導覽連結的錯誤頁面,卻忘了同時把伺服器實際回傳的狀態碼改成 404 或 410。同一篇文章也明確表態,網站移除網頁時,Google 偏好伺服器回傳 404 或 410,而不是 soft 404。
soft 404 對 SEO 的實際傷害,不在於它會讓網站被處罰,而在於浪費檢索資源。Google 官方文件說明:「Google 會查看網頁內容,再決定是否處理……如果內容疑似是 Google 搜尋的錯誤(例如空白網頁或錯誤訊息),Search Console 就會顯示 soft 404 錯誤」,而且這些網址會持續被檢索器造訪,佔用原本該花在正常網頁上的檢索資源。對中大型網站來說,大量 soft 404 網址長期存在,等於讓 Google 的檢索器把力氣耗在不該花的地方,排擠到真正該被優先檢索的新內容或更新過的頁面。
自訂錯誤頁面的內容,不影響它該回傳的狀態碼
把「頁面設計得好不好看」跟「狀態碼對不對」這兩件事分開想,問題就簡單很多。網站完全可以自訂一個美觀、附帶站內搜尋欄或熱門文章連結的 404 頁面,同時讓伺服器正確回傳 404 或 410,兩者並不衝突,差別只在於維護錯誤頁面的人,要記得同時檢查 HTTP 層的回應碼有沒有設對。
Google 官方部落格特別提醒一件容易被忽略的事:「即使網頁顯示『404 找不到』也不代表系統會確實傳回 404 HTTP 回應代碼」,並提醒要實際確認一次。很多 CMS 或自架系統的預設行為,是遇到找不到的網址就導向一支通用的錯誤頁面模板,但這支模板本身如果沒有明確設定回傳 404,伺服器很可能還是照著一般頁面的邏輯回傳 200。要確認這件事,不能只看畫面,得用開發者工具或線上檢測工具實際查一次狀態碼。
導向不相關頁面的重新導向,也可能被判定為 soft 404
另一種常見情境,是網站把已下架的商品頁、結束的活動頁,全部一律用重新導向導去首頁,而不是導向相關的分類頁或替代內容。這種做法乍看是禮貌的處理方式,不讓使用者看到錯誤畫面,但 Google 的網站遷移文件指出:「請勿將許多舊網址重新導向至不相關的單一目的地(例如新網站的首頁),這不但會造成使用者混淆,還可能遭 Google 視為 soft 404 錯誤。」
換句話說,做了重新導向不代表就安全過關,重新導向的目標網頁內容跟原本網址講的是不是同一件事,同樣會被納入判斷。Google 談檢索預算的文件也提醒,系統會繼續檢索 soft 404 網頁,白白浪費檢索預算,所以排除 soft 404 錯誤本身就能提升檢索效率。實務上比較穩妥的做法,是把已下架的內容導向真正相關的分類頁或替代商品,真的沒有相關內容可以承接,就直接讓它回傳 404 或 410,而不是硬導去一個八竿子打不著的首頁。
看懂狀態碼分成哪 5 類、各自代表什麼處理邏輯是一回事,實際去確認某個網址現在回傳哪一個代碼,又是另一回事。前面已經提過,畫面顯示的文字不能拿來判斷狀態碼對不對,必須靠實際檢測才準。
確認網址目前實際狀態碼的兩種做法
第一種方法是瀏覽器內建的開發者工具,平常瀏覽器本身就有,不需要另外安裝任何東西,比較適合臨時確認一兩個網址。第二種方法是命令列工具 curl,適合需要一次檢查大量網址,或是想寫成簡單腳本定期巡檢,例如網站搬完家之後,要逐一確認所有舊網址是不是都正確導向了新網址。
瀏覽器開發者工具的 Network 分頁直接顯示每個請求的狀態
對不熟悉命令列的人來說,開發者工具是最直覺的方法,不需要額外安裝任何東西,平常用的瀏覽器本身就內建這項功能。打開任何一個網頁,按 F12 叫出開發者工具,切到 Network 分頁,清單裡列出的是這個頁面載入過程中發出的每一筆請求,包含 HTML 本體、圖片、樣式表、字型跟串接的 API,每一列在 Name 旁的 Status 欄都能看到對應的狀態碼。重新整理前記得確認有沒有勾選 Disable cache(停用快取),否則瀏覽器可能直接顯示快取住的舊結果,看到的狀態碼跟伺服器現在實際回傳的不一定相符。
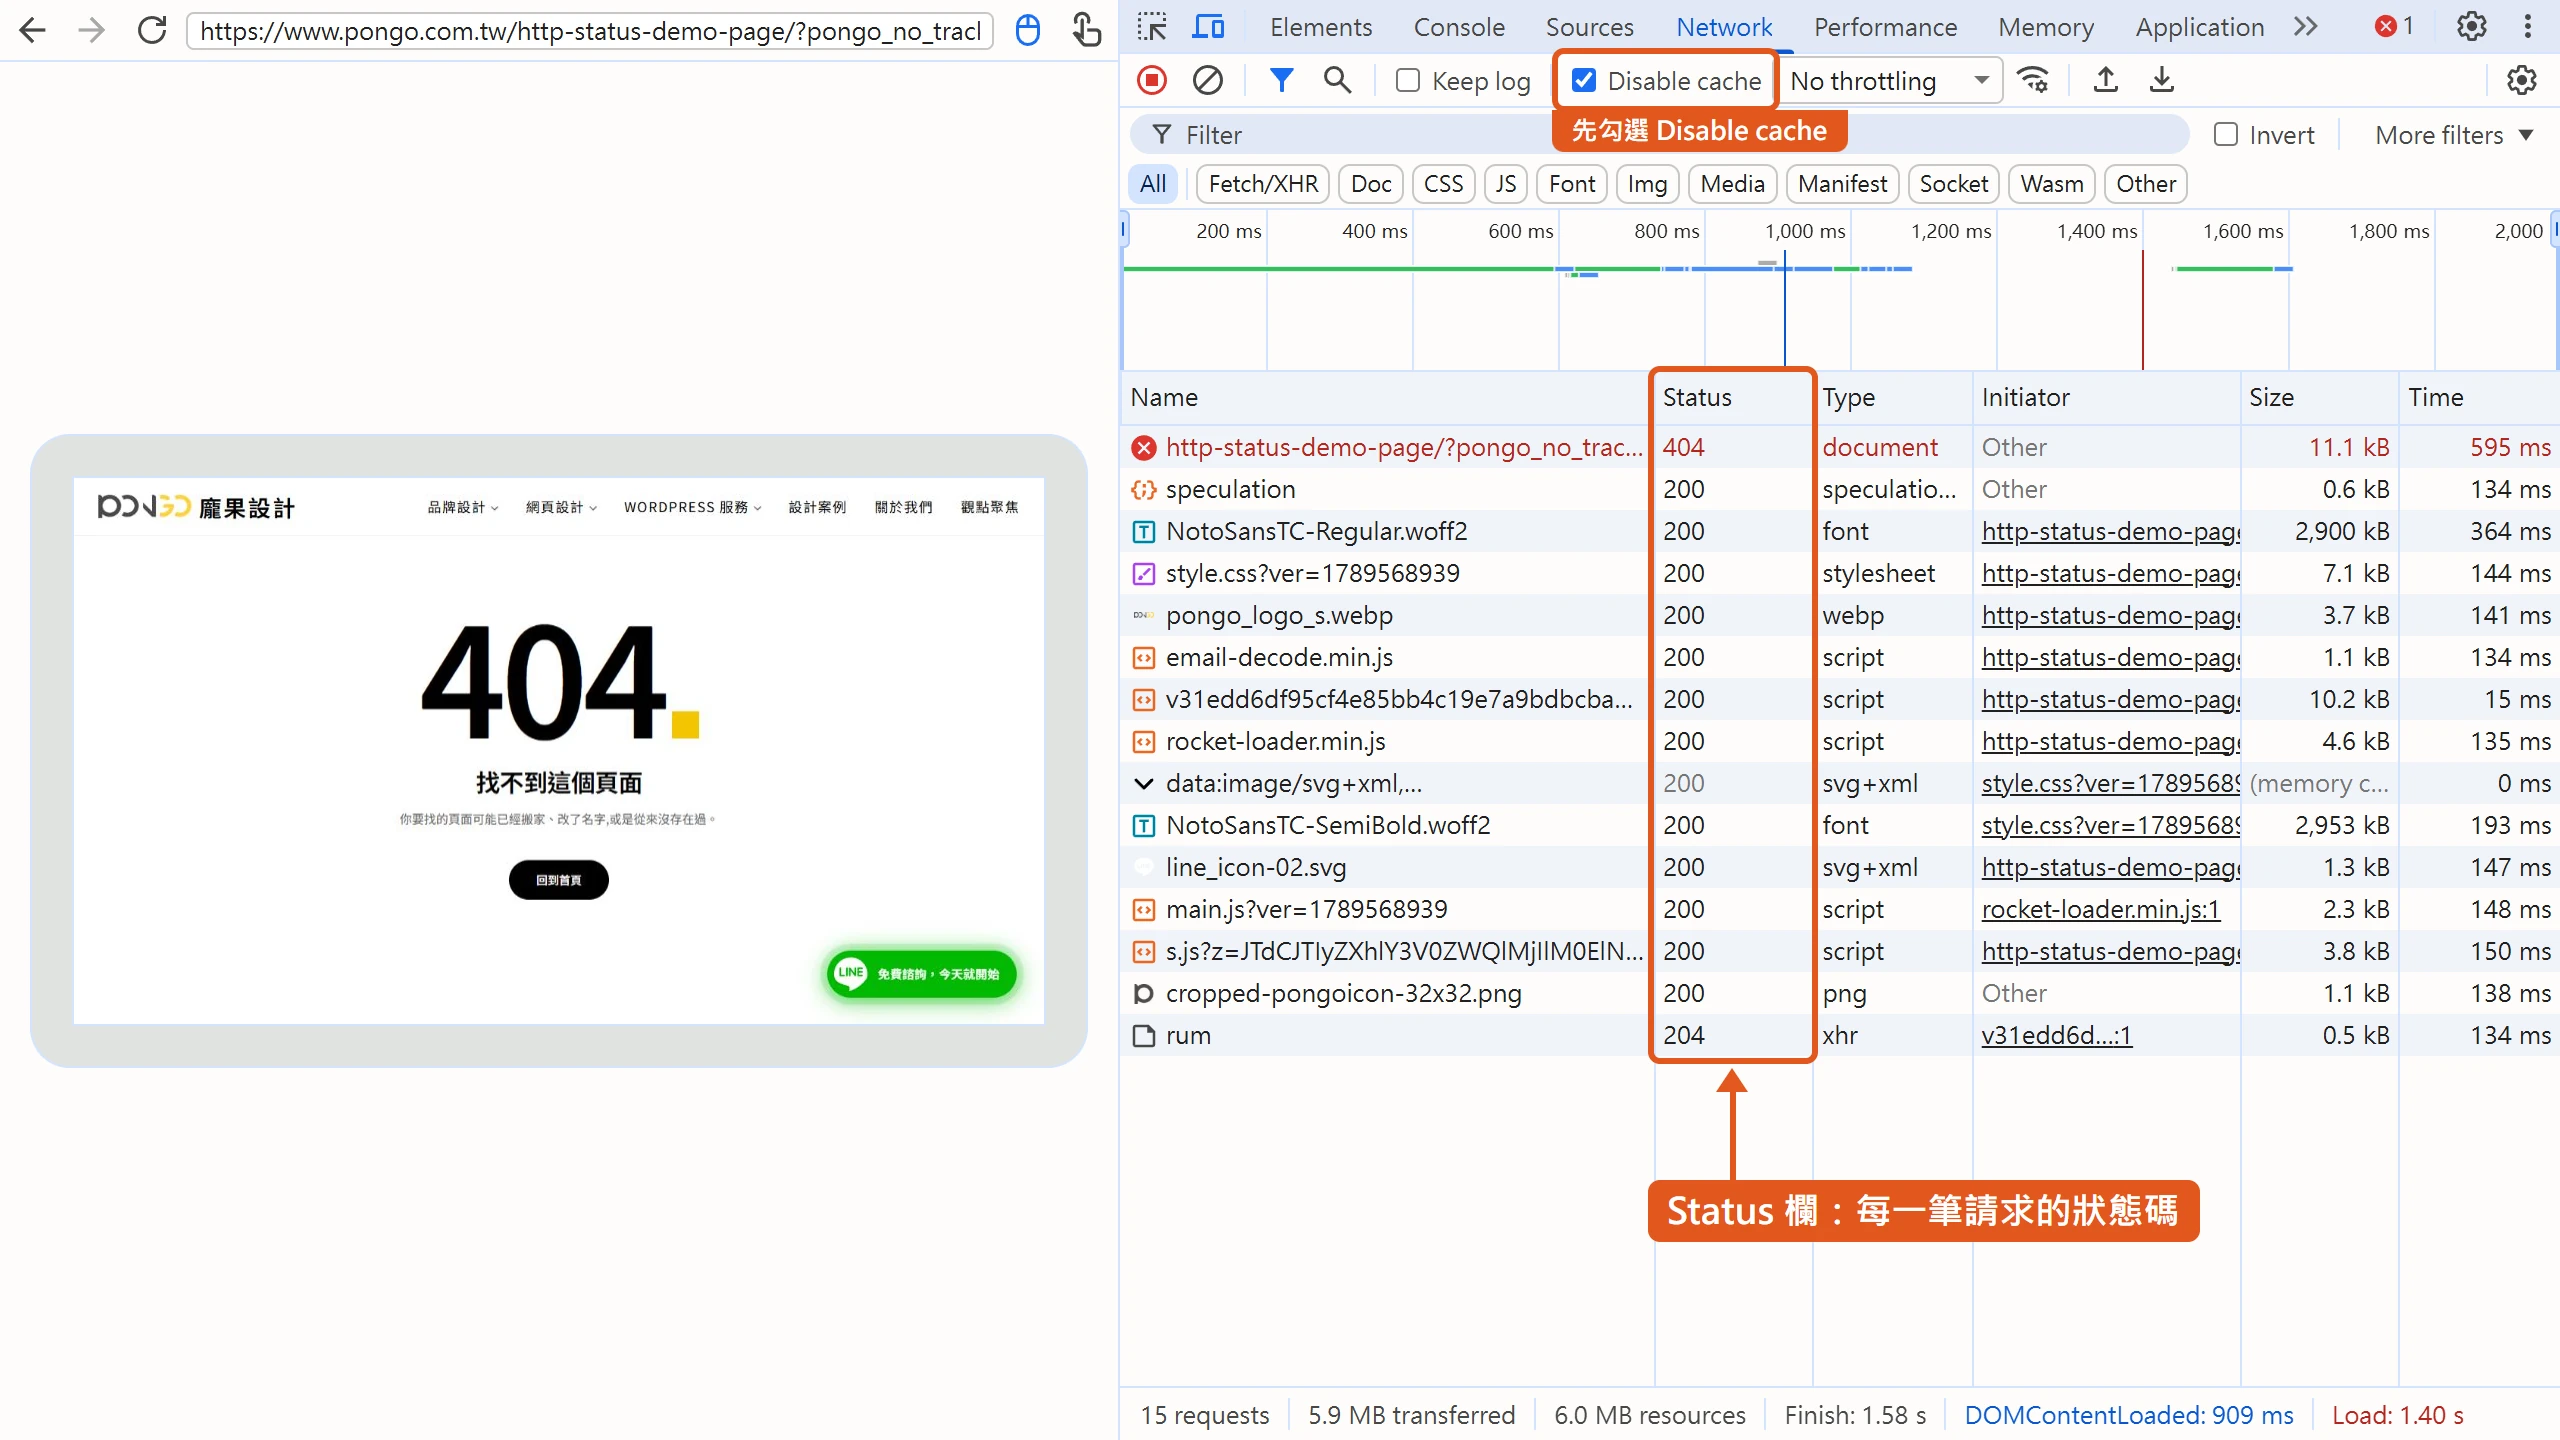
這個方法特別適合臨時確認某一個連結有沒有問題,例如懷疑網站上某個按鈕連到了失效的網址,點一次、看 Network 分頁裡那筆請求的狀態碼,馬上就能確認是 301 跳轉正常、還是直接落在 404。缺點是只能一次看一個頁面,而且要記得清掉快取的干擾,不適合用來一次盤點幾十個、幾百個網址。
命令列的 curl 指令,不開瀏覽器也能取得純狀態碼
curl 是行之有年的標準命令列工具,-I 參數只取得回應標頭,不會下載整個頁面本體,速度快很多,也不會佔用太多頻寬。實際下指令的寫法很簡單:
curl -I https://example.comCode language: Bash (bash)執行之後,第一行就會顯示狀態碼,例如 HTTP/1.1 200 OK,如果這個網址設了重新導向,還會在後面的標頭裡看到 Location 欄位,直接告訴你它導去了哪裡。
如果只想拿到單純的數字,不想看整段標頭,可以加上 -w 參數自訂輸出格式:
curl -s -o /dev/null -w "%{http_code}" https://example.comCode language: Bash (bash)這行指令會把回應內容全部丟到 /dev/null(不顯示、不儲存),只印出最後的狀態碼數字,很適合寫成簡單的 shell 腳本,搭配一份網址清單逐一檢查,例如搬家後要確認幾十個舊網址是不是都正確導向新網址,用這個寫法批次跑一次,比一個個開瀏覽器手動檢查快得多。
這 3 位數字看似枯燥,但它其實是使用者、瀏覽器與搜尋引擎之間最基本的溝通語言。網站改版、搬家、下架舊內容,每一次調整背後其實都在回答同一個問題,這個網址現在該回傳哪一個狀態碼,才符合它真正的狀態。選對了,重新導向的排名信號會順利轉移,刪除的頁面能被正確踢出索引,搜尋引擎也不會把力氣浪費在檢索一堆假裝存在的錯誤頁面上。下次網站出現異常,與其只看畫面上顯示了什麼文字,不如先打開開發者工具或跑一次 curl,看看伺服器真正回傳的是哪一組數字,答案往往比畫面上的錯誤訊息更誠實。