用 Nano Banana 修圖,比較像把照片遞給一位看得懂照片的修圖助理,再口頭交代一句「沙發換成棕色皮革,其他地方都不要動」,而不是自己拿著套索工具,沿著沙發邊緣一點一點描。Nano Banana 是 Gemini 內建圖像功能的名稱,換背景、移除路人、替衣服換色、把糊掉的老照片補清楚,都可以在對話框裡用文字提出來。
不過一句話能不能改得乾淨,差別往往不在模型,而在這句話有沒有講清楚兩件事,一是要改哪裡,二是哪裡不准動。只講前者的時候,模型得自己猜哪些地方可以碰,人物的臉、商品包裝上的字就有被一起改動的風險。
而要把這兩件事交代清楚,得先弄懂這種修圖和傳統軟體的根本差別,因為它用來限定範圍的工具不是選取框,而是語言。
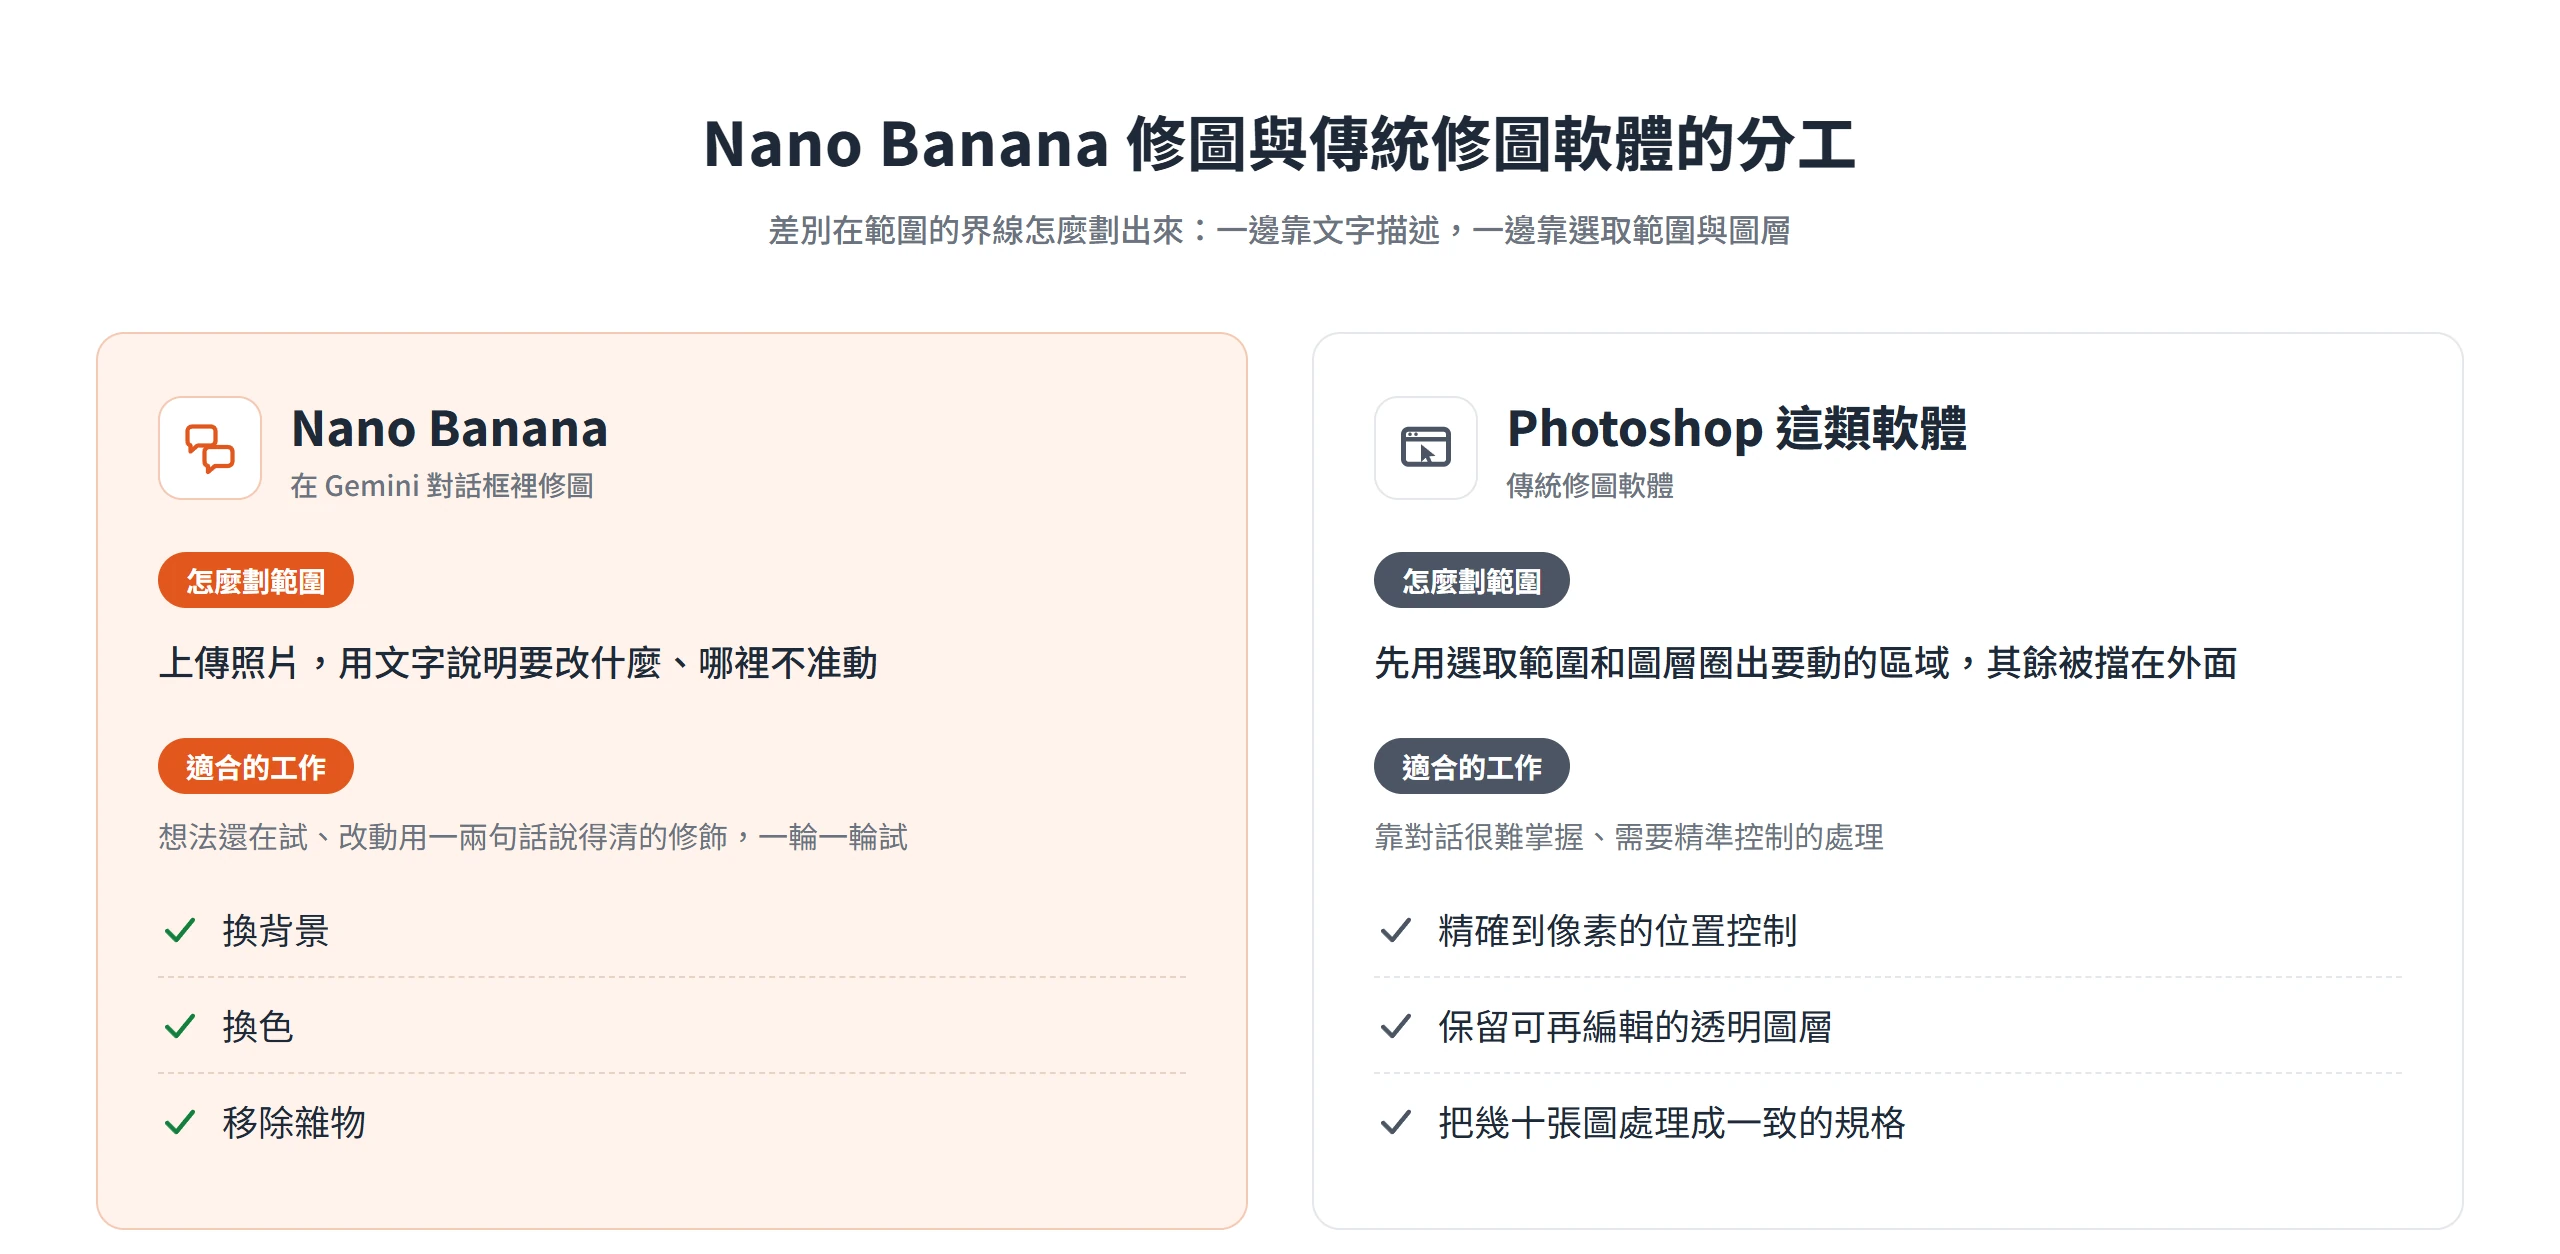
Nano Banana 修圖靠對話完成,不靠選取與圖層
在 Photoshop 這類軟體裡,修圖靠的是選取範圍和圖層,先把要動的區域圈出來,其餘部分就被擋在選取範圍外面。Gemini 裡沒有這一步,你上傳照片,再用文字說明想改什麼,範圍的界線全靠你怎麼描述。
Google 的說明提到,Nano Banana 從底層就設計成同時處理文字與圖片,它的幾個特性正好對應這種對話式的修圖方式:
- 同時讀圖和讀字。 模型看著你上傳的那張照片,同時理解你寫的指令,所以「把左邊那盞燈關掉」這種句子,它要自己在畫面裡找出哪一盞是左邊的燈。
- 記得前面做過的修改。 它不會把每個新請求當成空白開始,而是記得同一次對話裡剛做過的圖,所以你可以一輪一輪往下調。
- 能運用對真實世界的理解補足模糊指令。 例如修復老照片並上色時,Google 提到模型會結合對歷史脈絡的理解,這也是指令不必寫到每個細節的原因之一。
Nano Banana 的產品負責人 Nicole Brichtova 在 2025 年 Google 部落格的一篇文章裡,把這種做法稱為「pixel-perfect editing」,舉的例子是只改變單一細節,像沙發的顏色,而不影響場景裡的其他部分。這是 Google 對這項能力的定位,實際表現則要再對照 Google DeepMind 替 Nano Banana 2.1 寫的模型卡。模型卡列出的已知限制裡,有一條是人物外觀在輸入圖與輸出圖之間不一定完全一致,另一條是罕見情況下,輸出圖會沿用輸入圖主體的姿勢與結構。
換句話說,「只動指定的地方」是模型努力做到的結果,不是保證。這也是實際修圖時要反覆做兩件事的理由,一是把不動的範圍寫進指令,二是把大修改拆成小步驟,讓每一步都留下檢查和退回的空間。
什麼時候適合用它,什麼時候該回到傳統軟體,大致可以這樣分:想法還在試、改動可以用一兩句話說清楚的修飾,例如換背景、換色、移除雜物,適合用 Nano Banana 一輪一輪試;需要精確到像素的位置控制、要保留可再編輯的透明圖層,或是要把幾十張圖處理成一致的規格,這幾件事靠對話很難掌握,還是 Photoshop 這類軟體比較合適。
Gemini 內的修圖入口與各方案使用的模型版本
修圖有兩條入口。第一條是在 Gemini 的工具選單選「Create images」,接著輸入指令,或直接上傳要編輯的照片。第二條是到 Library 裡開啟一張已經存在的圖片,按下 Chat,再輸入想要的修改。第二條路徑,網頁版 Gemini 和手機 App 都有。
Google 的說明頁把編輯分成三種情況:修改 Gemini 自己生成的圖、上傳圖片請 Gemini 修改,以及上傳多張圖片合成一張新圖。拿自己的照片來修,走的就是第二種。
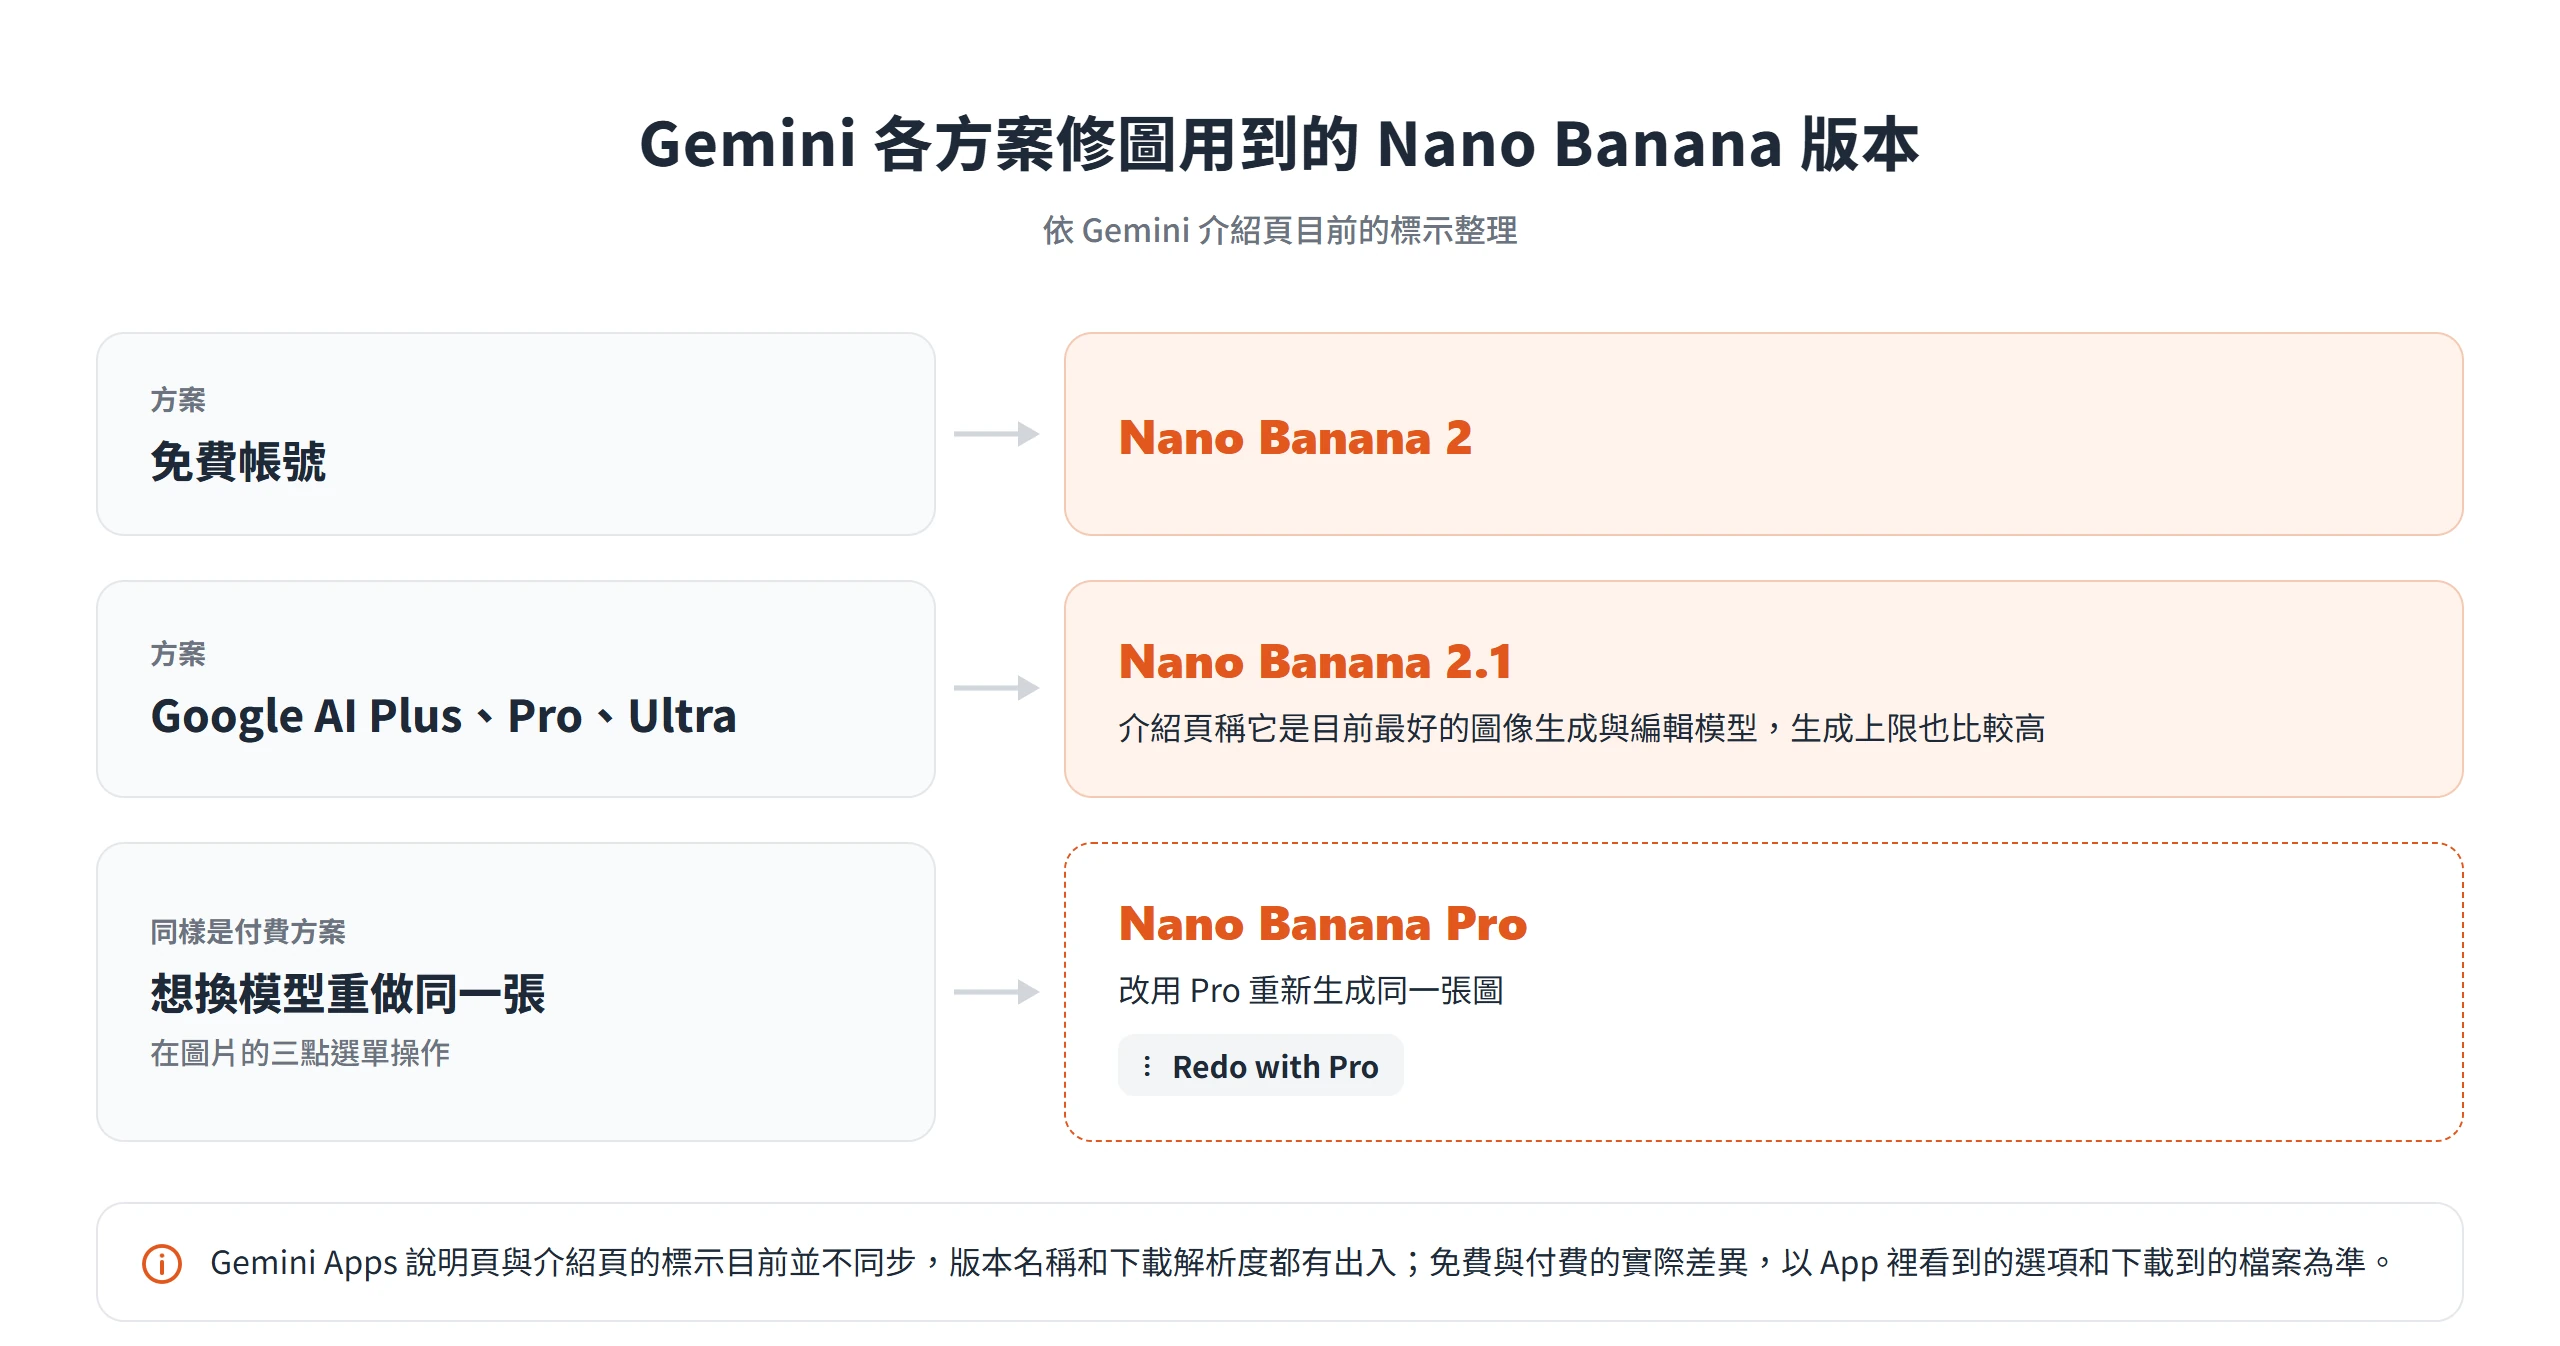
手上的帳號會用到哪一版模型,則要看方案。目前 Gemini 介紹頁的標示如下:
- 免費帳號使用 Nano Banana 2。
- Google AI Plus、Pro、Ultra 使用 Nano Banana 2.1,介紹頁稱它是目前最好的圖像生成與編輯模型,生成上限也比較高。
- 這幾個方案的使用者還可以在三點選單按「Redo with Pro」,改用 Nano Banana Pro 重新生成同一張圖。
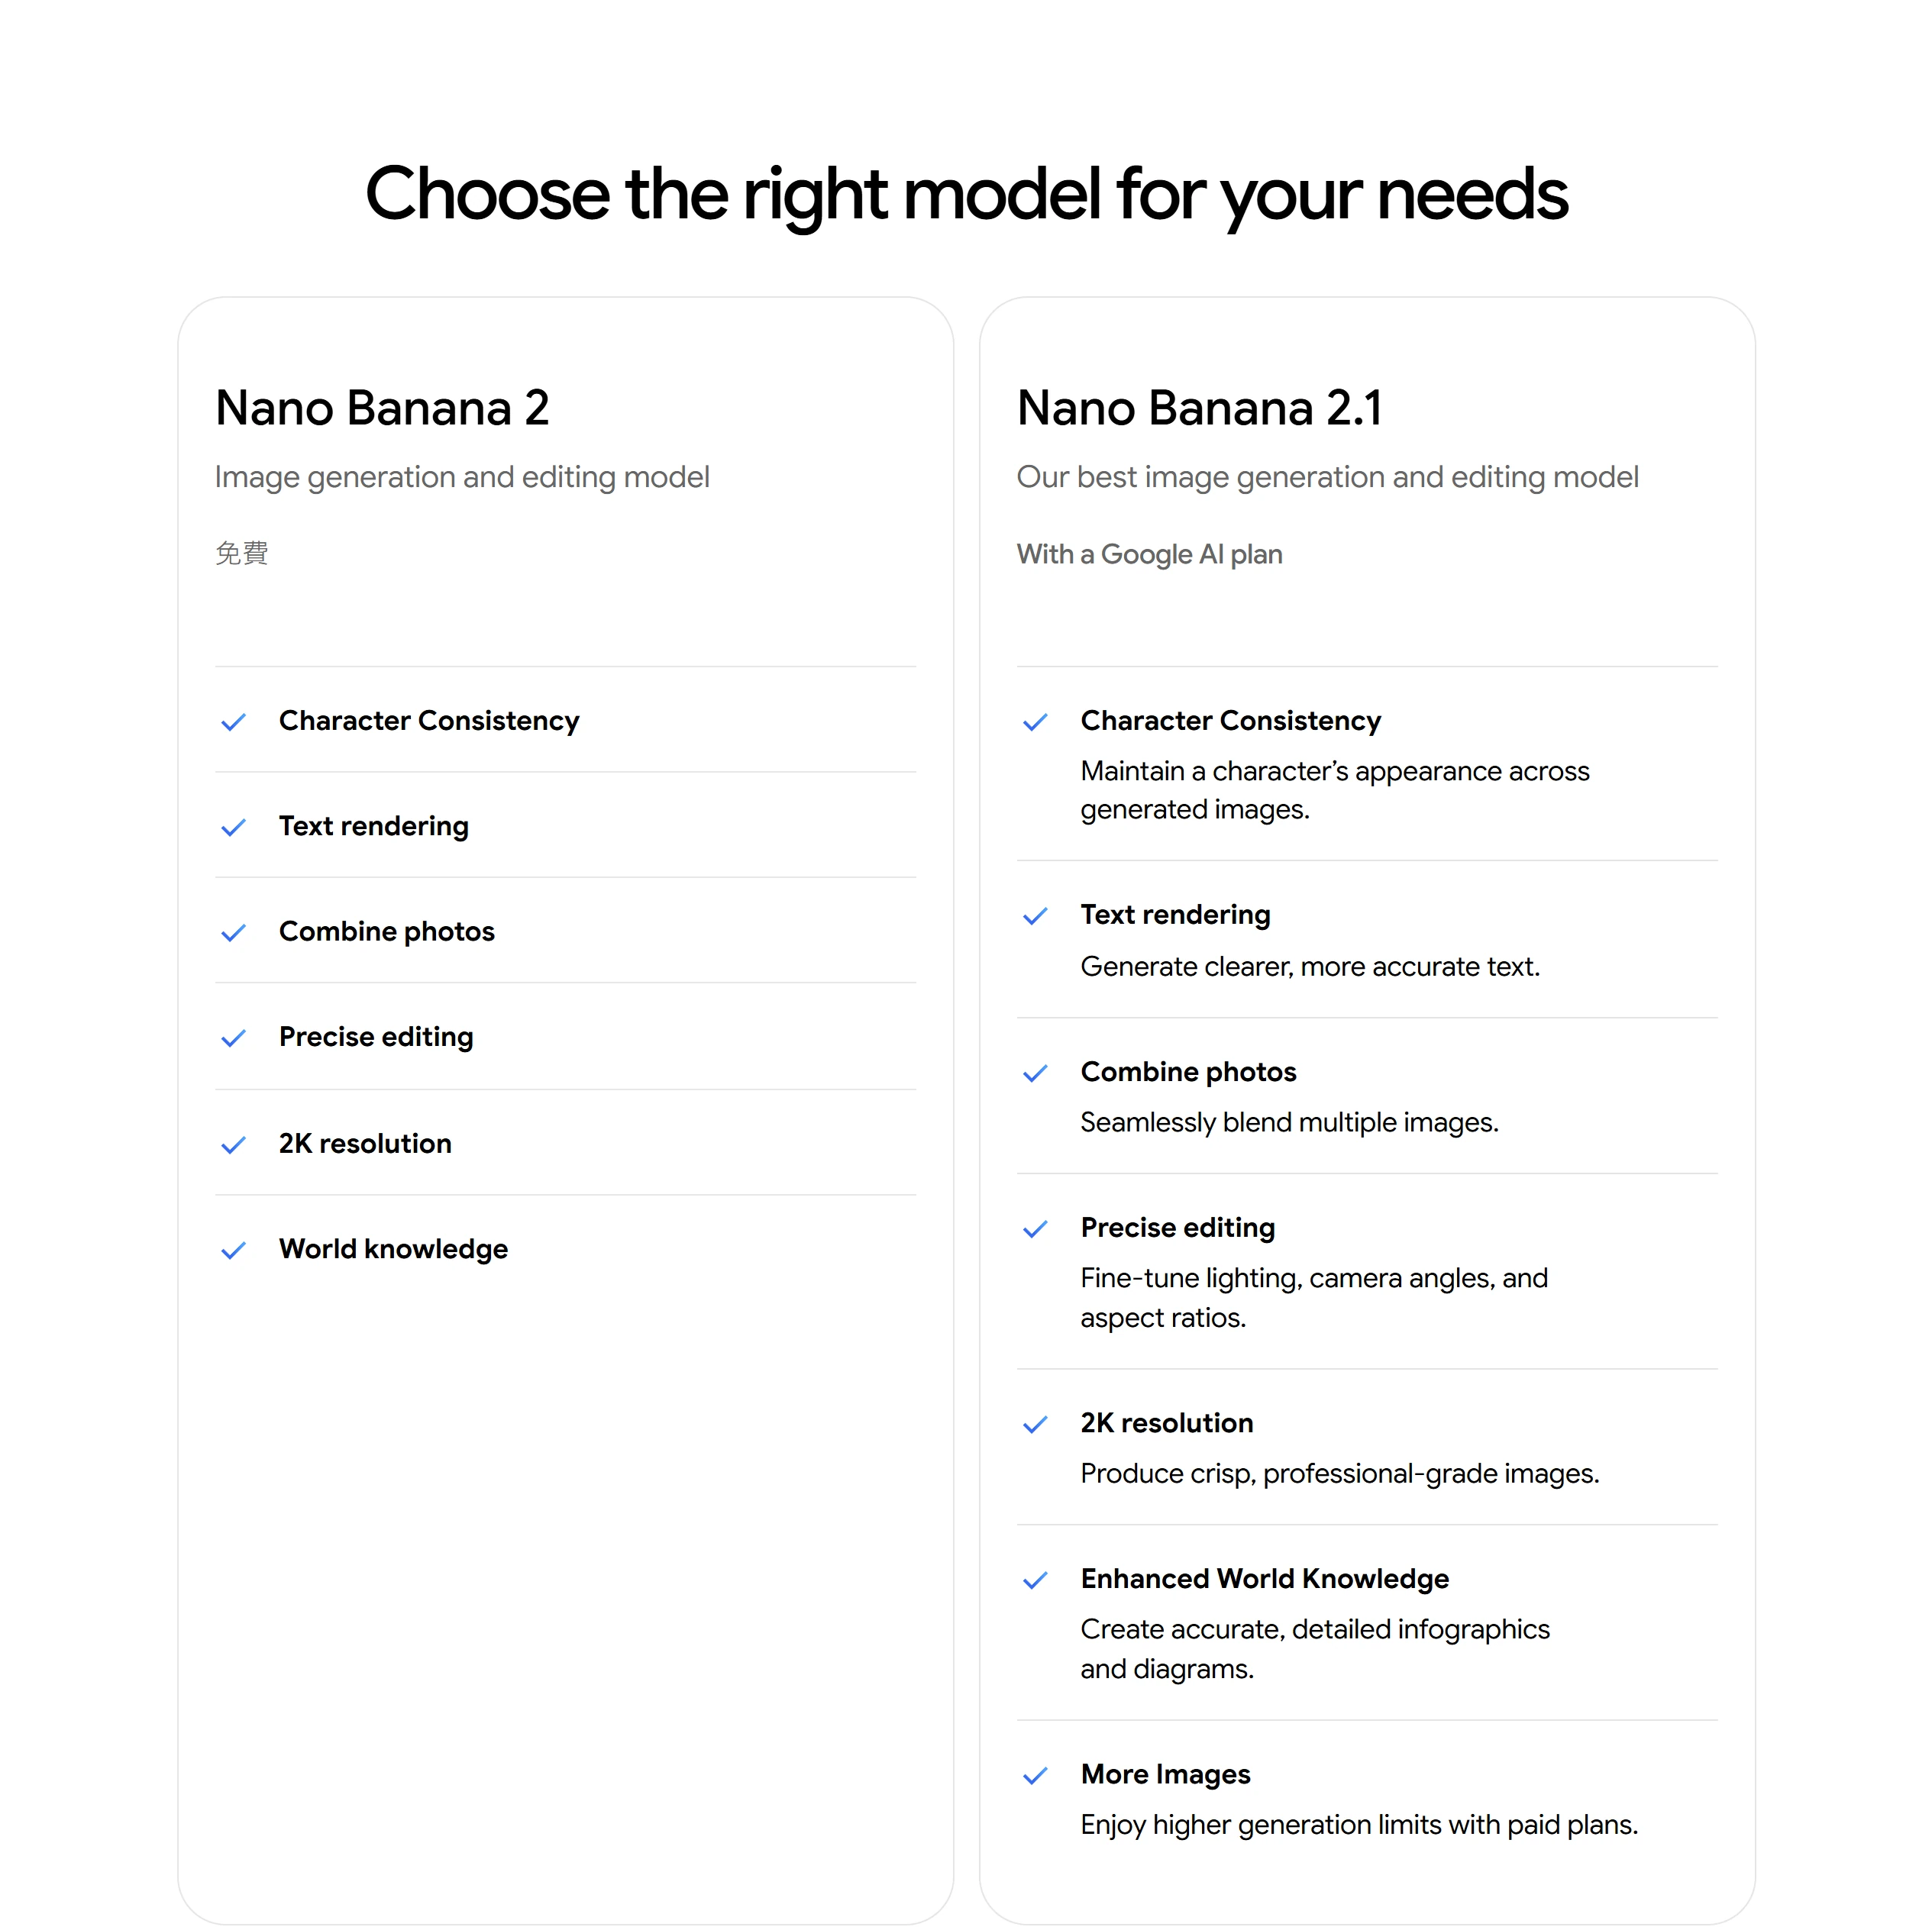
Nano Banana 2.1 由 Google 在 2026 年 10 月 6 日於 Gemini API 更新紀錄中宣布正式推出,屬於 Nano Banana 2 的更新版,視覺品質、指令遵循、多輪人物一致性與文字渲染都有提升。
只是各頁面的標示目前並不同步。Gemini Apps 說明頁的內文還沒改成 2.1,列的仍是 Nano Banana 2、2 Lite 與 Pro 這幾種;下載解析度也有出入,說明頁寫訂閱 Google AI 方案是 2K、沒有訂閱方案是 1K,介紹頁的版本表卻把 Nano Banana 2 標成 2K。所以免費與付費的實際差異,以你在 App 裡看到的選項和下載到的檔案為準。
上傳照片之前,還有三件事要先知道。編輯圖片的功能不開放給未滿 18 歲的使用者;上傳的照片必須是你有權使用的,Google 要求使用者遵守生成式 AI 的使用政策,不得侵犯他人的著作權或隱私;另外,所有 Gemini 生成的圖片都帶有 SynthID 浮水印,之後可以上傳到 Gemini 查詢這張圖是不是 AI 生成的。
修圖提示詞的骨架是改動項目與保持不變的範圍
一句好用的修圖提示詞,可以拆成三塊:要改哪個東西、改成什麼樣子,以及哪些地方一律不准動。如果改動會牽涉光線,就要再補一句,說明改完之後要怎麼跟原圖的光線與風格融合。
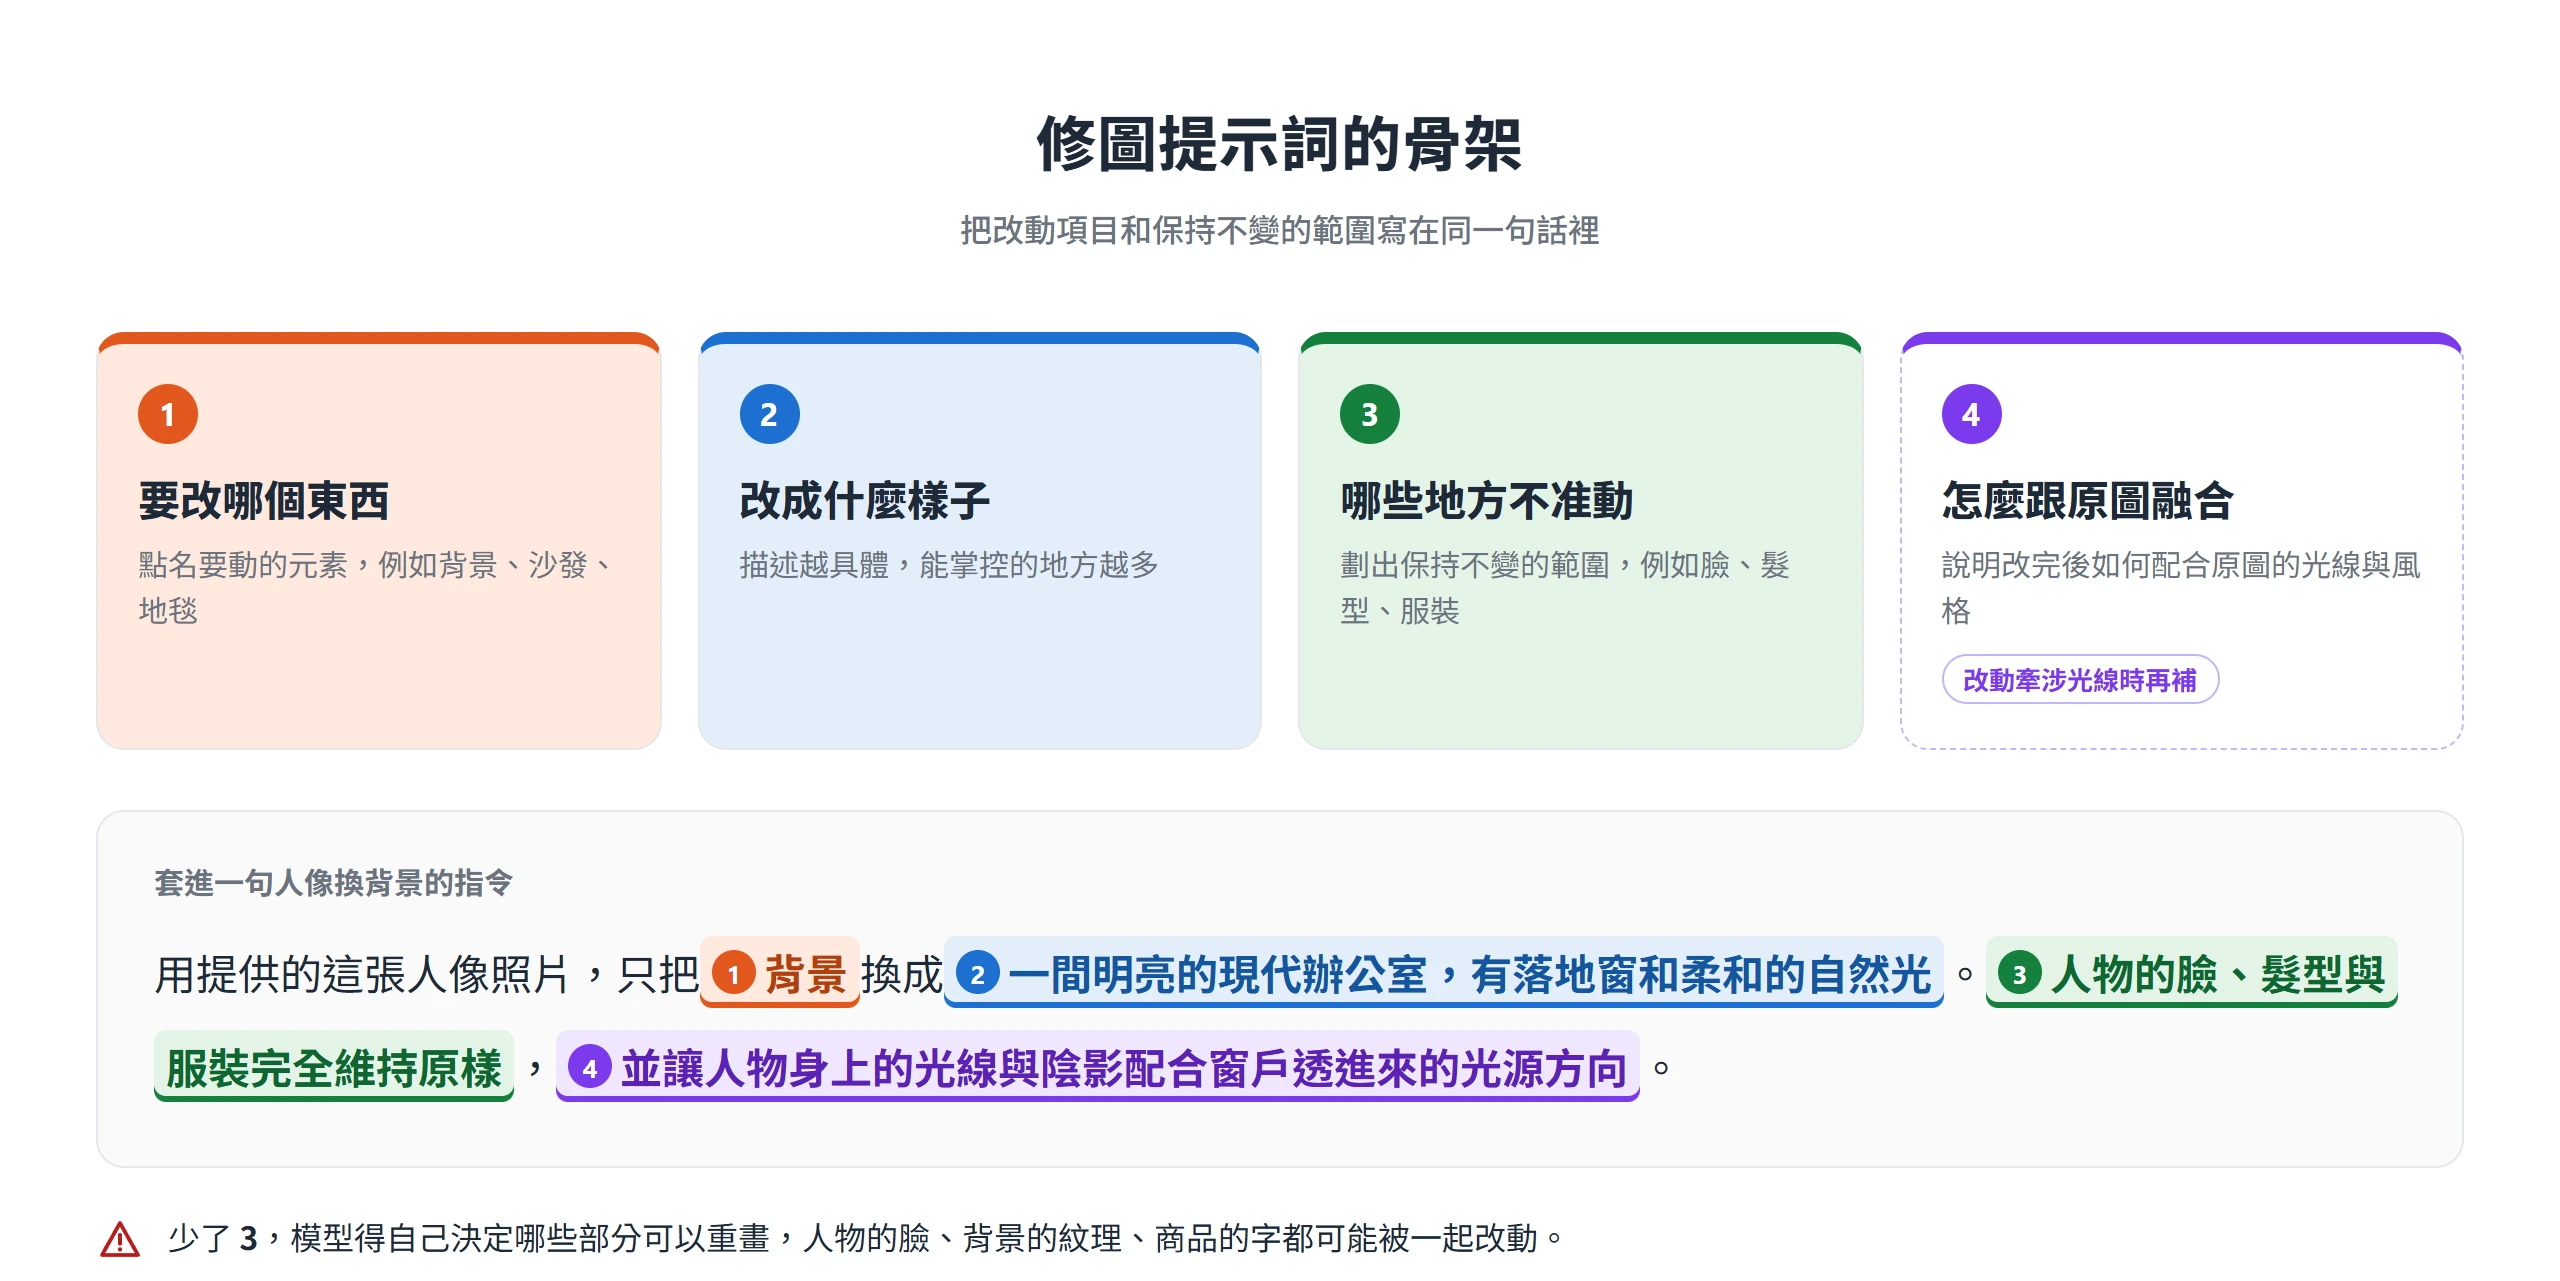
只說改什麼、不說不改什麼,是修圖結果偏離預期最常見的原因之一。指令沒有劃出界線的時候,模型得自己決定哪些部分可以重畫,人物的臉、背景的紋理、商品的字,都可能落在它的判斷範圍裡。
Google 的 Gemini API 提示指南針對修圖,給了兩種寫法。第一種是新增、移除或修改某個元素:
用提供的這張圖片,對 [主體] [新增/移除/修改] [元素],並確保這項改動 [說明要如何與場景融合]。Code language: plaintext (plaintext)Google 的範例是替一張貓咪照片加上一頂針織巫師帽,並要求帽子看起來戴得穩,而且符合照片柔和的光線。依照這個結構改寫成繁體中文,大概是這樣:
用提供的這張貓咪照片,在牠的頭上加一頂小小的針織巫師帽,帽子要看起來戴得穩,並且符合照片柔和的光線。Code language: plaintext (plaintext)第二種是只改一個指定的元素,其餘全部維持原樣:
用提供的這張圖片,只把 [指定元素] 改成 [新的元素或描述]。圖中其他一切維持原樣,保留原本的風格、光線與構圖。Code language: plaintext (plaintext)Google 的範例是把客廳裡的藍色沙發換成復古的棕色皮革沙發,並要求沙發上的抱枕與室內光線都不變。Google 把這種寫法稱為 inpainting(語意遮罩),意思是不用手動畫遮罩,改用對話來定義「改這裡、其他不動」。
以上都是寫法示例,括號裡換成自己的內容就能套用,實際結果會因照片和模型版本而不同。換背景與改細節的寫法,都是從這兩個骨架延伸出來的。
Google 在提示指南的最佳做法裡,有四條和修圖直接相關:
- 具體到細節。 描述越具體,能掌控的地方越多。同樣是換外套,「換一件好看的外套」比不上「換成深藍色羊毛長版大衣,肩線挺直」。
- 說明用途與意圖。 讓模型知道這張圖要拿來做什麼,它對情境的理解會影響結果。例如「這張商品照要放在電商的商品頁」,比什麼都不說更有方向。
- 拆成步驟一步步來。 場景裡元素很多的時候,把指令分成先做什麼、再做什麼,而不是一口氣塞給它。
- 用正面描述取代否定句。 Google 的建議是不說「不要有車」,改說「一條空無一人的街道」,用你想要的畫面取代你不想要的東西。
除了這四條,攝影用語也能用來控制畫面。Google 舉的例子有廣角鏡頭、微距鏡頭與低角度視角,這類詞寫進指令,可以用來指定構圖與視角。
Google 在 Gemini API 文件列出的「最佳效能語言」清單,有英文、日文、韓文等十幾種,中文列的是 zh-CN,也就是簡體中文,並沒有列 zh-TW。所以用繁體中文寫提示詞的時候,效果如何得靠自己用同一張照片實測,中文和英文哪個比較準,沒有資料可以下結論。
換背景要同時交代主體、光線與場景
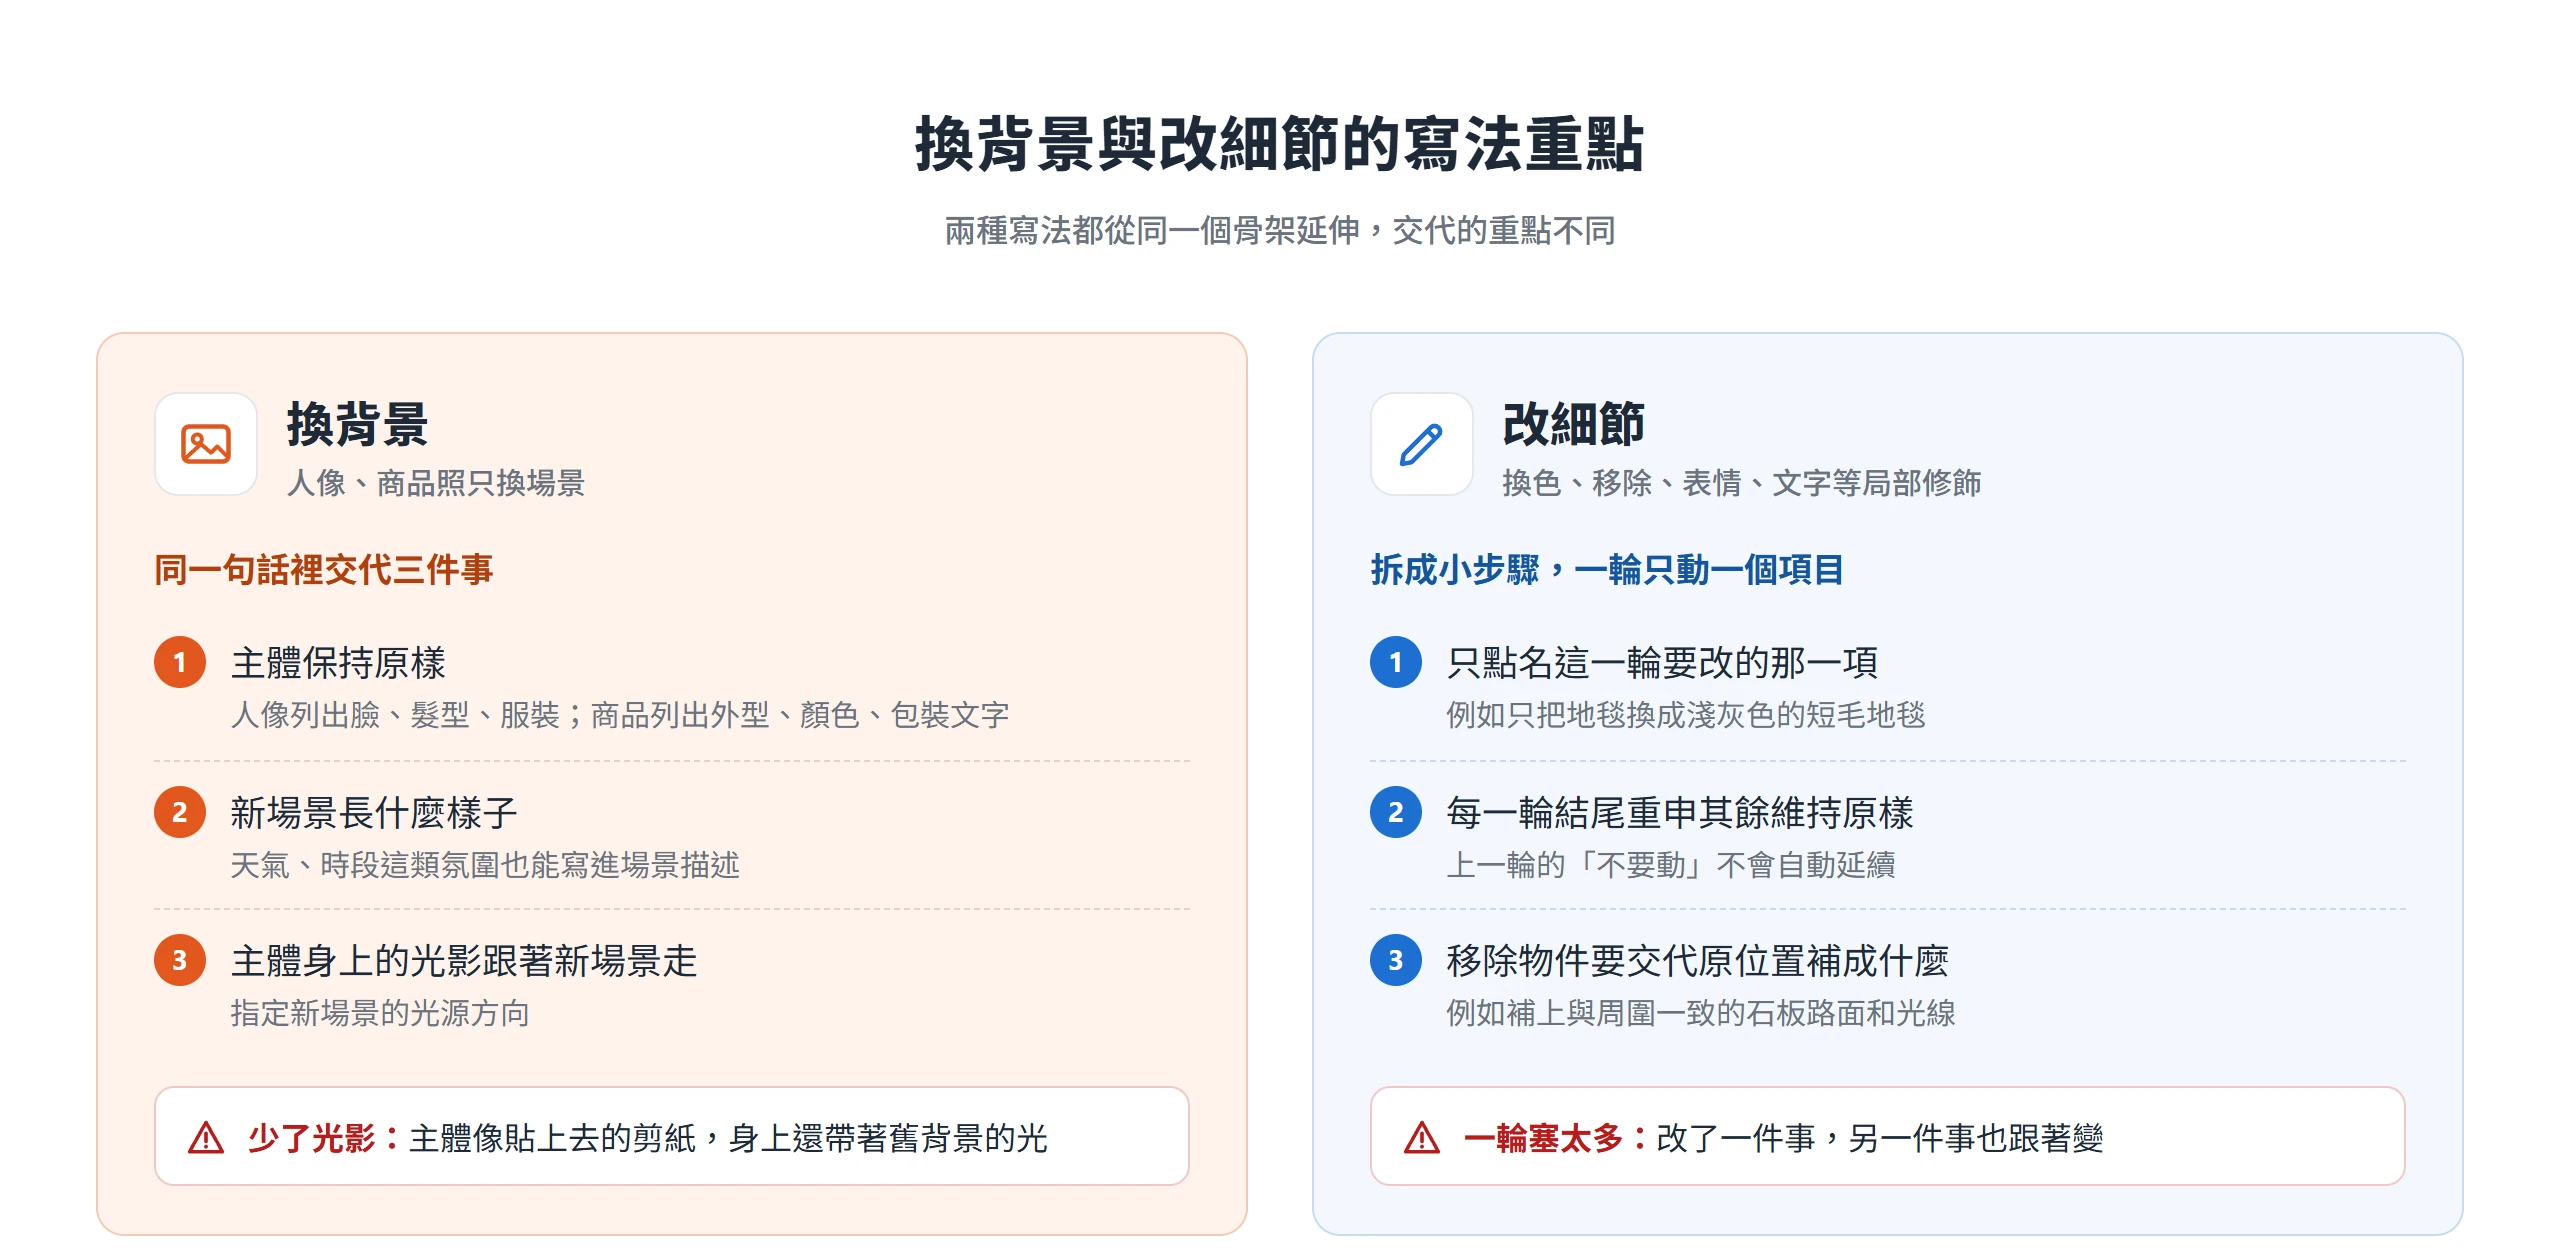
換背景是最常見的修圖需求。要讓換完的圖看起來像同一張照片,關鍵是在同一句話裡同時講三件事:主體保持原樣、新場景長什麼樣子,以及主體身上的光影要跟著新場景走。少了第三件,主體會像貼上去的剪紙,站在新背景前面卻帶著舊背景的光。
Google 的 Gemini API 文件在合成多張圖片的範例裡,就把這點寫進了指令,要求生成「光線與陰影調整到符合戶外環境」的全身照。這句話可以直接轉成換背景的寫法:
用提供的這張照片,只把背景換成 [新場景的樣子]。[主體] 的外觀維持原樣,並讓 [主體] 身上的光線與陰影配合新場景的 [光源描述]。Code language: plaintext (plaintext)下指令之前,先確認哪些東西算「背景」。桌面、牆面、窗外的風景,有時界線並不清楚,邊界模糊的時候,就在指令裡直接點名,像是「連同桌面一起換掉」或「桌面保留不動」。同一輪也只換背景這一件事,不要同時改服裝與姿勢,一次動的地方越多,越難判斷是哪裡出了問題。
Gemini 介紹頁也提到,可以把畫面氛圍從晴朗白晝改成陰鬱黑夜,並調整鏡頭角度與對焦。這代表換背景時,天氣、時段這類氛圍,同樣可以寫進場景描述。
人像和商品照保留主體只換場景
最常見的兩種素材,一種是人像,一種是商品照。人像的寫法,重點是把臉、髮型和服裝都列出來,說明這些不動:
用提供的這張人像照片,只把背景換成一間明亮的現代辦公室,有落地窗和柔和的自然光。人物的臉、髮型與服裝完全維持原樣,並讓人物身上的光線與陰影配合窗戶透進來的光源方向。Code language: plaintext (plaintext)這句話改動的只有背景,沒有動的有三處:臉、髮型和服裝。光影的部分則是「改動」與「不動」之間的橋,它讓人物留在原來的樣子,又不至於跟新場景脫節。人像要用自己的照片,或已經取得本人同意的照片。
商品照的寫法類似,要保護的是商品的外型、顏色和包裝上的文字:
用提供的這張商品照片,保留商品本身完全不變,包括外型、顏色與包裝上的文字。把商品放到一張原木色的桌面上,旁邊有一扇窗透進柔和的側光,商品的陰影要落在桌面上,與這個光源方向一致。Code language: plaintext (plaintext)寫「完全不變」不等於模型一定做得到。換完之後,要把圖放大,逐一檢查商品上的文字、標誌和邊緣有沒有被改動。人像也要這樣檢查,越是熟悉的人,越容易看出「差一點就不像」的地方,所以要拿原圖並排逐張比對。
背景換完後光影不一致的調整
換完背景最容易穿幫的有三處:光線方向、陰影和邊緣。主體臉上的受光方向和新背景的光源對不上,是最明顯的破綻;陰影要嘛不見,要嘛落在不合理的位置,也很容易被一眼看穿;至於主體邊緣,則常留著舊背景的顏色,看起來像是用剪刀剪下來的。
這時候不必整張重做,用接續追問的方式,一句話只調一項:
維持其他一切不變,只把人物的受光方向調成與背景一致,光源來自畫面左側的窗戶。Code language: plaintext (plaintext)這樣做靠的是 Gemini 記得同一次對話的特性,也符合 Google 提示指南的建議,與其期待第一次就得到完美的圖,不如用對話一步步做小幅調整。
不過要有心理準備,複雜的融合有時就是修不乾淨。Google 在 Nano Banana Pro 的提示技巧裡坦白提到,複雜的編輯,例如圖像融合或光線變化,有時會產生不自然的痕跡。若連續幾輪都修不好,一個實務上的退路是回到原圖,把光線、背景的描述重新整理成一句完整的指令,從頭來一次,而不是在越改越偏的那張圖上繼續疊加。這是做法上的建議,不是 Google 訂的規則。
純色底與棚拍風格背景的指定方式
商品圖和證件風格的照片,常常需要純白、淺灰,或有棚拍質感的背景。指定時,把顏色、光線型式和桌面材質三件事講出來就夠:
用提供的這張商品照片,保留商品本身不動,把背景換成純白色的攝影棚背景。採用三點柔光箱布光,光線柔和,消除強烈的陰影,商品底部只留自然的淡淡落影。Code language: plaintext (plaintext)這裡的光線描述,取自 Google 提示指南裡商品攝影的範本。範本寫的是三點柔光箱布光,目的是製造柔和擴散的亮部、消除強烈陰影;鏡頭角度則可以指定,例如略微抬高的 45 度俯拍。桌面材質也能指定,Google 的範例用的是拋光水泥桌面。想要淺灰色的背景,或換成木紋桌面,只要把句子裡的顏色和材質換掉就行。
指定了純白底,得到的是一張底色畫成白色的圖片,它不等於透明背景。需要真正的透明背景,例如要把商品疊進別的版面,另外用專門的去背工具處理,比在這一步硬要求來得穩。
改細節要拆小,一次只動一個項目
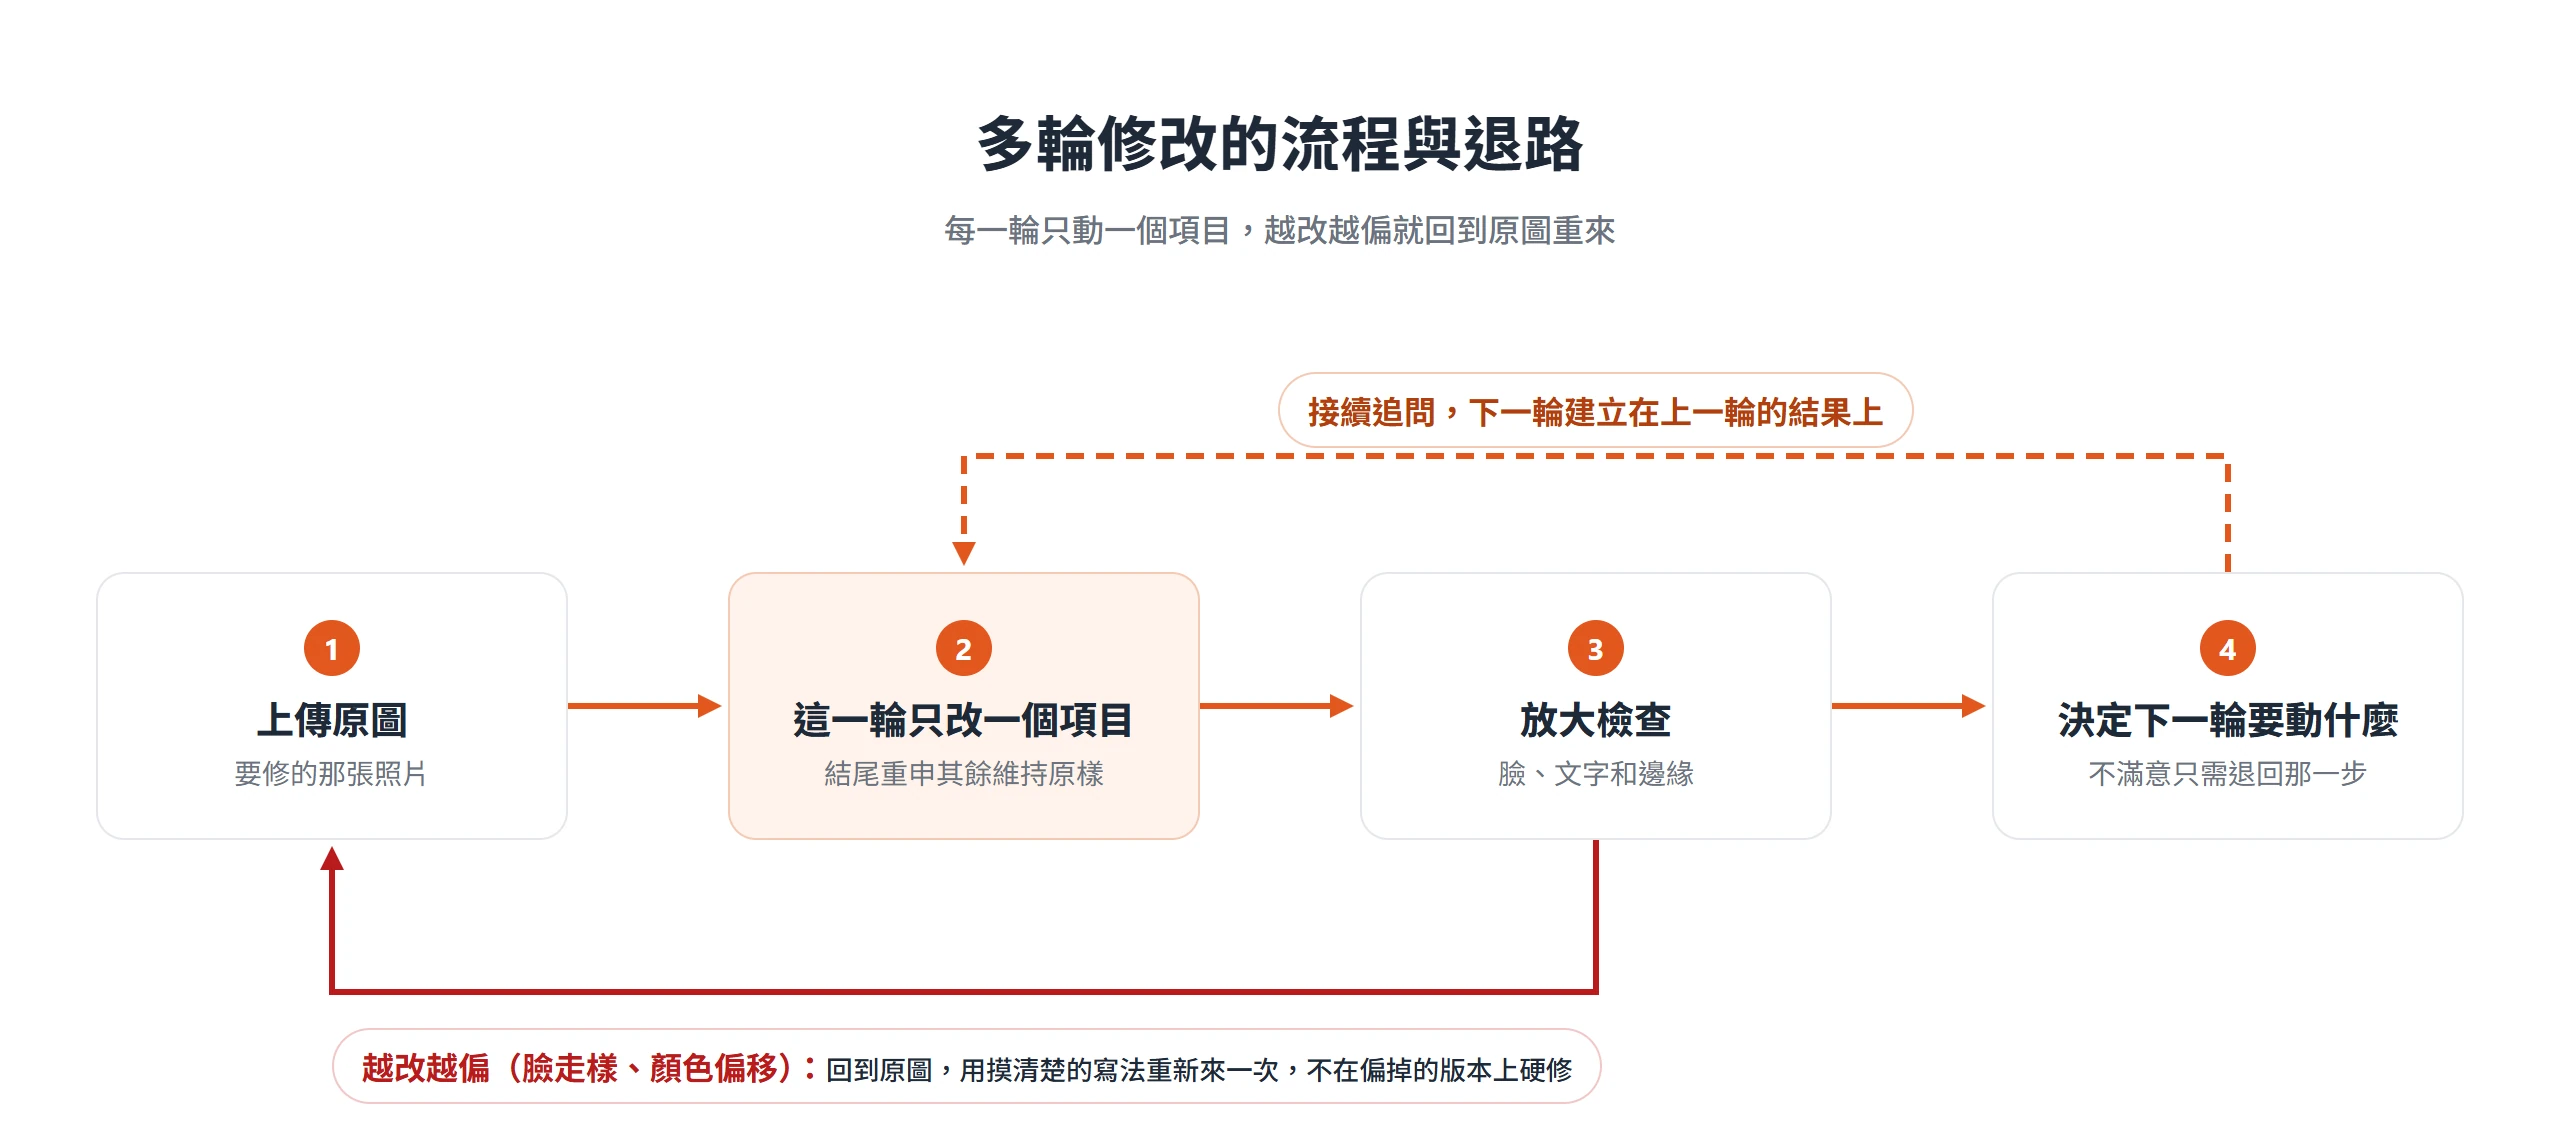
換背景之外,更常見的需求是局部修飾:換個顏色、拿掉雜物、調整表情、修補老照片、改一段文字。這些細節修改有一個共通的原則,就是 Google 反覆強調的做法,把複雜的修改拆成小步驟,每一輪只動一個項目。
Google 的例子是佈置一間空房間,不要一次要求所有家具到位,而是一次放一件家具。模型能記得同一次對話裡前面生成的圖,所以每一步都可以建立在上一步的結果上,任何一步不滿意,只需要退回那一步。
拆小之後,每一輪的指令都要記得重申「其餘維持原樣」。模型每次收到新指令,都會重新判斷哪些地方可以動,上一輪的「不要動」不會自動延續到下一輪。把這句話放在每一輪的結尾,是最省力的保險。
物件的換色、換款與移除
換色與換款是最單純的一類。寫法可以直接套用前面第二種骨架,指定那一件東西,其他維持原樣:
用提供的這張客廳照片,只把地毯換成淺灰色的短毛地毯。沙發、茶几與室內光線維持原樣。Code language: plaintext (plaintext)Google 的 Nano Banana Pro 提示技巧,對修圖指令的建議也是直接而具體,它舉的例子是「把那位男士的領帶換成綠色」「移除背景裡的那輛車」。
移除物件要多交代一件事,就是移除之後,原來的位置要補成什麼。只說「移除」,模型得自己決定怎麼補,結果可能與周圍不一致。
移除照片左側的路人,並在原本的位置補上與周圍一致的石板路面和光線。其餘部分維持原樣。Code language: plaintext (plaintext)要記得,被移除物件背後的內容,是模型推測補出來的,並不是還原當時真實的畫面。拿來做作品或日常照片沒問題,但不能當作那個位置原本的樣子。
表情、姿勢與穿著的調整
人物照最常見的需求,是閉眼的那張要重修、表情看起來不自然,或是想換一件上衣。人物越像本人,越容易被看出破綻,所以寫法的重點,是讓臉不被一起改掉。
Google 的 Gemini API 文件在「高擬真細節保留」的段落裡寫得很清楚,要確保臉部或標誌這類關鍵細節在編輯中不被改動,就在編輯指令裡,把它們描述得很詳細。範本的結構是在加入新元素的同時,加上「確保某某的特徵完全不變」,範例是在黑色上衣上加一個標誌,同時要求臉部特徵完全不變。依照這個做法,改表情的指令可以這樣寫:
用提供的這張人像照片,只把表情改成自然的微笑。人物的臉型、髮型、膚色與五官特徵完全不變,背景與服裝維持原樣。Code language: plaintext (plaintext)只動表情或穿著,不要同時動姿勢,這是前面「一次只動一個項目」的延伸。想要微調,可以用 Google 提示指南裡的追問句型:「維持其他一切不變,只把人物的表情改得嚴肅一點」。
Google DeepMind 的模型卡提到,人物一致性不一定每次都完美,罕見情況下還會殘留輸入圖的姿勢。所以真的要改姿勢,指令要把新姿勢描述具體,並且單獨成一輪;如果改出來的姿勢明顯還是原來的樣子,就回到原圖重新下指令。使用別人的照片之前,也要先取得對方同意。
模糊、老舊照片的修補與上色
許多人會拿它處理糊掉的照片、老照片和黑白照片。Google 的說明提到,Nano Banana 可以結合對歷史脈絡的理解,修復老照片並上色。寫法的重點是指定保留原有的構圖和人物臉部特徵,其餘交給模型補:
修復這張老照片並替它上色。保留原本的構圖與人物的臉部特徵,膚色、衣服與背景的顏色要符合那個年代的樣貌。Code language: plaintext (plaintext)模糊照片的寫法類似,要求變清楚的同時,把要保留的東西列出來:
把這張模糊的照片修得更清晰,人物的五官、髮型與服裝輪廓維持原樣,不要新增原圖裡沒有的物件。Code language: plaintext (plaintext)這類修補要先認清一個前提,被補清楚、被上色的部分,是模型推測後重新畫出來的內容,不是還原當年真實的細節。DeepMind 的模型卡也把幻覺(hallucination)列為基礎模型共通的限制,指的是模型會畫出看起來合理、卻未必真實的內容。所以修好的照片拿來當紀念沒問題,但不適合當作史料或證件使用。修完之後,把結果和原圖並排,仔細檢查臉部和畫面裡的文字。
圖中文字的修改與限制
設計師和電商賣家常會碰到要改招牌、海報或包裝上的文字。這類修改的第一個原則,是把要出現的文字用引號原樣寫進指令:
用提供的這張海報圖片,只把標題文字改成「秋季新品上市」。字體風格、顏色與位置維持原樣,其餘部分不動。Code language: plaintext (plaintext)不過文字是這類模型容易出錯的地方。DeepMind 替 Nano Banana 2 與 2.1 寫的模型卡都直接寫明,小字、長段落和整頁文字的渲染較差,在 1K 輸出上小字經常模糊。另外,Gemini Apps 說明頁寫到沒有訂閱方案的帳號下載的是 1K 圖。兩份資料對照起來看,免費帳號要改圖上的小字,最好抱持比較保守的預期。
Google 的 Gemini API 文件對「為圖片生成文字」給過一個建議:先把文字生成出來,再要求圖片加上這段文字。這個思路搬到改字上,就是先在對話裡把要放的字確認好,再下改圖的指令,不要讓模型一邊想文案、一邊畫字。
Gemini Apps 說明頁寫,文字渲染對「所有支援的語言」都更準確,但沒有特別點名繁體中文,所以繁體中文字會不會每個字都正確,沒有辦法保證。字級小或段落長的文字,不要期待一次成功,改完之後逐字核對一次。
直接在圖上圈選與加註,適合難以用文字指出的位置
有些地方很難用文字說清楚,像是畫面裡有好幾個長得很像的物件,或是要指某個角落的一小塊區域。Google 在 2025 年 12 月的 Gemini Drop 裡,提到了一種更直接的方式,可以用手指或游標,直接在圖片上圈選、畫線或加註,告訴 Gemini 要在哪裡做修改。
這種方式比純文字好用的情況,主要是需要「指位置」的時候。例如一張桌上擺了五個馬克杯,要換的是最靠近鏡頭的那一個,用文字描述得繞一大圈,直接圈起來就簡單了。Google 的公告只說明圈選與加註能做什麼,沒有細講圈完之後是否還要搭配文字指令,也沒有列出按鈕名稱與操作步驟,實際操作以 App 當下的畫面為準。圈完之後順手補一句文字,寫明要改成什麼,指令會更完整。
這類修改也有已知的限制。DeepMind 的模型卡列出的限制之一,就是在遮罩或塗鴉式的編輯中,指令可能只被部分遵守,塗鴉的筆跡也可能殘留在成品上。所以輸出之後,要檢查被圈選的區域是不是真的改對了,筆跡有沒有消乾淨,沒消乾淨的話,可以補一句文字要求去掉標註痕跡,或乾脆改回純文字的寫法。
多輪追加修改和多張參考圖合成的做法
前面講的都是單點修改,實際修一張圖,往往要連續改好幾輪。Google 的 Gemini API 文件把多輪對話列為迭代修圖的建議做法,它的範例是先生成一張資訊圖,再接著說「把這張資訊圖改成西班牙文,圖中其他元素不要改動」。這個句型把「要改的」和「不動的」放在同一句裡,和前面的骨架是同一個邏輯。
同一個對話連續編輯的好處,是每一步都建立在前一步的結果上,不必重新交代整張圖的背景。風險則是改的輪數越多,累積的偏差越大,臉慢慢走樣、顏色逐漸偏移,都是常見的情況。當你發現越改越偏,最乾淨的做法是回到原圖,用已經摸清楚的寫法重新來一次,不要在偏掉的版本上硬修。Nano Banana 2.1 的更新紀錄提到多輪人物一致性有所提升,但模型卡的限制說明還在,所以這個退路仍然需要。
另一種組織方式,是用第二張圖當參考,例如把商品放進場景,或把某種圖案、材質套到物件上。Google 的合成範本是這樣寫的:
用這幾張圖片的元素建立一張新圖片。把 [第一張圖的元素] 放到 [第二張圖的元素] 上,最終的畫面是 [描述最後的場景]。Code language: plaintext (plaintext)多張圖片的指令,要明講每一張圖扮演什麼角色。Google 的提示技巧給的例子是:用圖 A 的人物姿勢、圖 B 的藝術風格、圖 C 的背景環境。角色講清楚,模型才不會自己決定哪一張圖的哪個部分該被採用。
Gemini API 文件有列出多張參考圖的上限,不過那是 API 的規格,Gemini App 單次實際能上傳幾張,要以 App 當下的畫面為準。此外,Gemini Apps 說明頁提到,Nano Banana 2 Lite 不是為多張參考圖或多次編輯設計的,要走這條路線,先確認手上用的是哪一版。
修圖結果不如預期時的常見原因與對策
修圖出狀況的時候,從看到的現象往回找原因,比逐項檢查指令更快。下表的原因,來自 Google DeepMind 的模型卡與 Google 的提示技巧;對策是提示詞的寫法建議,每一條都可以試試,沒有哪一條是保證有效的。
| 現象 | 可能的原因 | 下一輪可以試試的改法 |
|---|---|---|
| 整張圖被重畫,風格或構圖全變 | 指令只說要改什麼,沒交代其餘維持原樣,模型得自己決定哪些地方能動 | 補上「只改 [元素],其餘維持原樣,保留原本的風格、光線與構圖」,並把改動縮成一個項目 |
| 人物的臉變得不像本人 | 模型卡指出,人物一致性在輸入圖與輸出圖之間不一定完美 | 在指令裡明講臉型、髮型、膚色與五官不變;連續幾輪越改越偏,就回到原圖重新下指令 |
| 左右搞錯,該改右邊的卻改了左邊 | 模型卡提到,偶爾會混淆左右這類空間定位 | 改用不依賴左右的描述,像「戴眼鏡的那一位」「靠窗的那盞燈」,或改用直接在圖上圈選 |
| 文字模糊或拼錯 | 小字與長段落的渲染較差,在 1K 輸出上小字常模糊 | 縮短文字、減少行數,用引號寫進指令;先確認文字內容,再下改圖指令,改完逐字核對 |
| 改完仍殘留原圖的姿勢 | 模型卡指出,罕見情況下,輸出圖會保留輸入圖的主體姿勢與結構對齊 | 把新姿勢描述得更具體,並單獨成一輪;仍然不行就回到原圖重來 |
| 圈選之後塗鴉痕跡沒消,或標註只被部分遵守 | 模型卡把部分遵守指令與筆跡殘留,列為遮罩與塗鴉式編輯的限制 | 圈選之後補一句文字,說明要改成什麼、要去掉標註痕跡;輸出後檢查被圈選的區域 |
| 融合處的光影或邊緣不自然 | Google 提到,複雜編輯與圖像融合有時會產生不自然的痕跡 | 接續追問,一次只調光線方向或邊緣其中一項 |
| 改了一件事,另一件事也跟著變 | 同一輪塞進太多項目,每一項都要重新判斷哪些地方能動 | 拆成小步驟,每一輪只動一個項目,並重申其餘維持原樣 |
即使照著表改,也不見得一次就到位。Google 的提示指南也提醒,不要期待第一次就得到完美的圖。用對話一輪一輪微調,本來就是這類修圖的正常流程,先有這個預期,第一輪結果不理想時也不必急著放棄。
最後是使用責任。所有 Gemini 生成的圖片都帶有 SynthID 浮水印,改過的照片也算在內,所以不要把修過的圖當成未經處理的原照片拿給別人看。上傳他人的照片需要先取得使用權利,Google 的使用政策不允許侵犯他人的著作權或隱私,這一點在人像與商品照上特別需要留意。
Nano Banana 把修圖的門檻,從會使用選取工具,降到說得清楚想改什麼,而說得清楚的標準,就是前面那兩件事:改哪裡、哪裡不動。挑一張自己的照片,先只換一個背景,把「其餘維持原樣」寫進指令,改完放大檢查臉、文字和邊緣,再決定下一輪要動什麼,這樣一步一步來,出了問題也比較容易看出是哪一輪改壞的。