
多數人以為,網站一旦被駭客盯上,情況會立刻天翻地覆:首頁整個被換掉,瀏覽器跳出鮮紅色的安全警告,流量報表應聲腰斬。但有一種入侵剛好相反,你打開後台看流量,曲線跟平常一樣正常;你自己點開網站每一頁,畫面也跟昨天一模一樣。真正露出馬腳的,是你拿自己的網域加上 site: 指令去 Google 搜尋,或是仔細看某幾頁的搜尋結果摘要,跳出來的內容卻跟本業毫無關係:壯陽藥、仿冒精品、線上博弈,標題與摘要全都不是你寫的。
這種情況有個專門的說法,通稱 SEO 垃圾連結注入。重點不是網站怎麼被攻進去的,而是攻進去之後,攻擊者刻意讓一切看起來風平浪靜。這也是為什麼多數人一開始怎麼查都查不出問題,你在找的是「哪裡壞了」,但對方要的根本不是讓東西壞掉。
搞懂這件事,能讓你不再只盯著流量報表找異狀。先弄清楚它跟一般認知裡「網站被駭」有什麼不同,再一路拆解它怎麼在你眼皮底下運作。
SEO 垃圾連結注入是什麼?借網站信任度幫別人排名
SEO 垃圾連結注入(SEO Spam Link Injection)指的是攻擊者拿到網站的未經授權存取權後(常見管道是外掛或佈景主題的安全漏洞),在網站裡加入額外的連結或內容,目的是借用這個網域原本就有的搜尋排名信任度,幫另一批毫不相干的網址衝排名。它跟勒索軟體、竄改首頁那種「要讓你馬上知道」的入侵不一樣,這種手法要的剛好相反,借得越久越划算,所以攻擊者會刻意讓一般訪客與網站管理員都感覺不到任何異狀。
Google 把這種情況正式歸類為遭入侵的內容,在說明垃圾內容政策的文件裡直接點出這個現象的關鍵:「您現有的網頁可能沒有遭入侵的跡象,但這些新建的網頁可能對訪客有害,或是對網站的搜尋結果排名有負面影響。」換句話說,流量報表看起來正常一點都不奇怪,因為報表反映的是你原本管理的那些頁面,被動手腳的,通常是另一批你根本不知道存在的內容。
也因為這樣,靠 site: 指令搜尋、或留意某幾頁的搜尋結果摘要,反而比看流量報表更容易先發現異狀。你的網站分析工具只會記錄有人造訪的頁面,但攻擊者新增或動過手腳的內容,不一定會被算進你平常在看的那些數字裡。至於這種偽裝具體是怎麼做到的,得先弄清楚它跟一般認知裡的「網站被駭」哪裡不一樣。
跟網站首頁被置換的入侵手法本質不一樣
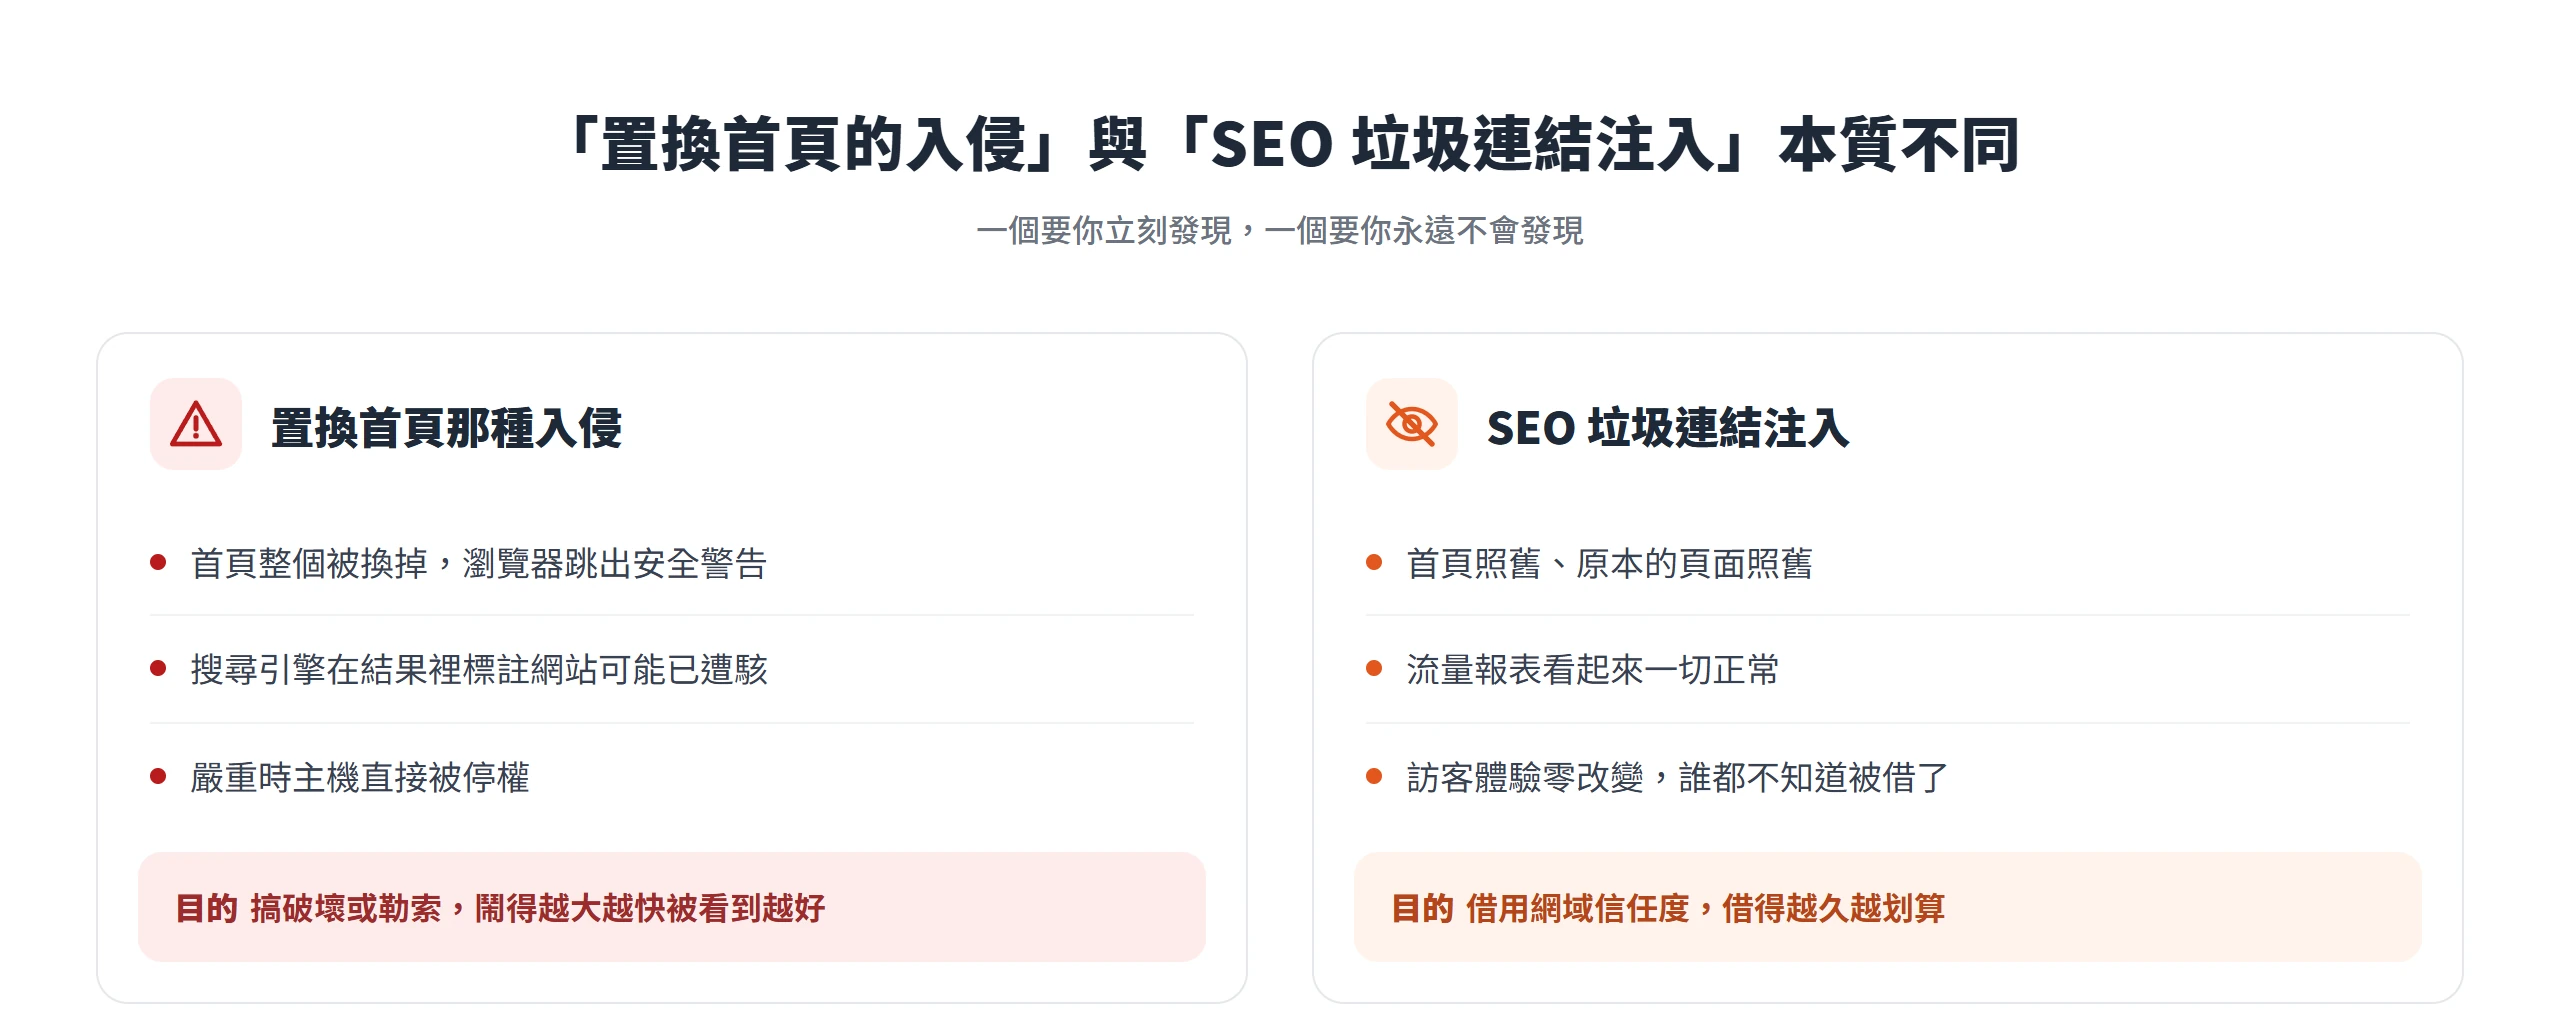
一般人聽到「網站被駭」,腦中浮現的畫面通常很戲劇化:首頁整個被換成別人的圖案或標語,瀏覽器跳出鮮紅色的安全警告,搜尋引擎在搜尋結果裡標註網站可能已遭駭,嚴重一點主機直接被停權。這些都是攻擊者故意要讓人立刻發現的手法,目的是搞破壞,或是拿網站當人質要贖金,鬧得越大、越快被看到,對他們的目的越有幫助。
SEO 垃圾連結注入的動機正好相反。攻擊者要的不是搞破壞或勒索,而是借,借得越久,能從這個網域榨出來的排名紅利就越多。既然是借,最理想的狀態就是誰都不知道自己被借了,首頁照舊、原本的頁面照舊、訪客體驗零改變,才能潛伏得夠久。這也是為什麼你自己巡邏網站、看流量報表都抓不出異狀,不是疏忽,而是攻擊設計從一開始就是衝著躲過這種檢查方式來的。
把「訪客體驗零改變」當成設計目標,在技術上具體要怎麼做到,才是接下來要拆的重點。
植入網頁、植入內容與重新導向三種常見注入手法
Google 官方文件把遭入侵的內容拆成四種常見手法,其中一種是植入程式碼,把惡意 JavaScript 放進頁面或 iframe 裡,通常用來散布惡意軟體或竊取資料,目的跟排名無關,這篇不深入討論。剩下三種都是衝著搜尋排名去的:植入網頁、植入內容、重新導向。
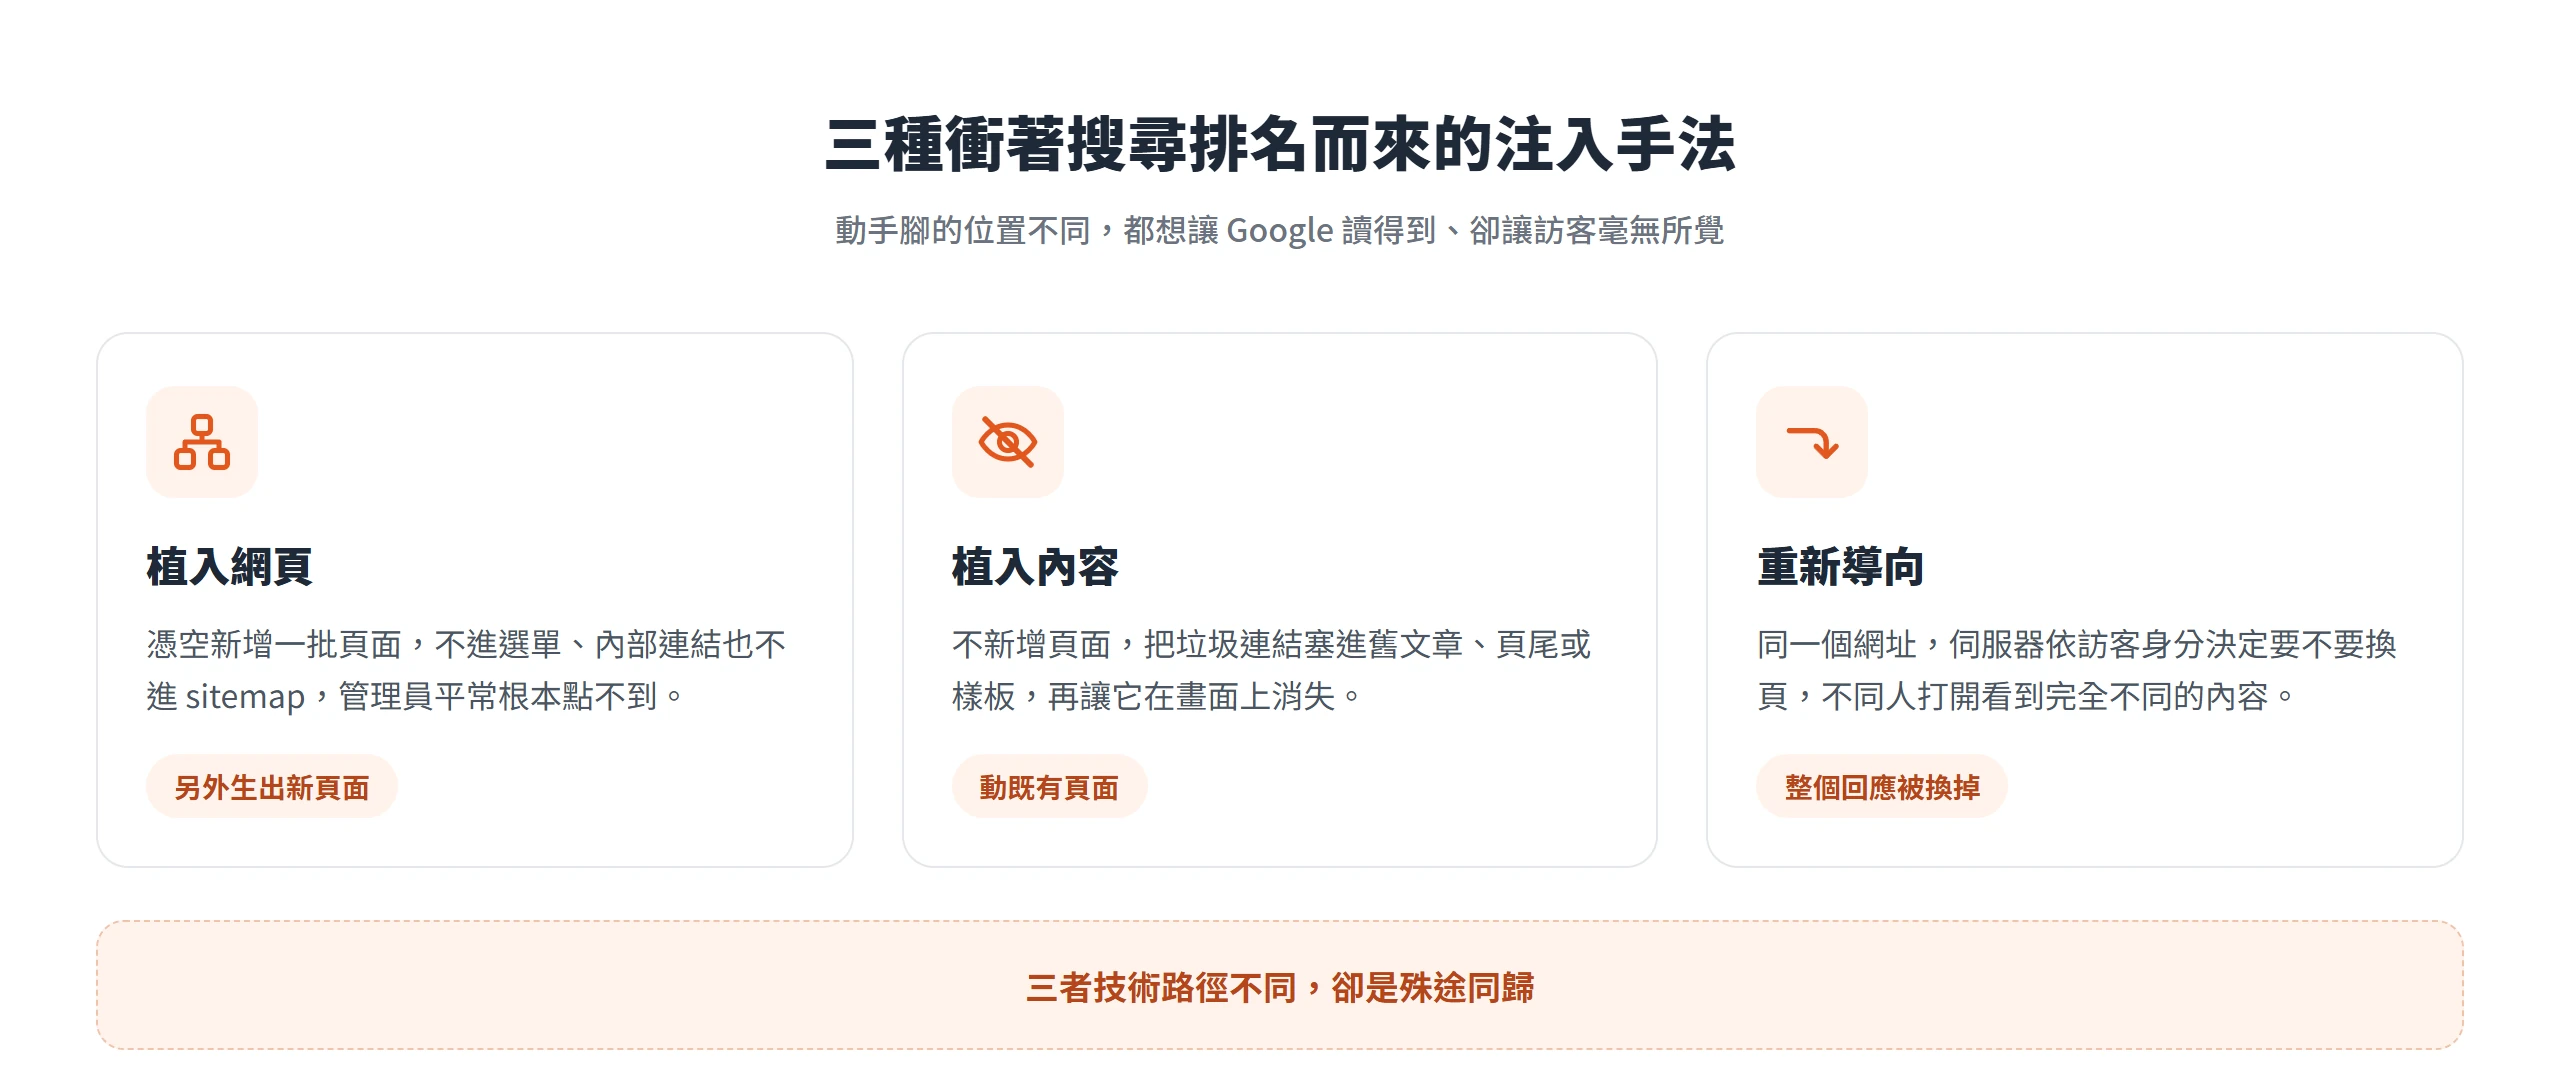
這三種手法的目的相同,都是要讓 Google 讀得到垃圾內容、卻讓一般訪客毫無所覺,差別在於攻擊者選擇動手腳的位置不一樣。植入網頁是憑空生出一批訪客原本進不去的新頁面;植入內容是動既有頁面,但讓內容在畫面上消失;重新導向則是同一個網址,依訪客身分給出完全不同的內容。三者的技術路徑不同,卻是殊途同歸。
植入網頁,另外新增一批頁面
植入網頁最常見的做法,是攻擊者利用外掛或佈景主題的漏洞,在網站裡新增大量頁面,常見的是自動產生的多國語言版本,或是套用同一個模板、只改關鍵字的頁面。這些頁面通常不會出現在網站選單、內部連結,也不會被列進 sitemap,站方管理員平常瀏覽自己的網站根本點不到。訪客要進得去,通常只有兩條路:透過攻擊者自己在別的網站鋪好的反向連結,或是直接從 Google 搜尋結果點進來。
資安業者 Sucuri 揭露過一個實際案例,清楚說明了為什麼站方後台的文章列表看不到這些頁面被建立過。惡意程式在網站資料庫裡另外建立一批偽造的資料表,前綴跟正常的 WordPress 資料表不一樣(例如 backupdb_prefix_posts),接著攔截 the_content、wp_header、wp_footer 這幾個 WordPress 掛勾函式,在頁面回應送出前,臨時把資料庫連線切換去讀取這批偽造資料表裡的垃圾內容,讀完再把連線切回正常資料表,讓 WordPress 後續流程照常運作。結果就是這些垃圾頁面的內容從頭到尾都不在真正的 wp_posts 資料表裡,自然也不會出現在網站管理後台的文章列表中,不是管理員沒仔細看,而是這批內容原本就不存在管理員找得到的地方。
植入內容,在既有頁面裡藏連結與文字
跟植入網頁不同,植入內容不新增任何頁面,而是直接把垃圾連結塞進網站原本就有的內容裡,常見的藏身處是舊文章的內文、頁尾區塊、外掛的小工具區,或是佈景主題的樣板檔案。這代表你的網站可能連一個新頁面都沒被建立,純粹是既有頁面被動了手腳,難怪從網址結構或網站地圖去查都查不出異狀。
Google 官方文件把這種手法定義為濫用隱藏的文字或連結,說明是「網頁上放置的內容只是為了操控搜尋引擎,而非方便一般訪客查看」,並列出幾種常見做法:在白色背景上使用白色文字、把文字藏在圖片後方、透過 CSS 把文字放到畫面之外、把字型大小或不透明度設為 0,甚至只把一個小型字元(例如一個連字號)設成連結。這幾種做法的共同點,是連結跟文字都真實存在於網頁的程式碼裡,只是被刻意安排成一般人肉眼看不到的樣子,這部分的技術細節,下一節會拆得更細。
幕後重新導向,依身分決定要不要換頁面
第三種手法跟前兩種完全不同路數,內容本身看起來完全沒被動過,但伺服器會依訪客的身分,決定要不要把這個訪客導去別的網址。判斷依據通常是訪客是不是從 Google 搜尋結果點進來的、使用者代理程式是什麼,或是裝置類型是手機還是電腦。前兩種手法是內容裡藏東西,這一種是整個回應被換掉,同一個網址,不同人打開看到的根本是兩份不同的內容。
Google 官方文件把幕後重新導向定義為向搜尋引擎顯示其中一種內容、同時將使用者重新導向到截然不同的內容的手法,並舉例說明常見情境是「向電腦使用者顯示正常網頁,但將行動裝置使用者重新導向至完全不同的垃圾內容網域」。台灣本地也有實際案例,台灣電腦網路危機處理暨協調中心(TWCERT/CC)通報過一種 SEO 中毒手法,攻擊者入侵合法網站並植入惡意程式碼後,會依訪客是從搜尋引擎點進來、還是直接輸入網址造訪來判斷,若判定是搜尋引擎導入的訪客,就導向詐騙網站;若是直接訪問,則正常顯示原本的頁面內容,藉此規避網站管理員自行察覺。
用位移、透明與字級歸零把文字擠出畫面外
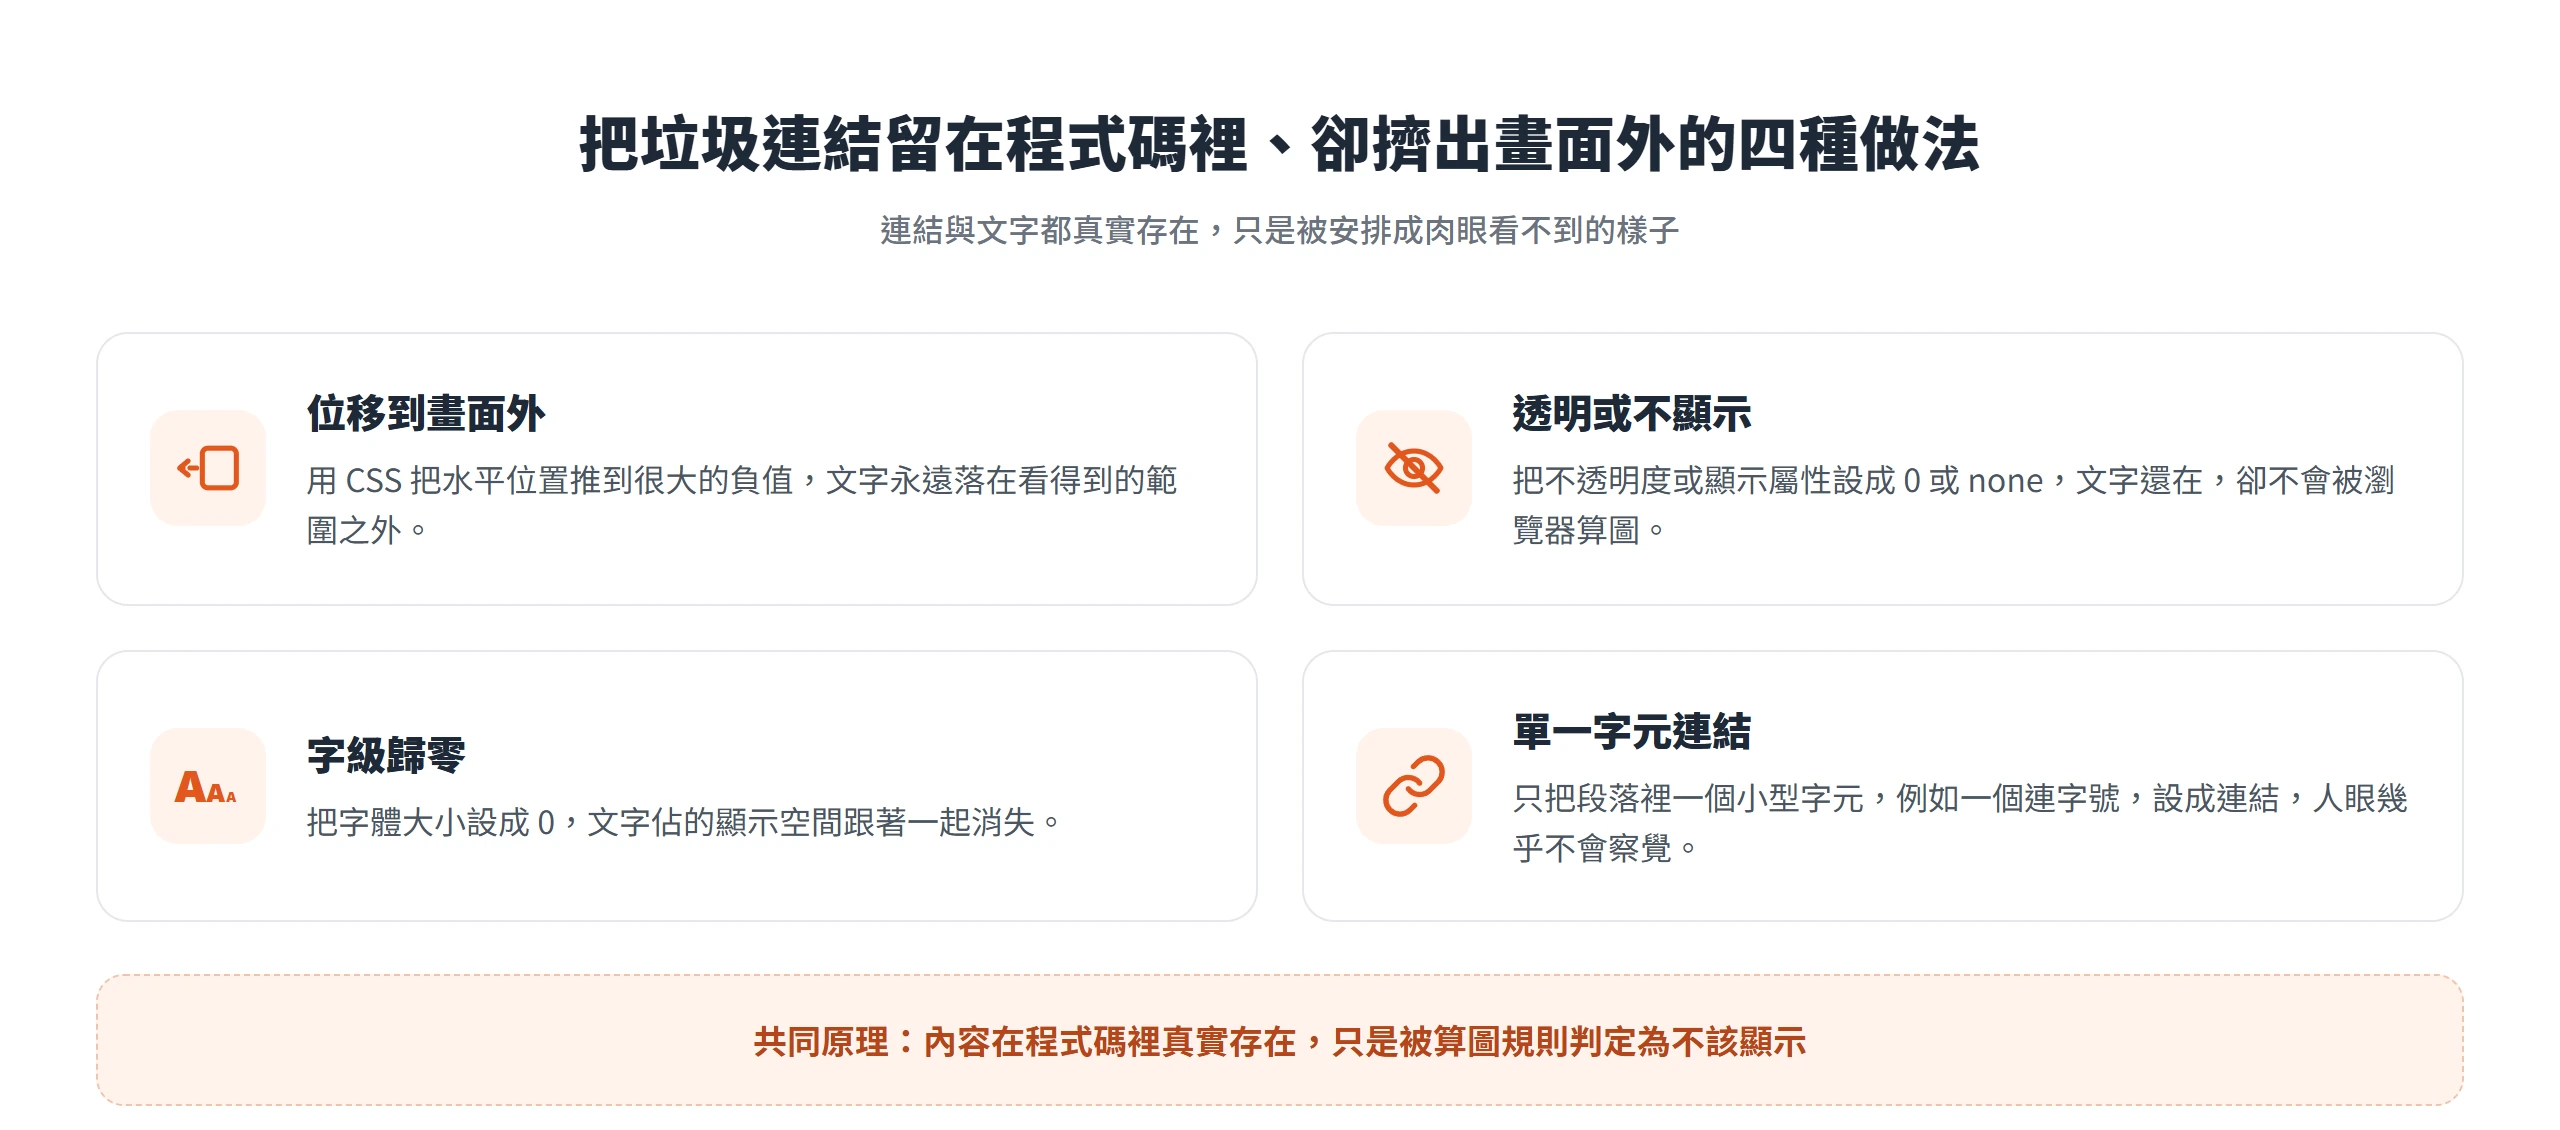
植入內容要讓垃圾連結留在 HTML 裡卻不出現在畫面上,常見做法有好幾種,原理都不難懂。最直覺的一種是把文字的水平位置用 CSS 推到畫面座標的負值之外,寫成一個很大的負數,文字在網頁的程式碼結構裡確實存在,甚至可以被滑鼠選取、複製,只是視覺呈現上永遠不會落在瀏覽器看得到的範圍內。
另外幾種做法效果類似,寫法不同:把不透明度或顯示屬性直接設成 0 或 none,文字同樣存在但不會被算圖;把字級設成 0,文字佔的顯示空間也一起消失;還有一種更不起眼的做法,是只把段落裡一個小型字元,例如一個連字號,設成連結,人眼幾乎不會注意到這裡多了一個連結。
更麻煩的是攻擊者還會刻意混淆,讓人工檢視原始碼時也不容易一眼看穿。Sucuri 曾揭露過一種做法:先把要隱藏的區塊寫成一段正常的 HTML,例如一個 id 叫 tesi 的區塊,接著在另一段 JavaScript 裡才把這個 id 拆成 “t”、”e”、”s”、”i” 這樣的字串組合,執行時才重新拼回 tesi、再把它的顯示屬性設成 none。整個隱藏的邏輯被拆成兩段分開放,單看某一段程式碼很難馬上看出它在做什麼。
這些手法的共同原理只有一個,內容在網頁程式碼裡真實存在,只是被瀏覽器的算圖規則判定為不該顯示,不是內容被藏到任何人都讀不到的地方。也因為這樣,透過瀏覽器檢視原始碼,理論上都找得到這些藏起來的連結,但接下來要看的這種手法,就連檢視原始碼都幫不上忙,因為瀏覽器打從一開始就沒收到那份內容。
使用者代理、網址來源和來源 IP 是分流內容的判斷依據
幕後重新導向要判斷這個訪客是不是 Google,常見依據有三種。第一種是 HTTP 請求裡的使用者代理程式字串,Googlebot 在發出請求時會表明自己的身分,攻擊程式碼比對到這個字串,就回傳垃圾版本的內容,比對不到就回傳正常頁面。第二種是 Referer 標頭,也就是訪客是從 Google 搜尋結果點進來,還是直接輸入網址、或從別的地方連進來,這項資訊同樣會夾帶在 HTTP 請求裡。第三種是來源 IP 範圍,Google、Bing 這些搜尋引擎的爬蟲 IP 區段是公開可查的資料,攻擊程式碼比對過後就能精準識別出這是不是搜尋引擎在存取。
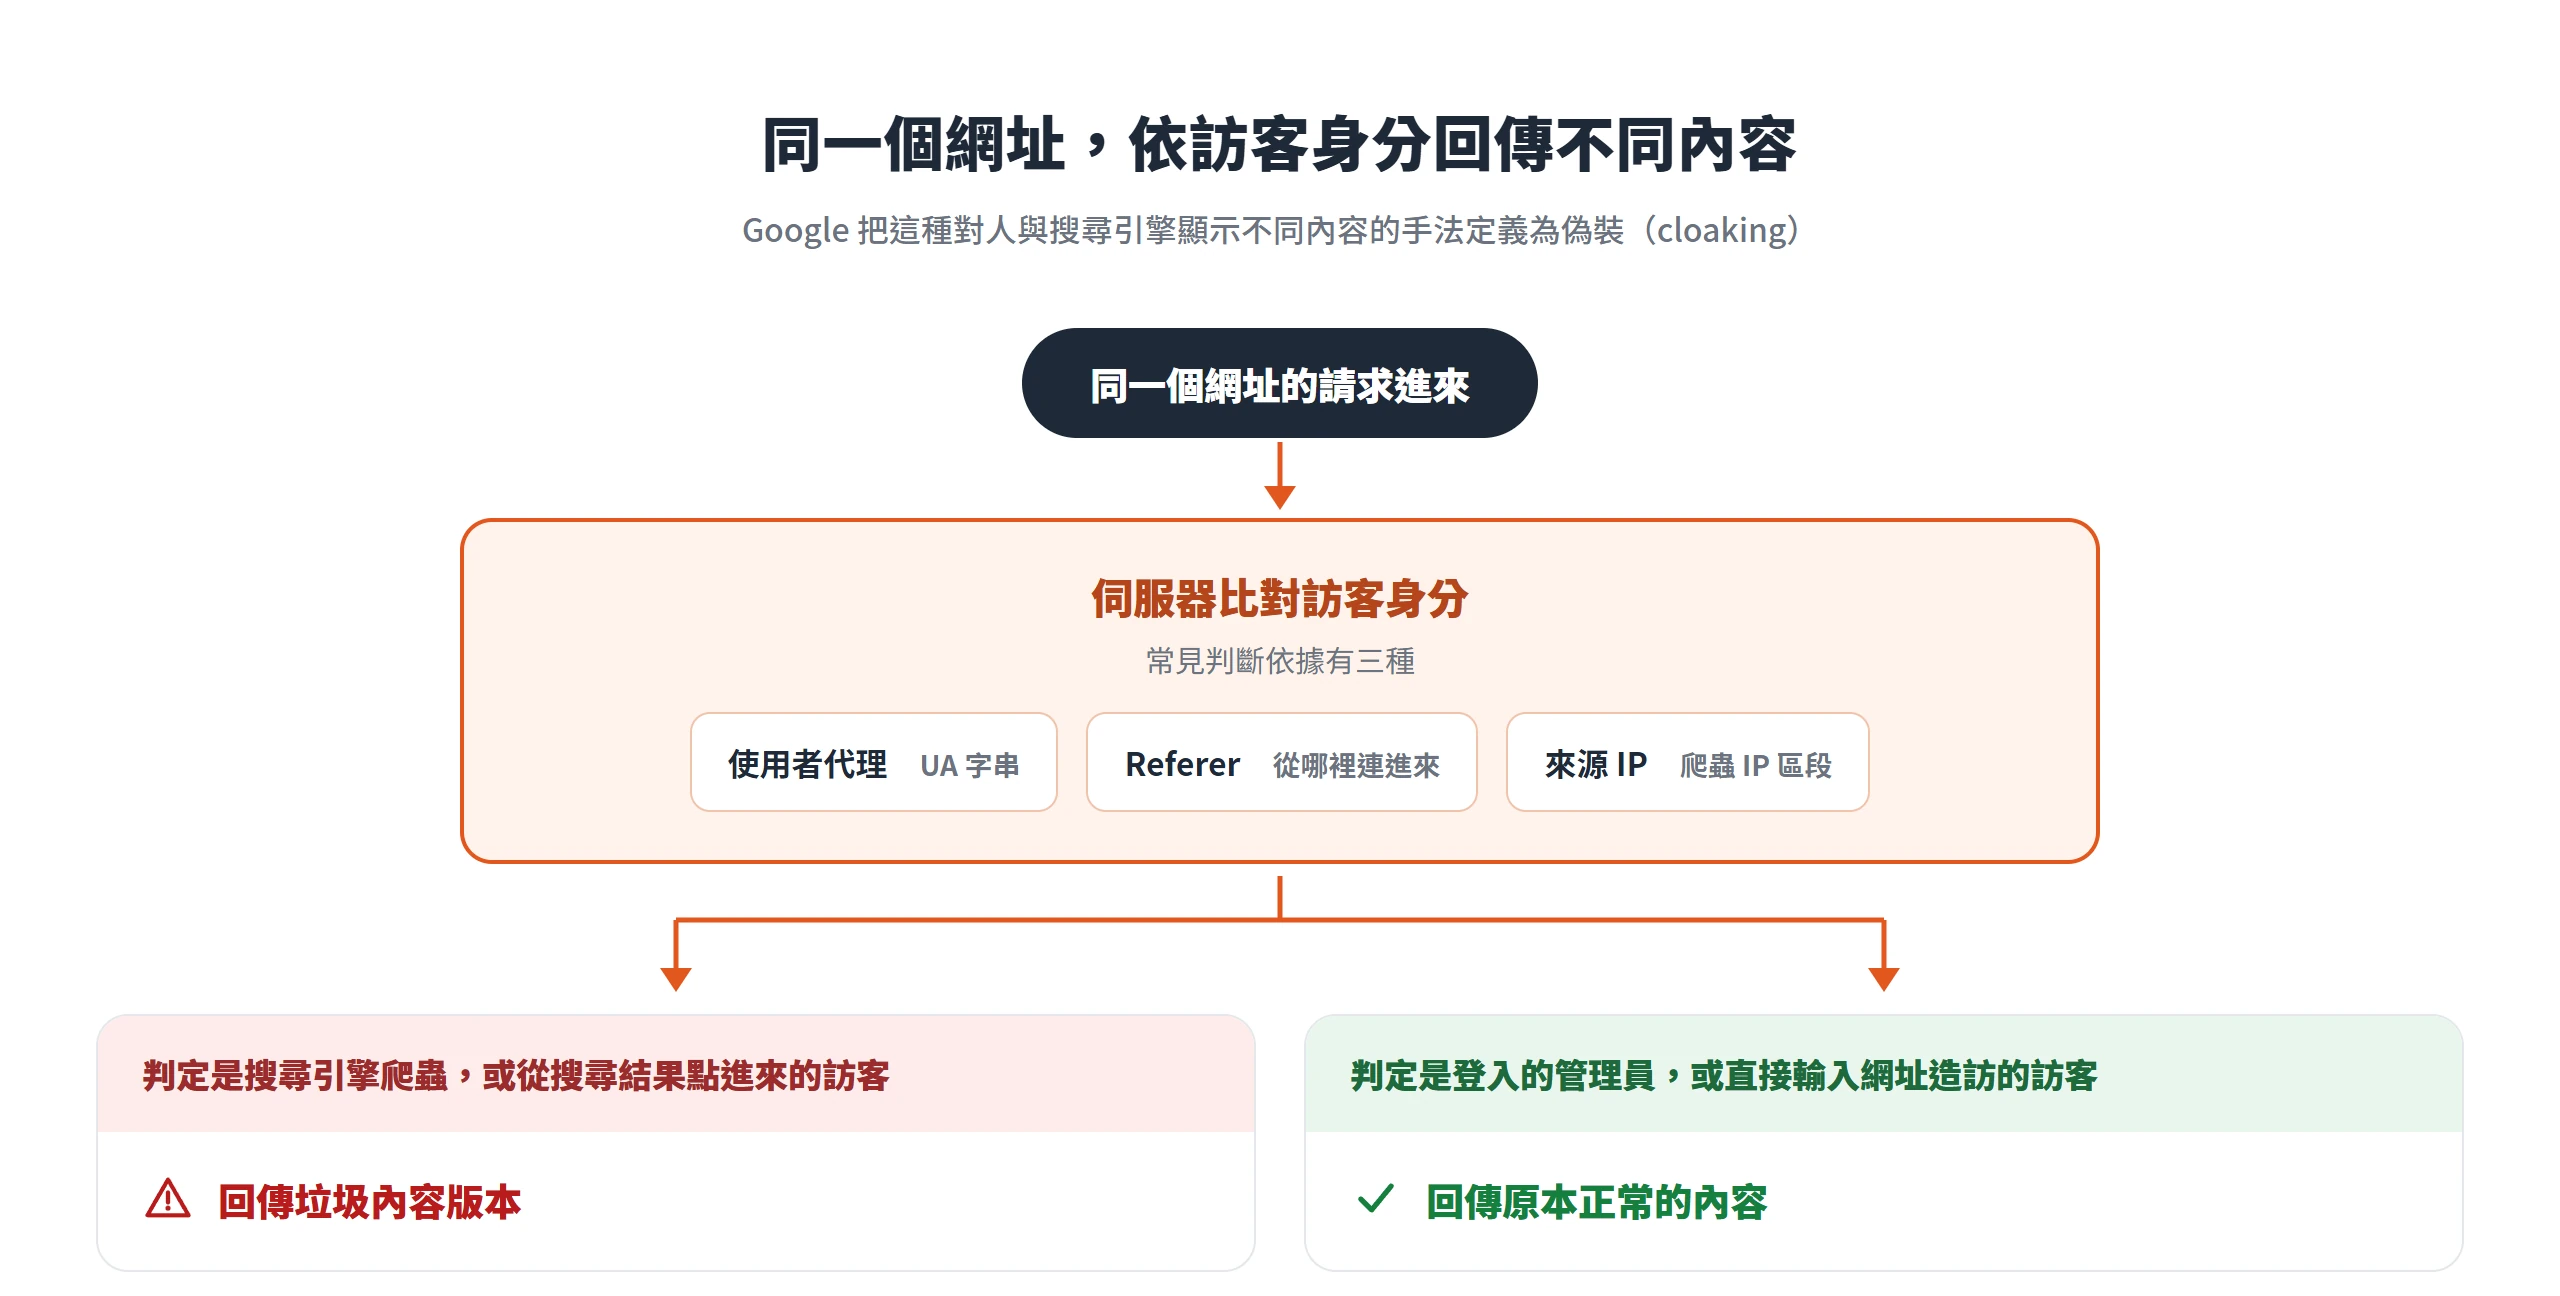
這裡有個關鍵差異,要跟前面「畫面上看不到但其實有送到瀏覽器」分開來看。上一節講的隱藏文字,瀏覽器其實收到了完整內容,只是沒有把它畫出來;這一節講的重新導向,是伺服器一開始送出的就是兩份不同的 HTML,瀏覽器根本沒收到那份垃圾內容。這正是 Google 官方定義裡偽裝(cloaking)的核心手法:「為了操控搜尋排名和誤導使用者,分別對使用者和搜尋引擎顯示不同內容的手法」,文件裡具體舉的例子是「只有在要求存取網頁的使用者代理程式為搜尋引擎時,才在網頁中插入文字或關鍵字,如果是真人訪客卻不會這麼做」。文件也明白指出:「如果網站遭到入侵,駭客常會透過偽裝讓網站擁有者難以偵測入侵情況。」
前面提到的 TWCERT/CC 通報案例,判斷依據正是 Referer——系統認出訪客是經由搜尋引擎進入,才會觸發導向詐騙網站的邏輯,直接訪問則不受影響。
連網站管理員登入後,也看不到被注入的內容
前面拆的兩種手法,一種是內容藏起來、一種是依身分換內容,但它們背後其實還有一條共通的隱藏規則,足以回答為什麼連網站擁有者自己巡邏都發現不了這個問題。攻擊程式碼通常會刻意排除已登入的使用者,包括管理員與編輯者帳號,也會排除已知的管理員 IP,只針對未登入的一般訪客與搜尋引擎爬蟲觸發垃圾內容。
這代表就算直接打開被注入的那一頁,用瀏覽器的檢視原始碼去檢查,看到的也很可能是完全乾淨的正常版本,因為攻擊程式碼一判斷這是登入使用者,就直接跳過注入邏輯,回傳原本的內容給你看。Sucuri 揭露的案例中就明確提到,攻擊程式碼「只鎖定未登入的網站使用者,以協助隱匿惡意活動」,而且會另外記錄訪客的 IP 位址,進一步降低被網站擁有者或管理員發現的機率。
換句話說,自己用瀏覽器打開網站檢查,天生就處在攻擊者刻意排除的那一群人裡。這不是要說明接下來該怎麼排查,那牽涉到另一套完全不同的檢測方法,而是點出「自己檢查看不出來」背後有一套刻意設計的原因,不是巡邏得不夠勤。
攻擊者要的是網域累積多年的信任度
拆完攻擊者怎麼做,回過頭問一個更根本的問題,為什麼要繞這麼一大圈,不乾脆自己架一個網站打廣告就好?答案在於一個全新註冊的網域,在 Google 眼中沒有任何歷史信任度,也沒有反向連結,要排到搜尋結果前面非常慢。相對地,一個經營多年、有真實內容與自然反向連結的既有網站,本身就帶著 Google 信任的權重,攻擊者要借的正是這個權重。
只要能把自己的垃圾網址包裝成來自一個受信任網域的連結,就等於直接繼承了這個網域一部分的排名能力,比從零開始養一個網站快得多。而且東窗事發之前,這整段借用期完全不用付出取得反向連結原本該花的成本與時間,對攻擊者來說幾乎是穩賺不賠。這也是為什麼攻擊者鎖定的通常是有一定歷史的既有網站,而不是隨機挑一個網站下手,信任度本身就是被利用的資產,新網站反而沒有利用價值。
這種手法能有多快、多大量地擴散,Sucuri 分析同一波攻擊活動時提供了具體的規模數據,引用 Majestic 連結索引工具的資料指出,受害網站群被注入垃圾連結後,某年 8 月時已從外部取得將近 1,000 個不同網域的反向連結,到同年 10 月初已成長到將近 1,500 個網域。短短 2 個月,透過大量遭駭網站集中建立起的反向連結規模,已經相當可觀。
多數案例是先被 Google 標記,才回頭查出問題
前面幾節講的每一種手法,設計初衷都是要讓人看不到:畫面隱藏、依身分分流、排除管理員與登入使用者。正因為如此,實際案例裡網站擁有者自己主動發現異狀反而是少數,多數情況是先收到 Google 對安全性問題的警告或列管,才回頭意識到網站已經被利用了一段時間。
這個發現順序會反過來,不是管理員疏忽,而是原理上的必然。Google 官方文件說明,網站若被判定違反垃圾內容政策,包括偽裝、隱藏文字或連結、遭入侵的內容等,「除了透過自動化系統偵測違反政策的行為以外,我們也會視需要執行專人審查,進而採取人工判決處罰」,這代表偵測管道主要來自 Google 自己的系統與審查機制,而不是仰賴網站擁有者主動通報。文件也提醒,違反政策的網站在搜尋結果中的排名可能會降低,甚至完全不會顯示在搜尋結果中。
換句話說,攻擊本身就是針對不讓人發現設計的,人類視角的偵測管道,天生就比搜尋引擎自己的信號慢一步。
知道這整套手法怎麼運作,至少能讓你下次打開後台時多一個習慣,別只看流量報表,偶爾也拿自己的網域去 Google 搜一次,看看搜尋結果裡冒出來的內容,是不是真的都是自己寫的。信任度是網站經營最慢才能養出來的東西,也正因為這樣,它才會被鎖定成借用的目標。