有些技術曾被普遍當成人工智慧,如今平凡到沒人多看一眼,手機掃描文件時自動抓出文字的功能就是一例。反過來,今天被稱為 AI 的聊天機器人與繪圖軟體,隨著普及,也可能走上同一條路。人工智慧這個詞,本來就是一條會移動的邊界。
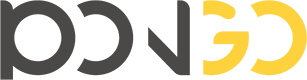
這也是它常被混著講的原因。新聞與產品介紹裡的 AI、機器學習、深度學習、生成式 AI,聽起來像同一件事,其實是由大到小層層包含的關係。人工智慧(Artificial Intelligence,縮寫 AI)指的是讓電腦完成過去需要人類智慧才能完成的事,例如理解語言、辨識影像、分析資料、提供建議。 把範圍弄清楚,下次再看到「AI 功能」「AI 推薦」這類字眼,就知道它大概在做什麼,又有哪些部分值得多留一分心。
人工智慧這個名字聽起來很玄,骨子裡靠的卻只是資料、演算法和運算能力這 3 樣東西。
人工智慧是什麼?
照 Google Cloud 的說法,人工智慧是一套讓電腦學習、推論並執行進階任務的技術,這些任務過去需要人類智慧才能完成,例如理解語言、分析資料,甚至提供實用建議。生活裡的例子很多,手機認出你的臉才解鎖、串流平台猜你接下來想看哪一部片,背後都是同一類技術在運作。
不論種類多繁雜,這些技術基本上都仰賴資料、演算法和運算能力。資料是 AI 學習的素材,演算法是從資料裡找出規律的方法,運算能力則讓龐大的計算能在合理的時間內跑完。其中最容易被忽略的是資料,Google Cloud 指出,訓練資料的品質和數量直接左右 AI 的效能。換句話說,資料太少或帶有偏差,演算法再精巧,學到的東西也會跟著失準。
還有一點常被誤會,人工智慧不是單一技術,而是涵蓋多門學科的領域。依 Google Cloud 的整理,它包含電腦科學、資料分析與統計、硬體與軟體工程、語言學、神經科學,甚至哲學與心理學。所以聽到有人說「用了 AI」,指的可能是很不一樣的做法。
AI 的全名是 Artificial Intelligence,中文翻成人工智慧,也有些中文資料寫成人工智能,兩種寫法對應的都是同一個英文詞。不論問的是「AI 是什麼」「什麼是 AI」「何謂 AI」,還是英文的 what is AI,指的都是同一件事。
這個詞的歷史其實不長。依 IBM 的整理,1950 年 Alan Turing 在論文〈Computing Machinery and Intelligence〉中提出機器能不能思考的問題;1956 年,John McCarthy 在達特茅斯學院(Dartmouth College)的首場 AI 研討會上提出「artificial intelligence」一詞。McCarthy 把它定義為「製造智慧機器,特別是智慧電腦程式的科學與工程」,並補充 AI 不必侷限於模仿人類在生物上可觀察的方法。
人工智慧的界線會隨技術普及而後移
很多人以為 AI 有一條清楚的界線,線的這邊是 AI,那邊不是。實際上,AI 並沒有單一公認的定義。OECD 成員國從 2018 年起著手討論 AI 的定義,一開始就決定不去定義「AI」這個太籠統的詞,改為定義更具體、可操作的「AI 系統」。OECD 自己也寫道,AI 與非 AI 之間沒有一條清楚的紅線,而是一個連續的光譜。
邊界之所以會移動,是因為大眾對 AI 的期待,會隨技術普及而提高。OECD 舉的例子是光學字元辨識(OCR),它曾被普遍視為 AI,現在多數人已不這樣看,但它用的仍是教科書上的 AI 方法。McCarthy 也不認為「這台機器有沒有智慧」是一道是非題,因為智慧牽涉多種機制,AI 研究已讓電腦做到其中一些、還做不到另一些。遇到只靠已被充分理解的機制就能完成的任務,電腦程式可以表現得很亮眼,他認為這樣的程式應視為「有點智慧」。
也因為這樣,OECD 的 AI 系統定義談的是系統做了什麼,而不是用了哪一種技術。用白話講,一個 AI 系統就是一套機器系統,為了明確或隱含的目標,從收到的輸入推論如何產生預測、內容、建議或決策等輸出,這些輸出能影響實體或虛擬環境,而且不同系統在部署之後的自主與適應程度各不相同。
實務上要判斷一個產品算不算 AI,可以抓兩條線索。第一,它是不是從收到的輸入推論出輸出,而不是照一條條固定規則走到底。第二,它有沒有用訓練資料學出一個模型。這兩條只是辨別的線索,不是硬性門檻,因為 OECD 的定義刻意涵蓋從簡單到複雜的各種系統,連靠明確寫下的知識與邏輯來推理的符號式 AI,也屬於 AI 系統的一類。
有了這把尺,再看到「AI 功能」的行銷字眼,就能自己量一量,看它收到輸入之後,是真的推論出預測或建議,還是只是把原本的功能換了個名字。
AI、機器學習、深度學習與生成式 AI 的包含關係
通行的說法是,AI、機器學習、深度學習、生成式 AI 不是四個並列的東西,而是由大到小一層套一層。IBM 把 AI 底下依序看成機器學習、深度學習、生成式 AI 這一串彼此包含的概念,Google Cloud 也說機器學習是 AI 的一種應用方式,深度學習則是機器學習的分支。
AI 是最外面那一圈。機器學習是 AI 的一種做法,讓系統從資料學出規律;深度學習是機器學習中使用多層神經網路的一支;生成式 AI 則是用深度學習做出、能產出新內容的模型。每往裡一層,就多了一項新的能力。
機器學習從資料歸納規律,學習方式分成 4 種
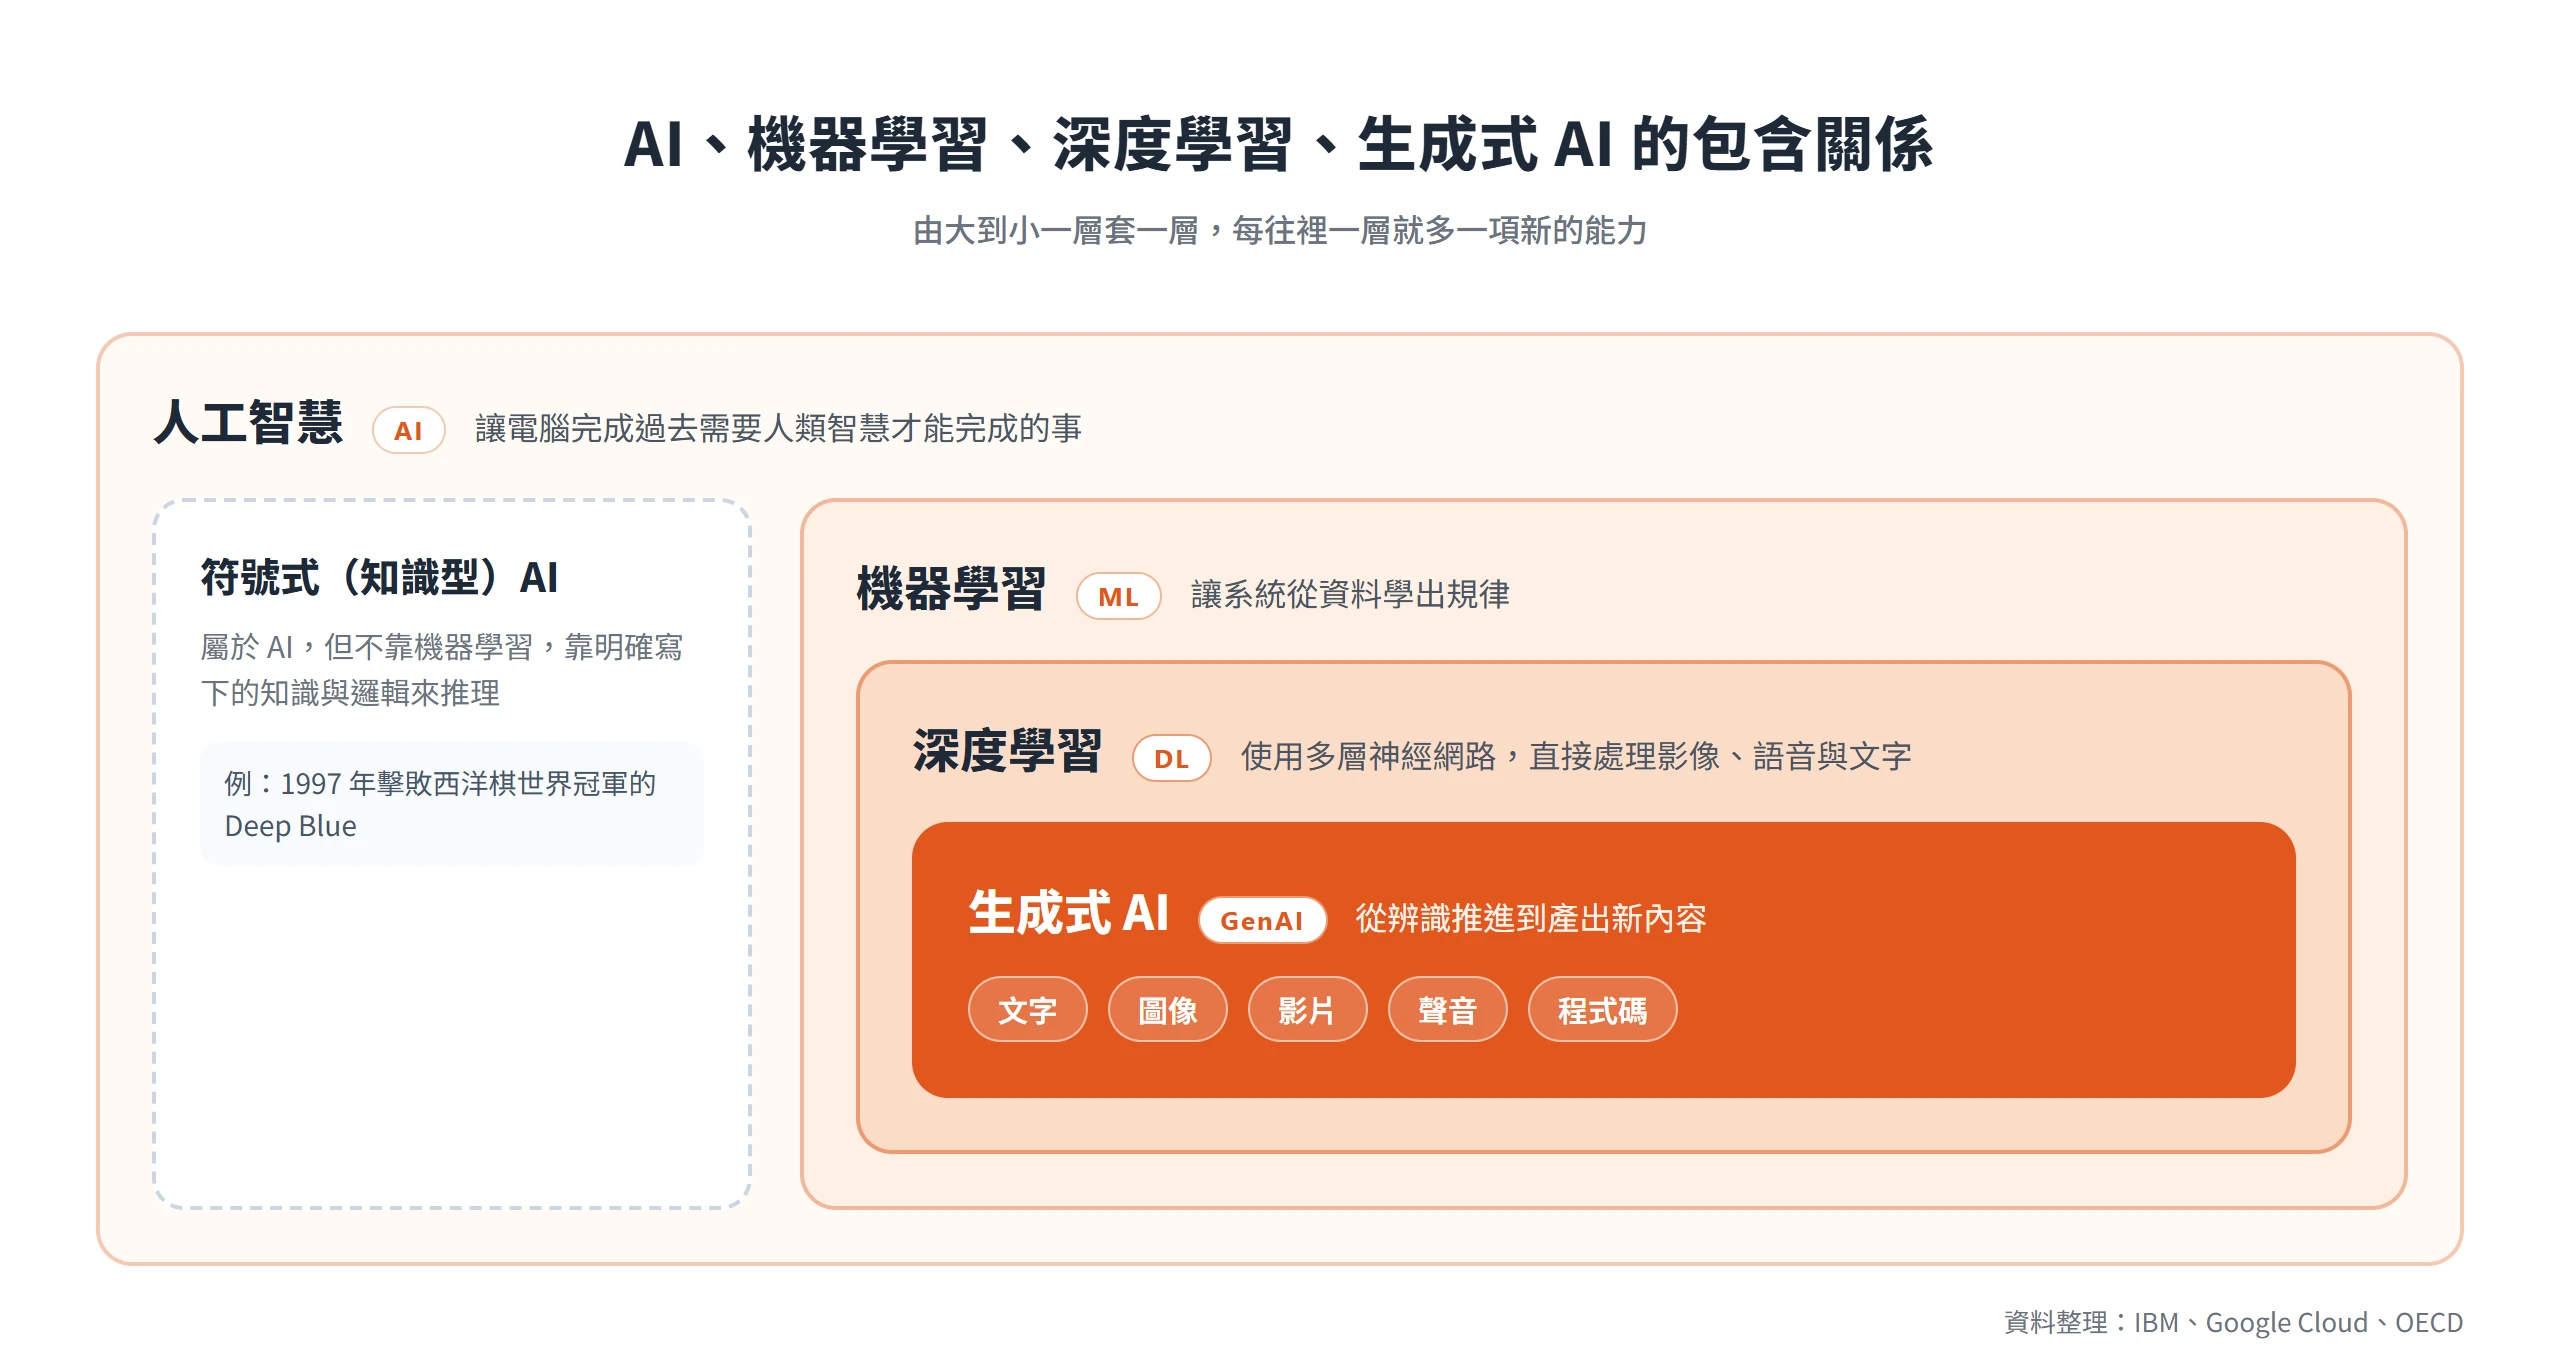
傳統程式是工程師把規則一條條寫死,電腦照著執行。機器學習則反過來,先給它大量範例,讓它自己找出規律,再拿規律去判斷新的資料。Google Cloud 的比喻很貼切,這就像是展示 100 萬個範例讓電腦學習,而不是撰寫 100 萬條規則。以辨識鳥類為例,只要向電腦展示數千張鳥類圖像,它就會自行學出鳥的樣貌。
依 Google Cloud 的整理,機器學習的學習方式有監督式、非監督式、半監督式與強化學習 4 種。監督式學習用已經標好答案的資料訓練,放到生活裡,就是拿一批分別標成垃圾郵件與正常郵件的信件,教系統日後自己分辨。非監督式學習的資料沒有標籤,由演算法自行分群,例如把顧客依消費習慣自動分成幾組。半監督式學習介於兩者之間,只有部分資料加上標籤。強化學習則靠嘗試錯誤與獎懲回饋,好比下棋時走對加分、走錯扣分,一局局練出好的走法。
這套做法有個前提,就是學到什麼取決於餵了什麼。Google Cloud 提醒,如果把帶有偏誤的資料集交給機器學習演算法,結果就會跟著出現偏誤,所以資料好不好,會直接決定結果可不可信。
深度學習以多層神經網路處理影像、語音與文字
深度學習和一般機器學習最大的不同,在於它用層數很多的神經網路,自己從原始的影像、聲音和文字裡抽出特徵,不必由人先告訴它要看什麼。IBM 的說明是,名稱裡的「深」指的就是網路的層數,遠多於傳統機器學習常見的 1 到 2 層隱藏層。
神經網路這個名字,來自大腦中神經元彼此傳遞訊號的方式。不過它只是受到啟發,並不是真的複製了大腦。比起一般機器學習,深度學習能直接處理影像、語音這類非結構化的資料,代價是需要更多的資料與運算能力,準確度才拉得上去。
這也是它今天幾乎無所不在的原因。IBM 指出,日常生活中多數 AI 應用的背後,都有某種形式的深度學習在運作,它特別適合電腦視覺與自然語言處理這類任務。而再往前一步,讓模型不只判斷、還能創作,就來到了生成式 AI。
生成式 AI 把能力從辨識推進到產出內容
前面兩層主要負責判斷、分類與預測。同樣看一張貓的圖片,傳統模型回答的是「這是貓」,生成式模型則能依照一段描述,畫出一隻新的貓。這就是從辨識到產出的差別。
依 IBM 的說明,生成式 AI 的做法是先用大量資料訓練出一個基礎模型。訓練時,它反覆做「填空」練習,預測序列中的下一個元素,可能是句子裡的下一個字、圖像的下一個元素,或程式碼的下一行指令,並不斷調整,縮小預測與實際資料的差距。練到一定程度,它就能依使用者的提示產出文字、圖像、影片、聲音或程式碼。最常見的基礎模型是大型語言模型,另外也有圖像、影音,以及能同時處理多種形式的多模態版本。2022 年 ChatGPT 問世,才讓生成式 AI 進入一般大眾的視野。
生成式 AI 能產出新東西,是因為學到了資料中的規律。IBM 的說法是,生成模型會編碼訓練資料的簡化表徵,再據此產出相似但不完全相同的新作品,所以內容跟訓練資料相似,卻不是原件。不過,新技術出現,並不代表舊的做法就被取代了。
規則式系統與傳統機器學習至今仍在大量使用
層層包含的關係,容易讓人誤以為 AI 就等於生成式 AI,但有兩件事說明並非如此。第一,不是所有 AI 都靠機器學習。OECD 把 AI 系統的建構方式分成兩大類,一類是機器學習,由系統接觸訓練資料自動產生模型,而不是依人類明確指令;另一類是符號式或知識型 AI,靠明確描述變數與它們之間關係的知識表徵來推理,這些表徵可以由人寫入,也可以由機器產生。1997 年擊敗當時西洋棋世界冠軍 Garry Kasparov 的 IBM Deep Blue,就是這一類的代表。OECD 說明,工程師給它的棋規只能讓它下出合法的棋,好棋大多來自它對未來走法的大量推演。
第二,不是所有任務都適合用生成式 AI。AWS 指出,不少組織在各種數位任務中仍使用機器學習模型,而且在許多使用案例中,機器學習模型的效能優於基礎模型,開發人員可以依任務選擇最合適的模型。換句話說,較新的技術不一定比較好,要看手上的任務是什麼。
日常生活早已出現的人工智慧應用
如果覺得 AI 是 2022 年之後才冒出來的新東西,生活裡其實早就有不少例子,像是手機解鎖、串流平台的推薦、地圖的路況預估,都已經用了好些年。
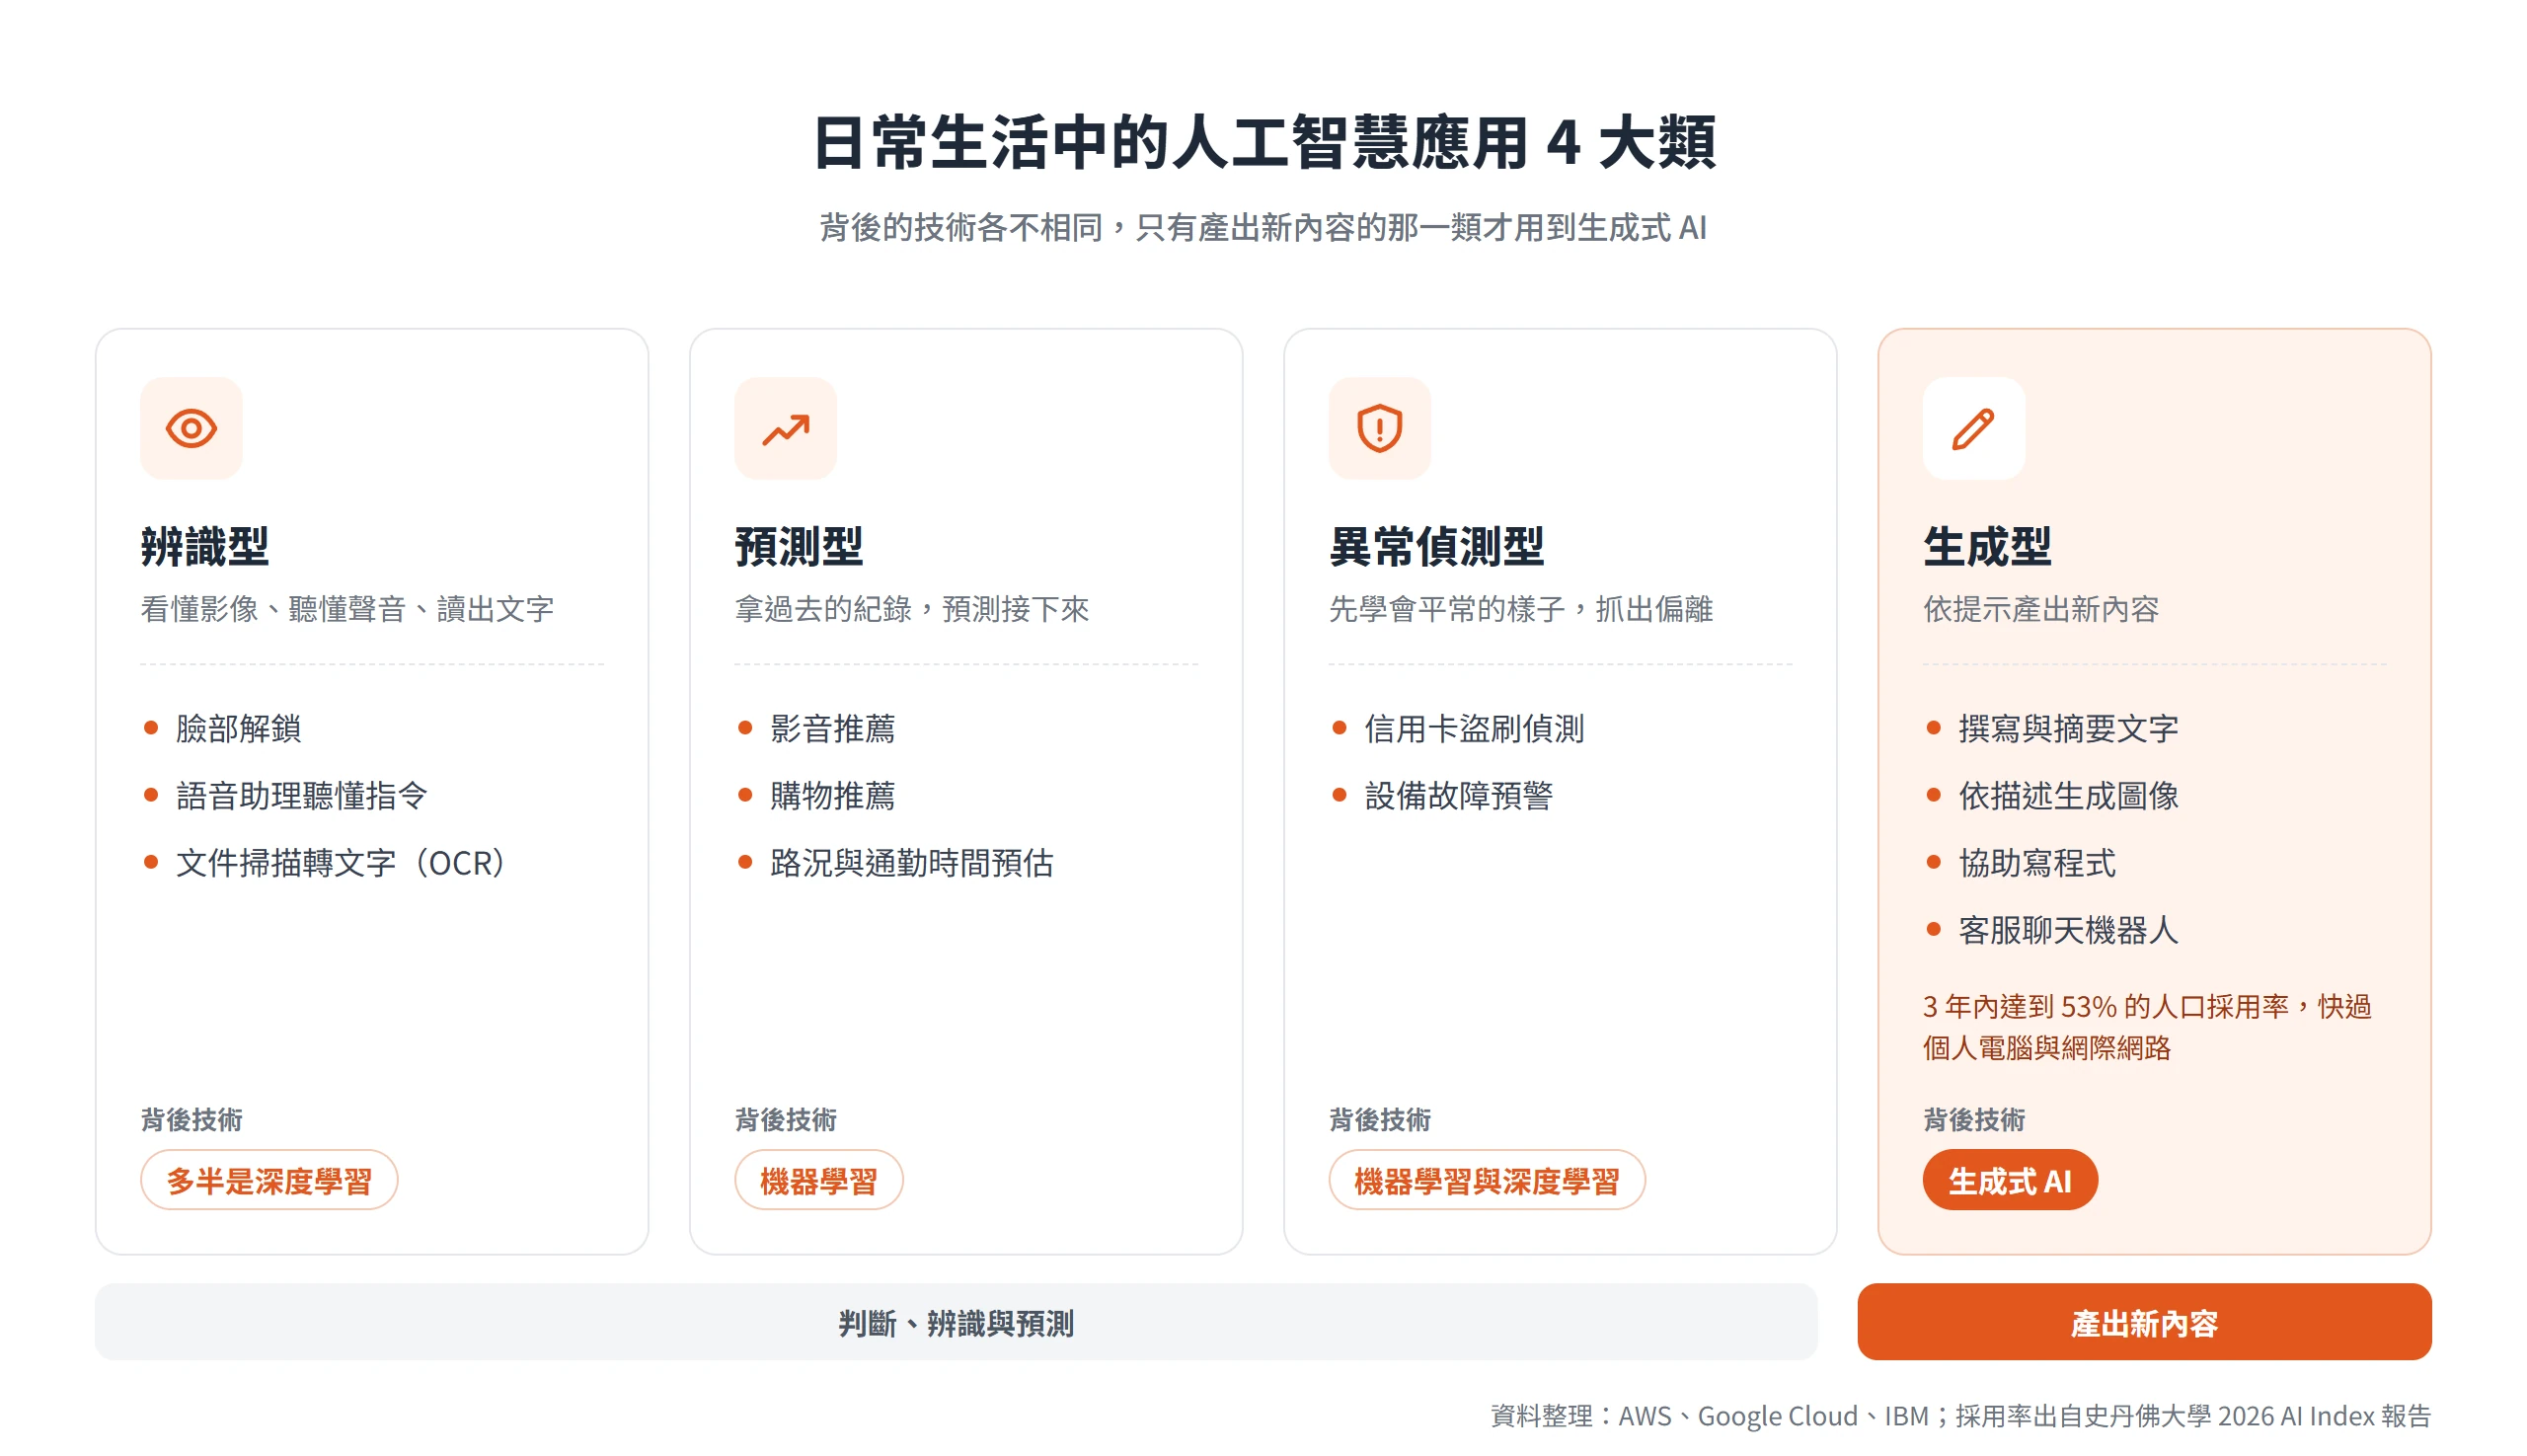
這些應用背後的技術其實各不相同,有的靠深度學習,有的只需要傳統機器學習,只有最近的一類才用到生成式 AI。
臉部解鎖、語音助理與文件掃描背後的辨識能力
AI 很早就普及的用途,是「看」與「聽」。手機認出臉才解鎖,用的是電腦視覺,AWS 說明它使用深度學習從影片與影像中擷取資訊,除了臉部辨識,也用在內容審核與自動駕駛。對著智慧音箱說話,它能聽懂指令,靠的則是語音辨識,深度學習模型會解譯人類語音、把它轉錄成文字,虛擬助理就是靠這一步聽懂指令。
把紙本文件變成可搜尋的文字,就是前面提到的 OCR。Google Cloud 指出,OCR 會運用 AI 從圖像與文件中擷取文字與資料,把非結構化的內容轉成結構化資料。把聲音和影像轉成文字之後,還得理解意思,這部分由自然語言處理負責,AWS 的說明是,它用神經網路解析文字、擷取含義,常見於文件摘要、聊天機器人與情緒分析。
影音推薦、購物推薦與路況預估都屬於預測型應用
打開串流平台,首頁上的推薦並不是隨機排的。AWS 提到,Netflix 和 Spotify 這類串流服務的推薦引擎,會分析使用者偏好來提供個人化的內容建議;電商平台也會根據瀏覽歷史與偏好推薦商品。原理一句話就能講完,就是拿你過去看過、買過什麼,來預測你接下來可能想要什麼。
路況預估是另一個例子。Google Cloud 舉過一個例子,訓練演算法分析即時的大眾運輸與車流資料,預測交通流量和壅塞程度,進而估出通勤時間;AWS 也提到 AI 能預測交通模式並建議替代路線。這幾種應用做的都是預測,而不是生成新內容,靠機器學習就做得到,並不需要生成式 AI。
信用卡盜刷偵測與設備故障預警
AI 還有一種本事,是找出不對勁的地方。IBM 說明,銀行偵測盜刷的邏輯,是先學會你平常怎麼消費、通常在哪裡登入,一旦出現偏離,例如不尋常的消費或登入地點,就先標記為可能的詐欺交易,讓金融機構能更快回應,把損失壓低。
工廠裡也有類似的做法。機器學習模型可以分析感測器、物聯網與營運科技資料,預測設備何時需要維護,並在故障發生前先做出預警。這類應用大多在使用者看不見的地方默默工作,用的多半是機器學習與深度學習,通常不會有人意識到 AI 就在身邊。
生成式 AI 負責寫文字、畫圖與寫程式
近幾年最醒目的一類,是生成式應用。IBM 列出的用途包括依描述撰寫與摘要文字、依一段說明生成圖像,以及協助寫程式、簡化重複的程式撰寫工作。AWS 則指出,生成式 AI 可以由簡短的文字提示建立影像、影片、文字與音訊,文字生成常用在客戶支援、行銷與內容創作。
客服聊天機器人是兩種技術常見的結合點。IBM 說明,這類工具同時運用自然語言處理與生成式 AI,來理解並回應顧客的問題。和前面幾類不同,生成式應用的重點是產出新內容,而不是判斷或預測,也因此特別需要留意幻覺與偏誤。
它普及的速度也特別快。史丹佛大學 2026 年的 AI Index 報告摘要指出,生成式 AI 在 3 年內達到 53% 的人口採用率,快過個人電腦與網際網路,不過各國的快慢不一,而且與人均 GDP 高度相關。
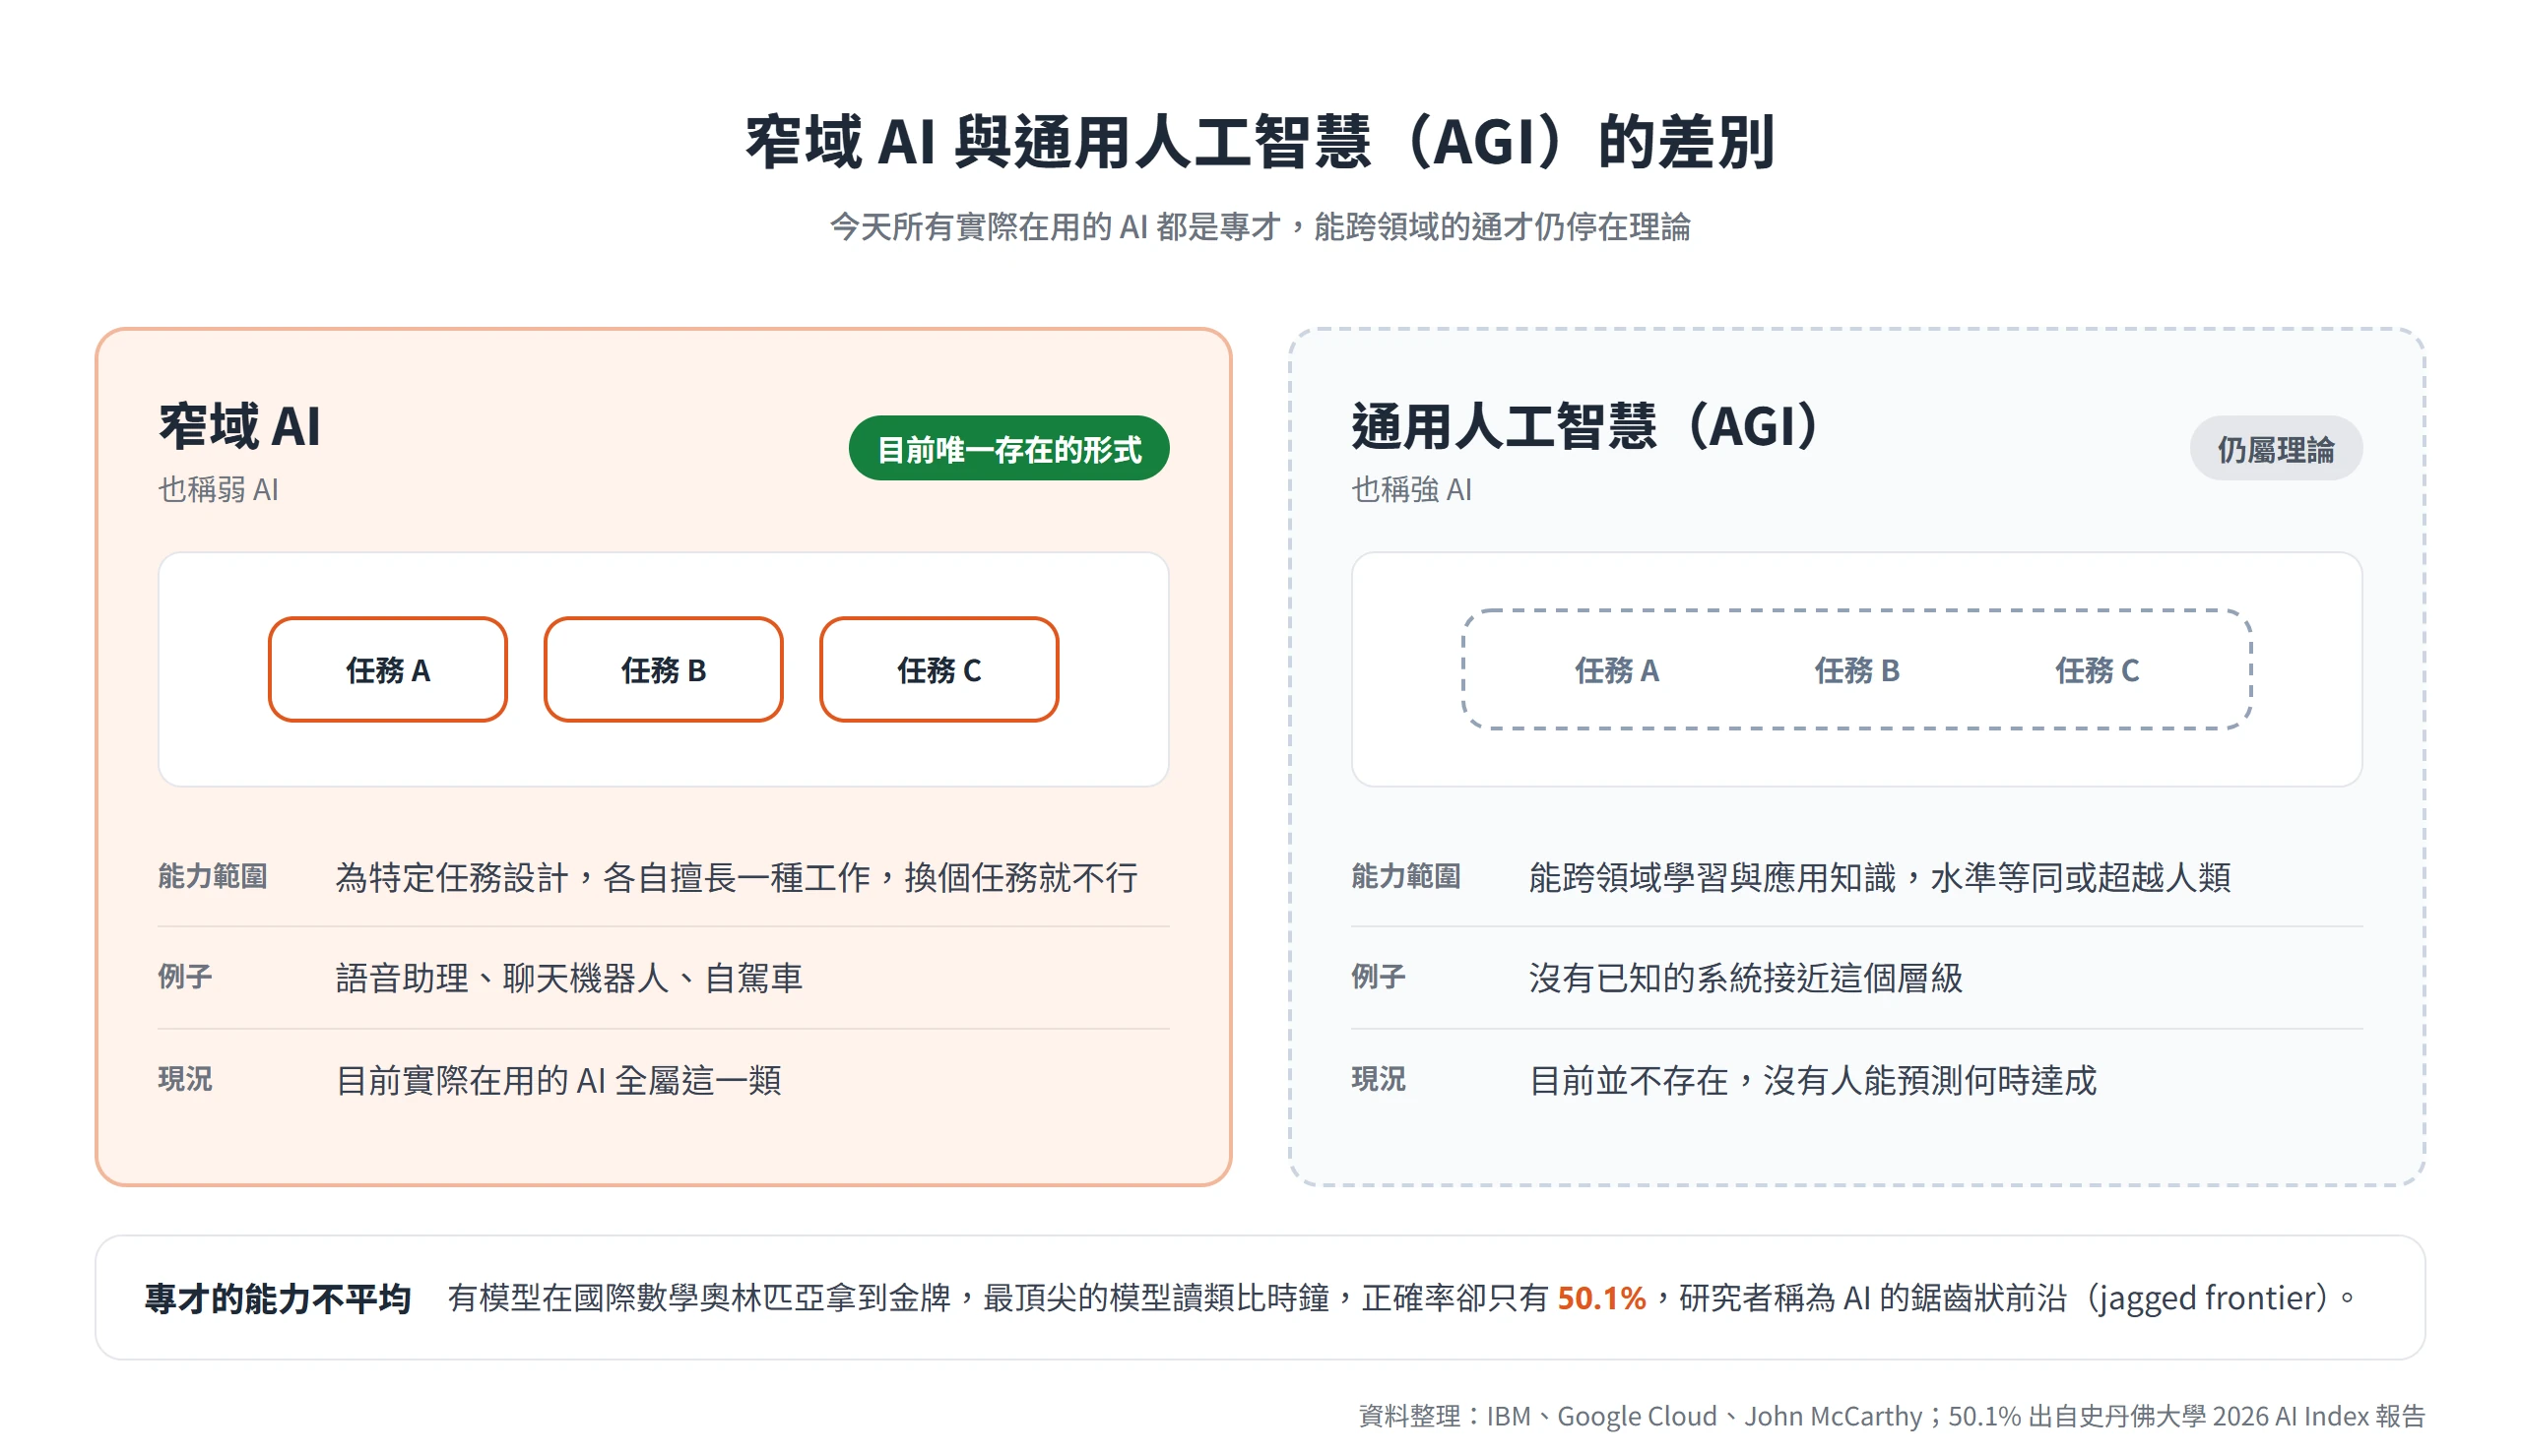
目前的 AI 都是專才,通用人工智慧仍停在理論階段
看過這麼多應用,很容易讓人聯想到電影裡那種有自己想法的 AI。現實是,今天所有實際在用的人工智慧,都屬於專才。
依能力範圍,AI 大致分成兩種。窄域 AI(也稱弱 AI)是為特定任務設計的系統,語音助理、聊天機器人、自駕車都屬這一類,各自擅長一種工作,換個任務就不行。通用人工智慧(AGI,也稱強 AI)則指能跨領域學習與應用知識,水準等同或超越人類的 AI。IBM 的說明是,這個層級目前仍屬理論,沒有已知的系統接近。Google Cloud 同樣表示,窄域 AI 是目前唯一存在的 AI 形式,AGI 目前並不存在。
至於什麼時候會出現,McCarthy 指出,多數 AI 研究者認為還需要新的基礎想法,因此沒有人能預測人類水準的智慧何時會達成。
專才的能力還有一個特色,就是不平均。同一份 AI Index 報告摘要舉了一組對比,Gemini Deep Think 在國際數學奧林匹亞(IMO)拿到金牌,但最頂尖的模型讀類比時鐘,正確率只有 50.1%。報告指出,這種能力有強有弱、分布不均的現象,就是研究者所說的 AI 鋸齒狀前沿(jagged frontier),在難題上表現亮眼的模型,仍可能在看似簡單的事情上出錯。
AI 的 3 個常見誤解與生成式 AI 的幻覺
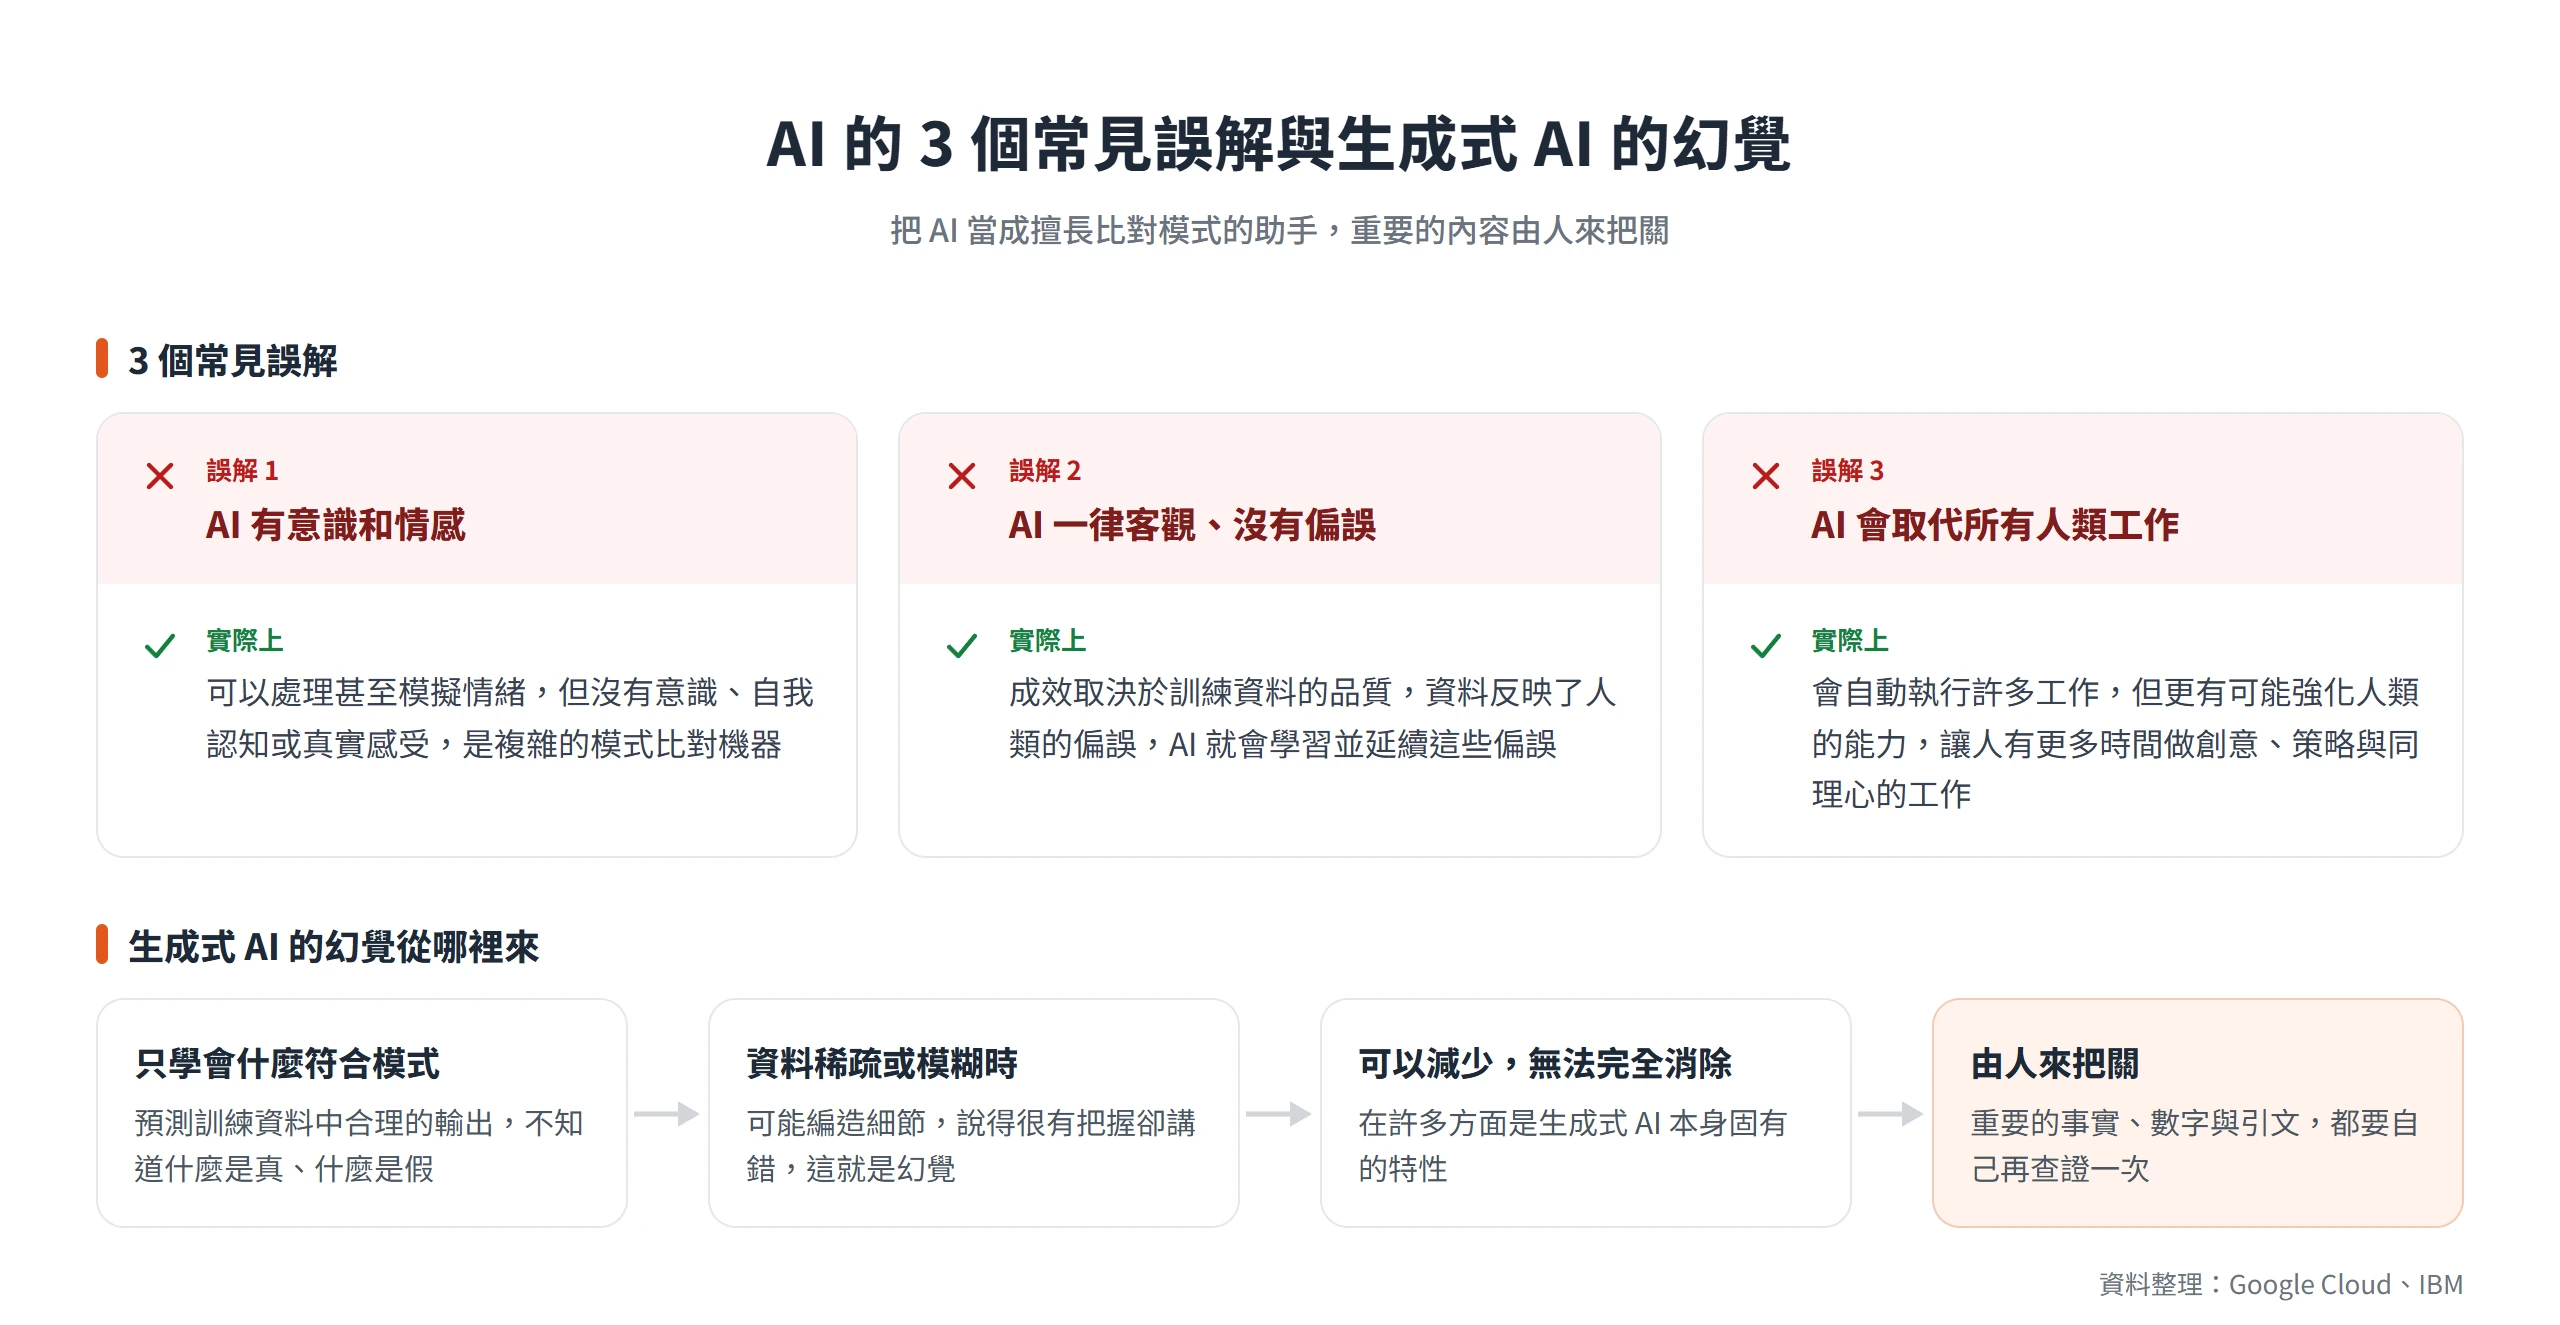
談到 AI 能不能相信,Google Cloud 整理過 3 個常見的誤解,值得先釐清。
第一個誤解是 AI 有意識和情感。實際上,AI 系統可以處理甚至模擬情緒,但沒有意識、自我認知或真實感受,它是複雜的模式比對機器。
第二個誤解是 AI 一律客觀、沒有偏誤。事實上,AI 的成效取決於訓練資料的品質,如果資料反映了人類的偏誤,AI 就會學習並延續這些偏誤。
第三個誤解是 AI 會取代所有人類工作。Google Cloud 的看法是,AI 確實會自動執行許多工作,但更有可能強化人類的能力,讓人有更多時間從事更具創意、策略性與同理心的工作。
生成式 AI 還有一個特性需要留意。IBM 指出,它的運作方式是預測訓練資料中合理的輸出,並不「知道」什麼是真、什麼是假,只「知道」什麼符合模式。以文字模型來說,它被訓練去預測序列中的下一個 token,追求的是在模式內說得通,而不是對世界的描述正確。所以當資料稀疏或模糊時,它可能編造細節,這就是常說的幻覺。
幻覺可以減少,但無法完全消除,IBM 認為這在許多方面是生成式 AI 本身固有的特性。實用的做法很單純,就是把 AI 當成助手,重要的事實、數字與引文都要自己再查證一次,由人來把關。
人工智慧的標籤會隨技術普及而移動,判斷它的方法卻不必跟著變。下次看到新的 AI 功能,不妨先問兩件事,一是它從什麼輸入推論出什麼輸出,二是它的結果有沒有人在把關。把它當成一位擅長比對模式、偶爾會說得很有把握卻講錯的助手,人工智慧就會是個好用的工具,而不是需要仰望或害怕的對象。