多數人一想到 A/B 測試,腦中浮現的都是那種以小博大的故事。一句標題文案的小改動,讓公司一年多賺進 1 億美元,這種案例聽起來像奇蹟。這個故事是真的,出自 Bing 搜尋的內部案例,也讓不少人相信,只要肯做這套實驗,任何網站的任何決策都能靠數據找到絕對正確的答案。這正是這篇想戳破的地方。A/B 測試本身沒有問題,問題出在把它當成能回答任何規模、任何層級問題的萬用驗證工具,而不是只在特定條件下才成立的方法。
Bing 會被拿出來當範例,是因為它的流量大到讓工程師措手不及。實驗才跑沒幾個小時,系統就自動跳出「營收異常暴增」的警報,後續分析才確認這個原本被列為低優先的文案改動,一年在美國就多帶進超過 1 億美元營收。這類案例撐起了「A/B 測試永遠是對的」這個印象,但很少人回頭問一句,自己的網站有那種等級的流量嗎?A/B 測試(A/B Testing) 讓使用者隨機看到只差一個地方的兩個版本,再用實際行為的數據判斷哪一版表現更好,道理原本很單純,只是這道理要成立,背後藏著一連串關於流量、時間與問題層級的前提,很少有人講到。
這篇想把這些前提一一攤開,先從撐起這套神話的成功案例本身講起,再往下拆流量門檻算不算得過去、雜訊怎麼被誤讀成訊號,最後回頭看它真正管用、也真的值得依賴的地方。
百萬流量的成功案例,撐起了 A/B 測試的神話
2012 年,Bing 一名工程師手上有個構想,把一則廣告文案裡的標題稍微改寫。這個構想原本在待辦清單裡排不上前面,團隊也沒特別看好,他還是把它拿去做了一次線上對照實驗,讓一部分使用者看到新版標題、另一部分維持舊版,同時觀察兩邊的營收表現。實驗才跑了幾個小時,系統就自動跳出「營收異常」的警報。通常這種警報代表哪裡出了技術問題,追蹤碼漏放、頁面壞掉才會讓數字瞬間暴衝,這次不是。分析團隊確認之後,這個構想真的讓營收提升 12%,換算成年度、只算美國市場就超過 1 億美元,是 Bing 有史以來投資報酬率最高的一個構想。這件事後來被 Bing 的分析與實驗團隊負責人 Ron Kohavi 寫進《哈佛商業評論》,成為講述 A/B 測試威力時最常被引用的案例之一。
這類案例會被廣泛引用不是沒有道理,數字具體、來源具名,又出自全球知名品牌,天生就比一句「我們認為這樣做比較好」更有說服力。Kohavi 與另外兩位共同作者在《Trustworthy Online Controlled Experiments》書中也提到,Google、Microsoft、LinkedIn、Airbnb 這類公司,每年各自執行的線上對照實驗數量都超過 2 萬次。這個規模本身就在說明一件事,這些公司的成功案例是建立在天文數字般的流量與實驗量之上,不是隨便找一天跑一次測試就複製得出來的結果。
問題出在敘事傳播的過程中,「Bing 那年有多少流量」「那年跑了幾萬次實驗」這幾句話,幾乎每次轉述都被拿掉了。留下來的只剩「A/B 測試讓一句標題文案賺進 1 億美元」這個結論,聽起來像是任何網站、任何規模,只要肯做測試就能複製的奇蹟。這正是後面幾節要拆開來看的地方,同一套方法套用在流量差了好幾個量級的網站上,還會不會得到一樣的答案。
一次真正有效的測試所需流量遠高於多數人想像
「這個流量應該夠了吧」是多數人啟動 A/B 測試前的直覺,但這個直覺很少被拿出來驗算過。要回答「流量夠不夠」這個問題,統計上有一個明確的門檻叫最小可偵測效果(Minimum Detectable Effect,MDE)。白話說,就是「我想抓到多小的差異」這件事,會直接決定「我需要多少樣本才抓得到」。想偵測的差異越小,需要的樣本就越大,反過來如果只想抓出很明顯的差異,需要的樣本會少一些。這個關係不是憑感覺估的,而是有明確的計算公式。
Optimizely 官方文件給過一個具體例子。假設一個頁面原本的基準轉換率是 15%,想知道新版能不能讓轉換率相對提升 10%,而且要有 95% 的統計顯著水準才敢下判斷,光是這一組條件,每個版本就需要大約 8,000 名訪客。如果一次測 4 個版本,等於 1 個原版加 3 個變化版,四個版本加起來要湊到 32,000 名訪客。官方以「網站每週有 1 萬名不重複訪客,而且把全部流量都投進這場實驗」為前提估算,跑完這個門檻需要 3.2 週。
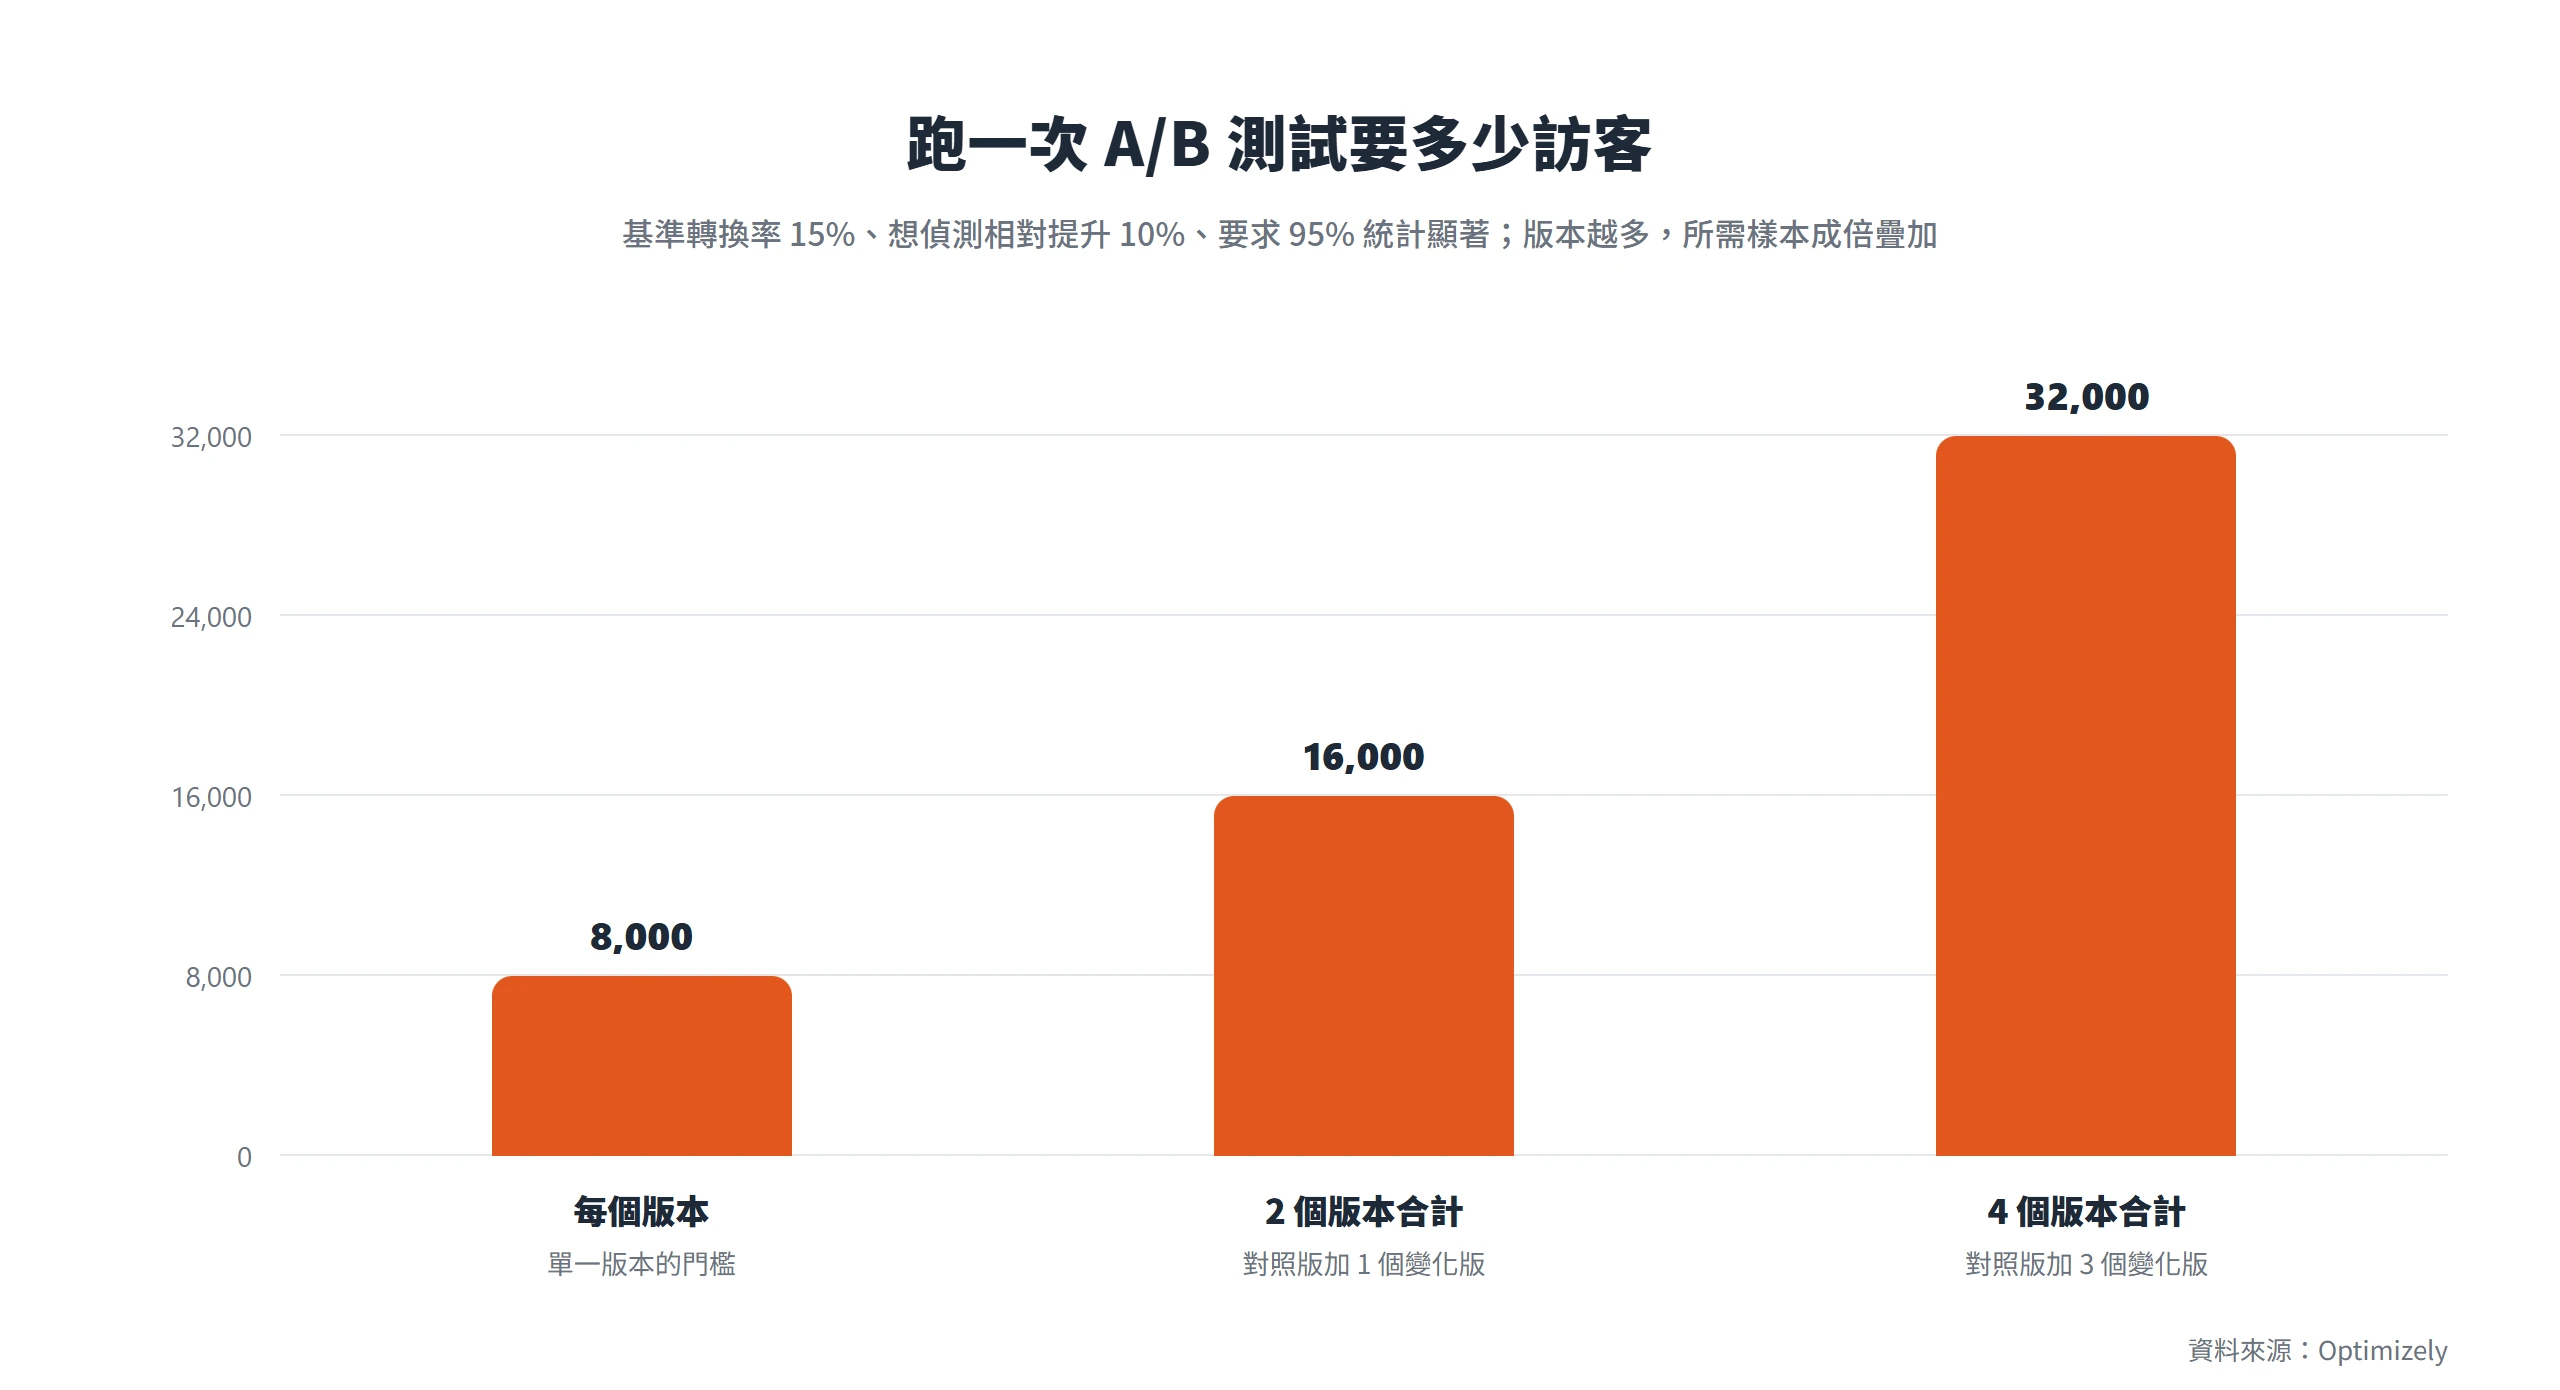
問題是,多數台灣中小企業網站,連「每週 1 萬名訪客」這個前提都構不成。如果把上面同一組官方參數換算到月流量僅 1,000 到 3,000 名訪客的網站,換算成週流量大約是 230 到 700 人,就算只測最簡單的 2 個版本、把門檻縮到 16,000 人,也得花上將近 5 個月到超過 1 年才跑得完,而且這個估算的前提是版本間的效果差異要夠大,相對提升要有 10%。如果實際效果只有 3% 到 5% 這種更常見的幅度,所需樣本數還會再放大好幾倍,跑完的時間只會更久,不會更短。
小流量測試的多數顯著結果只是雜訊
流量不夠,並不代表測試會乖乖告訴你「樣本還沒收滿,請再等等」。它反而常常在你等不及的時候,先端出一個看起來很像贏家的結果,問題是這個「贏家」多半只是雜訊被誤讀成訊號,比乾脆不測還糟,因為它給了你一個錯誤的信心去做下一步決策。
提前偷看數據,假陽性率會被推得更高
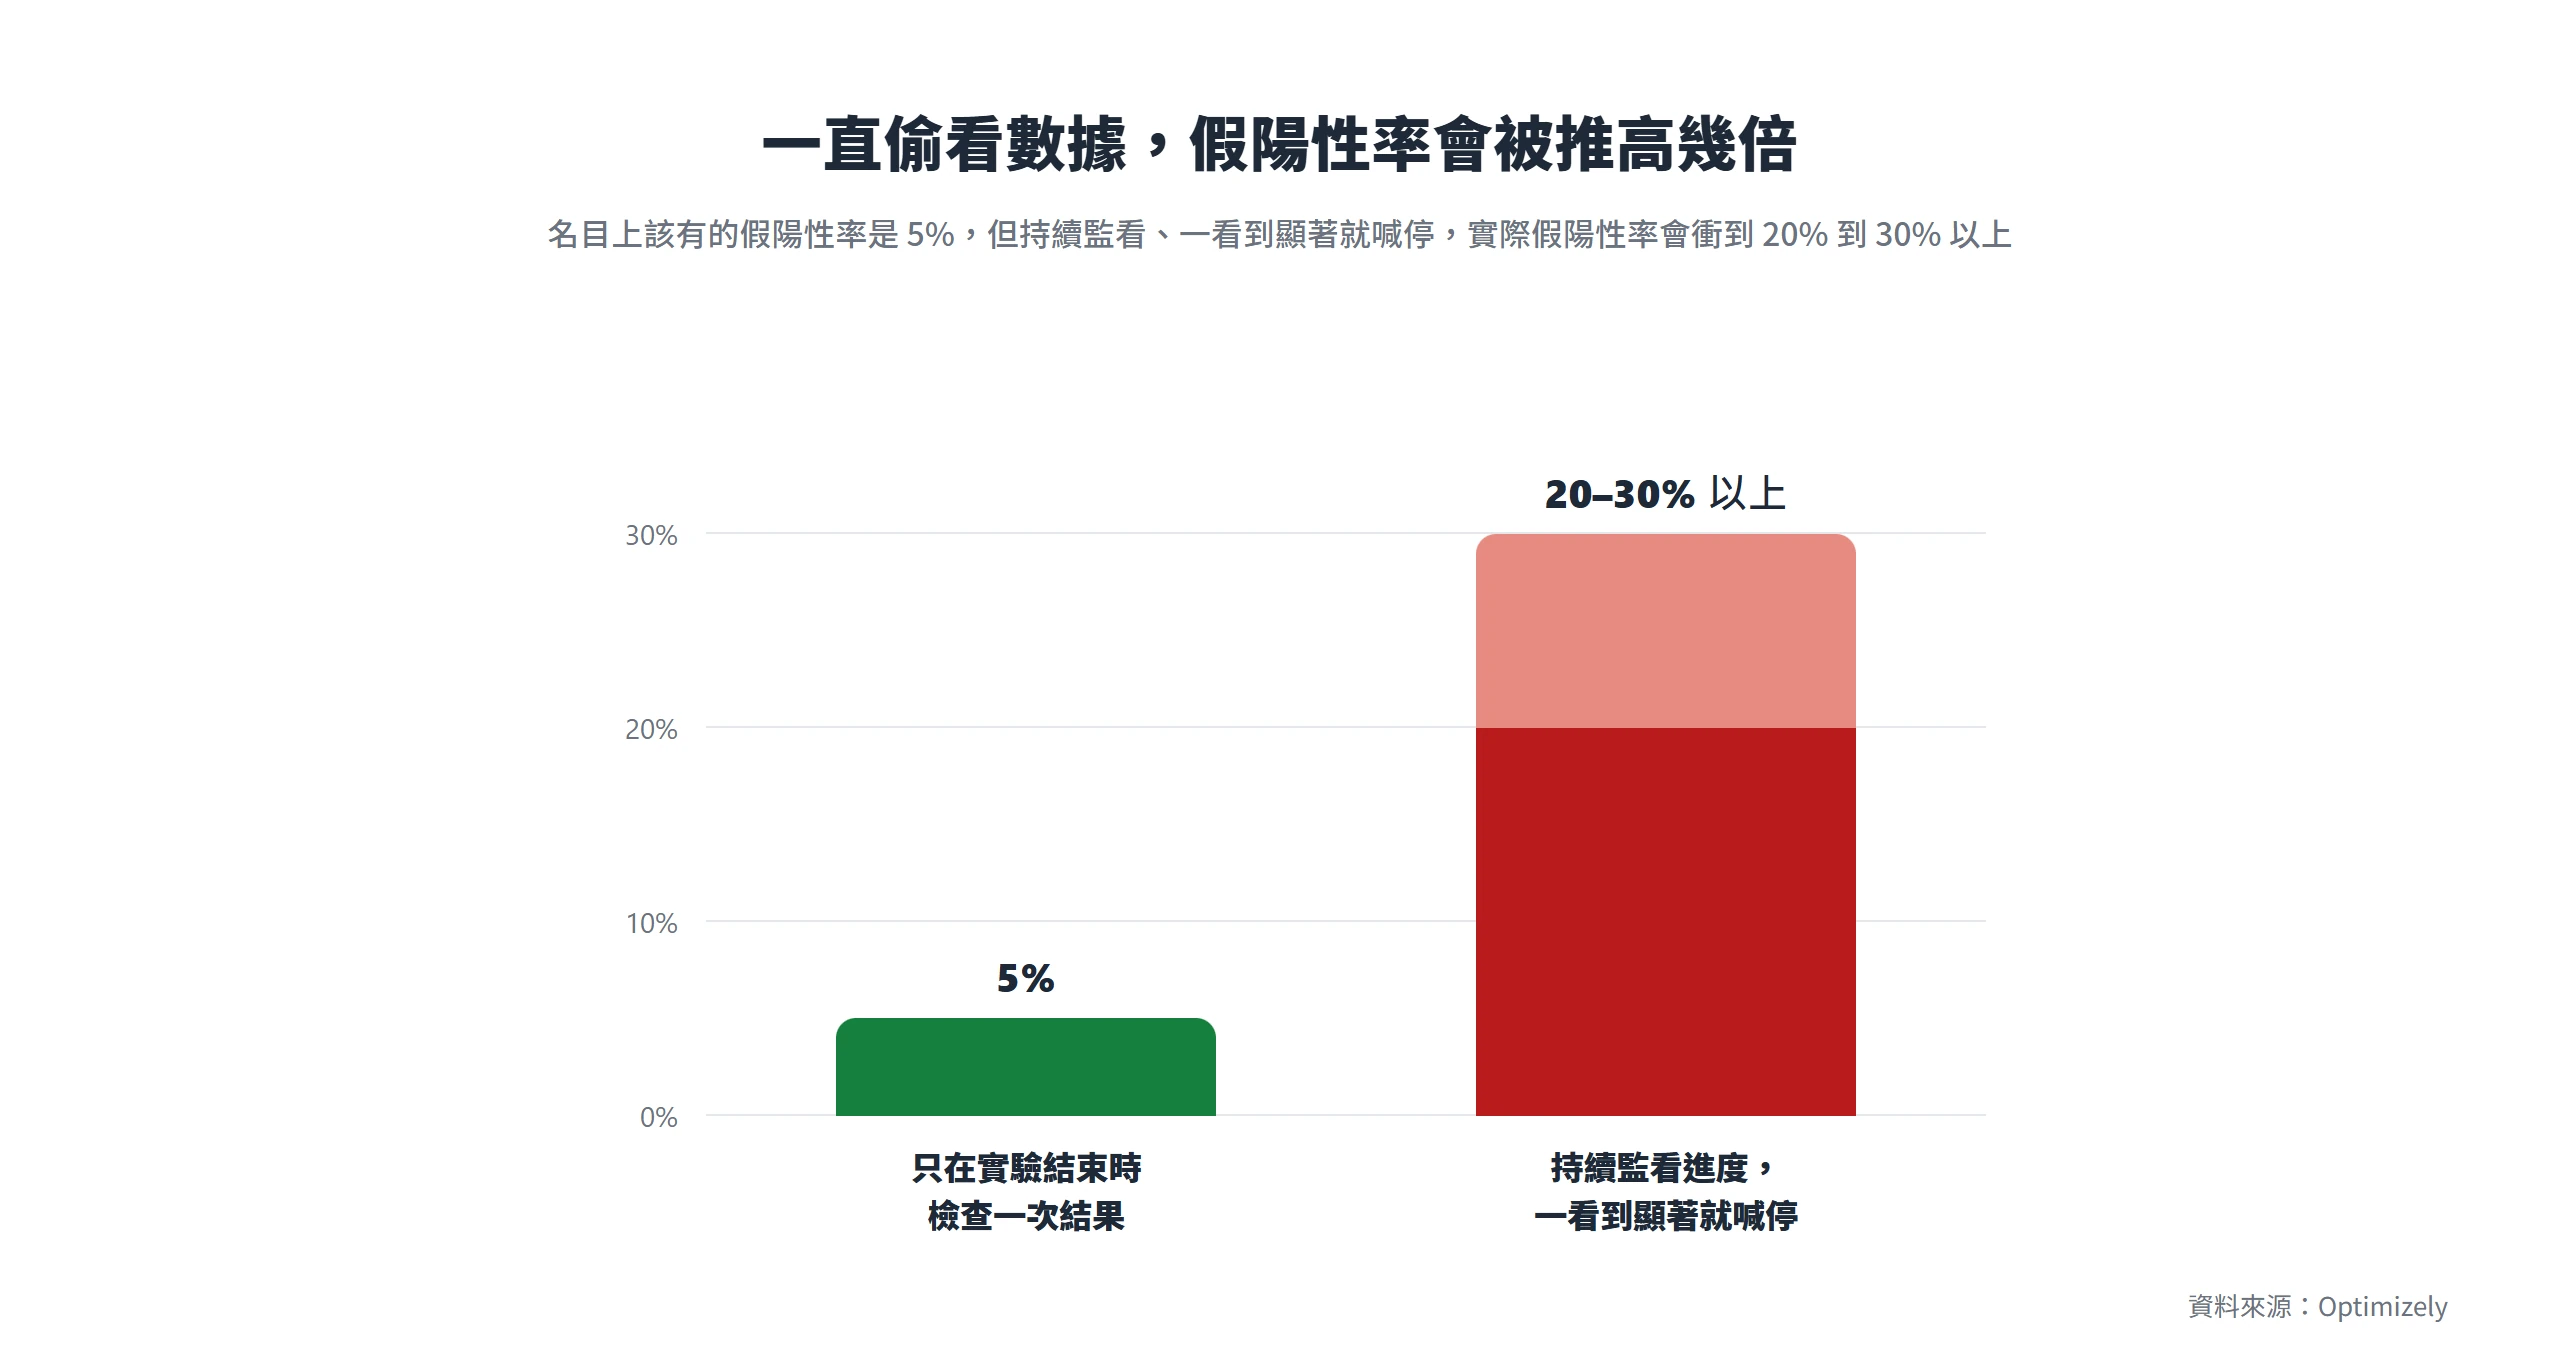
小流量測試最常見的因應方式,就是每天打開後台看一眼「有沒有顯著了」,一看到顯著就喊停,這個動作本身就會系統性地製造假陽性,跟流量大小是兩件不同的事,但流量越小,等待的耐性通常也越薄弱,越容易做這個動作。
Optimizely 的統計團隊與史丹佛大學學者合著的一篇論文指出,傳統的 p 值與信賴區間,原本假設你只在實驗結束的那一刻檢查一次結果。只要使用者持續監看實驗進度,在看到「顯著」的當下就喊停,實際的假陽性率會從名目上的 5% 被推高到 20% 到 30% 以上。換句話說,你以為自己抓到的是真的有效,有很高的機率其實只是隨機波動剛好在那一刻越過了顯著的門檻,再多等幾天,它可能又縮回去了。
顯著結果格外亮眼時,通常代表哪裡出了錯
統計學界有一條被稱為 Twyman 法則的觀察,原本用來描述電視收視率的量測,後來被廣泛套用到各種數據分析情境上,任何看起來有趣或異常的數字,通常是錯的。翻譯成白話,就是越誇張、越亮眼的結果,越可能不是因為你發現了什麼厲害的東西,而是哪裡出了問題,追蹤碼漏放、樣本比例失衡、某個分眾流量被污染,都會讓數字看起來特別漂亮。
Kohavi、Tang、Xu 在《Trustworthy Online Controlled Experiments》書中,把這條法則明確寫進線上對照實驗的操作準則,列為判讀「好到不像真的」結果時的第一道防線。小流量測試因為本身波動就大,特別容易冒出這種看起來很猛的假結果,樣本越少,單一極端值對整體平均的影響就越大,一兩個異常使用者的行為,就足以把轉換率拉出一個誇張的差距。讀者看到這種結果,學會的第一個反應應該是懷疑,不是慶祝。
資源足夠的實驗多數也測不出正向結果
就算把流量與雜訊這兩個問題都排除,剩下的現實還是不樂觀。Kohavi 與 Microsoft 同事在一篇論文中揭露 Microsoft 內部的實驗數據,那些設計嚴謹、由專業團隊執行、目標是改善關鍵指標的實驗裡,大約只有三分之一真的測出統計顯著的正向結果,另外三分之一持平無顯著差異,剩下三分之一甚至測出負向結果。
Microsoft 的流量與工程資源,遠遠超過任何一間中小企業網站能想像的規模,連他們設計嚴謹的實驗都只有三分之一能測出正向結果,反推回來,流量遠遠不足、實驗設計也未必嚴謹的小型網站,測出真的有效結果的機率只會更低,不會更高。但很多小型網站測試的心態卻反過來,因為每一次測試成本都不低,一旦看到一次顯著,就傾向直接採信,不太會去想這次的顯著,會不會就是那三分之二裡的雜訊。
就算流量足夠,測試也只能在既有框架裡打轉
把前面的流量問題與雜訊問題都排除,假設一個網站真的流量夠大、也真的測出了乾淨的訊號,A/B 測試能回答的問題,仍然有一條天生的界線。它只能在已經放進實驗裡的幾個候選版本之間挑出一個贏家,按鈕顏色、文案用詞、圖片擺在左邊還是右邊,這種問題它答得漂亮。但它沒辦法回答「這個版面配置本身該不該整個重排」「導覽結構該不該砍掉重練」這種資訊架構層級的問題,因為候選方案本身就得先靠判斷力做出來,測試不會替你想出方案,也不會告訴你該往哪個方向想。
Nielsen Norman Group 的一篇分析明確區分了兩種情境的差別,漸進式優化,改一個元素、測一次,跟大幅改版,整頁重新設計,不是同一回事。大幅改版時,頁面上同時變動的元素太多,各個元素的效果會互相遮蔽,光靠一次測試,很難拆解出是哪個元素在起作用,轉換率變好或變差,功勞或責任都很難釐清該記在誰頭上。
這篇分析也點出一條出路,把大改版拆成一連串中間測試,理論上可以逐步驗證。但問題馬上又繞回原點,「怎麼拆、往哪個方向拆」這個判斷,仍然來自人的經驗與品味,不是測試本身能夠產生的。測試永遠只能回答「這個已經存在的候選方案表現好不好」,答不出「還有沒有更好的候選方案我根本沒想到」。
數據不能取代對產品全局的判斷力
當一間公司把「有沒有數據支持」當成每一個決策非過不可的門檻,會發生什麼事?Google 前視覺設計主管 Douglas Bowman 在 2009 年公開發表的辭職信〈Goodbye, Google〉裡給了一個具體答案。他寫到,團隊曾經在兩種藍色之間拿不定主意,於是把這兩種藍色之間的漸層拆成 41 種色階,逐一測試哪一種表現最好,他也提到自己曾經只是想決定一條邊框該是 3 像素、4 像素還是 5 像素寬,卻被要求拿數據證明。這封信後來被 Fast Company、AdWeek 等媒體廣泛報導,普遍被解讀為數據測試凌駕設計判斷、導致組織無法做出大膽決策的代表案例。
這個故事點出的問題,不是測試本身有問題,而是測試被無限上綱到連幾個像素的邊框寬度都要拿數據證明。當組織把力氣全部花在把附近那座小山爬得更精確一點,卻沒有人在看整座山的地圖在哪裡,最後所有決策都停留在哪個色階多了幾次點擊這種微幅優化上,反而失去了做大格局、有遠見決策的能力。這也跟上一節答不了結構問題互相呼應,不是測試本身有錯,是把它用在不該用的地方,還把它當成迴避判斷的藉口。只要說得出「我們有測試」,就不用為一個真正需要眼光與品味的決策負責。
質化研究能用更少樣本回答問題出在哪
過度依賴 A/B 測試,還有一個常被忽略的代價,把資源全押在量化測試上,等於放棄了另一種成本低得多、而且能回答「為什麼」而不是只回答「哪個贏」的方法。A/B 測試告訴你哪個版本轉換率比較高,但答不出使用者為什麼在某個環節遇到問題,質化研究剛好補上這一塊。
Nielsen Norman Group 的研究發現,找 5 名使用者做質化可用性測試,就能找出介面裡大約 85% 的可用性問題。這個數字放回前面 H2 算出的門檻一起看,對比會很鮮明,量化測試要湊到上萬名訪客才測得出一個假設對不對,質化測試只要 5 個人,就能找出多數使用者在哪個環節遇到問題、問題出在哪裡。兩者要回答的問題本來就不一樣,量化測試取得的是能拿來做基準比較的數字,質化測試取得的是「哪裡有問題、為什麼有問題」這種數字本身講不出來的洞察,兩者是互補關係,不是誰能取代誰。
當一個團隊的資源全部押在等流量跑完 A/B 測試上,質化研究這條成本低得多、也回答得了為什麼的路,常常就這樣被放棄了。不是因為它不管用,而是因為量化測試看起來比較科學,即使實際上流量根本撐不起那套科學。
用流量規模與問題層級,決定該不該測
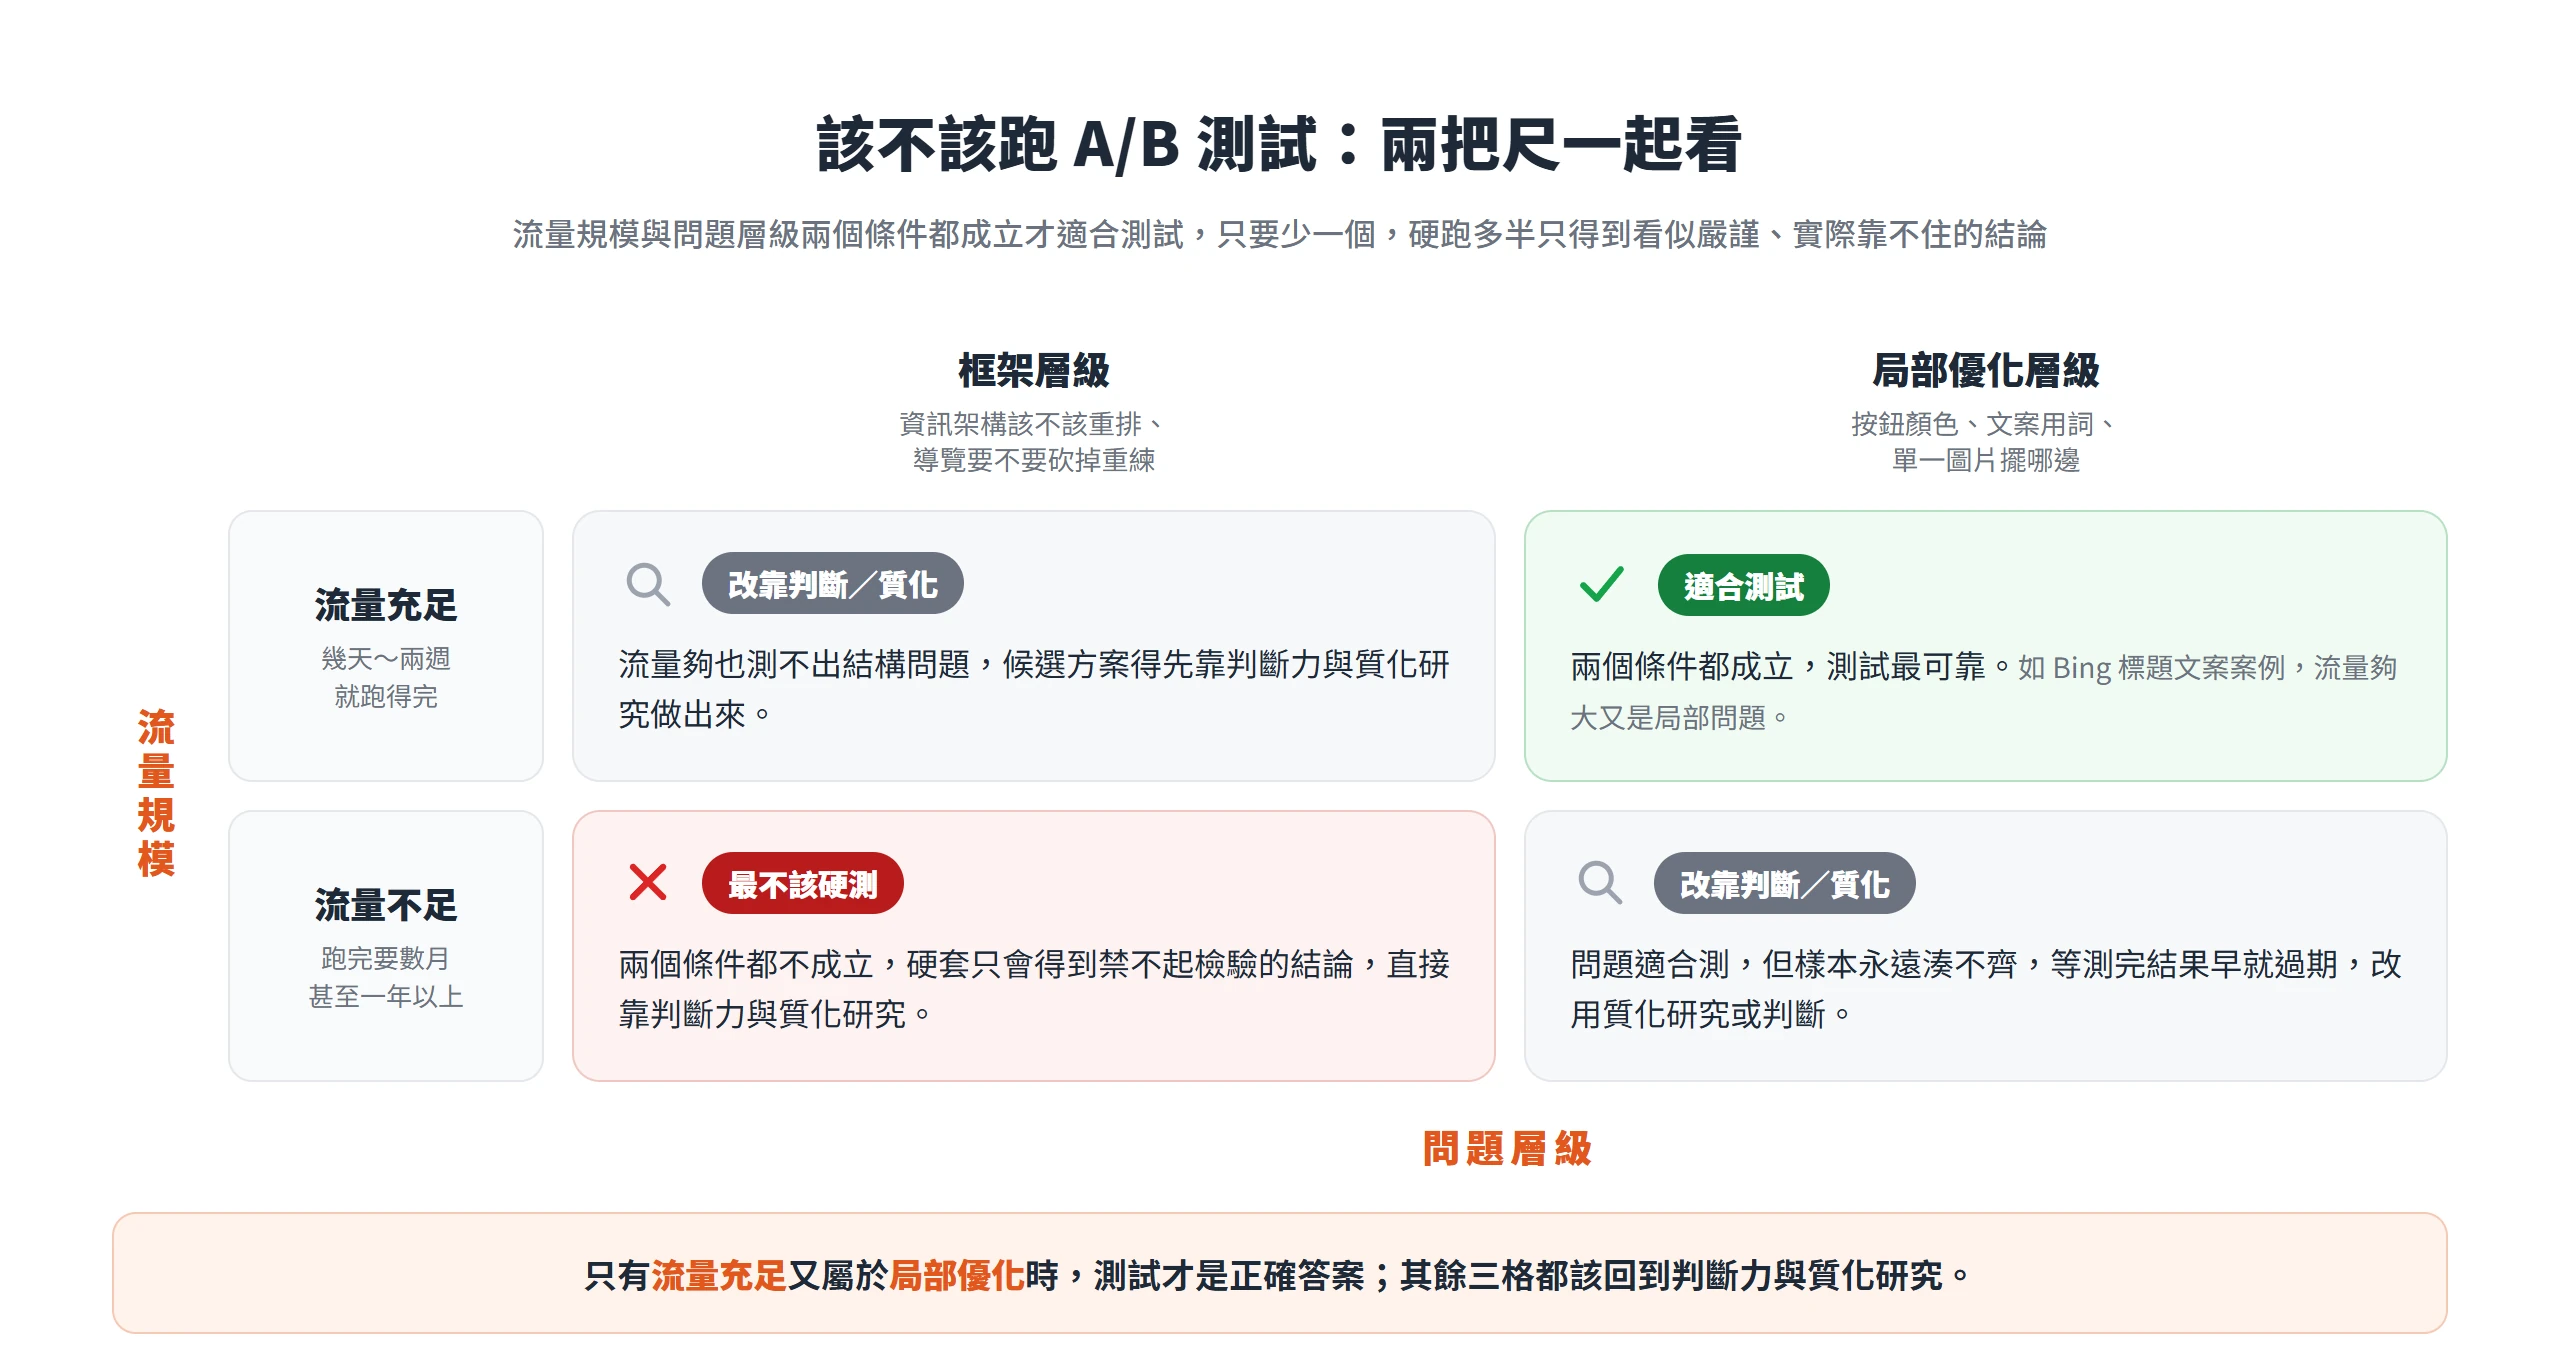
前面幾節拆開了 A/B 測試的幾個限制,但這不是要全盤否定它。A/B 測試沒有錯,錯的是不分場合硬套。這裡給兩把可以實際拿來用的尺,判斷「我這個情境,該不該跑 A/B 測試」。
月流量規模是測試能否成立的第一道門檻
第一把尺,是回頭用前面那組官方 MDE 公式,代入自己網站的實際月流量與想偵測的效果幅度,算出跑完一次測試大概要多久。如果代入之後,答案是幾個月甚至一年以上,就代表這個情境不適合硬跑 A/B 測試。不是因為測試做不到,而是等測試跑完的這段時間,市場、產品、甚至公司本身可能都已經變了,測出來的結果早就過期。這種情況下,該把資源挪去質化研究,或是直接靠對產品與使用者的判斷做決定,不必硬等一個永遠湊不齊樣本的答案。
反過來,如果代入之後,答案是幾天或頂多一兩週就跑得完,代表流量門檻沒問題,可以放心往下看第二把尺,問題本身適不適合用測試來回答。
問題屬於局部調整或框架本身,測試效力天差地遠
第二把尺,是回頭看前面講過的界線,按鈕顏色、文案用詞、單一圖片這種答案已經在候選名單裡的問題適合測試,「這個資訊架構該不該整個重排」這種答案根本還沒被想出來的問題,測試給不了答案,得靠判斷力、質化研究與經驗去回答。
Bing 那次標題文案的案例,剛好同時符合這兩個條件,流量夠大,問題也剛好落在文案用詞怎麼選這種局部層級,測試才發揮得出它真正的威力。而 Basecamp 的例子,剛好示範了另一面。Basecamp 共同創辦人 Jason Fried 曾公開談過,團隊多數產品決策仰賴長期累積的判斷力與品味,而非逐項測試才決定,但他也公開承認過一次代價。Basecamp 曾經改版首頁,拿掉了原本放在首頁的註冊表單,卻沒有做 A/B 測試,導致轉換率下滑了一段時間才被發現,換算損失達數百萬美元。他事後承認,如果當初做了測試,兩週內就能抓到問題。
這個案例剛好示範了反方成立的那一面。當問題確實屬於「這個版本表現有沒有比較好」這種可被測試回答的局部問題,而且流量也撐得起測試時,跳過測試、只憑判斷,代價一樣可能很高。這正是這篇想留下的判斷方式,先看流量門檻撐不撐得住,再看問題屬於局部還是框架層級,兩個條件都成立,測試才是正確答案,少了任何一個,硬跑測試多半只會得到一個看起來很科學、實際上靠不住的結論。
回到最開頭 Bing 那個一年多賺 1 億美元的故事,它是真的,但它能發生,靠的是 Bing 那年的流量大到工程師措手不及。多數網站沒有那種流量,這不是誰的錯,只是代表同一套方法在不同規模下,會給出完全不同的答案。
A/B 測試該得到的評價,不是萬用的科學驗證工具,也不是沒用的把戲,而是一個有清楚使用條件的方法。流量夠、問題屬於局部優化層級,它就是最可靠的答案;流量不夠、或問題屬於資訊架構這種框架層級,硬套只會得到一個看起來嚴謹、實際上禁不起檢驗的結論。分辨清楚自己現在站在哪一邊,比迷信任何一套方法本身,都更接近真正做對決策這件事。