
多數人判斷一款 AI 文案產生器寫出來的文案能不能用,看的是讀起來順不順、格式對不對;真正該檢查的,卻是規格編得對不對、語氣像不像自己家、賣點站不站得住腳,這三件事跟順不順沒有太大關係。
如果你平常靠 AI 文案產生器批次寫社群貼文、商品頁文案或廣告標語,大概都遇過同一種情況:交期一到,產出的稿子讀起來完整、分段清楚,看過一遍覺得順就送出去了。問題往往不在送出去的那個當下被發現,而是等文案上線之後,規格寫錯被讀者抓包、語氣跟同業一模一樣、或是點擊之後沒人真的下單,這時候要收拾就麻煩多了。
AI 文案產生器能快速產出通順的句子,這件事本身沒有問題;問題出在通順只保證這篇文案讀得下去,不保證裡面的規格是真的、語氣是你家的,也不保證讀者看完願意採取下一步動作。判斷方法可以拆成幾個自己就能核對的檢查點,不用再只憑語感決定一篇 AI 文案能不能直接用。這正是所有判斷的起點,文案讀起來很完整,不代表它站得住腳。
通順好讀的文案,不代表內容站得住腳
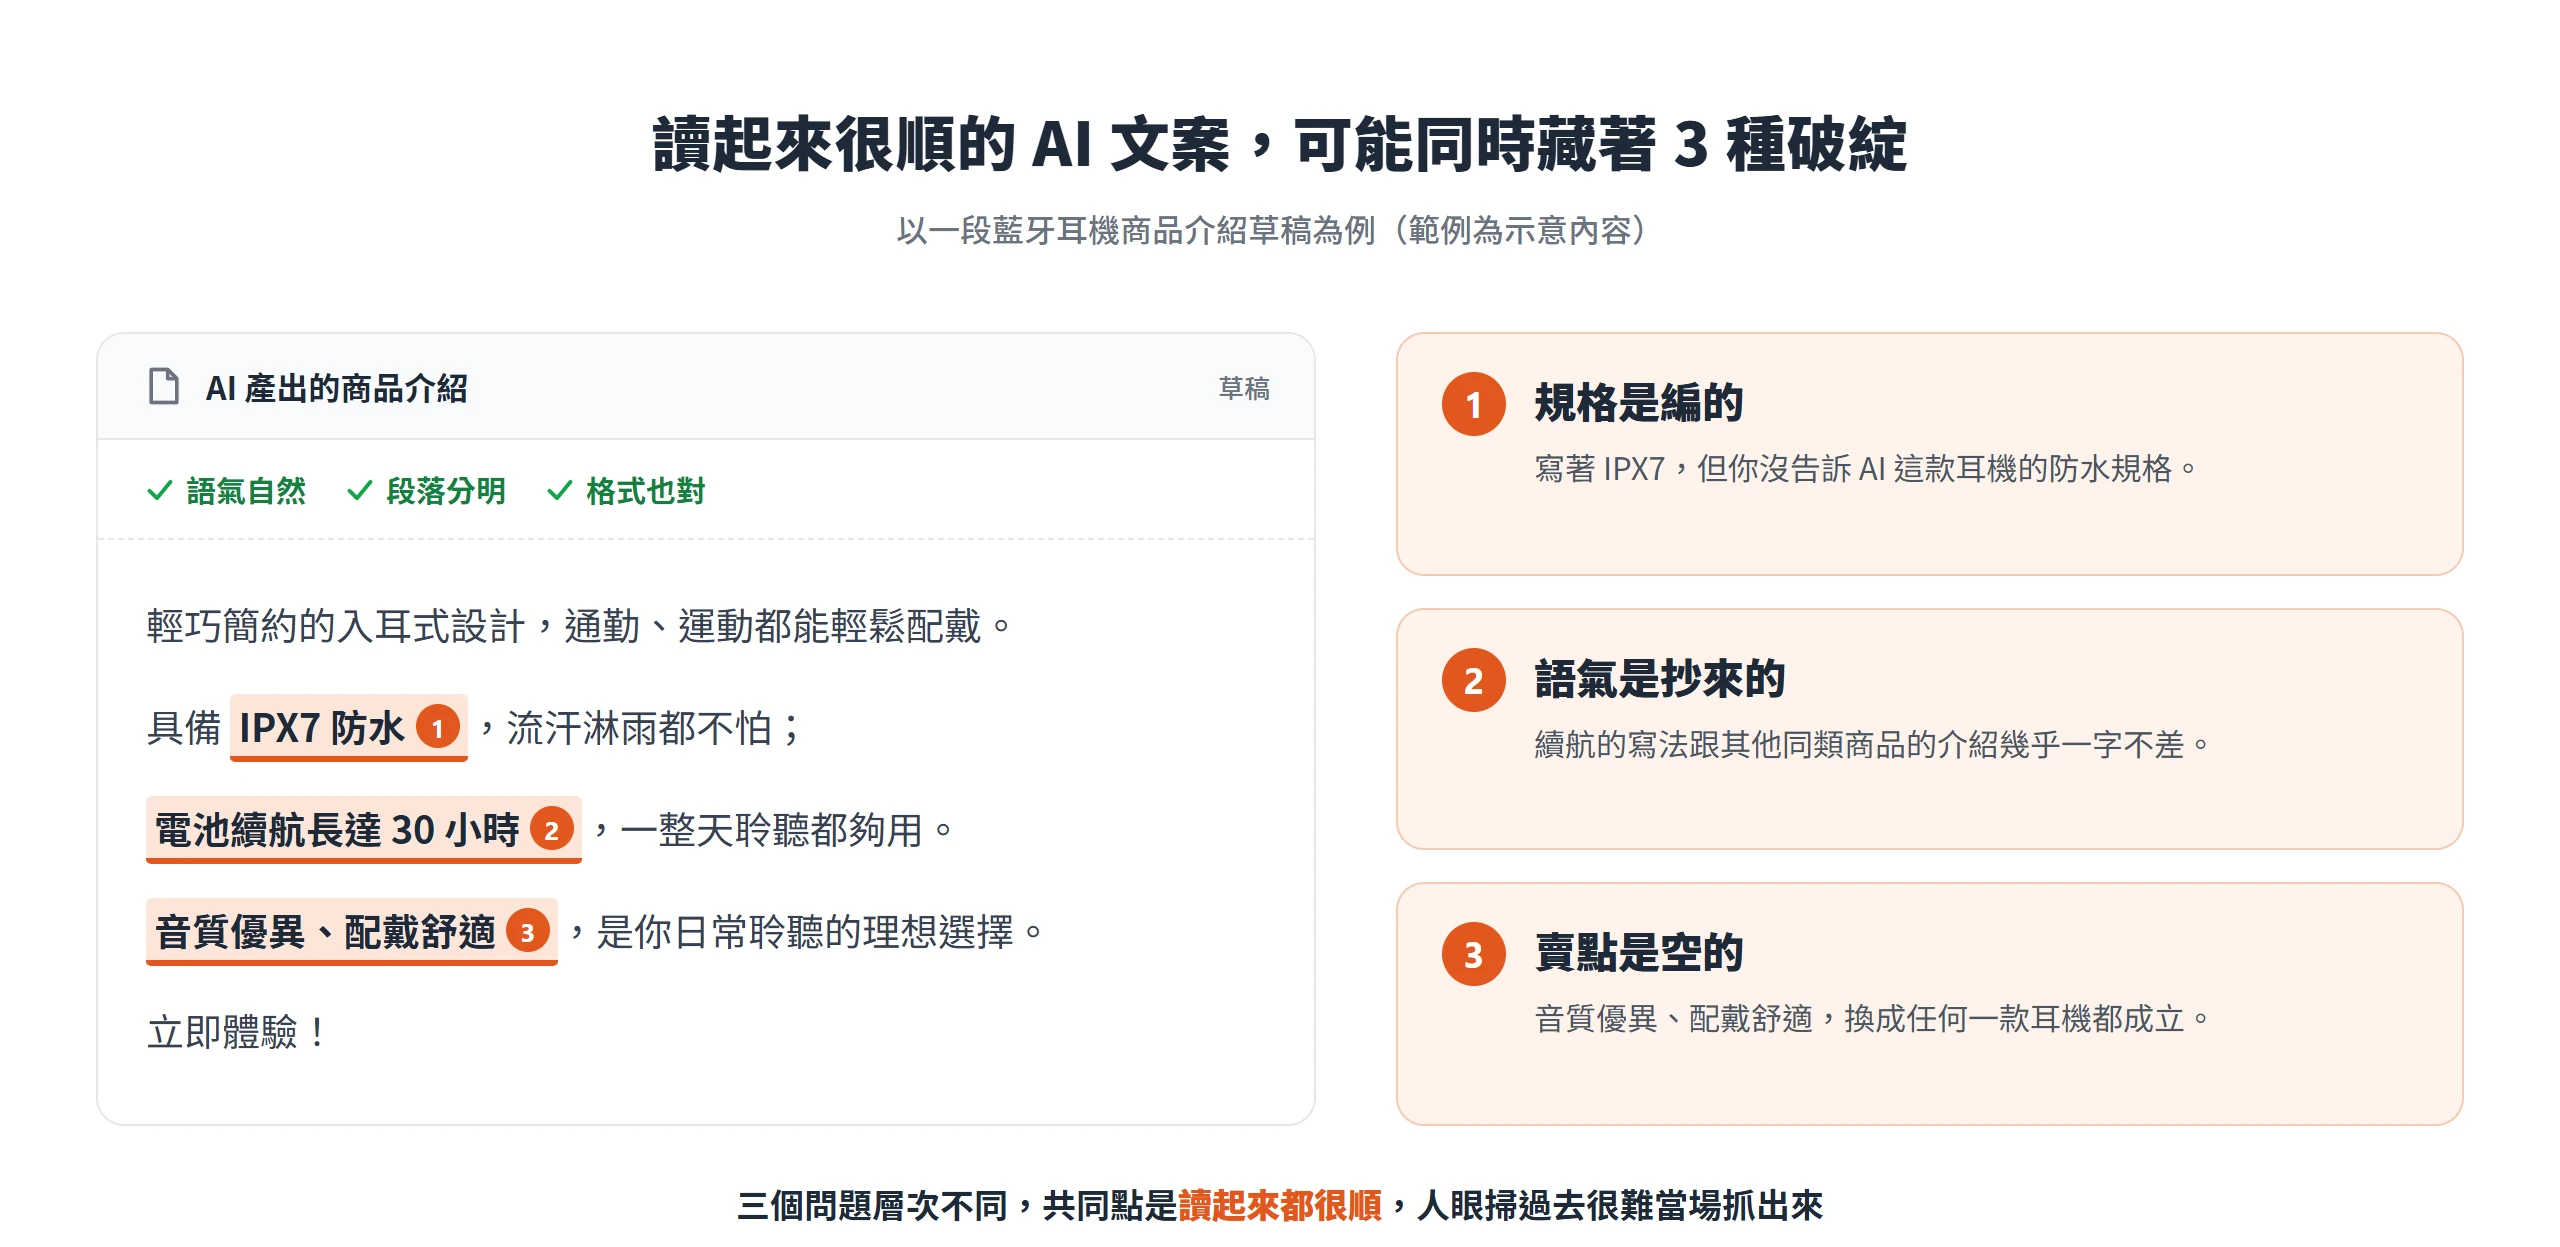
假設一款藍牙耳機要上架,你請 AI 文案產生器寫一段商品介紹。幾秒鐘後跑出來的文字語氣自然、段落分明,格式也對,先講設計再講規格,最後收在一句行動呼籲,表面上完全是一篇能直接貼上架的文案。
問題藏在細節裡。防水等級寫著 IPX7,你其實沒告訴 AI 這款耳機的防水規格;電池續航寫成 30 小時,用詞跟其他同類商品的介紹幾乎一字不差;賣點寫著音質優異、配戴舒適,換成任何一款耳機都成立。這三個問題各自屬於不同層次,規格是編的、語氣是抄來的、賣點是空的,但它們有一個共同點,讀起來都很順,人眼掃過去很難當場抓出來。
會出現這種情況,原因跟 AI 文案產生器的運作方式有關。這類工具背後的生成式語言模型,是從大量訓練資料裡挑出統計上最可能接續的字詞,目標是產出一句讀起來通順、合乎語法的話,不是查核這句話講的是不是事實,也不理解你的品牌調性,更不會判斷這段文字有沒有說服力。它擅長的是判斷下一個字該接什麼,不是這句話對不對。
這也是為什麼 Google 對 AI 生成內容的立場,從來不是看內容是不是機器寫的,而是看內容本身好不好。Google 搜尋中心的部落格說明過,用 AI 操弄排名的做法違反其垃圾內容政策,但用 AI 產出對讀者真正有幫助的內容並不是問題,判準回到內容本身的專業性、經驗、權威性與可信度。換句話說,通順從來不是判準,可用不可用才是。
所以判斷一篇 AI 文案能不能用,起手式不是唸一次順不順口,而是先問清楚裡面每一句話,是不是真的對得起「可以直接拿去用」這幾個字。
規格與數據若有誤,責任不會算在 AI 頭上
AI 文案產生器最容易被戳破的地方,是內容本身站不站得住腳。說明書上沒寫的規格,它會自己補一個出來;讀起來自信滿滿,你卻沒辦法保證那是真的。放在商品頁與廣告上,這不是抽象的品質不好,而是規格寫錯、承諾過頭,會直接變成品牌要負責的廣告內容。
資訊缺漏時,AI 習慣自己把答案補上
這種現象在學術文獻裡叫做幻覺(hallucination),生成模型在沒有明確資料的情況下,會依訓練資料裡學到的模式接續內容,產生看似合理、實際上卻不對應任何真實資料的輸出,具體數字與引用來源最常出事。一份發表於《Mayo Clinic Proceedings: Digital Health》的研究,向一款生成式語言模型提出 20 個醫學問題並要求附上參考文獻,結果產生的 59 筆參考文獻裡,有 41 筆(約 69%)是編出來的,格式、作者與期刊名稱卻都煞有介事。
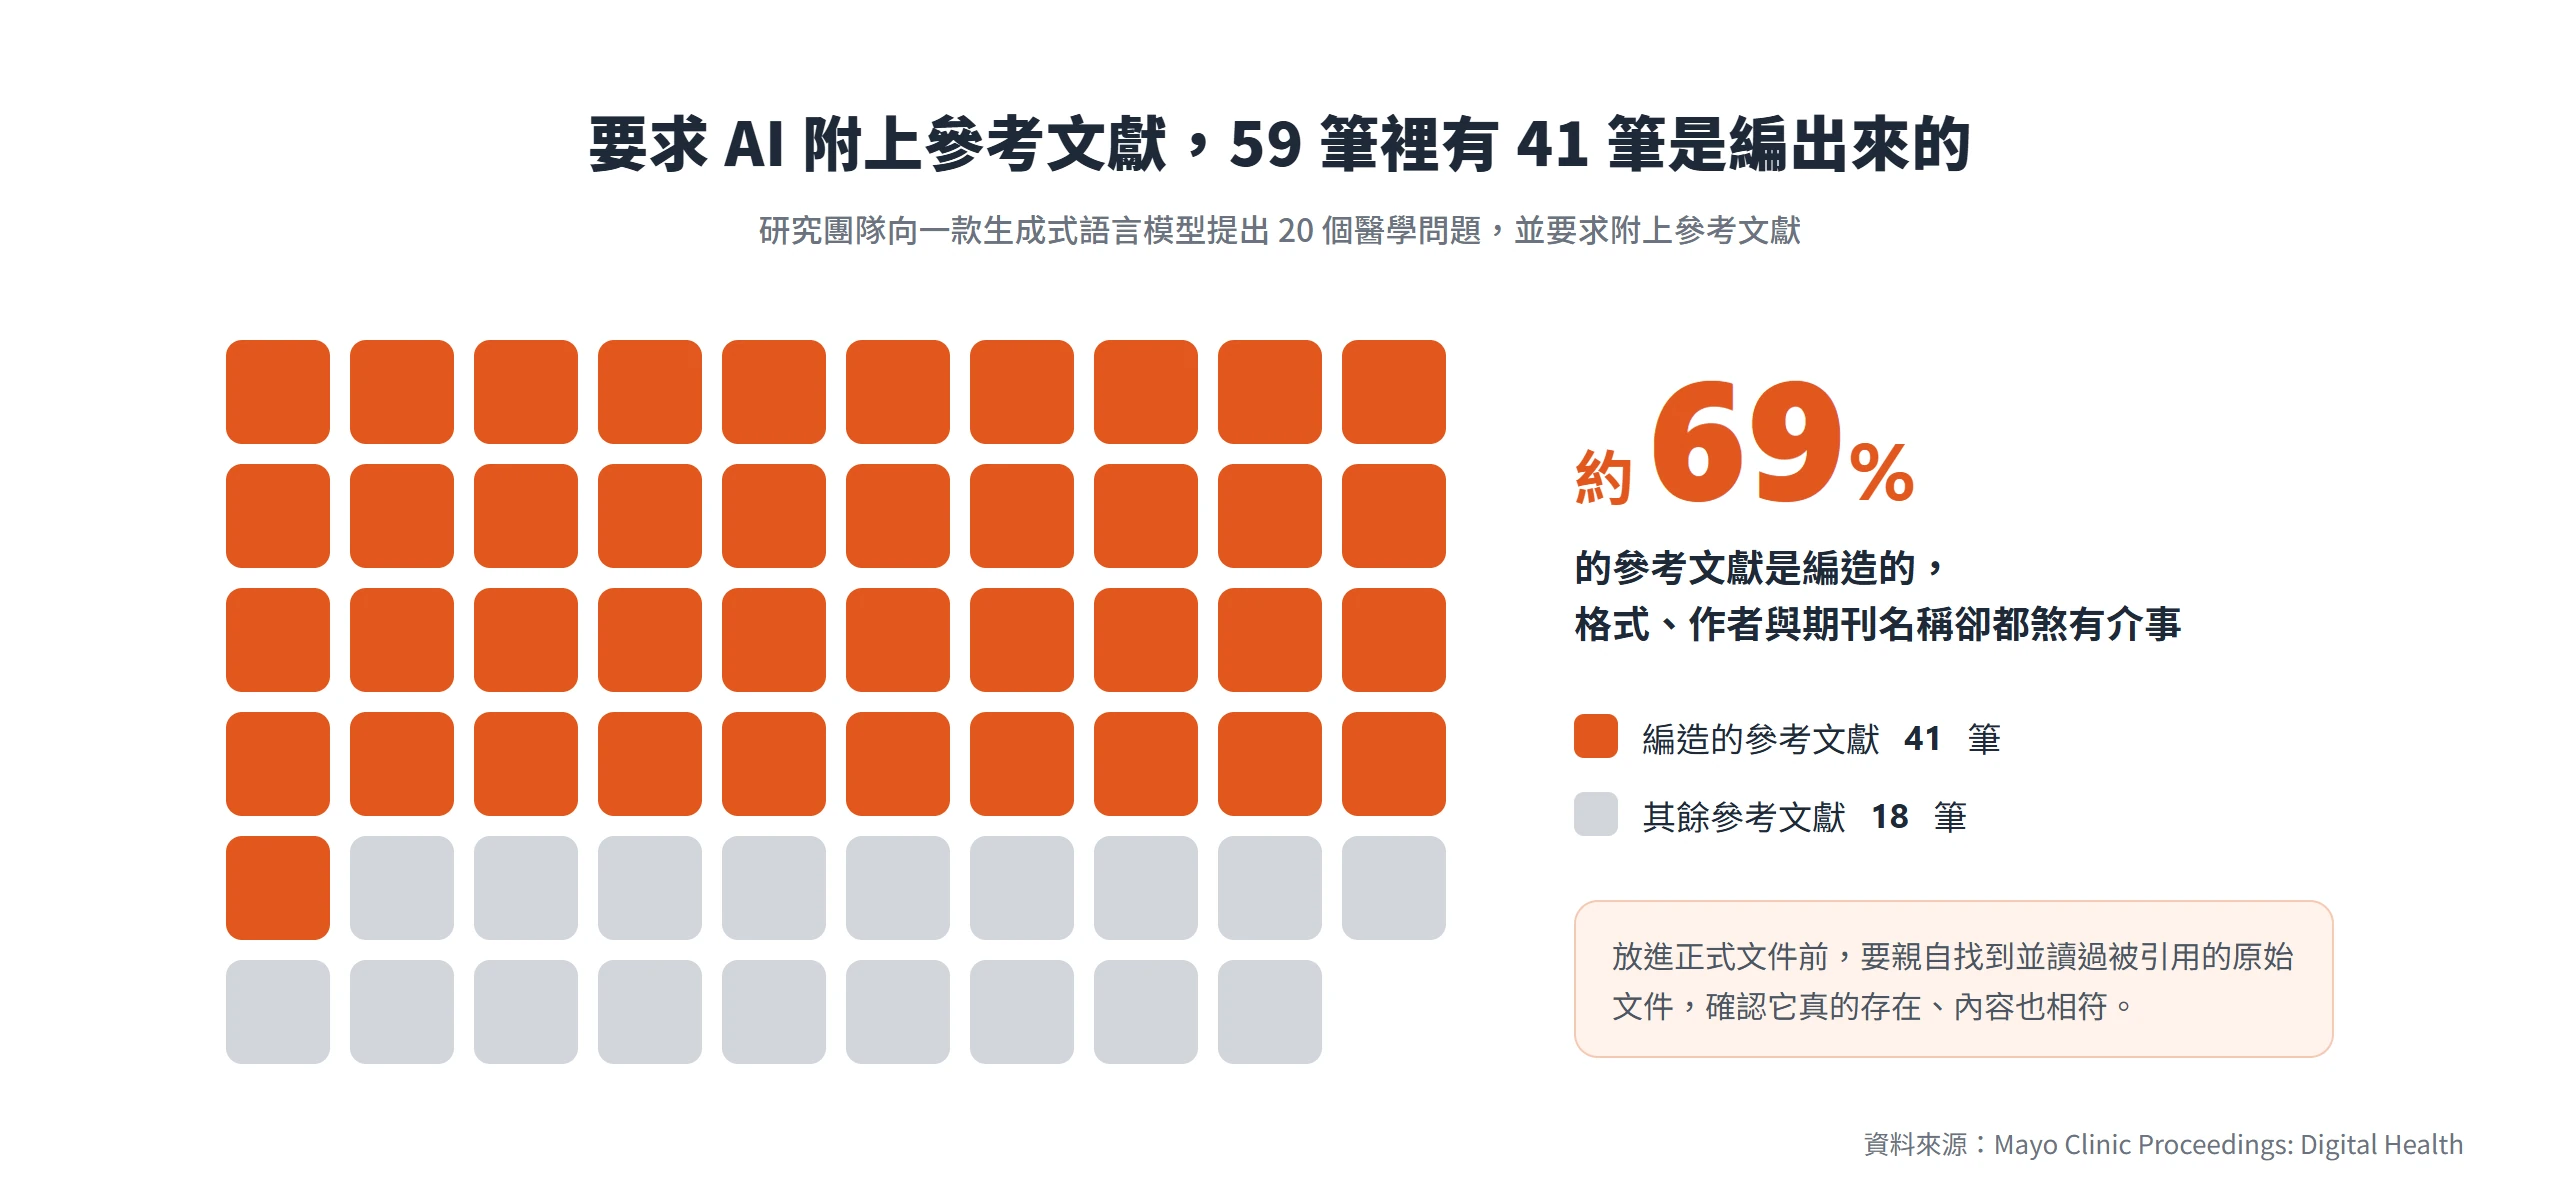
放進商品文案的情境,要核對的對象其實很明確。防水等級、續航時數、尺寸重量、保固年限、認證標章,每一項都拿去跟原廠規格表、說明書或檢驗報告逐條比對,對不上或查不到出處的就刪掉,不要讓 AI 自己補出來的數字跟著商品頁上線。多問 AI 幾次都得到同樣的答案也不算數,模型的一致性跟真實性是兩回事。
不實廣告和著作權的責任,不會因為 AI 生成而消失
規格編錯還牽涉到實際的責任歸屬。依公平交易委員會的網路廣告處理原則,刊播廣告的事業要善盡真實表示義務,廣告內容如果有引人錯誤之虞,對外要負責的是打這則廣告、發表這篇文案的品牌自己。那段文字就算出自 AI 之手,也不能拿來主張自己不用負責。AI 只是工具,最後把文案送出去、掛上品牌名稱的人,才是要對內容負責的人。
著作權是另一層要顧的事。經濟部智慧財產局說明過,只下一句指令、內容完全由 AI 生成的文字,不算著作權法保護的著作;如果使用的 AI 服務條款本來就限制商業用途,直接拿生成的文案去打廣告,也等於帶著這層限制上路。事實查核與原創性怎麼在上稿前完整走一遍,可以接著看這篇把關流程的整理。
缺乏品牌語氣的文案,換上別家名稱一樣通用
規格對了,還有第二關要過,就是語氣像不像自己家。AI 語言模型的訓練目標是產出統計上最常見、最像人話的句子,這個特性用在客服對答上表現得很好,換到需要凸顯品牌獨特性的文案上,卻是天生的弱點。愈多人用同一批模型、餵差不多的提示詞,產出的措辭自然會往同一個方向收斂。判斷的方法很直接,把文案裡的品牌名換成任何一個同業,這句話還成立嗎。
統計上最常見的措辭,正是品牌語氣的天敵
這不是憑感覺說 AI 文案讀起來都很像,而是真的有研究量測過這件事。Chaoran Liu、Tong Wang 與 S. Alex Yang 三位學者 2025 年發表的一項研究,以義大利米蘭地區的餐廳為樣本,觀察當地在 2023 年一度全面停用一款主流生成式 AI 聊天服務期間,這些餐廳的 Instagram 貼文出現什麼變化。結果發現,服務停用的那段期間,這些餐廳貼文在用字、句法結構、語意與語言風格上的相似度都出現下降,內容變得更不一樣、更有各自的特色;同一段期間,這些貼文獲得的平均按讚數也隨之上升——內容愈同質化,讀者願意按讚的意願似乎就愈低。
這個結果指向同一件事,使用生成式 AI 寫文案的時候,內容確實會出現同質化,而同質化的內容,互動表現反而比較差。這對只重視提高產出速度、卻沒回頭調整語氣的做法,是一個值得留意的訊號。
從詞彙、句長到觀點具體度的三個檢查點
要判斷一篇 AI 文案像不像自己家,不必單靠語感評分,拆成三個具體的面向來對照就好:
- 詞彙:文案裡用的形容詞、動詞,是不是這個品牌平常真的會用的字,還是任何品牌都會用的萬用詞,例如優質、專業、卓越、頂級這一類。
- 句長與節奏:AI 預設偏好中等長度、結構工整的句子,跟品牌原本說話的長短節奏對不對得上;平常習慣短句、口語化的品牌,套上工整的長句反而顯得生疏。
- 觀點具體度:文案有沒有講出只有這個品牌會這樣講的具體立場或細節,還是換一個品牌名稱,整句話照樣通順成立。
這三個面向不是憑空列出來的,剛好對應前一節那份研究拿來量測相似度的幾個維度,詞彙、句法、語意與語言風格,換句話說,同質化具體會表現在這幾個地方,檢查的順序也就從這裡下手。
品牌語氣文件和明確指令,才能把文案拉回自己的聲音
知道問題在哪之後,解法不是每次生成完再花時間修語氣,而是在下指令之前,先把這個品牌會怎麼說話講清楚。具體的用詞禁區與偏好詞、慣用的句子長短、過去寫得好的文案範例,都應該當成輸入條件先給 AI,而不是丟一句籠統的「請幫我寫一段行銷文案」就期待它自己猜到位。
同時要提醒自己一件事,AI 產出的內容該被當成素材,不是成品。最後仍然需要有人對照這段話是不是只有我們會這樣講,確認過才算定稿。這一步不能省,省了等於把品牌語氣的把關責任,整個交給一個從來沒看過品牌歷史的工具。
空泛的形容詞代替不了具體的購買理由
AI 很擅長把賣點重新排列組合成一句通順的話,卻常常停在抽象的形容詞層次,品質優異、值得信賴、CP 值高,這些話換成任何一個競品都講得出來,讀者看了沒有感覺。真正有說服力的文案,要換成具體、可驗證的說法,確切的數字、可查證的細節、明確的下一步動作。
具體證據和空泛形容詞的差別
有一個測試可以自己動手做,把 AI 寫的每一句賣點拿去問一次,如果把品牌名換成任何一個同業,這句話還成立嗎。品質優異、值得信賴放到誰身上都通,但保固 3 年、全台維修站超過 80 處,只有特定品牌講得出來。
凡是換了名字還一樣成立的句子,就代表它沒有真正的說服力,需要換成具體、可以查核的細節。這個測試的價值在於,它把很抽象的「說服力好不好」,變成一個當場就能核對的動作,不必再靠語感猜。
行動呼籲要具體到讀者知道下一步
說服力的最後一哩路是行動呼籲。AI 文案產生器最常給出「立即體驗」「馬上了解更多」這類籠統字眼,讀者看完不知道下一步具體要做什麼、要花多少時間,或者要付出什麼代價。
要判斷一句行動呼籲好不好用,方法很直接,看它有沒有具體交代按下去之後會發生什麼事。Nielsen Norman Group 的可用性研究指出,使用者會不會點擊一個連結或按鈕,取決於文字能不能讓人一眼判斷出「按下去會通往哪裡、得到什麼」;這種線索愈明確具體,使用者愈容易做決定,文字愈含糊籠統,猶豫甚至乾脆放棄的人自然變多。與其寫「立即體驗」,不如直接寫清楚下一步是免費試用 14 天,還是需要先填一張表單。
把 AI 草稿改成能上線文案的最後一步
前面兩個檢查點可以串成一個修改流程。先把每一句空泛的形容詞,替換成具體、可驗證的細節或數字;再把結尾的行動呼籲,換成讀者一看就懂下一步要做什麼的說法。這兩步做完,AI 的初稿才算真正被改成能上線的文案,而不是停留在讀起來很順的階段。
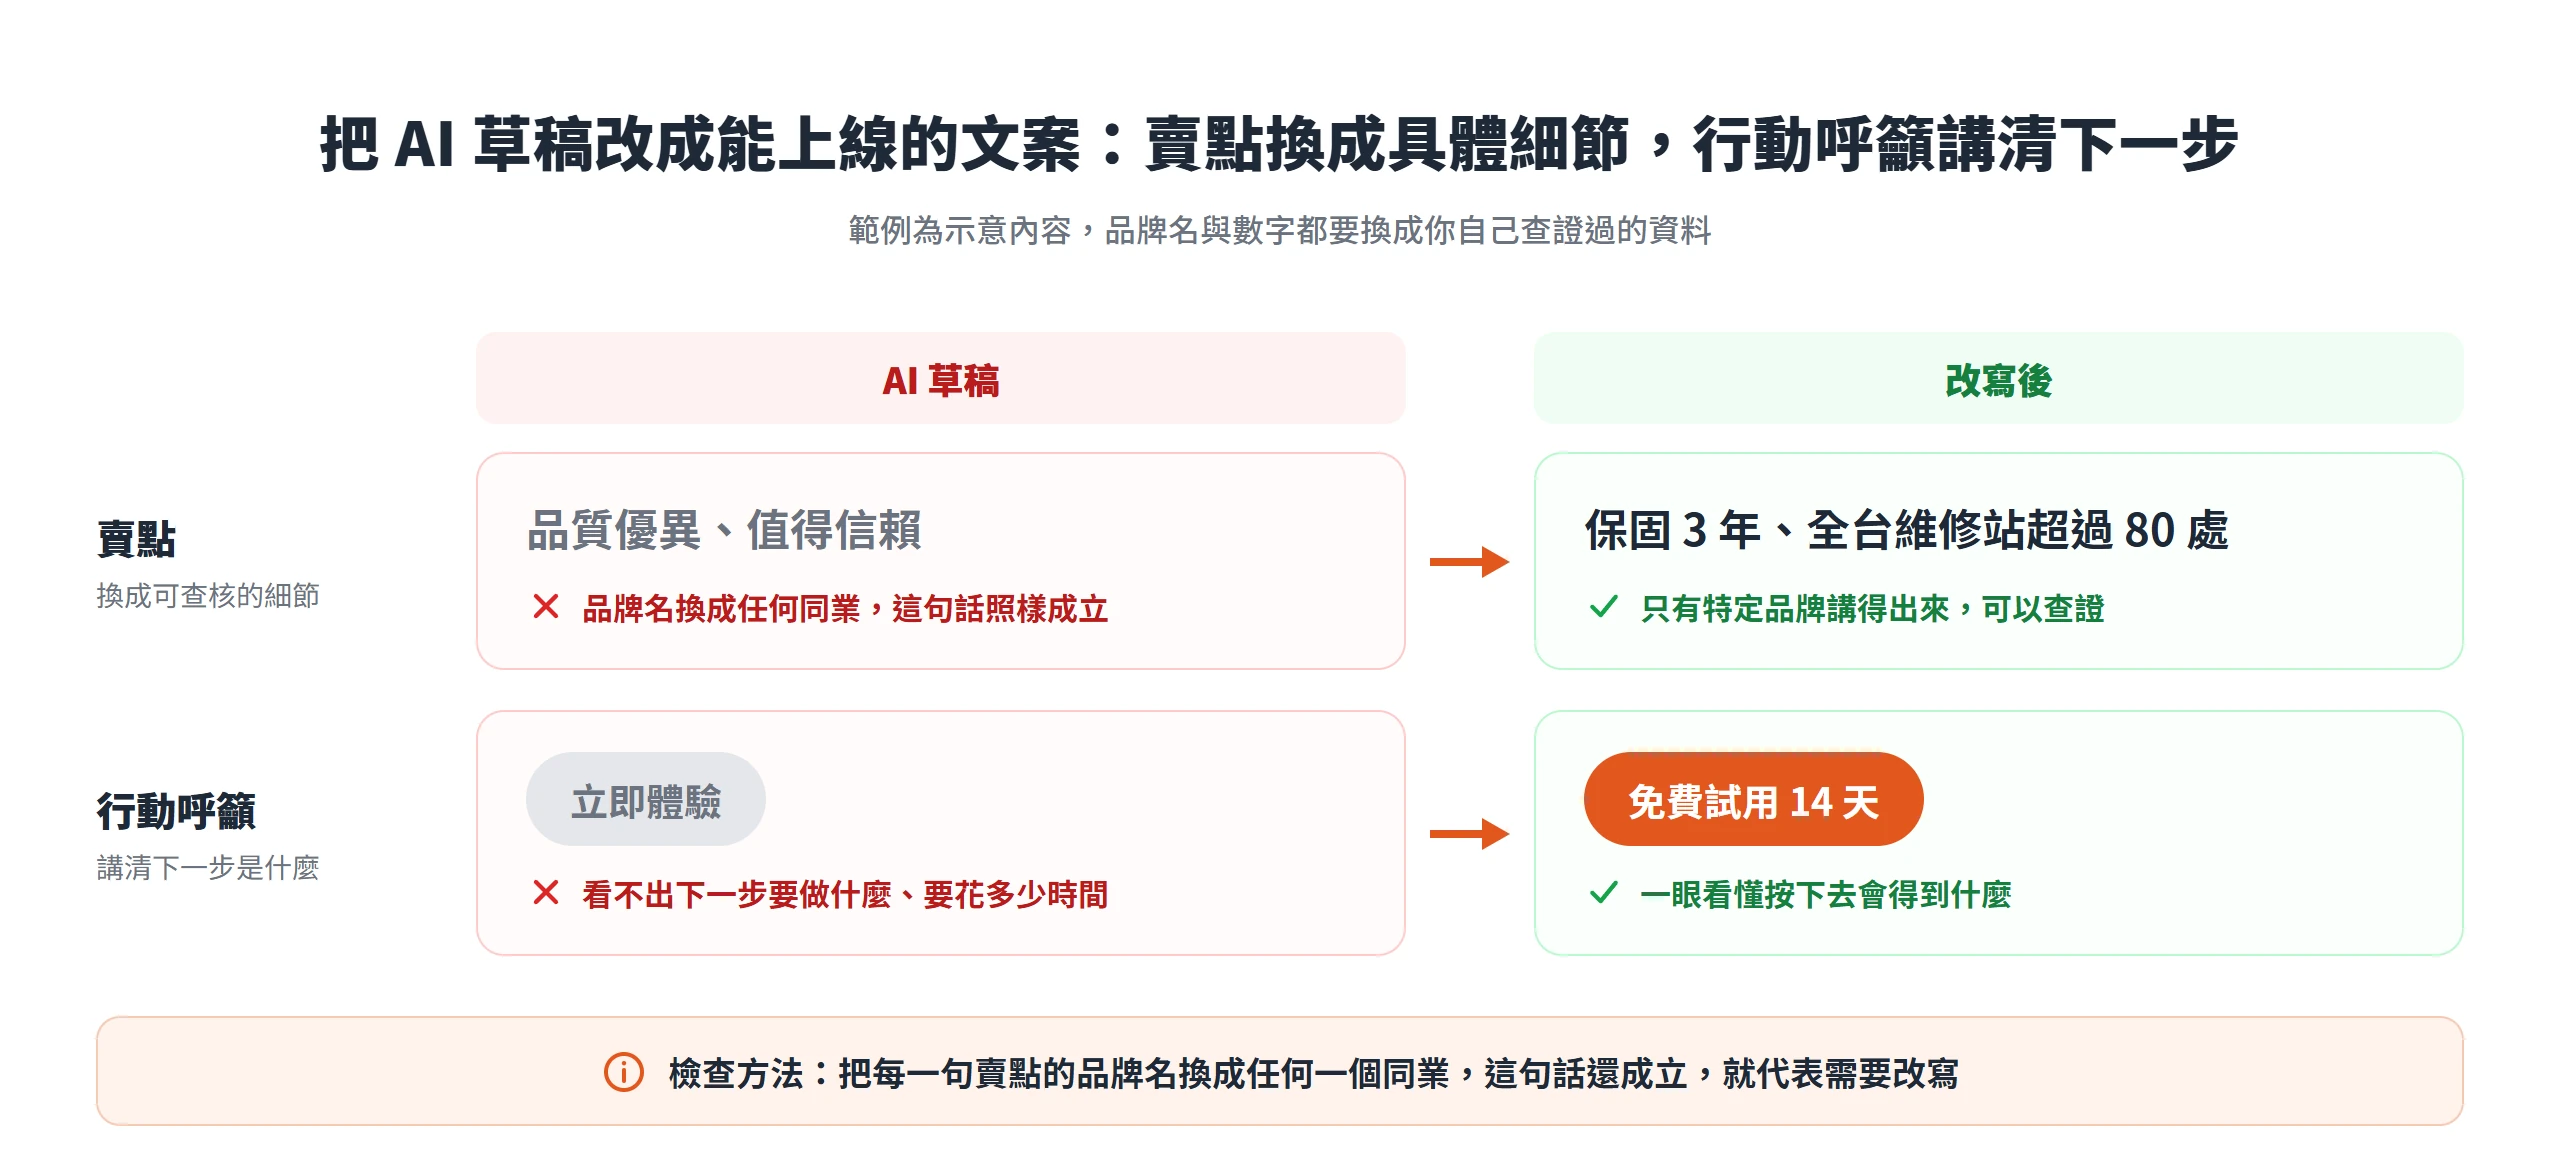
這個順序也提醒一件事,說服力是最後才處理的環節,前面規格對不對、語氣像不像自己家,都還沒確認清楚之前,先急著雕琢說服力的句子,多半是白工。
三個判斷點的檢查順序,以及人工複核的角色
這三個判斷點,該先做哪一個,其實有一個合理的順序。建議的做法是先查事實正確性,再看品牌語氣,最後才處理說服力。理由很直接,前面的問題沒解決,後面的修改就是白工,一段規格是編出來的文案,就算語氣再貼合品牌、行動呼籲寫得再具體,也不能拿去用;反過來說,內容是真的,才值得花時間去調語氣與說服力。
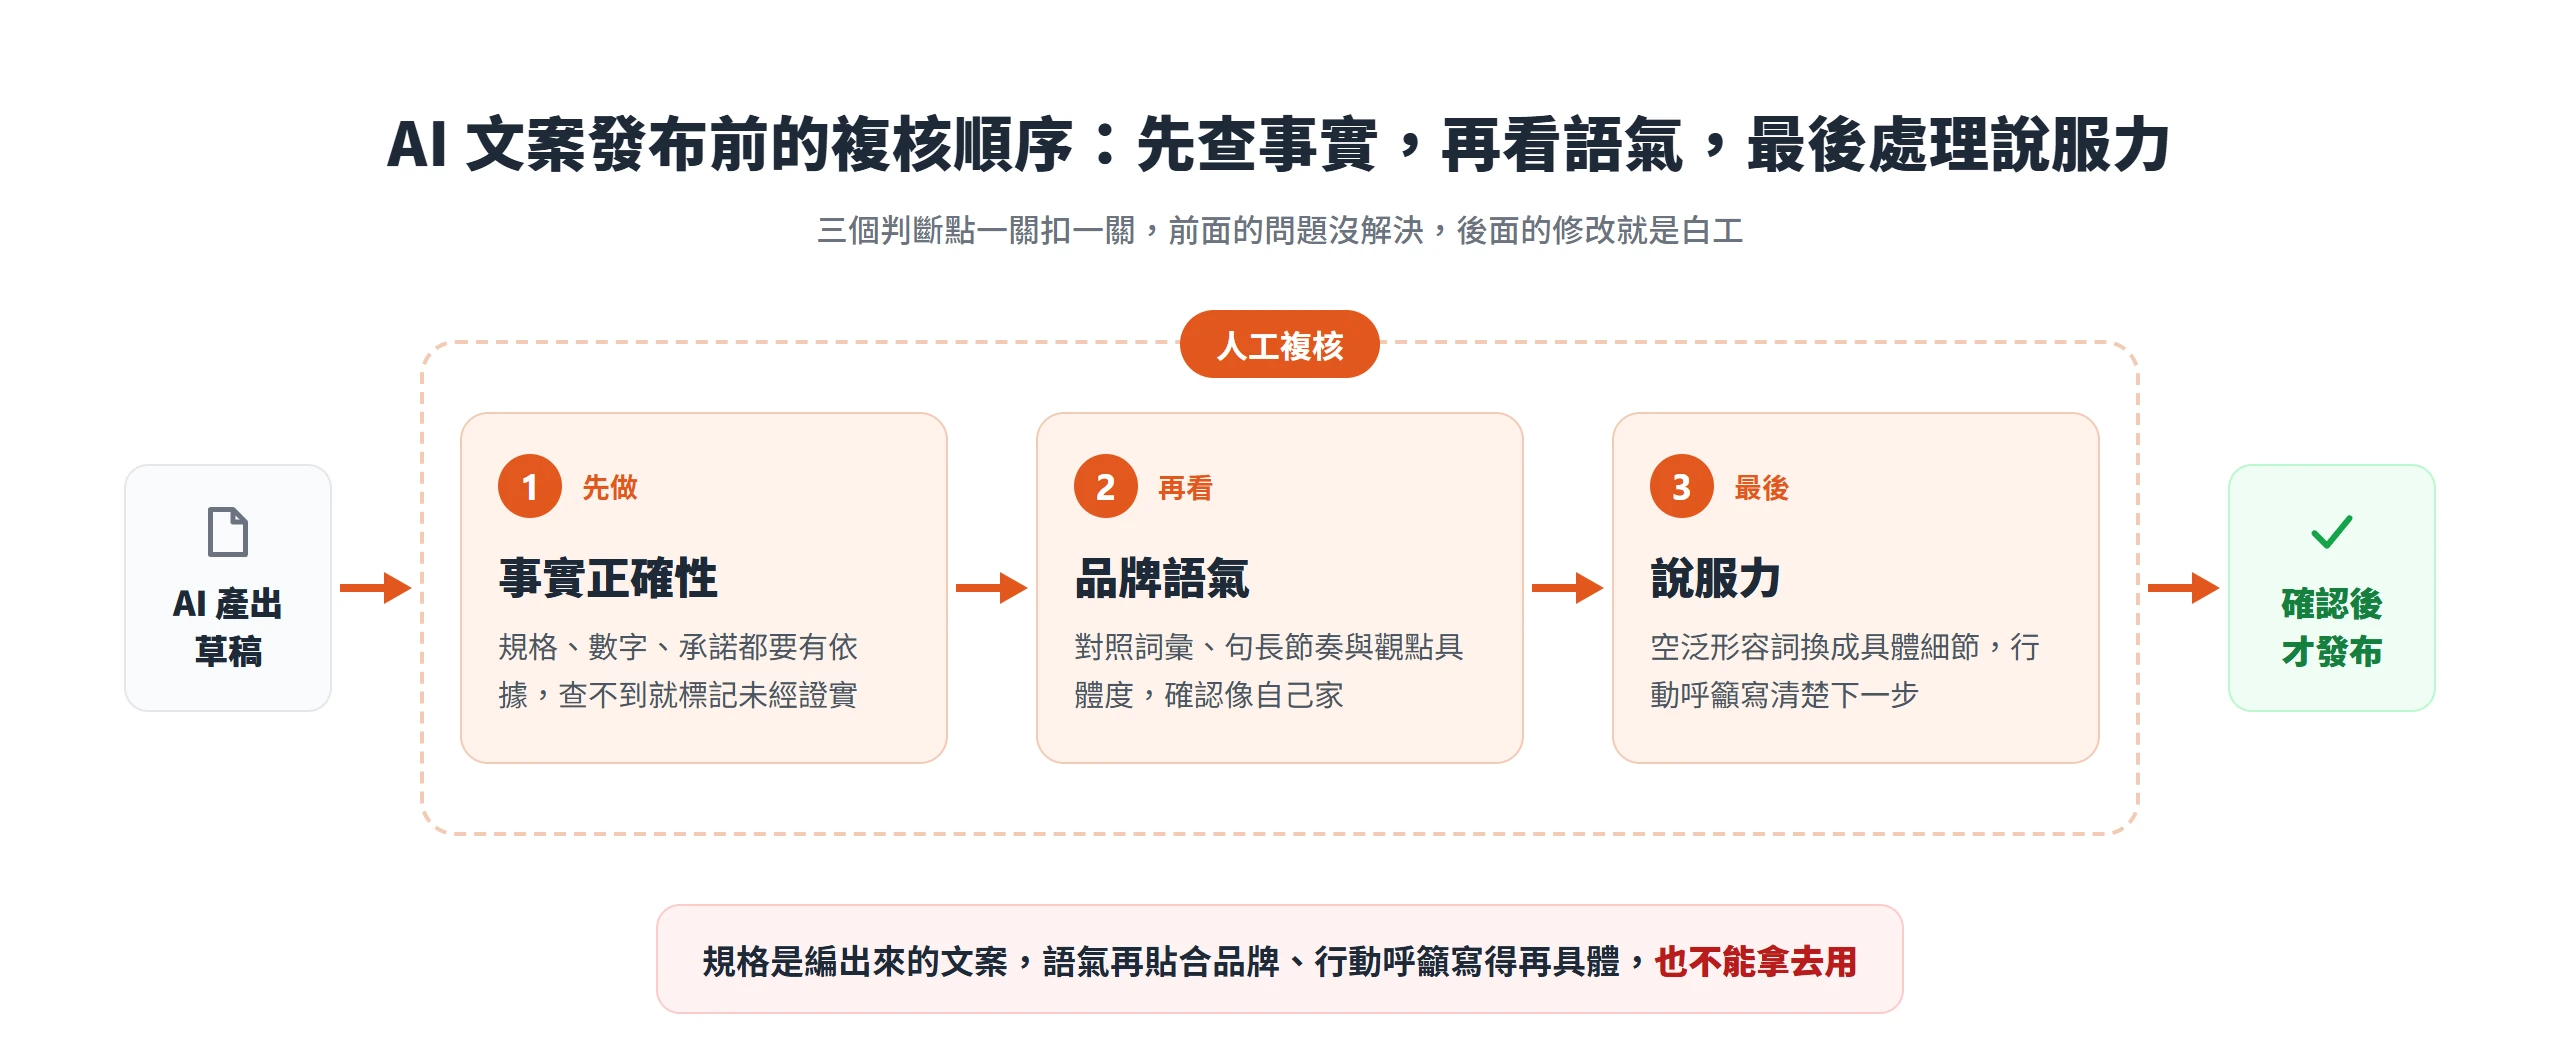
這個順序也解釋了為什麼查核不能被跳過。規格錯了,後面修再多次語氣都沒有意義;語氣沒對上,說服力寫得再好,讀者也感覺得出這不是自己家在講話。三個層次一關扣一關,前面站不住,後面做的努力就是浪費時間。
面對這整件事,容易走向兩個極端,一個是完全不敢用 AI 寫文案,怕出錯就乾脆不碰;另一個是全部丟給 AI、看過一遍順就發出去,兩種都不是真正的答案。Google 官方的立場其實講得很清楚,內容好不好,看的是有沒有幫助、可不可靠、原不原創,不是看它是不是 AI 生成的。真正該做的,是在 AI 產出草稿之後,留一道人工複核的關卡,把事實、語氣、說服力這三件事逐一確認過,才算完成。
AI 文案產生器負責把空白填滿、把草稿寫出來,這件事它做得又快又好;但草稿能不能真的代表一個品牌站上檯面,最終仍然要有人拍板。下一次看到一篇讀起來很順的 AI 文案,先別急著按下發布,多花幾分鐘核對規格、唸一次語氣、換掉那些放諸四海皆準的形容詞,這篇文案才算真正屬於這個品牌,而不是任何一家都能用的通用版本。