一張公仔照裡有透明壓克力底座、印著字的窗型包裝盒,還有桌面上柔和的打光,看上去像剛從工廠出貨的商品。但 AI公仔其實更像一場只拍照、不生產的棚拍,模型畫出的是一張商品攝影照,並沒有哪個實體公仔跟著誕生。
做法本身不難,上傳一張照片、貼上一段描述,Gemini 和 ChatGPT 都能出圖。麻煩的是描述寫得太籠統時,成品往往只是一張普通的人物插畫,沒有底座也沒有包裝,或是盒面印著一串讀不懂的亂碼。好在同一份提示詞骨架在兩個工具上都用得上,差別只在操作畫面和幾處要微調的地方。
不過在動手之前,得先弄清楚這種圖交付的是什麼,不然很容易期待它做到它做不到的事。
AI公仔是什麼?
AI公仔指的是把人物、寵物或原創角色的照片交給圖像生成模型,請它產出一張像商品攝影的公仔照。畫面裡常見的元素有透明壓克力底座、窗型包裝盒,以及擺在書桌或展示櫃上的場景。這個詞很容易讓人聯想到 3D 公仔,兩者其實是不同的東西。
最容易搞混的是成品的性質。AI 輸出的是一張 2D 圖片,不是能拿去 3D 列印的模型檔,也不是能交給工廠開模的設計稿,圖裡的公仔沒有背面資料、沒有尺寸,也沒有量產需要的結構。換句話說,它是「公仔長什麼樣子」的示意照,不是「公仔怎麼做出來」的施工圖。
常見成品大致分兩類。一類是寫實收藏型,主角是 PVC 公仔或樹脂雕像,重點在塗裝與質感;另一類是玩具包裝型,主角是掛卡泡殼的動作人偶或盲盒,重點在包裝上的版面與文字。先決定自己要哪一類,後面提示詞要著墨的地方就不一樣。
這個玩法有兩個常被提起的起點。社群上廣傳過一段 1/7 比例公仔的提示詞,場景是電腦桌,螢幕上顯示建模過程,桌邊擺著印有插畫的包裝盒;在 ChatGPT 上則常見掛卡泡殼的動作人偶風。下面的提示詞骨架,就是從這兩種畫面歸納出來的。
公仔圖提示詞由主體、材質、底座、包裝與場景拼成
公仔圖不是叫模型「做得可愛一點」,而是在描述一張商品攝影照。模型不會替人猜底座是什麼顏色、盒子長什麼樣子,沒寫到的東西,它就用最常見的樣子補上,所以提示詞要把畫面裡每樣東西都交代到。
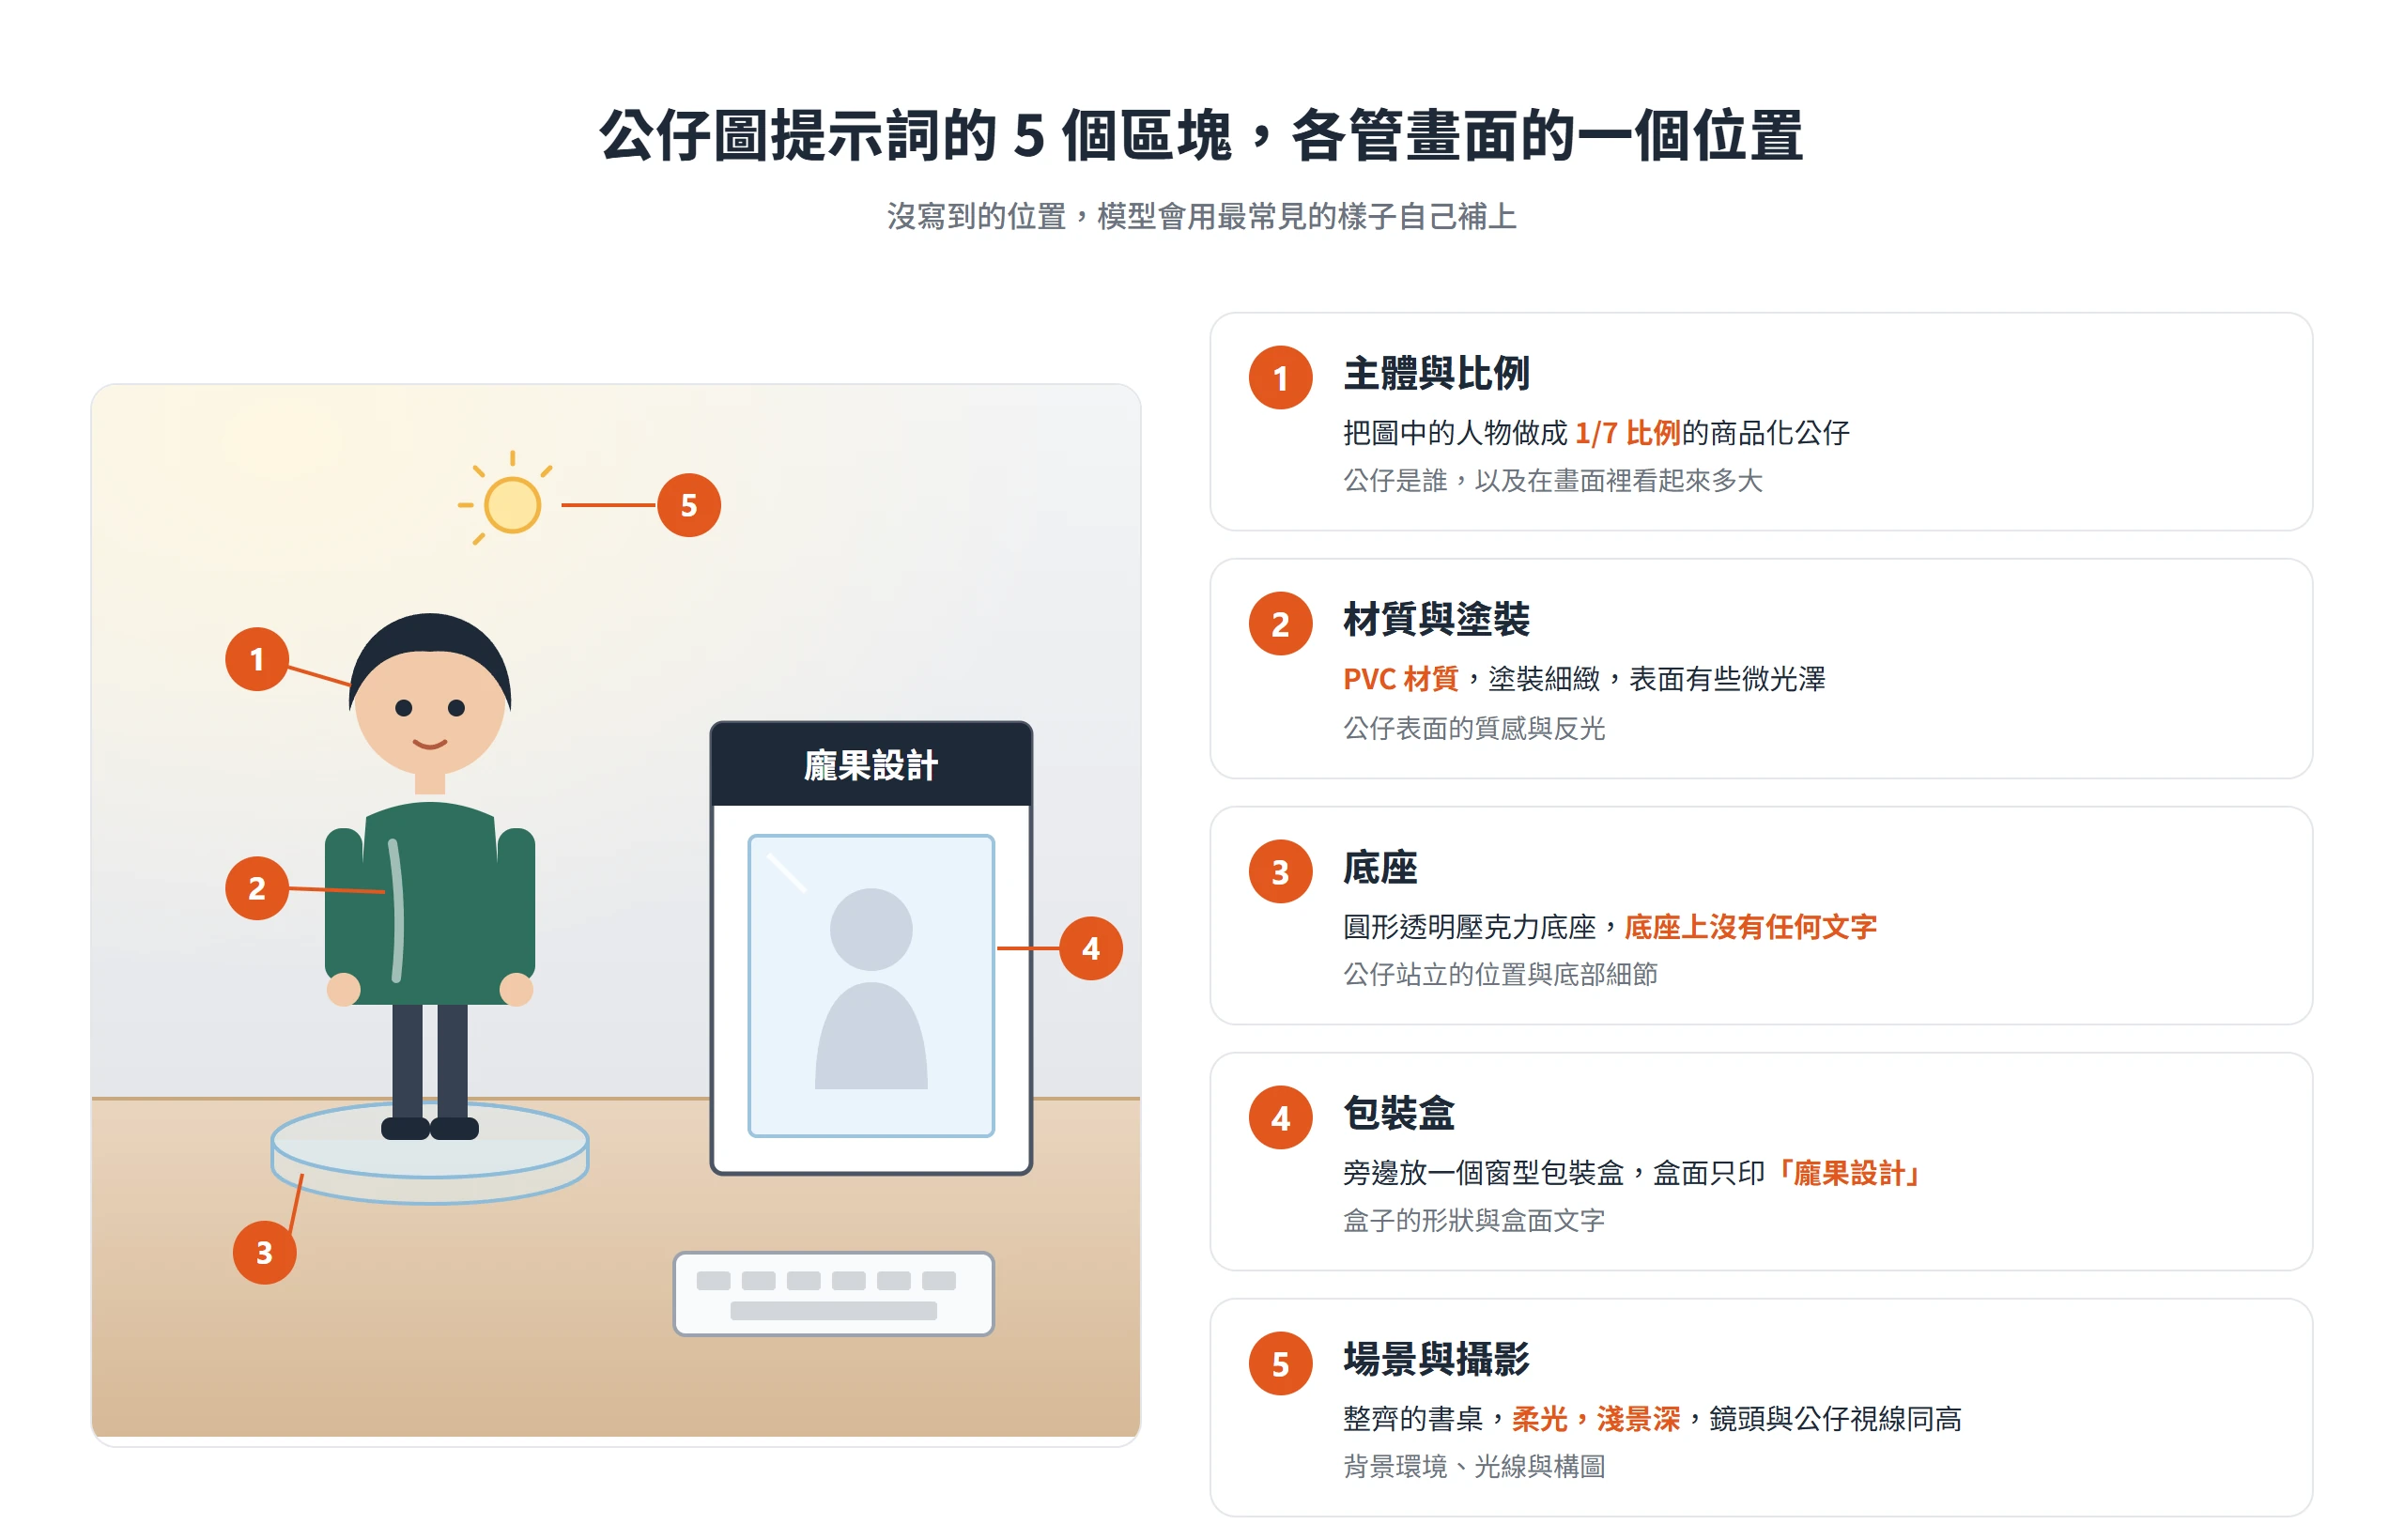
Google 的 Gemini API 文件在圖像生成的說明裡寫道,描述得越具體,越能掌控結果;範例中也常用鏡頭類型、拍攝角度這類攝影用語來控制構圖。把這個思路套到公仔圖上,提示詞可以拆成 5 個區塊,每個區塊管畫面的一個位置。
| 區塊 | 範例寫法 | 管的是畫面哪裡 |
|---|---|---|
| 主體與比例 | 把圖中的人物做成 1/7 比例的商品化公仔 | 公仔是誰,以及在畫面裡看起來多大 |
| 材質與塗裝 | PVC 材質,塗裝細緻,表面有些微光澤 | 公仔表面的質感與反光 |
| 底座 | 圓形透明壓克力底座,底座上沒有任何文字 | 公仔站立的位置與底部細節 |
| 包裝盒 | 旁邊放一個窗型包裝盒,盒面只印「龐果設計」 | 盒子的形狀與盒面文字 |
| 場景與攝影 | 整齊的書桌,柔光,淺景深,鏡頭與公仔視線同高 | 背景環境、光線與構圖 |
比例是實體公仔相對真人的縮小倍率,斜線後面的數字越小,代表公仔本身做得越大。材質則影響反光,PVC 偏亮面、樹脂偏霧面,一句話就能讓整張圖的質感往不同方向走。底座和包裝盒是這類圖最有辨識度的兩個道具,沒有它們,成品很容易退回一般的人物插畫。
下面是一份可以直接複製的完整中文提示詞,後面兩個工具的章節都用這一份。「圖中的人物」是可以替換的部分,換成寵物或原創角色也成立。
請以 1/7 比例,把圖中的人物製作成商品化公仔,寫實風格。公仔採用 PVC 材質,臉型、髮型與服裝完全依照原圖,塗裝細緻,表面有些微光澤。公仔站在圓形透明壓克力底座上,底座上沒有任何文字。場景是一張整齊的書桌,公仔旁邊放著一個窗型包裝盒,盒面印有人物的插畫與「龐果設計」四個字,盒面文字只有這四個字。桌面上只有公仔、鍵盤與包裝盒。以攝影棚柔光拍攝,淺景深,焦點在公仔的臉,鏡頭與公仔視線同高。Code language: plaintext (plaintext)盒面要出現的字,請用引號框起來並且越短越好,字越多,出錯的機率越高。提示詞用繁體中文寫就可以;如果覺得盒面字或細節不如預期,可以換成英文版,用同一張照片再出一次對照。
之後想局部修改時,可以沿用「改哪一項、其餘維持不變」的寫法,這個做法在兩個工具上都適用。
原圖符合 4 個條件,公仔才會像本人
模型是拿上傳的照片當外貌依據。照片糊、臉被遮、背景雜,模型就得自己猜,猜錯的地方就是成品走樣的地方,所以進到工具之前,先把素材備好比事後追問省力得多。
適合的照片有 4 個條件:畫面裡只有一個人、臉部正面而且清楚、光線均勻、背景單純。側臉、戴墨鏡、臉被頭髮蓋住,或是多人合照,模型很難判斷哪一張臉才是要做成公仔的那一個。
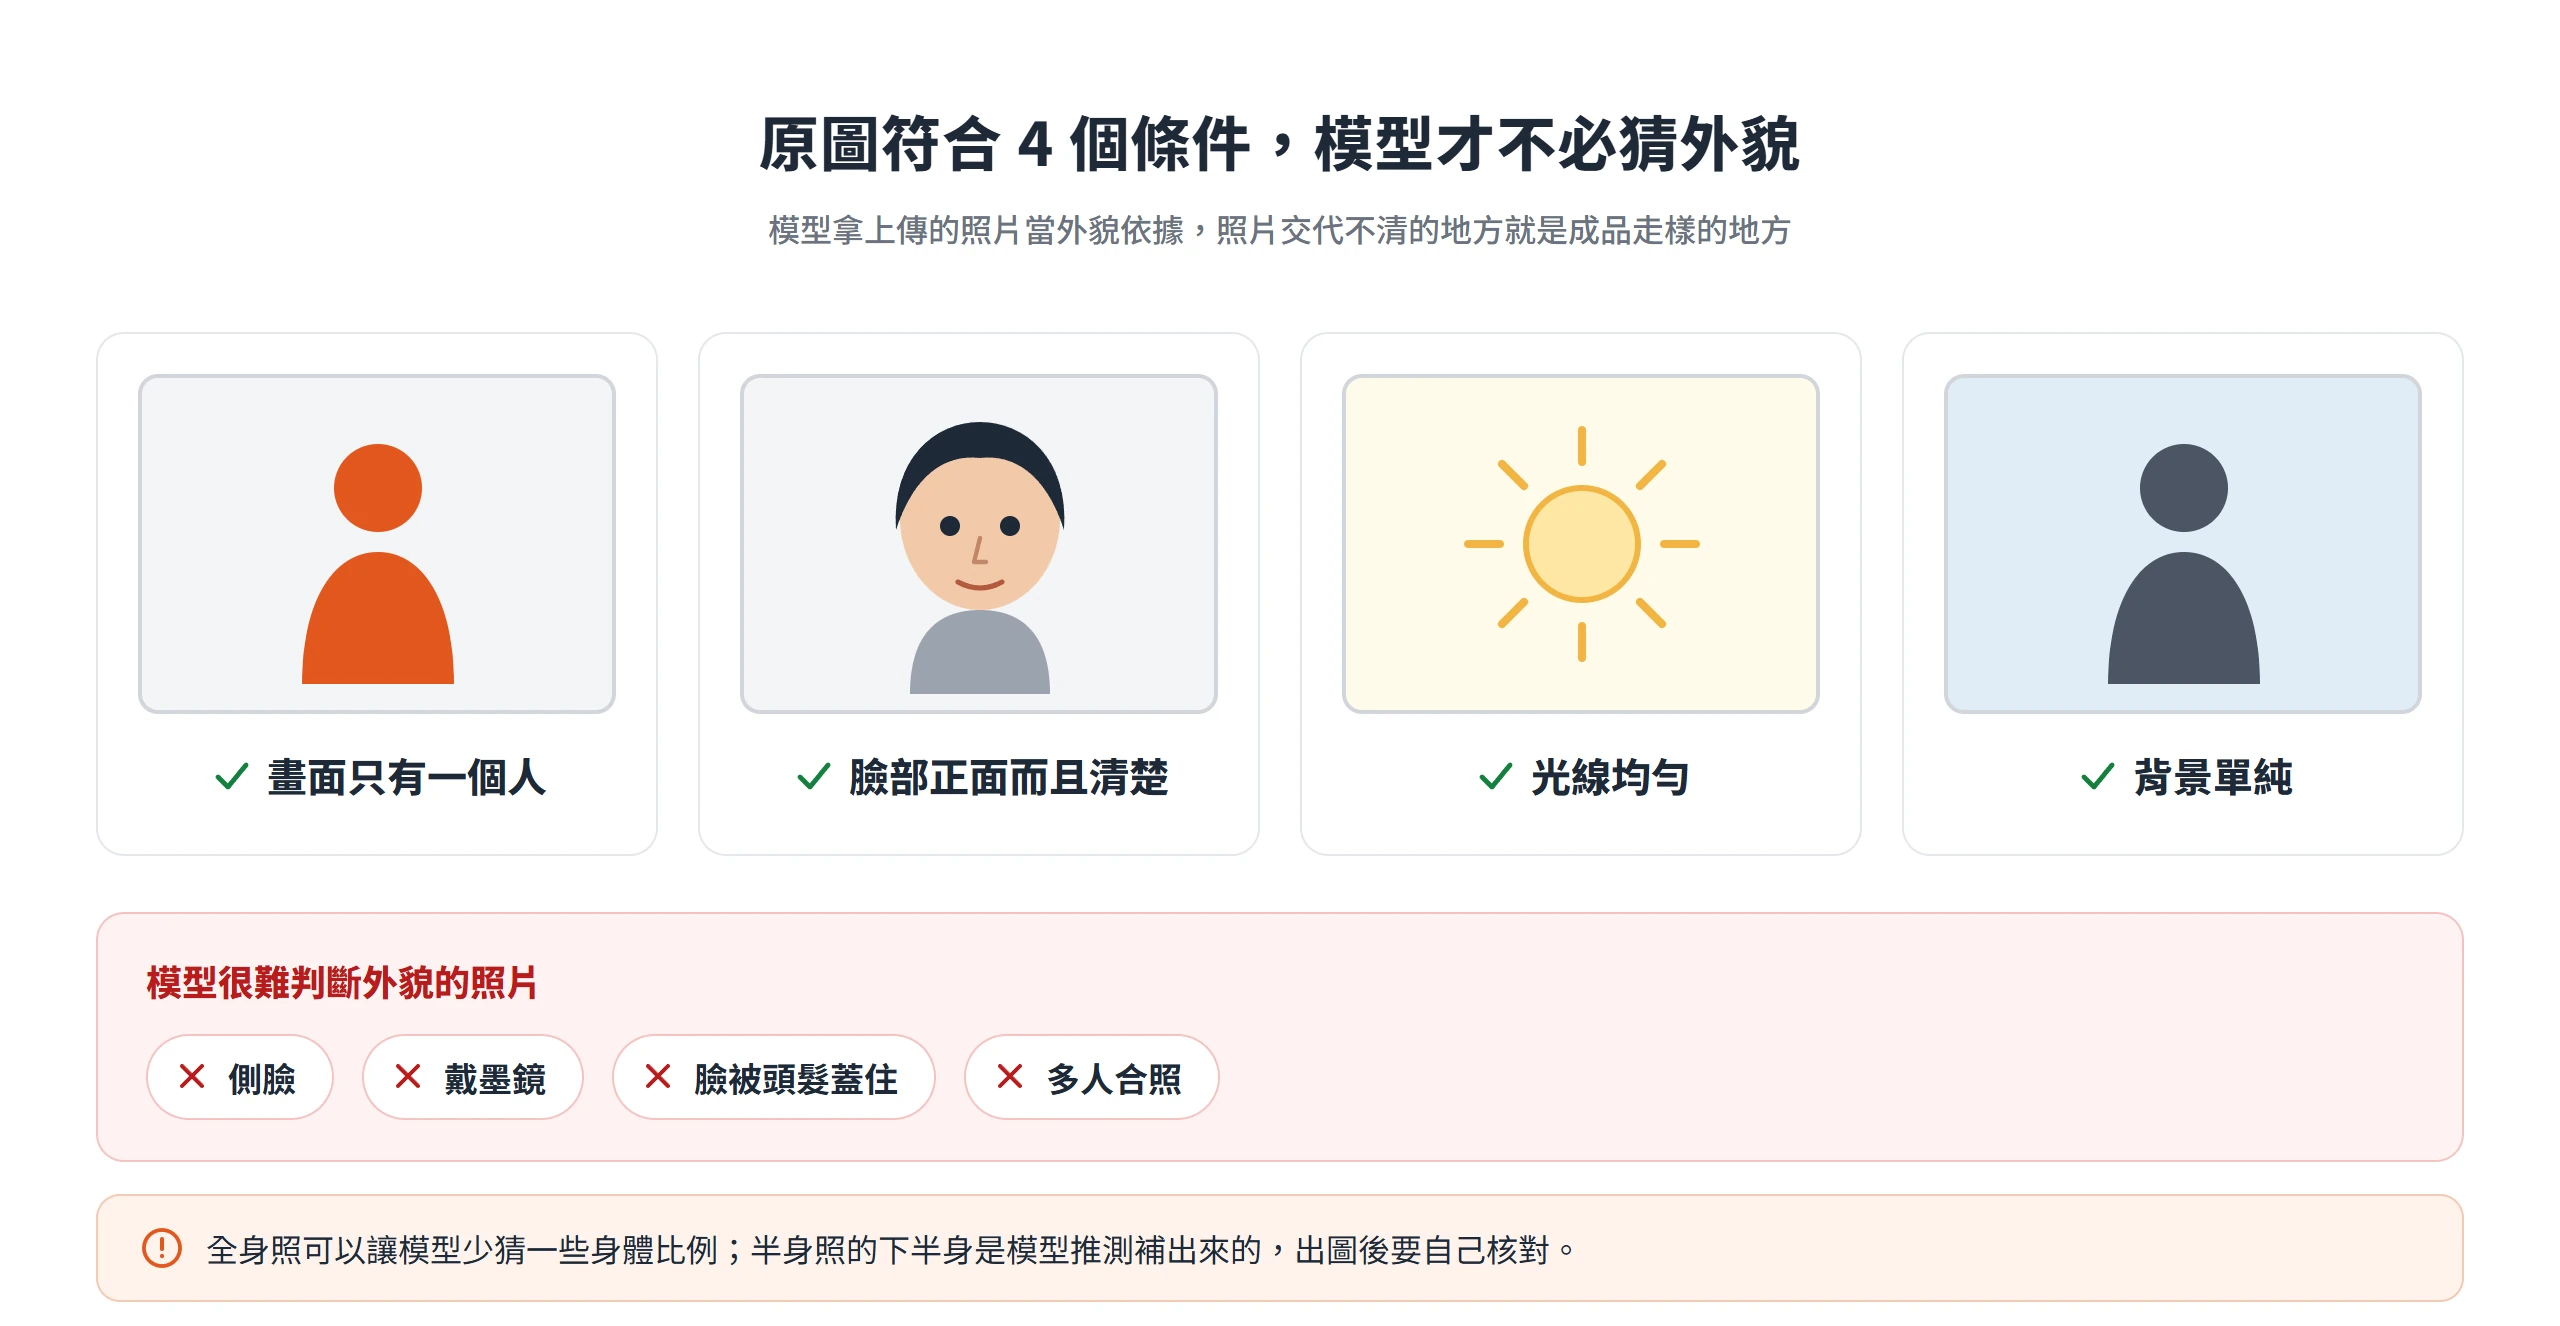
全身照可以讓模型少猜一些身體比例;半身照也能做,只是腿部和下半身是模型推測補出來的,不一定符合本人,出圖後要自己核對。想指定特定的服裝或配件,可以另外再給一張參考圖,說明哪些要沿用。Google 的 Gemini API 文件寫明,一次最多可以混合 14 張參考圖,不同模型對物件與角色參考圖各有上限,App 內實際能上傳幾張,以介面顯示為準。
寵物和原創角色同樣適用,而且最沒有肖像上的顧慮。不過不論是哪一種,照片本身都要是自己有權使用的。
在 Gemini 把照片轉成公仔圖
Gemini 這條路徑要先確認的是帳號條件與入口。同一份提示詞放進去,第一張成品很少一次到位,細節要靠檢查和追問補齊,所以多數功夫花在出圖之後。
圖像功能入口與免費、付費帳號的差別
以電腦版網頁為例,在左上角展開側邊欄,選擇其中的 Images,就進入圖像功能。把照片上傳到對話框,貼上前面那份提示詞送出即可;各方案實際使用哪個圖像模型,以 App 裡看到的選項為準。
帳號有幾個前提要先知道。Google 的說明頁寫明,個人帳號生成圖片要滿 13 歲(或所在國家規定的年齡),編輯圖片則不開放給未滿 18 歲的使用者;上傳照片請 Gemini 改成公仔,屬於編輯的範圍,帳號年齡不符時就無法使用。生成與編輯圖片也會用掉使用額度,Google 的用量說明寫明,Gemini Apps 依運算量計算用量,每 5 小時刷新一次、另有每週上限,圖片這類多媒體請求耗用得比一般對話多;額度依方案不同,也可能不經通知調整,剩下多少可以在 App 的設定裡查看。
下載解析度也會影響公仔圖。說明頁寫明,有 Google AI 方案的帳號可以下載 2K 解析度,沒有方案則是 1K。盒面的小字在 1K 下比較容易糊。
付費訂閱者還可以在圖片右下角的 More 選單選擇 Redo with Pro,改用 Nano Banana Pro 重做同一張圖。說明頁提到,Pro 在需要呈現文字的圖上能補出更多細節;不過這個選項同樣受額度限制,Nano Banana 2 的圖片額度用完之後,就不能再用 Pro 重做。另外,Gemini API 文件寫明,所有生成的圖片都帶有 SynthID 浮水印。
貼上提示詞後先檢查臉、底座與盒面文字
送出提示詞、拿到第一張成品後,第一眼先檢查 3 件事:
- 臉像不像原圖,特別是髮型、五官位置和膚色。
- 底座上有沒有多出文字,提示詞已經要求「沒有任何文字」,一旦出現就是要追問修正的訊號。
- 盒面的字有沒有錯,要逐字對照,而不是掃一眼就放行。
這 3 個位置是公仔圖最常出問題的地方。比對時把成品和原圖並排放著看,比單看成品容易發現走樣。
Google DeepMind 為 Nano Banana 2.1 公布的模型卡,列出了已知限制:小字、長段落的文字呈現不佳,在 1K 解析度下常常模糊;輸入圖片與輸出圖片之間的角色一致性也不一定完美。換句話說,臉有一點走樣、盒面小字糊掉,本來就是可預期的狀況,不代表提示詞寫壞了。
用追問一輪一輪微調,不整段重寫
結果大致對了、只差幾處細節的時候,不必把整份提示詞重寫,用追問改局部就好,而且一次只動一個項目。Google 的 Gemini API 文件也寫明,多輪對話是迭代調整圖片的建議做法。同一次對話裡,Gemini 看得到前面出過的圖,所以追問時只要講清楚這一輪要改什麼即可。
下面是 4 句追問範例,每一句只動一個地方:
把底座改成黑色圓形壓克力,其餘維持不變。Code language: plaintext (plaintext)盒面的文字改成「王小明」,字體清楚,其餘維持不變。Code language: plaintext (plaintext)把場景換成木質展示櫃的中層,公仔與包裝盒維持不變。Code language: plaintext (plaintext)打光改成從左前方照過來的柔光,公仔與場景維持不變。Code language: plaintext (plaintext)每一輪都要重申「其餘維持不變」,因為上一輪講過的不變範圍不會自動延續。如果某一輪改壞了,不要在壞掉的那張圖上繼續疊加,回到上一張滿意的版本,換個說法重新追問,通常比越改越亂省事。
在 ChatGPT 用同一份提示詞出圖
把前面那份提示詞原封不動搬到 ChatGPT,就是這條路徑的起點,畫面描述的順序和內容都不用重寫。操作上沒有太多門檻,需要留意的是幾個寫法習慣,以及真人照片可能被拒絕的情況。
上傳照片與貼上提示詞的操作
打開 ChatGPT 的對話框,點輸入框旁邊的上傳(+)按鈕,選擇準備好的照片,再把提示詞貼進輸入框送出。這裡不用自己選圖像模型,系統會套用目前提供的圖像生成功能。如果 ChatGPT 先回問問題,或只回了一段文字描述,補一句「請直接生成圖片」就可以。
免費帳號和付費帳號能使用的圖像功能與生成張數並不相同,具體數字會隨時間調整,以介面上的提示為準。
OpenAI 為 ChatGPT Images 2.5 公布的系統卡說明,生成的圖片會帶有 C2PA 中繼資料,並加上隱形浮水印。
增改提示詞要守住的 2 個寫法和真人照片被拒的處理
提示詞搬到 ChatGPT 之後,自己再增改內容時,有 2 個寫法要守住。一是盒面要出現的字用引號框起來,並限制在短詞;二是一次只講一種包裝形式,不要同時要求窗型盒又要掛卡泡殼。另外,使用真人照片時,要預期請求可能被拒絕。
OpenAI 在系統卡裡指出,模型的寫實度提高後,在沒有防護的情況下可能產出更逼真的深偽圖片,包括真人的政治、性或其他敏感圖像,這類圖片違反使用政策,因此在文字提示與圖片兩個層面都設有檢查。
所以被拒絕不一定是提示詞寫壞了。遇到這種情況,改用自己的照片,或換成原創角色、寵物就好,不要用換個說法的方式硬繞。
直接在圖片上標註要改的位置
ChatGPT 的圖片編輯器有選取工具,可以直接在圖片上框出要局部修改的範圍;OpenAI 推出 ChatGPT Images 2.5 時也說明,現在可以直接在圖片上留言,做更聚焦的修改。要改的只是底座或盒面上的一小塊時,直接框選,就不必再用一長串文字描述「底座的左下角」「盒面第二行」這類位置。
標註之後仍然要補一句文字,寫明這個位置要改成什麼,不然模型只知道這裡要動,不知道往哪個方向動。OpenAI 的說明頁也提醒,選取的範圍不一定精準,修改可能延伸到選取範圍以外,所以改完之後,記得把沒有被標註的地方逐項再看一遍,確認臉、底座、盒面和場景沒有被一起改掉。
4 種公仔風格只要替換幾個描述詞
骨架不變,只要換掉風格相關的詞,就能做出不同的公仔。成品形式大致分成 4 種,每種只需要改幾個詞,寫法在兩個工具上通用。
這些範例的盒面文字一律用「龐果設計」「王小明」這類虛構名稱,提示詞裡也不寫既有玩具品牌或角色名,以免成品出現酷似既有商品的標誌。
寫實收藏型 PVC 公仔
換詞的重點有 3 個。比例:1/7、1/6、1/4 都是常見寫法,換一個比例,公仔在畫面裡的份量就跟著變。材質:PVC 偏亮面、樹脂偏霧面,會直接改變反光。塗裝:細緻的漸層、衣服的皺褶,可以明確寫出來,不然模型常常只給出單色的平塗。
場景也可以從電腦桌換成展示櫃或書架,底座則維持透明壓克力或換成深色方座,這樣同一份骨架就能出好幾種收藏風格。
請把圖中的人物做成 1/6 比例的寫實收藏公仔,樹脂材質,表面是霧面塗裝,衣服的皺褶與配件細節清楚。公仔站在方形黑色底座上,底座沒有任何文字,放在木質展示櫃的中層,櫃內有暖白色燈條。臉型、髮型與服裝維持圖中人物不變。Code language: plaintext (plaintext)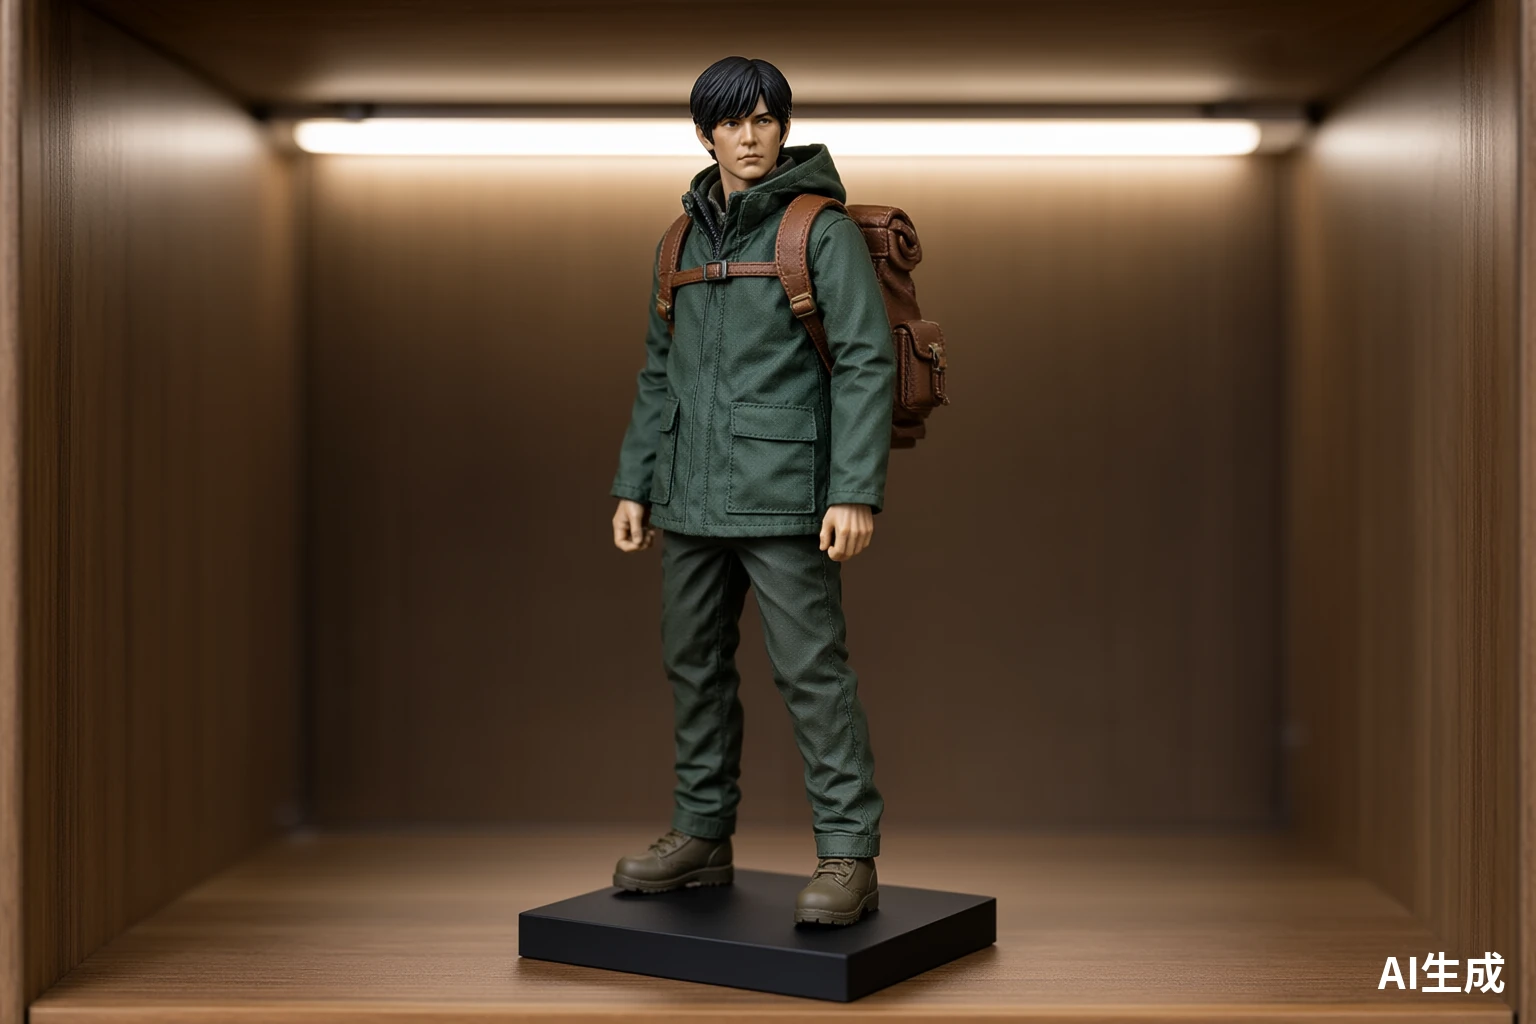
掛卡泡殼包裝的動作人偶
這一型的重點在包裝,要換的詞有包裝形式(掛卡、泡殼)、卡片頂端的文字、卡片底色,以及配件區。配件區可以列出配件清單,例如行李箱、小狗公仔、耳機,再加上標示「Accessories」。
包裝上的文字多,出錯的機率也跟著變高,所以先限制字數,卡片頂端只放一個短名稱,配件標示只放一個英文單字,其餘位置不放字。
請把圖中的人物做成掛卡泡殼包裝的動作人偶。卡片底色是深藍色,頂端只寫「龐果設計」四個字,下方是透明泡殼,人偶放在中央,旁邊有 3 件配件:行李箱、小狗公仔與耳機,配件區標示「Accessories」。卡片上的文字只有這兩處。Code language: plaintext (plaintext)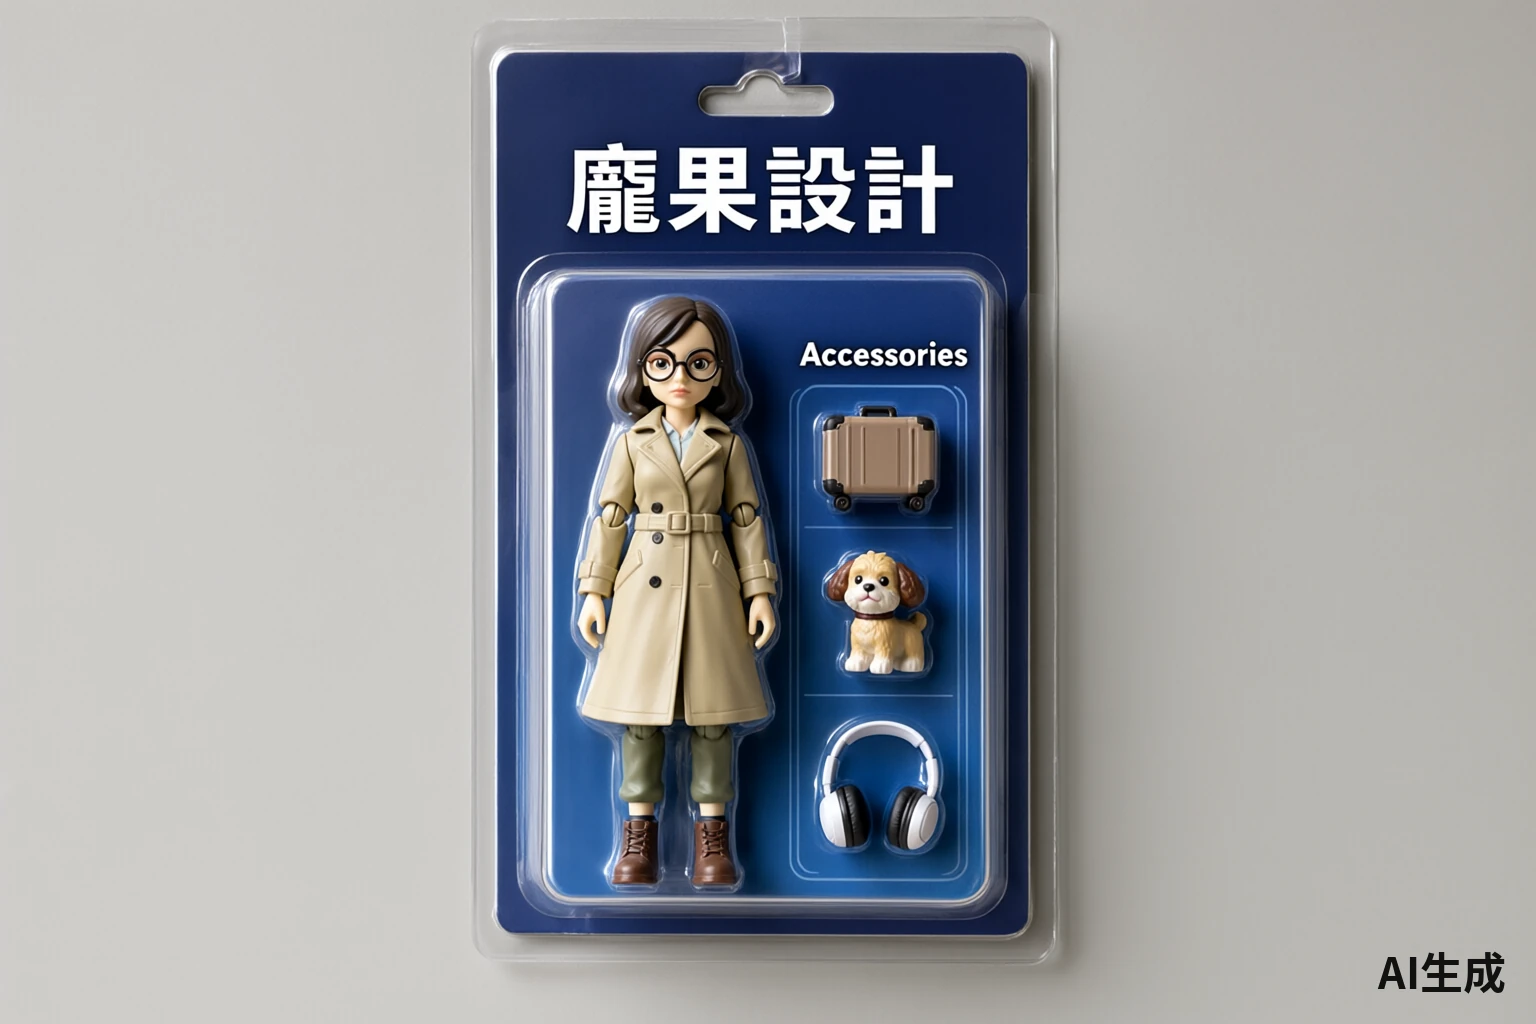
Q 版盲盒與黏土質感玩偶
這一型要換的是頭身比、材質和包裝。Q 版的特徵是頭很大,比例可以直接寫成 2 頭身或 3 頭身,也就是身高只有頭部的 2 到 3 倍;材質寫軟陶或黏土質感,表面會多出一點手作的指痕與霧面;包裝則是透明盲盒盒身,背景用單色,畫面會乾淨很多。
提示詞不要借用既有的黏土公仔產品名,改用「黏土質感」「軟陶材質」這類描述質感的說法,同樣能描述出想要的質感。
請把圖中的人物做成 Q 版盲盒公仔,約 2 頭身,頭部明顯偏大,材質是柔軟的軟陶質感,表面有細微的指痕。公仔放在透明盲盒盒身裡,背景是單色的淺粉色,盒身下方只印「王小明」三個字。Code language: plaintext (plaintext)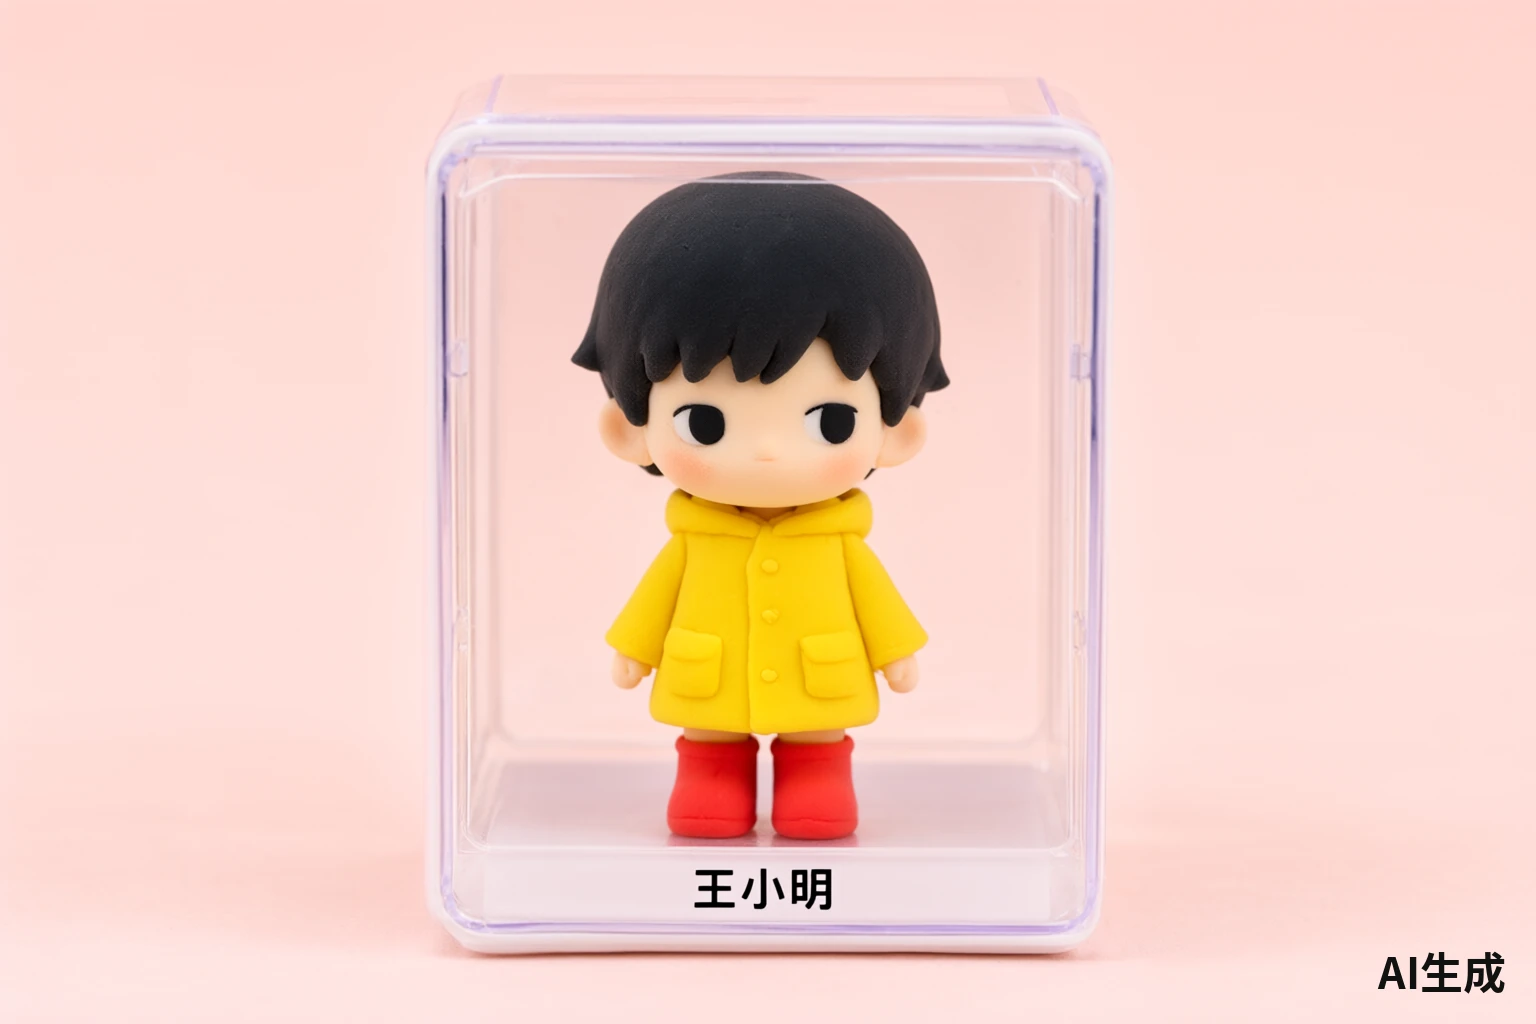
寵物與原創角色公仔
寵物和自家吉祥物,是最沒有肖像顧慮、也最適合設計師與品牌拿來做周邊提案的題材。重點在於把外型特徵列出來:毛色、配色、標誌性的配件,因為模型要從照片或角色圖上抓特徵,列得越清楚,抓錯的機率越低。
有些特徵只靠照片很難抓得準,像左耳的缺角、鼻頭的顏色,寫進提示詞等於替模型再確認一次。
請把圖中的貓咪做成寫實收藏公仔,橘白相間的毛色,鼻頭是粉紅色,左耳有一小塊缺角,脖子上戴著藍色鈴鐺項圈。公仔站在圓形透明壓克力底座上,底座沒有任何文字,旁邊是窗型包裝盒,盒面只印「龐果設計」四個字。Code language: plaintext (plaintext)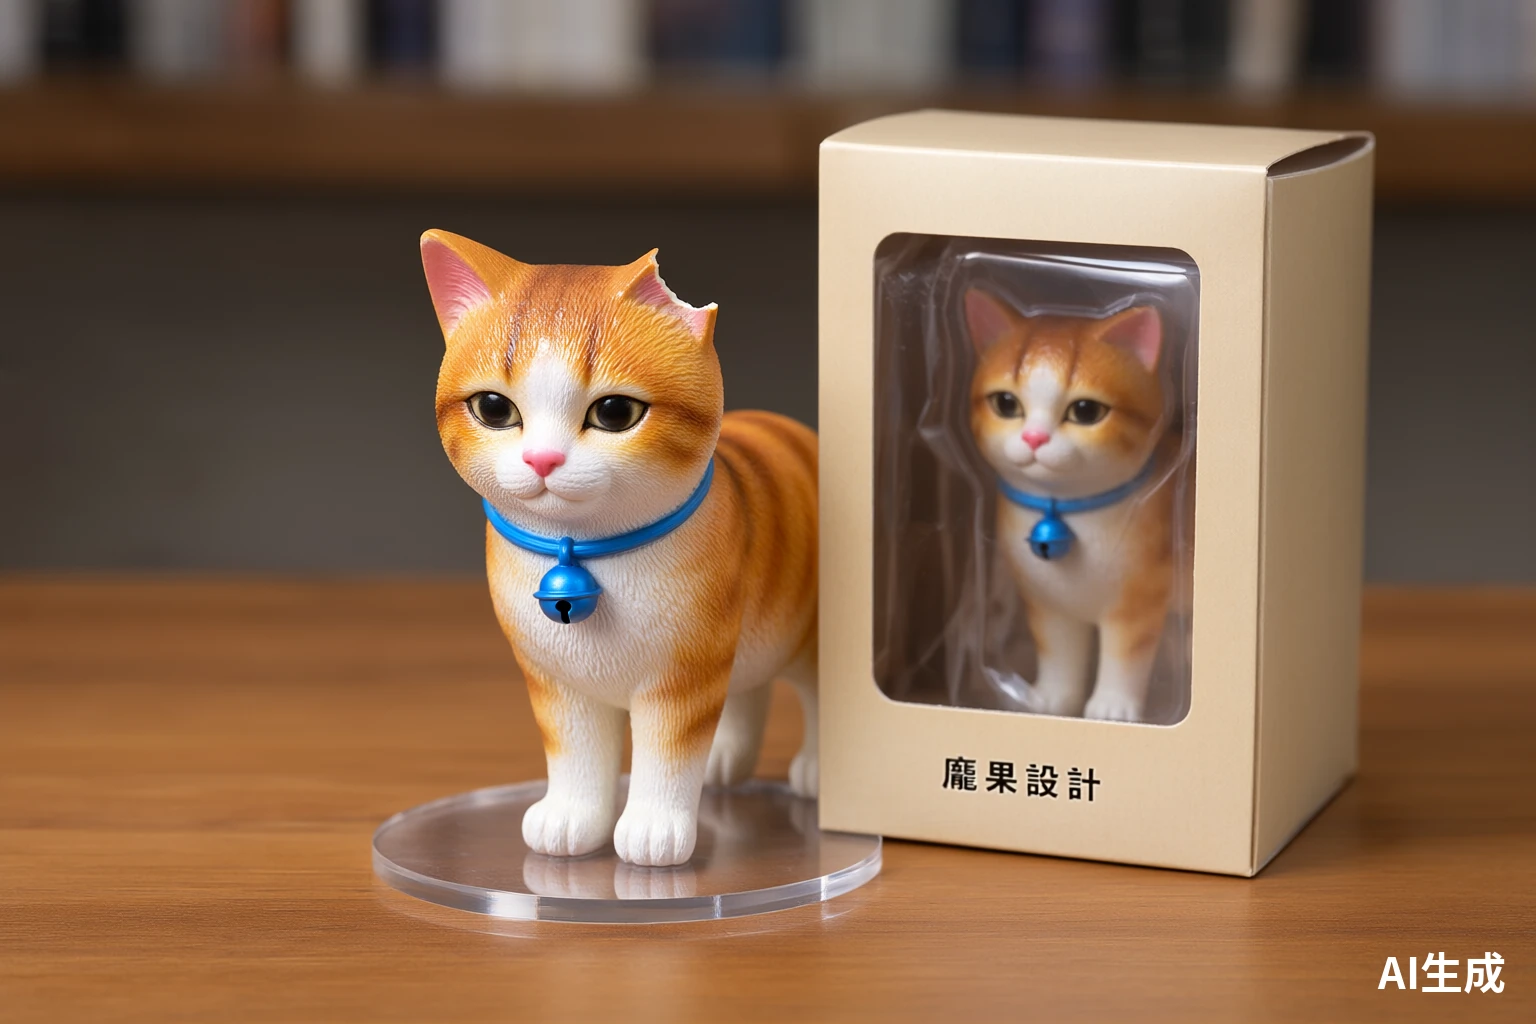
臉不像、盒面亂碼與比例失真的調整方式
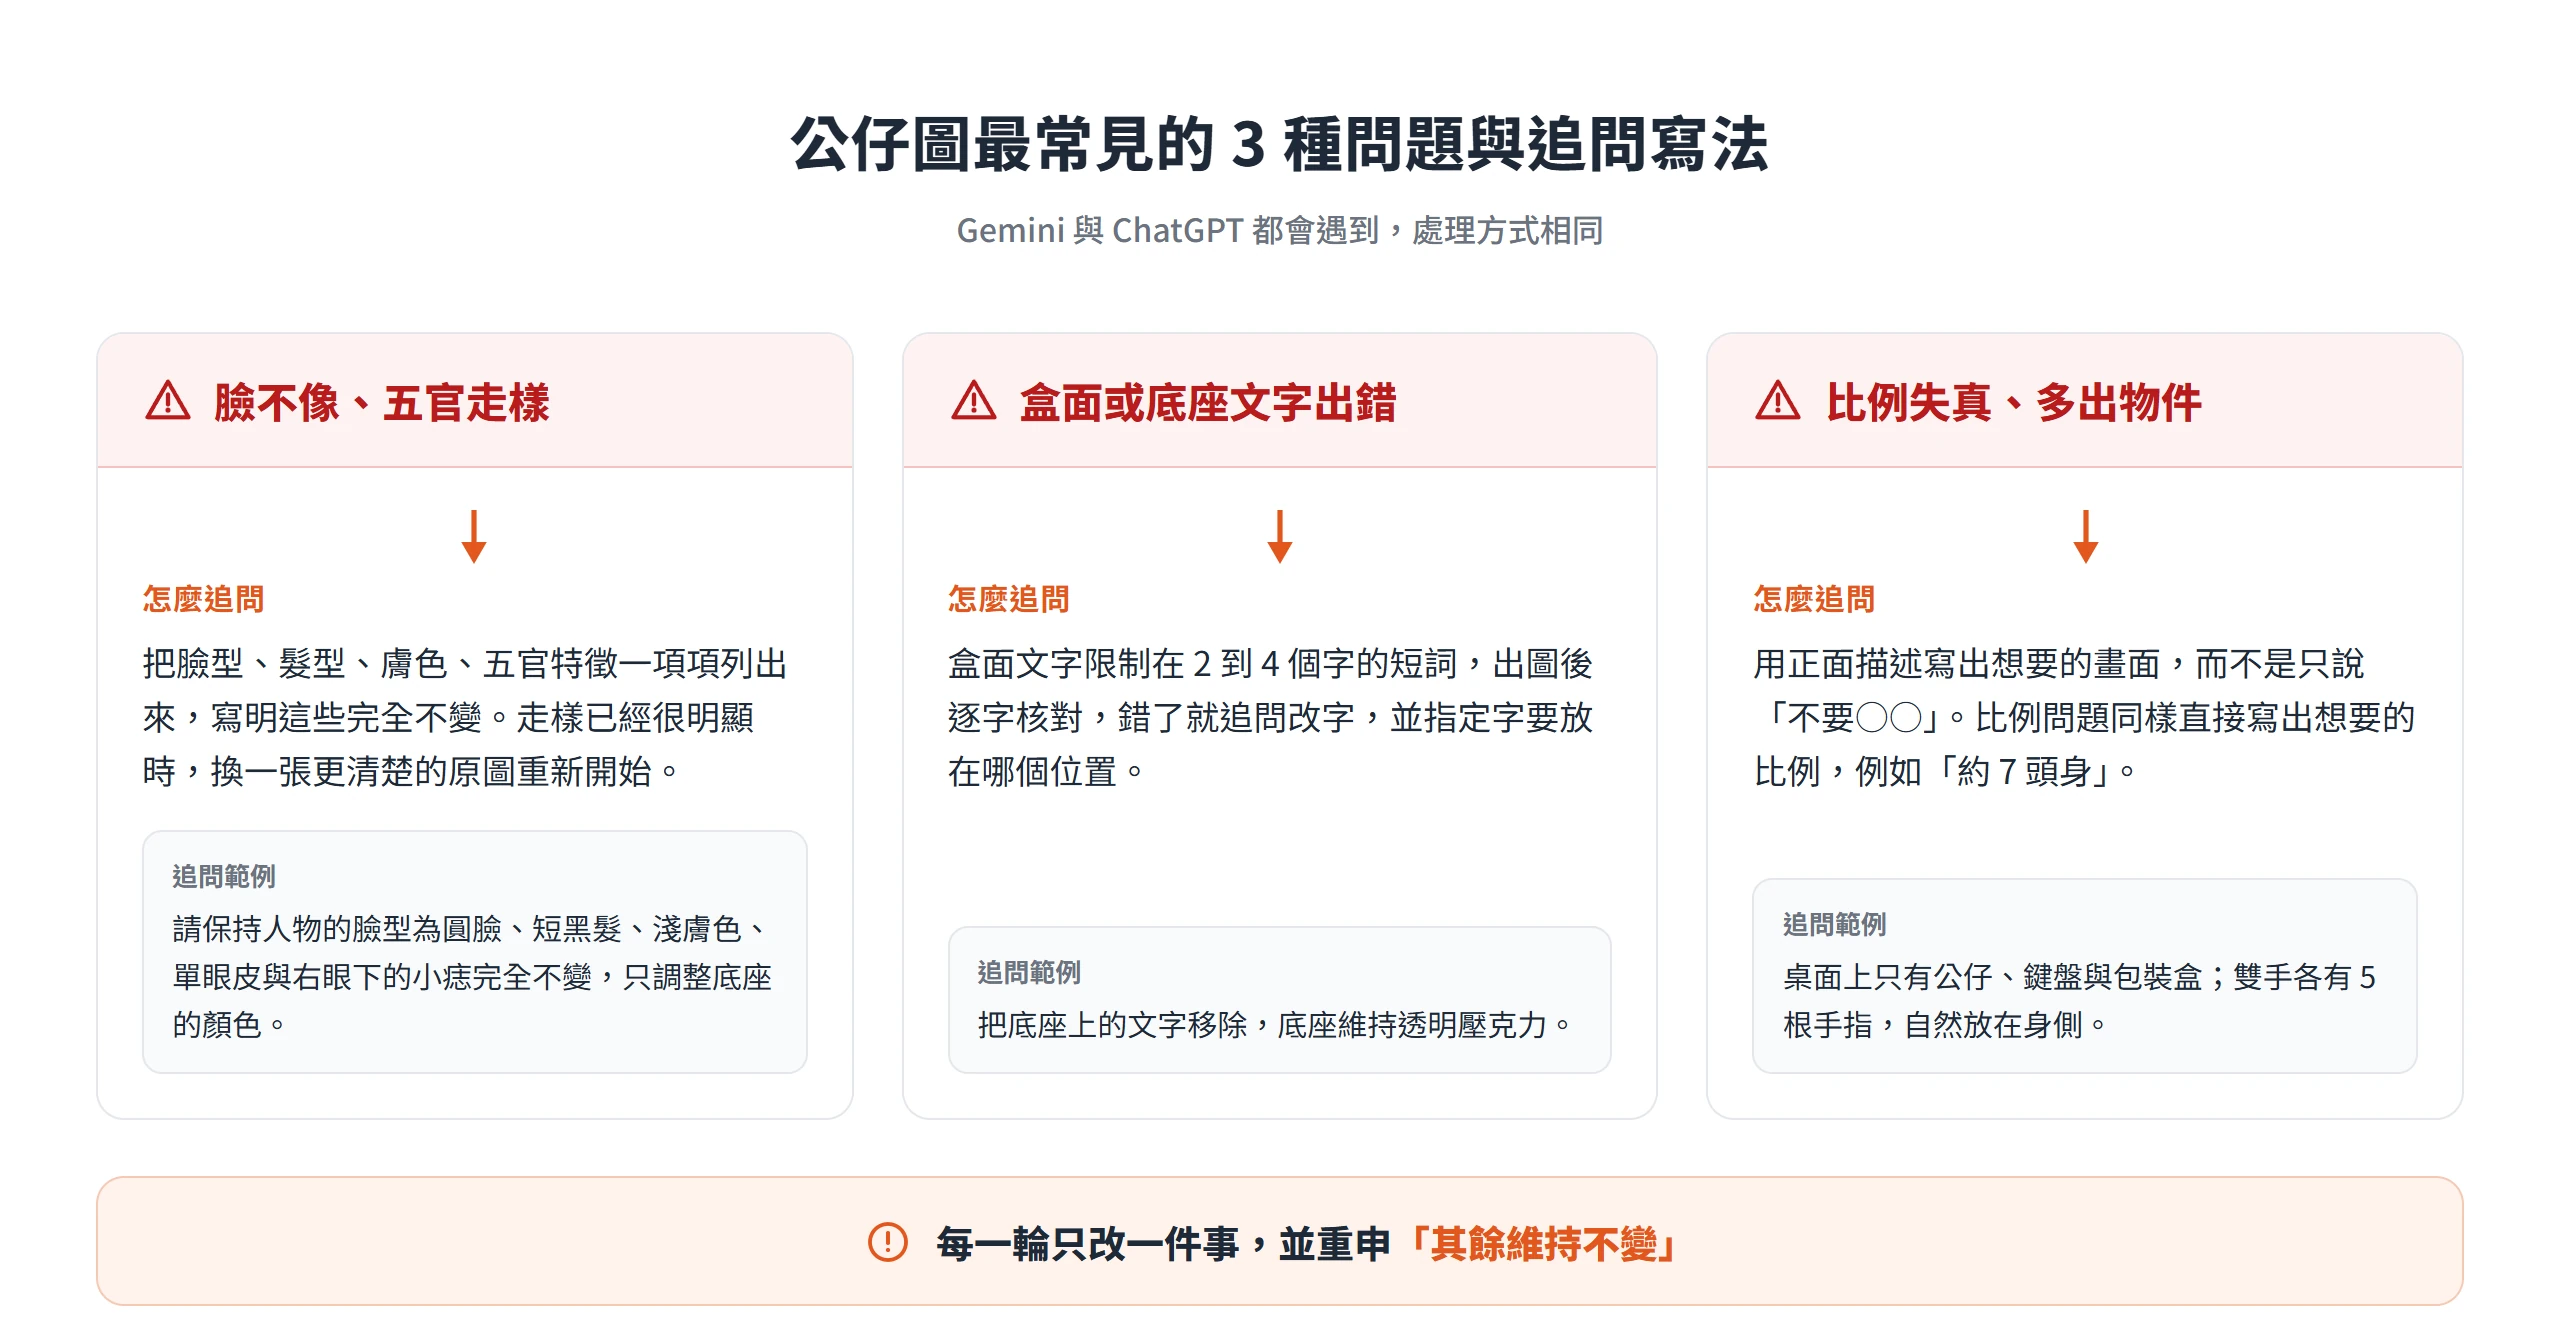
臉不像、盒面字出錯、比例走樣,是公仔圖最常見的 3 種問題,在兩個工具上都會遇到,處理方式也相同,追問時一次只改一件事,並重申其餘維持不變。
五官走樣時,把要保留的特徵寫進指令
模型本來就無法保證每次都畫出同一張臉。前面提過 Google DeepMind 的模型卡寫明角色一致性不一定完美,所以走樣是常見狀況,不是操作失誤。
做法是在追問裡,把臉型、髮型、膚色、五官特徵一項項列出來,並寫明這些完全不變。描述得越詳細,模型越知道哪裡不能動。
請保持人物的臉型為圓臉、短黑髮、淺膚色、單眼皮與右眼下的小痣完全不變,只調整底座的顏色。Code language: plaintext (plaintext)如果同一張圖已經走樣得很明顯,換一張更清楚的原圖重新開始,通常比在已經走樣的那張上繼續追問有效。越改越偏的情況,往往是因為每一輪都在偏掉的版本上再疊加。
盒面與底座文字出錯的處理
盒面的品牌字、卡片頂端的名字,最容易出錯。做法是先在對話裡把要放的字確認好,再請模型加到盒面上;字數越少越穩,盒面文字最好限制在 2 到 4 個字的短詞。
小字與長段落不要期待一次成功。出圖後逐字核對,錯了就追問改字,並指定字要放在哪個位置。前面提過,1K 解析度的下載圖,小字更容易糊,有 Google AI 方案的話可以改用 2K 下載,也可以把字放大、放少。
提示詞明明寫了底座「沒有任何文字」,成品仍可能出現文字,這時直接追問「把底座上的文字移除,底座維持透明壓克力」,通常一輪就能解決。
比例失真和多餘物件的修正
頭大腿短、手指數量不對、桌面多出沒要求的物件,這類問題用「正面描述」追問比較有效,也就是寫出想要的畫面,而不是只說「不要○○」。只說不要什麼,模型並沒有得到「想要的畫面長什麼樣子」的線索,修正的方向就不明確。
舉例來說,與其說「不要有多餘的東西」,不如改說「桌面上只有公仔、鍵盤與包裝盒」;與其說「手指不要變形」,不如改說「雙手各有 5 根手指,自然放在身側」。
比例的問題也一樣,直接寫出想要的比例:「約 7 頭身,身體的比例符合成年人」。寫得具體,模型就不用自己猜。
公仔圖適合做提案與社群素材,不是量產稿
公仔圖在工作流程裡的位置,大致落在「提案」與「宣傳」這兩端。吉祥物周邊要先給客戶看個方向、社群貼文需要一張吸睛的視覺、活動頁面要一張主視覺,這些情境都用得上,而且不必先請人建模或實拍,就能先有一張可以討論的圖。
它不適合的是量產。輸出只是一張 2D 圖,沒有三視圖,沒有尺寸標註,也沒有材質與色號的規格,更不是 3D 檔,工廠拿到這張圖,無法直接開模。要做成實體周邊,仍然需要專業的 3D 建模或雕塑流程接手,把圖上的外觀轉成可生產的結構。
另外要記得,圖上的包裝和品牌字都只是示意。盒面印的是虛構名稱,或提案用的暫定品牌名,這些內容在實際量產時要依真正的品牌規範重新設計,不能直接沿用 AI 出的版本。
真人照片、玩具品牌與 AI 生成標示的使用原則
公仔圖最容易踩到的兩個地方,一是上傳了誰的照片,二是盒面與提示詞出現了誰的品牌。再加上發布時要不要標明是 AI 生成,這 3 件事都有各自的做法可循。
他人照片要先取得本人同意
最穩當的做法是只上傳自己的照片、自己的寵物、原創角色,或是已經取得本人同意的照片。名人、同事、朋友的照片,要先徵求對方同意。
兩個工具的使用規範,都把這件事寫得很清楚。Google 的生成式 AI 使用限制政策,明文禁止侵害他人權利,包括隱私權與智慧財產權;Gemini API 文件也提醒,上傳的圖片,使用者必須確保自己擁有必要的權利。
Google 的 Gemini Apps 說明頁指出,系統偵測到可能違反服務條款的內容時,圖片可能被移除;OpenAI 的系統卡則寫明,以真人為對象的政治、性或其他敏感深偽圖片,違反使用政策。所以當工具拒絕處理真人照片時,改用自己的素材最省事,不用想辦法繞過。
提示詞與盒面不寫既有玩具品牌
既有的玩具品牌與角色名,涉及商標與著作權。把它們寫進提示詞,成品的盒面可能出現酷似的標誌或造型,用來發布、販售,或是做成品牌周邊時,風險更高。Bandai、Funko、Lego 這類名稱,都是不要寫進提示詞的例子。
做法是用形容詞描述風格,像「高品質收藏型」「掛卡泡殼」就能表達想要的質感;盒面的品牌字,自己指定成虛構名稱,或是自家品牌名。
Google 的生成式 AI 使用限制政策同樣禁止侵害他人智慧財產權。至於做出來的圖能不能商用、用到什麼範圍,以各工具的服務條款為準,使用前先看過比事後補救安全。
發布時保留 AI 生成的標示
兩個工具產出的圖,都內建來源標記。Gemini 生成的圖片帶有 SynthID 浮水印;ChatGPT 生成的圖片則帶有 C2PA 中繼資料與隱形浮水印。這些標記的用意,是讓人之後能辨認出圖片的來源。
發布到社群,或是交付給客戶時,不要把它說成手工製作的模型或實拍照片,也不要刻意移除這些標示。Google 的生成式 AI 使用限制政策也明文禁止,為了欺騙而謊稱內容完全由人類獨立創作。
直接說明「這是 AI 生成的示意圖」,對提案來說反而更清楚,客戶知道看到的是方向,不是成品。
用 AI公仔做出提案圖之前,先挑一張自己有權使用、臉部清楚的照片,把提示詞骨架貼進去跑第一輪,再一次只改一個項目。圖上的公仔只是方向,真要變成能擺在櫃子上的實體,還需要後面完整的建模與生產流程接手。