多數人以為「能不能用 AI」是一條技術門檻的分界線,用得愈深愈代表這家公司走在前面。但同一支 AI 工具,拿來生成十個社群貼文標題讓人挑選,跟直接把它寫出的產品規格、數字或引用原封不動發佈上線,根本是兩件風險完全不同的事。真正決定這件事該不該放行的,從來不是有沒有用 AI,而是這份產出接下來要不要被讀者當成一件真事去相信。
這條界線聽起來像是老生常談,落到實際工作卻常常被搞混。文案、設計稿、程式碼三種完全不同的產出型態,判準其實是同一套:這份東西還在被推翻、被篩選的階段,還是已經要代表品牌對外說話、對某個決策負責。前者出錯的成本很低,後者出錯的代價可能是必須負起的責任,或是讀者對整個品牌失去信任。這條線一旦畫錯,付出代價的從來不是寫出這段文字或畫出這張圖的 AI,而是簽字把它送出去的人。
這條線該怎麼畫,得先從最基本的那一半,哪些東西現在就可以放手講起。
AI 產出的草稿、內部素材可以直接沿用
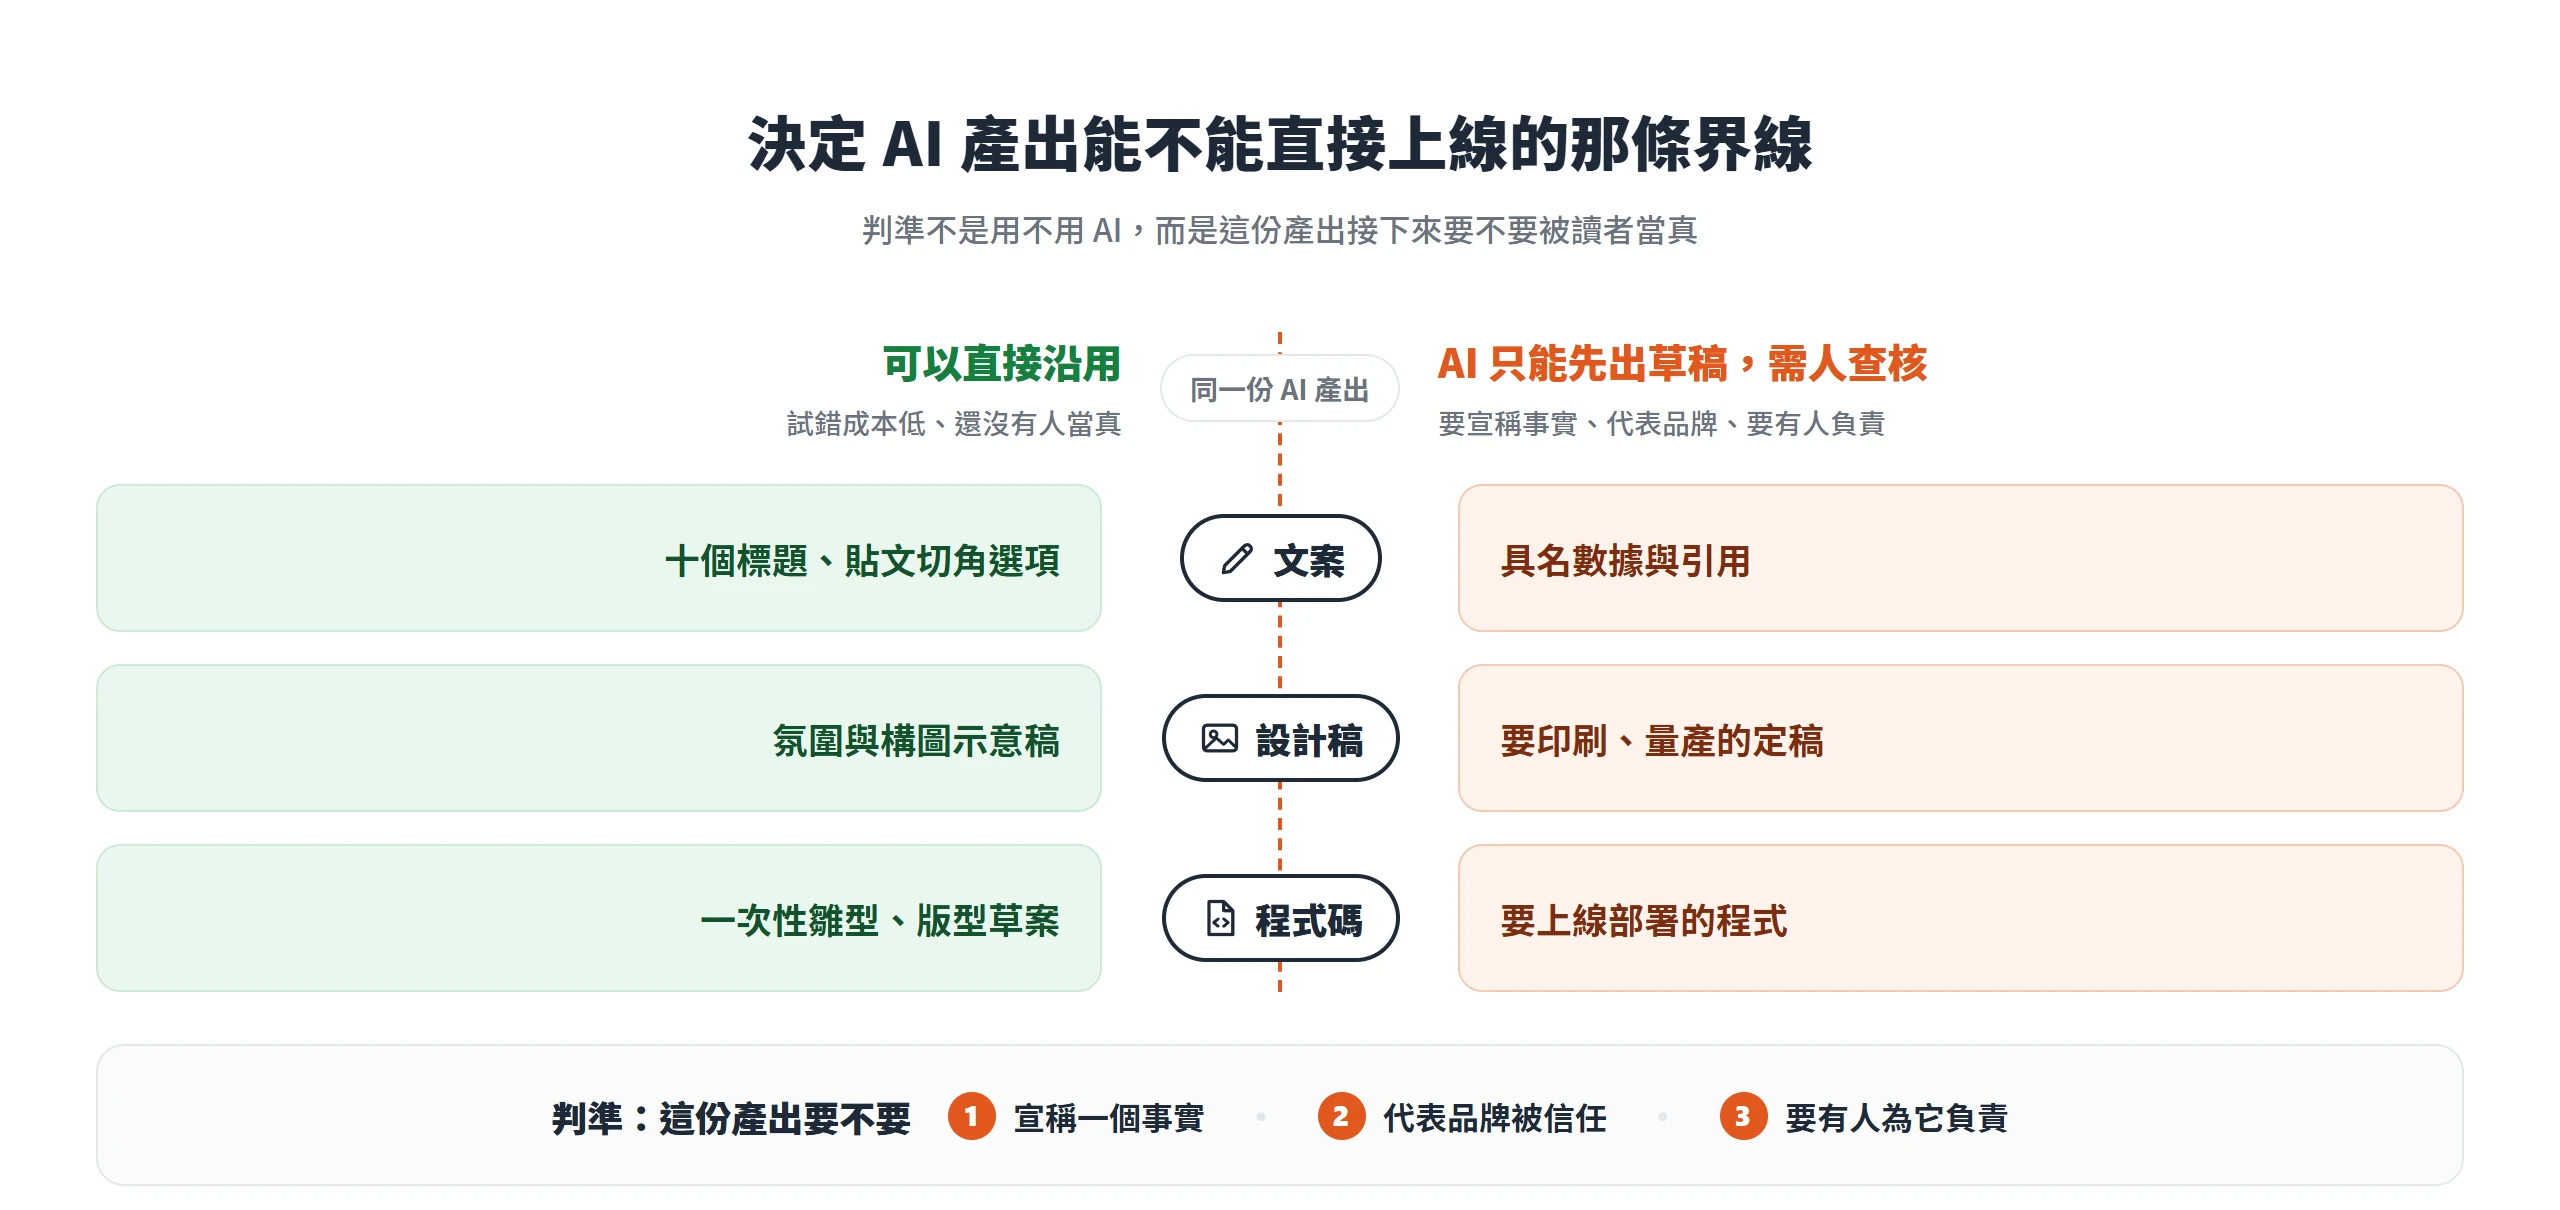
能不能直接把 AI 產出拿去用,判準不是用不用 AI,而是這份東西接下來要不要對外宣稱一個事實、要不要代表品牌被讀者信任、有沒有人要為它負責。文案的十個標題選項、圖像的氛圍示意、程式碼的一次性雛型、版型的排版草案,這幾種東西的共同點是,錯了重來的成本很低,而且還沒有人會拿它當真。
探索和腦力激盪階段的試錯成本很低
發想與腦力激盪的本質,是提供選擇,不是定案。一支 AI 工具一次寫出十個社群貼文切角、二十個標題選項,讓人從裡面挑,這個階段的產出本來就要被大量丟棄,只有最後被選中、被人核可過的那一個,才會真正被讀者看見。沒有讀者會看到那九個沒被選中的版本,自然談不上宣稱事實,也談不上代表品牌被信任。
Nielsen Norman Group 在 2023 年發布的一份調查,訪問了 841 位使用者經驗從業者,發現約 31% 的受訪者會把生成式 AI 當成發想夥伴,用來克服面對空白畫布的焦慮、一次探索多種可能的方向。這份調查的重點不在 AI 適合做哪種任務,而在於這類任務本身的性質,產出本來就是要被篩選、被推翻的過程,不是直接拿去對外發布的成品。試錯成本低,才是這個階段可以放手讓 AI 做的真正原因。
版型和內部溝通素材的效率優先
版型範本、內部提案簡報的草稿、寫給同事看的內部溝通文件,這些從一開始就不是對外的最終交付物。同事打開一份用 AI 快速拼出來的簡報草稿,知道這只是討論用的半成品,不會把裡面的每一個字當成品牌對外的承諾。這類素材追求的是效率,把腦子裡模糊的想法快速攤開來討論,不是把一份完成品交出去。
決定要不要把關的關鍵,是這份東西的讀者是誰。內部溝通的讀者是同事、是自己,這群人本來就知道自己看到的是過程,不是結果,要等到內容真的定案、真的要拿去對外的那一刻,才需要人力仔細覆核。整個過程不必每一步都停下來等審核,不然效率反而被自己設下的關卡拖垮。
需要查核與負責的產出,AI 只能先出草稿
把「可以直接用」那一半攤開之後,剩下的另一半就是需要人查核與負責的產出。這一半一樣橫跨文案、設計稿、程式碼三種型態,共同點是都碰到宣稱事實、代表品牌信任、需要人負責的決策這三件事中至少一件,AI 在這裡只能先給草案,不能自己拍板。
具名數據和引用必須回溯到查得到的出處
美國聯邦貿易委員會(FTC)在 2024 年 9 月宣布的「Operation AI Comply」執法行動,直接示範了這件事出錯會有多具體的後果。FTC 對 AI 寫作工具 Rytr 提告,理由是這家公司從 2021 年 4 月起販售一項「見證與評論生成」功能,讓付費使用者只要輸入極少量、通用的資訊,就能生成無上限的詳細消費者評論。FTC 調查發現,這些評論裡包含大量跟使用者實際輸入完全無關、卻具體到足以誤導讀者的細節,一旦被原樣貼上網公開,幾乎必然是不實的。FTC 原於 2024 年底達成和解,要求 Rytr 不得再廣告、行銷或銷售任何「生成消費者評論或見證」的服務;這項要求後來在 2025 年底被 FTC 自行撤銷,理由是配合鼓勵 AI 產業創新的政策方向。
同一波執法行動裡,自稱「全球第一個機器人律師」的 DoNotPay 也被提告,理由是它宣稱能讓消費者不請律師就打官司、幾分鐘生成有效的法律文件,但公司本身從未測試過自家聊天機器人的產出品質,也沒有聘僱任何一位執業律師,最終以支付賠款、通知訂閱者留意服務限制收場。同一段時間,美國多個州也陸續出現在書狀裡引用 AI 虛構判例、最終要自己承擔後果的律師,根據法律學者 Damien Charlotin 建立、路透社等媒體引用的 AI 幻覺判例資料庫,光是美國本土的案件到 2026 年就已經超過千件,且仍在快速增加。這些案例的共通點很簡單,AI 寫出來的文字讀起來完全像真的,但沒有人回頭核對過真偽,一旦被核對出來,代價由簽名送出文件的人承擔,不會找上寫出這段文字的 AI。
精準與合規要求高的設計稿和程式碼,先當底稿處理
設計稿這一端的道理更直觀。品牌識別、Logo、包裝設計一旦要進入正式印刷或量產,色彩管理、模切線、可印刷區域這些規格是有標準答案、可以驗證對錯的技術問題,不是美感問題。假設一家做食品包裝的中小企業委託設計一款新包裝,AI 生成的視覺稿在氛圍與構圖上可以做得很完整,但印刷色與專色的精準度、包裝上法定標示的位置與字級,這些從來不是 AI 被訓練去把關的東西。這一關省不得,不是因為不信任 AI 的美感,而是因為做錯了沒有補救空間,印刷已經下線、包裝已經量產,才發現色彩失準或標示缺漏,成本比事前多花一次核對高出太多。
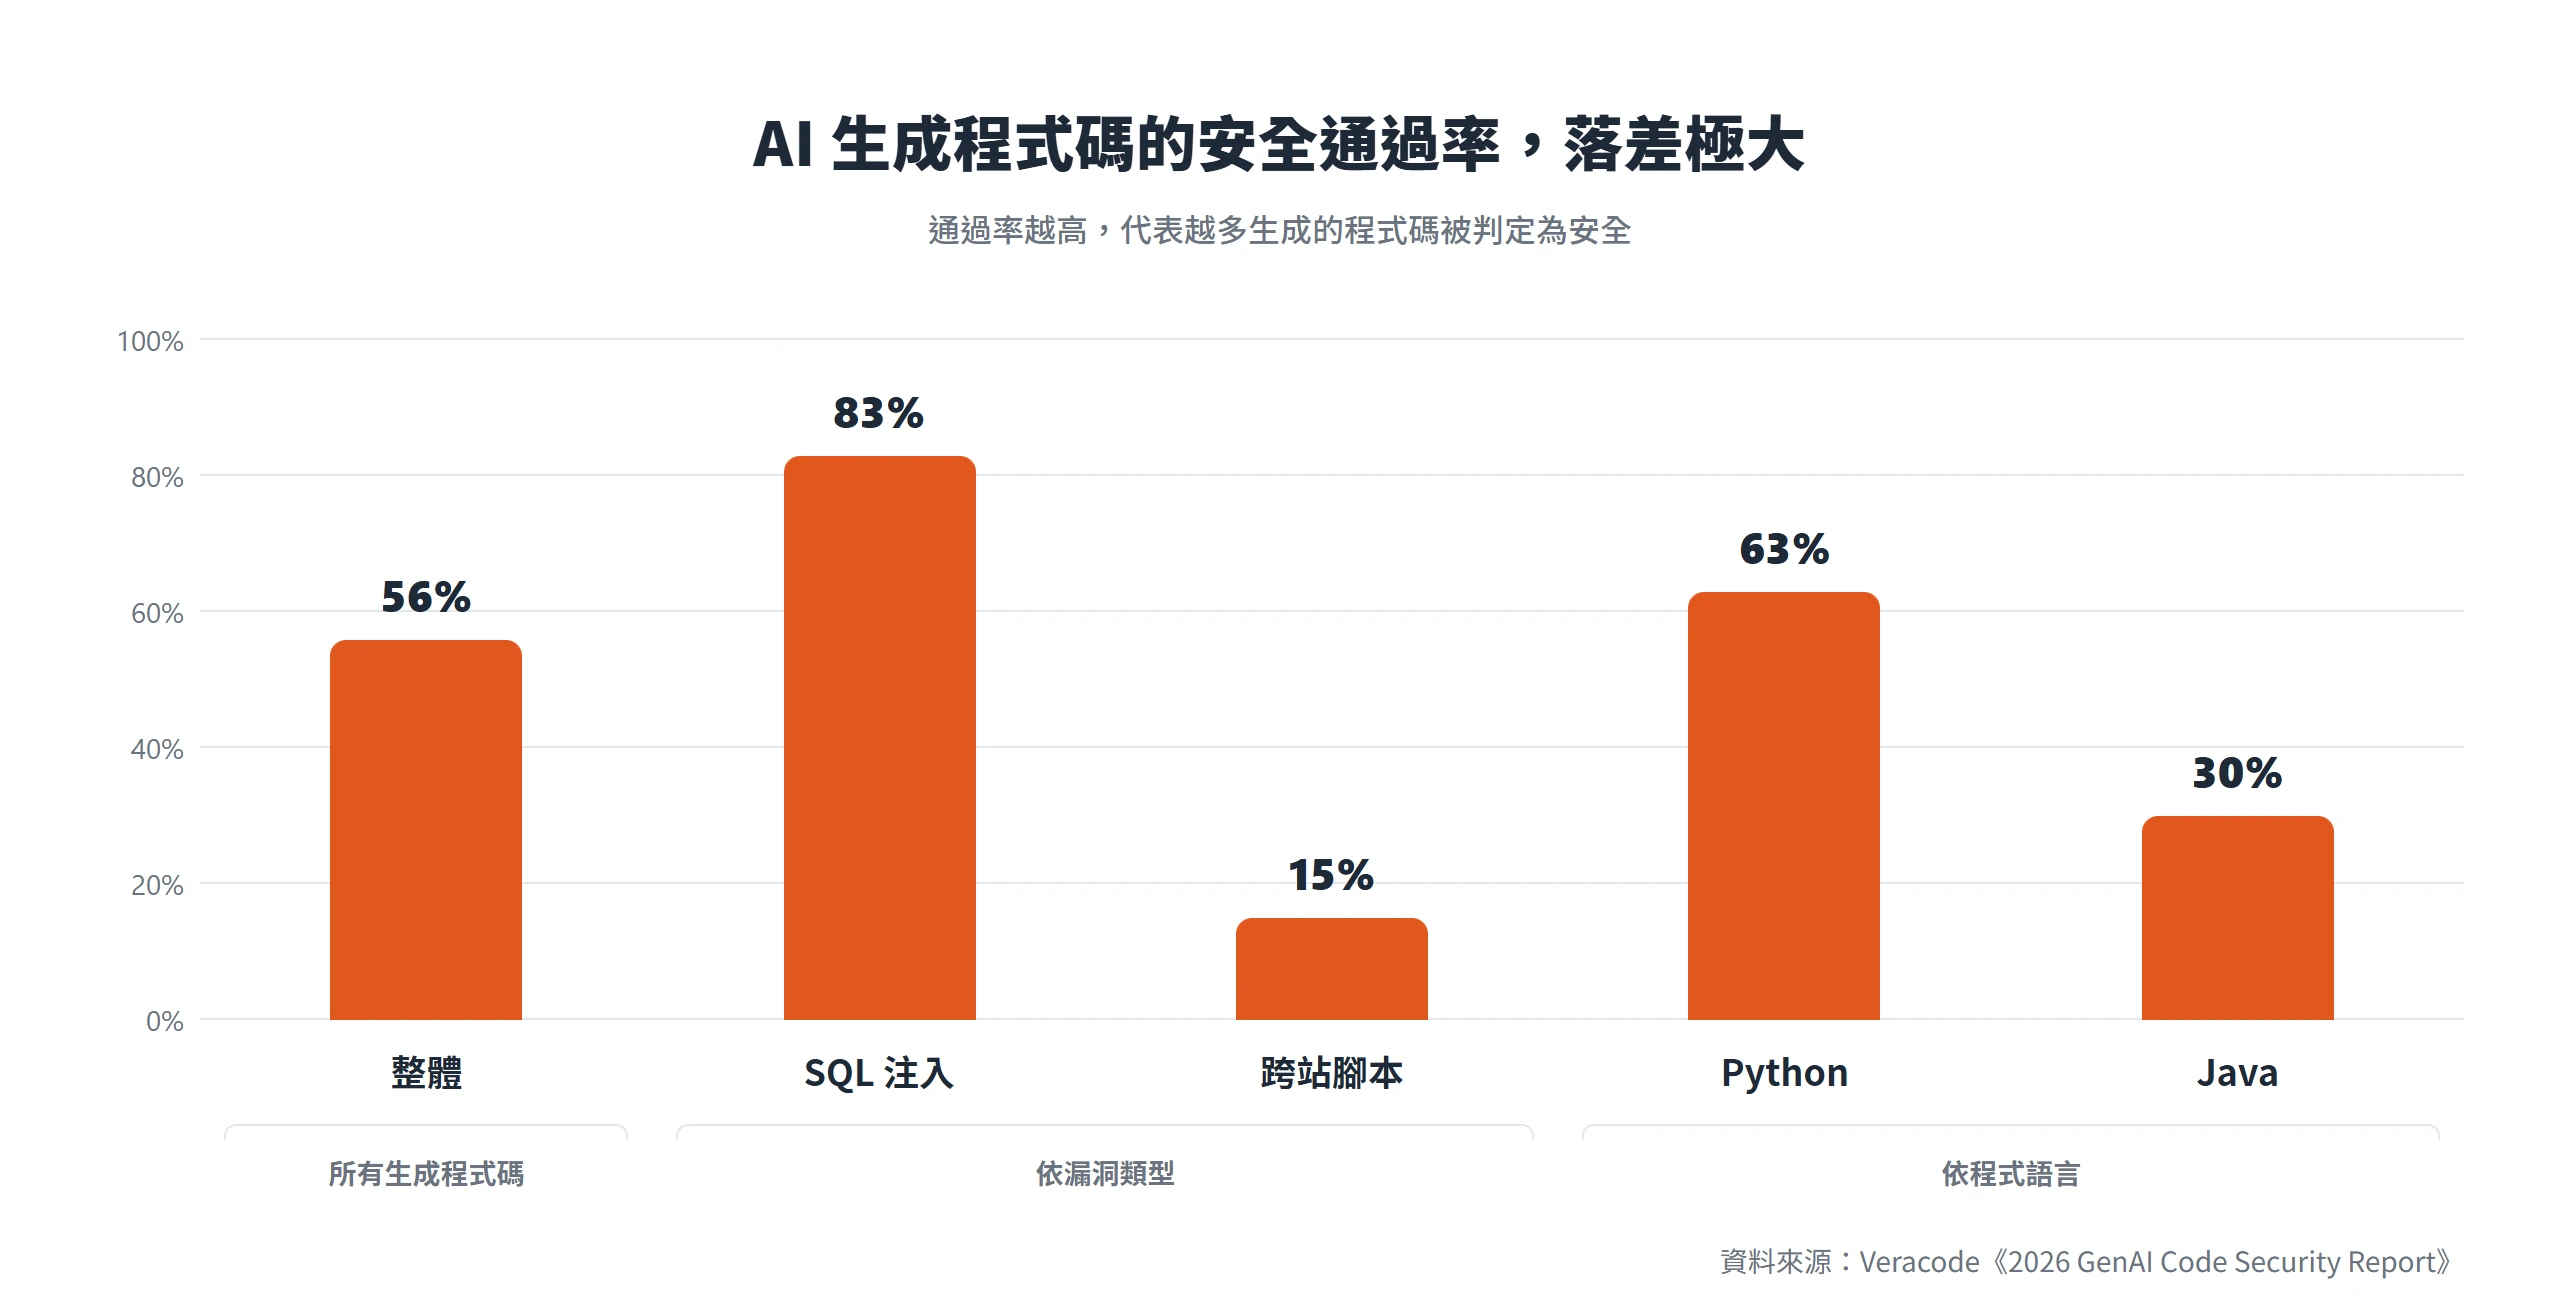
程式碼那一端則有更具體的量化數據撐著。Veracode 在 2026 年 7 月發布的《GenAI Code Security Report》分析了超過 100 個大型語言模型,涵蓋 4 種程式語言與 4 種關鍵漏洞類型,結果只有 56% 的 AI 生成程式碼被判定安全,等於近半數帶有已知的安全漏洞。這個安全表現並沒有隨著模型變強而改善,新一代、規模更大的模型在語法正確性上明顯進步,生成的程式碼卻沒有明顯更安全。分項來看,SQL 注入的通過率有 83%,跨站腳本攻擊的通過率卻只有 15%;依程式語言別,Python 有 63% 通過,Java 卻只有 30%。Veracode 把原因歸結為訓練資料本身混雜安全與不安全的實作、AI 缺乏對應用程式安全需求與商業邏輯的深度理解,也還做不到判斷資料是否為使用者可控輸入所需的複雜跨程序分析。這代表程式碼上線前的安全掃描,不是保守作法,而是目前唯一補得上這個落差的方法。
AI 不能代替人拍板沒人能承擔後果的決策
把前面兩節的案例放在一起看,會發現文案、設計稿、程式碼三種完全不同的產出型態,背後其實是同一件事。Rytr 的評論、DoNotPay 的法律文件、引用虛構判例的律師、Veracode 測出的程式碼漏洞,共同點都是這份產出沒有先經過人核實,就被當真發布或部署出去。責任最終還是找上簽名的那個人,不會找上寫出這段文字或這段程式碼的 AI。
這也是這一整節判準的收斂,不是看這件事複雜不複雜,而是看做錯了誰要負責。文案發想稿做錯了,大不了換一個版本重寫;但具名數據寫錯了又公開發布出去,最終要負責的人,是那個按下發布鍵的人,不是那個生成這段文字的工具。這條分界線,決定了同一支 AI 工具,今天用在哪個位置需要人多核一遍。
這條界線背後有三股要求人判斷的力量
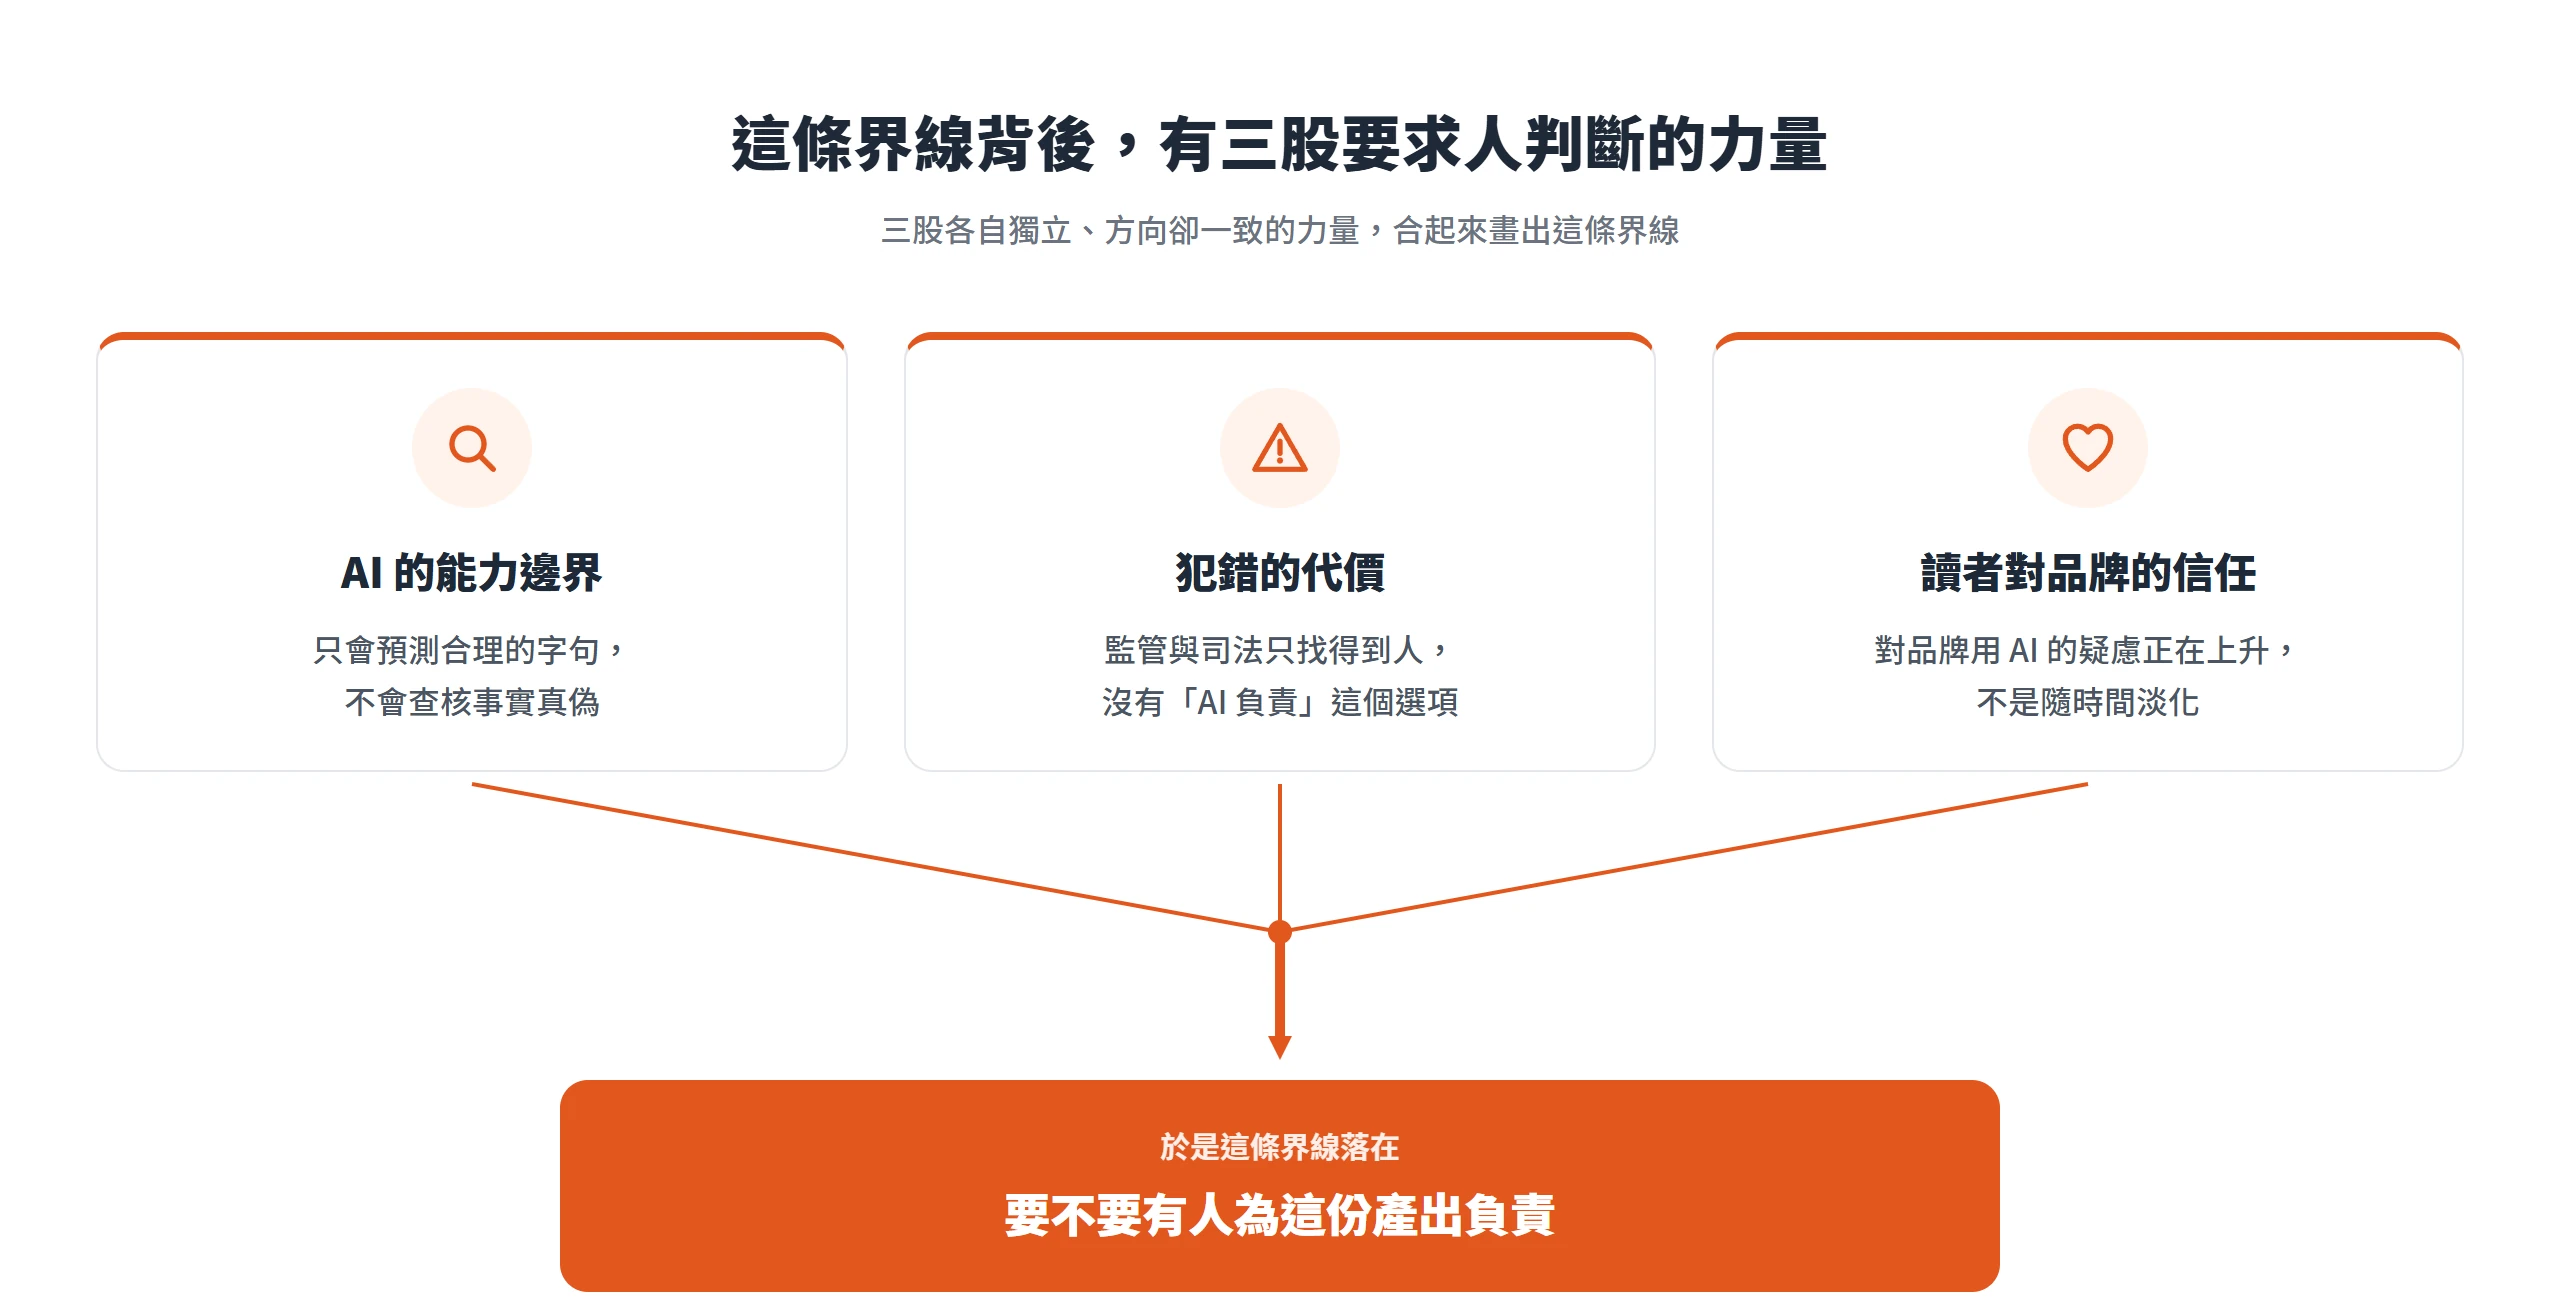
「哪些可以直接用、哪些要把關」是具體的分界,但這條線為什麼剛好落在這裡,而不是別的地方,背後有三股各自獨立、方向卻一致的力量。這三股力量分別是 AI 本身的能力邊界、犯錯之後代價找誰算、還有讀者對品牌信任的期待,合在一起才畫出這條界線。
AI 缺乏查核事實真偽的能力,只能預測合理的字句
AI 文字產出讀起來很像真的,卻經常是錯的,原因不是某個模型特別差,而是生成式語言模型的運作原理本身,是在預測下一個最可能出現的字詞,不是在查核這件事是不是真的。這兩種能力完全不同,一個是語言的合理性,一個是事實的真偽,前者是模型的強項,後者從來不是。
就算是專門為降低虛構率打造、標榜用「檢索增強生成」技術的付費法律 AI 工具,也做不到零虛構。史丹佛大學 RegLab 團隊發表的一份針對商用 AI 法律研究工具的實證評估發現,部分供應商曾宣稱自家技術能消除或避免虛構、甚至保證零虛構的法律引註,但實測結果顯示,幾款主流法律 AI 工具的虛構率仍落在 17% 到 33% 之間,相較一般用途的聊天機器人雖然已經低不少,但遠遠稱不上供應商宣稱的零虛構。研究還指出,這些系統對自己的錯誤缺乏自覺,反而容易強化使用者原本就有的錯誤假設。連專門為法律場景打造的工具都做不到,更說明查核真偽這件事現階段還是得靠人。
犯錯的代價最終沒有人可以歸咎給 AI
前面提到的案例,合起來講的是同一條制度性的原則,不是個案倒楣。不論是哪一種情況,最終要負責的一律是使用 AI 的人或公司,沒有「AI 要負責」這個選項存在。這不是道德呼籲,而是被寫進國際標準機構框架裡的具體要求。
美國國家標準與技術研究院(NIST)的《AI 風險管理框架》明確要求組織建立可追溯到人類決策者的當責機制,並主張人力監督的程度應該跟 AI 產出的潛在影響成比例,潛在影響愈大,需要的監督愈多,而不是齊頭式套用同一套標準。這條「比例式監督」的原則,直接支撐「責任回到人身上」不只是一句道德喊話,而是有標準可以依循的具體要求。
品牌信任建立在讀者相信為真,錯置了很難補回
就算沒有觸法、沒有被告,讀者對「品牌用 AI 用到什麼程度」本身已經越來越敏感,而且這個敏感度是在上升,跟「AI 越普及,大家越見怪不怪」的直覺剛好相反。
美國內容行銷與公關代理商 Fractl 在 2026 年第二季的消費者調查,訪問了 1,008 位美國消費者與 150 位行銷人員,發現認為「品牌大量使用 AI 會降低我對這個品牌信任」的消費者比例,從 2025 年的 20% 倍增到 2026 年的 40%,Z 世代這個比例更高達 54%。只有 14% 的消費者表示會因為品牌大量使用 AI 而更信任該品牌。這組數字說明,讀者對 AI 的疑慮不是在隨時間淡化,而是在加深。
同一份調查也指出一個明顯的落差,84% 到 91% 的消費者希望各種格式的 AI 內容都被標示出來,但只有 20% 的品牌會一律揭露自己使用 AI,33% 的品牌從不揭露。品牌信任建立在讀者相信眼前看到的是真的這個前提上,一旦這個前提被打破,要花的力氣往往比一開始就老實標示高出許多。
把關要落在流程裡而不是工具挑選上
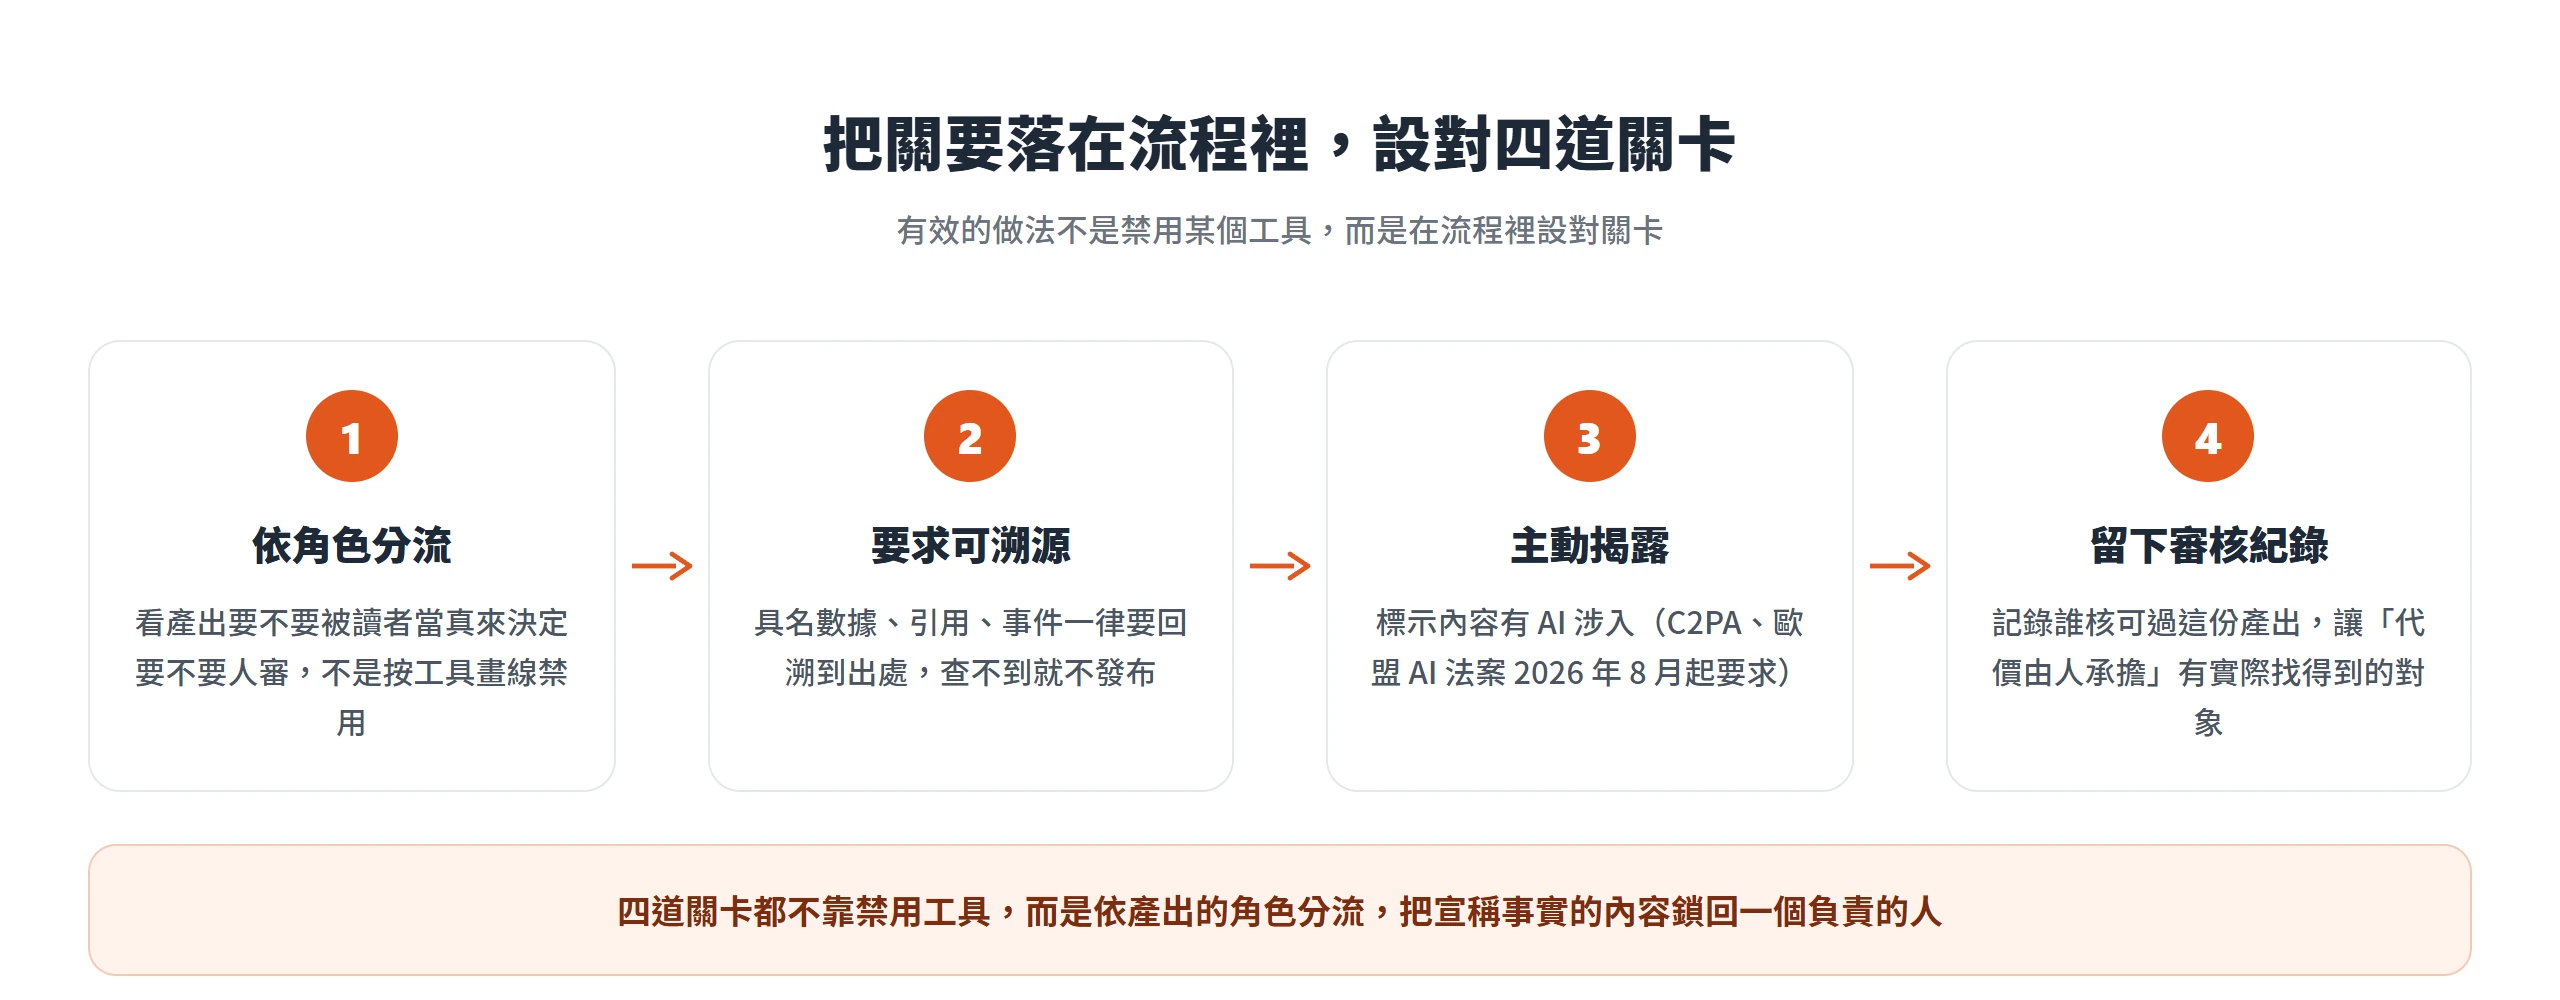
把關要落在流程裡,不是靠禁用某個 AI 工具,或規定某類工作一律不准碰 AI。真正有效的做法是在流程裡設對幾個關卡,依產出的角色分流、要求宣稱事實的內容能溯源、主動揭露、留下誰核可過的紀錄。
分流看的是產出角色不是使用的工具
同一支 AI 工具,拿來生成十個社群貼文切角讓人挑,跟直接把生成的貼文原封不動發布,是完全不同的風險等級。禁用或放行不該按工具畫線,而是按這份產出接下來要不要被讀者當真畫線,這正好呼應前面提到的比例式監督原則,潛在影響愈大,需要的人力監督愈多。
美聯社的新聞編輯室準則,是這套分流邏輯已經落地的具體示範。美聯社允許記者用生成式 AI 做前期研究、翻譯、文件摘要、逐字稿轉謄、文法拼字校對,以及下標題與內容摘要的初步協助,這些全部屬於草稿或輔助的角色。但同一套準則也明文規定,新聞的溯源查證、編輯判斷、事實查核一律要留給人,AI 不能取代原始採訪、消息來源查證,或記者最終的把關與判斷,而且每一則有 AI 涉入的內容出版前都必須由記者親自審過。同一支工具,依角色分流管理,不是整個編輯室一刀切禁用或全面放行。
宣稱事實的內容一律要求可溯源的出處
這個關卡的設法很直接,凡是文案裡出現具名數據、具名引用、具名事件,一律要求能回溯到查得到的原始出處,查不到出處就不能發布。這條規則直接對應前面 Rytr、DoNotPay、引用虛構判例的律師三個案例,它們共同的破口都是內容宣稱了具體事實,卻沒有人回頭查證過。
Google 在《製作實用、可靠且以使用者為優先的內容》這份官方文件裡,把內容是否有任何顯而易見的錯誤資訊,列為評估內容專業度的重點問題之一,也提到讀者與訪客有權知道內容是用什麼方法產生的,包括是否為 AI 生成或 AI 輔助。這說明宣稱事實要能溯源,不只是內部品管的要求,搜尋引擎本身也已經把這件事,當成評估內容品質的具體問題。
主動揭露比隱藏對品牌更划算,讀者在意產出的來源
揭露這個關卡在技術上已經有標準可以落地,不只是靠品牌自己口頭承諾。C2PA 是由 Adobe、OpenAI、Google、Microsoft 等共同支持成立的內容溯源技術標準組織,已經制定「Content Credentials」這種可嵌入內容、可加密簽署的中繼資料結構,記錄一項內容由誰在何時用什麼工具產生、是否使用 AI 產出或編輯,經過竄改會破壞加密連結、留下可偵測的痕跡。其中的 digitalSourceType 欄位,可以具體標示內容是完全由模型生成、由 AI 強化、由裝置拍攝,還是由人力編輯。
歐盟《人工智慧法案》自 2026 年 8 月起要求 AI 生成內容加上透明度標示,C2PA 的揭露欄位正好可以滿足這項規定。這跟前面提到的揭露落差正好對上,消費者想要的揭露,技術上已經可行,落差主要在品牌願不願意做,不是能不能做。
AI 產出要留下負責人與審核紀錄
最後一個關卡是留紀錄。每一份進入正式產出的 AI 內容,都該留下誰核可過的紀錄,不是為了究責文化,而是讓「代價由人承擔」這句話有實際可執行的對象。Veracode 在因應建議裡,明確提出組織應該建立 AI 治理機制,記錄 AI 使用的提示詞、生成的程式碼、安全複核紀錄,供法規遵循與事故調查使用,並針對 AI 生成的程式碼建立專門的審查流程。
這套邏輯不只適用程式碼,文案與設計稿一樣可以比照辦理。誰核可了這份對外文案裡的數據來源,誰核准了這張設計稿的印刷規格,同樣的做法可以類推適用。留紀錄本身不會讓 AI 產出的錯誤變少,但它讓「做錯了誰要負責」這句話,從一句原則變成一個真的找得到人的機制。
回到最前面那個對比,同一支 AI 工具寫出的十個標題選項跟直接發布的產品數據,危險程度從來不一樣,差別不在工具本身,而在這份產出接下來要不要被讀者當真、要不要有人為它簽字負責。這條界線不是用來限制 AI 能做多少事,而是用來確保做錯的時候,永遠找得到一個可以負責的人。
AI 能接手的產出範圍還會持續擴大,寫得更快、做得更像,但查核事實真偽、承擔決策後果、守住讀者對品牌的信任,這幾件事目前還輪不到 AI 接手。把這條界線畫清楚,才不會等到監管機關開罰、法院裁罰,或讀者發現自己被騙了之後,才想起來原來這份產出根本沒人核過。