眼動追蹤研究建議,一份熱點圖至少要測 39 位使用者,才稱得上「穩定」。多數團隊看的卻是流量普通、剛上線沒幾天的頁面,樣本可能只有兩三百次瀏覽,顏色深淺看起來卻已經像一份鐵一般的事實,紅色最深的那一塊直接被解讀成「使用者最想要的東西」,設計會議上就這樣定案改版。
熱點圖(Heatmap)是把大量使用者的滑鼠移動、點擊或捲動位置疊加起來,用顏色深淺呈現「相對集中程度」的統計視覺化。它本身沒有錯,錯的是把一張聚合出來的統計圖,當成使用者真實心思的錄影帶在讀。這篇要老實把這件事拆開,熱點圖擅長回答「哪裡」,答不出「為什麼」,而「為什麼」往往才是決定改版方向對不對的關鍵。
資料源頭有多間接、樣本數夠不夠穩定、捲動百分比怎麼算、點擊次數代表什麼,這幾個環節各自都藏著容易誤判的地方,也決定了熱點圖在工作流程裡該擺在哪個位置最合適。
熱點圖真正在量什麼?聚合出來的注意力代理指標
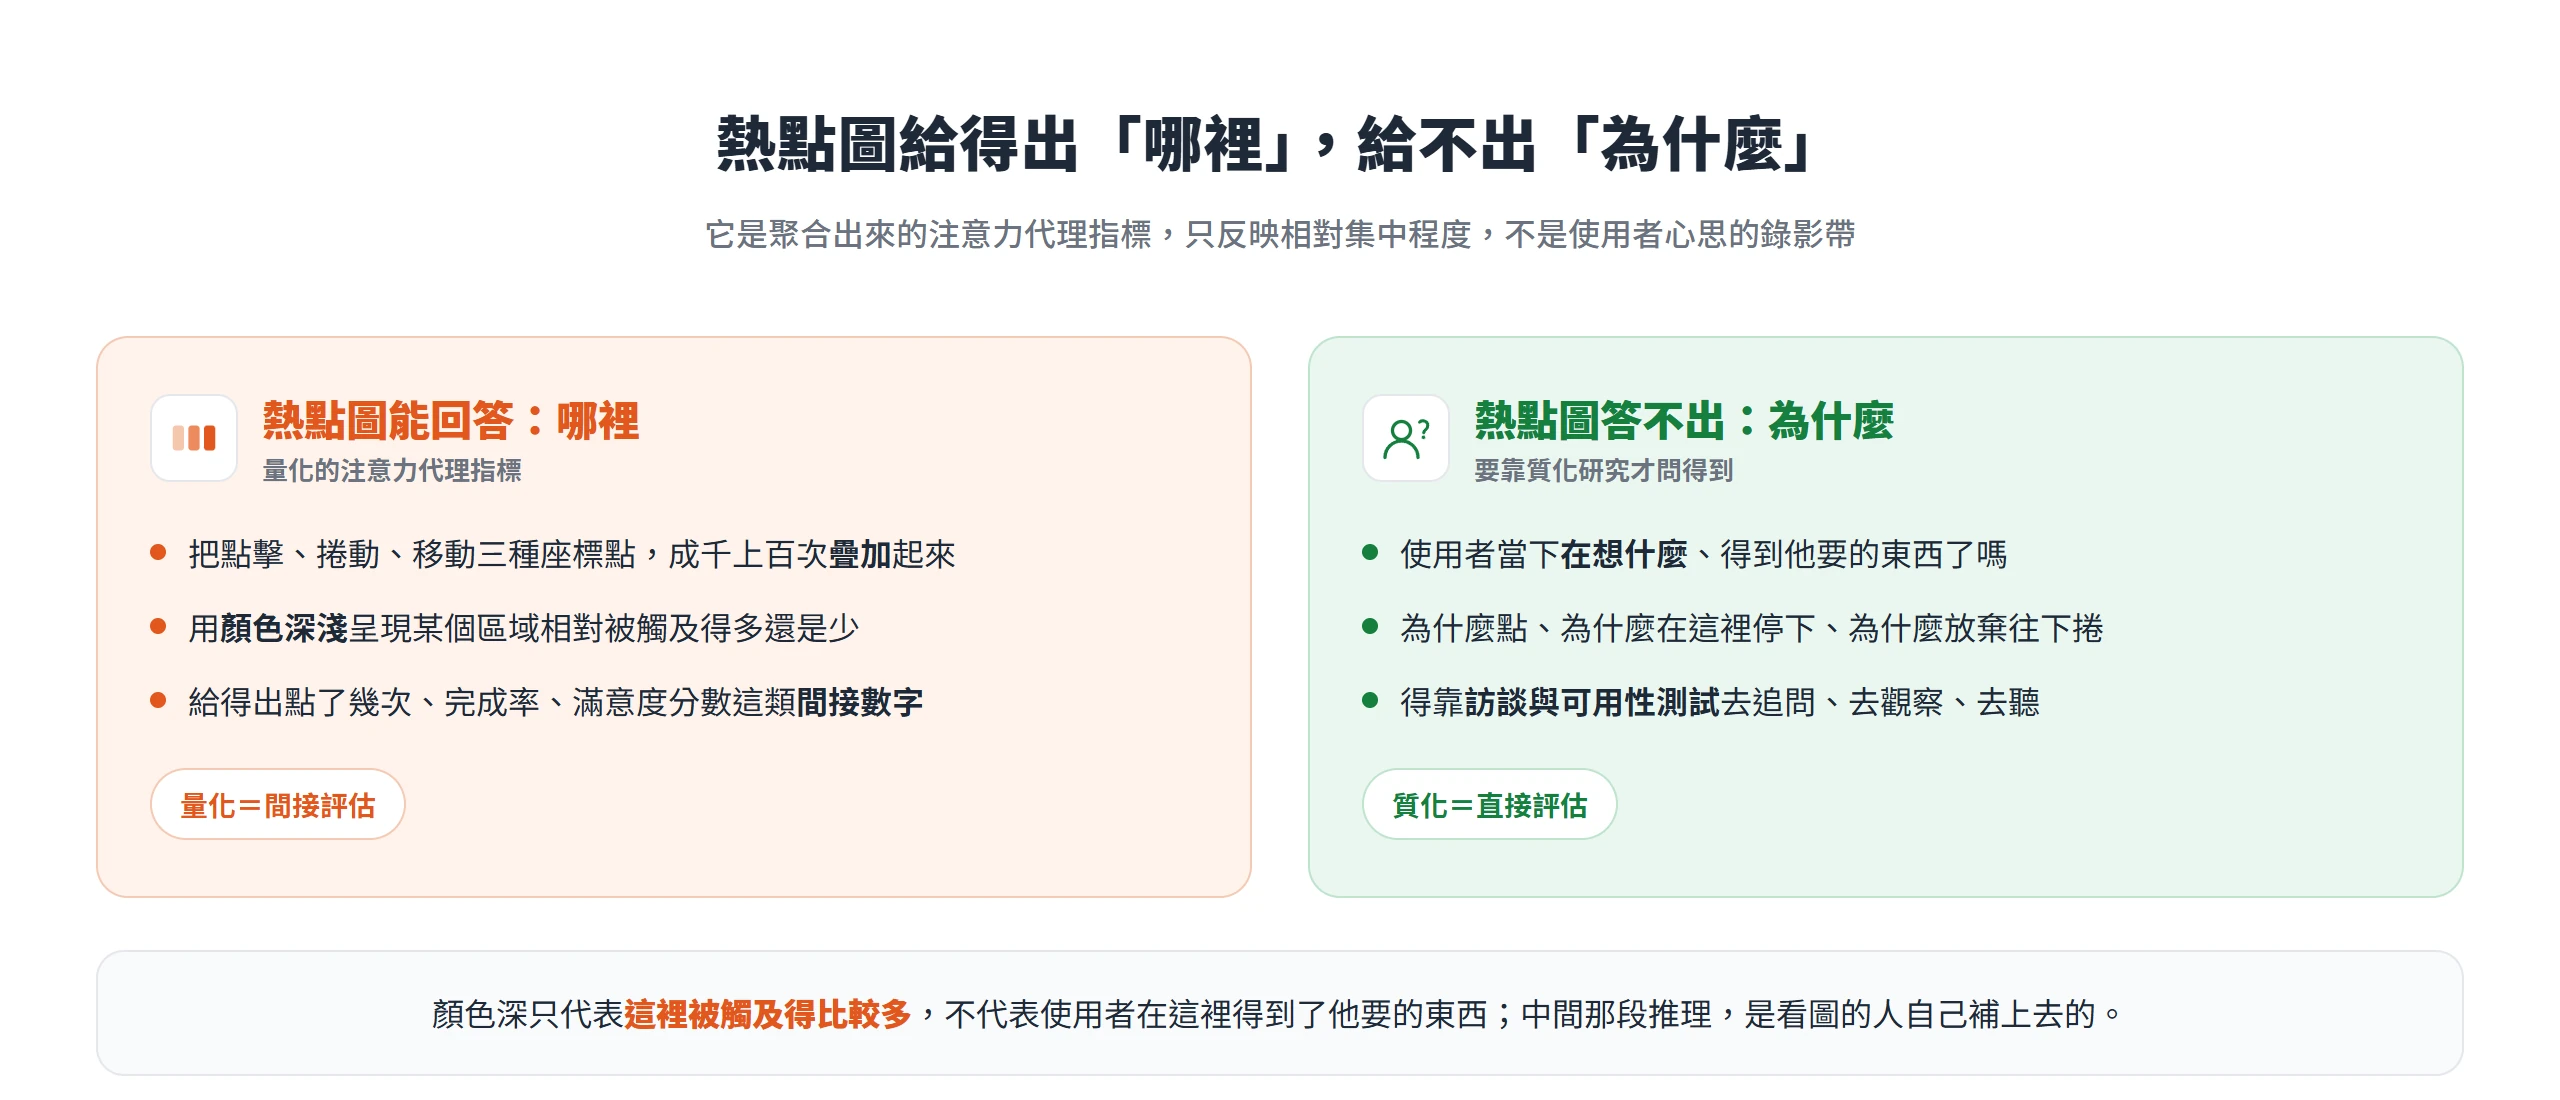
熱點圖不是單一使用者的行為錄影,而是把成千上百次瀏覽疊加起來的統計摘要。常見的三種,點擊熱點圖記錄使用者點在哪、捲動熱點圖記錄大家滑到頁面第幾個位置就停下來、移動熱點圖記錄滑鼠游標劃過的路徑,共通的做法都是把每一位使用者留下的一個座標點,跟其他所有人的座標點疊在一起,再用顏色深淺呈現這個區域相對被觸及得比較多還是比較少。它回答的是「哪裡」,不是「那個人當下在想什麼」。
這種聚合的性質,決定了熱點圖天生的能與不能。Nielsen Norman Group 的分析師 Raluca Budiu 在 2017 年一篇比較量化與質化可用性研究的文章裡把這個界線講得很清楚,量化資料(quantitative data)是一種間接評估,只反映使用者表現出來的數字,點擊了幾次、完成率多少、滿意度打了幾分,這些數字本身不會指出使用者遇到了什麼問題。熱點圖正是一種量化可視化,它繼承了量化資料的所有限制,給得出「多少」,給不出「為什麼」。要直接觀察到使用者卡在哪個環節、聽到使用者自己怎麼描述困惑,得靠質化研究,也就是訪談與可用性測試,這些方法能做直接評估,熱點圖做不到。
這個量化與質化的分工,值得記在心上,因為它會反覆出現在後面每一節。熱點圖顏色深的地方,只代表這裡被觸及得比較多,不代表使用者在這裡得到了他要的東西,也不代表這裡的設計做對了。中間那段推理,是看熱點圖的人自己腦補上去的,不是熱點圖本身告訴你的。
滑鼠移動的軌跡不等於眼睛真正落點
多數熱點圖工具實際記錄的不是眼球,而是滑鼠游標的位置,或觸控裝置上手指點按與滑動的軌跡。行銷素材上常把這類熱點圖直接稱作使用者的目光焦點,暗示顏色深的地方就是眼睛盯著看的地方,但滑鼠不是眼睛,兩者只是有統計上的相關,不是同一件事的兩種記錄方式。
《Journal of Eye Movement Research》期刊 2018 年一篇由 Egner 等研究者發表的論文,比較了滑鼠點擊注意力追蹤與真正的眼動追蹤這兩種量測方法,結論是兩者之間存在高度顯著的相關性(p < 0.001)。但同一份研究也指出,不同圖像類別之間的相關程度出現顯著差異,換句話說,滑鼠與眼睛的一致程度,會隨著內容類型與任務性質浮動,不是一個固定不變的等號。這篇論文比較的是視覺注意力研究領域裡兩種量測方法的差異,並不是專門針對商業網站熱點圖工具做的實驗,但背後那個原理是共通的,滑鼠位置終究只是眼睛的間接代理,不是直接測量。
在手機這類觸控裝置上,這個落差通常更明顯。使用者用眼睛讀過一段文字,手指卻不見得點過或滑過那個位置,很多內容明明被看過,卻因為手指沒有觸碰到,在點擊熱點圖上完全消失,呈現一片沒有顏色的空白。把這片空白解讀成這段內容沒人關注,方向可能正好搞反。
樣本數不夠時,熱點圖只是隨機雜訊疊出來的形狀
熱點圖是統計聚合,任何統計聚合都有樣本數夠不夠穩定這個前提,熱點圖也不例外。樣本數太少的時候,圖上看起來集中的那一塊紅,很可能只是少數幾個人剛好點在附近造成的巧合,換一批使用者、換一天流量,同一個頁面的熱點圖形狀可能完全不一樣,但沒有人會把兩張圖疊在一起比對,大家只看手上這一張,就把偶然當成規律。
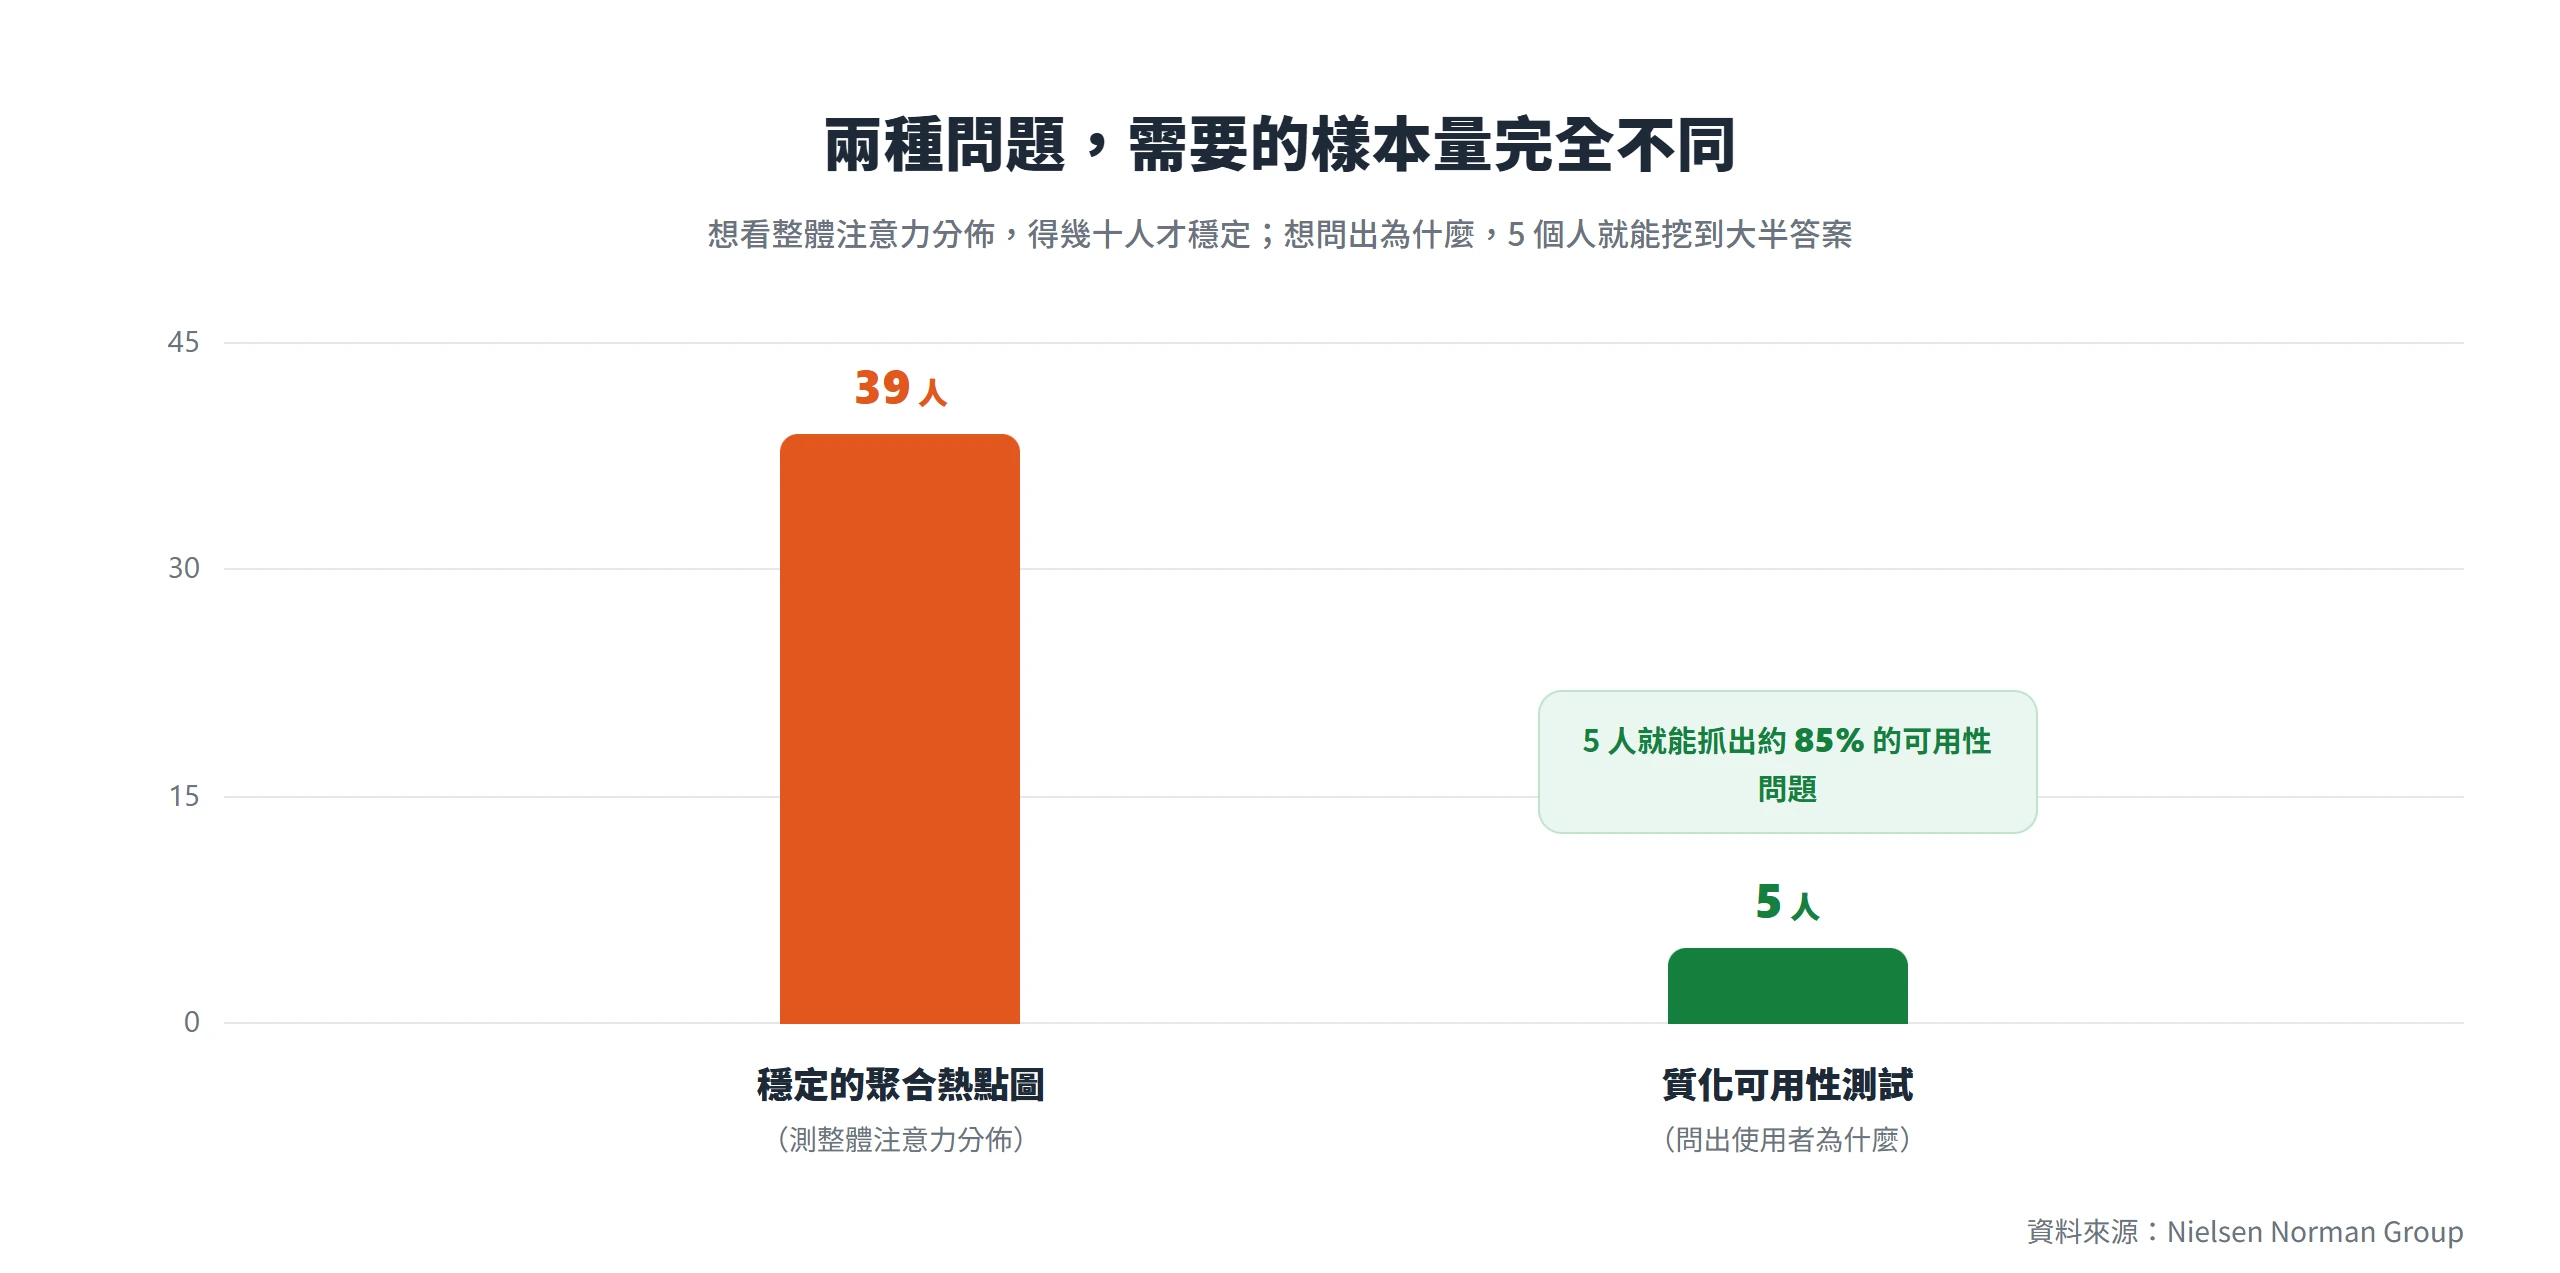
Nielsen Norman Group 創辦人 Jakob Nielsen 在 2012 年一篇談可用性測試該找幾位使用者的文章裡,對眼動追蹤給出具體的數字建議,要拿到穩定的熱點圖,建議測 39 位使用者。同一個機構另一篇由 Kate Moran 在 2017 年發表、聚焦標示物眼動實驗的文章也提到,聚合熱點圖需要相對大量的參與者才可靠,大約 30 人上下。這兩個數字都是眼動追蹤研究領域裡的具體建議值,不是網站點擊熱點圖工具訂出來的官方門檻,但聚合可視化需要足夠樣本才不失真這個統計原理是共通的,流量不高的頁面、剛上線沒幾天的版面,或是篩選條件縮到只剩一小群受眾的熱點圖,都可能只是雜訊被誤讀成規律。
對照之下,質化的可用性測試門檻低得多。Nielsen 另一篇更早、談「為什麼只需要測 5 位使用者」的經典文章也提到,5 位使用者的可用性測試幾乎就能拿到成本效益最高的回報,測到 5 個人時,通常已經抓出這個設計裡大約 85% 的可用性問題。這組對照值得記住,想知道使用者為什麼進行不下去,5 個人的訪談就能挖到大半答案;想知道整體注意力分佈長什麼樣子,才需要幾十人的規模。用錯方法去回答另一種問題,不管樣本多少都是白費工。
隨版面高度浮動的捲動熱區占比
捲動熱點圖上顯示的百分比,常被直接讀成「大家看到這裡就不看了,這條線以下沒人在乎」,但這個百分比其實是相對於那一頁的總長度算出來的,不同頁面的長度不一樣,百分比就不能直接拿來互相比較。同樣寫著 50% 的使用者捲到這裡,在一個很短的頁面和一個很長的頁面上,代表的實際內容量差了好幾倍。
比例之外,更常被忽略的是「摺線」(fold,使用者不用捲動就能看到的範圍)本身根本不是一條固定的線。同一個頁面在不同裝置、不同螢幕解析度、不同瀏覽器工具列高度下,摺線的實際位置都不一樣,拿同一份捲動熱點圖去跨裝置對照,基準本身就在浮動。Nielsen Norman Group 的 Therese Fessenden 在 2018 年發表的一篇文章裡,實測 120 位使用者、超過 13 萬次注視點,發現當年使用者平均把 57% 的頁面瀏覽時間花在摺線以上,74% 的時間花在前兩個螢幕頁面內,也就是往下捲動最多兩個螢幕高度的範圍,就已經吃掉四分之三的關注時間。這個數字比同一個機構 2010 年的舊資料明顯下降(當時測出 80% 的瀏覽時間集中在摺線以上),代表摺線位置與長頁面的關注比例,會隨著時代和版面設計風格改變,不是一條放諸四海皆準的鐵律。
同一篇研究也提出一個叫「假底線」(false floor)的現象要特別提防,版面設計得過於簡約、留白很大,容易讓使用者誤以為頁面已經到底,提早停止往下捲,即使下面其實還有重要內容。Fessenden 給的建議是用文字被刻意截斷這類視覺提示,明確告訴使用者下面還有內容,不要單靠留白和空間感去暗示頁面結束,留白多不代表內容少,但使用者很容易這樣誤判。
點擊次數多不代表使用者滿意或找到重點
一個區塊被點很多次,直覺的解讀是大家喜歡這裡、這個設計做對了,但同一種點擊模式背後,可能藏著完全相反的兩種情境。一種是使用者真的感興趣才點下去;另一種是使用者找不到想要的東西,對著不能點的元素、或標題跟內容對不上的連結,一次又一次重複亂點,這種挫折性的點擊在熱點圖上留下的痕跡,跟真心感興趣的點擊看起來一模一樣。
Nielsen Norman Group 的 Aurora Harley 在 2015 年一篇談「pogo-sticking」(來回彈跳式瀏覽)的文章裡,舉了一個很直接的例子:同一批使用者在新聞首頁上點了 5 則標題,如果 5 篇文章都讀得滿意,這是一次很好的體驗;如果 5 篇文章都因為標題誇大、內容文不對題而讓人失望,一路點回首頁再點下一則,這是一次很糟的體驗。這兩種南轅北轍的感受,點擊數字本身完全看不出差別,文章原文寫得直接,光靠計算點擊次數,無法區分這兩種情境。
還有一種更容易被忽略的成因:使用者對著看起來像可以點、其實不能點的元素重複點擊,加粗的文字、看起來像按鈕的色塊、只是純裝飾用的圖示。這類元素也會在熱點圖上疊出顯眼的熱區,但那其實是設計本身造成使用者困惑的訊號,不是這裡很受歡迎的證據。要分辨這兩種情況,單靠熱點圖辦不到,得回放個別使用者的工作階段錄影,或直接找幾位使用者做可用性測試,問清楚他們當下實際想點的是什麼、有沒有點到。
熱點圖只定位問題不解釋成因
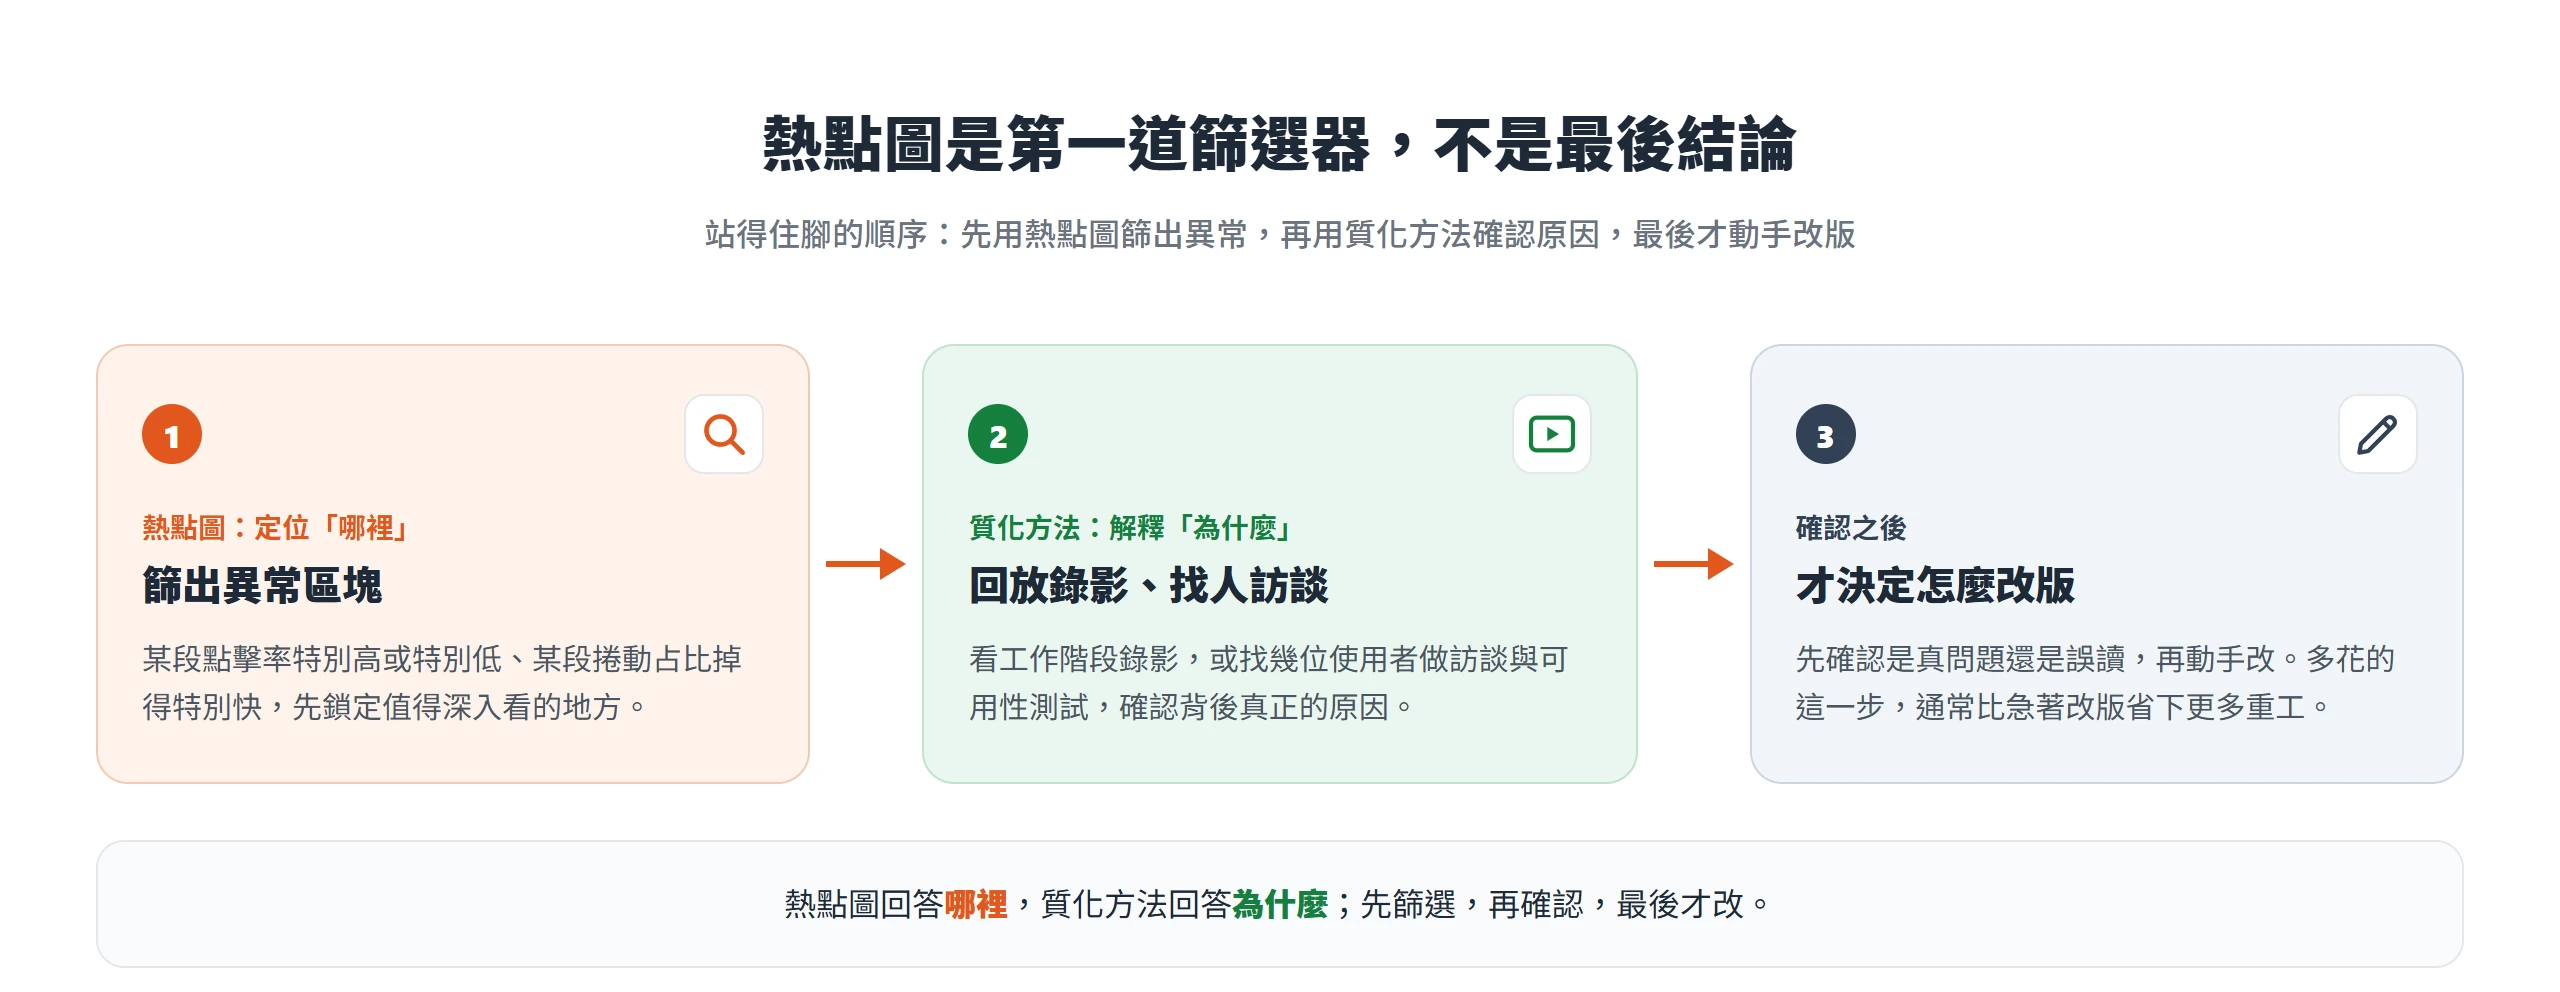
前面幾節攤開的幾個誤讀,收攏起來其實是同一個立場:熱點圖擅長的是「哪裡」,哪個區塊被點、被捲到、被滑鼠經過;它從結構上答不出「為什麼」,使用者為什麼點、為什麼在那裡停下來、為什麼放棄往下捲。要補上「為什麼」,得另外搭配工作階段錄影,一段一段看個別使用者實際怎麼操作,或是直接找使用者訪談、做可用性測試,讓研究者能追問、能觀察使用者卡在哪裡、能聽到使用者自己怎麼形容那個困惑。
實務上最常見的錯誤流程,是看了一眼熱點圖就直接動手改版,紅色深的地方保留放大,顏色淡的地方直接砍掉。比較站得住腳的順序應該反過來:熱點圖先發現異常,某個區塊點擊率特別高或特別低、某段捲動占比掉得特別快,再用工作階段錄影或訪談確認背後的原因,確認完是真的問題還是誤讀,才決定怎麼改。這中間多花的那一步訪談或錄影回放,通常比急著改版省下更多重工。
質化研究能做到量化數據做不到的一件事,觀察多位使用者是不是都卡在同一個地方,藉此確認一個現象是不是真的問題,而不是只憑一張圖去猜。Nielsen Norman Group 的分析同樣指出,量化資料連該往哪個方向改都給不出來,它只告訴你數字,不會告訴你下一步該調整設計裡的哪個環節。這也是為什麼不少組織偏好拿量化數據去說服管理階層,數字看起來客觀、有說服力,但真正驅動改版方向的洞察,多半還是來自質化研究裡那些具體的、聽得到使用者原話的觀察。熱點圖是假設產生器,不是答案本身。
該把熱點圖當成提問工具,不是答案本身
熱點圖真正該扮演的角色,是幫你快速篩出哪裡值得深入看的第一道關卡,不是拿來直接下結論的最後一步。它提出問題,這裡的點擊率為什麼特別高或特別低、這段捲動占比為什麼掉得特別快,但答案要靠別的方法去確認,回放工作階段錄影看實際發生了什麼,或找幾位使用者做可用性測試問清楚原因。把熱點圖顏色深淺直接當成使用者要的就是這個拿去改版,正是這篇想拆穿的核心迷思。
越是急著看到成效、想快點交出改版結果的團隊,越容易只看一眼熱點圖顏色就下結論,這種情境很容易理解,畢竟熱點圖看起來直觀,彩色的圖表比一頁訪談逐字稿好懂得多。但直觀不等於正確,顏色深淺告訴你的永遠只是「哪裡」,「為什麼」還是得靠人去問、去看、去聽。
熱點圖回答哪裡,質化方法回答為什麼,這條界線值得在每次打開熱點圖工具的當下先提醒自己一次。它是一個很好的篩選器,能幫你快速鎖定哪裡不對勁,但真正決定要怎麼改的那個判斷,終究得靠人回去看、去問,而不是靠一張顏色圖自己說話。