
多數人在拿捏這個問題時,想的是「分頁比較老派,載入更多比較現代」,把它當成一個介面美感的選擇題。這個問法本身就偏了。Google 的檢索器不會替一顆按鈕的手感評分,也不會因為畫面捲得順就多看幾眼,它認的東西單純到近乎無情,只看這批內容背後有沒有一個真實的網址,可以被直接連過去。
分頁(pagination)、載入更多(load more)、無限捲動(infinite scroll),乍看是要不要多點一次頁碼的體驗差異,對搜尋排名的影響卻可能天差地遠。選錯做法,足以讓一整批文章或一整批商品從搜尋結果裡消失,經營者自己還完全看不出來,因為使用者捲得到、點得到,畫面一切正常,唯獨檢索器走不到那批內容背後的網址。
分頁與載入更多本質上在解決同一個清單過長的問題
清單類網頁攤開來看,呈現方式其實只剩三種,而且解決的都是同一件事,清單本身太長,沒辦法一次塞進使用者眼前,勉強塞進去,效能只會變差,也超出瀏覽器與後端能負荷的量。
第一種是分頁,使用者靠上一頁、下一頁與頁碼這類連結,在多個網頁之間切換,每次只看到清單裡一個網頁份量的內容。第二種是載入更多,頁面上放一顆按鈕,點下去畫面在原地往下擴充,不用換頁,一次多顯示一批結果。第三種是無限捲動,使用者捲到目前畫面的底部,系統就接著自動載入下一批,理論上沒有終點,直到清單本身見底為止。
Google 的技術文件把這件事定義成使用者體驗的選擇,不是單純的技術選型,文件裡明講可以用其中一種模式來顯示大型清單的部分內容。文件也具體點出這種漸進式載入對使用者的好處,初步載入的速度比一次載入全部結果快,行動網路的流量用量也比較省;對後端而言,能減少從資料庫或類似資源擷取的資料量,連帶改善後端效能,也避免了清單太大直接把瀏覽器或後端系統的資源榨乾,導致整個頁面出錯。
只是這三種做法能不能被搜尋到,靠的不是介面設計得好不好,是背後有沒有一件更基本的東西。
搜尋引擎的檢索器只認得到網址連結,不是使用者的點擊與捲動
決定介面能不能被搜尋到的關鍵,在於檢索器怎麼讀取網頁。Google 的檢索器在爬網站、尋找要建立索引的網頁時,通常只讀取 HTML 裡<a>元素href屬性裡的網址;它不會去「點選」按鈕,通常也不會觸發需要使用者操作才能更新目前畫面內容的 JavaScript 函式。
換句話說,傳統分頁的每一頁,本來就是一個真實、獨立、能被連結指到的網址,檢索器只要照著<a href>一路走,就能走完整個清單。載入更多與無限捲動如果只靠 JavaScript 把新內容動態插進同一個網頁,卻沒有對應的真實連結,那些內容在檢索器眼中就等於不存在,它捲不到底,也不會替使用者按下那顆按鈕。
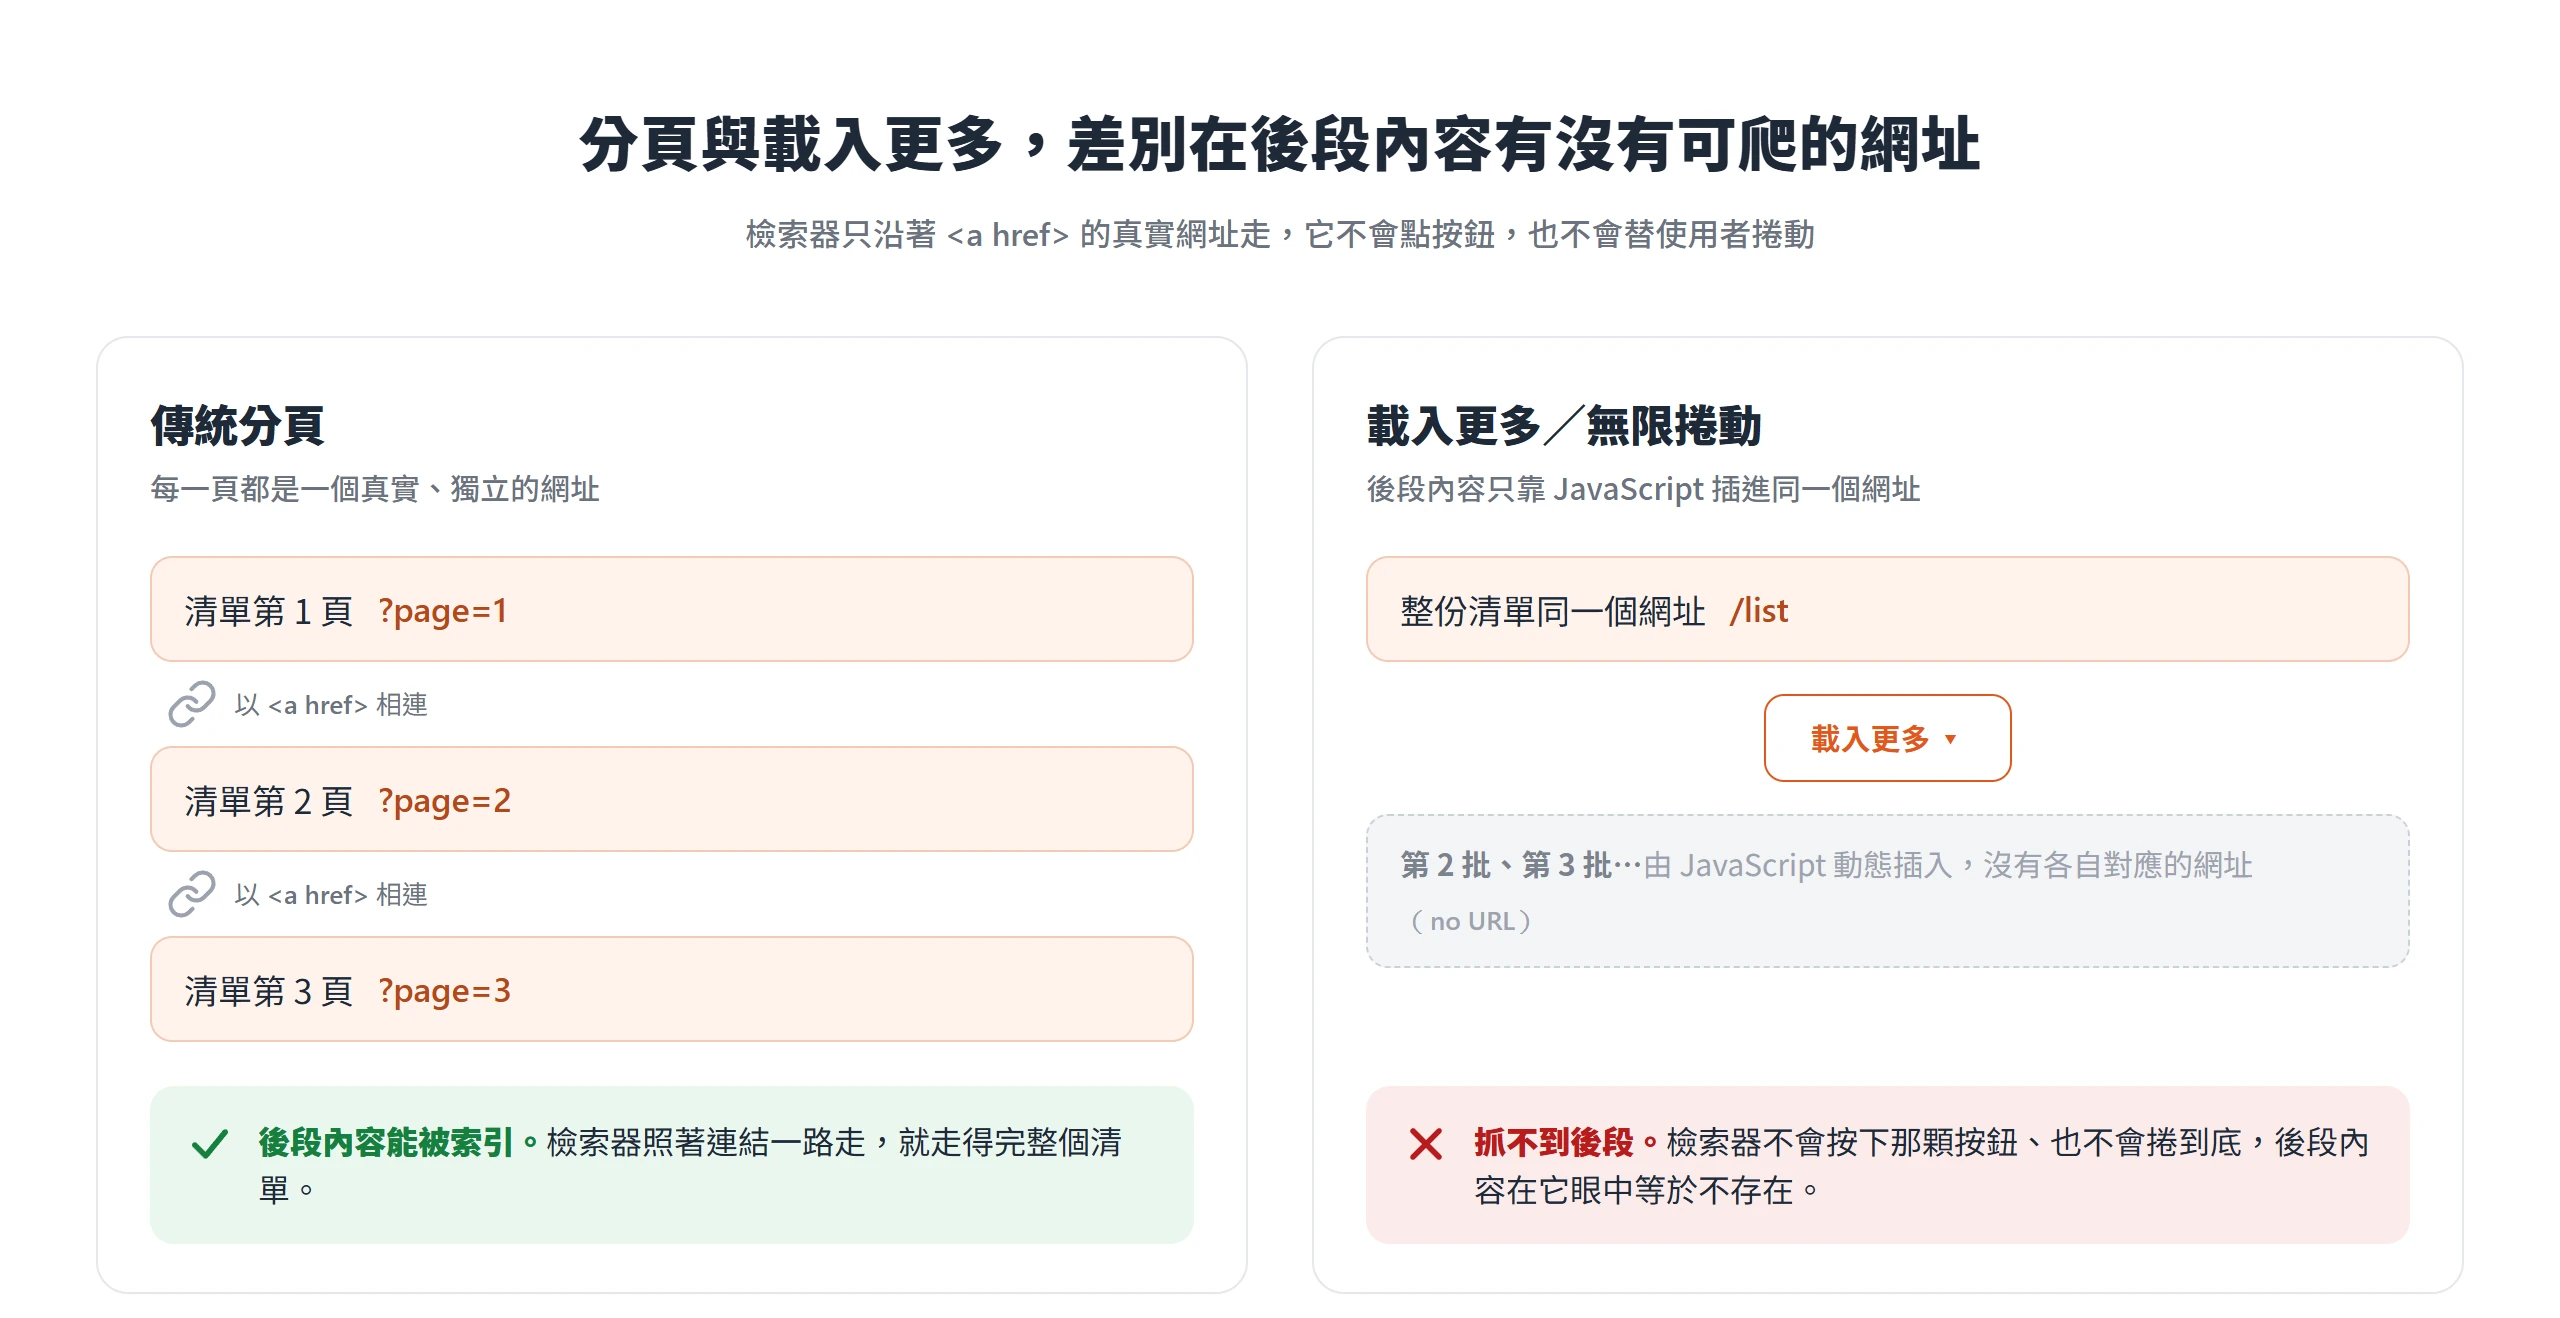
Google 的 John Mueller、Maile Ohye 與 Joachim Kupke 三人早在 2014 年就在 Google Search Central 部落格具名發表文章,公開示警過這件事。文章直接點出,在無限捲動的情況下,檢索器沒辦法穩定模擬使用者手動捲動畫面或點擊按鈕載入更多項目這類行為,所以不一定能存取到動態消息或圖庫裡的每一個項目,檢索器碰不到的內容,自然不太可能出現在搜尋結果裡。這句話說明的其實是不少網站真正踩過的坑,流量掉了一大截卻查不出哪裡出錯,問題根本不在內容品質,而在檢索器從頭到尾就沒看過那批內容。
真正的取捨判準是這份清單的後段內容需不需要被獨立索引
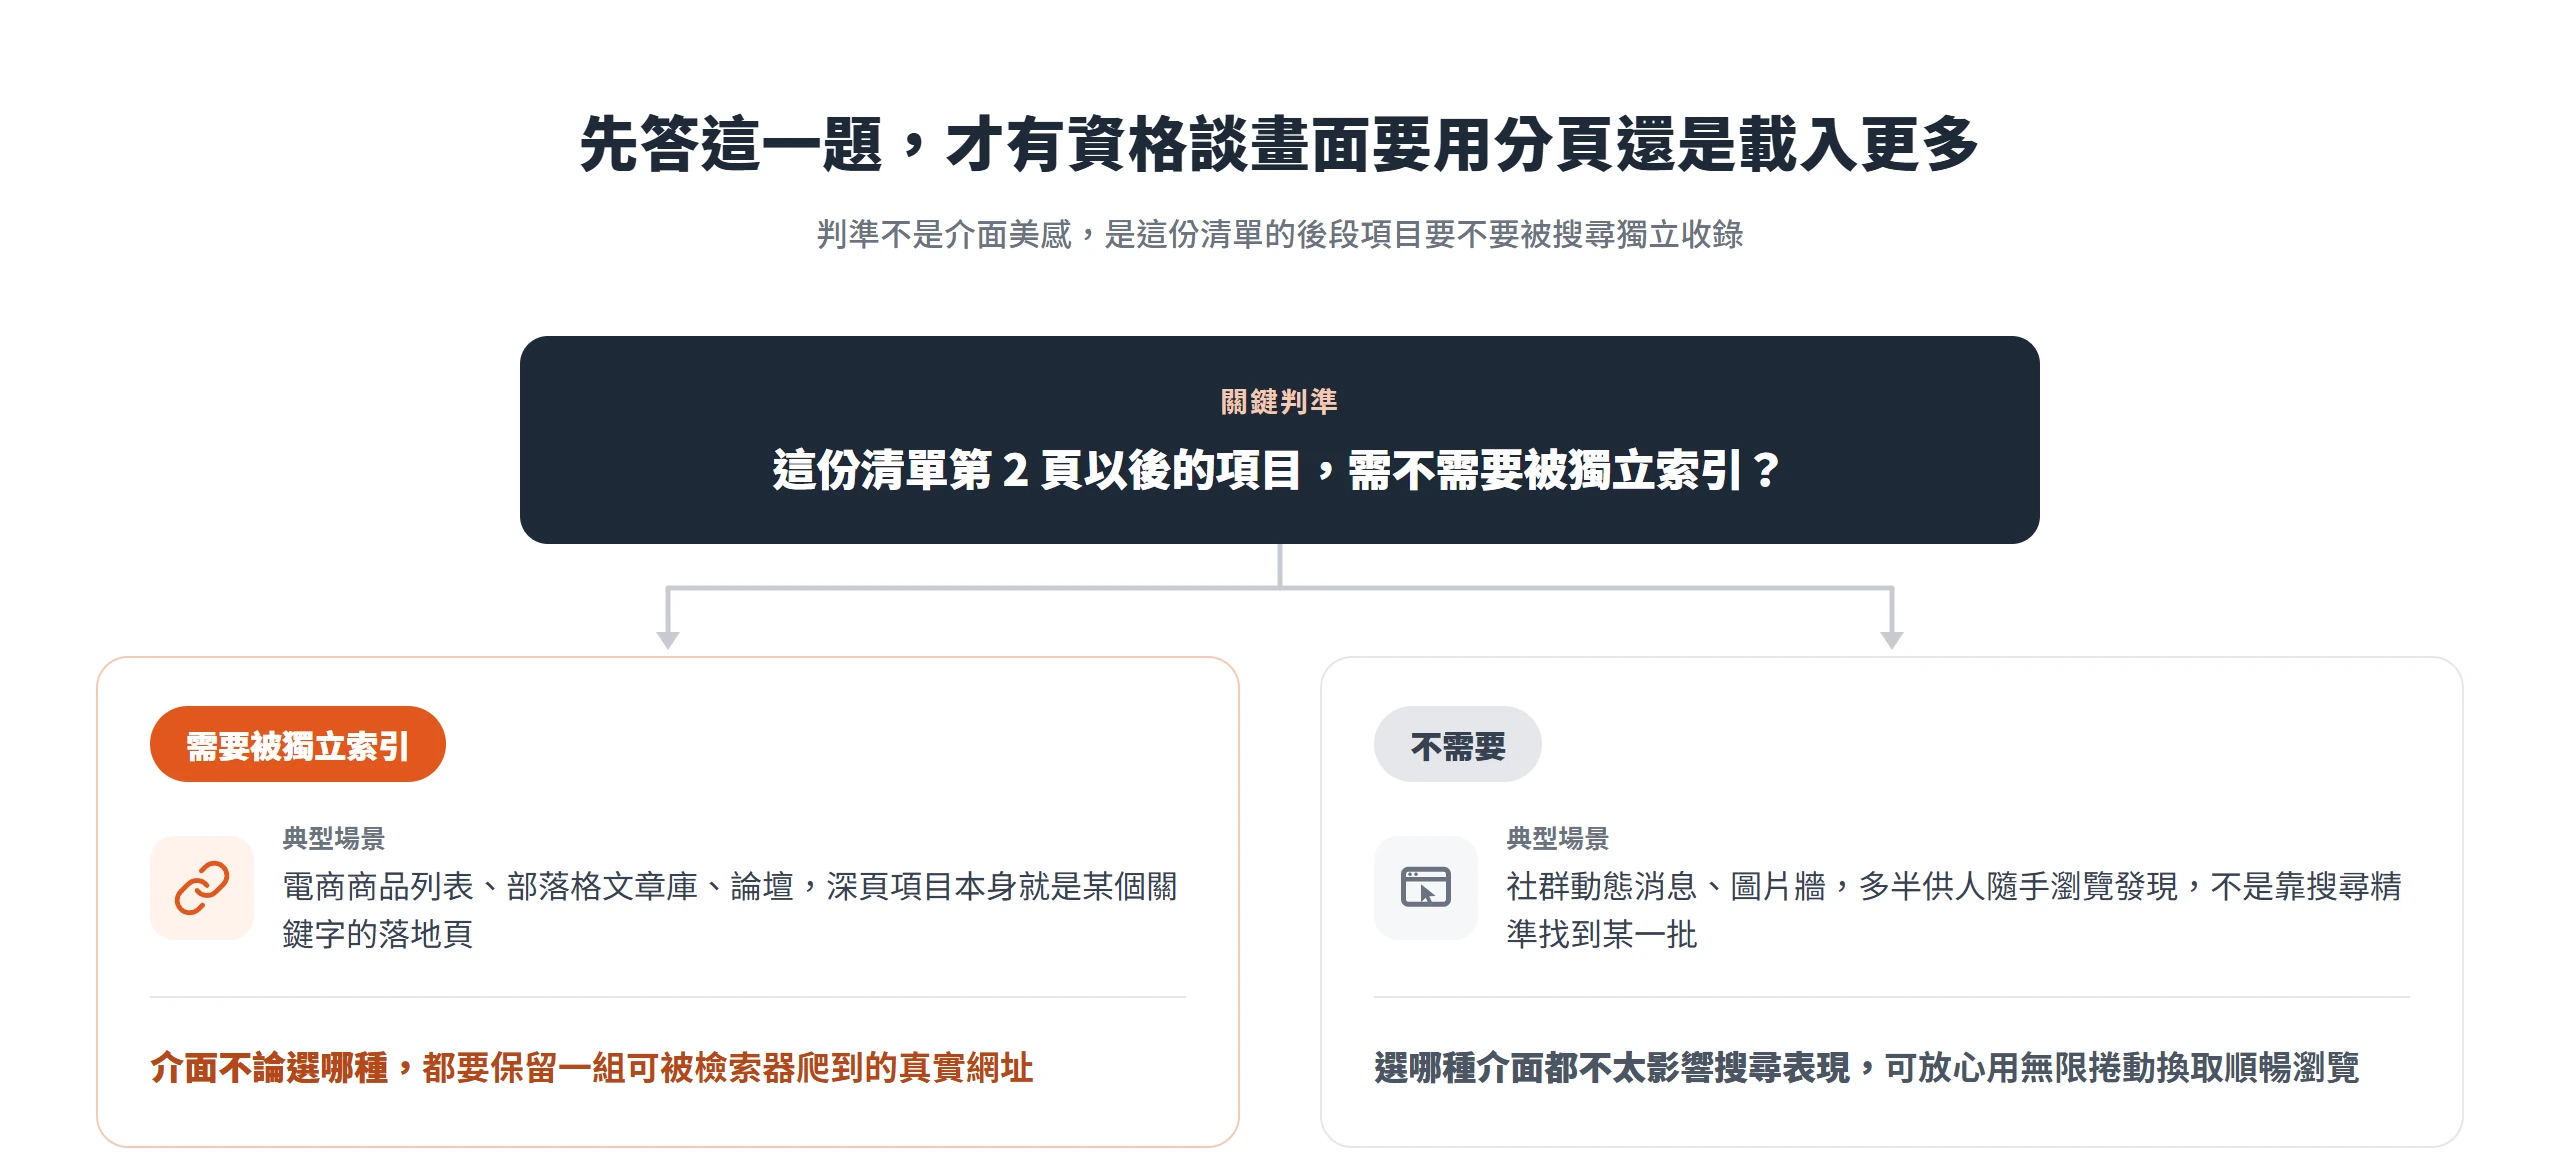
很多討論把這個問題問成「分頁跟載入更多,哪個對 SEO 比較好」,但這個問法本身就問錯了方向。三種模式都可以做到對搜尋引擎友善,只要背後配有可以被檢索器找到的真實網址;真正該問的問題是,這份清單裡第 2 頁、第 3 頁以後的項目,有沒有人會直接想找到它,需不需要被獨立收錄進搜尋結果。
答案不同,取捨就跟著不同。需要被獨立索引,介面選項就要繞著「保留可爬的網址」設計;不需要,選哪種介面都不太影響搜尋表現。電商與內容庫型的網站,跟純粹供人瀏覽的頁面,剛好落在這條線的兩端。
電商與內容庫的深頁,其實是某個關鍵字的落地頁
電商商品列表、部落格文章庫、論壇這類「清單本身就是內容庫」的網站,第 5 頁、第 10 頁裡躺著的具體項目,某件商品、某篇文章,本身就可能是某個長尾關鍵字要對應的目標頁面。如果這些項目從沒被檢索器爬到,等於這些項目永遠不會出現在搜尋結果裡,永遠等不到搜尋帶來的流量。
Google 的技術文件開場就是拿電商當例子:使用者用電子商務網站上的搜尋框查詢時,網站往往只能在回應裡先顯示一部分可用產品,因為完整的比對結果可能過於龐大,沒辦法一次顯示在單一網頁上。文件也列出電商網站常見的漸進載入情境,包括顯示某個分類底下所有產品的分類網頁、網站長期累積下來的網誌文章或電子報標題清單、產品網頁上的使用者評論,以及網誌文章底下的留言。這些都是官方點名「清單本身即內容庫、深頁需要被找到」的場景。這種情境下,介面不管做成分頁、載入更多或無限捲動,都必須確保背後有真實可爬的網址,對應到每一批項目。
純瀏覽情境不需要每一批內容都被搜尋看到
社群動態消息、圖片牆這類單純供人隨手瀏覽、發現內容的頁面,情況完全相反。使用者多半是從 App 內、社群分享,或已經在網站裡點進來的,不是靠搜尋引擎去精準找「某則貼文的第 8 批」。這種情境下,後段內容能不能被獨立索引根本不重要。
Google 在同一篇 2014 年的部落格文章裡也承認這類場景,指出一個網站的動態消息或圖片釘選牆很可能就是用無限捲動做的,而且使用者會很喜歡這種體驗。換句話說,官方自己也認同,以瀏覽發現為主、不是以搜尋落地為主的頁面,適合用無限捲動。選擇無限捲動、犧牲一點深頁可爬性換取更流暢的瀏覽體驗,是合理的取捨,不是偷懶。
載入更多背後仍要留一條可以直接連到的分頁網址
需要被獨立索引,卻又想保留載入更多或無限捲動這種畫面體驗,其實不是二選一。正確做法不是放棄這種介面改回傳統分頁,而是在畫面呈現方式不變的前提下,讓背後同時存在一組真實、可以被直接連結的分頁網址。使用者看到的還是點按鈕或往下捲動就能看到更多,檢索器看到的則是一組結構完整、可以逐一走訪的分頁序列。
Google 在 2014 年那篇文章裡給出的建議相當具體,要確保搜尋引擎能爬到無限捲動頁面裡連結的個別項目,網站或內容管理系統就要額外產生一組分頁序列,搭配無限捲動一起用,每一批內容各自對應一個真實網址。網址寫法上,用查詢參數或路徑會比較理想,例如以分類名稱加頁碼組成的網址,或是用某個識別碼標出目前位置;比較不理想的做法是用網址片段區分頁碼,因為片段本身不會被檢索器當成不同網址看待。
實作上,Google 也建議搭配瀏覽器的歷史操作機制,讓使用者做出類似點擊換頁的動作時,網址跟著更新,這樣使用者才能依序回頭瀏覽剛剛捲過的內容,也能把某一批內容加進書籤分享出去。做完之後,每個分頁網址都要能被單獨測試訪問,超出清單範圍的網址,例如頁碼遠遠超過實際頁數,也要確實回傳真正的 404 錯誤,而不是回傳一個看起來正常、實際上沒有內容的空白頁。
選了分頁不代表就自動對搜尋引擎友善
把鏡頭轉回傳統分頁,選對介面不等於做對了。分頁本身也有幾種常見的實作錯誤,會讓第 2 頁以後的內容從一開始就無法被索引,等於白白選了理論上對 SEO 最友善的介面,卻拿到最差的結果。
這裡也要澄清一個已經過時的舊建議:rel="next"與rel="prev"這組標記,過去曾被當成告訴搜尋引擎「這幾頁是同一個系列」的方式,但 Google 的 John Mueller 在 2019 年公開表示,這組標記已經不再用於索引與排名模型,Google 的技術文件也不再提到這組標記。現在加不加都不會影響排名,不必再花力氣特別維護;已經有這組標記的既有網站,也不必特地把它移除,因為它沒有壞處,只是不值得再投入心力。真正該注意的,是兩個後果嚴重得多的實作錯誤。
把第 2 頁以後 canonical 回第一頁,等於幫 Google 刪掉這些頁面
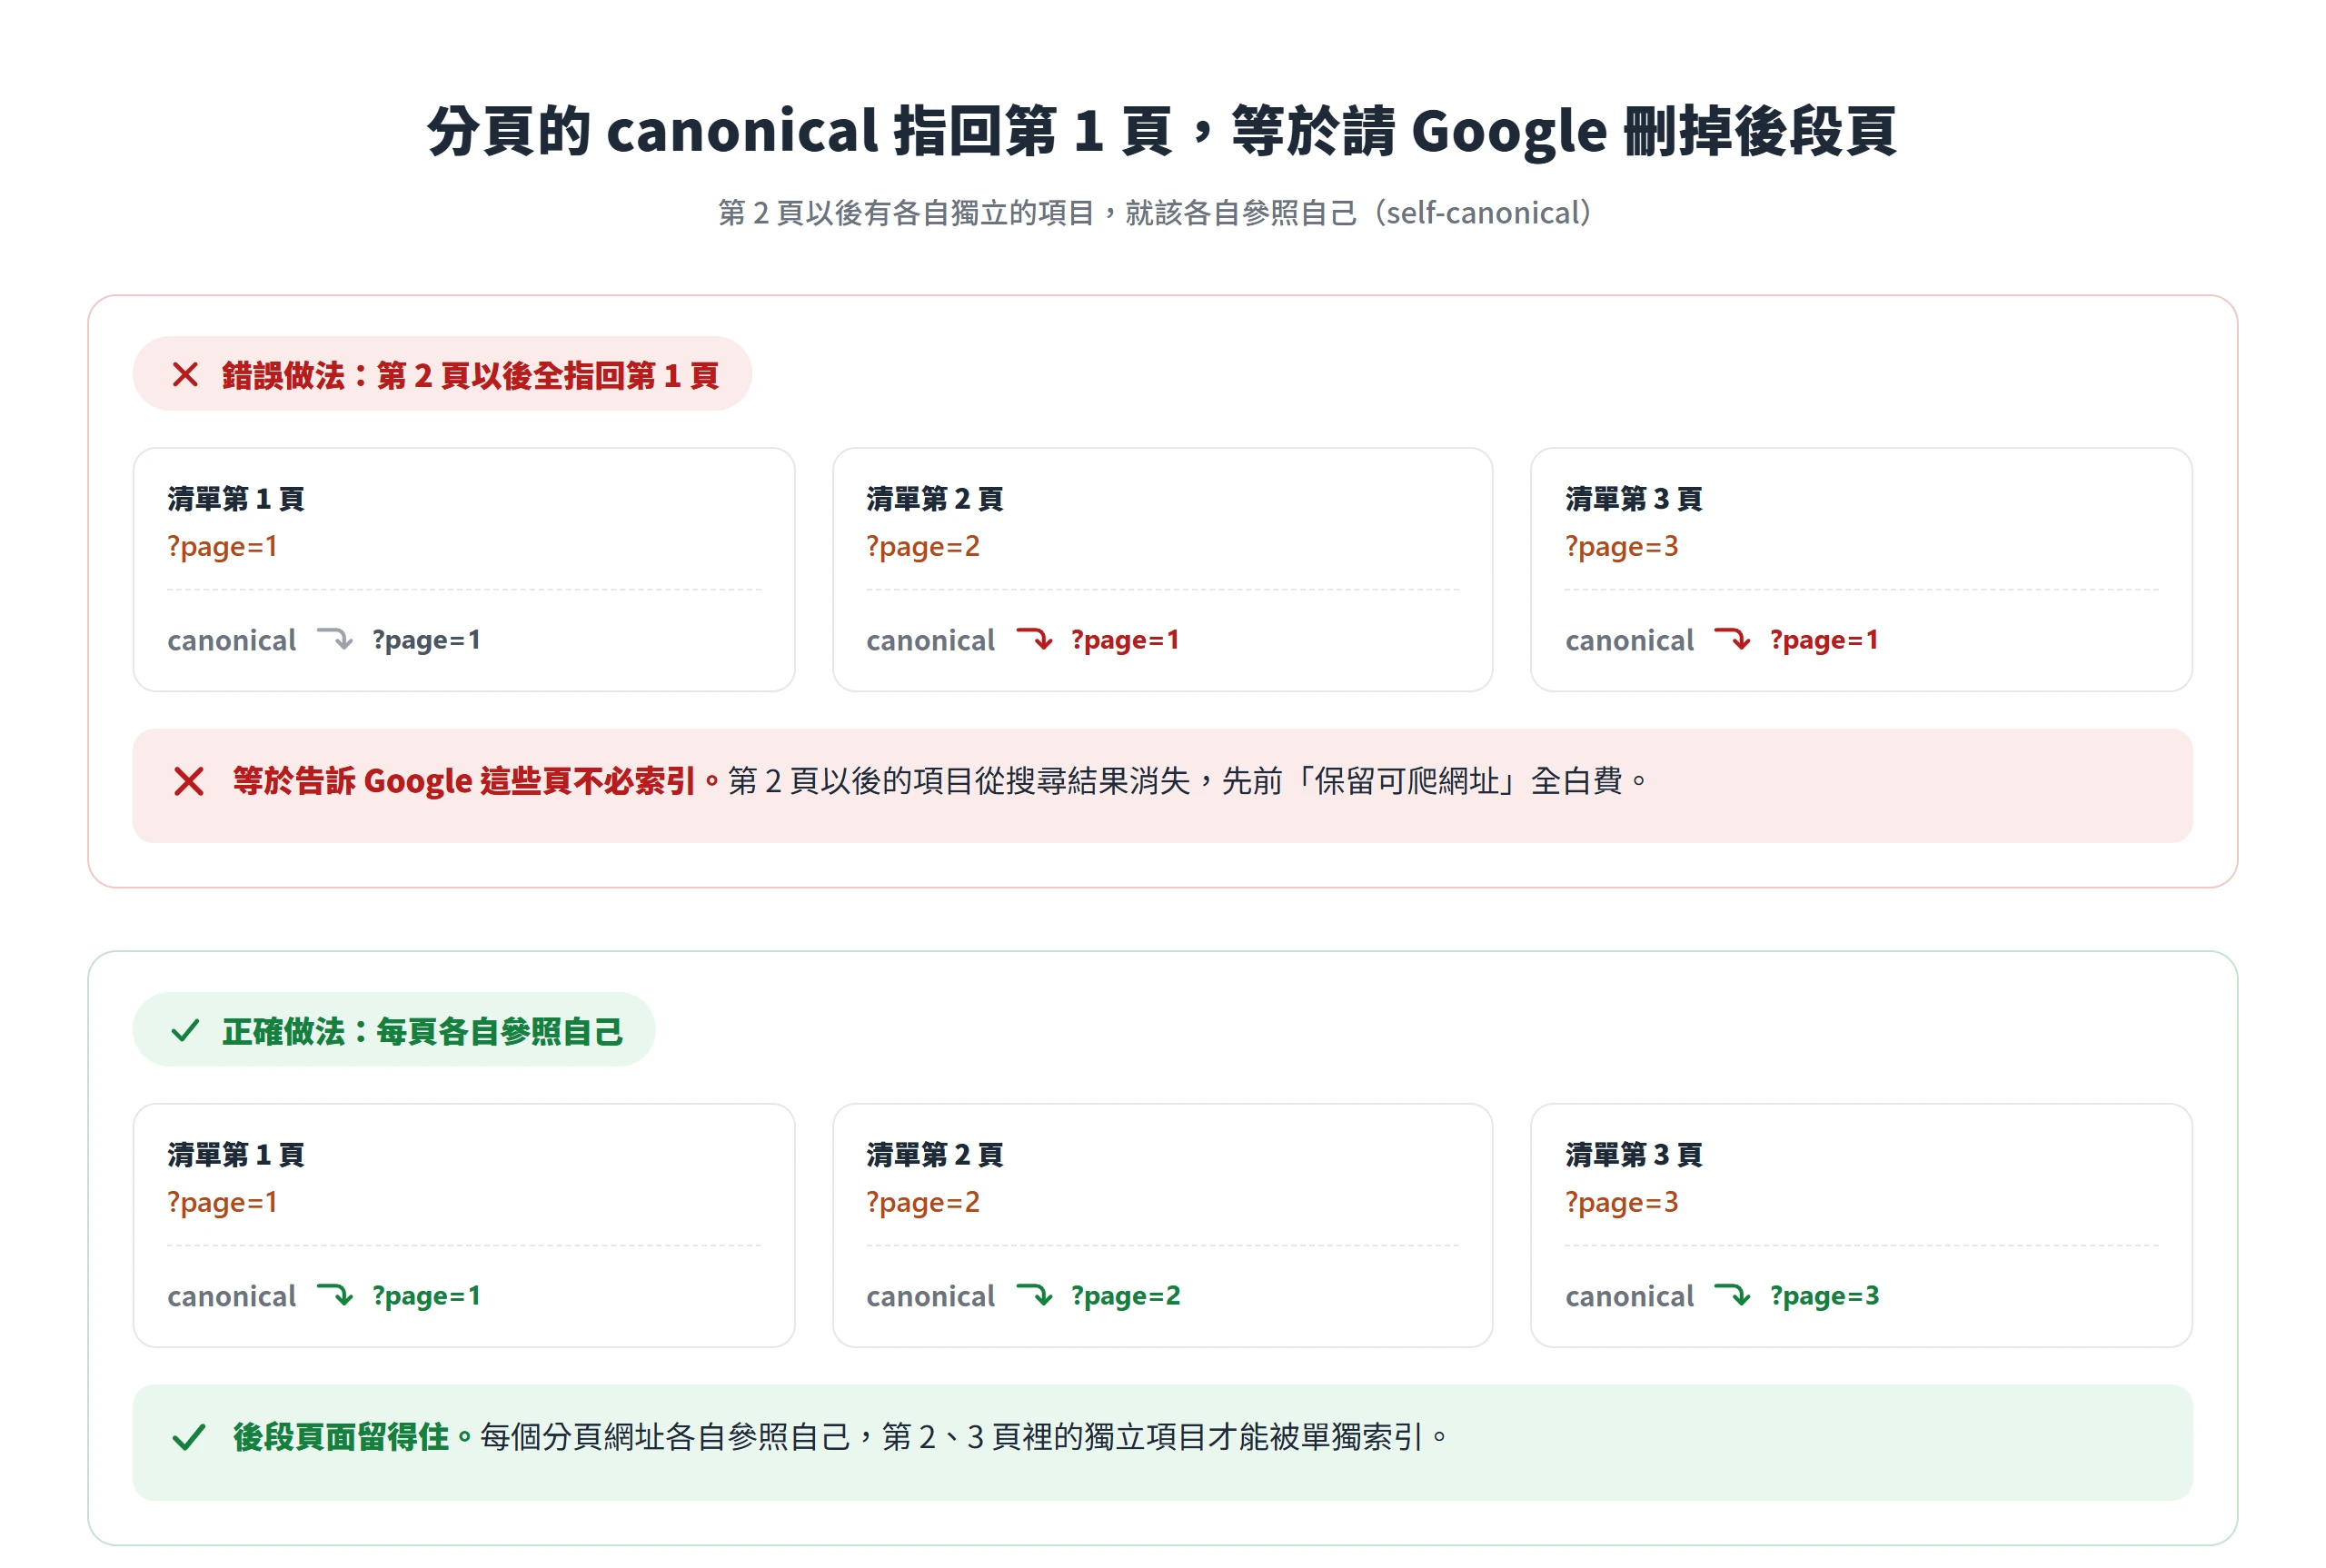
第一個常見錯誤,是把分頁序列裡第 2 頁以後的網頁,全部設定rel="canonical"指回第一頁。canonical 標記的作用是告訴 Google,這幾個網址內容重複,只要索引指定的那一個就好;一旦把第 2 頁以後都指回第一頁,等於明白告訴 Google 這些頁面不重要,不必索引,第 2 頁以後裡的項目就會從搜尋結果裡消失,前面努力做的「保留可爬網址」也整套白費。
Google 的技術文件在講怎麼正確使用網址時明確提醒,不要拿分頁序列裡的第一頁當標準網頁,而是要為每個網頁指定專屬的標準網址。正確做法是每個分頁網址各自參照自己,只有考慮把「純粹重複第一頁內容、技術上不得已」的變體網址指回原始網址時才例外,第 2 頁、第 3 頁這種有各自獨立項目的網頁,都應該是自我參照。
用#片段標記分頁頁碼,Google 一律忽略
第二個常見錯誤,是用網址片段,也就是網址裡#後面的文字,當作分頁頁碼的區分依據。這種寫法在檢索器眼中,#之後的內容會直接被忽略,等於所有分頁看起來都是同一個網址,第 2 頁以後的內容根本沒有機會被單獨爬到、單獨索引。
Google 的技術文件寫得很直接,請勿將網址片段標識做為清單中的頁碼,因為 Google 會忽略片段標識;如果 Googlebot 發現接續網頁的網址只有#之後的文字不同,很可能會判斷這是已經擷取過的網頁,也就不會再去瀏覽它的連結。同一份文件也給出對照組寫法,用查詢參數或路徑指定頁碼是可行的做法,只在網址片段裡放頁碼則是應該避免的寫法。
大型網站的分頁還要考量檢索預算夠不夠分配
把視角拉高到大型網站的層級,還有一個規模夠大才會浮現的進階考量,不是每一頁分頁變體都值得被索引,即使技術上可以做到全部可爬。Google 把這種資源限制稱為檢索預算,指的是 Google 有能力、也願意花在這個網站上的網址檢索數量。文件給出的參考門檻是,擁有超過 100 萬個不重複網頁、內容變動頻率適中的大型網站,或是擁有超過 1 萬個不重複網頁、內容變動極為頻繁的中型或大型網站,才需要認真把檢索預算當一回事;規模沒到這裡,多半不必特別煩惱這件事。
檢索預算真正吃緊時,該擔心的不是「還有多少內容沒被爬到」,而是「檢索器把時間花在哪裡」。Google 的文件點名的低價值網址例子之一,正是內容跟已連結網頁重複的無限捲動頁面,以及同一個頁面不同排序方式產生的多個版本——這類頁面本身沒有獨立的新內容,卻一樣要耗掉一次檢索。部落格常見的標籤頁、分類頁分頁變體,往往也是同樣性質,跟主要清單頁高度重複、內容單薄,若網站規模夠大,把檢索資源花在這裡就是在排擠真正該被爬到的商品頁、文章頁。
Google 的文件並不建議用noindex來處理這類低價值頁面,因為 Google 仍然得先送出檢索要求,看到noindex標記之後才會放棄索引,等於檢索的時間已經花掉了,白白浪費;真正有效的做法是用 robots.txt 直接封鎖這些網址,讓檢索器一開始就不去讀取它們,把省下來的檢索資源讓給真正該被爬到的主要清單頁與內容頁。
不是所有檢索器都能等到 JavaScript 把內容補齊
傳統分頁與用 JavaScript 動態載入內容之間的取捨之外,還有一層容易被忽略的變數,就算是 Google 自己,遇到需要執行 JavaScript 才會出現內容的頁面,也不是檢索當下立刻就能看懂,得先把頁面排進佇列等候轉譯。
Google 的技術文件把處理 JavaScript 的流程拆成檢索、轉譯、建立索引三個階段,並說明所有提供 200 狀態碼的網頁都會被送進轉譯佇列,不論頁面上有沒有 JavaScript 都一樣;網頁可能在這個佇列裡停留幾秒,但也可能需要更長的時間。文件在結尾也講得很直接,仍然建議採用伺服器端轉譯或預先轉譯,讓使用者和檢索器都能更快速地瀏覽網站,而且不是所有的檢索器都能執行 JavaScript。
這代表把清單內容留在只有 JavaScript 動態插入、沒有對應真實網址的狀態,付出的代價不會只算在 Google 頭上,其他沒有能力執行 JavaScript 的檢索器,會直接看不到這批內容,也就無從把它排進自己的索引。真實網址、伺服器端就能讀到的內容,才是對所有檢索器都成立的做法,不是賭 Google 最後總會把它轉譯出來。
清單要用分頁還是載入更多,從來不是介面美感的選擇,而是先答完「這批內容需不需要被找到」這一題,才有資格談畫面該怎麼做。答案是需要,不論選哪種介面,都要留住一條檢索器走得到的真實網址;答案是不需要,無限捲動帶來的順暢瀏覽體驗,本身就是值得的取捨。把這一題想清楚了,接下來要不要加 pushState、要不要顧慮檢索預算,都只是把這個判斷落實到細節而已。