多數團隊在評估要不要改成 Headless 架構時,問的是「前端框架要不要跟上」;真正決定 SEO 表現的,其實是網站有沒有把伺服器端渲染這件事做對。Headless 架構把內容管理系統(CMS)與畫面呈現拆成兩套獨立系統,CMS 只負責出內容 API,畫面要交給另一套前端框架自己決定怎麼渲染成使用者看到的網頁。傳統一體式 CMS(像標準 WordPress)則是換頁就直接吐出完整 HTML,內容管理與畫面渲染綁在同一套系統裡。
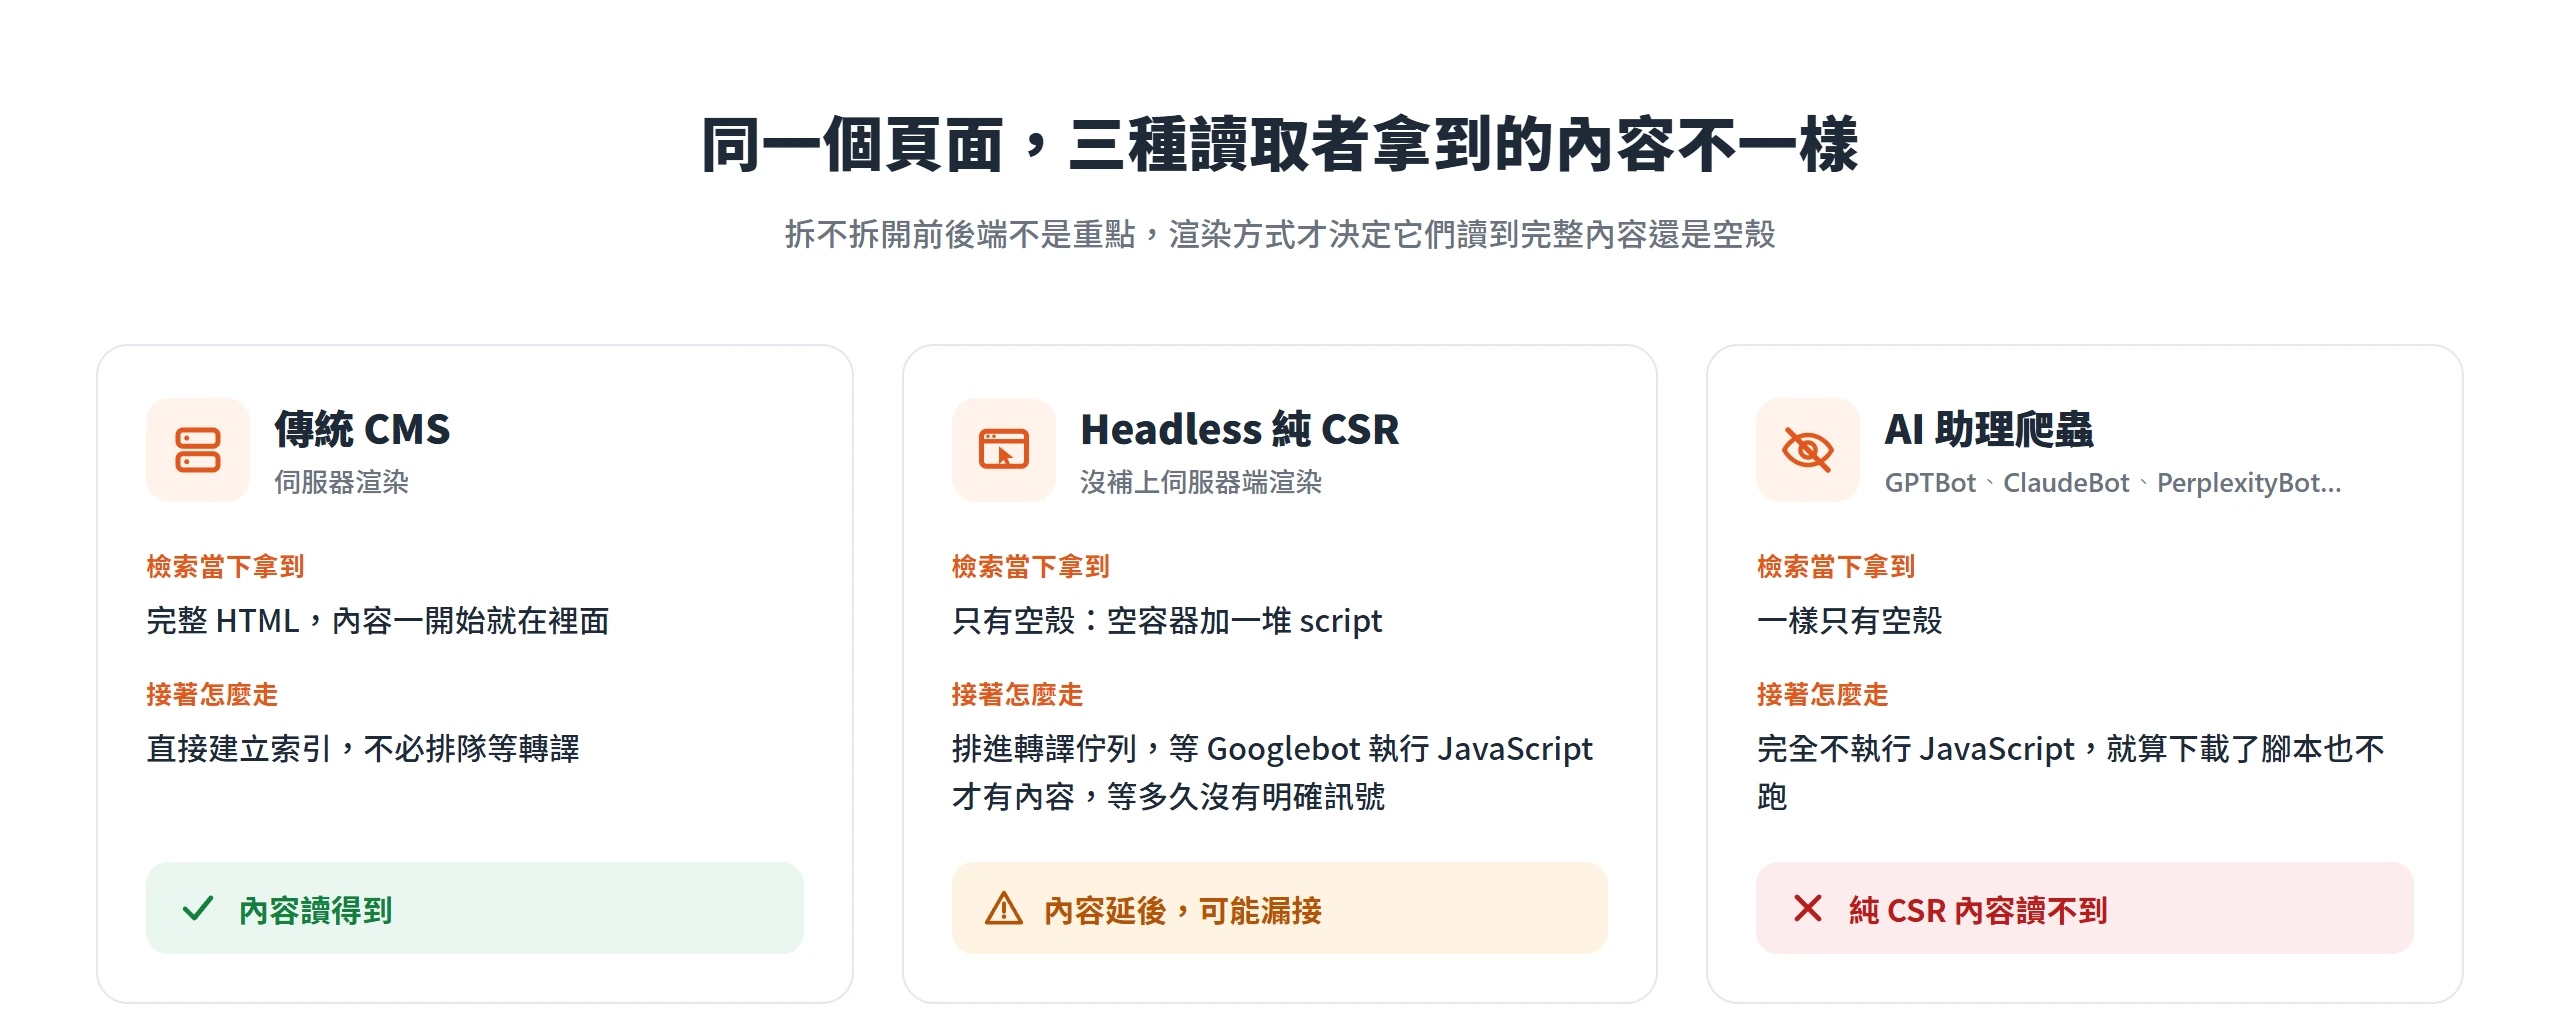
這個「拆開」本身不會讓 SEO 變差——真正決定結果的是拆開之後,前端選擇用哪種方式把資料變成畫面。如果前端框架靠純 JavaScript 在瀏覽器裡把內容跑出來,Googlebot 拿到的第一份回應可能只是一個空殼;等主流 AI 助理的爬蟲不會執行 JavaScript 這件事攤開來看,這個取捨的重量還會更大。我們幫客戶做內容型、行銷型網站時,預設不會為了跟上架構趨勢就改成 Headless,除非有具體理由撐得住多出來的工程與維運成本。先從「拆開」這件事本身,跟傳統 CMS 有什麼差異講起。
內容型網站不會為了跟上架構趨勢改成 Headless
Headless 與傳統 CMS 的差別不在「先進不先進」,而在資料流向哪裡才變成畫面。傳統一體式 CMS,比如標準的 WordPress,後台存的內容跟前台顯示的頁面是同一套系統管的,編輯按下發佈,伺服器立刻把資料庫裡的內容組成完整 HTML,訪客與搜尋引擎拿到的都是同一份成品。Headless 把這件事拆成兩套系統,CMS 這一端只負責透過 API 把內容吐出來,至於這份資料要變成什麼樣的畫面、用什麼技術渲染、渲染要在伺服器上做還是留給瀏覽器做,全部交給另一套前端工程自己決定。
這個「拆開」的立場不是「Headless 不能用」,而是多數案子沒有理由承擔這筆多出來的工程。內容型、行銷型網站要的東西並不複雜:頁面穩定被收錄、標題描述正確顯示、載入速度夠快。傳統 CMS 幾乎把這幾件事都內建好了,換成 Headless 之後,這些原本附贈的東西要自己重新接上,接得完整,SEO 表現不會變差;接漏一項,問題不會馬上反映在畫面上,而是安靜地出現在收錄率與排名裡。這也是為什麼判斷一個網站該不該上 Headless,不能只看前端團隊想不想用 React 或 Vue,得先問清楚渲染這一關打算怎麼處理。
真正決定 SEO 結果的,從來不是「有沒有拆開前後端」這件事本身,而是拆開之後的渲染方式。先看 Google 怎麼處理一個網頁,才看得懂為什麼渲染方式會決定一切。
檢索與轉譯拆成兩個階段,Googlebot 不會馬上看到內容
Google 處理一個網頁,分成三個階段:檢索(crawling)、轉譯(rendering)、建立索引(indexing)。Google 在官方文件《瞭解 JavaScript 搜尋引擎最佳化 (SEO) 基礎知識》裡明講:「Google 的 JavaScript 網頁應用程式處理作業分成三個主要階段:檢索、轉譯、建立索引。」關鍵在於,檢索與轉譯是兩個分開的佇列,不是同一個動作的兩個步驟。
傳統伺服器渲染的頁面,HTTP 回應裡本來就是完整 HTML,Googlebot 檢索完就能直接解析內容,不用等第二關。純前端渲染的 Headless 頁面則不一樣,第一次拿到的 HTTP 回應可能只是一個空殼,真正的內容要等這個網頁被排進轉譯佇列、Google 的運算資源允許時,才會由無頭 Chromium 執行 JavaScript 把內容跑出來。同一份文件寫道:「除非 robots meta 標記或標頭告知 Google 不要建立網頁索引,否則 Googlebot 會將所有提供 200 HTTP 狀態碼的網頁排入轉譯佇列……在 Google 資源允許的情況下,無頭 Chromium 會轉譯網頁並執行 JavaScript……Google 也會利用經過轉譯的 HTML 來建立網頁索引。」也就是說,Headless 網站沒做好渲染時,問題不是「網站看起來不對」,而是 Googlebot 當下讀到的版本,跟使用者實際看到的版本是兩份不同的東西。
網頁進入轉譯佇列後的等待時間沒有明確訊號
上面那份文件還有一句更關鍵的補充:網頁「可能會在這個佇列中停留數秒,但也可能需要更長的時間。」這句話沒有給出具體的時間範圍,而這正是這一關最麻煩的地方——你不會收到任何通知,告訴你某個頁面還卡在轉譯佇列裡沒有被真正讀到內容。文件裡也直接承認這種不確定性:「網頁正在等待檢索及轉譯時,您無法透過任何明確跡象立即得知當下情況。」
傳統 CMS 完全不會踩到這個風險,因為它根本不靠轉譯佇列,HTML 一開始就是完整的,不用排隊等 JavaScript 被執行。Headless 若沒有做好伺服器端渲染,新頁面上線後的索引速度就會被這段看不見的等待時間拖慢。多數站方不會第一時間懷疑是渲染出了問題,通常要等新頁面上線幾週、排名遲遲沒有起色,才會回頭檢查轉譯後的 HTML 長什麼樣子。
純用戶端渲染讓最初的 HTML 幾乎不含內容
把這種只有空殼、沒有實際內容的原始 HTML 講成具體畫面會更好理解,使用者打開一個頁面看到的成品,跟 Googlebot 檢索當下拿到的原始 HTTP 回應,其實是兩份不同的東西。後者可能只有一個空的容器元素加上一堆 script 標籤,實際內容要等瀏覽器把 JavaScript 跑完,才會出現在網頁的 DOM 結構裡。web.dev 對純用戶端渲染(CSR)的定義說得很直接:「用戶端轉譯是指使用 JavaScript 直接在瀏覽器中轉譯網頁。所有邏輯、資料擷取、範本和路徑都會在用戶端處理,而不是在伺服器上處理……用戶端算繪可能難以製作,且難以維持行動裝置的效能。」
Headless 如果採用純 CSR 前端框架,卻沒有加上伺服器端渲染(SSR)或靜態產生(SSG),這正是最典型的風險樣貌。「拆開前後端」常常被拿來跟「SEO 變差」畫上等號,根源也在這裡。但這不是必然的結果,是「沒處理渲染」的結果。同一份文件也點出 CSR 對效能的連帶影響:「用戶端算繪的主要缺點是,隨著應用程式成長,所需的 JavaScript 量也會增加,進而影響網頁的 INP。」換句話說,渲染沒做對,踩到的不只是收錄,連使用者體驗的核心指標都會一起被拖累。
AI 助理的爬蟲目前完全不執行 JavaScript
把「渲染方式決定結果」這個判準延伸到 AI 搜尋,也就是本站常提的 GEO,會看到更大的落差。Googlebot 至少會執行 JavaScript,用無頭 Chromium 把頁面轉譯出來再建立索引;但目前主流 AI 助理背後的爬蟲完全不是這樣運作。Vercel 與 MERJ 在 2024 年 12 月發表的聯合研究監測了 nextjs.org 與 Vercel 網路上超過 5 億次 GPTBot 請求等真實流量數據,結論寫得很直接:「The results consistently show that none of the major AI crawlers currently render JavaScript.」研究列出的名單包括 OpenAI 的 OAI-SearchBot、ChatGPT-User、GPTBot,Anthropic 的 ClaudeBot,Meta 的 Meta-ExternalAgent,ByteDance 的 Bytespider,以及 Perplexity 的 PerplexityBot,這些爬蟲都讀不到純前端渲染出來的內容。研究也點出一個容易被忽略的細節:「ChatGPT and Claude crawlers do fetch JavaScript files (ChatGPT: 11.50%, Claude: 23.84% of requests), they don’t execute them. They can’t read client-side rendered content.」它們會下載 JavaScript 檔案,卻不會執行,等於白抓一份空殼。
例外是 Google 自家的 Gemini,研究裡寫道:「Google’s Gemini leverages Googlebot’s infrastructure, enabling full JavaScript rendering.」另一個例外是 Apple 的 AppleBot,研究指出它和 Googlebot 一樣透過瀏覽器式爬蟲執行 JavaScript。也就是說,一個 Headless 網站就算靠某些手段讓 Google 排名維持正常,AI 助理引用它的機率仍然很低,這是只盯著 Google 排名時最容易漏掉的一塊。Vercel 與 MERJ 給的建議也呼應這個結論:「Prioritize server-side rendering for critical content. ChatGPT and Claude don’t execute JavaScript, so any important content should be server-rendered.」重要內容一律要能在伺服器端就渲染完成,不能指望前端框架在瀏覽器裡把它跑出來。
傳統 CMS 內建的 SEO 基礎設施,拆開後要自己重建
多數人討論 Headless,焦點都放在「渲染快不快」,卻忽略了傳統一體式 CMS 其實默默幫你做好了一整組 SEO 管線:每一頁自動生成的標題與描述標籤、canonical 網址、隨內容自動更新的 sitemap、結構化資料。這些東西平常感覺不到它的存在,正是因為它一直都在。Headless 拆開前後端之後,這些不會自動跟著搬過去,要在前端這一側重新一項一項接上。接得不完整,問題不會立刻反映在畫面上,而是安靜地反映在收錄與排名裡。傳統 CMS 免費附贈的這幾樣東西,Headless 都要花工夫自己重新接上一輪,才不會等到收錄與排名出問題才發現漏接。
標題與描述能用 JavaScript 設定,但轉譯失敗就等於沒有
Google 官方文件明講,技術上完全可以用 JavaScript 動態設定 <title> 與 meta description:「只要提供獨特的描述性 <title> 元素和中繼說明,即可協助使用者迅速找出最符合個人需求的搜尋結果。您可以透過 JavaScript 設定或變更中繼說明和 <title> 元素。」這句話常被拿來當作前端動態插入標題描述沒問題的依據,但它有一個前提沒被講出來:轉譯要成功執行,這句話才成立。
傳統 CMS 因為 HTML 一開始就是完整的,標題與描述永遠都在,不需要靠任何額外動作才會出現。Headless 前端如果靠 JavaScript 動態插入這些標籤,一旦轉譯佇列延遲、腳本執行出錯,或是逾時被中斷,Googlebot 讀到的就是一份沒有標題描述的空白版本。而且這種失敗通常沒有警報跳出來提醒你,要主動用複合式搜尋結果測試或網址檢查工具,去看轉譯後實際產生的 HTML,才會發現標題描述根本沒有跑出來。
標準網址只能設定,不可用前端改到原始網址以外
canonical(標準網址)在 Headless 前端一樣可以用 JavaScript 插入,但 Google 官方文件劃了一條明確的紅線,不能用 JavaScript 把 canonical 改成跟原始 HTML 裡指定的網址不同的另一個網址。文件寫道:「您可以使用 JavaScript 設定標準網址,但請注意,您不應使用 JavaScript 將標準網址變更為原始 HTML 中指定的標準網址以外的網址。設定標準網址的最佳方式是使用 HTML,但如果必須使用 JavaScript,請務必將標準網址設為與原始 HTML 相同的值。如果無法在 HTML 中設定標準網址,可以使用 JavaScript 設定標準網址,並在原始 HTML 中忽略該網址。」
這是一條特別容易被前端工程師忽略的細節。傳統 CMS 的 canonical 邏輯通常內建在模板系統裡,一次設定就對全站生效,不會有例外。Headless 前端如果用不同的路由套件各自處理頁面,很容易出現某條路由的 canonical 跟伺服器端渲染出來的原始版本對不上的狀況,這種前後不一致,Google 可能不採用站方指定的網址,改由自己重新選一個它認為對的標準網址,結果往往不是站方原本想要的那一頁。
內容更新與前端部署分屬兩套系統,sitemap 容易跟不上
這一點是架構層面的推理,不需要外部數據佐證。傳統 CMS 裡,sitemap 通常跟內容存在同一套系統,內容一存檔,sitemap 立刻反映最新狀態。Headless 拆開後,內容存在 CMS 這一端,但把內容轉換成一個個網址、寫進 sitemap 的邏輯,卻要靠前端那一端的建置或部署流程去產生。
兩套系統各自有各自的更新節奏。前端如果沒有跟著每次內容異動重新產生 sitemap,例如採用靜態產生卻沒設定隨內容變動觸發重新建置,sitemap 裡列出的網址就會跟 CMS 裡實際存在的內容脫節,剛發佈的新頁面沒被收進去,早就下架的頁面卻還留在裡面。這種脫節不會讓網站馬上出問題,但會讓 Google 抓到的網址地圖,跟網站實際的內容結構越差越遠。
動態轉譯是 Google 自己定位的暫時補丁
既然前端渲染這麼麻煩,一個常見的折衷方案是動態轉譯,偵測進來的請求是不是搜尋引擎的爬蟲,是的話就另外給一份伺服器渲染好的版本,一般使用者則照舊拿到用戶端渲染的版本。Google 在官方文件《使用動態轉譯功能做為暫時替代方案》裡,把這個方法的運作方式與定位講得很清楚:「A dynamic rendering server detects bots that may have problems with JavaScript-generated content and serves a server-rendered version without JavaScript to these bots while showing the client-side rendered version of the content to users.」只要提供給爬蟲與使用者的內容相近,這個做法不算作弊;文件寫道:「Googlebot generally doesn’t consider dynamic rendering as cloaking. As long as your dynamic rendering produces similar content, Googlebot won’t view dynamic rendering as cloaking.」但如果送出完全不同的內容,那就是造假,文件裡也把這條界線標得清楚:「Using dynamic rendering to serve completely different content to users and crawlers can be considered cloaking.」
更重要的是 Google 對這個做法的長期定位。同一份文件直接寫道:「Dynamic rendering is a workaround and not a recommended solution, because it creates additional complexities and resource requirements.」並接著建議:「Instead, we recommend that you use server-side rendering, static rendering, or hydration as a solution.」動態轉譯是給暫時沒辦法做伺服器端渲染的網站用的過渡方案,不是建議長期使用的正式做法,Google 明確把伺服器端渲染、靜態渲染,或是 hydration(先在伺服器端渲染出完整 HTML,再交給前端接手處理互動)排在優先順序前面。
Headless 要嘛從一開始就把渲染做對,用 SSR 或 SSG 把完整 HTML 準備好;要嘛得接受用動態轉譯這種公認的權宜之計,而且明知道它遲早要被換掉。沒有第三條路能讓「前端渲染完全交給瀏覽器跑、又完全不影響 SEO」這兩件事同時成立。
這些條件成立時我們會建議直接採用 Headless
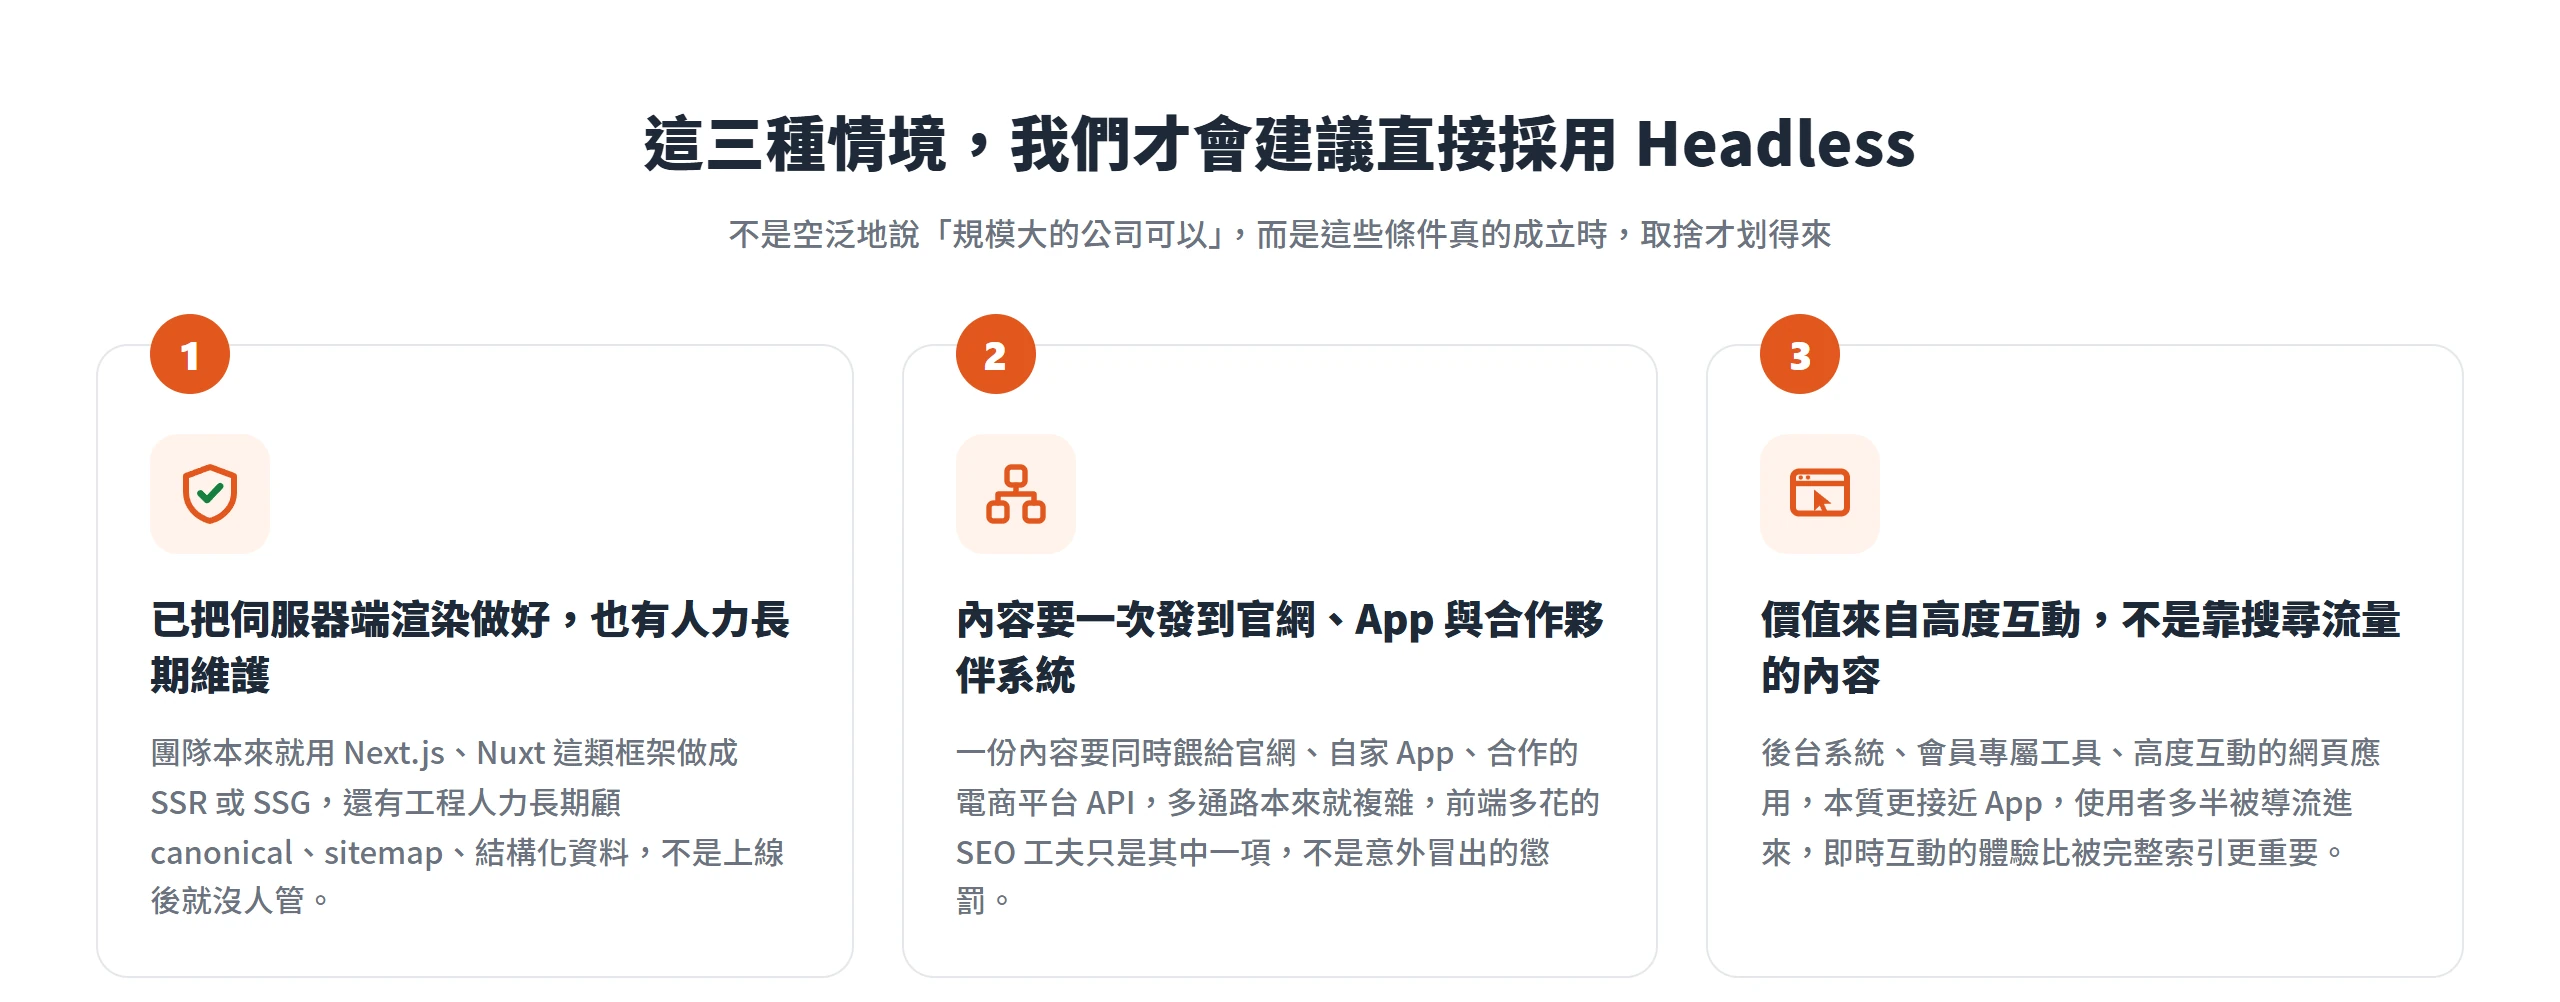
前面幾節談的風險都有一個共同起因,渲染沒有做對,或是基礎設施沒有接好。反過來說,只要這些條件真的成立,Headless 原本的優勢就能發揮出來,取捨的天平也會跟著倒向另一邊。以下三種情境,是我們會直接建議客戶採用 Headless 的判準,不是空泛地說「規模大的公司可以」。
團隊已經把伺服器端渲染做好,也有人力長期維護
如果團隊本來就用 Next.js、Nuxt 這類支援伺服器端渲染的前端框架,把畫面做成 SSR 或 SSG,而且有工程人力長期維護 canonical、sitemap、結構化資料這些環節,不是上線後就沒人管,前面幾節講的風險基本上都不成立。這時候 Headless 反而能拿到它原本設計時想給的優勢:更輕量的內容傳遞、更好的邊緣快取部署,以及跟 CMS 完全解耦帶來的前端開發彈性。
web.dev 對正確做好伺服器端渲染與靜態渲染的效益寫得很具體:「伺服器端轉譯通常會產生快速的 FCP……這有助於減少網頁的 TBT,進而降低 INP,因為載入網頁期間不會經常阻斷主執行緒。」對靜態渲染的評價更高:「只要限制網頁上的用戶端 JavaScript 數量,這種做法就能快速顯示 FCP,並降低 TBT 和 INP。與伺服器端算繪不同,由於網頁的 HTML 不必在伺服器上動態產生,因此這項技術也能持續實現快速的 TTFB……您可以將靜態算繪部署至多個 CDN,充分運用邊緣快取。」換句話說,把渲染這一關真正做對的 Headless 網站,效能表現不會輸給傳統 CMS,某些指標甚至更好。
內容要同時發到官網、App 與合作夥伴系統
Headless 的原始設計目的,就是一份內容、多個出口,CMS 只管內容,網站、App、第三方系統各自呼叫同一套 API 取資料、自己決定怎麼呈現。如果客戶的需求本來就是這種多通路情境,比如一個零售品牌要把同一批商品資訊,同時餵給官網、自家 App,以及合作的電商平台 API,那麼「網站前端要額外處理 SEO」這件工程成本,是換取多通路彈性必然要付的代價,不是意外冒出來的副作用。
這種情境下,就不該再拿「內容型網站」的標準去衡量這筆取捨划不划算,重新做一套內容管理系統去對接三、四個不同的出口,本來就比只服務一個網站前端複雜,SEO 這關要多花的工夫,只是這筆複雜度裡的其中一項,不是額外的懲罰。
網站的價值來自高度互動,不是靠搜尋流量進來的內容
不是所有網站都靠自然搜尋流量活。後台系統、會員專屬工具、高度互動的網頁應用程式,這些本質上更接近「App」而不是「內容頁面」,使用者多半是被導流進來的,像是廣告、品牌搜尋、內部連結,而不是靠 Google 對某個內容頁面的排名找到它。
web.dev 對這種情境給的建議是:「如果體驗使用用戶端算繪,並依賴大型 JavaScript 組合,建議考慮積極分割程式碼……對於互動程度低或沒有互動的體驗,伺服器端算繪可做為這些問題的更具延展性解決方案。」反過來看,互動程度高、體驗導向的網頁應用,考量的重點本來就跟內容型網站不一樣,用戶端渲染帶來的即時互動、不必重新整理頁面的體驗,比起被完整索引更重要,Headless 或 CSR 的取捨天平自然會往另一邊倒。
Headless 本身從來不是問題,問題出在拆開之後,渲染這一關有沒有真正做對。內容型、行銷型網站如果沒有把伺服器端渲染做好,也沒有人力長期維護前端這一側的 SEO 基礎設施,多出來的工程成本換不回等值的好處,反而要承擔轉譯佇列、標題描述失效、sitemap 脫節這些看不見的風險,而且在 AI 助理的爬蟲普遍不執行 JavaScript 的現況下,這筆風險只會更重,不會更輕。要不要改成 Headless,該先問的不是這個框架夠不夠新,而是團隊有沒有能力把伺服器端渲染做對、又能不能長期維護下去;答得出來,取捨才有意義。