
一個 10.93GB 的模型檔,要放進一張只有 12GB 顯存的顯卡,還得替 6.5 萬個 token 的上下文留位置。照 Unsloth 替 Qwen3.8-27B 整理的記憶體建議,3-bit 量化要 12~14GB、4-bit 要 16~19GB,一張 RTX 3060 連 3-bit 的下限都只是勉強碰到邊。Qwen3.8 27B 12GB 能不能跑,因此成了手上只有一張 12GB 顯卡的人最先想知道的事。
我們用 RTX 3060 12GB 搭配 llama.cpp 實際跑了兩天,結論是跑得動,生成速度約每秒 20 個 token、上下文開到 64K,長文裡藏的資訊也找得到。不過過程並不順,遇過伺服器啟動正常、第一次送請求就顯存不足崩潰,也遇過思考模式想了 28 分鐘、把我們設的 3 萬 token 輸出上限用光,最後一行程式都沒交出來。
顯存不足的崩潰,源頭是 12GB 的空間分配;思考 28 分鐘還沒寫出程式,則是慢硬體上的時間成本。在 12GB 顯卡上跑 27B,每一個啟動參數都是在這兩筆帳之間取捨。
27B 是 Qwen3.8 唯一的 dense 模型,放進 12GB 只能選 3-bit 以下量化
Qwen3.8-27B 是阿里巴巴 Qwen 團隊在 2026 年 8 月 14 日開放權重的模型,採 Apache 2.0 授權,除了文字也能看圖。Qwen3.8 系列目前在 Hugging Face 開放權重的有三個模型,另外兩個是總參數 2.4 兆的旗艦 2.4T-A95B 與總參數 1,250 億的 Flash-Next,都屬於 MoE 模型;27B 則是其中唯一的 dense 模型,也是體積最小、唯一有機會放進單張消費級顯卡的尺寸。
dense 的意思是每產生一個 token 都要用上全部 270 億個參數,不像 MoE 模型每次只啟用其中一部分。所以 27B 的權重沒有辦法「只挑常用的放顯存」,要跑得快,就得整份放進去。問題是 Qwen 在 Hugging Face 上放的 BF16 原版權重分成 18 個檔案、合計約 55.6GB,是 12GB 的 4 倍多;要把它縮小,最直接的做法就是量化,把每個參數用更少的位元來存。
Unsloth 在它的 Qwen3.8 文件裡列了各種量化位元對應的建議記憶體,指的是系統記憶體加顯存的總量:
| 量化位元 | Unsloth 建議記憶體 |
|---|---|
| 1-bit | 7~8GB |
| 2-bit | 9~11GB |
| 3-bit | 12~14GB |
| 4-bit | 16~19GB |
| 6-bit | 23~26GB |
| 8-bit | 31GB |
| BF16 | 56GB |
Unsloth 對 4-bit 的說法是可以在 16~19GB 顯存的顯卡上跑,舉的例子是 RTX 5080、4090 這一級。照這張表,12GB 顯卡要把模型整個放進顯存,只剩 3-bit 以下可以選。我們用的是 Unsloth 的 UD-IQ3_XXS,檔案 10.93GB(Hugging Face 以十進位的 GB 標示,換算成顯卡用的二進位單位約 10.18GiB),剛好落在 3-bit 建議下限的邊緣。Qwen3.8-27B 的能力表現與完整測試另有專文介紹。
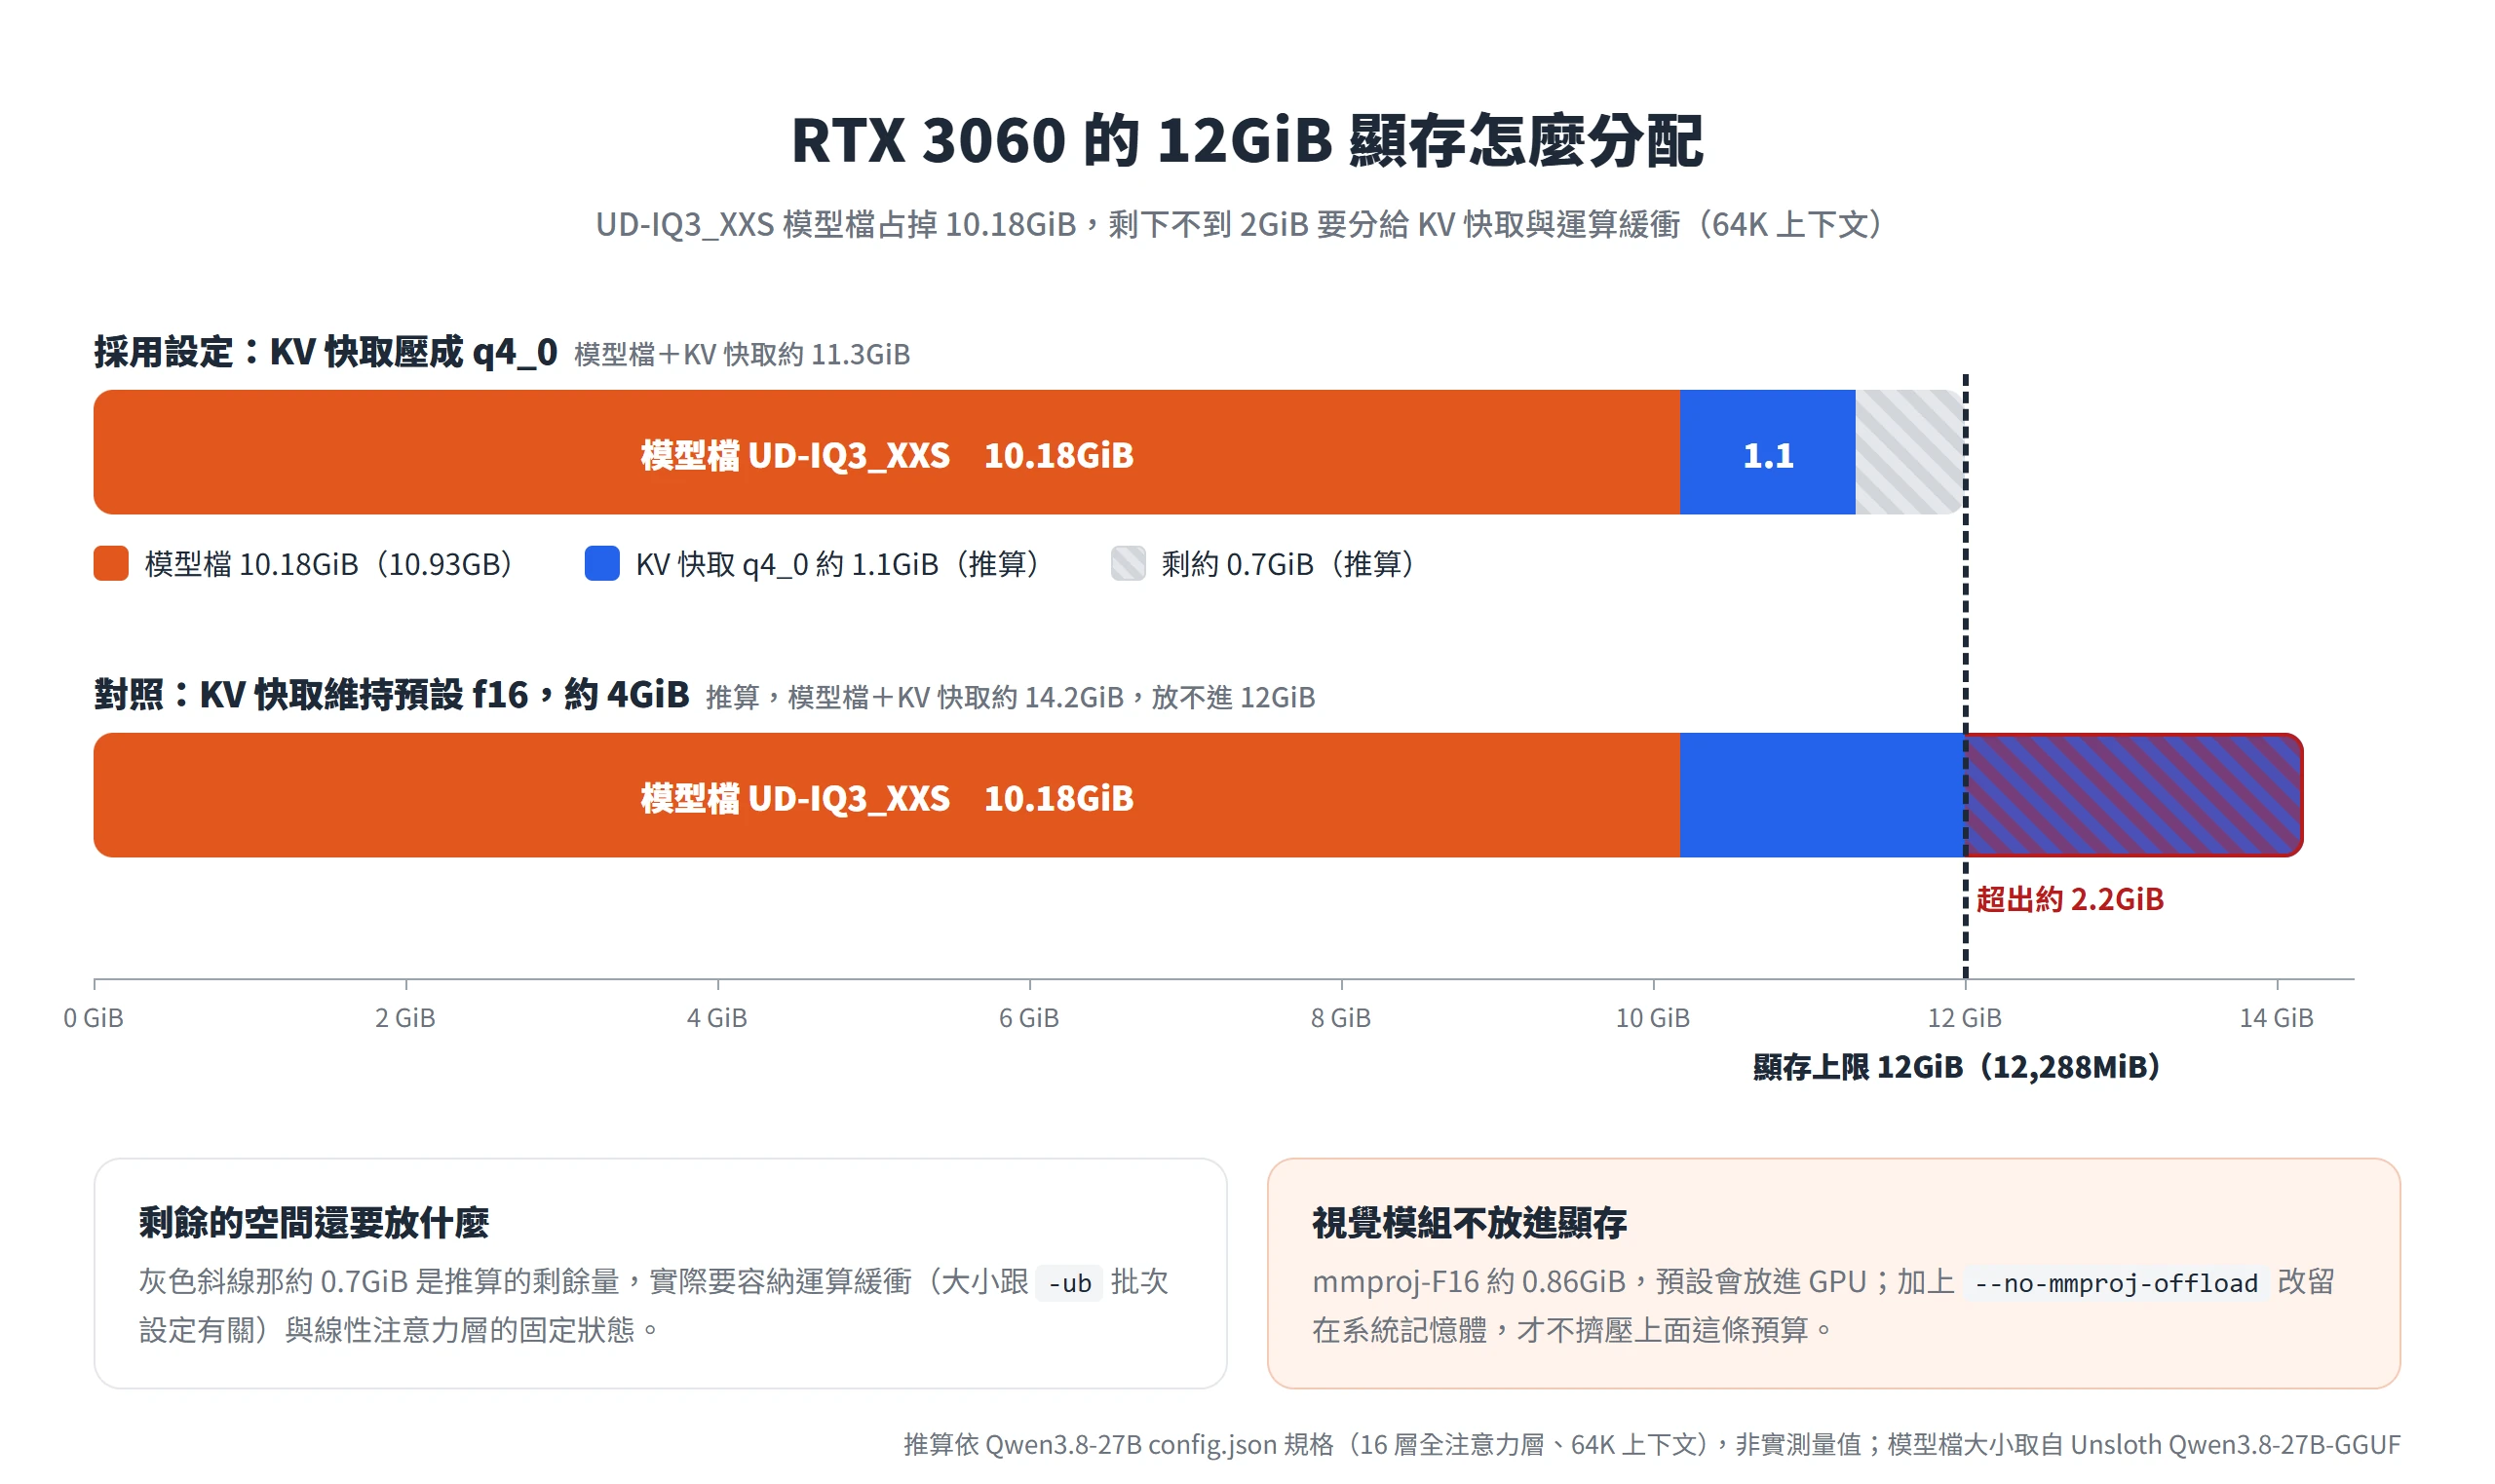
RTX 3060 的 12GB 顯存是 12,288MiB,也就是 12GiB。扣掉模型檔的 10.18GiB,剩下不到 2GiB,要分給另外兩塊一定得占的空間,一塊是 KV 快取,存放模型讀過的上下文,上下文開得越長就越大;另一塊是運算緩衝,llama.cpp 每次把一批 token 丟進 GPU 計算時要用的暫存空間,大小跟批次設定有關。llama.cpp 的每一個啟動參數,其實都是在模型檔、KV 快取、運算緩衝這三塊之間調配位置。
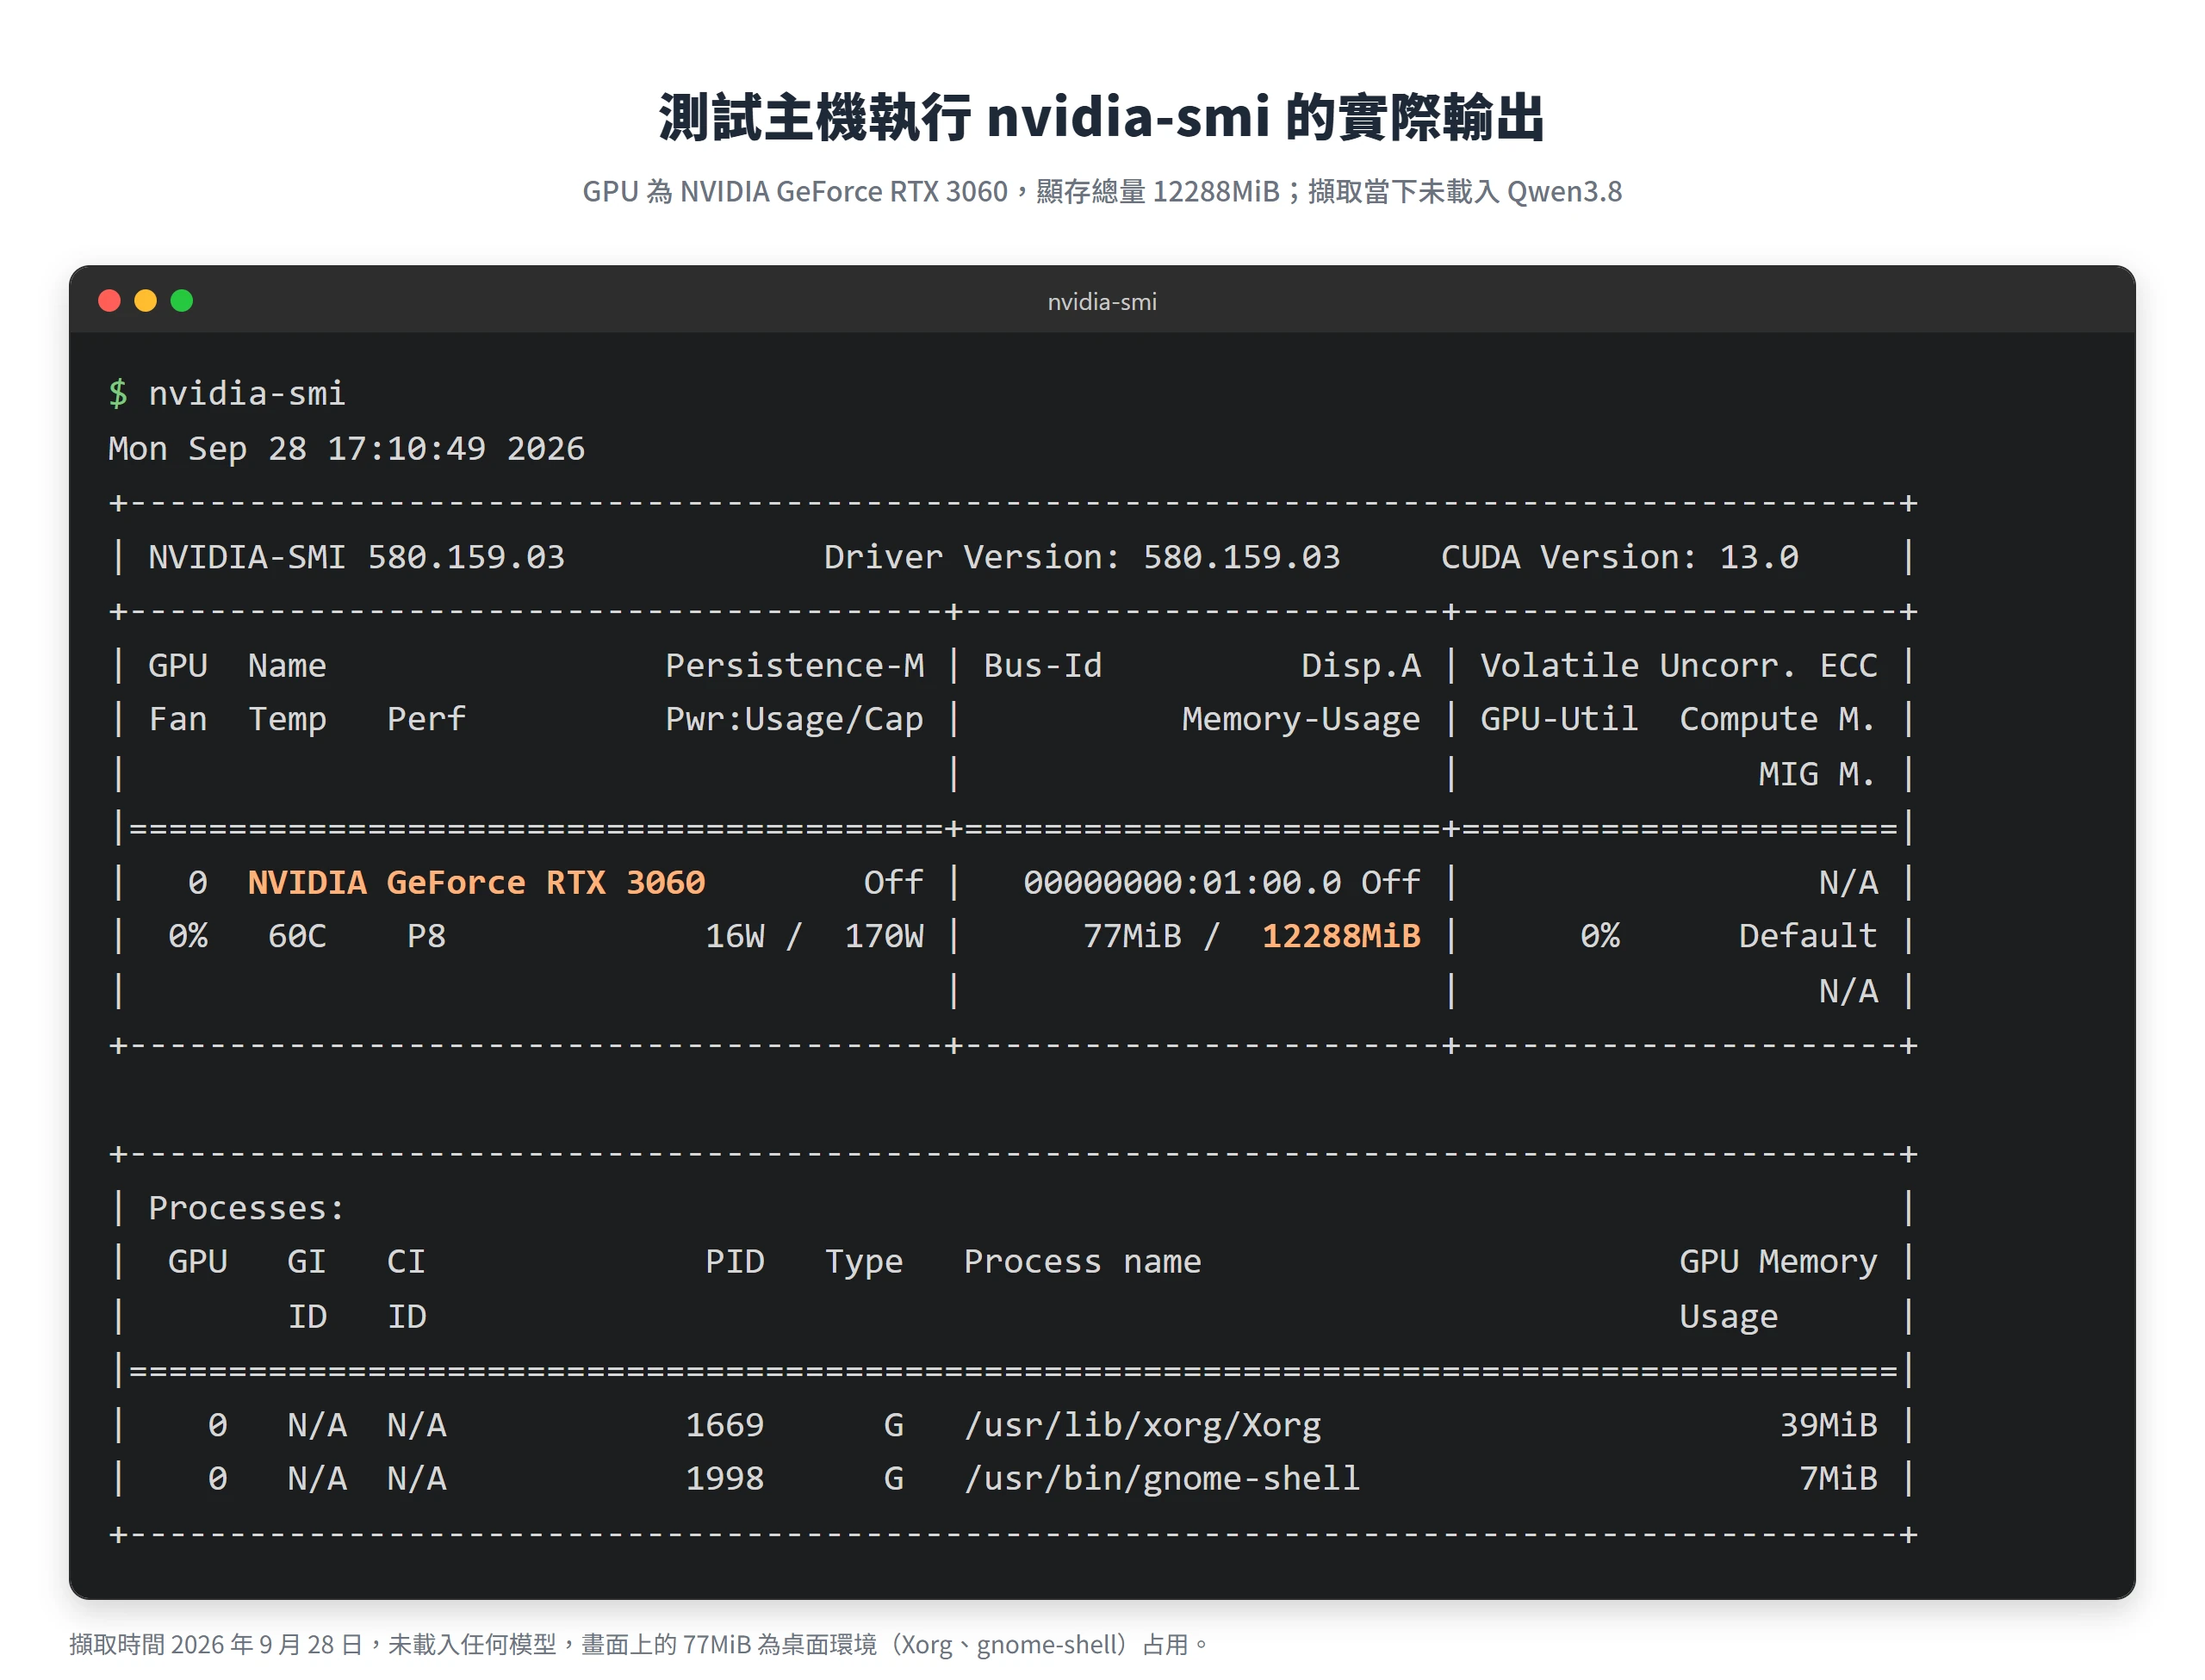
測試主機、llama.cpp 版本與量化檔
我們的實測全部在同一台機器上完成,規格是 Ubuntu 24.04、RTX 3060 12GB、系統記憶體 15GB,推論引擎是 2026 年 9 月 26 日版本的 llama.cpp(commit 81bc6b8),測試日期是 2026 年 9 月 26 到 27 日。模型主力用 Unsloth 的 UD-IQ3_XXS,另外拿 UD-Q2_K_XL 當對照;視覺模組用 mmproj-F16.gguf。
llama.cpp 不需要為 Qwen3.8 另外裝特別版本。Qwen 在模型卡上寫明 Qwen3.8 是建立在 Qwen3.5 的架構基礎上,模型設定檔 config.json 裡的架構名稱也仍是 Qwen3_5ForConditionalGeneration,所以原本支援 Qwen3.5 的 llama.cpp 可以直接載入。要提醒的是,這些數字只代表這台 RTX 3060 的表現,換成別張顯卡、別的驅動或更新的 llama.cpp,速度與顯存餘裕都可能不同。
UD-IQ3_XXS 和 UD-Q2_K_XL 的實測差異
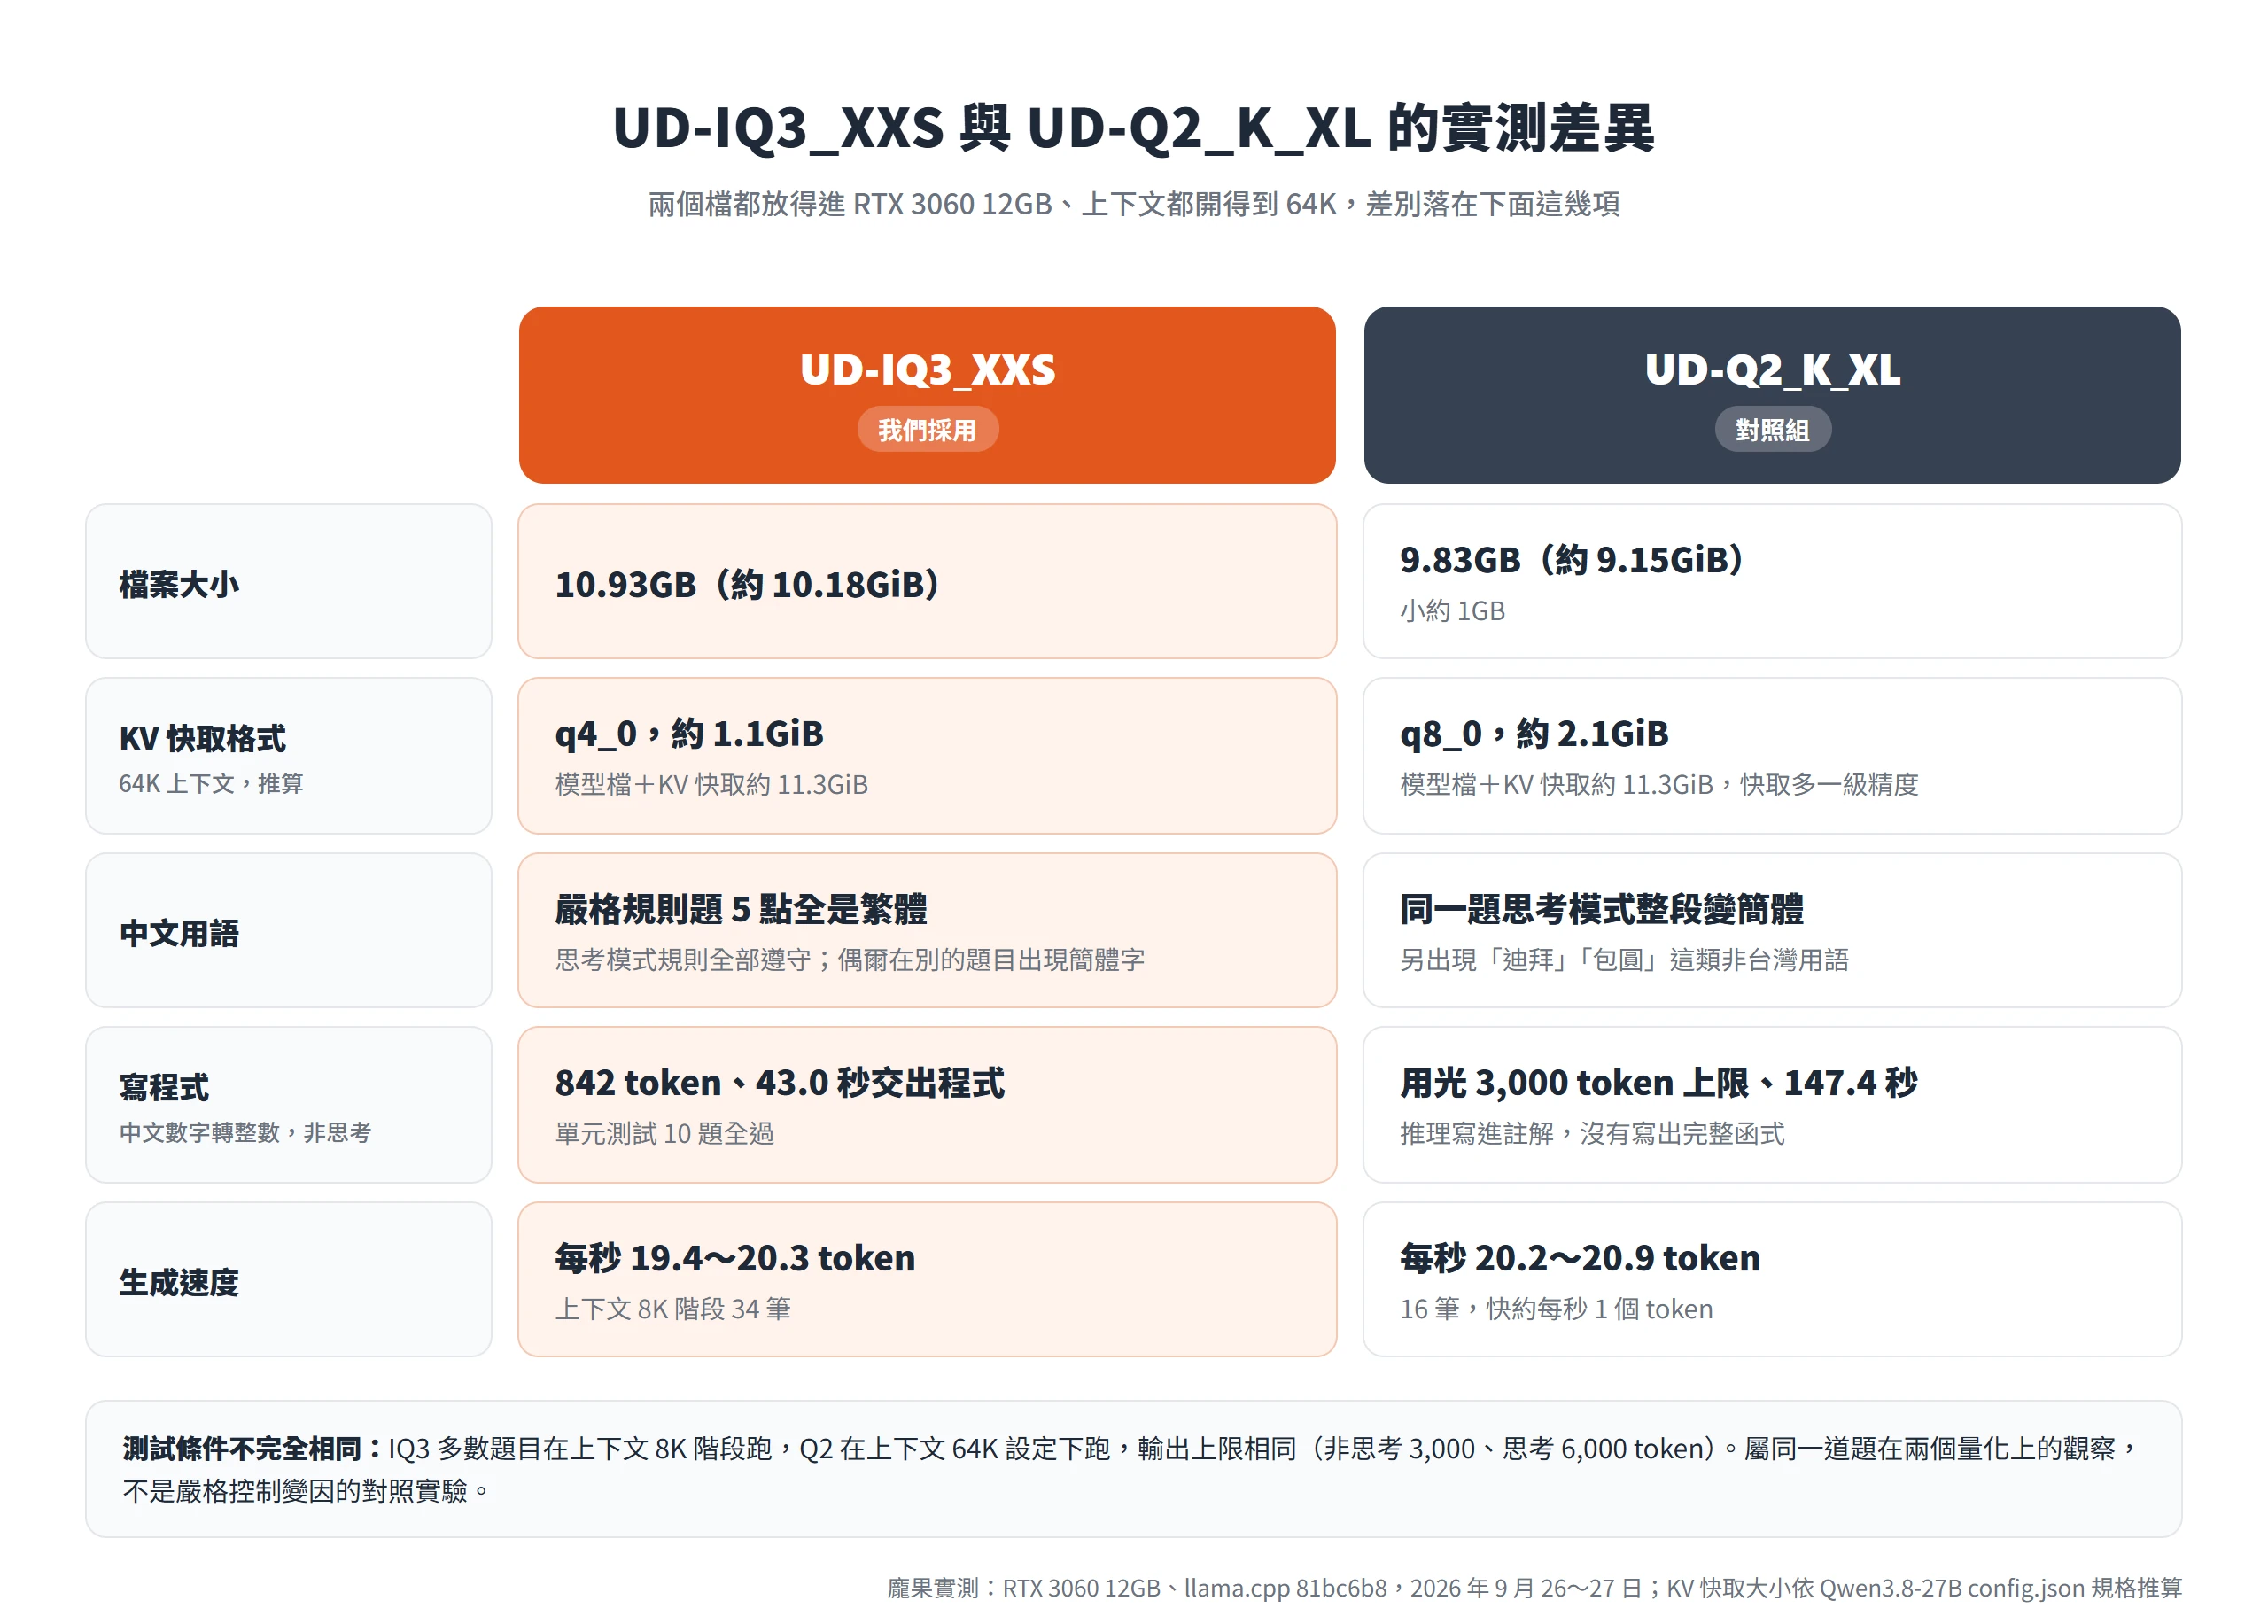
用 12GB 顯卡的人,最先要決定的是下載哪一個檔。我們兩個都跑過,UD-IQ3_XXS 與 UD-Q2_K_XL 都塞得進 12GB、上下文也都開得到 64K,差別落在 KV 快取的精度、中文用語、寫程式的冗長程度和速度這四件事上,最後我們採用 UD-IQ3_XXS。
要先說清楚的是,兩組測試的條件並不完全相同。IQ3 的多數題目是在上下文 8K 的階段跑的,Q2 則是在上下文 64K 的設定下跑,所以兩者的差異屬於「同一道題在兩個量化上的觀察」,不是嚴格控制變因的對照實驗。
Q2_K_XL 檔案小約 1GB,換來 KV 快取多一級精度
UD-Q2_K_XL 的檔案是 9.83GB(約 9.15GiB),UD-IQ3_XXS 是 10.93GB(約 10.18GiB),兩者相差約 1GB。這 1GB 的差距,讓 Q2 在 64K 上下文下還能把 KV 快取存成 q8_0 格式,IQ3 則必須把 KV 快取壓到 q4_0 才放得下。
依 Qwen 公布的模型規格推算,64K 上下文的 KV 快取用 q8_0 約 2.1GiB、用 q4_0 約 1.1GiB,兩種組合的「模型檔+KV 快取」都落在約 11.3GiB。換句話說,這是同一個空間預算的兩種花法,一種把位元留給模型權重,一種把位元留給上下文快取。這個數字是推算值,不是量測值,而且沒有算進線性注意力層的狀態與運算緩衝,那兩塊要另外計入。
Q2_K_XL 較常冒出簡體字與大陸用語
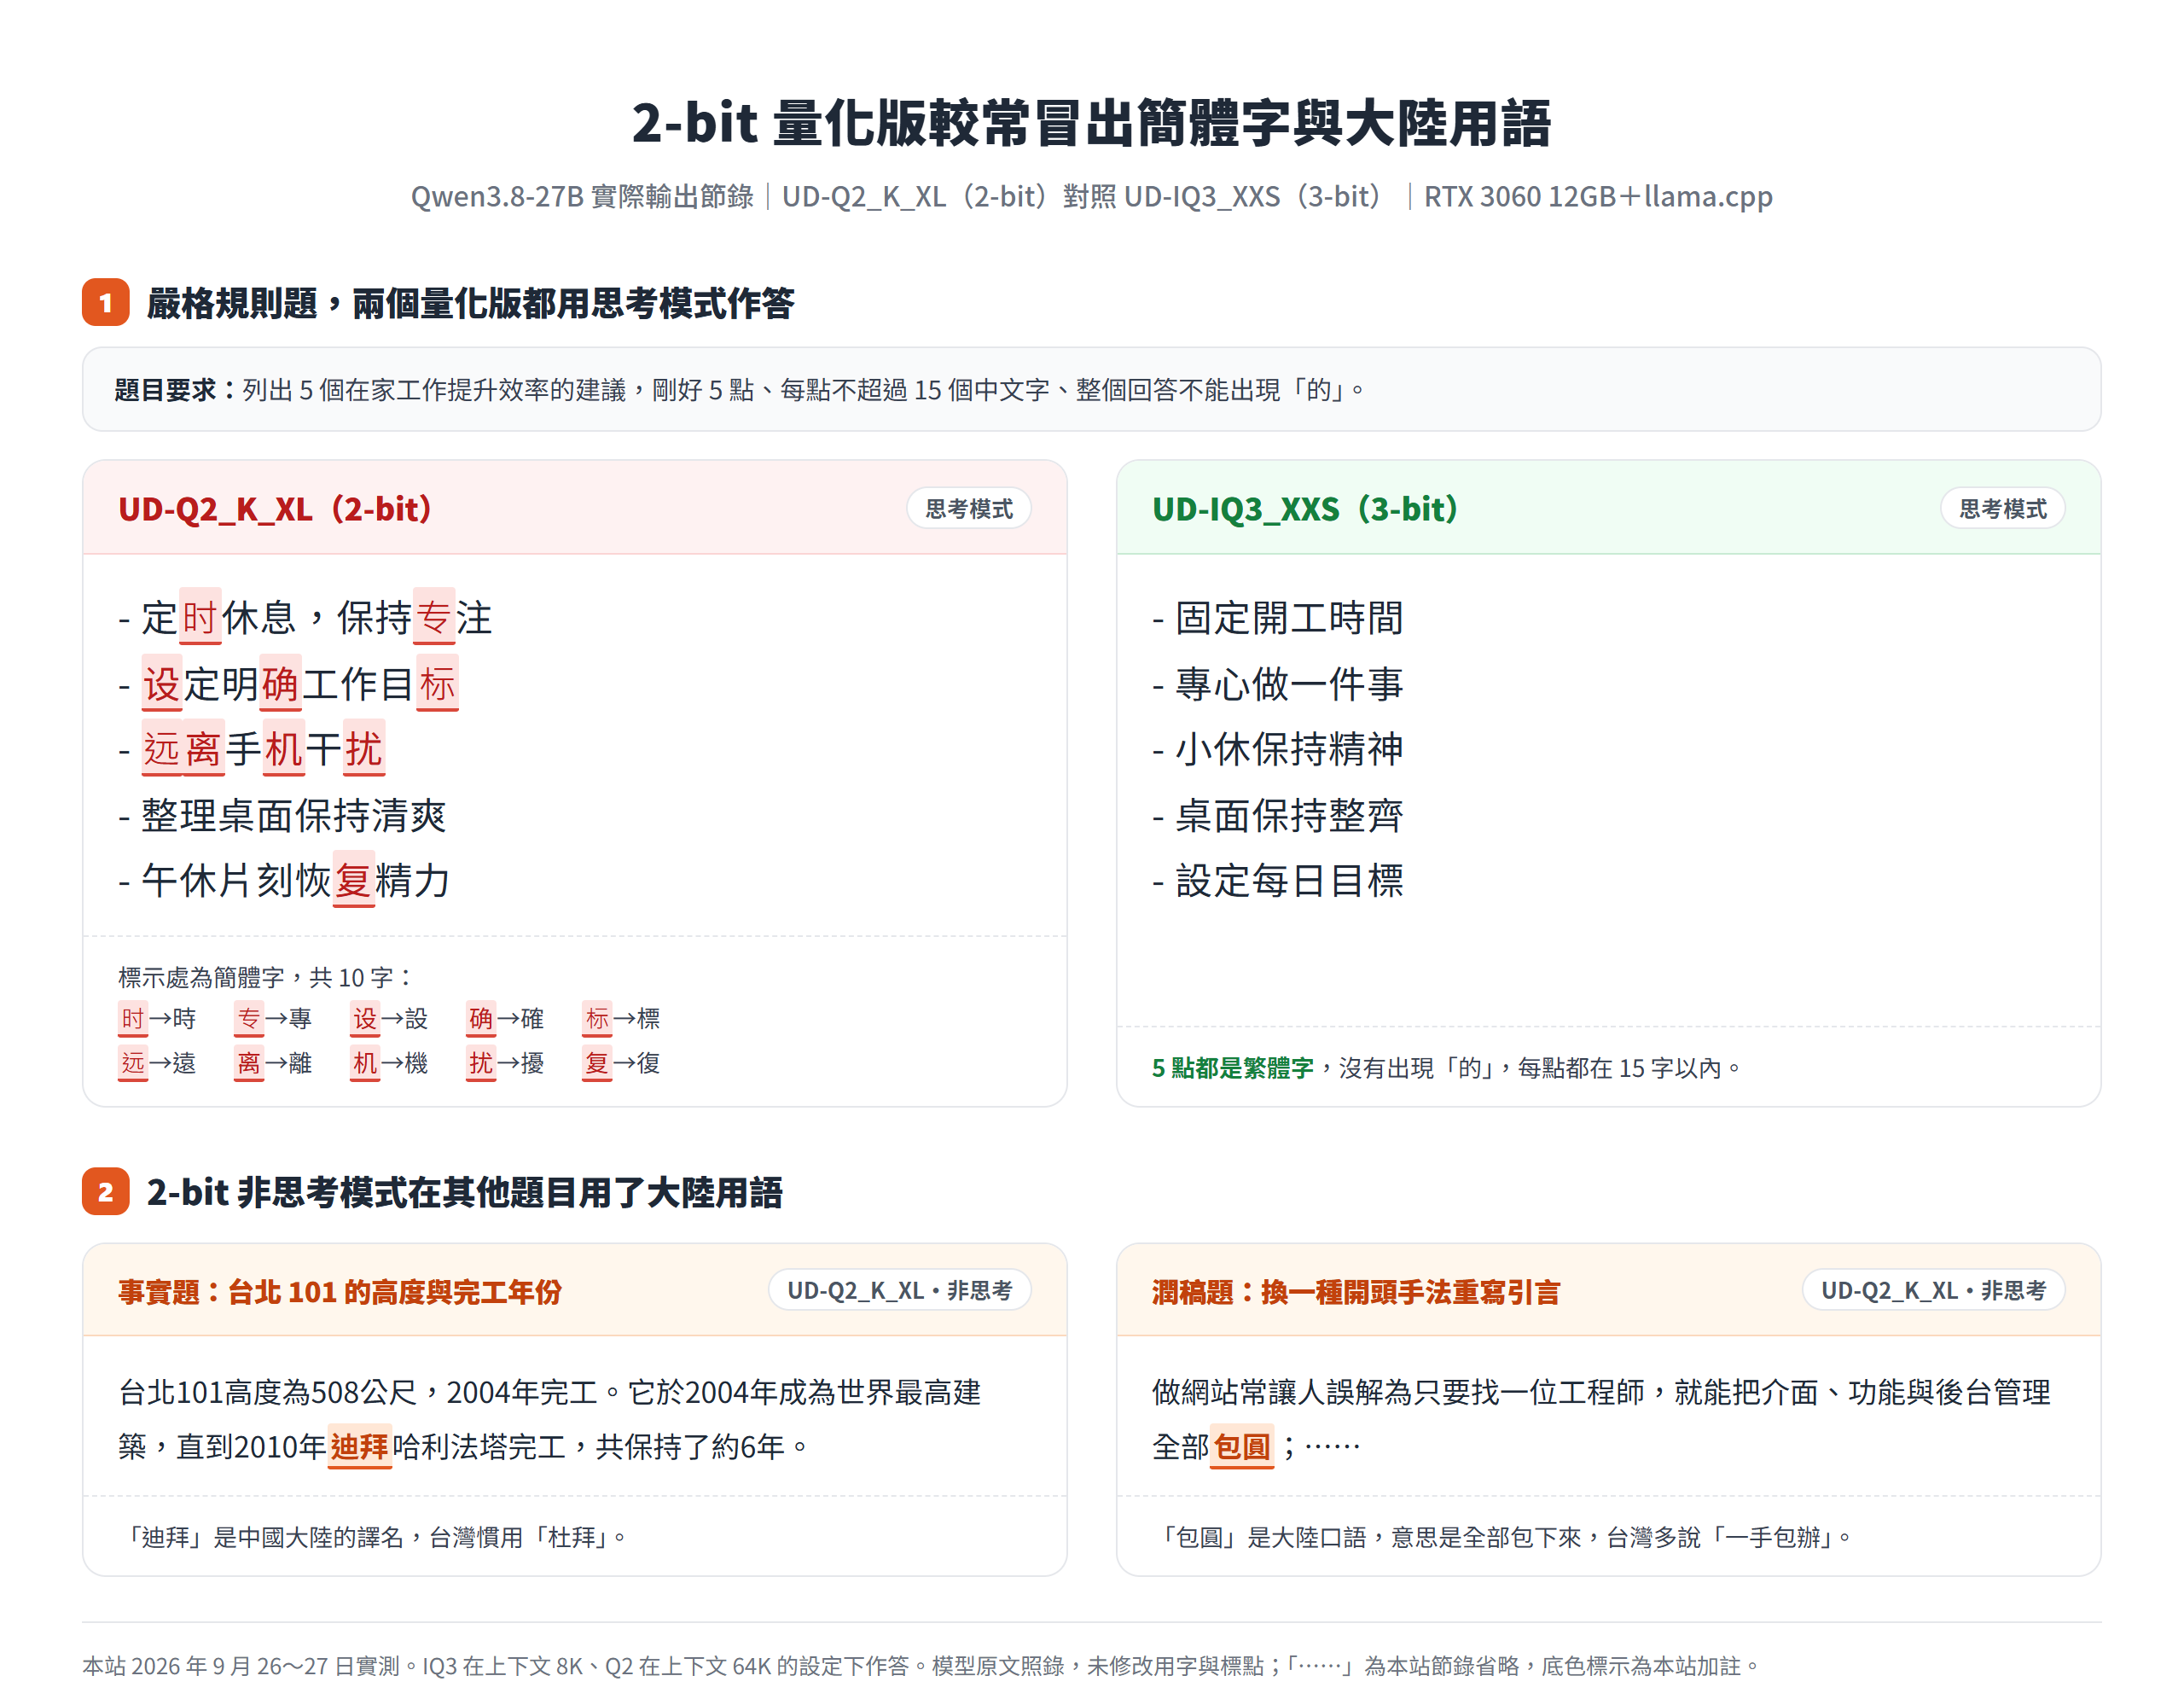
同樣的題目,Q2 比較容易冒出不是台灣習慣的用語。問台北 101 的高度與完工年份時,Q2 的非思考模式答對了,卻把杜拜寫成「迪拜」;請它換一種開頭手法重寫一段引言時,句子有改寫,但用了「包圓」這種大陸用語。
最明顯的是嚴格規則題,題目要求剛好列 5 點、每點不超過 15 個字、全文不能出現「的」字。Q2 的思考模式照樣列出 5 點,卻整段變成簡體字,連「定時休息,保持專注」這樣的短句都用簡體寫出。IQ3 同一題的思考模式 5 點全是繁體,規則也全部遵守。IQ3 偶爾也會出現簡體字,只是發生在別的題目上,細節整理在模型介紹那篇。
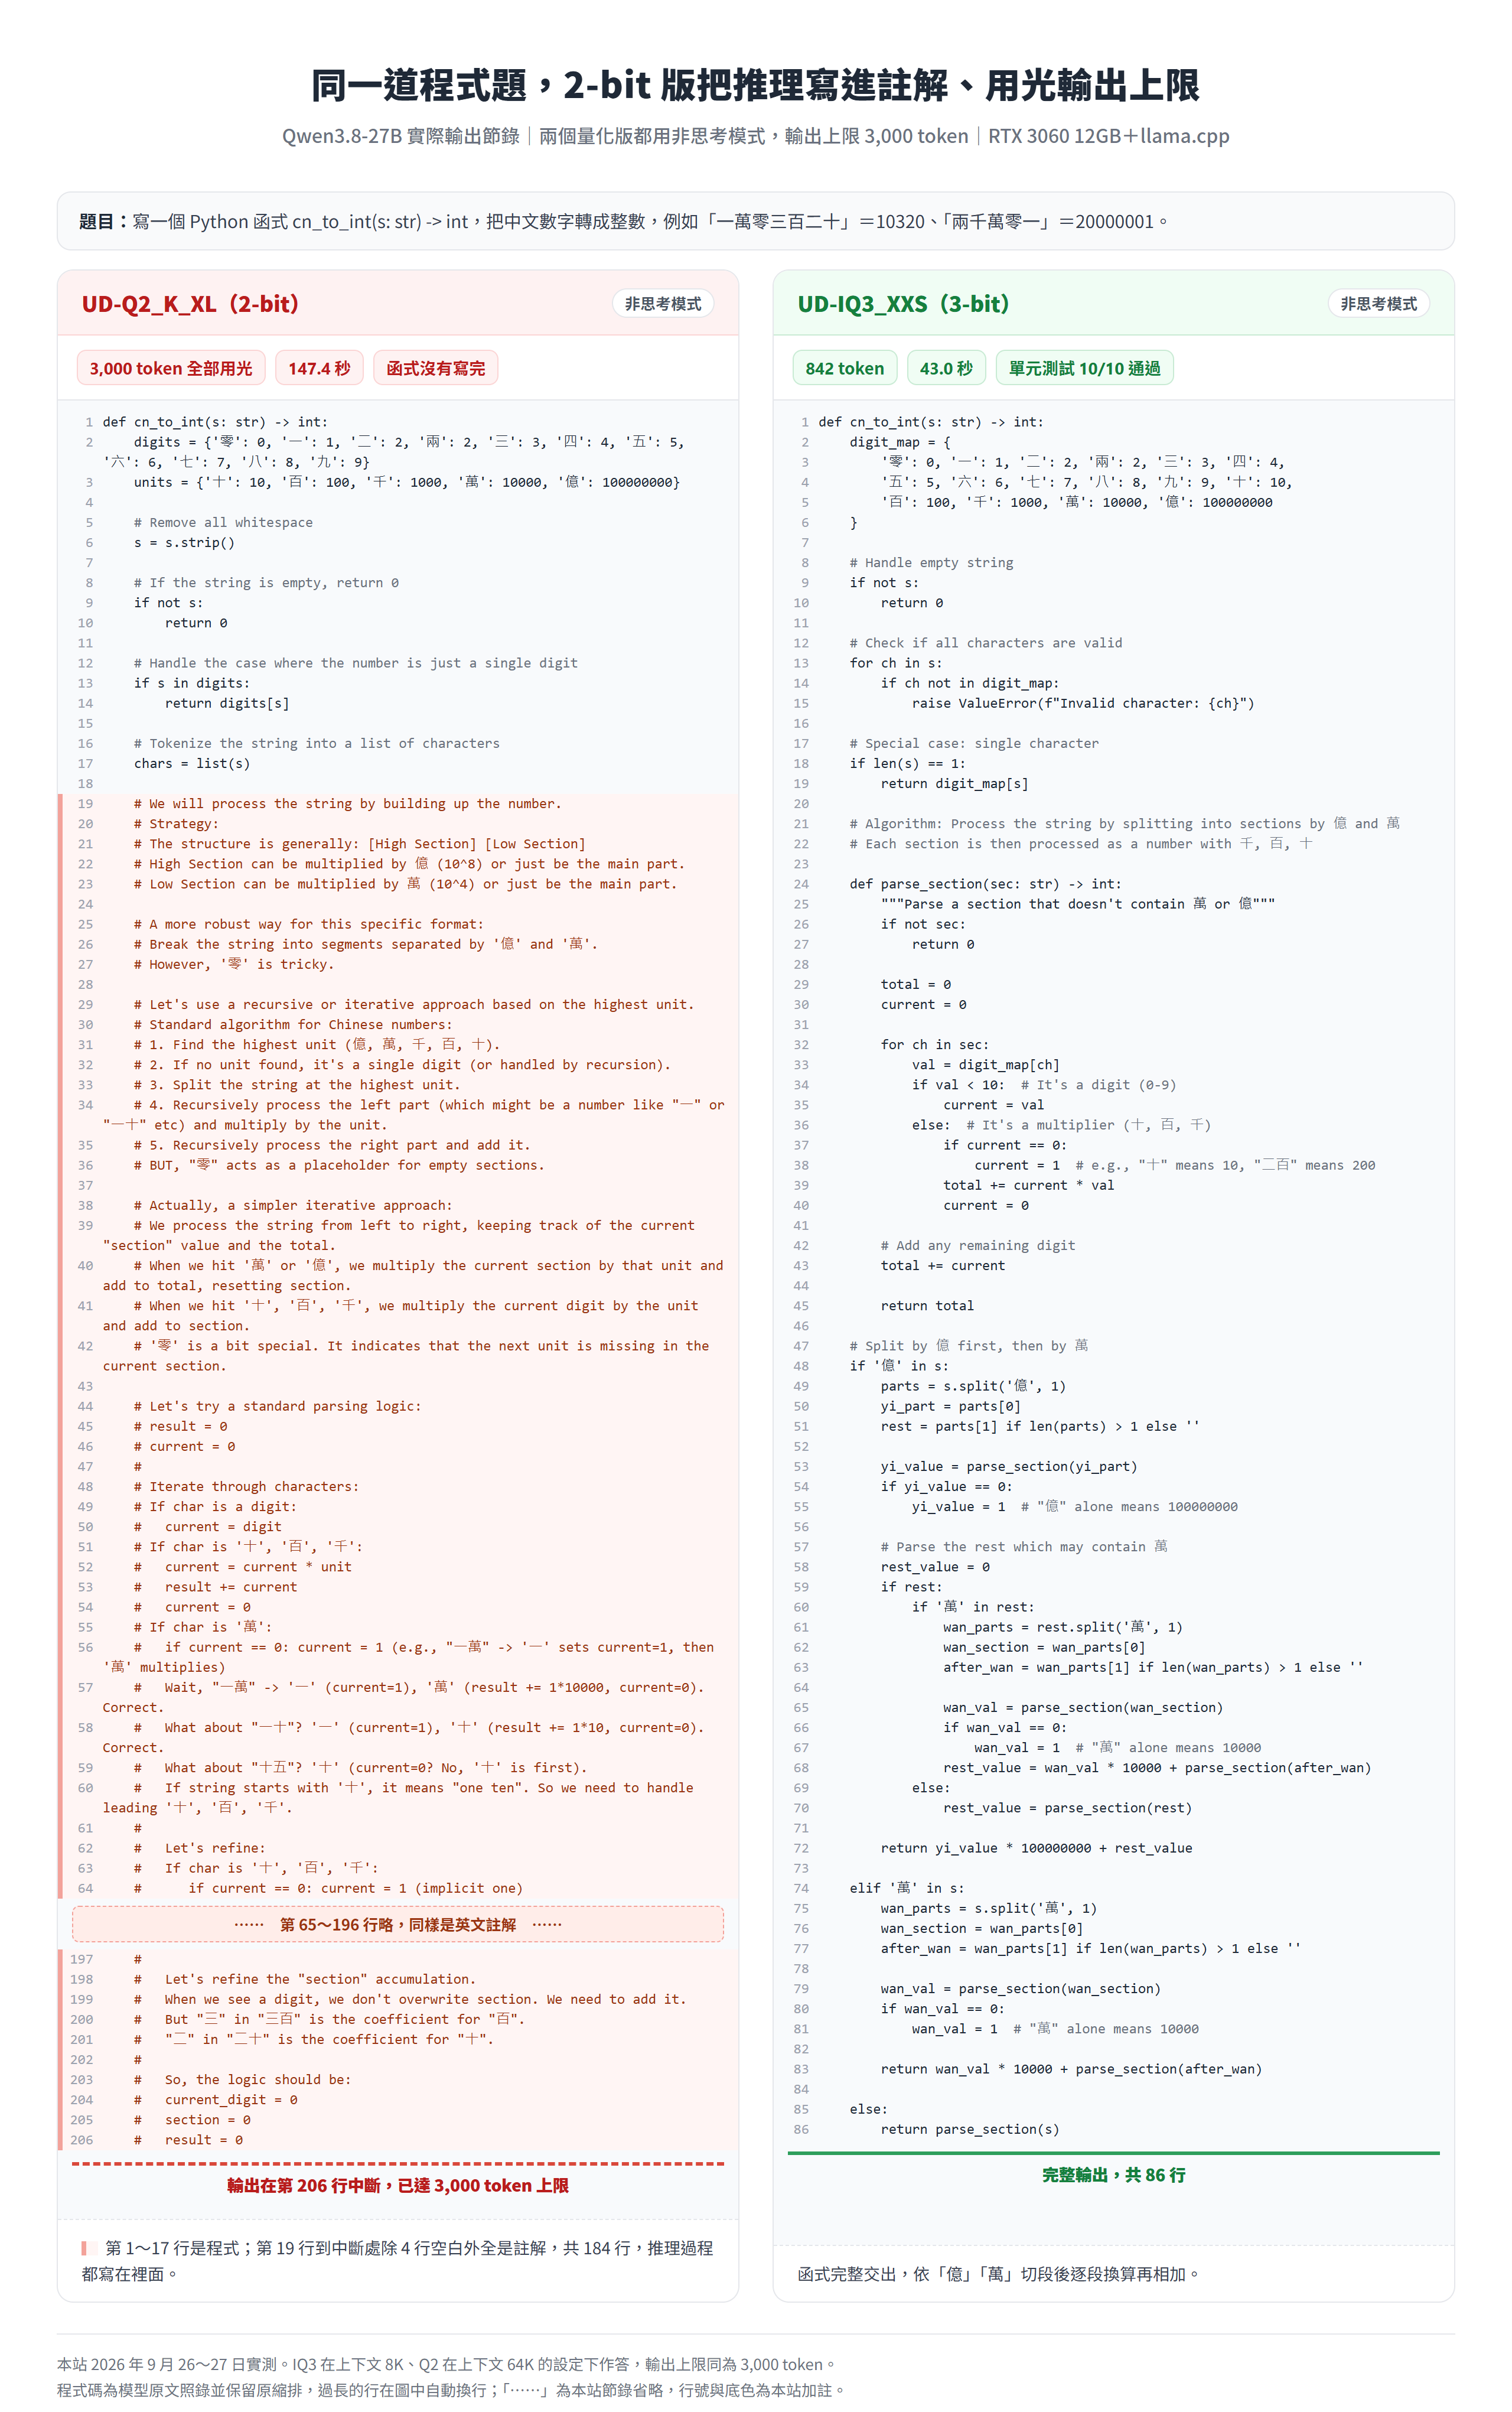
Q2_K_XL 寫程式較冗長,3,000 token 用光仍未完成
「寫程式比較囉嗦」要落到具體例子才有意義。題目是寫一個 Python 函式,把「一萬零三百二十」這類中文數字轉成整數。Q2 的非思考模式把推理過程整段寫進程式註解,英文註解一行接一行寫個不停,用光 3,000 token 的輸出上限、花了 147.4 秒,還是沒有寫出完整的函式。IQ3 同一題用 842 個 token、43.0 秒就交出程式,跑單元測試 10 題全過。
另一個例子是騎士與騙子的邏輯題,Q2 非思考用了 1,542 個 token,IQ3 是 1,079 個,兩者都答對。數學應用題、條件機率與最長迴文子字串這幾題,兩個量化也都答對。不過條件差異仍要記得,IQ3 這幾筆是上下文 8K、Q2 是 64K,只有輸出上限相同,非思考模式都是 3,000 token、思考模式都是 6,000 token。
Q2_K_XL 生成速度只快約每秒 1 個 token
Q2 的檔案比較小,生成也比較快一點。Q2 組 16 筆測試的生成速度落在每秒 20.2 到 20.9 個 token,IQ3 在 8K 階段的 34 筆落在每秒 19.4 到 20.3 個,差距大約每秒 1 個 token。
以一段 1,000 token 的回答來說,這個差距只省下約 2 秒,換來的卻是用語與程式品質的落差。對要拿來寫繁體中文內容、寫程式的人來說,這筆交換不划算,這也是我們最後選 IQ3 的理由。
Q4 量化搭配部分權重放系統記憶體的另一條路
12GB 不是只有 3-bit 一條路。llama.cpp 允許把一部分權重留在系統記憶體、交給 CPU 計算。-ncffn(完整寫法 --n-cpu-ffn)可以把前 N 層的 dense FFN 權重留在 CPU,-ot(--override-tensor)則能逐一指定個別張量放在哪裡。這樣就能改用 4-bit 量化,代價是速度。
這條路我們沒有測,只能引用社群回報作參考。Unsloth 的 Qwen3.8-27B GGUF 頁面討論區裡,有使用者在 8 月 16 日分享了他的設定,同樣是 RTX 3060 12GB(Windows 11、同時接螢幕,可用顯存約 11.25GB)、系統記憶體 32GB DDR4,跑的是 Unsloth 8 月 19 日改版前的舊版 Q4_K_S 量化(這個檔與他後來對照的 IQ4_NL 都已從儲存庫移除)、KV 快取 q4_0,把 46 層的 FFN 放到系統記憶體,再加上 MTP 推測解碼,96K 上下文下生成約每秒 9.7 個 token、讀取約每秒 225 個 token,顯存用到約 11.04GB。他也提到 IQ 系列量化在這種大量 CPU 卸載的設定下明顯更慢,改用 IQ4_NL 時生成掉到約每秒 4.94 個 token。拿來對照我們全部放顯存的每秒約 20 個 token,兩條路是「品質換速度」的取捨,看的是你比較在意哪一邊。
下載 GGUF 模型檔與視覺模組時要指定量化名稱
在 llama.cpp 上跑 Qwen3.8-27B 要準備兩個檔,一個是主模型的 GGUF 檔,另一個是視覺模組 mmproj。主模型負責理解與產出文字;mmproj 負責把圖片轉成模型讀得懂的形式,不打算讓它看圖,就可以不下載、也不載入。
Unsloth 在 Hugging Face 上的 Qwen3.8-27B-GGUF 儲存庫裡,跟 12GB 有關的檔案有這幾個:
Qwen3.8-27B-UD-IQ3_XXS.gguf(10.93GB)是我們採用的主模型Qwen3.8-27B-UD-Q2_K_XL.gguf(9.83GB)是對照用的較小版本mmproj-F16.gguf與mmproj-BF16.gguf(各約 0.93GB)是視覺模組,兩個選一個下載即可MTP/mtp-Qwen3.8-27B-Q4_0.gguf(1.37GB)是推測解碼用的檔案,我們沒有使用
llama.cpp 可以用 -hf 參數直接從 Hugging Face 下載並啟動,寫法是 -hf 使用者/儲存庫:量化名稱。要特別注意的是,冒號後面的量化名稱一定要寫。llama.cpp 伺服器文件寫明,沒有指定量化時預設會抓 Q4_K_M,而 Qwen3.8-27B 的 4-bit 檔在 12GB 顯卡上整個放不下。儲存庫裡有 mmproj 的話也會一併下載,不需要看圖可以加 --no-mmproj 跳過。
# 指定 UD-IQ3_XXS,並跳過視覺模組
llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-IQ3_XXS --no-mmprojCode language: Bash (bash)
另一個常見的混淆來自版本更新。Unsloth 在 8 月 19 日把 Qwen3.8-27B 的 UD 系列 GGUF(UD-Q8_K_XL 除外)換成 Unsloth Dynamic 3.0 重新上傳,同時刪掉 Q4_K_M、Q4_K_S、IQ4_NL 等一批舊的非 UD 量化檔,儲存庫最後一次更新是 8 月 20 日,新舊檔案的內容並不相同。更新前寫成的教學或下載紀錄,檔案大小可能跟現在對不上,一律以儲存庫目前列出的檔案為準。
至於 Ollama,它的模型庫裡 qwen3.8 最小的 27B 標籤(27b、27b-q4_K_M、27b-nvfp4 等)都是 18GB,12GB 顯卡用預設標籤一樣放不進顯存。
llama-server 完整啟動參數逐項說明
下面這組是我們最後穩定使用的啟動指令,前面提到的崩潰都是在調整到這組之後才消失:
llama-server -m Qwen3.8-27B-UD-IQ3_XXS.gguf --mmproj mmproj-F16.gguf --no-mmproj-offload \
  -ngl 99 -c 65536 -b 512 -ub 256 -fa on --cache-type-k q4_0 --cache-type-v q4_0 \
  --jinja --host 0.0.0.0 --port 8080 -np 1Code language: Bash (bash)
照抄這串指令不難,難的是知道每個參數在管哪一塊空間,換了顯卡或需求時才知道該動哪裡。各參數的預設值都以 llama.cpp 伺服器文件為準。
模型檔與視覺模組的載入位置
-m 指定主模型檔的路徑,--mmproj 指定視覺模組檔。llama.cpp 預設會把視覺模組也放進 GPU(--mmproj-offload 預設是開啟的),mmproj-F16 約 0.93GB,換算約 0.86GiB,在只剩不到 2GiB 的餘裕裡是很大的一塊。加上 --no-mmproj-offload 之後,視覺模組改留在 CPU 與系統記憶體,不占顯存。
代價是看圖的時候改由 CPU 處理,速度會比較慢;我們沒有做 GPU 與 CPU 的看圖速度對照,所以給不出確切倍數。不需要看圖的人,最省事的做法是乾脆不載入 mmproj。Unsloth GGUF 頁面的討論區裡也有類似的社群回報,有人刪掉 mmproj 之後,模型不再被擠到 CPU 上跑;也有人保留 mmproj、加上 --no-mmproj-offload,表示不必刪檔也能維持正常的生成速度。
全部層數放進 GPU,上下文開到 65536
-ngl 99 表示最多把 99 層放進顯存。Qwen3.8-27B 只有 64 層,寫 99 就等於「全部放進去」。這個參數預設是 auto,層數一旦留在 CPU,生成速度就會明顯下降。前面社群回報那組把 FFN 放到系統記憶體的設定,生成只剩每秒 10 個 token 左右,就是這個代價的量級。
-c 65536 就是 64K 上下文。這個參數預設是 0,意思是直接讀模型本身的設定,而 Qwen3.8 原生支援 262,144 token;依模型規格推算,這個長度的 f16 KV 快取光自己就約 16GiB,12GB 顯卡不可能容納,上下文最好手動指定。另外,新版 llama.cpp 文件裡有一個預設開啟的 --fit 選項,會自動調整沒有手動指定的參數,讓它們塞得進裝置記憶體(預設保留 1024MiB 餘裕);我們是手動指定 -ngl 與 -c,把控制權握在自己手上。
邏輯批次與實體批次都調得比預設值小
-b 是邏輯批次上限,預設 2048;-ub 是實體批次上限,預設 512,也就是一次實際丟進 GPU 運算的 token 數。-ub 越大,讀長文(prompt processing)越快,但運算緩衝占的顯存也越多。我們把兩者調成 512 與 256,是拿讀取速度去換顯存餘裕,這也是後面那次崩潰能修好的關鍵之一。
這個方向有第三方測試可以佐證。GitHub 上有開發者公開了同樣是 RTX 3060 12GB、64K 上下文、KV 快取 q4_0 的單次測試,模型是另一個社群版本的 IQ3_XXS 量化檔,批次從 16/16 提高到 128/128,讀取一段 8,595 token 的提示時,速度從每秒 82.13 個 token 升到 320.24 個,剩餘顯存則從 549MiB 降到 449MiB;再提高到 256/256,讀取速度是每秒 377.09 個 token,剩餘顯存只剩 385MiB。這份測試用的是自行修改過的 llama.cpp,只適合拿來說明「批次越大,讀得越快、也越吃顯存」的方向,具體數字不能直接套用。
KV 快取壓成 q4_0 就必須開啟 Flash Attention
--cache-type-k q4_0 --cache-type-v q4_0 把 KV 快取從預設的 f16 壓成 q4_0。q4_0 每 32 個數值用 18 個位元組儲存,f16 則要 64 個位元組,占用大約是原本的 28%。可選的格式還有 f32、bf16、q8_0、q4_1、iq4_nl、q5_0、q5_1 等,q8_0 是精度與空間的中間選項。
-fa on 在這組設定裡不是選配。llama.cpp 規定 V 快取要量化就必須開啟 Flash Attention,原始碼裡寫得很直接,沒開的話會出現 quantized V cache was requested, but this requires Flash Attention 這個錯誤;-fa 的預設值是 auto,遇到量化 V 快取時會自動開啟,但明確寫上 on 比較不會出意外。KV 快取壓到 q4_0 對品質有多少影響,我們沒有單獨測,只能說在這組設定下,5.8 萬 token 的長文裡藏的資訊仍然找得到。
聊天模板、監聽位址與單一處理槽
--jinja 讓 llama-server 使用模型內建的聊天模板。Qwen3.8 的開關思考、調整 reasoning_effort 都是靠這份模板生效,Unsloth 的文件就是用 --chat-template-kwargs 把 reasoning_effort 傳進這份模板。新版 llama-server 預設已經開啟,寫上也無妨。
--host 0.0.0.0 --port 8080 讓同一個區網裡的其他電腦也連得到這台伺服器,預設只聽本機的 127.0.0.1,連接埠預設就是 8080。開放到區網時,可以加上 --api-key 設一組金鑰做驗證。-np 1 則固定只開一個處理槽,預設是 auto;單人自用一次只處理一個請求,固定成 1 個槽,設定比較單純。
16K 上下文首次請求就崩潰,調小批次並移出視覺模組
我們一開始把上下文只開到 16K、批次大小用預設值,伺服器啟動時一切正常,模型也載入成功,但第一次送出請求,就因為顯存不足直接崩潰。
修法分兩步。第一步是把 -ub 從預設的 512 調小到 256,縮小每次運算要配置的緩衝空間;第二步是加上 --no-mmproj-offload,把約 0.86GiB 的視覺模組移出顯存。兩步做完之後伺服器就穩定下來,後來上下文還一路開到 64K 都沒有再崩潰。
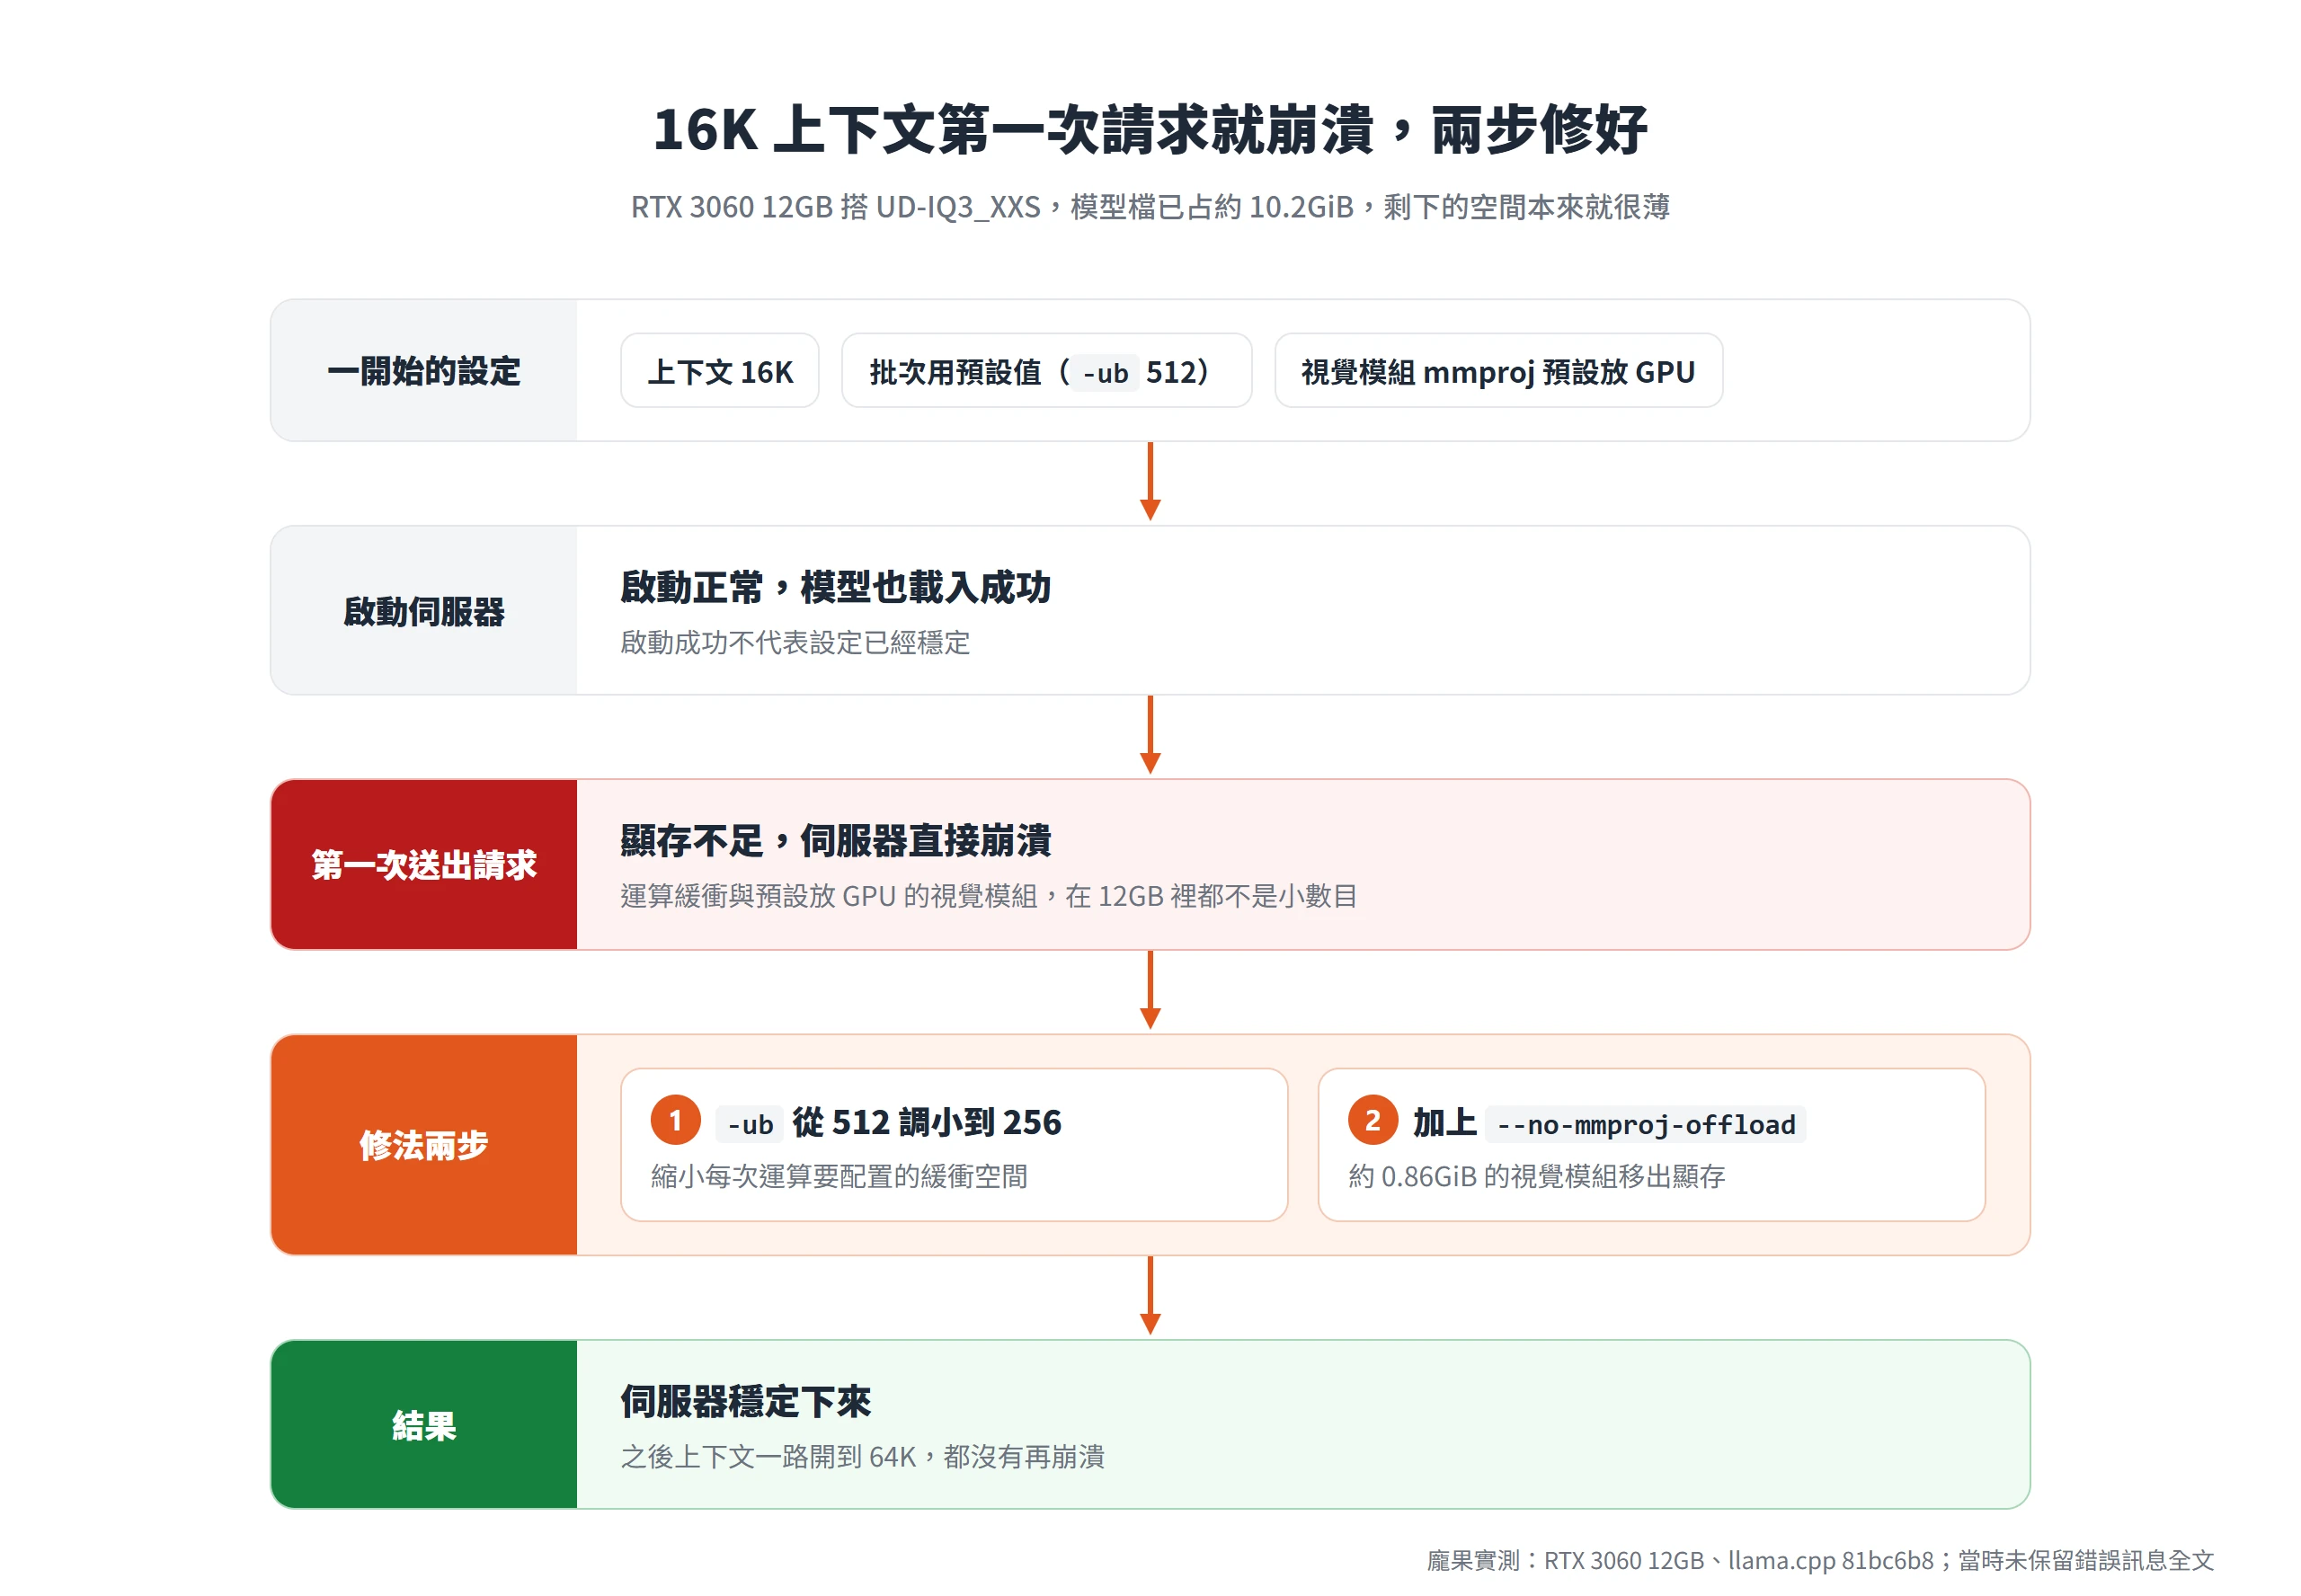
從文件能確認的原理來看,-ub 決定運算緩衝的大小,mmproj 預設放在 GPU,這兩塊在 12GB 裡都不是小數目,而模型檔已經占掉約 10.2GiB,剩下的空間本來就很薄。當時沒有留下錯誤訊息全文,崩潰為什麼發生在第一次請求、而不是啟動當下,我們也沒有進一步追查。
這次經驗留下一個實用的判斷,12GB 顯卡跑 27B 時,伺服器啟動成功不代表設定穩定。調好參數之後,最好馬上送一個真的長請求試過一次,確認讀長文和生成都順利跑完,再拿來做正事。
壓到 q4_0 的 KV 快取讓上下文開到 64K
Qwen3.8 原生支援 262,144 token 的上下文,Qwen 的模型卡也說明可以用 YaRN 延伸到約 100 萬 token,但同時提醒開源框架的 YaRN 是靜態縮放,可能拉低短文本的表現,只建議在真的需要長文時才開。在 12GB 顯卡上,這些都遠遠用不到。KV 快取壓到 q4_0 之後,64K 放得下,128K 就放不下了。
64K 換算成中文大約是 7 到 9 萬字。這個換算來自我們自己的輸出,散文題非思考模式寫了 365 個中文字、用 335 個 token,健保簡介題寫了 197 個字、用 143 個 token,每個 token 約對應 1.09 到 1.38 個中文字。實際測試時,我們塞過 5.8 萬 token 的長文,模型仍能正常回答。
開到 64K 還有另一個理由,是要接 AI 代理框架。Hermes Agent 的文件寫明,它推薦的本機模型都配至少 64K 的上下文,我們開到 64K 也是為了符合這個門檻;接上 Hermes Agent 之後的實測,放在模型介紹那篇。
16 層全注意力層的 KV 快取,從 f16 壓到 q4_0 省下近 3GiB
Qwen3.8-27B 的 64 層裡,只有 16 層是全注意力層,其餘 48 層是 Gated DeltaNet 線性注意力層。線性注意力層保存的是固定大小的狀態,不會隨上下文變長而增加,真正隨上下文變大的 KV 快取只來自那 16 層。這是 27B 能在 12GB 上開到 64K 的重要原因。
依 config.json 公布的規格計算,每層有 4 個 KV 頭、每個頭 256 維,K 與 V 各存一份,用 f16 時每個 token 要 2 × 16 × 4 × 256 × 2 位元組,約 64KiB。64K 上下文乘下來約 4GiB;壓到 q4_0 後約 1.1GiB。兩者差了將近 3GiB,這 3GiB 就是 64K 放不放得進 12GB 的分界。f16 的 4GiB 加上 10.18GiB 的模型檔,早已超過 12GiB;q4_0 的版本則剛好擠得進去。這些都是依模型規格推算的數字,不是實際量測值。
128K 上下文連同模型本體放不下
我們試過把上下文拉到 128K,就算 KV 快取已經壓到 q4_0,加上模型本體仍然放不下,只能退回 64K。
需要更長上下文的人,大致只剩兩條路:換一張顯存更大的顯卡,或是接受把部分權重放到系統記憶體、用速度去換空間,也就是前面社群回報的那種做法。這兩條路我們都沒有測,無法提供這台機器以外的數字。
RTX 3060 生成每秒約 20 個 token、長文讀取每秒約 400 個
在這台 RTX 3060 上,等待 Qwen3.8-27B 回應的時間分成兩段。「讀取」(prompt processing)是模型把你貼進去的文章、對話紀錄一次讀完的階段,速度約每秒 400 個 token,5.8 萬 token 的長文約 2.5 分鐘就讀完;「生成」是模型一個 token 一個 token 寫出回答的階段,每秒約 20 個 token,換成中文大約每秒 20 到 28 個字。丟一份長文件進去時,前面那段等的是讀取,後面慢慢跑出字來的是生成。
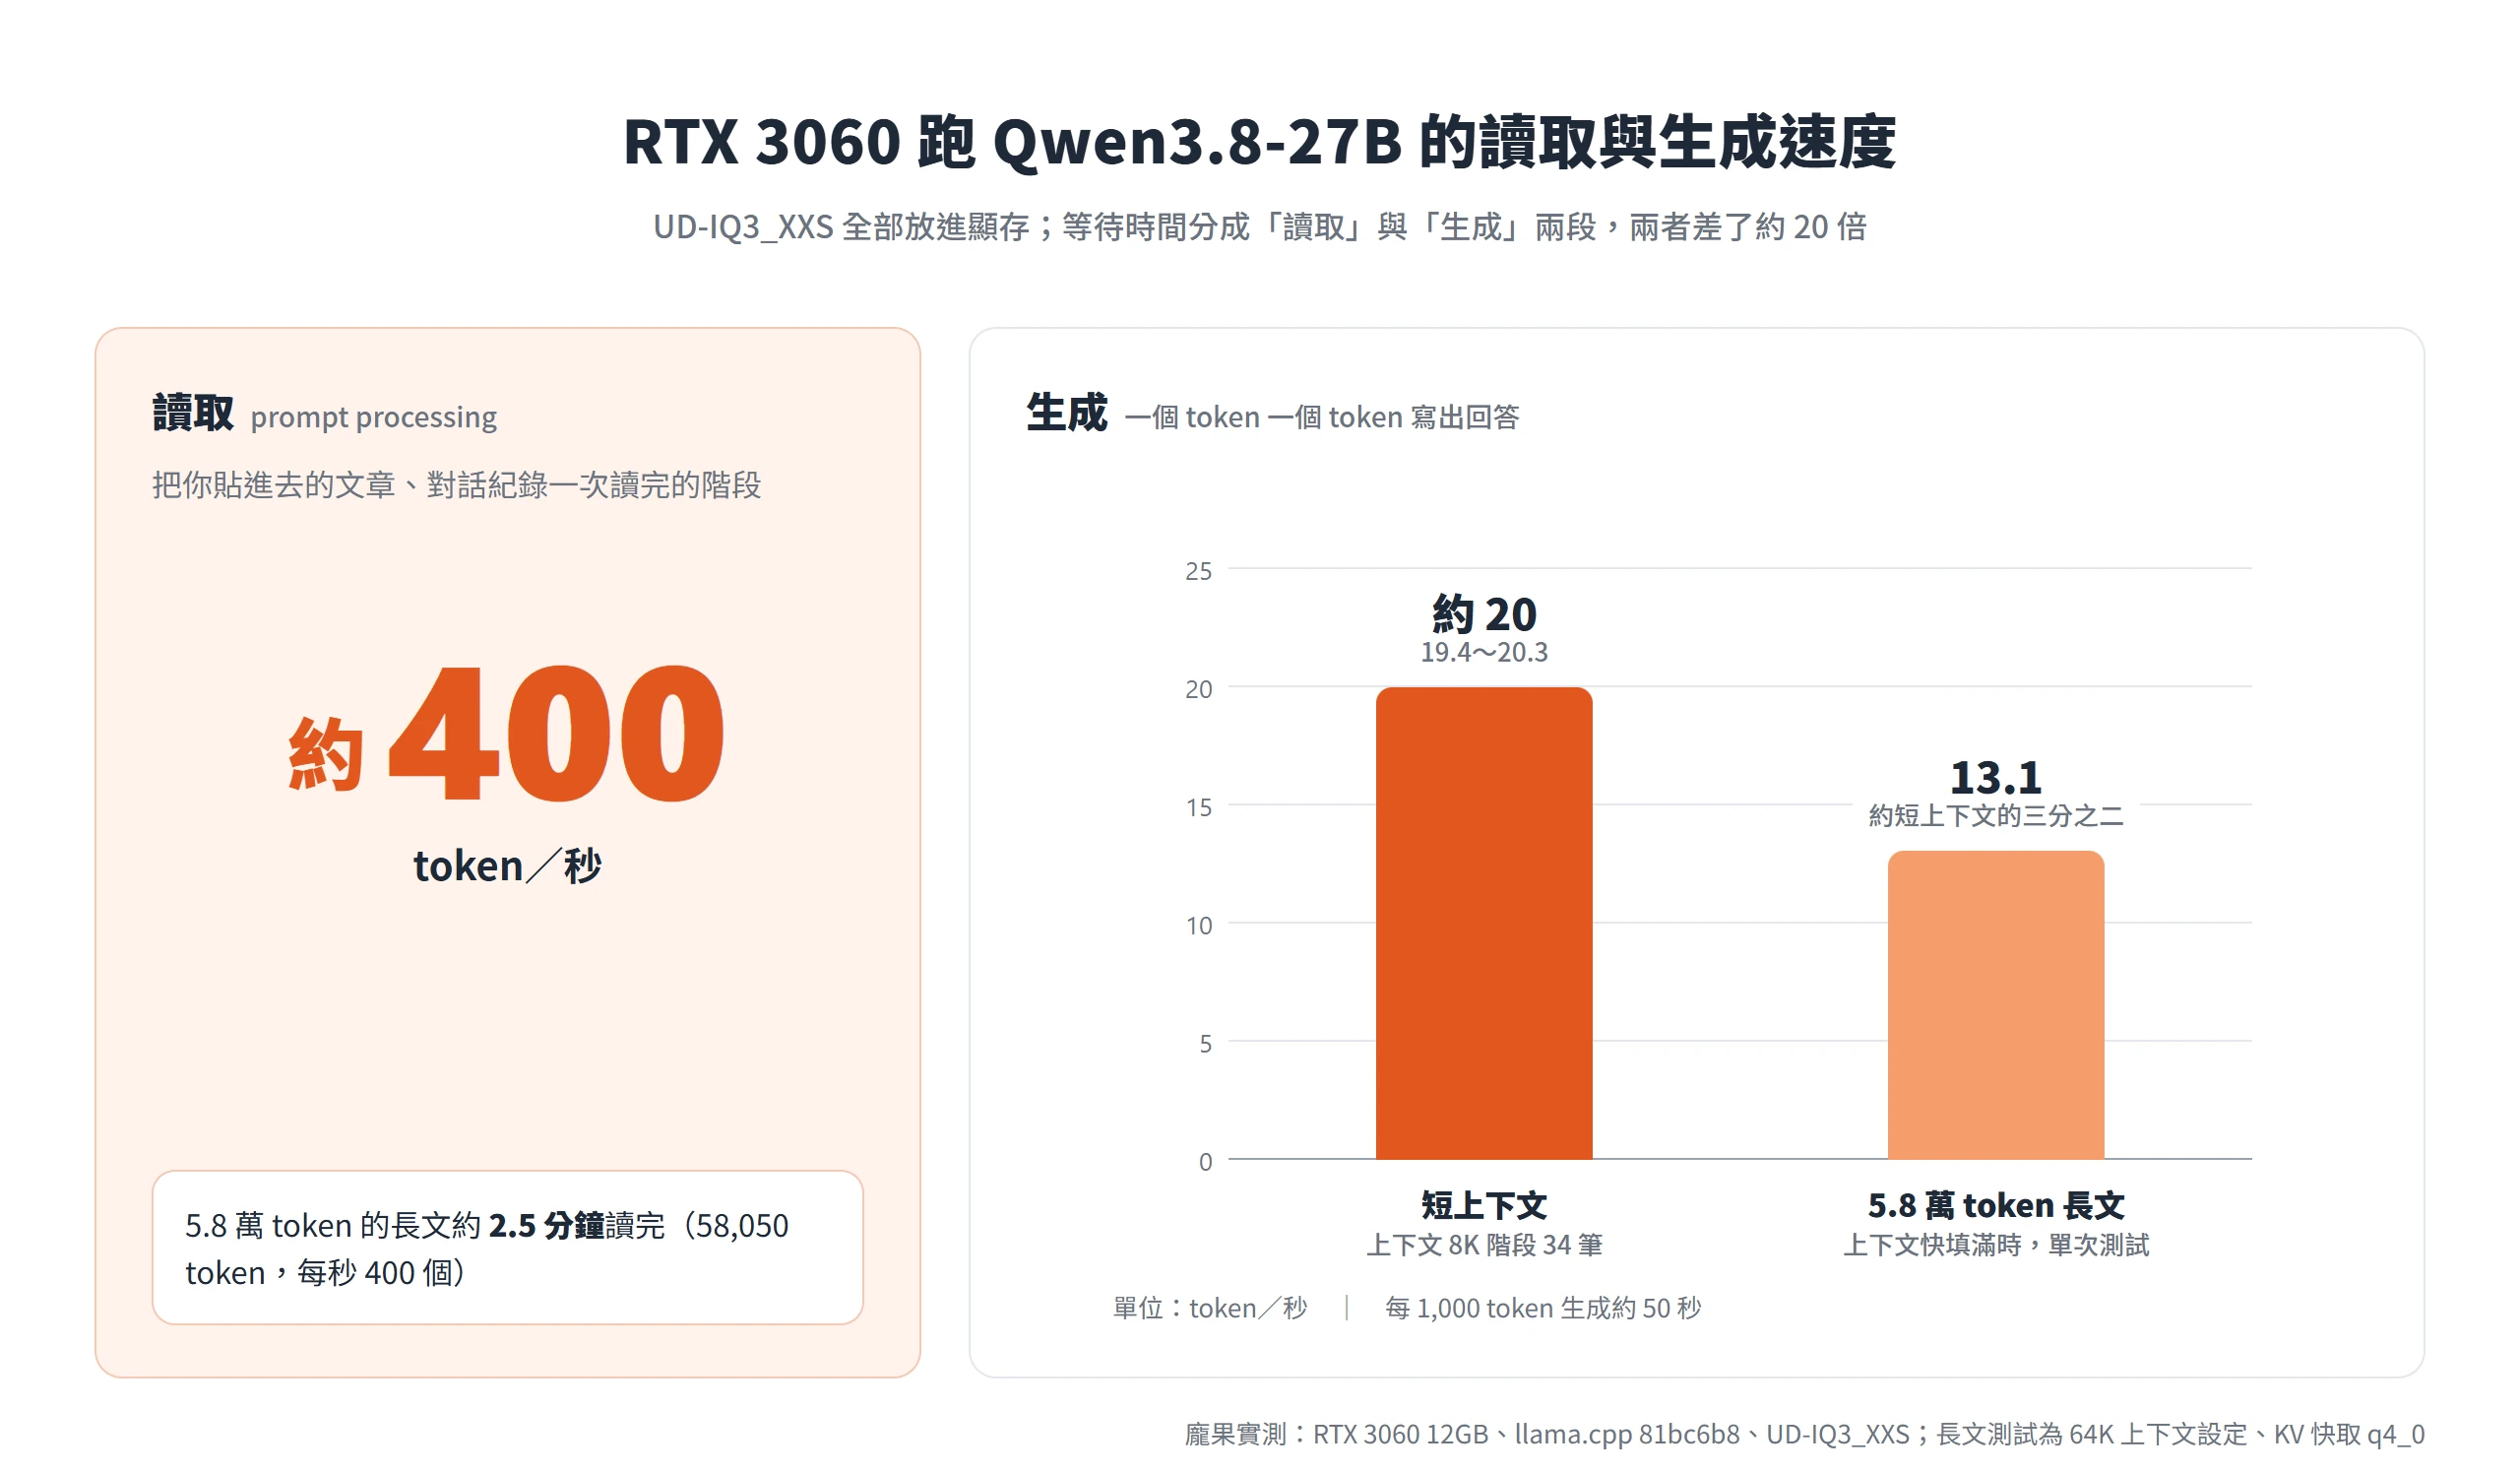
各組測試的生成速度都在同一個量級。IQ3 上下文 8K 的 34 筆是每秒 19.4 到 20.3 個 token,照 Qwen 建議取樣參數跑的 64K 那組 7 筆是 18.8 到 19.9 個,長輸出那組 5 筆是 17.6 到 20.0 個,其中輸出 3 萬 token 那筆平均 17.6、2 萬 token 那筆 18.3,輸出越長,平均速度越低。
上下文填到 5.8 萬 token 時生成降到每秒 13 個
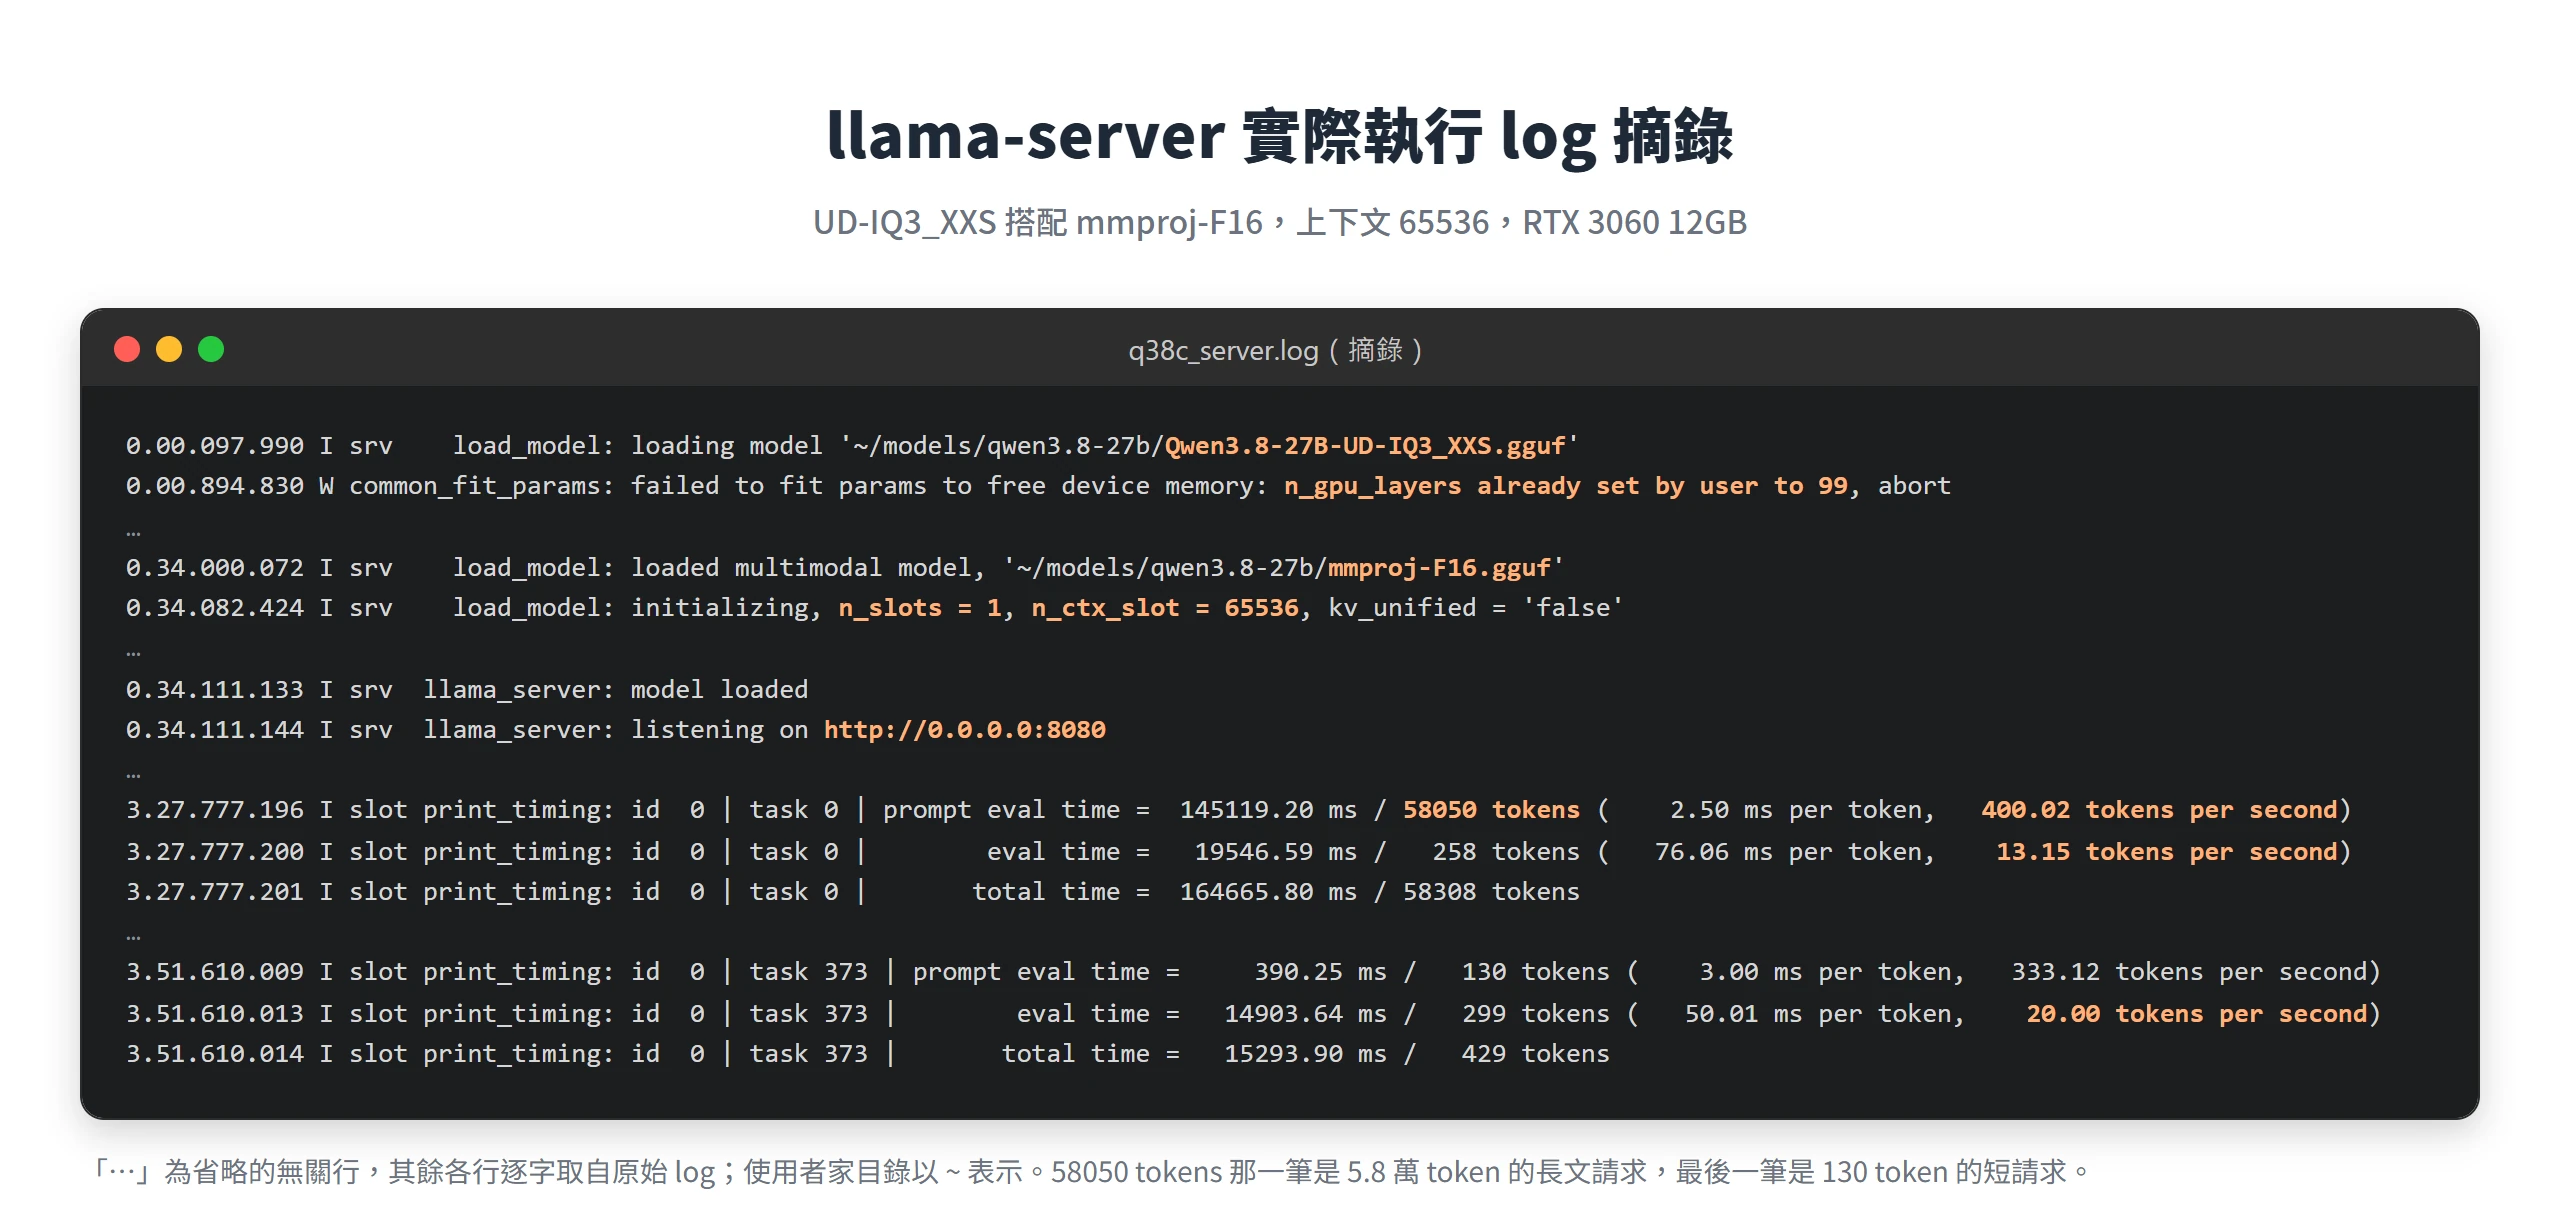
上下文越滿,生成就越慢。我們把多篇文章串成 58,050 token 的長文丟進 IQ3,讀取速度是每秒 400 個 token,讀完之後生成只剩每秒 13.1 個 token,大約是短對話時的三分之二。Q2 在 34,948 token 的長文下,讀取每秒 426 個、生成每秒 16.2 個 token。兩筆的量化與長度都不同,只能看出同一個趨勢,不能直接比較。
這組長文測試同時驗證了 64K 上下文加上 q4_0 KV 快取的設定可以正常使用。我們在長文中間藏了一句備用鑰匙的位置與密碼,模型在 5.8 萬 token 的版本裡找到了鑰匙位置與密碼,對文章重點的提問也全部答對;3.5 萬 token 的版本(Q2 那次)則在被問到一篇不存在的文章時,正確回答「沒有這篇」,沒有自己編內容。找資料準確度的完整細節,放在模型介紹那篇。
輸出上限直接決定等待時間
在每秒約 20 個 token 的硬體上,輸出上限就等於等待時間的上限,每 1,000 個 token 大約要 50 秒。我們一開始把輸出上限設在 3,000 到 6,000 token,結果要求做網頁的題目全部被截斷。在上下文 8K、上限 6,000 token 的階段,思考模式有 5 題用滿上限被截,每題都跑了約 5 分鐘(308 到 310 秒),最後沒有完整成品。
咖啡店形象首頁這題最能說明輸出上限的影響。上限放寬到 7,000 token 時仍被截斷,跑了 361.0 秒;後來上限給足,模型用了 7,946 個 token、414.1 秒(約 7 分鐘)才寫完整份網頁。輸出上限要依任務來給,網頁、長篇程式碼這類輸出要給得寬,同時也要先想好自己願意等多久。思考模式用掉的 token 也算在同一個輸出上限裡,這筆帳在慢硬體上更可觀。
llama-server 的預設取樣參數不同於 Qwen 建議值
llama-server 在沒有指定取樣參數時,會用它自己的一組預設值,和 Qwen 模型卡建議的兩組數值都不一樣。這個落差我們一開始並沒有注意到,三組數值並排如下:
| 參數 | llama-server 預設 | Qwen 建議(思考模式) | Qwen 建議(非思考模式) |
|---|---|---|---|
| temperature | 0.8 | 1.0 | 0.7 |
| top_p | 0.95 | 0.95 | 0.80 |
| top_k | 40 | 20 | 20 |
| min_p | 0.05 | 0 | 0 |
| presence_penalty | 0 | 0 | 1.5 |
| repetition_penalty | 1.0 | 1.0 | 1.0 |
我們前期上下文 8K 的那一組測試,取樣參數沒有照 Qwen 的建議值設定;到了後期的建議參數組,才改成照建議值跑。必須坦白的是,我們沒有在同一道題上做「照設」與「沒照設」的對照,所以不能把哪一個錯誤歸因到取樣參數上。建議參數組裡,非思考模式的中文數字轉整數題仍然只拿到 7/10,照設之後並不代表問題就消失。能確定的是,照建議值設定是 Qwen 明確列出的使用前提,值得一開始就設好。
Qwen 為思考與非思考模式各列一組建議值
Qwen 模型卡把建議值分成思考模式與非思考模式兩組。思考模式是 temperature 1.0、top_p 0.95、presence_penalty 0;非思考模式是 temperature 0.7、top_p 0.80、presence_penalty 1.5,top_k 兩組都是 20、min_p 都是 0。最大的差別在 presence_penalty,非思考模式會用它來壓低重複用詞,思考模式則完全不用。Unsloth 文件列出的思考模式數值也與模型卡相同。
模型卡另外提醒,presence_penalty 可以在 0 到 2 之間調整來抑制無限重複,但值調高偶爾會出現語言混雜,表現也可能略為下降;它也註明各推論框架對取樣參數的支援程度不一。要注意的是,我們觀察到的簡體字現象出現在上下文 8K 那組與 Q2 那組,這些測試不一定用了 1.5 的 presence_penalty,所以不能把兩件事直接連在一起。
切換模式時隨請求一併送出取樣參數
啟動參數只能設一組預設值。如果同一台伺服器會在思考與非思考之間切換,比較好的做法是讓每一次請求自己帶上該模式的取樣參數,並用 chat_template_kwargs 裡的 enable_thinking: false 關掉思考。Qwen3.8 預設開著思考模式,llama.cpp 伺服器文件舉的 chat_template_kwargs 範例也正好是這一個。
下面是一個走 OpenAI 相容端點(/v1/chat/completions)的最小範例,示範非思考模式的寫法:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "messages": [{"role": "user", "content": "用三句話介紹台南"}],
    "temperature": 0.7,
    "top_p": 0.8,
    "top_k": 20,
    "min_p": 0,
    "presence_penalty": 1.5,
    "chat_template_kwargs": {"enable_thinking": false}
  }'Code language: Bash (bash)
要用思考模式時,把 temperature 改成 1.0、top_p 改成 0.95、presence_penalty 改成 0,拿掉 enable_thinking: false 即可。這樣兩種模式各自用對的那組值,不必為了切換模式重開伺服器。
Qwen3.8 與 Qwen-Image 無法同時載入,只能輪流開啟
同一張 12GB 顯卡如果也拿來跑 Qwen-Image 做圖片生成,兩個模型沒有辦法同時常駐。Qwen3.8 這組設定已經把顯存用到接近上限,要做圖就得先停掉 llama-server,等圖片做好再把它開回來。
實務上的影響是每次切換都要重新載入約 11GB 的模型檔,兩個模型沒辦法隨叫隨到。如果希望語言模型與圖片生成模型同時待命,例如讓 AI 代理自己寫提示詞、再直接交給圖片模型出圖,這就是 12GB 不夠用、需要更大顯存的時候。
慢硬體上 reasoning_effort 的取捨
Qwen3.8 的思考模式有一個 reasoning_effort 設定,決定模型要想多深。Qwen 模型卡列了三個等級,xhigh 是預設值,給需要深入分析的複雜任務;medium 在準確與速度之間取平衡;low 以速度與成本為優先。在每秒約 20 個 token 的 RTX 3060 上,「想得深」直接等於「等得久」,這個設定就不只是品質問題,而是時間問題。
翻開 Qwen3.8 的聊天模板,可以看到這三個等級的實際作法。選 xhigh 時,模板會在系統訊息裡加上一段指令,要求模型 Please think carefully through the task, validate key assumptions, consider plausible alternatives,也就是仔細思考、驗證關鍵假設、考慮其他可能;選 low 時加的是 Keep your thinking brief and focused,要模型想得簡短聚焦;medium 則什麼都不加。所以 reasoning_effort 是寫給模型的一段指令,不是硬性的 token 預算,模型實際會想多久,仍要看題目與它自己的判斷。
模型卡也提醒了反方向的情況,在多輪的代理任務裡,調低 reasoning effort 不一定能縮短整體完成時間。單輪回答變快了,但可能因為分析不足而失敗重試,總延遲與 token 用量反而增加。我們這次的測試都是單輪、單題,放到代理任務上要另外評估。
在 RTX 3060 與 3 萬 token 上限下,xhigh 沒有寫完程式
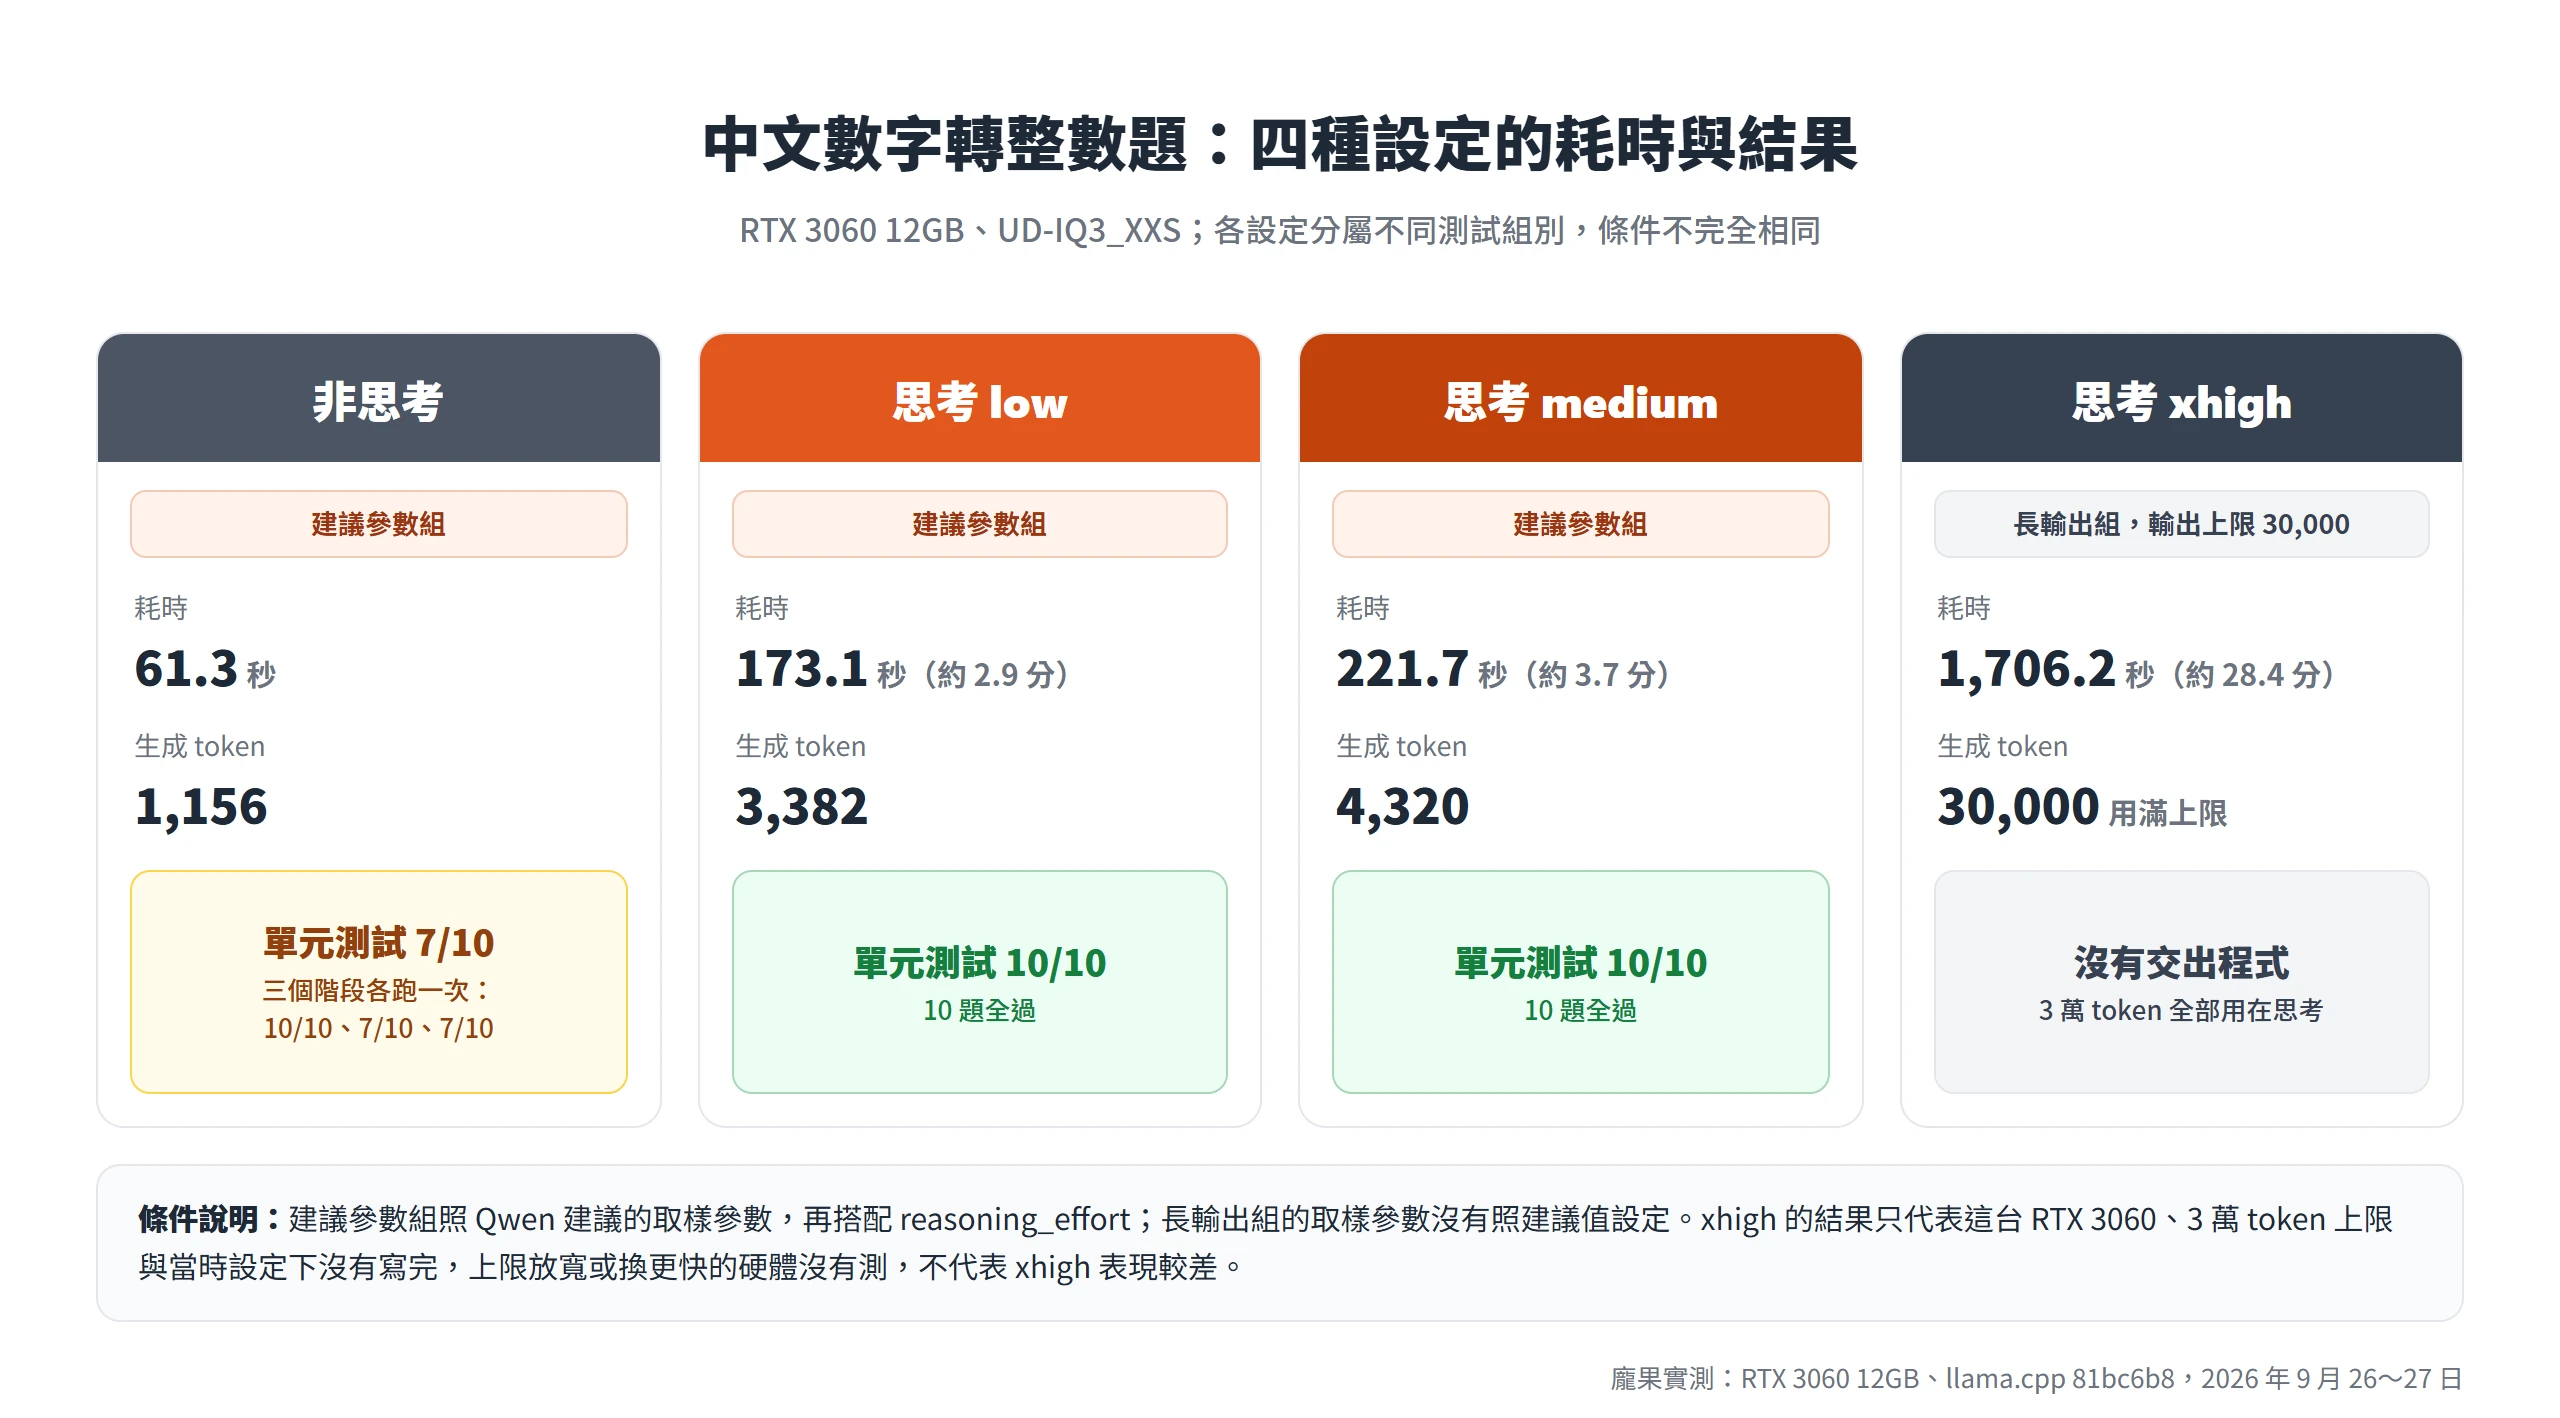
同樣是中文數字轉整數那一題,思考模式用預設的 xhigh、輸出上限給到 3 萬 token,結果模型想了 1,706.2 秒,也就是 28.4 分鐘,3 萬個 token 全部花在思考上,最後一行程式都沒有交出來,平均生成速度每秒 17.6 個 token。更早在上下文 8K、輸出上限 6,000 token 的階段,同一題的 xhigh 也是用滿上限被截斷,跑了 308.6 秒。
這個結果要連同條件一起看。xhigh 那次屬於長輸出組,那組的取樣參數沒有照 Qwen 的建議值設定;後面 low 與 medium 那兩次屬於建議參數組,取樣參數有照建議值。兩邊的條件並不完全相同。沒寫完這件事,是「用光我們設的 3 萬 token 上限」加上「這張顯卡每秒約 20 個 token」兩件事疊在一起的結果。上限放寬,或換一張快得多的硬體,結果可能不一樣,這兩種情況我們都沒有測。所以能說的只到「在這台 RTX 3060、3 萬 token 上限、當時的設定下,xhigh 沒有寫完」為止,不代表 xhigh 比較差,也不代表 Qwen 的預設值不好。
xhigh 也不是每一題都失敗。最長迴文子字串那題,8K 階段的 xhigh 用了 5,607 個 token、約 4.8 分鐘,單元測試 6 題全過;畫一隻 SVG 橘貓那題,給足上限之後,xhigh 用了 20,045 個 token、約 18 分鐘,畫出比非思考模式精緻許多的一隻,有虎斑紋也有光暈效果。在這張顯卡上,xhigh 主要的代價是等待時間。
low 與 medium 不到 4 分鐘寫完程式,單元測試全過
同一題改用 Qwen 建議的取樣參數,再搭配 reasoning_effort,low 用了 173.1 秒(約 2.9 分鐘)、medium 用了 221.7 秒(約 3.7 分鐘),兩者的單元測試都是 10 題全過。非思考模式最快,但我們在三個階段各跑過一次,結果分別是 10/10、7/10、7/10。這三次分屬不同組別、條件不完全相同,但同一題就出現了兩種結果,非思考模式寫出的程式一定要跑過測試才能用。
| 設定 | 測試組別與條件 | 耗時 | 生成 token | 單元測試結果 |
|---|---|---|---|---|
| 非思考 | 8K 組,上限 3,000 | 43.0 秒 | 842 | 10/10 |
| 非思考 | 長輸出組,上限 30,000 | 16.2 秒 | 299 | 7/10 |
| 非思考 | 建議參數組 | 61.3 秒 | 1,156 | 7/10 |
| 思考 low | 建議參數組 | 173.1 秒 | 3,382 | 10/10 |
| 思考 medium | 建議參數組 | 221.7 秒 | 4,320 | 10/10 |
| 思考 xhigh | 長輸出組,上限 30,000 | 1,706.2 秒 | 30,000 | 沒有交出程式 |
low 也不是永遠比較快。騎士與騙子這種簡單的邏輯題,low 用了 817 個 token、41.7 秒,8K 階段的 xhigh 反而只用 719 個 token、36.8 秒,兩者都答對。題目簡單時,等級之間的差距不大;差距會拉開的,是需要反覆推敲的題目。medium 的其他例子也一樣順利,待辦清單網頁用了 2,007 個 token、101.8 秒寫完,SVG 橘貓用了 1,378 個 token、69.9 秒完成,這兩筆我們只確認輸出完整,沒有另外做互動測試或評分。
Qwen 建議的推理長度上限換算成 RTX 3060 的等待時間
用簡單的算術就能判斷思考模式的時間成本。這張顯卡每 1,000 個思考 token 約 50 秒,想 5,000 個 token 就是 4 分鐘左右。Qwen 模型卡的最佳實務建議裡,為了代理任務的表現,推理內容的長度上限給到 262,144 token、最終回答給到 131,072 token;照每秒 20 個 token 換算,光是把推理上限用滿就要約 13,107 秒,也就是 3.6 小時,而且上下文填滿之後生成還會變慢。
在 RTX 3060 上直接套用這個上限並不實際,所以我們自己把輸出上限設在 3 萬 token,並把 effort 調低。llama.cpp 另外有一個 --reasoning-budget N 參數,可以硬性限制思考 token 的數量(預設 -1 代表不限制,0 代表立刻結束思考),跟 reasoning_effort 這種給模型的軟性指令不同。這個參數我們沒有測,只提供作為另一個選項。
在 llama.cpp 指定 reasoning_effort 的三種方式
第一種是用啟動參數,替整台伺服器設定預設值。這是 Unsloth 文件寫的做法,參數會傳進 jinja 聊天模板,所以 --jinja 要保持開啟:
llama-server -m Qwen3.8-27B-UD-IQ3_XXS.gguf --jinja \
  --chat-template-kwargs '{"reasoning_effort":"low"}'Code language: Bash (bash)
第二種是新版 llama-server 文件裡的 --reasoning-effort 參數,一樣是整台伺服器的預設值,寫法比較短。不設定時是 default,也就是保留模板自己的預設(Qwen3.8 就是 xhigh):
llama-server -m Qwen3.8-27B-UD-IQ3_XXS.gguf --jinja --reasoning-effort lowCode language: Bash (bash)第三種是每次請求自己帶,在 chat_template_kwargs 裡放 reasoning_effort,同一台伺服器就能依任務切換:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "messages": [{"role": "user", "content": "寫一個 Python 函式判斷質數"}],
    "temperature": 1.0,
    "top_p": 0.95,
    "top_k": 20,
    "min_p": 0,
    "presence_penalty": 0,
    "chat_template_kwargs": {"reasoning_effort": "low"}
  }'Code language: Bash (bash)
不管用哪一種,都要記得 Qwen3.8 的聊天模板只接受 xhigh、medium、low 三個值。llama-server 文件裡的 --reasoning-effort 雖然列了 high、max 這類等級,但依 Qwen 原版模板的寫法,傳入這三個以外的值會直接丟出錯誤,錯誤訊息會列出它支援的三種。Unsloth GGUF 檔內建的模板多做了一步,會把 high 當成 xhigh 處理,max 這類值則一樣會報錯。
在這台顯卡上,我們最後的用法是這樣分工:一般問答、摘要、寫程式草稿用非思考模式,求快;需要準確的推理、程式與潤稿,用思考模式搭配 low;做網頁、畫圖、動畫這類成品導向的任務,願意等的時候才用思考模式,並把輸出上限給到 1 到 3 萬 token。
Qwen3.8 27B 12GB 這個組合,在 RTX 3060 上是真的跑得起來的。靠著 UD-IQ3_XXS 量化、KV 快取壓到 q4_0、批次調小、視覺模組移出顯存,換來每秒約 20 個 token 的生成速度與 64K 的上下文。代價也同樣清楚,每一 GB 都算得很緊,思考模式要主動調低 effort、給對輸出上限,否則等待時間會超出耐心。先用一個真的長請求確認設定穩定,再依任務決定要不要讓模型思考、想多深,這張 12GB 顯卡就能成為一台堪用的本機模型伺服器。