
Qwen3.8 27B 是 Qwen 團隊在 2026 年 8 月 14 日開放權重的大型語言模型,270 億個參數全部參與運算,是 Qwen3.8 系列三個開放權重模型中唯一的 dense 架構,也是體積最小的一個。它能直接讀圖片與影片,原生上下文約 26 萬 token,授權是可以商用、也能修改的 Apache 2.0。系列另外兩個模型都是總參數上千億的 MoE 架構,只有 27B 在量化之後放得進一張消費級顯示卡。
文章前半先介紹它的規格,包括四分之三的層改用線性注意力,為什麼能讓長文少占記憶體;預設開啟的思考模式,reasoning_effort 的三段深度各自在做什麼;以及模型卡上的六項基準分數,是在什麼條件下測出來的。
後半是實測。我們把 3-bit 量化版裝在一台 RTX 3060 12GB 的主機上,從數學、邏輯、程式、事實題、翻譯與看圖,一路測到 5.8 萬 token 的長文找資料,最後接上 Hermes Agent 當代理,記下它在家用硬體上做得好的工作、會出錯的地方,以及對應的參數設定。
Qwen3.8-27B 是什麼?
Qwen3.8-27B 是阿里巴巴集團 Qwen 團隊(Qwen Team)推出的開放權重模型,2026 年 8 月 14 日同步上架 Hugging Face 與 ModelScope。它是一個 270 億參數的 dense 模型,也是原生的視覺語言模型,圖片、影片都能直接輸入,輸出則是文字。模型卡把它的類型標成「Causal Language Model with Vision Encoder」,也就是在語言模型之外,多接了一個視覺編碼器。
Qwen 是阿里巴巴的大型語言模型品牌,歷經好幾個世代才更新到現在的 3.8 系列,品牌本身的發展脈絡與選型觀念,可以先從 Qwen 的總覽文認識。
Qwen 團隊形容 27B 是一個「compact, deployment-friendly dense model」,意思是精簡、容易部署。它的架構直接建立在 Qwen3.5 的基礎上(模型卡原文是「Built on the architectural foundation of Qwen3.5」),設定檔 config.json 裡的架構名稱仍是 Qwen3_5ForConditionalGeneration。這一點對使用者很有利,原本已經支援 Qwen3.5 的工具,例如 llama.cpp,通常可以直接載入 27B。
27B 沒有另外發表技術報告,正式的說明只有 Hugging Face 上的模型卡與 GitHub 上的 README,支援幾種語言、用了多少訓練資料都沒有公布。另外,搜尋 Qwen3.8 時常會看到「Qwen3.8 35B A3B」這個組合,不過 Qwen 團隊並沒有推出這個尺寸,Hugging Face 上掛這個名字的是社群自己蒸餾出來的版本。
Qwen3.8 三個開放權重模型中唯一的 dense 架構
Qwen3.8 系列目前在 Hugging Face 上有三個開放權重模型,27B 是其中唯一的 dense 架構,體積也最小。旗艦 Qwen3.8-2.4T-A95B 在 8 月 12 日先釋出,採用 MoE(混合專家)架構,總參數 2.4 兆、每次推論只啟用其中 950 億,這種規模需要資料中心等級的硬體才跑得動。兩天後釋出的 27B 則是 dense 架構,每次推論 270 億個參數全部參與運算,量化之後可以放進單張消費級顯示卡。8 月 26 日公開的 Qwen3.8-Flash-Next 同樣是 MoE,總參數 1,250 億、每次啟用 60 億,Qwen 團隊把它定位成預覽下一代架構的實驗模型。
同系列的旗艦 Qwen3.8-Max 更早就以預覽版亮相,那是另一個規模、另一種使用方式的產品;27B 則是能自己下載、自己部署的開放權重版本。
Qwen 團隊放出的原始權重是 BF16 格式,18 個分片合計約 55.6GB,另外也提供 FP8 版本。一般的消費級顯示卡裝不下這個大小,所以在家跑多半要靠社群做的量化檔,我們測試用的也是量化版。
Apache 2.0 授權,可商用也可修改
27B 採用 Apache 2.0 授權,可以商用,也可以修改、再散布。對想把模型接進自家產品或內部系統的團隊來說,這是限制少、條件也容易評估的一種授權。
同系列的旗艦則沒有用同一份授權,而是另一份自訂的 Qwen3.8-Max License,兩者的條件不同。只打算用 27B 的話,看 Apache 2.0 就夠了。
混合注意力架構撐起 26 萬 token 上下文
規格表上最值得看的有兩件事。一是 27B 有四分之三的層改用線性注意力,處理長文時需要存下的 KV 快取比較少;二是它原生就支援 262,144 個 token 的上下文,也就是大約 26 萬個 token,要更長才需要另外開 YaRN,而且開了可能讓短文的表現變差。
token 是模型切分文字的基本單位。以我們這次測試的輸出來看,1 個 token 大約對應 1.1~1.4 個中文字,後面提到的上下文長度、輸出上限與生成速度,都是用 token 計算。
四分之三的層改用線性注意力
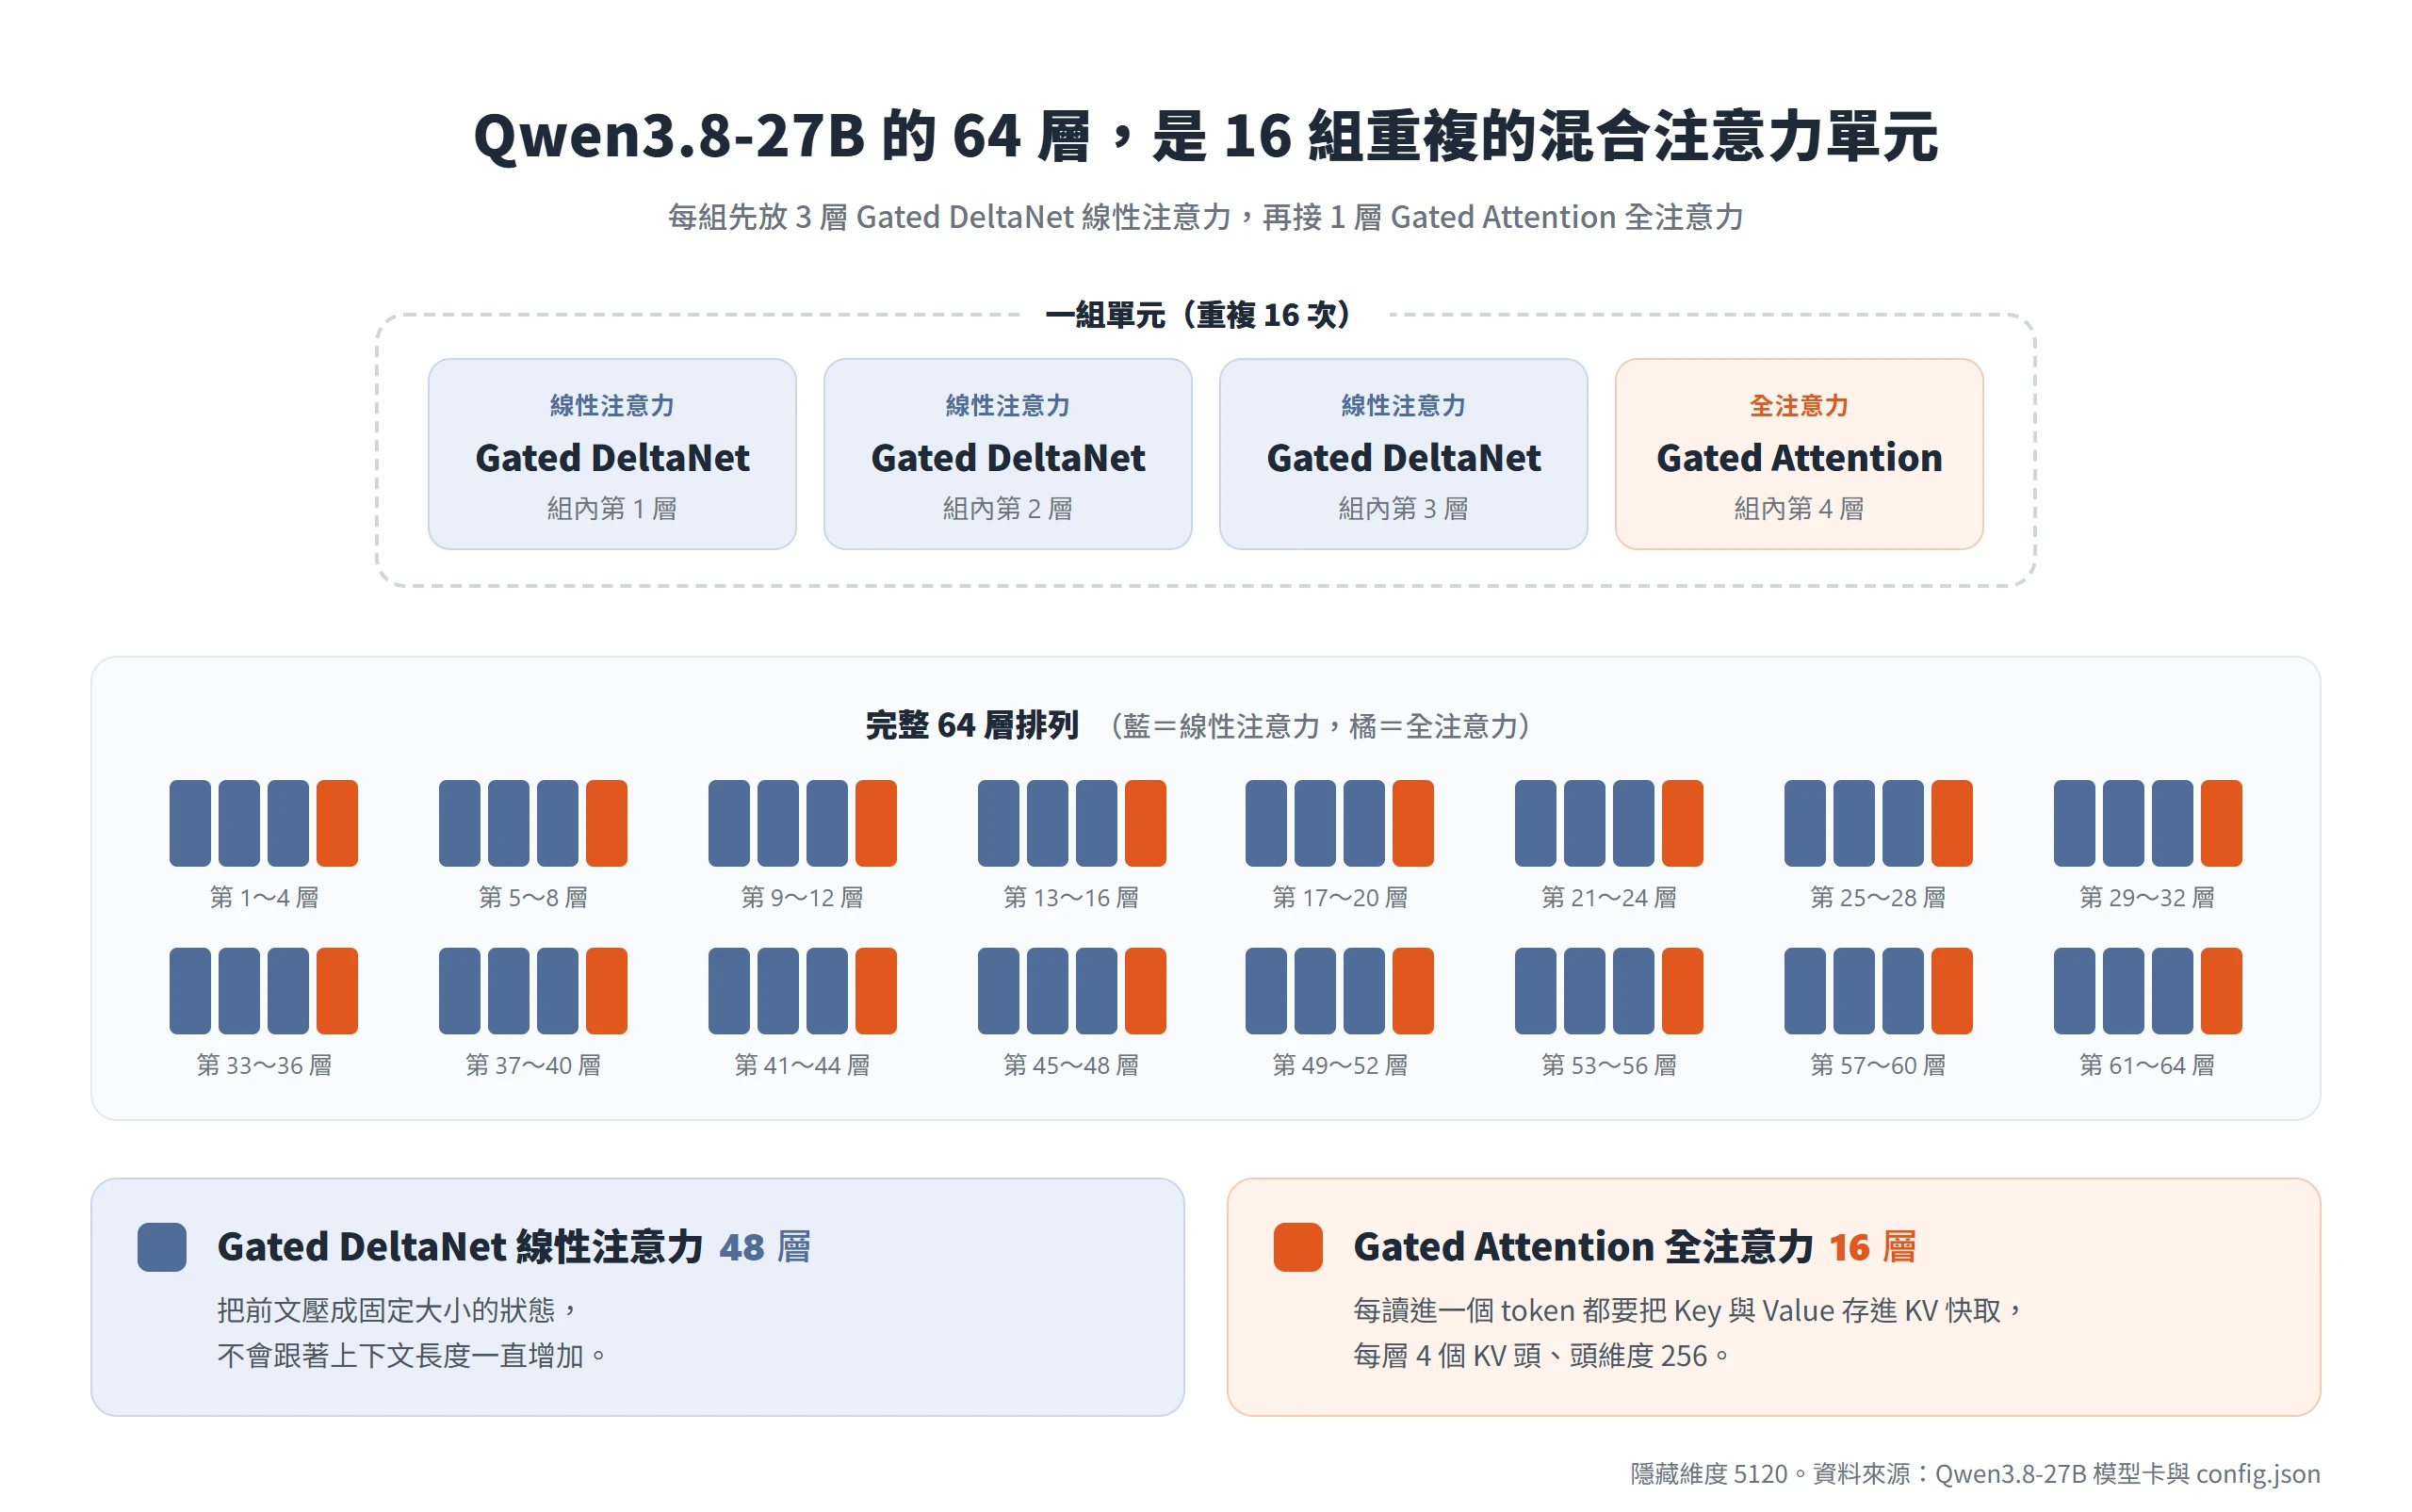
27B 共有 64 層,隱藏維度 5120。這 64 層並不是同一種結構,而是 16 組重複的單元,每組先放 3 層 Gated DeltaNet 線性注意力,再接 1 層 Gated Attention 全注意力,所以總共是 48 層線性注意力加上 16 層全注意力。
差別在於記住前文的方式。全注意力層每讀進一個 token,都要把它的 Key 與 Value 存進 KV 快取,上下文越長,快取就越大;線性注意力層則把前文壓成固定大小的狀態,不會跟著長度一直增加。27B 只有 16 層全注意力需要存 KV 快取,而且每層只有 4 個 KV 頭(頭維度 256),這是它能在小容量的顯示記憶體上開長上下文的結構原因。我們在 12GB 顯示卡上把上下文開到 64K,靠的就是這個特性,再加上把 KV 快取壓成 q4。
模型卡另外提到,27B 用多步的 MTP(Multi-Token Prediction,多 token 預測)方式訓練。MTP 讓模型一次預測後面好幾個 token,支援的推論框架可以拿它來加速生成。llama.cpp 要另外加上 --spec-type draft-mtp 才會啟用 MTP,我們的啟動參數沒有加這一項,所以後面的速度數字都不含 MTP 加速。
原生上下文 262,144 token,更長才開 YaRN
模型卡寫明 27B 原生支援 262,144 token,透過 YaRN 這類 RoPE 縮放技術可以延伸到約 100 萬 token。不過模型卡也提醒,主流開源框架實作的都是靜態 YaRN,縮放倍數不會隨輸入長度調整,可能拉低短文的表現。所以模型卡建議只在真的要處理超長文件時才修改設定,並依常用的長度調整倍數,例如常用長度落在 524,288 token 時,把 factor 設成 2.0。
另一組值得注意的數字是輸出長度。針對代理任務,模型卡建議把推理內容的上限設到 262,144 token、最終回答的上限設到 131,072 token。換句話說,27B 在設計上就是一個「想得很長、答得也很長」的模型。我們在 RTX 3060 上測試時,輸出上限給得不夠,思考模式好幾次還沒寫到答案就被截斷,跟這個設計方向有很大的關係。
圖片與影片都能直接輸入的原生視覺模型
27B 看圖、看影片的能力是模型本身就有的,不是另外外掛一個模型。模型卡列出的範圍從理工科的圖表、文件,一路到「小時級」的長影片;設定檔裡的視覺編碼器有 27 層、隱藏維度 1152。
在 llama.cpp 這類使用 GGUF 格式的工具上,視覺部分是獨立的一個檔案,叫作 mmproj。Unsloth 提供的 GGUF 版本裡,mmproj-F16.gguf 約 928MB、mmproj-BF16.gguf 約 931MB,要另外下載、啟動時一起載入,否則模型只讀得到文字。顯示記憶體吃緊時,也可以把這個視覺模組放在 CPU 上執行,我們在 12GB 顯示卡上就是這樣處理的。
要處理長影片的話,還可以調整影片前處理的設定。模型卡建議把 video_preprocessor_config 裡的 longest_edge 設成 469,762,048(對應約 22.4 萬個影片 token),讓模型用更高的影格率取樣小時級的影片。這屬於進階用法,一般看圖不需要動它。
思考模式預設開啟,reasoning_effort 分成三段
Qwen3.8-27B 預設會先思考再回答,這是用它時最先會碰到的設定。每次回答前,模型會先輸出一段包在 <think>...</think> 裡的思考內容,再給出正式回答。思考模式是推理模型共通的做法,推理模型和一般聊天模型的差別,可以先從推理模型的通論理解。
思考可以逐次關閉。在 OpenAI 相容的 API 請求裡加上 chat_template_kwargs,把 enable_thinking 設成 false,這一次就會直接回答;要保留思考、只調整深度,則改傳 reasoning_effort。以 llama.cpp 的 llama-server 為例,伺服器要啟用 Jinja 樣板引擎,這些參數才會生效(目前版本預設就開啟,我們啟動時也加上了 --jinja)。下面兩段是依 llama.cpp 與 Unsloth 文件的寫法整理的請求範例,我們沒有逐字執行過這兩段:
# 這一次不思考,直接回答
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"用一句話說明 RAG"}],
       "chat_template_kwargs":{"enable_thinking":false}}'

# 保留思考,但把深度調成 low
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"用一句話說明 RAG"}],
       "chat_template_kwargs":{"reasoning_effort":"low"}}'Code language: Bash (bash)
多輪對話還有一個 preserve_thinking 設定,預設開啟,會把歷史訊息的思考內容都保留在上下文裡。只想保留最新一輪的思考,可以把它設成 False,讓長對話少佔一些上下文。
xhigh、medium、low 三段思考深度
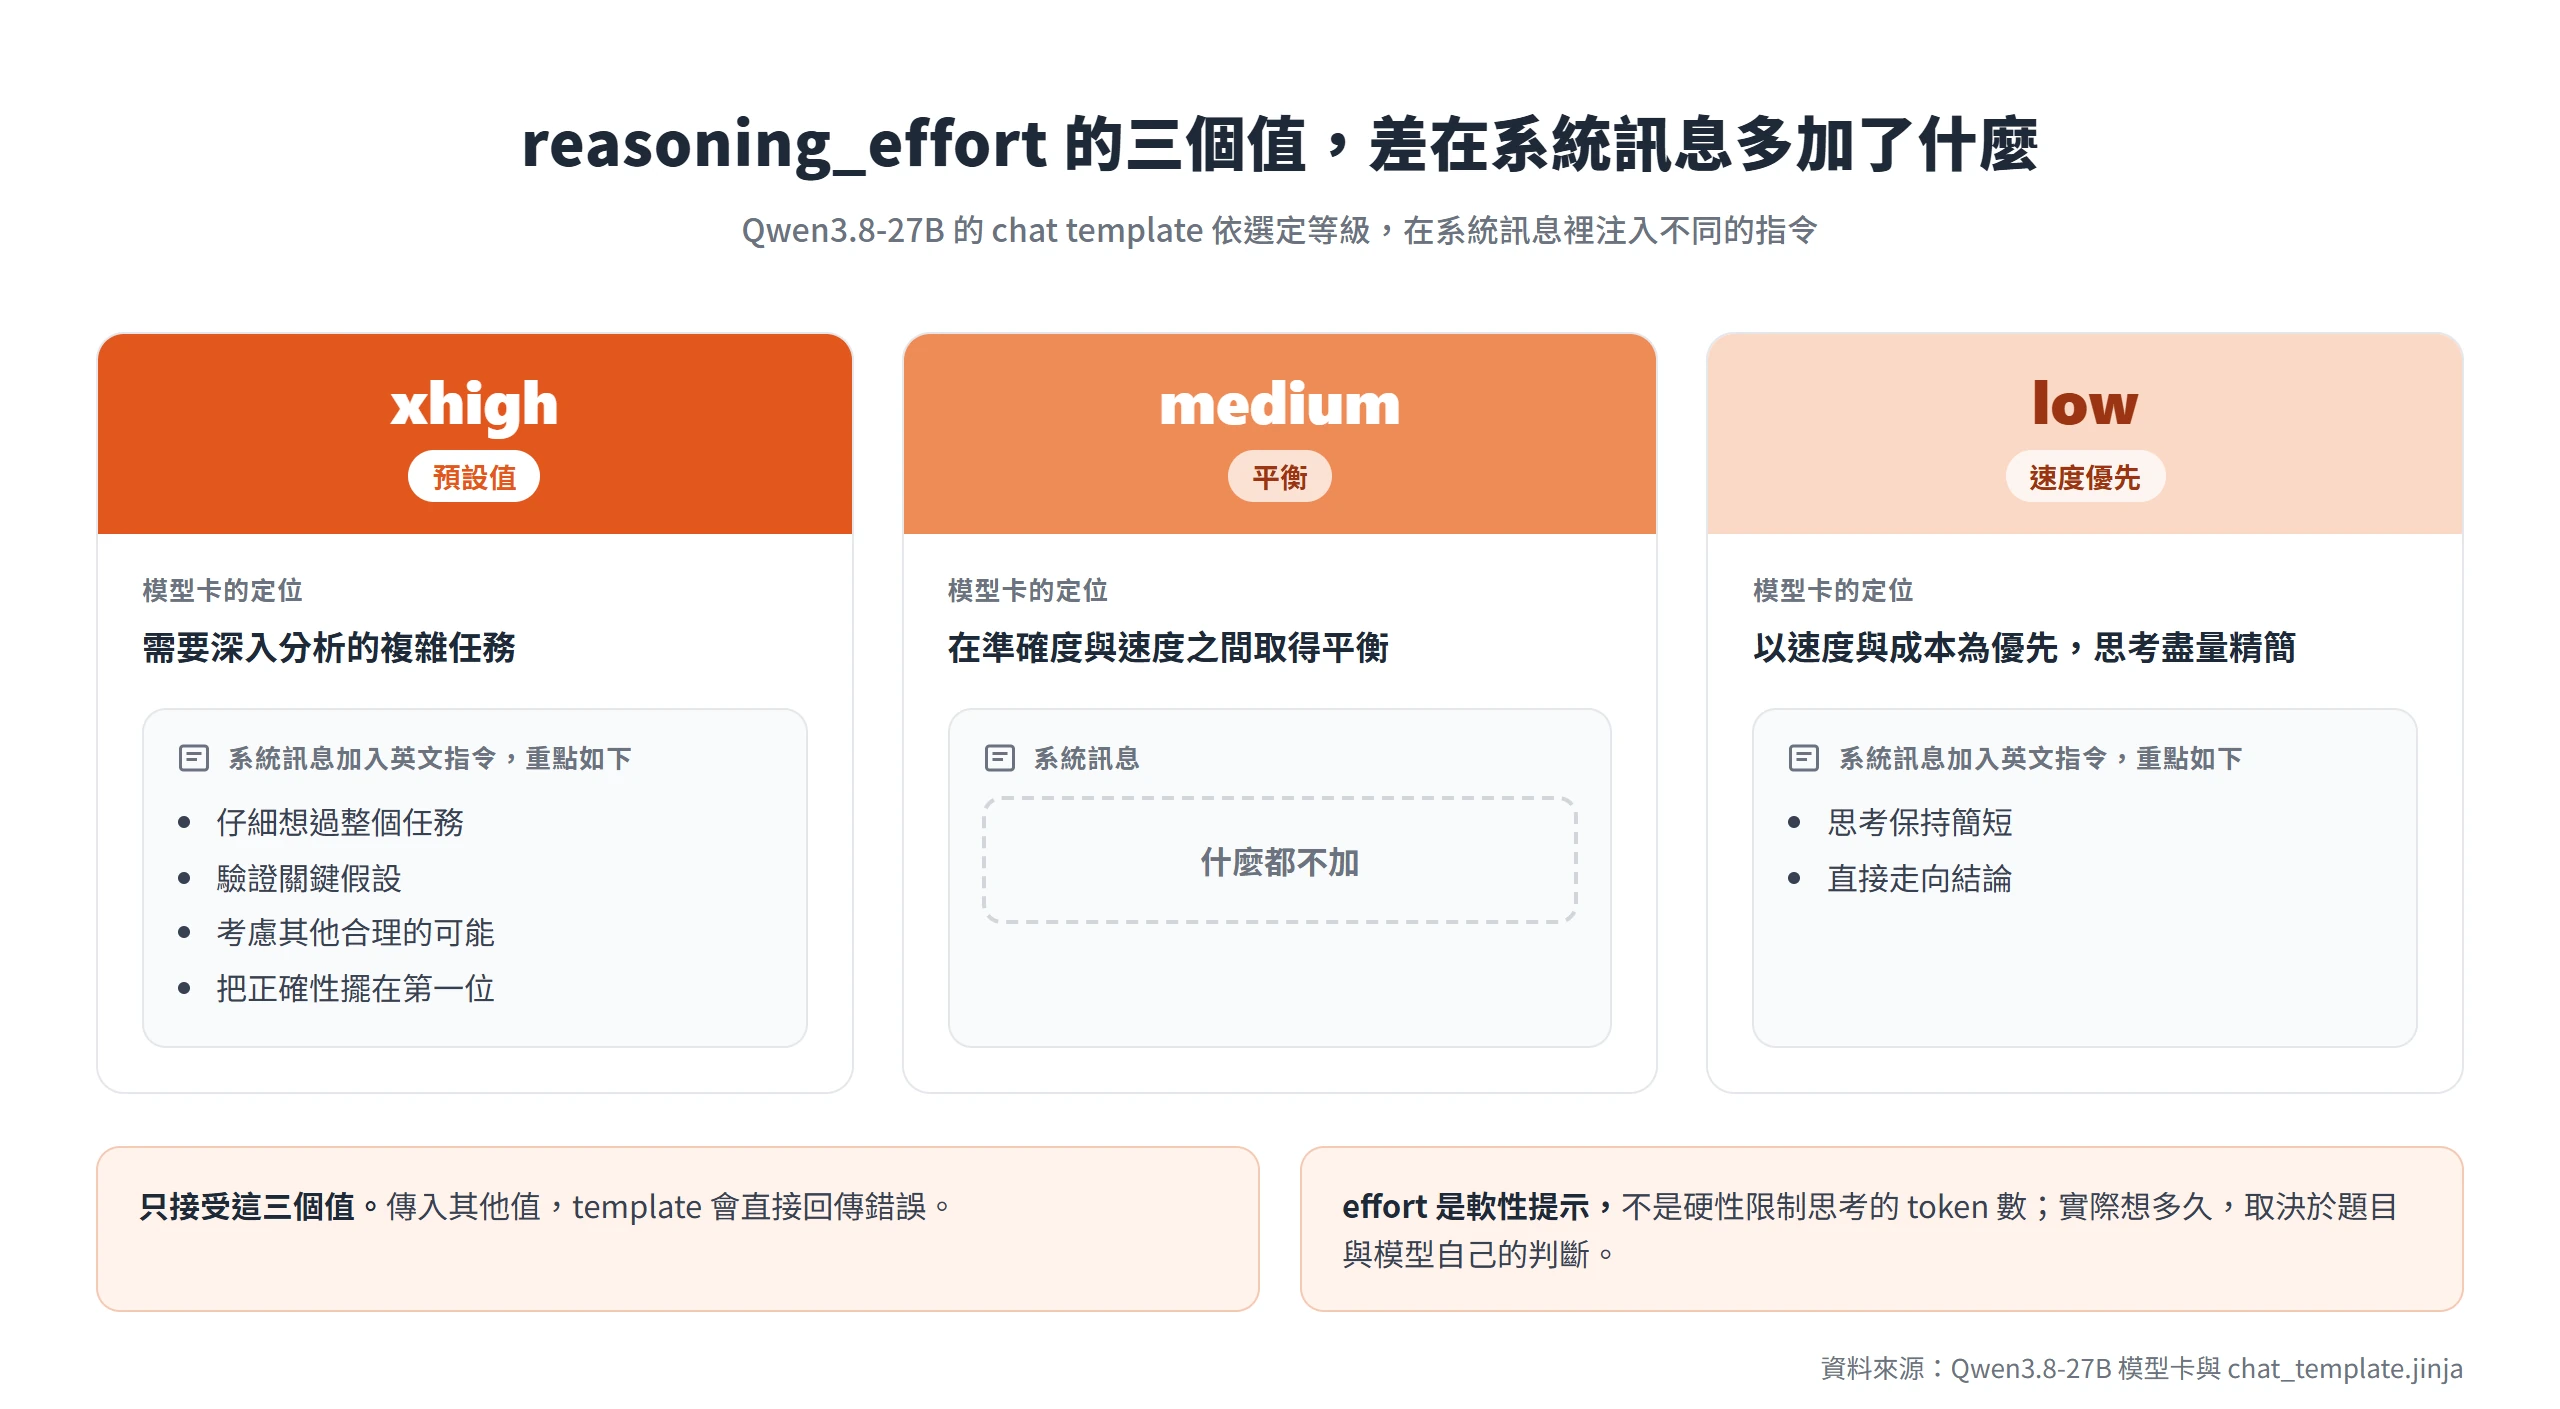
reasoning_effort 只有三個值。xhigh 是預設值,模型卡的定位是給需要深入分析的複雜任務;medium 在準確度與速度之間取得平衡;low 則以速度與成本為優先,讓思考盡量精簡。
這三個等級怎麼運作,從 chat template 看得最清楚。template 只接受 xhigh、medium、low 三個值,其他值會直接回傳錯誤。選 xhigh 時,它會在系統訊息裡加入一段英文指令,要求模型仔細想過整個任務、驗證關鍵假設、考慮其他合理的可能,並把正確性擺在第一位;選 low 時加入的是「思考保持簡短、直接走向結論」;medium 則什麼都不加。由此可見,effort 是一段軟性的提示,而不是硬性限制思考的 token 數,模型在 xhigh 下會照著指令反覆檢查,實際要花多少 token,取決於題目與模型自己的判斷。Hugging Face 討論區也有使用者回報,預設的 xhigh 碰到簡單任務一樣會想很久。
Qwen 團隊自己也提醒了反方向的情況。在多輪的代理任務裡,調低 effort 雖然讓每一輪回應變快,卻可能因為分析不足而失敗、重試,整體的延遲與 token 用量反而增加。所以 effort 並不是越低越好,要看任務是一問一答,還是要連續執行好幾個步驟。
思考與非思考模式各有一組取樣參數
兩種模式建議的取樣參數不一樣,切換模式時,參數也要跟著換。模型卡列出的建議值如下:
| 參數 | 思考模式 | 非思考模式 |
|---|---|---|
| temperature | 1.0 | 0.7 |
| top_p | 0.95 | 0.80 |
| top_k | 20 | 20 |
| min_p | 0.0 | 0.0 |
| presence_penalty | 0.0 | 1.5 |
| repetition_penalty | 1.0 | 1.0 |
模型卡另外註明,各推論框架支援的取樣參數不盡相同,設定前要先確認手上的工具吃得到哪些參數。這組建議值我們一開始並沒有照著設,第一批 8K 上下文的測試用的是另一組取樣參數,後來才改用建議值重測一部分題目。所以後面引用 8K 組的結果時,要記得那是在非建議參數下跑出來的,早期測到的不少問題也集中在這一組。
模型卡對 presence_penalty 還有一句提醒,這個值可以在 0 到 2 之間調整,用來抑制無止盡的重複,但調高時偶爾會出現語言混雜,表現也可能略降,而非思考模式的建議值正好是 1.5。我們測試中看到的簡體字現象,和這段說明的方向一致;不過出現簡體字的題目多半在 8K 組,那一組並沒有照建議值設定,兩者之間的關係我們沒有驗證過。
模型卡自評的六項基準分數與測試條件
Qwen 團隊在模型卡上公布了一整張基準測試表。挑出幾個容易理解的項目,27B 自評的分數如下:
- SWE-bench Pro:61.7,測的是修正真實軟體專案裡的問題,接近工程師日常的工作。
- Terminal Bench 2.1:73.0,讓模型在終端機裡下指令、寫程式、完成任務。
- LiveCodeBench v6:90.3,程式競賽類型的題目。
- IFBench:79.5,看模型能不能精準遵守各種格式與限制條件。
- GPQA Diamond:89.2,研究所程度的物理、化學、生物題目。
- OSWorld-Verified:84.3,模型看著電腦畫面、操作介面完成任務的能力。
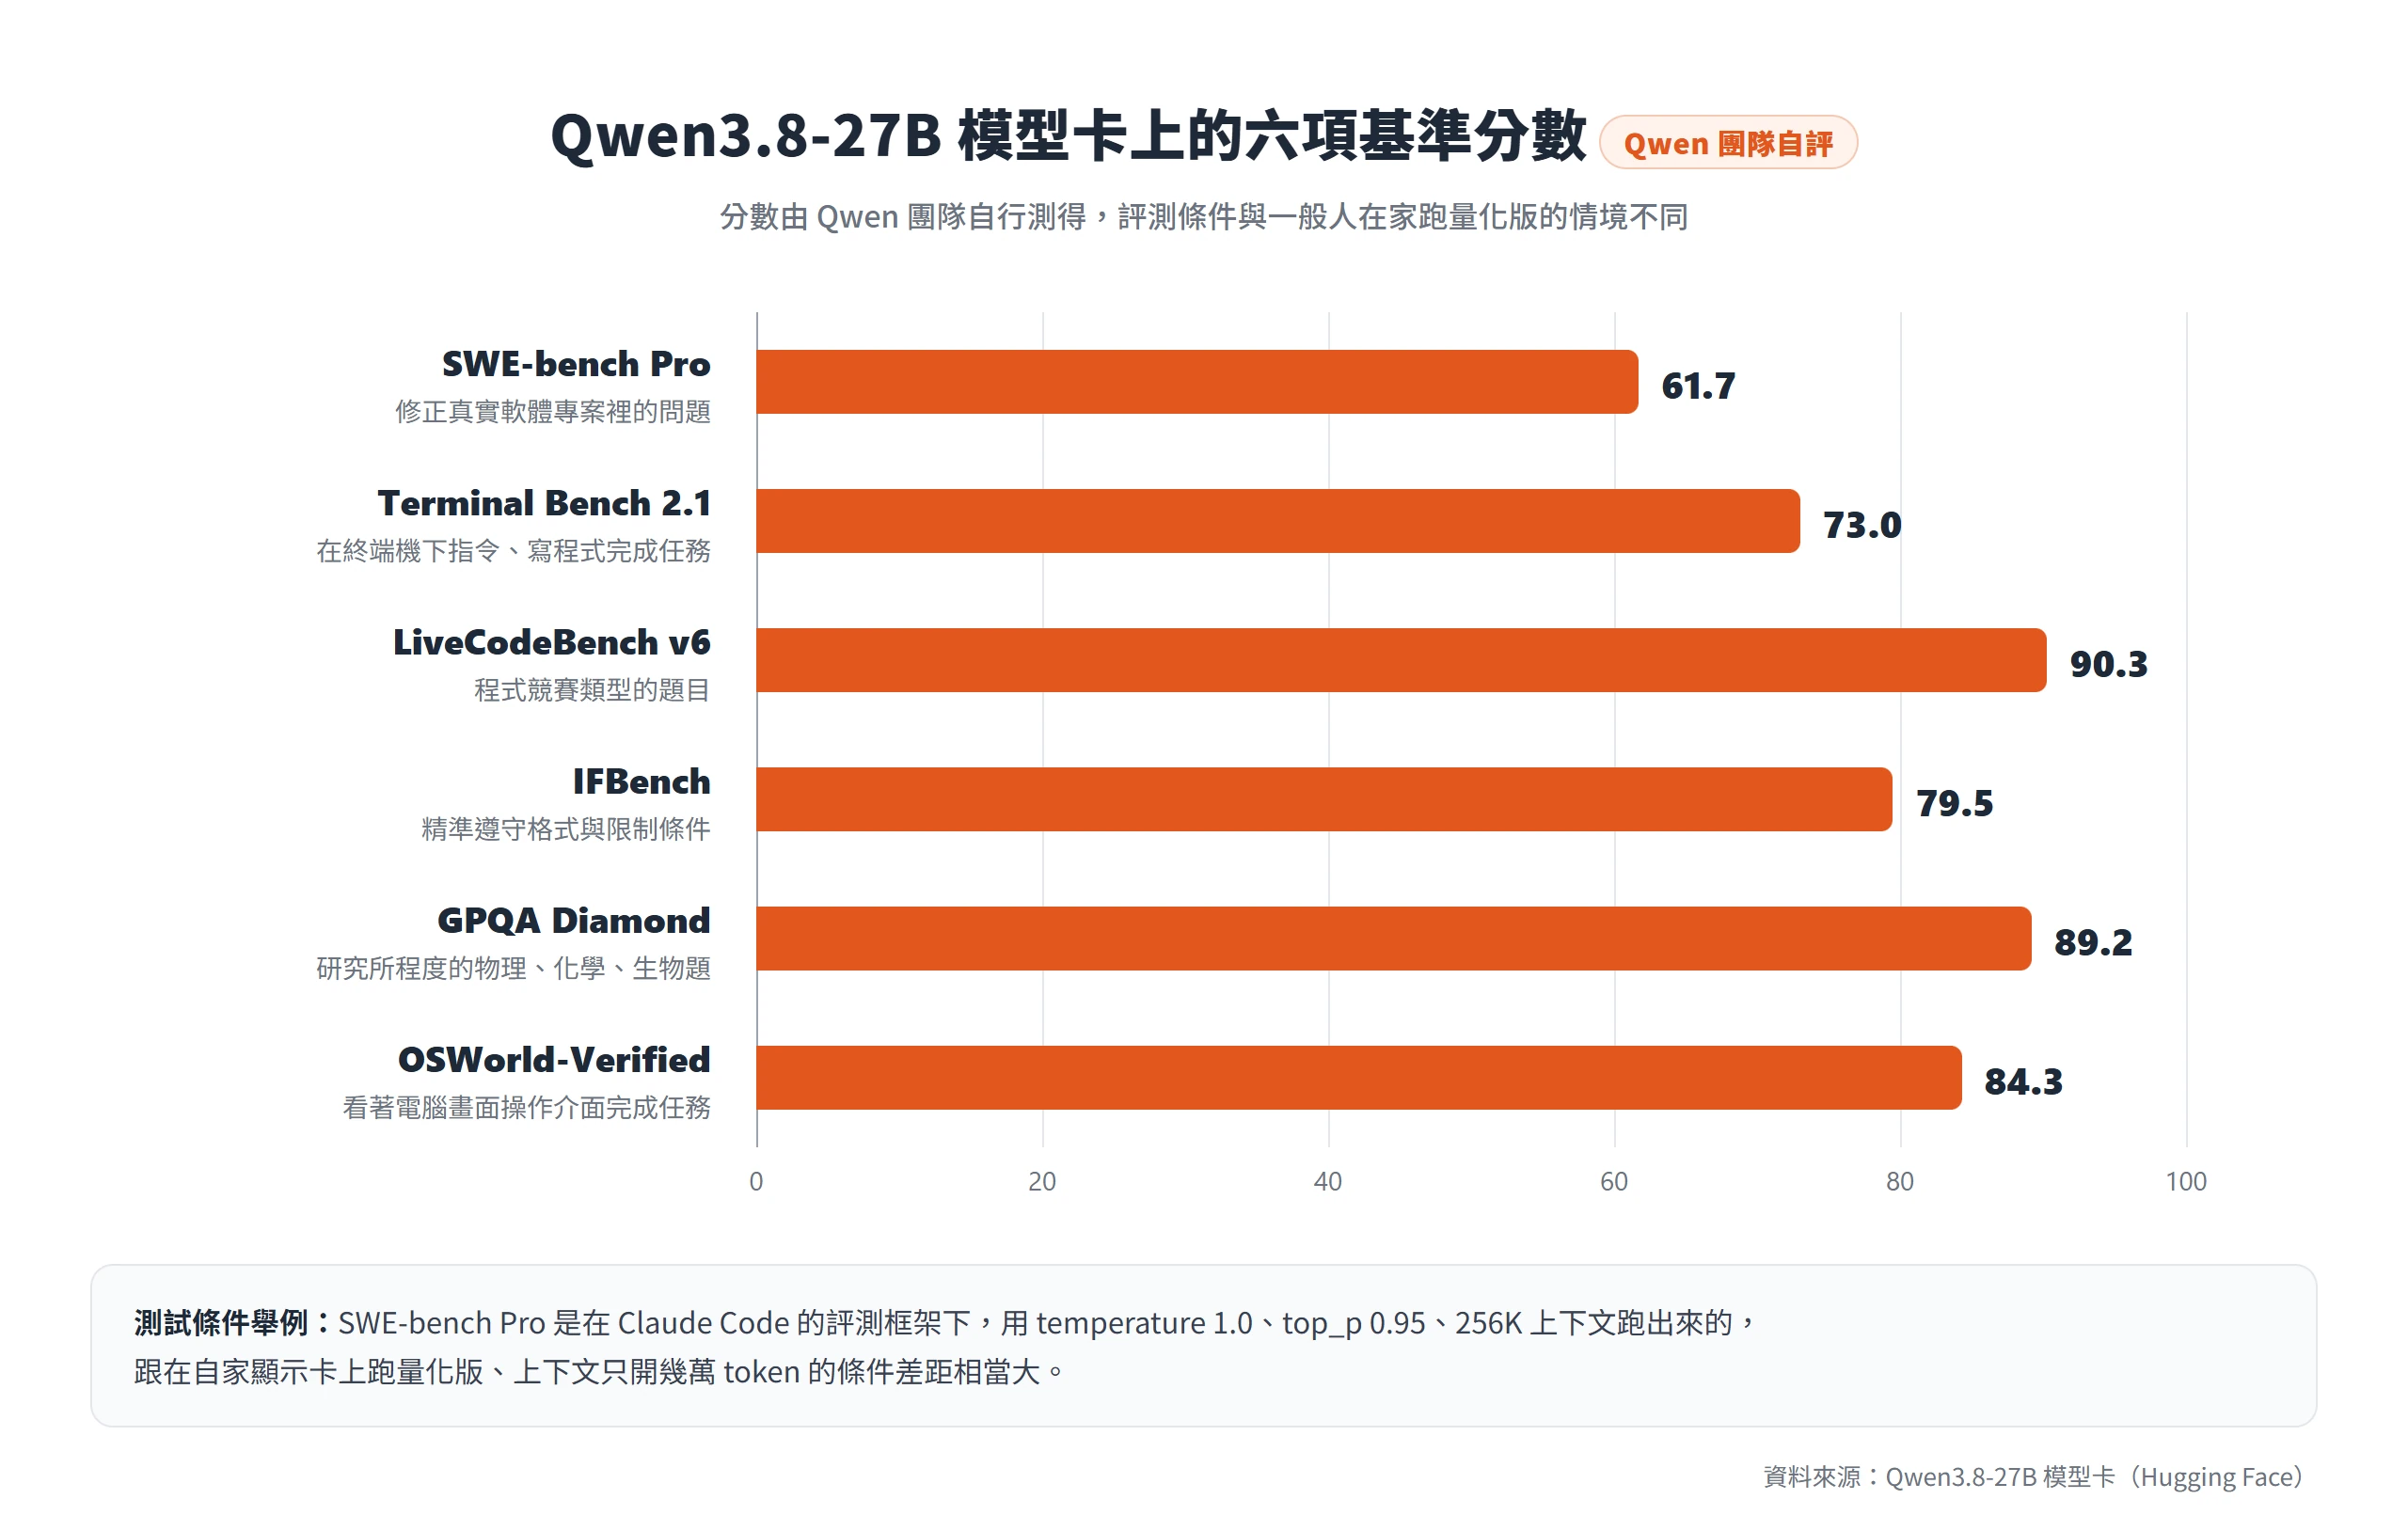
這些數字都是 Qwen 團隊自己測的,評測條件也跟一般使用情境不同。以 SWE-bench Pro 為例,模型卡註明是在 Claude Code 的評測框架下,用 temperature 1.0、top_p 0.95、256K 上下文跑出來的。這跟一般人在自家顯示卡上跑量化版、上下文只開幾萬 token 的條件,差距相當大。
模型推出的時間還不長,獨立的第三方評測也還不多。分數可以當作能力方向的參考,至於在自己的硬體上表現如何,還是得實際跑過才算數,所以我們把它裝上一張 RTX 3060,照自己的用途出題。
RTX 3060 12GB 上的測試環境和參數
測試在 2026 年 9 月 26 日到 27 日進行,用的是一台裝 Ubuntu 24.04 的 AI 主機,軟硬體條件如下:
| 項目 | 內容 |
|---|---|
| 硬體 | RTX 3060 12GB、記憶體 15GB |
| 系統與推論引擎 | Ubuntu 24.04、llama.cpp(2026-09-26 版,commit 81bc6b8) |
| 主要量化檔 | Unsloth 的 UD-IQ3_XXS(3-bit,10.9GB) |
| 對照量化檔 | Unsloth 的 UD-Q2_K_XL(2-bit,9.83GB) |
| 生成速度 | 每秒約 20 個 token |
約 55.6GB 的 BF16 原始權重不可能直接載入 12GB 顯示卡,所以我們改用 Unsloth 做的 GGUF 量化檔 UD-IQ3_XXS,把權重壓到約 3 位元。Unsloth 同時也是知名的模型微調工具,這個團隊與它的微調工具另有介紹。
Unsloth 自己的文件把 3-bit 版本的建議記憶體列在 12~14GB,我們的 12GB 顯示卡剛好落在下限邊緣,要把 KV 快取壓縮、把視覺模組移到 CPU,才讓 64K 上下文穩定跑起來。為什麼挑這個量化檔、啟動參數怎麼下、顯示記憶體不足當機後怎麼解決,都整理在部署紀錄裡。
也可以用 Ollama 跑 27B,不過 Ollama 模型庫預設的 27b 標籤約 18GB,12GB 顯示卡放不下,要改拉 Hugging Face 上較小的量化檔。Ollama 的安裝與基本指令,可以參考 Ollama 入門教學。
測試分成 4 組,設定不完全一樣:
- IQ3 8K 組:上下文 8K,輸出上限非思考 3,000 token、思考 6,000 token,取樣參數沒有照模型卡設定。17 道基本題主要在這組跑,兩道網頁題的非思考模式另外把輸出上限放寬到 7,000 token 重跑過一次。
- IQ3 長輸出組:上下文 64K,輸出上限放寬到 30,000 token,用來重跑被截斷的網頁、畫圖與程式題。
- IQ3 建議參數組:上下文 64K,改用模型卡的取樣參數,並指定 reasoning_effort。
- Q2_K_XL 組:換成 2-bit 的 UD-Q2_K_XL、上下文 64K,當作量化位元更低時的對照。
17 道題目涵蓋知識 1 題、事實 1 題、數學 2 題、邏輯 1 題、程式 2 題、網頁 2 題、畫圖與動畫 2 題、寫作 1 題、翻譯 1 題、格式 2 題、圖像生成提示詞 1 題、看圖 1 題,每題都跑思考與非思考兩種模式。另外還做了程式題的思考深度對照、長文大海撈針、潤稿測試,以及接上 Hermes Agent 的代理任務。沒有做成對照的組合,例如 8K 組思考模式的網頁題被截斷、沒有產出,就不列入結果。
生成速度方面,短上下文的題目每秒約 20 個 token,換算成中文大約每秒 20~28 個字。這個速度用來聊天、寫短文夠用,但思考模式動輒幾千個 token 的推理,就得等上好幾分鐘。
這組測試有三個限制要先講清楚:
- 用的是 3-bit 量化版,結果不代表 BF16 原版的表現,顯示記憶體也只落在建議範圍的下限。
- 第一批 8K 測試的取樣參數沒有照模型卡設定。
- 每題多半只跑一次,偶然的成分無法排除。
以下所有結論,都只代表「RTX 3060 12GB+llama.cpp+UD-IQ3_XXS」這套條件,不外推到其他硬體。
數學、邏輯、格式遵循題全數答對
這一類題目 27B 在兩種模式下都答對,是整輪測試裡最穩的一塊。
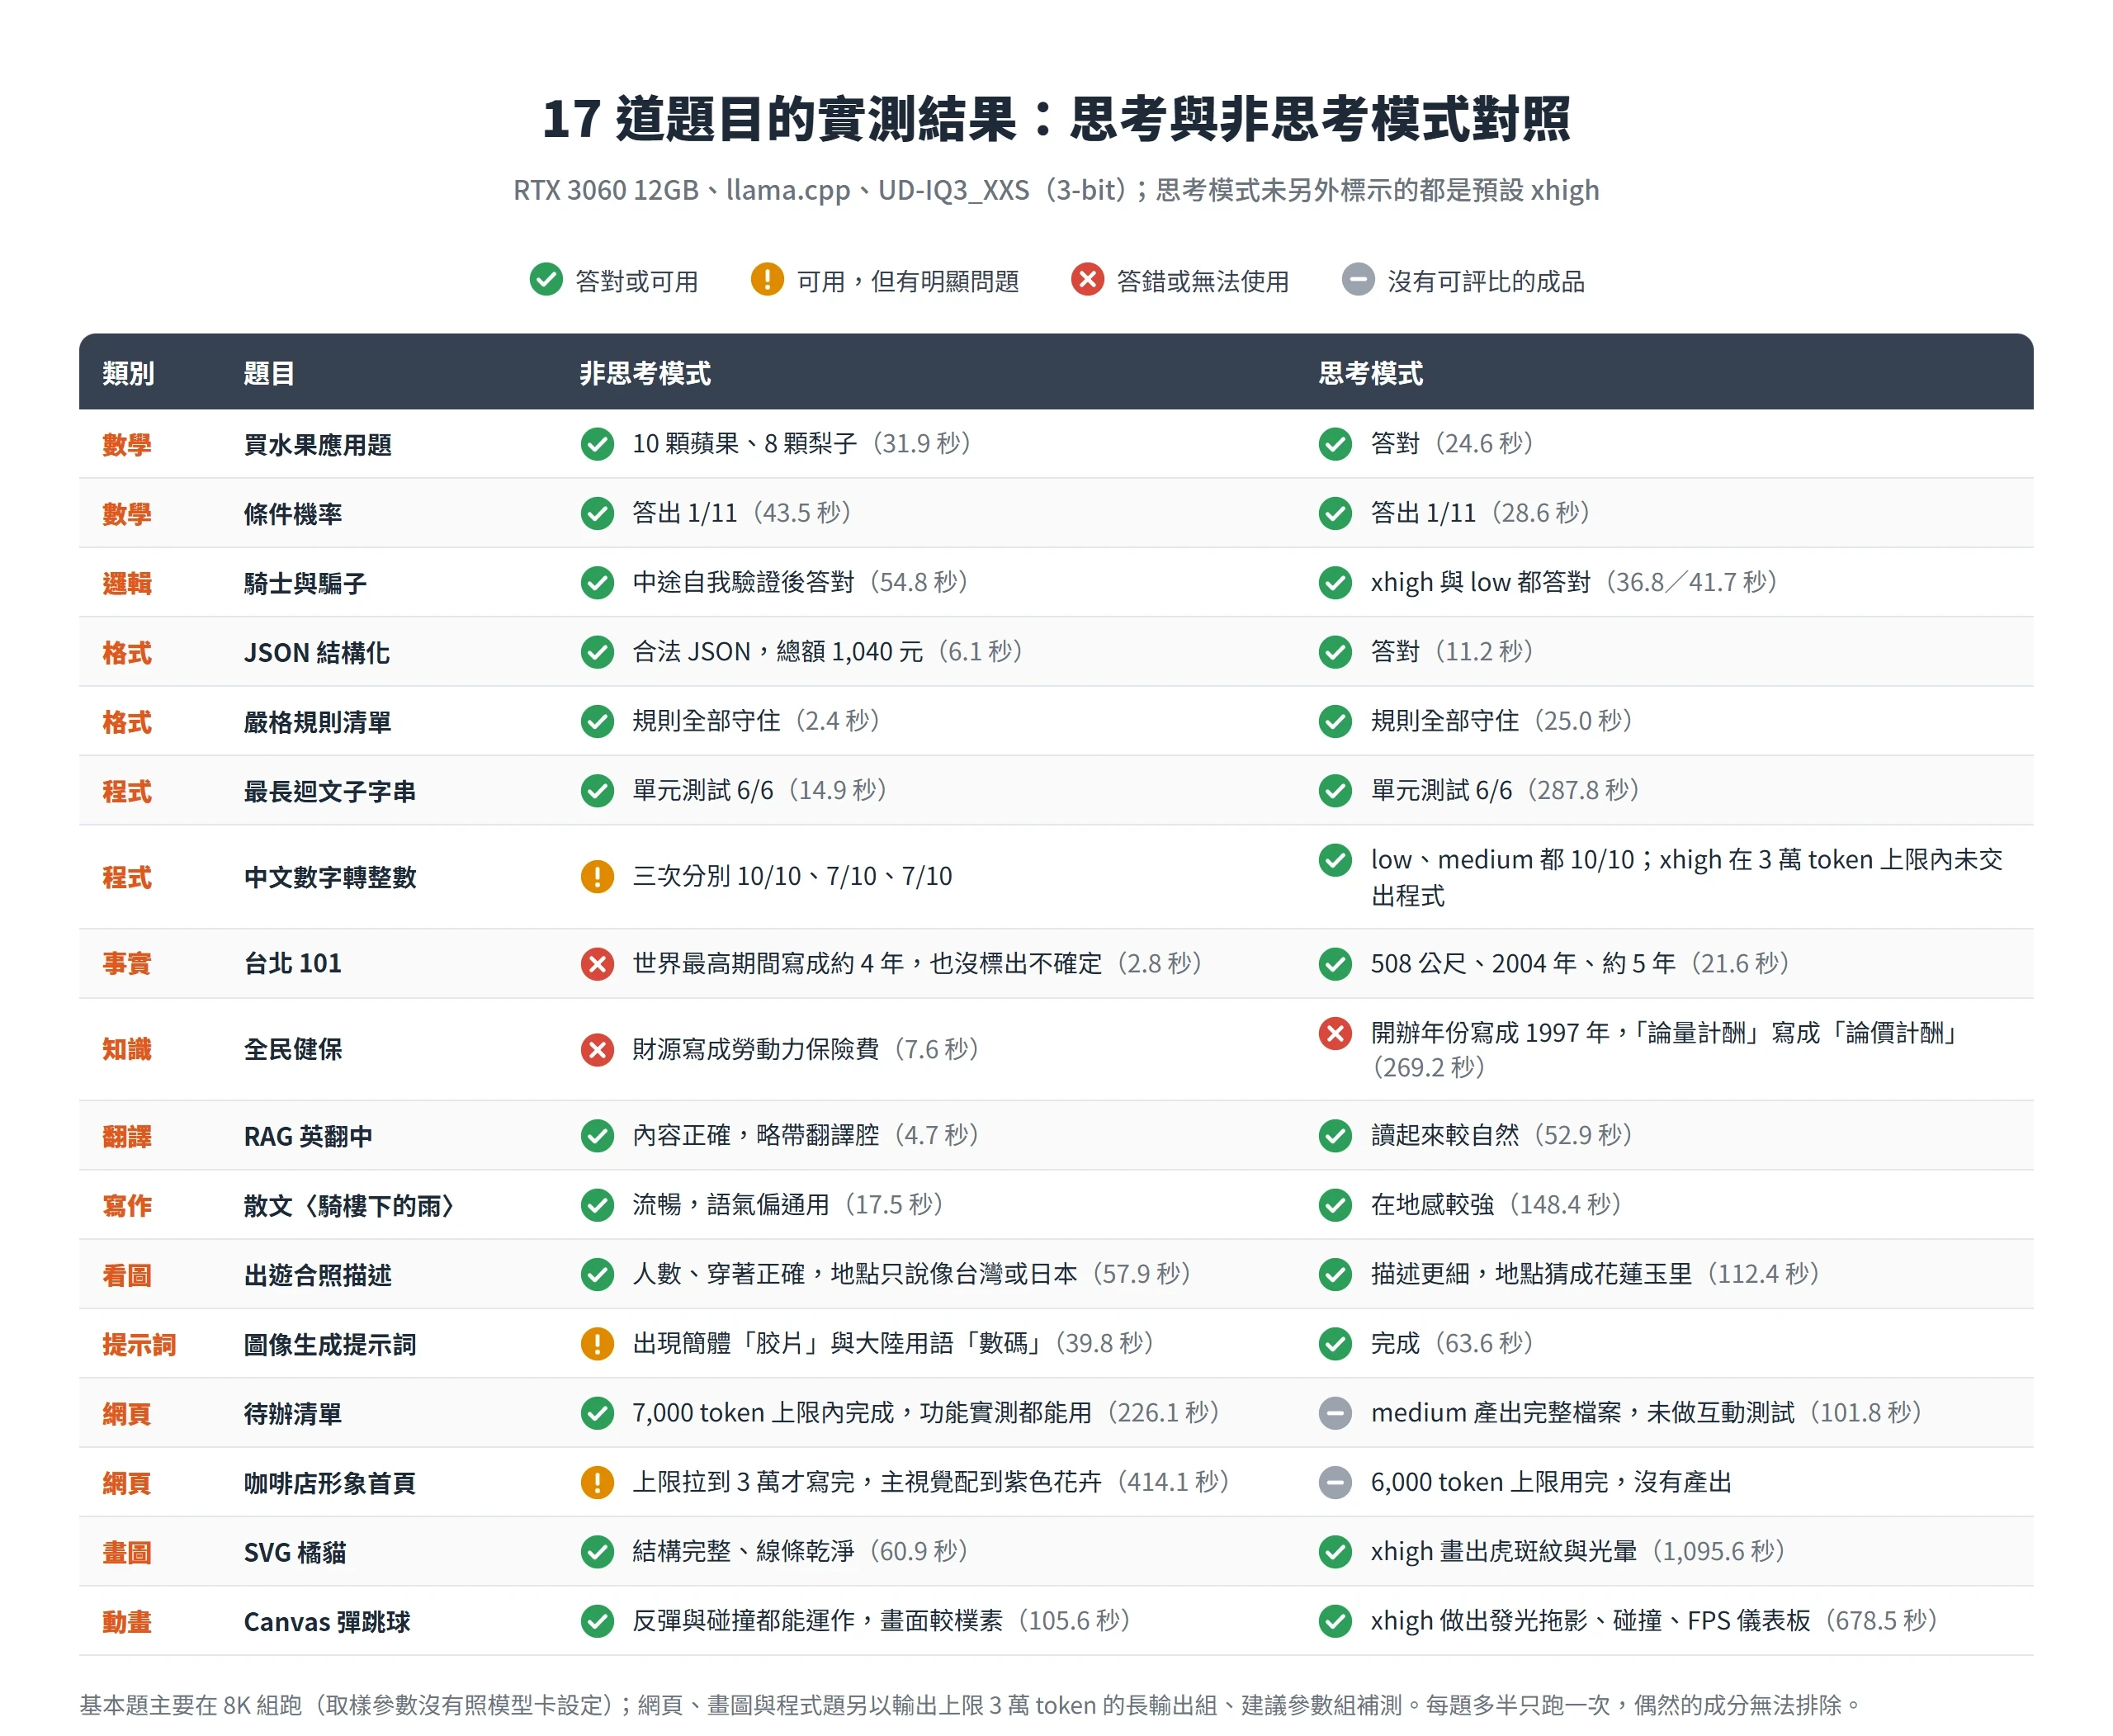
買水果應用題給的條件是蘋果每顆 25 元、梨子每顆 40 元,共買 18 顆、花了 570 元,兩種模式都算出 10 顆蘋果、8 顆梨子。非思考模式花 31.9 秒、輸出 624 個 token,思考模式反而更快,只用 24.6 秒、478 個 token。條件機率題問的是擲兩顆骰子、已知至少一顆是 6 時,兩顆都是 6 的機率,兩種模式都答出 1/11;非思考模式還用列舉與補集兩種方法各算一次,花了 43.5 秒,思考模式則是 28.6 秒。
邏輯題是經典的騎士與騙子題型,騎士永遠說真話、騙子永遠說謊,A、B、C 三人各說一句話,要判斷每個人的身分。兩種模式都得出 A 是騎士、B 和 C 是騙子。比較有意思的是非思考模式的推理過程,它先驗證「A 是騎士」這個假設可以成立,接著寫下「看來這個假設(A 是騎士)似乎是成立的?」這樣的自我懷疑,再回頭驗證「A 是騙子」會導出矛盾,才正式定案,前後花了 54.8 秒。非思考模式沒有獨立的思考區塊,卻也會在回答中途自己補驗證一次。思考模式 xhigh 用了 36.8 秒,改用建議參數、effort 設成 low 重跑則是 41.7 秒,也都答對。
格式題更能看出它守規矩的程度。JSON 題要求照指定結構,把一段訂單描述轉成 JSON,訂單內容是 3 包芒果乾每包 180 元、2 罐花生醬每罐 250 元,選擇超商取貨。兩種模式都只輸出合法的 JSON、沒有多餘文字,總額 1,040 元算得正確,delivery 欄位也正確填入「超商取貨」,非思考模式只花了 6.1 秒。
嚴格規則清單題的限制最多,包括剛好 5 點、每點用「- 」開頭、每點不超過 15 個中文字、全文不能出現「的」字,也不能有任何開頭或結尾說明。兩種模式全部守住。非思考模式 2.4 秒就交出答案,只用了 36 個 token,5 點分別是「劃定專用辦公區」、「設定固定工作時段」、「使用番茄鐘法則」、「遠離手機干擾源」、「定期起身伸展」。
這和模型卡上 IFBench 拿到 79.5 的方向一致。單次測試證明不了什麼,但在這套條件下,要它照格式輸出、照規則寫清單,是相對可靠的工作。
非思考模式寫程式快,但結果不穩定
程式題的結果呈現兩種樣貌。非思考模式幾秒到一分鐘就交出程式,但同一題跑三次,通過率不一樣;思考模式在預設的 xhigh 下,有一題在我們給的 3 萬 token 輸出上限內沒有寫完,改成 low 或 medium 後,4 分鐘內就全部通過。每支程式我們都實際執行單元測試,不是看起來對就算數。
先看比較單純的最長迴文子字串,題目要求時間複雜度在 O(n²) 以內,長度相同時回傳最先出現的那一個。非思考模式 14.9 秒、284 個 token 就寫完,6 個單元測試全數通過;思考模式 xhigh 花了 287.8 秒、5,607 個 token,結果一樣是 6/6。同樣答對,思考模式多花了約 19 倍的時間,這種難度的題目,非思考模式就夠用了。
中文數字轉整數題,非思考模式三次結果各不相同
中文數字轉整數這題要寫一個 Python 函式,把「一萬零三百二十」轉成 10320、「兩千萬零一」轉成 20000001,需要處理零、兩、十、百、千、萬、億這些字,我們準備了 10 個單元測試。非思考模式在三組設定下各跑了一次,結果並不相同:
- 8K 組:43.0 秒、842 個 token,10 個測試全數通過。
- 長輸出組:16.2 秒、299 個 token,通過 7 個。
- 建議參數組:61.3 秒、1,156 個 token,通過 7 個。
這三次的設定並不完全相同,上下文長度與取樣參數都有差異,所以不能當成同條件重跑三次。不過同一道題、同一個模型,一次全對、兩次只過 7 成,已經足以說明非思考模式交出來的程式,要先跑過測試才能拿去用。它寫得很快,這是優點,也是最容易讓人放鬆檢查的地方。
xhigh 在 RTX 3060 與 3 萬 token 上限下沒有交出程式
同一題換成思考模式、維持預設的 xhigh,在長輸出組跑了 1,706.2 秒,約 28.4 分鐘,把 3 萬 token 的輸出上限整個用完,被截斷時還停在思考階段,沒有交出任何程式碼。這段思考內容大多是英文推理與程式草稿,生成速度是每秒 17.6 個 token。在 8K 組給 6,000 token 上限時情況也一樣,308.6 秒後上限用完,同樣沒有答案。
這個結果牽涉兩件事,要分開來看。28 分鐘是硬體速度造成的,RTX 3060 每秒只能產出十幾到二十個 token,3 萬個 token 本來就要跑將近半小時;沒有寫出程式,則是思考內容把我們設定的 3 萬 token 輸出上限用光了。前面提到 xhigh 會在系統訊息裡要求模型驗證關鍵假設、考慮其他可能,它一再反覆推敲可能與此有關,但我們沒有證據證明兩者的因果關係。
所以這個結果的解讀範圍很窄。在 RTX 3060 12GB、3 萬 token 輸出上限的條件下,xhigh 沒有在上限內寫完這道題,這不代表 xhigh 比較差,也不代表預設值設得不好。上限再放寬、或換成更快的硬體,結果可能不同,這部分我們沒有測。
改用 low 或 medium,4 分鐘內通過全部單元測試
同一題改用建議參數組,把 reasoning_effort 換成 low 與 medium,兩次都在 4 分鐘內交出通過全部 10 個測試的程式。四種設定放在一起比較如下:
| 設定 | 耗時 | 生成 token | 單元測試結果 |
|---|---|---|---|
| 非思考(三次) | 16.2~61.3 秒 | 299~1,156 | 10/10、7/10、7/10 |
| 思考 low | 173.1 秒(約 2.9 分鐘) | 3,382 | 10/10 |
| 思考 medium | 221.7 秒(約 3.7 分鐘) | 4,320 | 10/10 |
| 思考 xhigh | 1,706.2 秒(約 28.4 分鐘) | 30,000(達上限) | 3 萬 token 上限內未交出程式 |
low 比 medium 少用約 900 個 token、快了將近 50 秒,兩者都比非思考模式慢,換到的是穩定的全對。在每秒只有 20 個 token 左右的 12GB 顯示卡上,單輪的程式題用 low,是兼顧時間與正確性的實際選擇。
不過這是單輪題的結果,多輪代理任務要另外評估,理由就是前面提到的 Qwen 團隊提醒。慢硬體上的思考深度、輸出上限與 llama.cpp 啟動參數怎麼搭配,部署紀錄裡有更完整的設定說明。
台北 101 與健保題錯在年份、期間、財源和制度用語
推理能力強,不代表事實就可靠。兩道事實與知識題裡,兩種模式各錯了不同的地方,思考模式修正了一個錯誤,卻在另一題錯出新的問題。
台北 101 題問高度、完工年份,以及曾經當了多久的世界最高建築,並要求「不確定的地方請直接說不確定」。非思考模式 2.8 秒就回答 508 公尺、2004 年完工,但把世界最高的期間寫成「約 4 年(2004 年至 2008 年)」,也沒有照題目要求標出不確定。思考模式 xhigh 用了 21.6 秒,答出 508 公尺、2004 年、約 5 年(2004 至 2010 年),這次是對的。依世界高層建築與都市人居學會(CTBUH)的摩天大樓資料庫,台北 101 高 508 公尺、2004 年完工,直到 2010 年初杜拜的哈里發塔落成,才讓出世界最高建築的頭銜。
換成 2-bit 的 UD-Q2_K_XL 版本,非思考與思考模式都答出 508 公尺、2004 年完工,期間寫成「約 6 年」(2004 至 2010 年),以年份粗估算是答對,不過非思考模式用了大陸譯名「迪拜」。
健保題要求用約 200 字介紹台灣的全民健康保險,並列出兩個優點與兩個缺點。非思考模式 7.6 秒寫完,但把財源寫成「主要依賴勞動力保險費」;思考模式花了 269.2 秒、5,260 個 token,保費分攤的描述大致正確,卻把開辦年份寫成 1997 年,還把衛生福利部所稱的「論量計酬」寫成「論價計酬」。根據衛生福利部的資料,全民健保在 1995 年 3 月開辦,保費由被保險人、投保單位與政府三方分擔,另外還有補充保險費。
兩題看下來,錯誤的型態很一致。年份、期間、財源、制度用語這類需要準確記憶的事實,模型寫得很有把握,卻不一定對;思考模式能修掉部分錯誤,但不保證事實正確。拿 27B 寫介紹、寫文章時,事實、年份與規格數字都要人工查證。
翻譯、散文與看圖大致可用,偶爾混入簡體字
繁體中文的寫作與翻譯整體可用,而且思考模式明顯更自然、更有在地感。看圖的描述相當準確,只有思考模式多補的地名聯想跟畫面對不上;另一個要知道的現象,是它偶爾會冒出簡體字和大陸用語,量化位元越低越明顯。
思考模式的翻譯、散文讀起來更自然
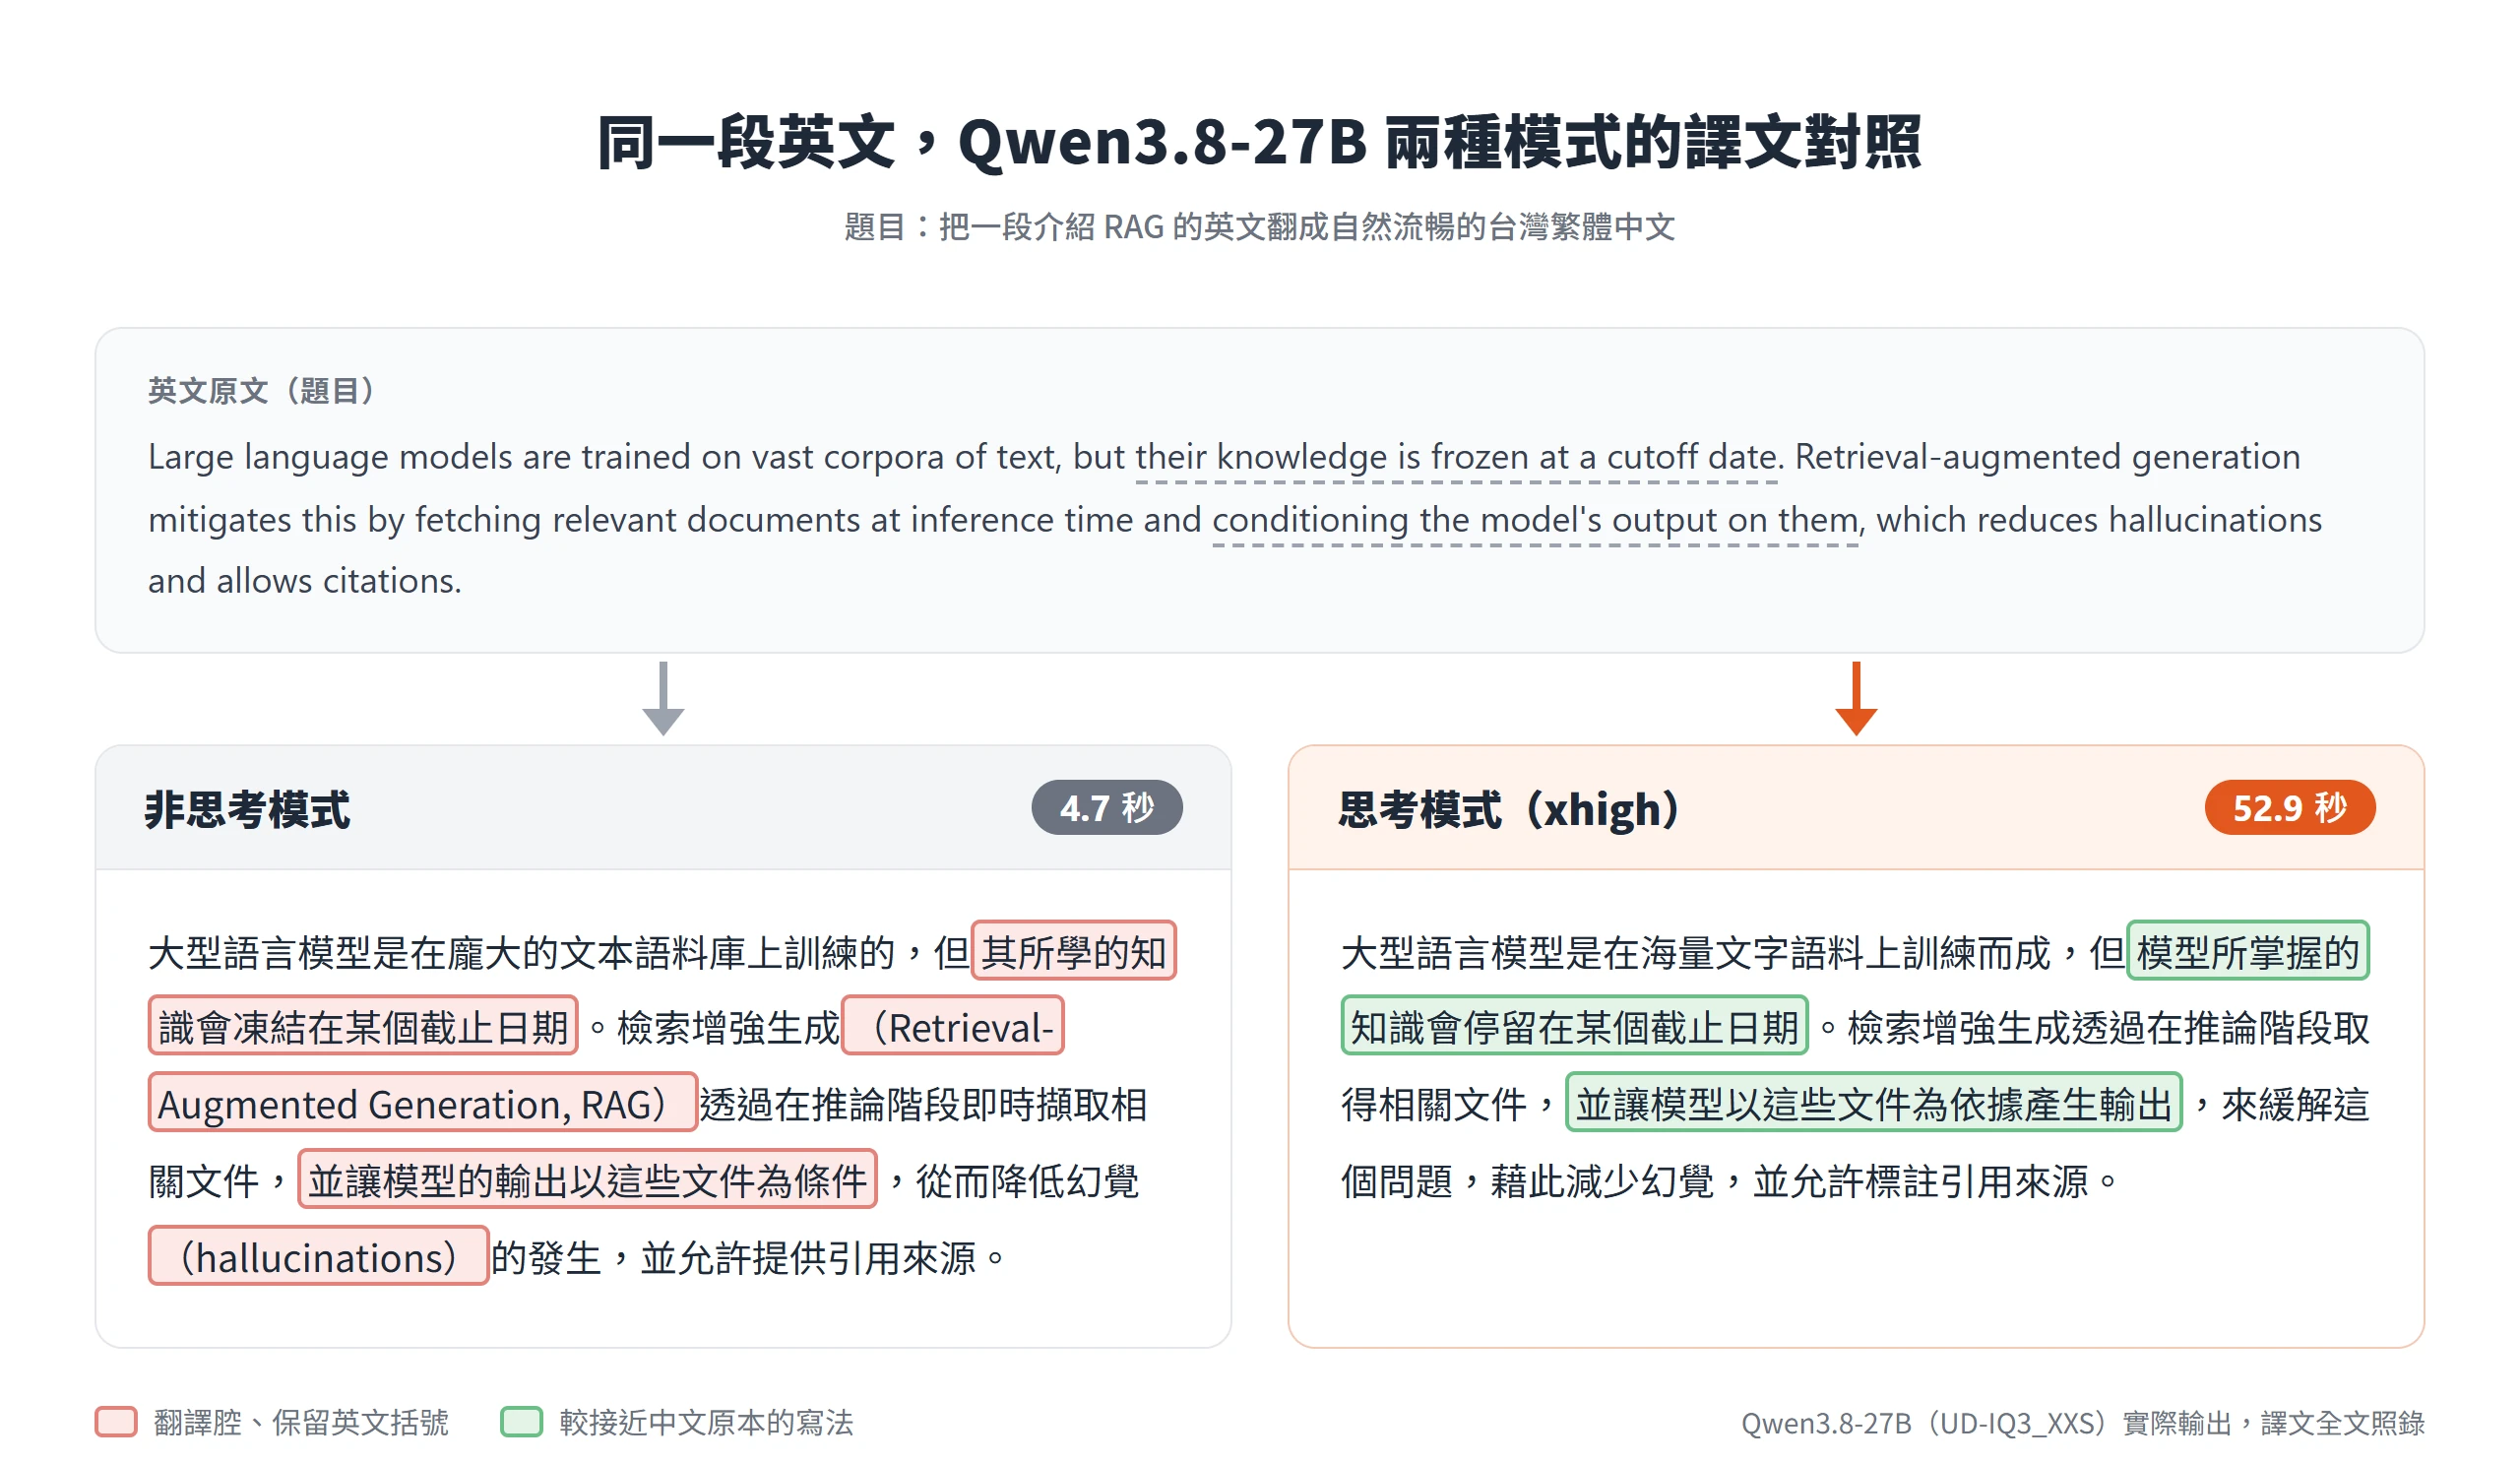
翻譯題是一段介紹 RAG(檢索增強生成)的英文。非思考模式 4.7 秒就譯完,內容正確,但有些句子帶著翻譯腔,像「其所學的知識會凍結在某個截止日期」、「讓模型的輸出以這些文件為條件」,還把英文原文留在括號裡。思考模式花了 52.9 秒,譯成「模型所掌握的知識會停留在某個截止日期」、「讓模型以這些文件為依據產生輸出」,讀起來就像中文原本的寫法。
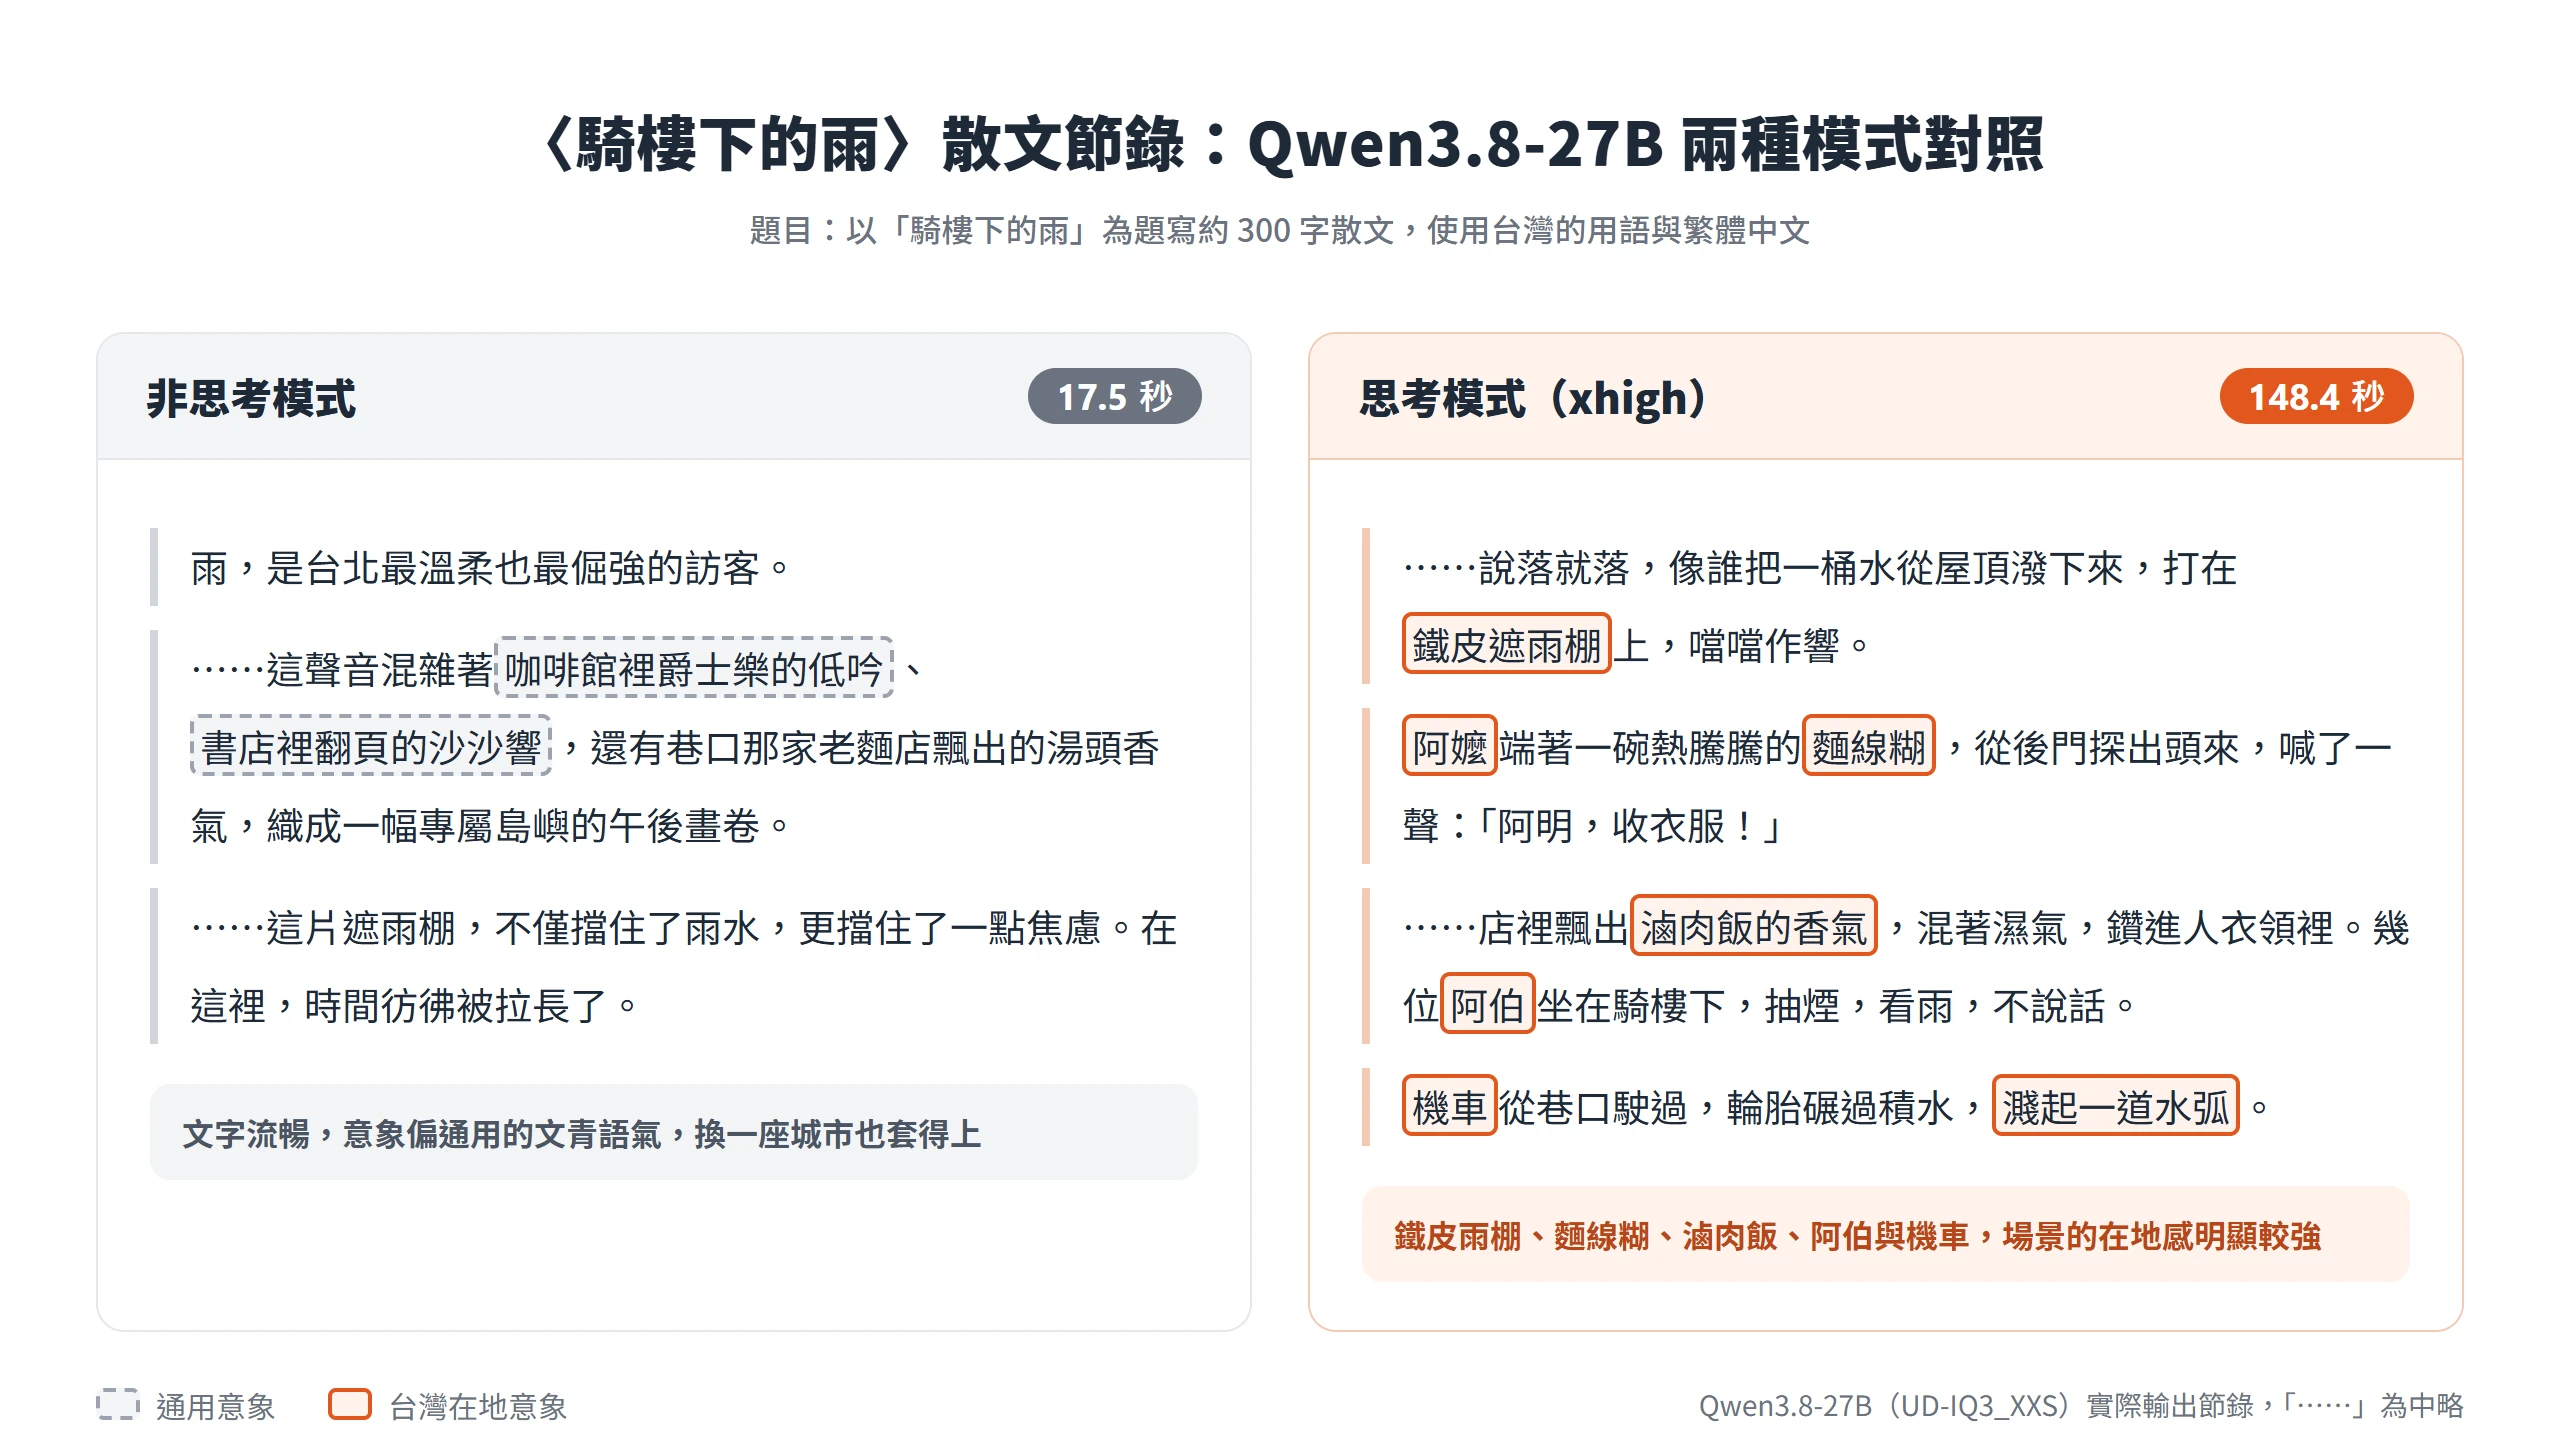
散文題以〈騎樓下的雨〉為題,要求使用台灣的用語。非思考模式 17.5 秒寫完,寫了台北的騎樓、咖啡館裡的爵士樂、書店的翻頁聲,文字流暢,但偏向通用的文青語氣,換一座城市也套得上。思考模式花了 148.4 秒,寫的是鐵皮遮雨棚上的雨聲、阿嬤端出來的麵線糊、巷口飄來的滷肉飯香、坐在騎樓下看雨的阿伯,還有機車碾過積水濺起的水花,場景的在地感強了不少。
看圖描述準確,思考模式多聯想出不合畫面的地名
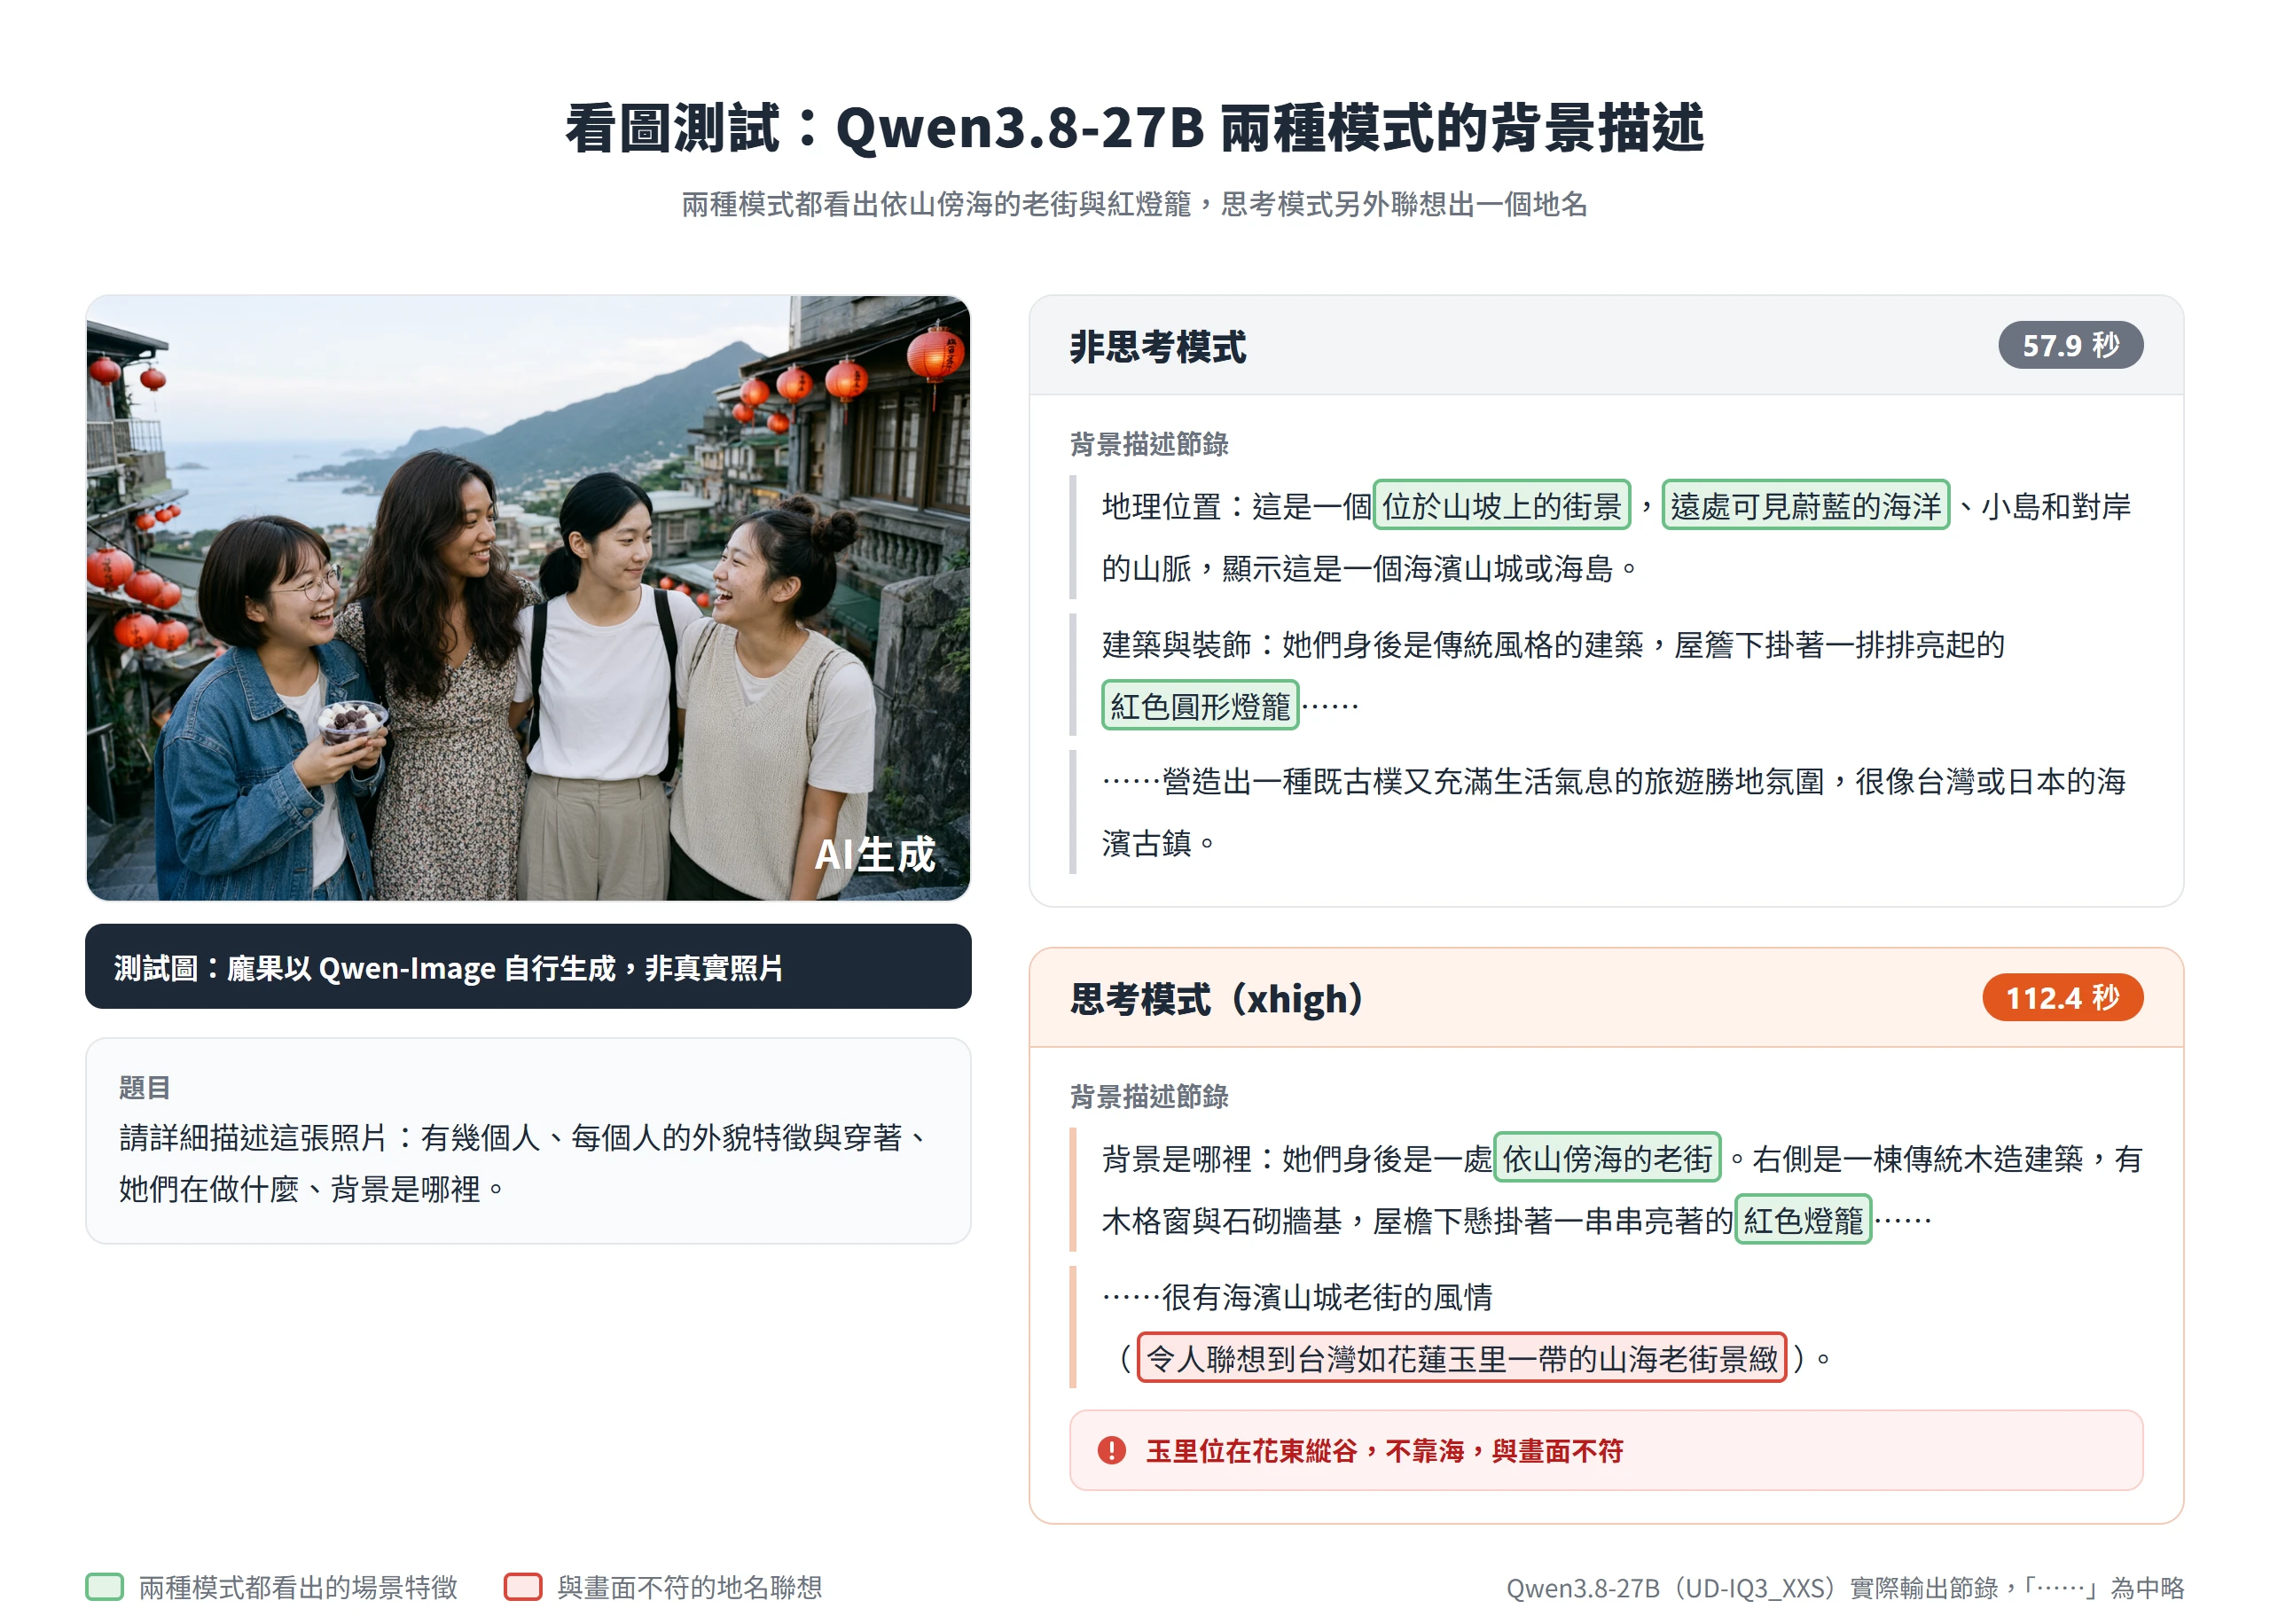
看圖測試用的是我們自己用 AI 圖像生成模型做的一張圖,畫面是四位女生在九份老街出遊的合照,並不是真實照片。題目要它描述有幾個人、每個人的外貌與穿著、她們在做什麼,以及背景在哪裡。因為是生成的圖,畫面裡不一定有九份才有的地標,所以我們不拿「猜不猜得中九份」來評分,只看它的描述有沒有根據。
非思考模式 57.9 秒回答,正確數出 4 位女性,逐一描述髮型與穿著,也看出最左邊那位手上捧著芋圓類的甜點,背景有紅燈籠與海景,地點則只說「很像台灣或日本的海濱古鎮」。思考模式花了 112.4 秒,描述更細,連木格窗、石砌牆基、燈籠上的字樣都寫進去,同樣看出這是依山傍海的老街,最後卻多補了一句「令人聯想到台灣如花蓮玉里一帶的山海老街景緻」。玉里位在花東縱谷,並不靠海,這個聯想跟畫面對不上,屬於地理知識搭錯,不是看圖看錯。人物、物件與場景類型都看得準,拿它辨識畫面內容沒問題;它額外補上的具體地名,則要自己再確認。
量化位元越低,簡體字和大陸用語越常出現
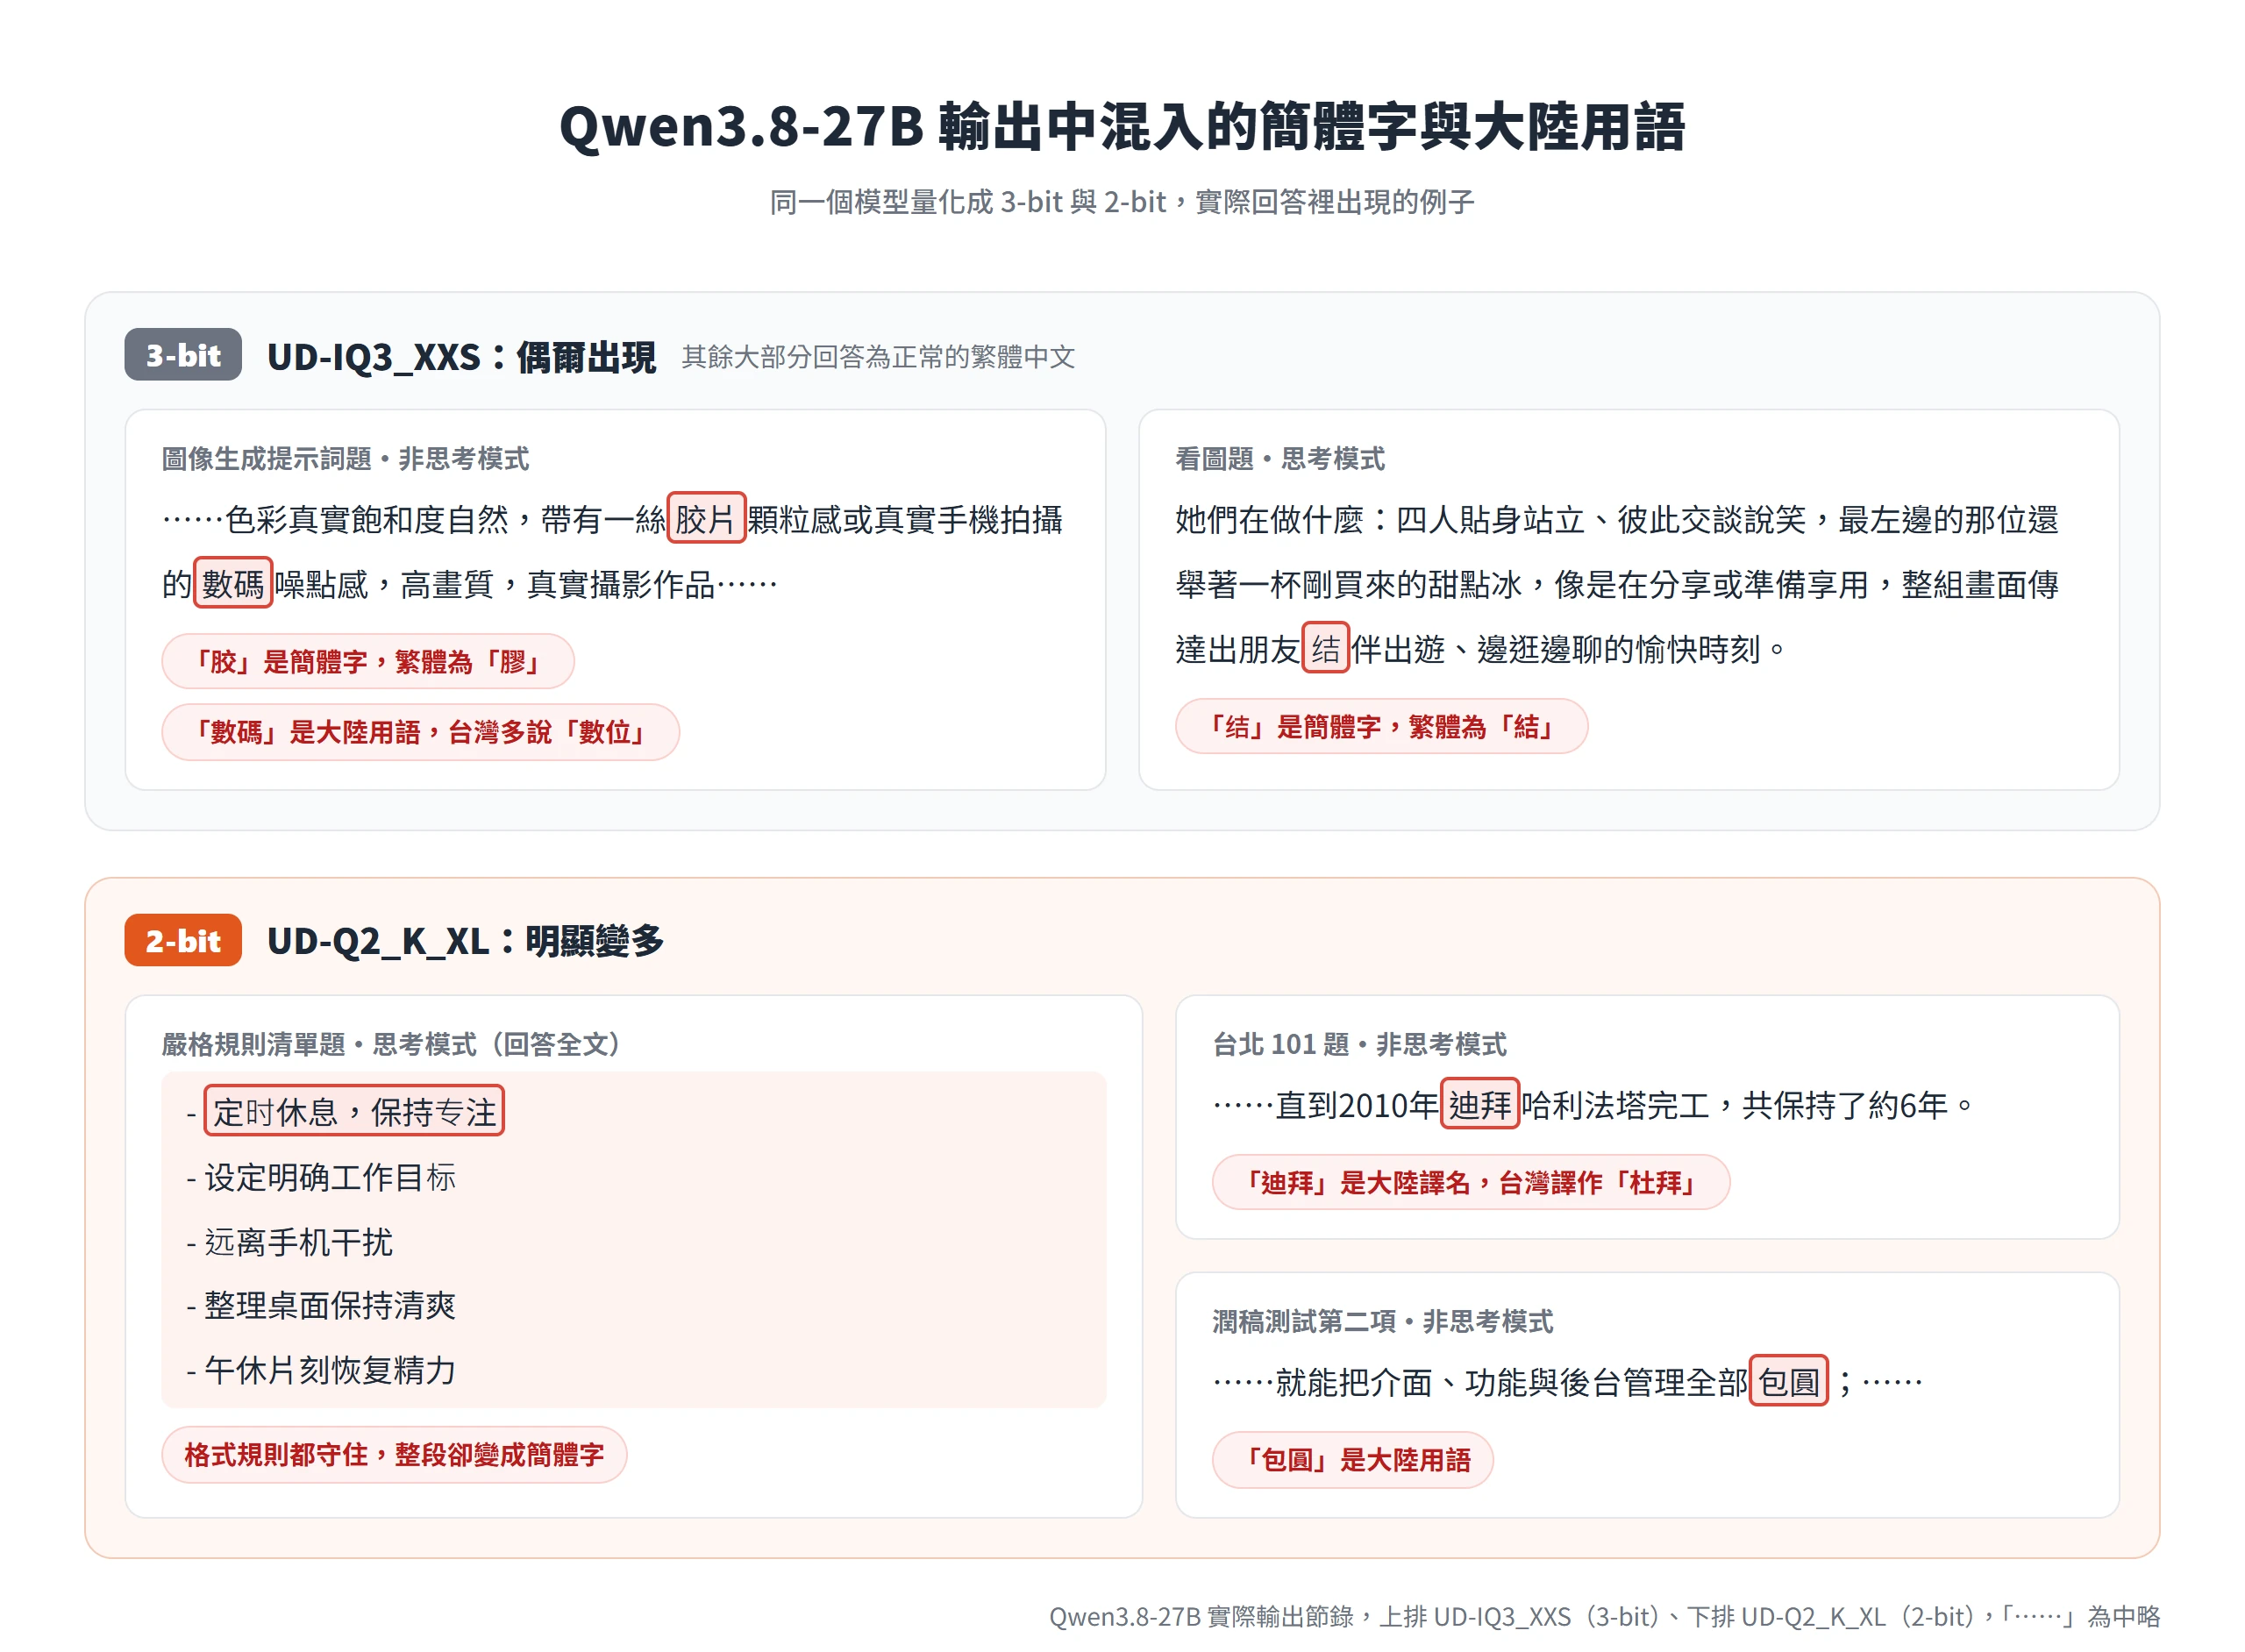
簡體字和大陸用語出現的頻率不高,但確實會出現。在 3-bit 的 UD-IQ3_XXS 上,圖像生成提示詞題的非思考回答裡出現了簡體的「胶片」和大陸用語「數碼」;看圖題的思考版則在「结伴」一詞冒出簡體的「结」。其餘大部分回答都是正常的繁體中文。
量化到 2-bit 的 UD-Q2_K_XL,狀況明顯變多。嚴格規則清單題的思考版雖然規則都守住了,整段卻變成簡體,例如「定时休息,保持专注」;台北 101 題的非思考版用了「迪拜」;潤稿測試的非思考版寫出「包圓」。量化位元越低,語言越容易混雜,在這輪測試裡的趨勢相當明顯。
要壓住這個現象,最直接的做法是在系統提示裡明確要求使用台灣繁體中文,接上 Hermes Agent 時我們就是這樣處理的。
依 14 條寫作規範潤稿,思考模式才真正改寫
我們拿自己網站上一篇談前端與後端分工的文章段落,給 27B 一份 14 條的寫作規範,請它做三種潤稿任務。規範涵蓋台灣繁體與台灣用語、破折號的使用上限、不用疑問填充詞、禁用 AI 套語、不站在文章外面稱呼讀者、避免過度口語、禁用 emoji 與網址、反轉句要具體、不自述文章結構、不用誇張比喻、句子要有主詞、不可捏造、保持客觀口吻,以及只輸出正文。
第一項是重寫一段引用 MDN 文件的長段落,要保留所有事實、讓它讀起來更順。兩種模式都做到 0 違規、事實完整;非思考模式 9.9 秒完成,語氣偏生硬,思考模式花了 127.7 秒,寫出來最接近原站的風格。
第二項是用不同的開頭手法重寫三段引言,兩種模式的差距在這裡最明顯。非思考模式 12.0 秒交稿,實際上只刪掉第一句「多數人以為…」,後兩段幾乎逐字照抄原文;思考模式花了 157.8 秒,改從報價單上「網站建置」常被寫成單一項目切入,原本要傳達的重點也都保留下來。
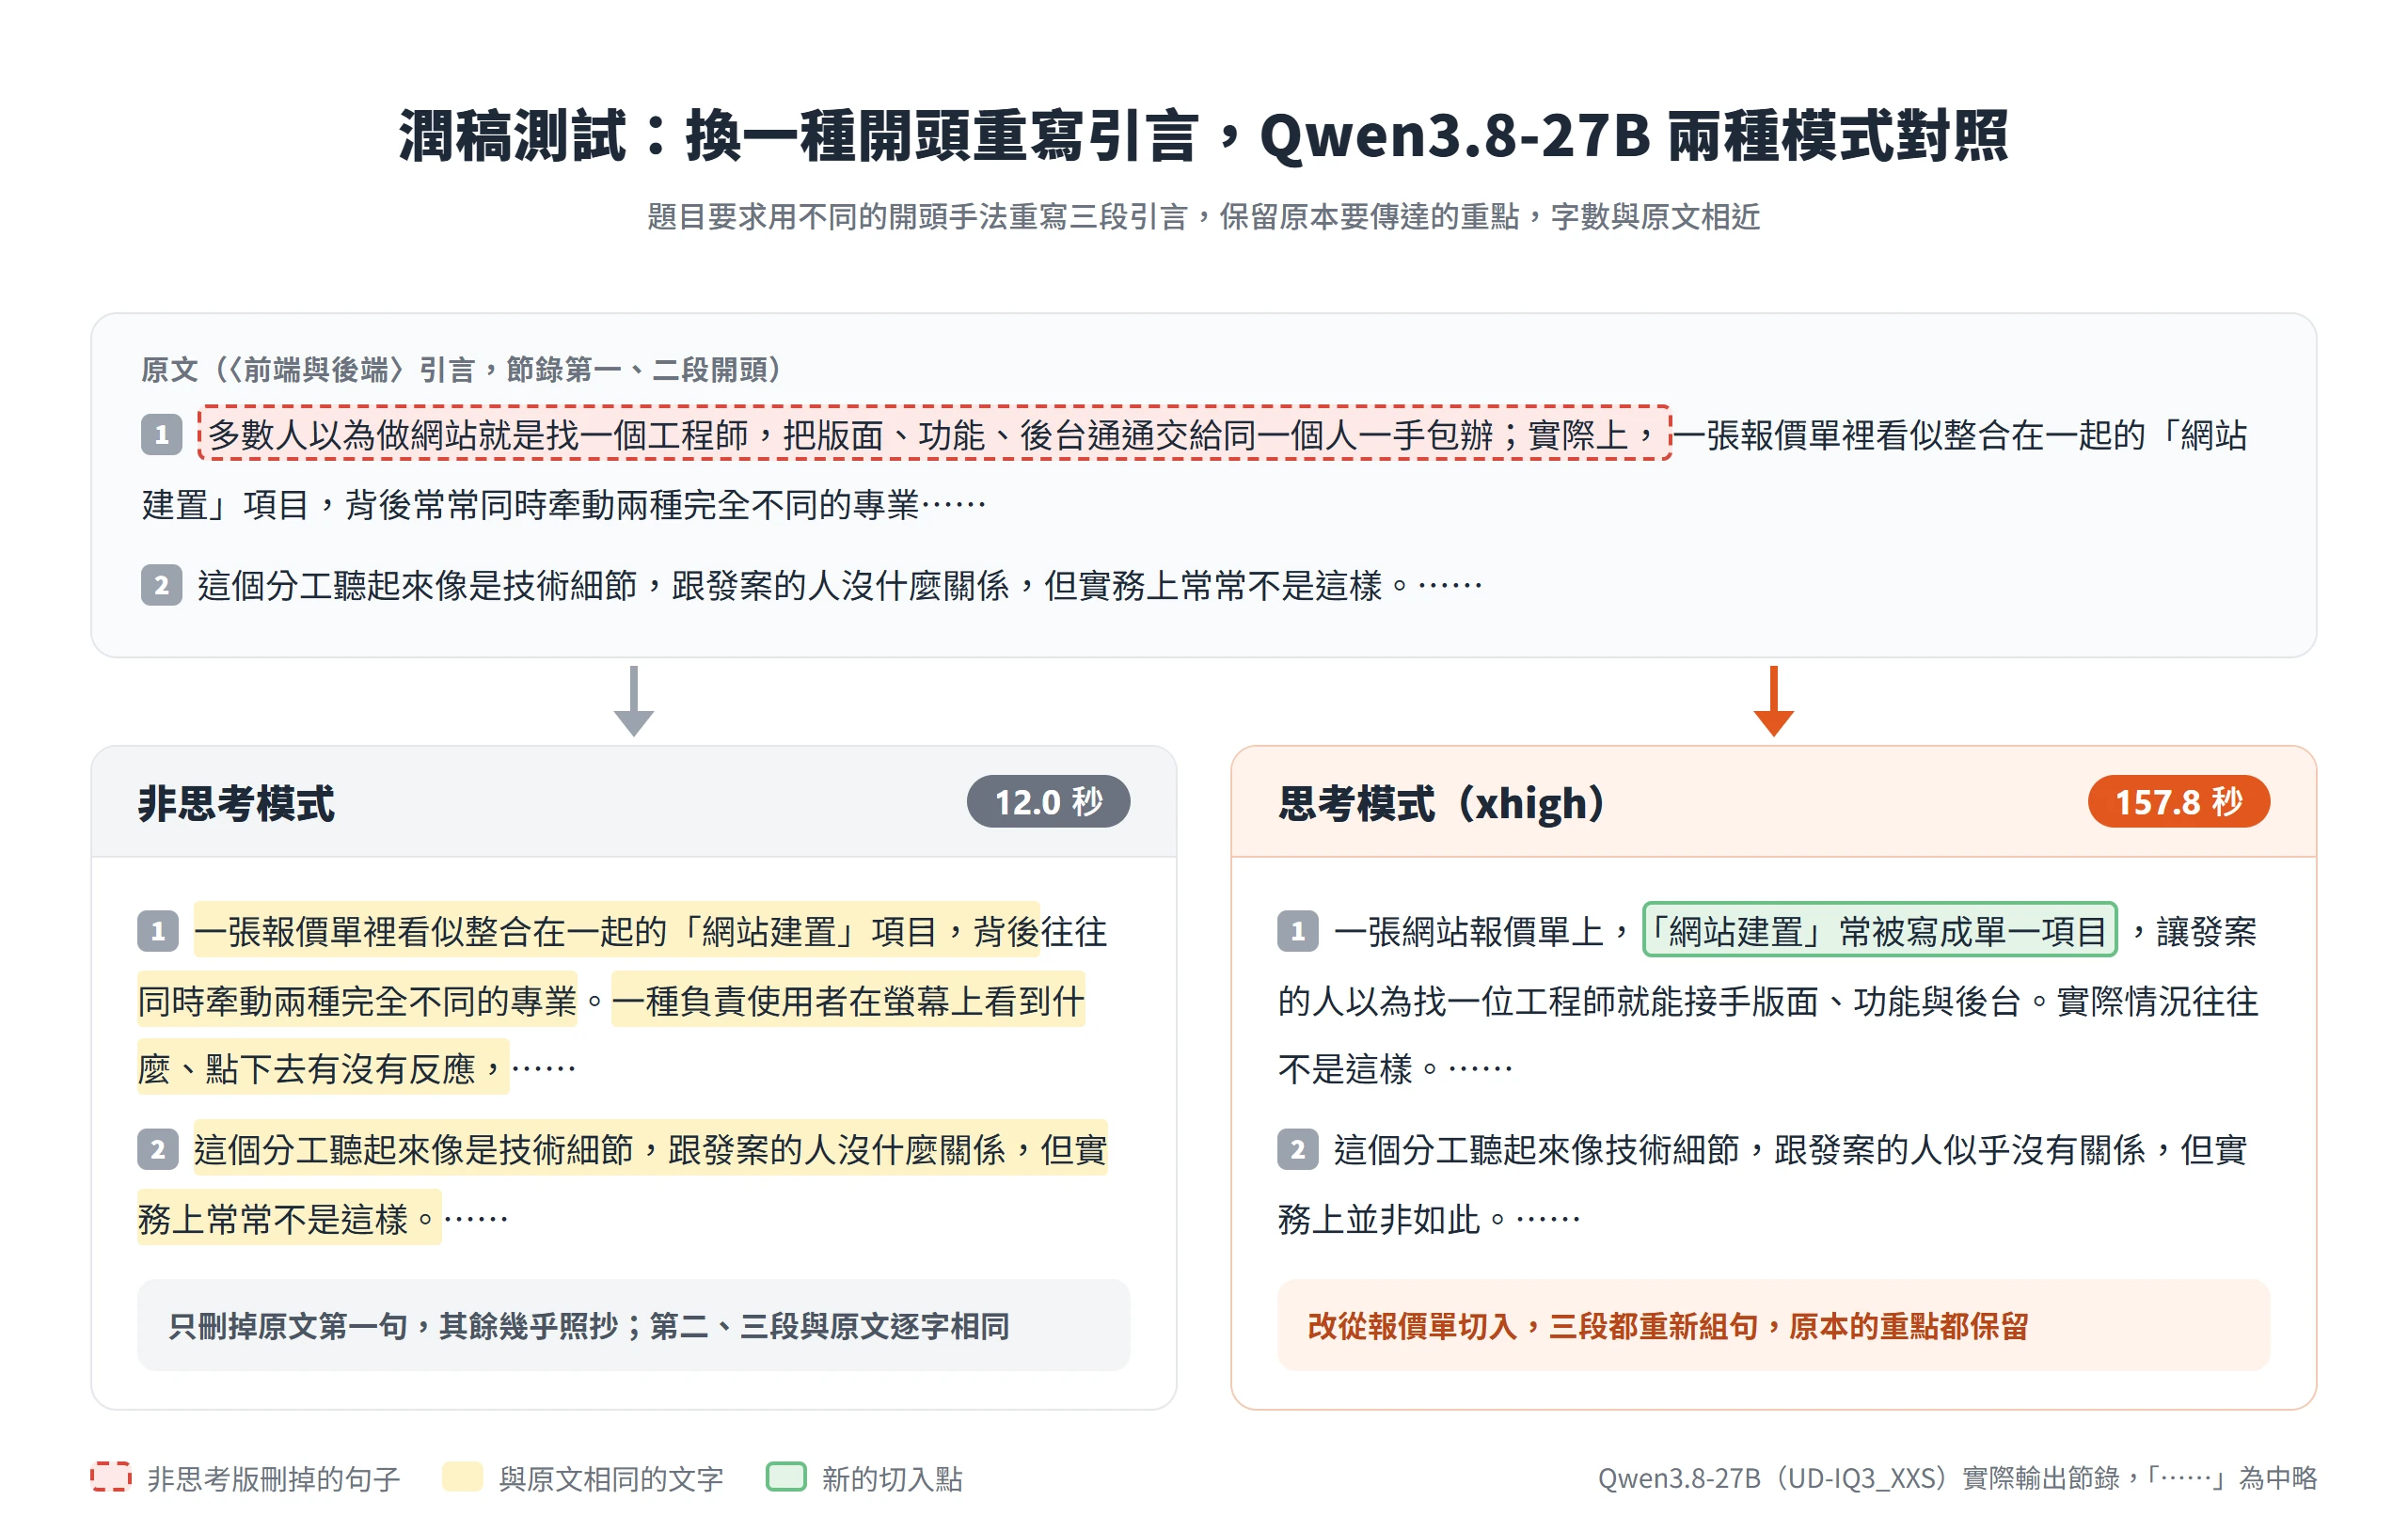
第三項是修正一段刻意埋了 10 個違規的文字,包括破折號、疑問填充詞、AI 套語、過度口語、emoji、網址、簡體字、空泛的反轉句,以及站在文章外面稱呼讀者的說法。兩種模式都把 10 個違規全部清掉,非思考模式只花 5.0 秒,思考模式則是 146.1 秒。
整體來看,挑出違規、清掉違規,兩種模式都做得到;需要真正改寫的任務,只有思考模式真的動筆,代價是每段要兩分鐘以上。在每秒約 20 個 token 的硬體上,一篇文章分成十幾段潤稿,粗估就要半小時以上,比較適合排在背景慢慢跑。
2-bit 的 UD-Q2_K_XL 版本表現又不太一樣。它的非思考模式在第二項倒是有改寫,但用了大陸用語「包圓」;第三項雖然也做到 0 違規,卻留下「並非技術層面的高下之分,而是職能分工的不同」這種空泛的反轉句,正好是規範要避免的寫法。
5.8 萬 token 長文中找回藏起來的一句話
大海撈針是測試長上下文最直接的方法。我們把自己網站上 10 到 17 篇文章串成一份長文,在中間藏一句跟上下文無關的備註,內容是辦公室的備用鑰匙藏在三樓茶水間第二個抽屜的藍色鐵盒裡、密碼是 7426。接著問它兩個問題,一是鑰匙藏在哪裡、密碼是多少,二是其中一篇談前端與後端的文章,提到了哪三個判斷維度。
在 3-bit 版本、64K 上下文、KV 快取壓成 q4 的條件下,58,050 token 的長文,它找到了鑰匙的位置與密碼 7426,三個判斷維度也全部答對。讀取速度約每秒 400 個 token,整份長文大約 2.5 分鐘讀完;開始回答後,生成速度降到每秒 13.1 個 token,比短上下文時慢了三成多。
另一次測試的長度是 34,948 token,跑在 2-bit 的 UD-Q2_K_XL 上。這一份刻意沒有收錄前端與後端那篇文章,第二個問題就變成陷阱題。它一樣找到了藏起來的備註,並正確回答長文裡沒有這篇文章,而不是順著問題編出三個維度。這次的讀取速度是每秒 426 個 token,生成速度每秒 16.2 個 token。
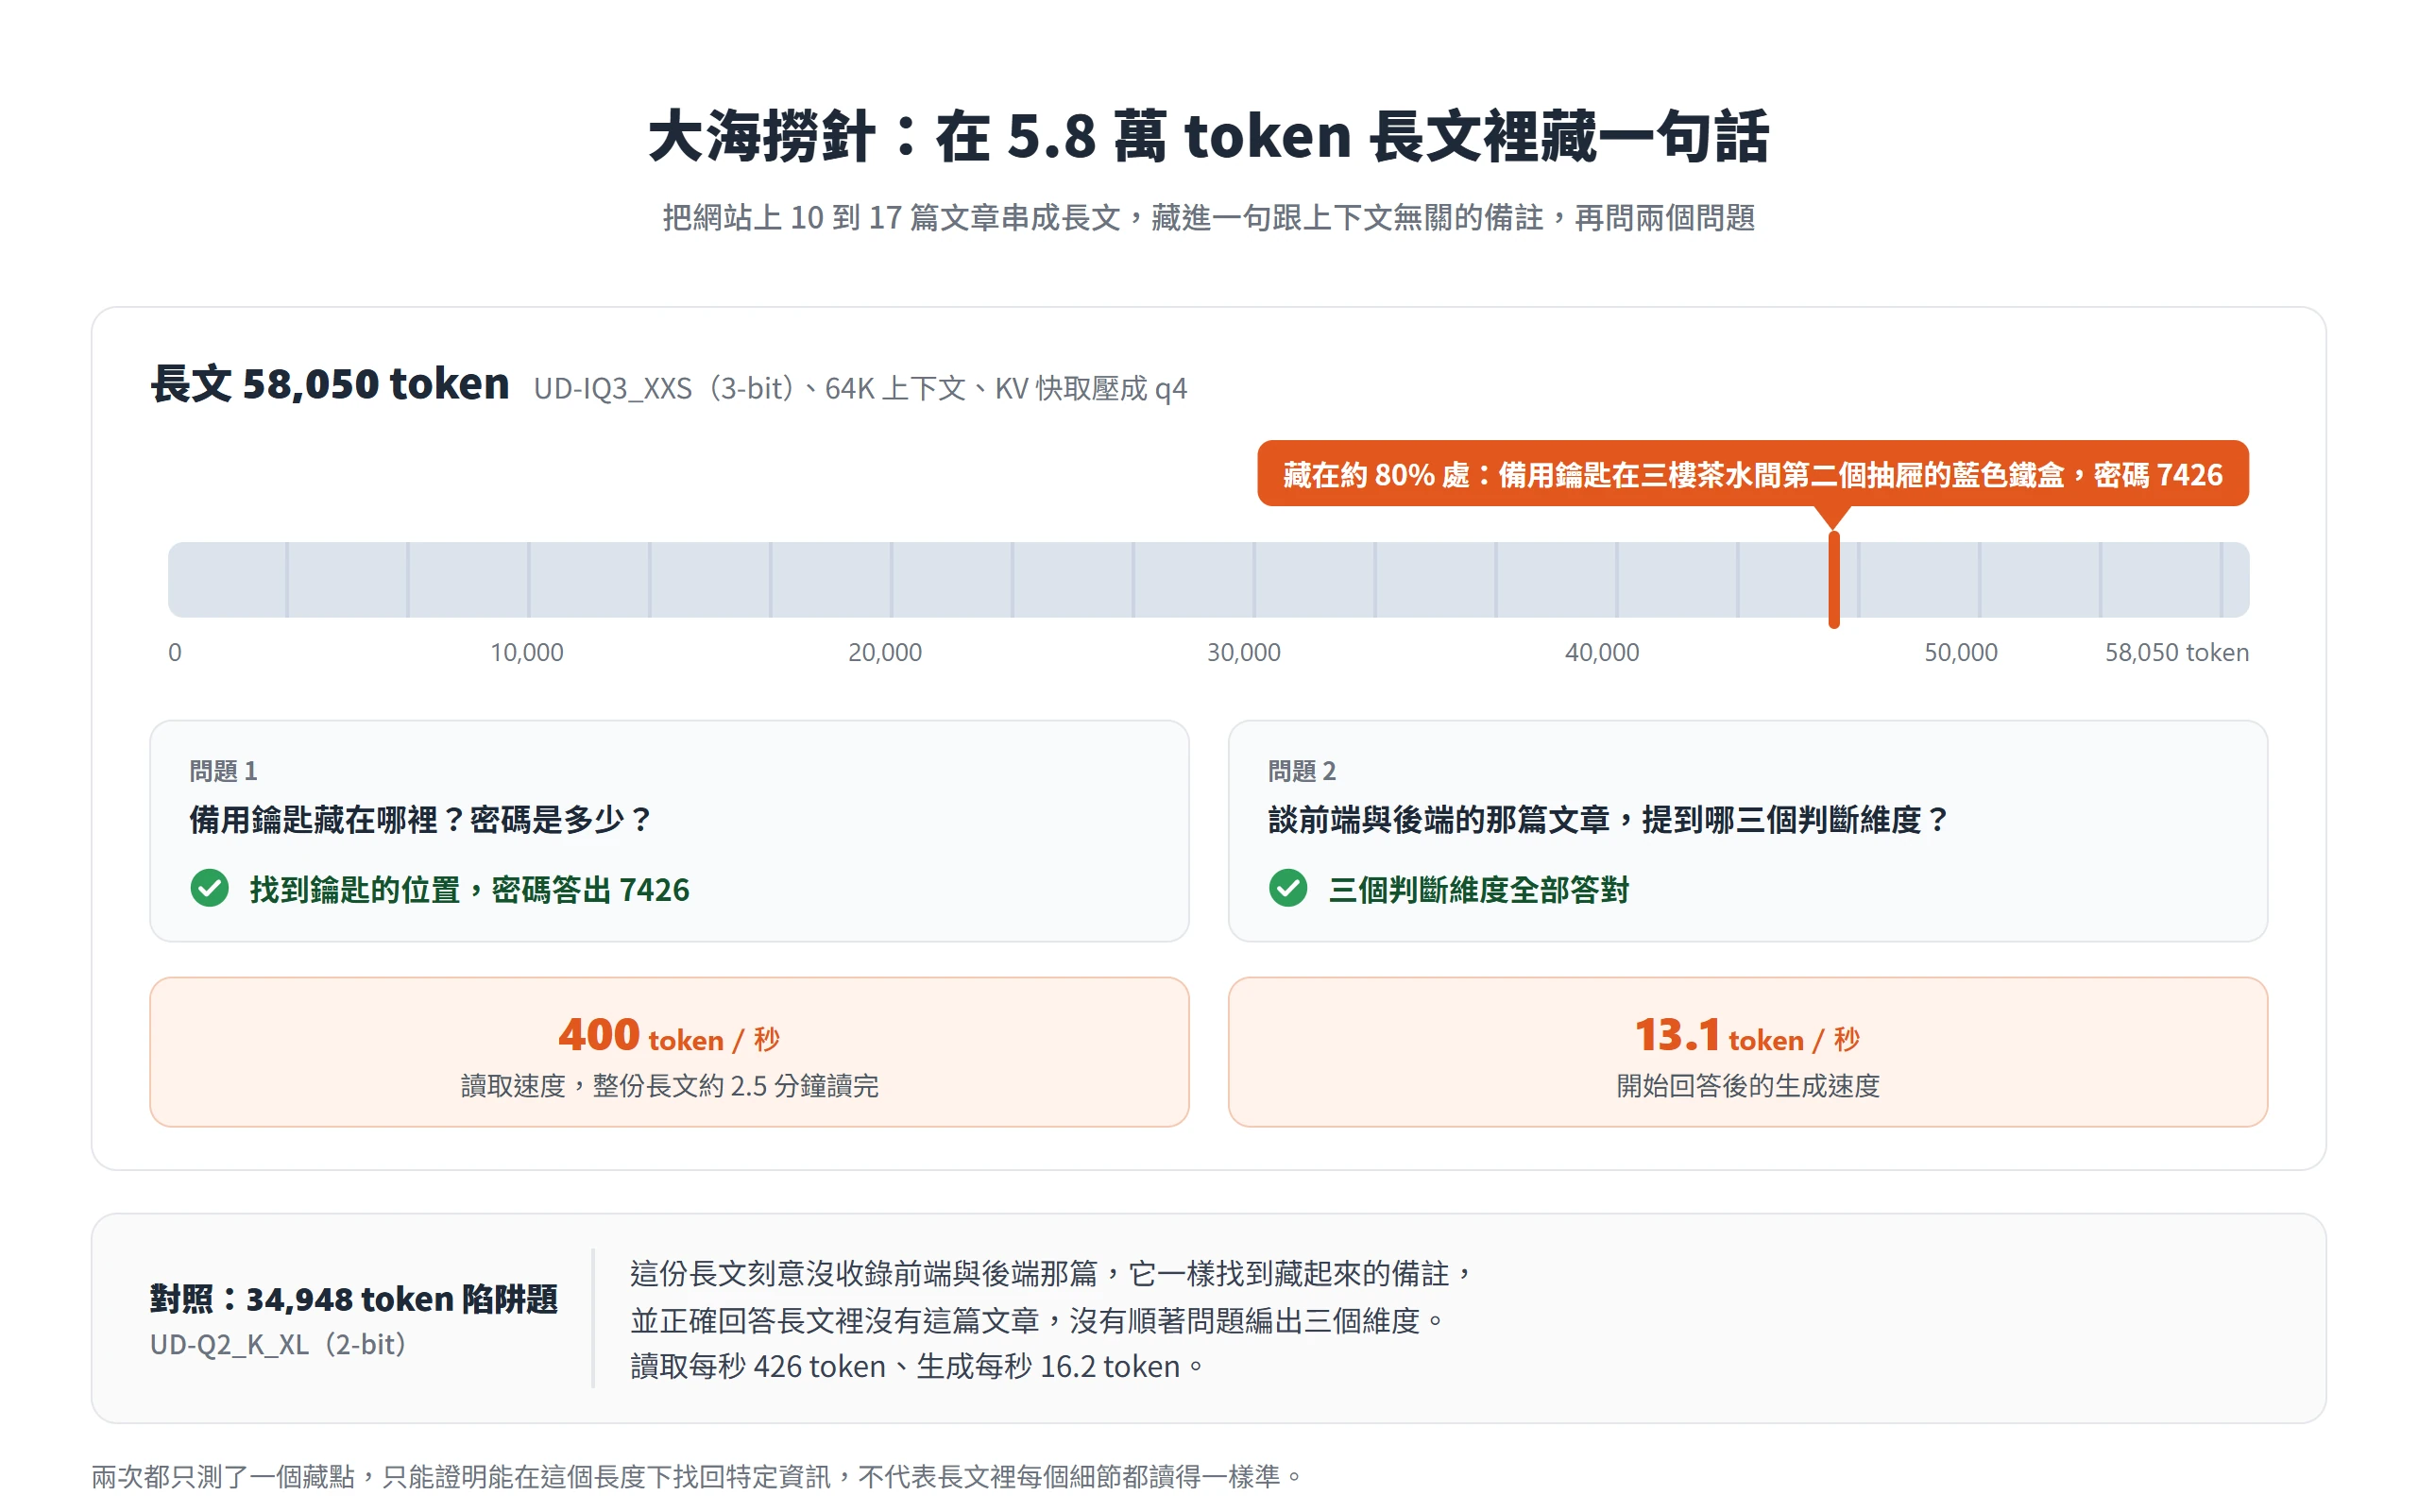
64K(65,536 token)大約等於 7~9 萬個中文字,約十幾篇文章的份量,一次放進去問答是可行的。只是這兩次都只測了一個藏點,結論要保守看待,它證明 27B 能在這個長度下找回特定資訊,不代表長文裡每個細節都讀得一樣準。上下文再往上開到 128K,連同模型本體就放不進 12GB 顯示卡了。
網頁與動畫要給足輸出長度才寫得完
做網頁、SVG、Canvas 動畫這類要輸出大量程式碼的任務,第一個問題是輸出上限。8K 組給思考模式 6,000 token 的上限,四道網頁與畫圖題全部用滿上限,連一份成品都沒有交出來。放寬到 3 萬 token 後,思考模式的成品明顯比非思考精緻,只是一件要花 11 到 18 分鐘;非思考模式快得多,成品大致可用,但常留下小瑕疵。每個成品我們都在瀏覽器實際打開看過。
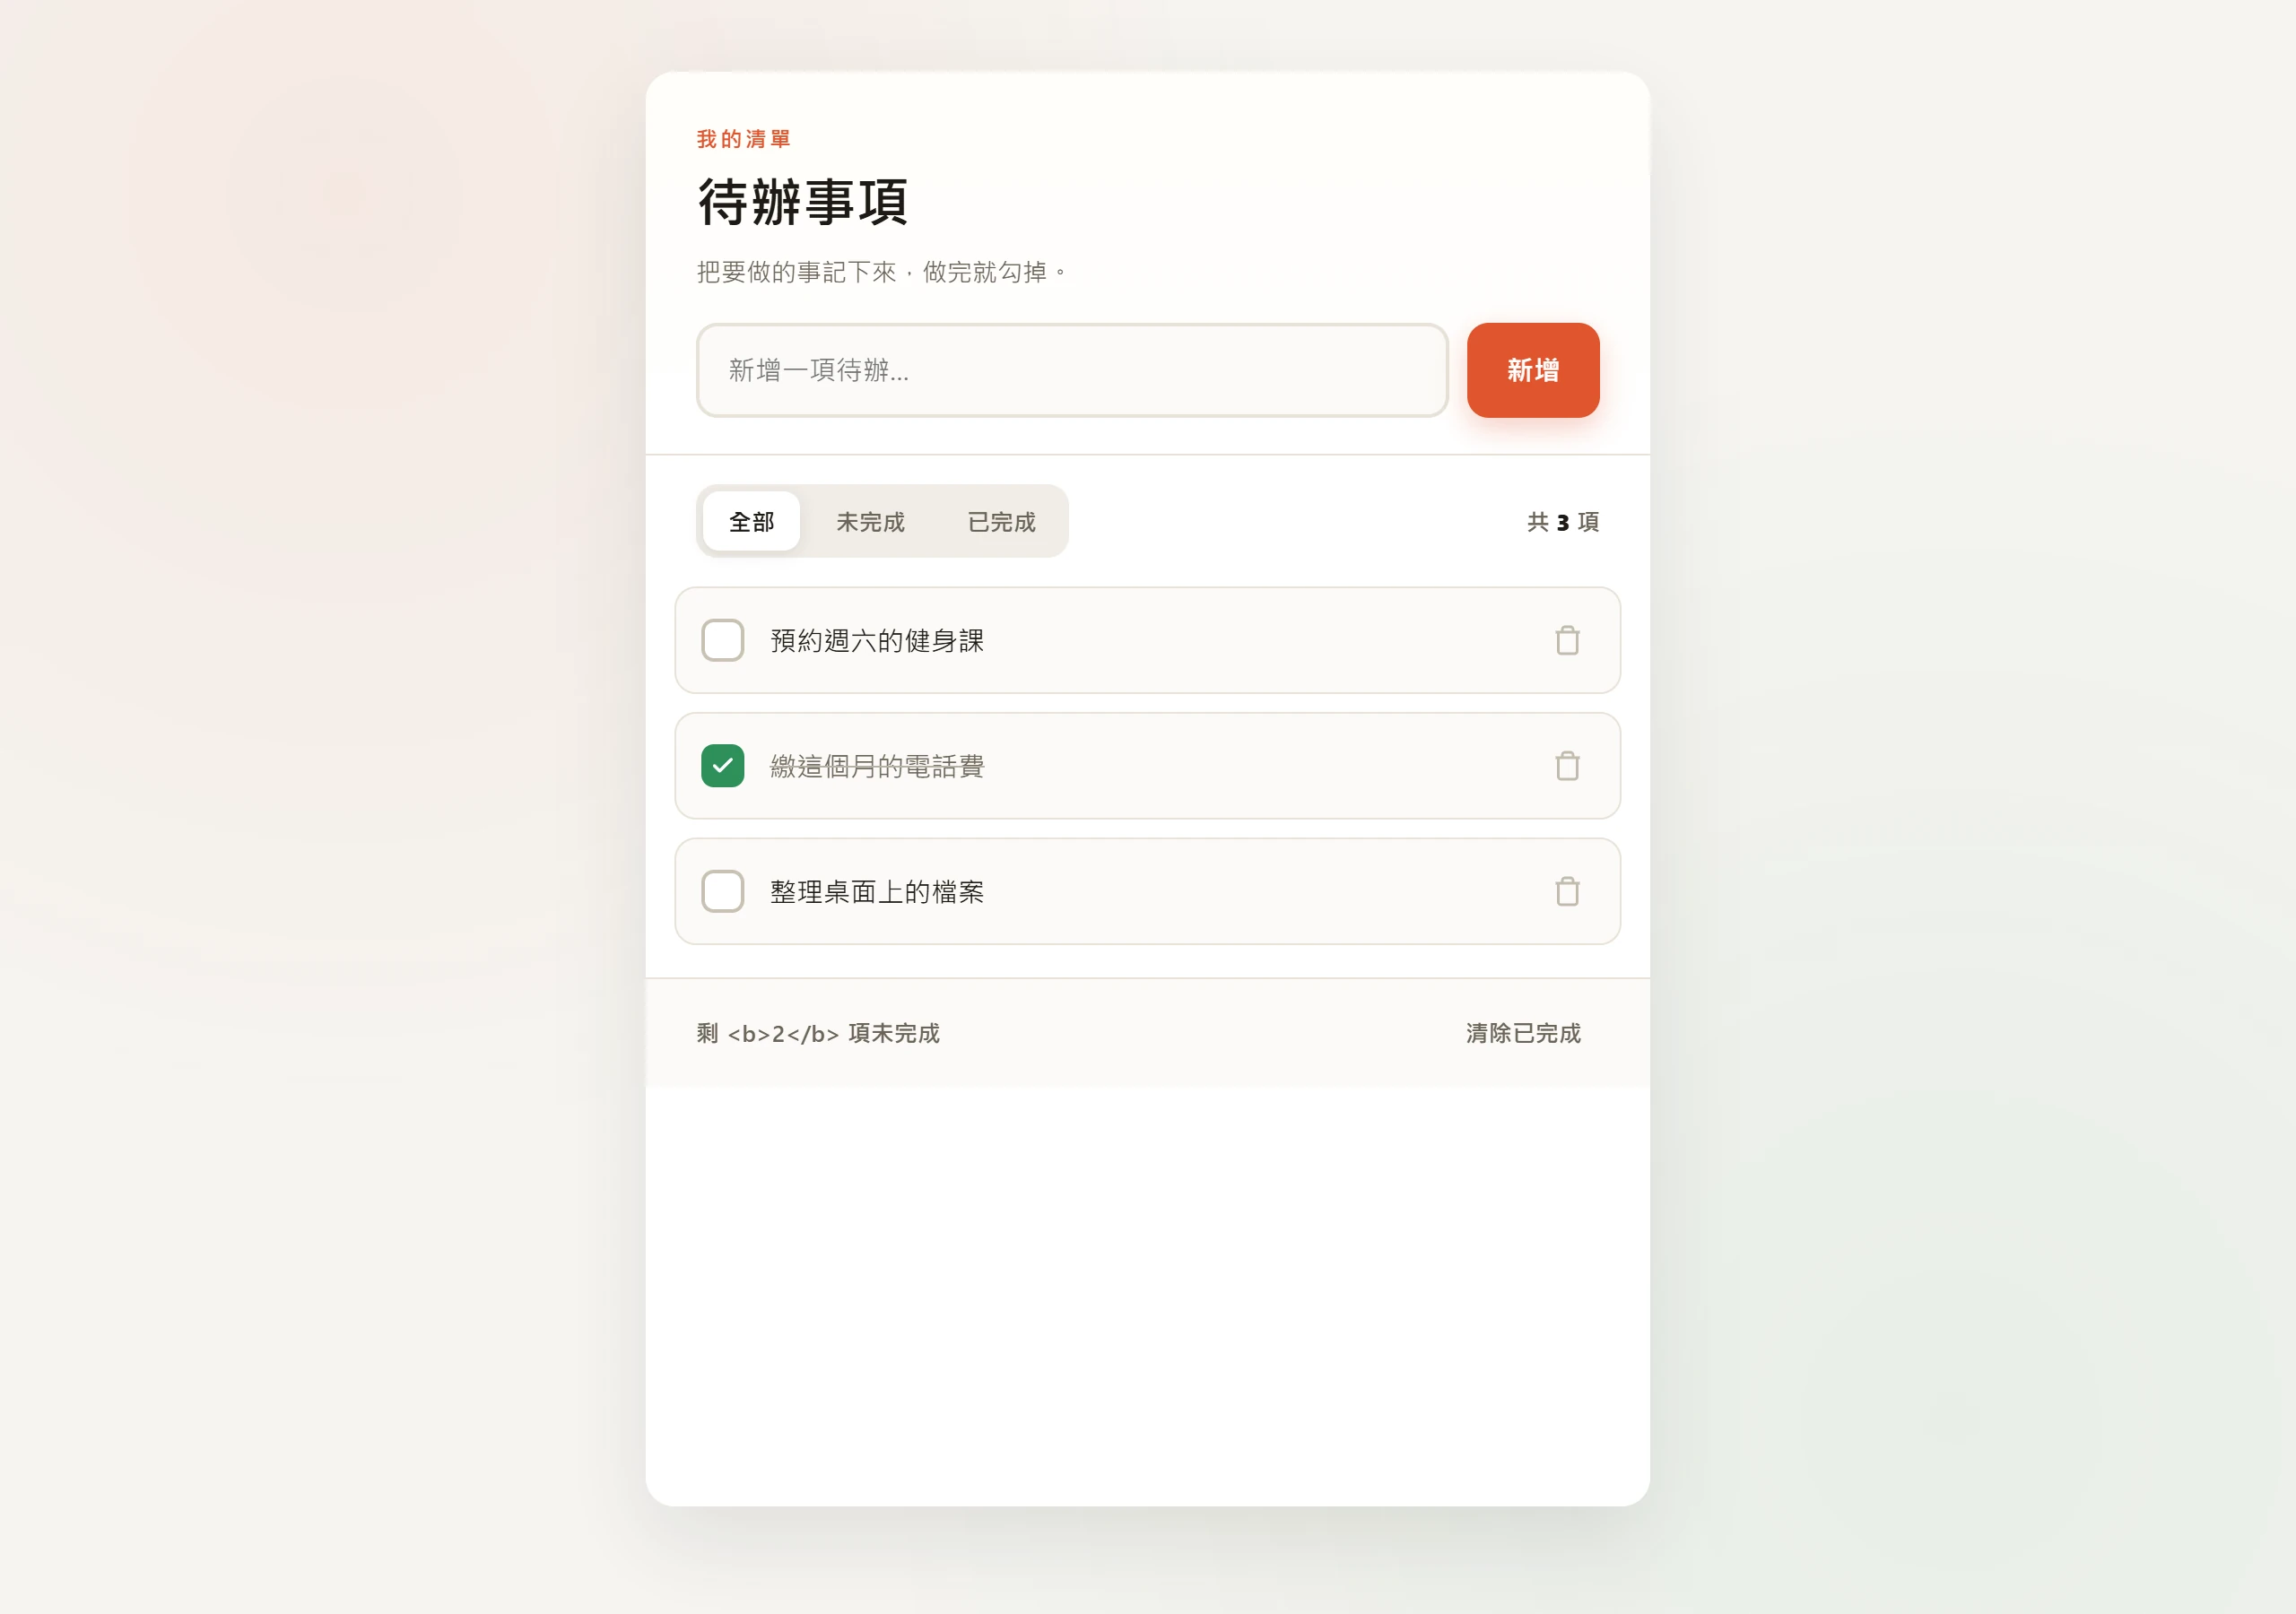
待辦清單題要做出新增、勾選、刪除、篩選功能,並用 localStorage 存檔。非思考模式在輸出上限放寬到 7,000 token 時,226.1 秒、4,410 個 token 完成,我們實際操作過,每項功能都能正常使用,只有底部的剩餘項目計數把 <b> 標籤當成文字顯示出來。另外用建議參數、思考 medium 跑過一次,101.8 秒、2,007 個 token 就產出完整的檔案,不過這一份沒有另外做互動測試。
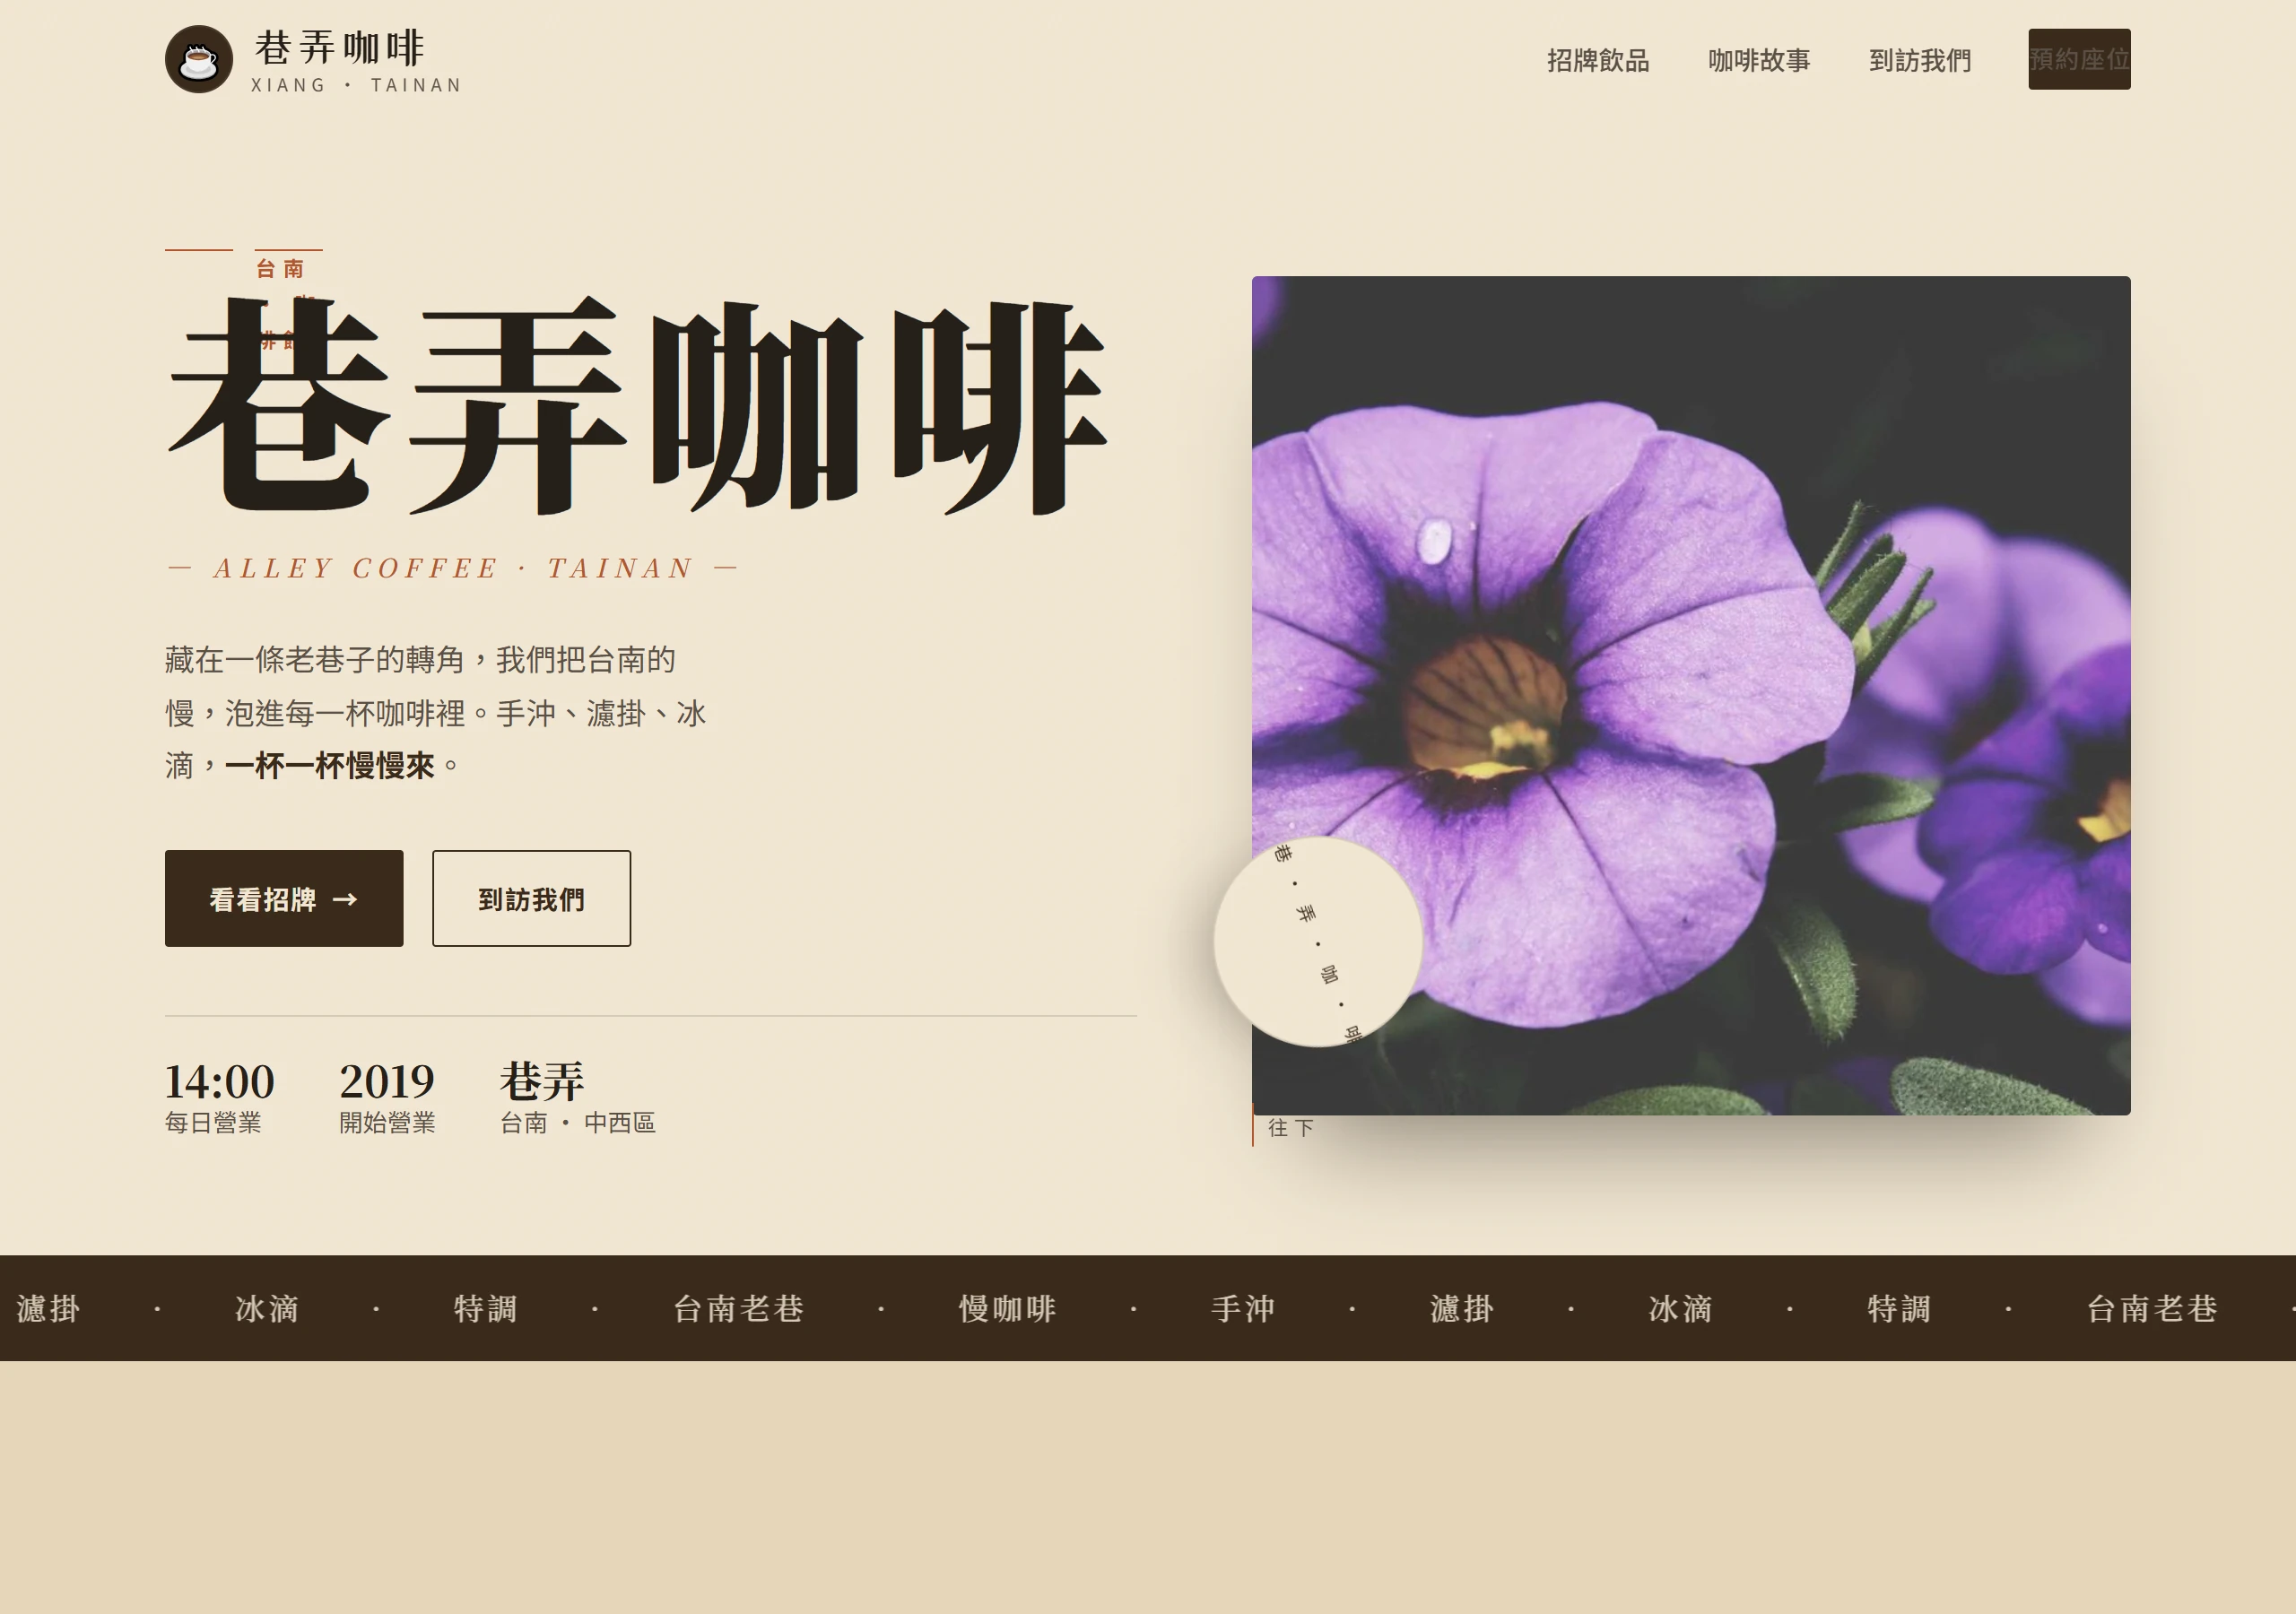
台南「巷弄咖啡」形象首頁這題,要有導覽列、主視覺、三張飲品卡片、營業資訊與頁尾,手機版也要能正常排版。非思考模式在 7,000 token 上限下跑了 361.0 秒,仍然被截斷;上限拉到 3 萬時,用了 7,946 個 token、414.1 秒(約 7 分鐘)才完整寫完。成品的配色有質感,不過主視覺抓了一張跟咖啡無關的紫色花卉圖片。
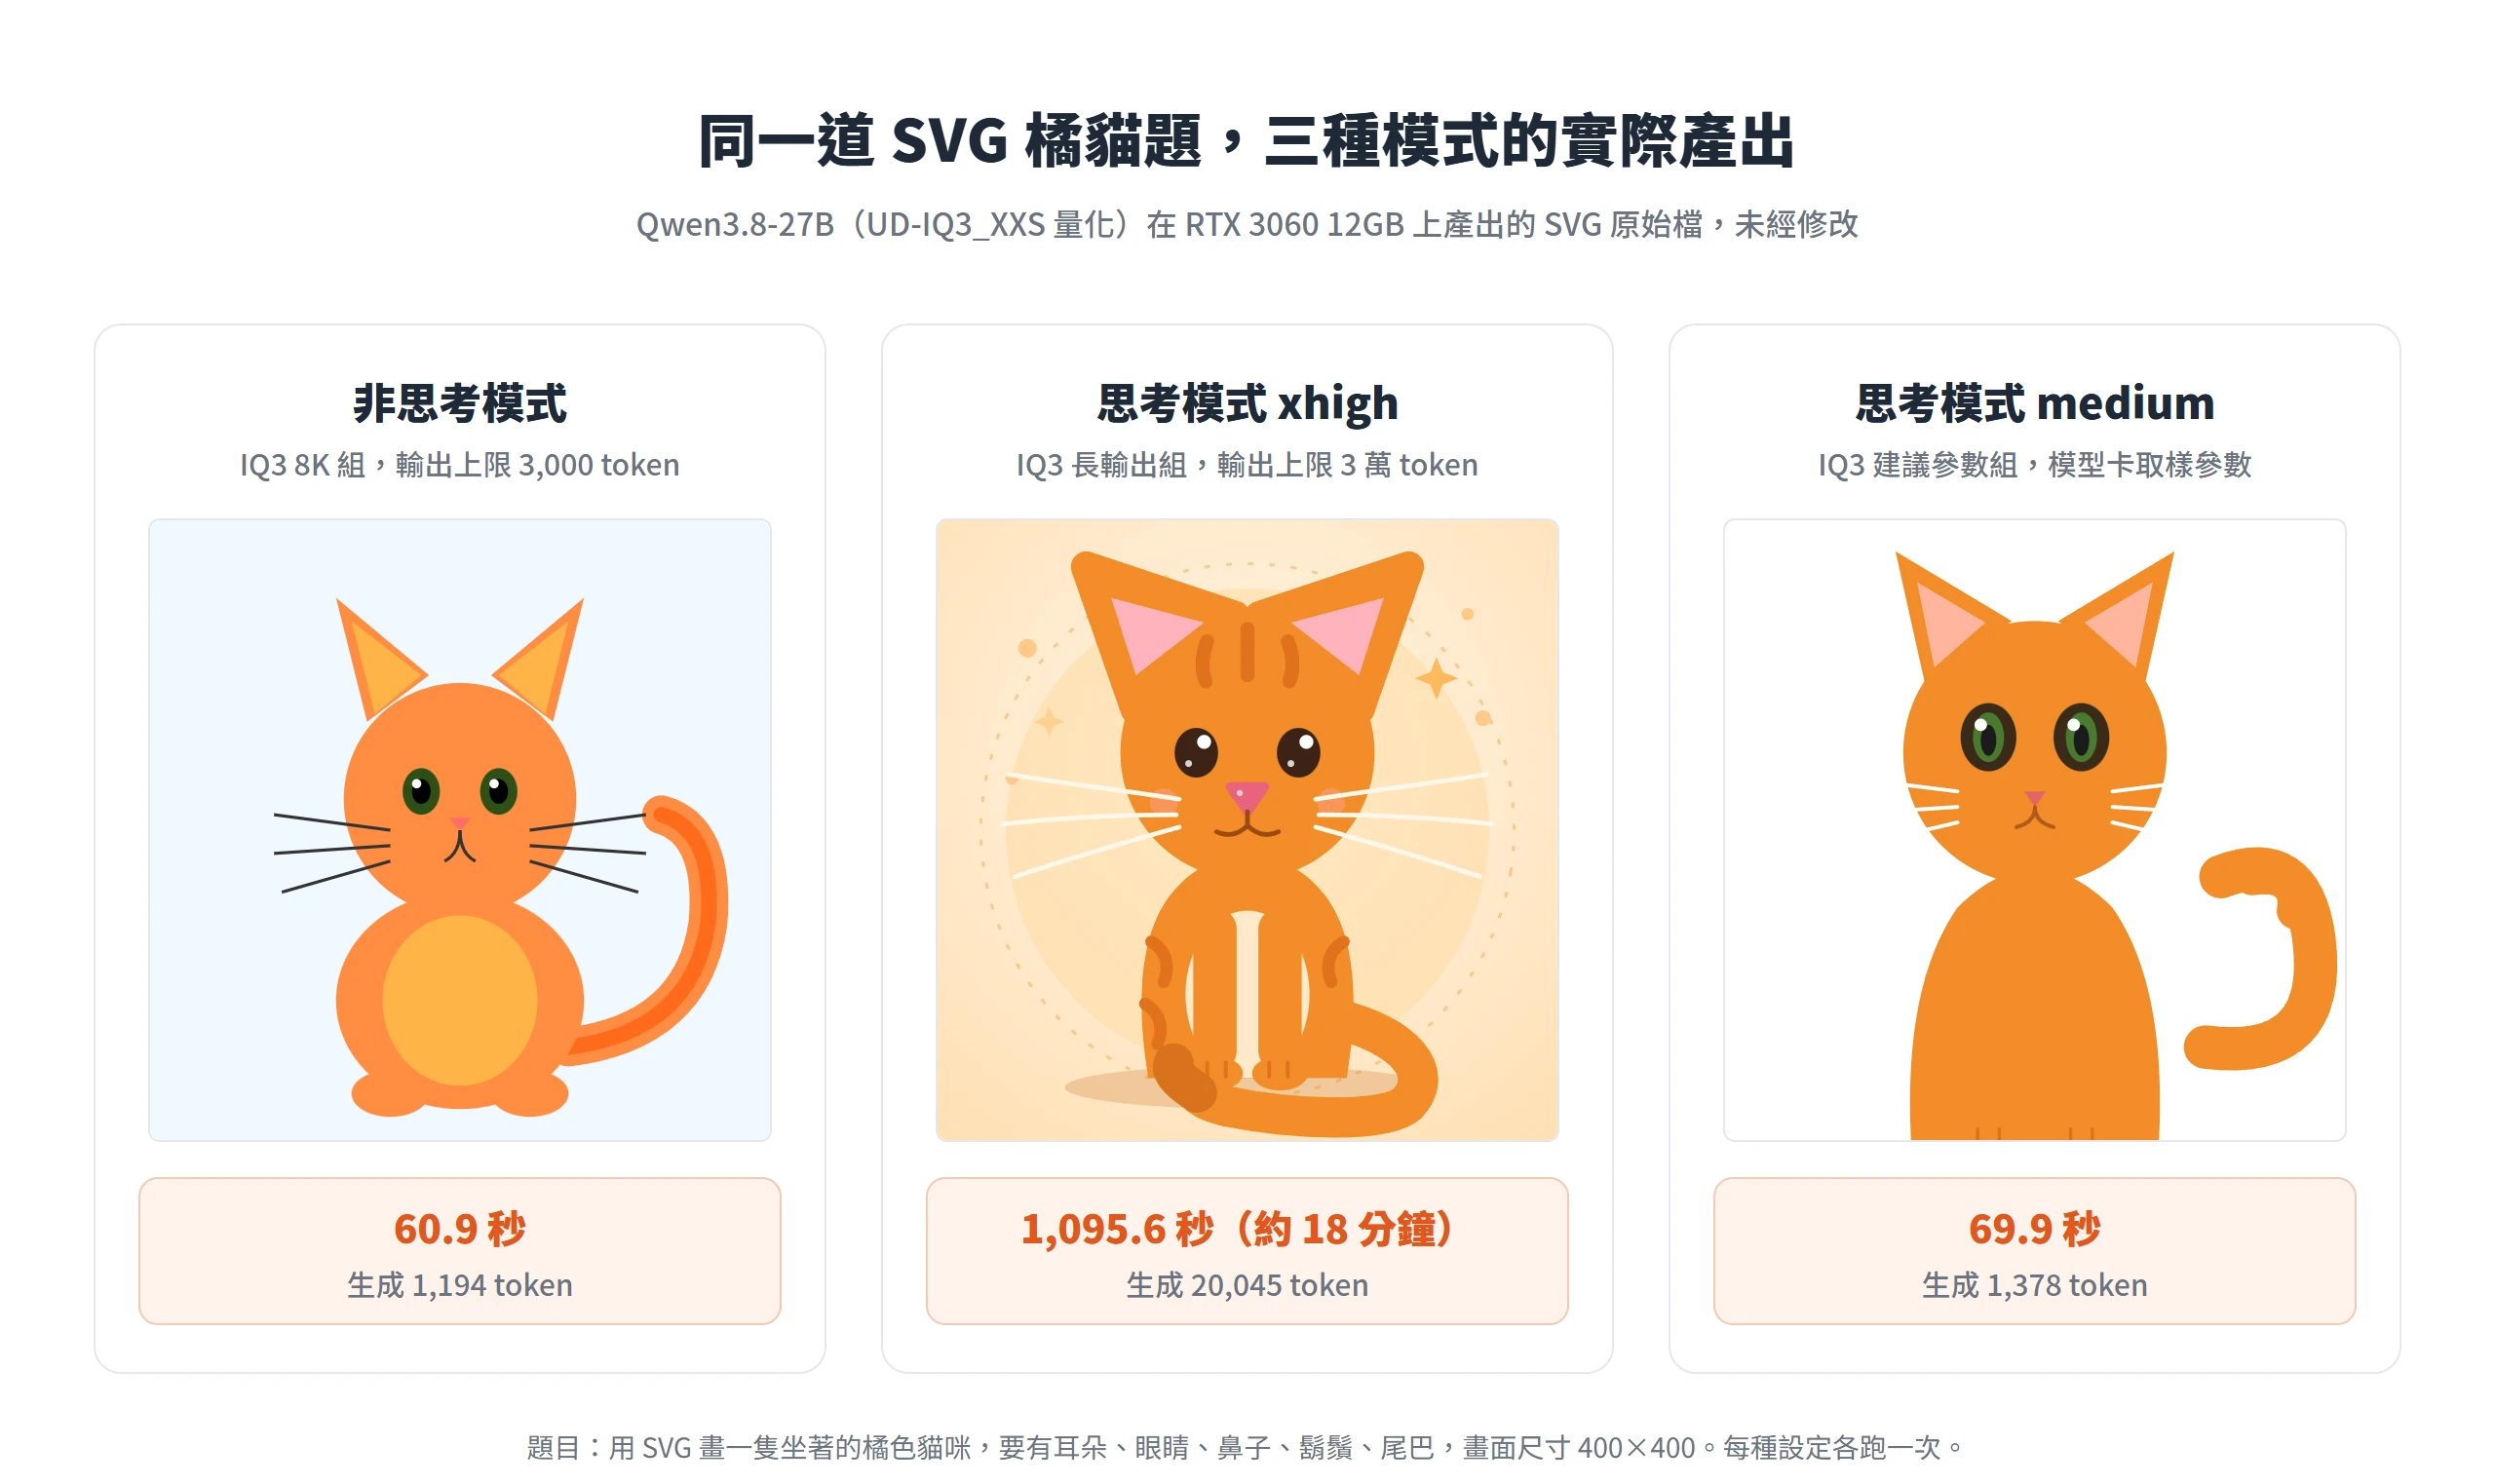
SVG 橘貓題的兩種模式落差最直觀。非思考模式 60.9 秒畫完,結構完整、線條簡單乾淨;思考模式 xhigh 在 3 萬 token 上限下花了 1,095.6 秒(約 18 分鐘)、20,045 個 token,畫出有虎斑紋、有光暈的橘貓,精緻很多。用 medium 重跑一次只要 69.9 秒就完整產出,但這張我們沒有另外評比畫面。
Canvas 彈跳球題要求 15 顆大小、顏色各不相同的球,碰到牆壁會反彈,彼此之間也要碰撞反彈。非思考模式 105.6 秒交出程式,程式會依視窗大小設定畫布,我們在瀏覽器打開,15 顆球的牆壁反彈與彼此碰撞都能正常運作,只是畫面比較樸素。思考模式 xhigh 在 3 萬 token 上限下花了 678.5 秒(約 11 分鐘)、12,780 個 token,做出發光拖影、球體碰撞、FPS 儀表板,還加上滑鼠互動,是這輪測試裡最亮眼的成品。
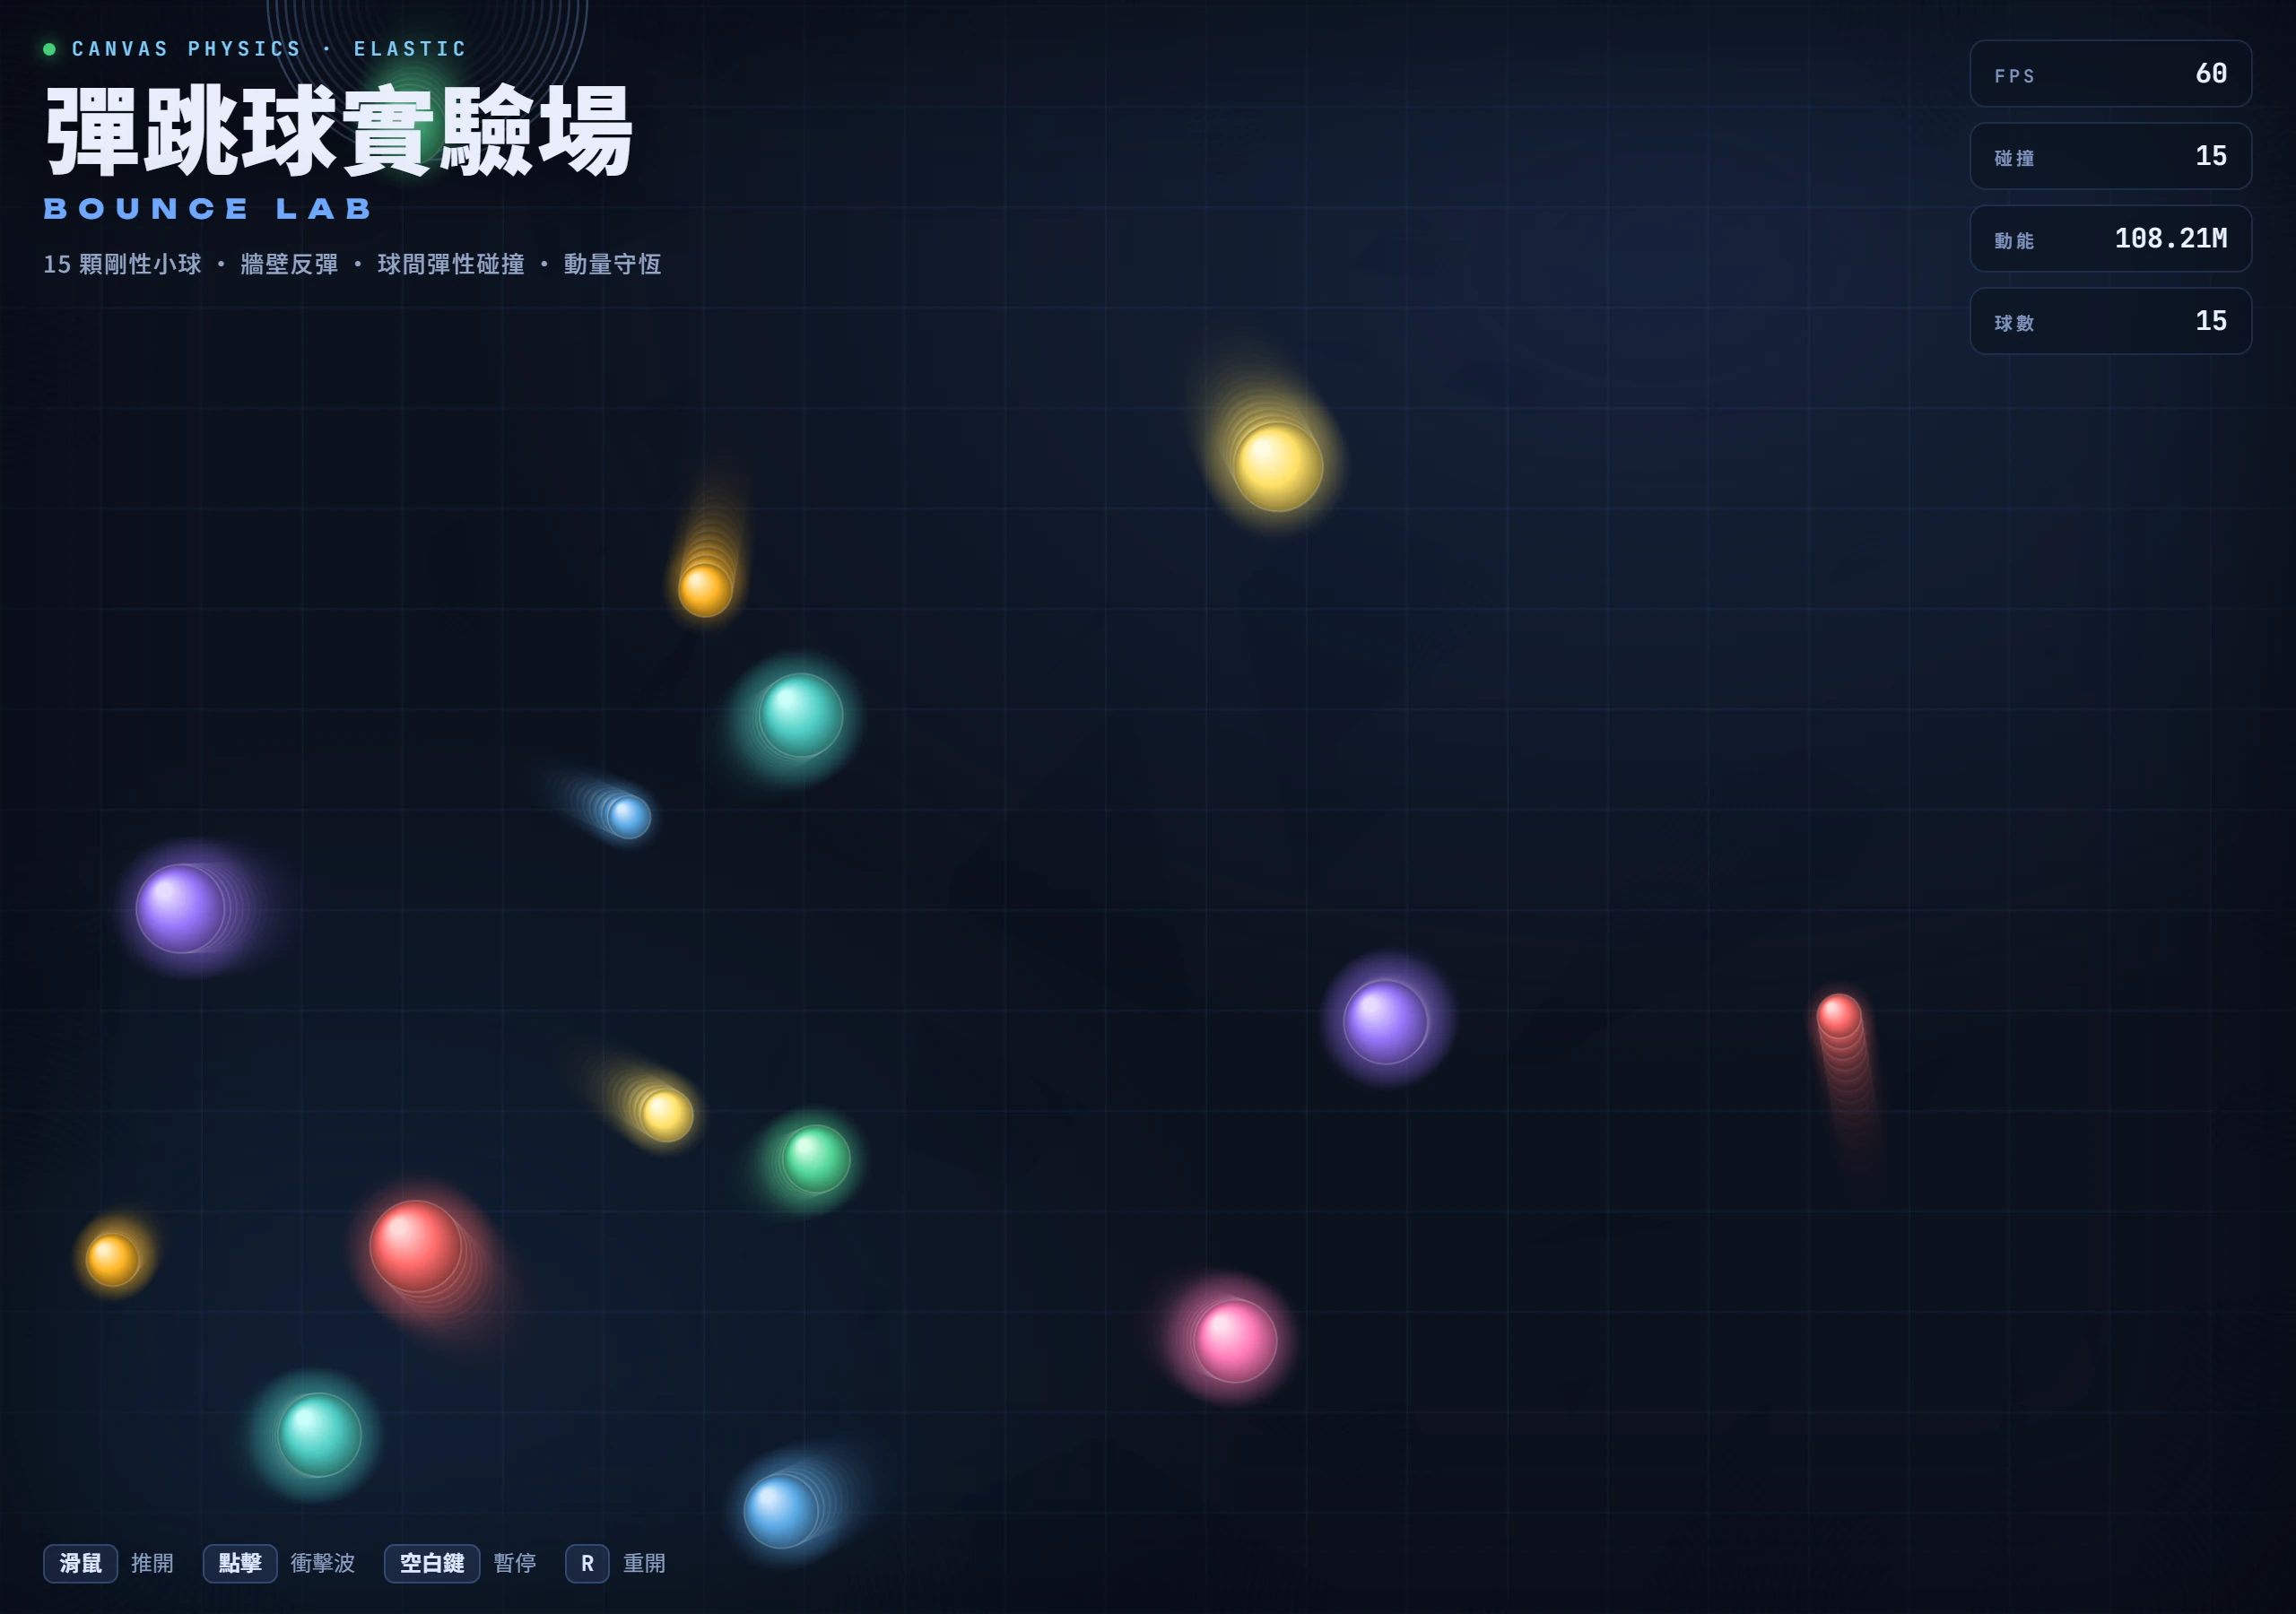
這幾件 xhigh 的成品都在 3 萬 token 上限內完成,和前面程式題 xhigh 沒寫完是不同任務的不同結果,不能歸納成 xhigh 一律寫不完。做這類任務時,先把輸出上限給足,才看得到思考模式真正的成品。
接上 Hermes Agent 當本機 AI 代理
前面的測試都是一問一答。接上 AI 代理框架之後,27B 要自己下指令、讀寫檔案、上網查資料,這也是不少人在本機架設模型的目的。我們用 Hermes Agent 當代理框架、Qwen3.8-27B 當它的大腦,看它在真的會執行指令的環境裡能做到哪裡。AI 代理和一般聊天機器人有什麼不同,可以先從 AI 代理的介紹了解。
Hermes Agent 接本機模型的 64K 門檻
Hermes Agent 是 Nous Research 開發的開源 AI 代理,採 MIT 授權,可以自己架設。它有跨對話的記憶,會從過去的經驗自己建立技能(skills),也能接上 Telegram、Discord、Slack 等通訊軟體。我們裝的是 2026 年 9 月 24 日發布的 v0.21.5,安裝前先看過安裝腳本的內容,全程不用 sudo,下載的檔案也有雜湊驗證。
接本機模型的方式很單純。執行 hermes model 選擇 Custom endpoint,或在 config.yaml 裡填入 base_url,就能接上 llama-server、Ollama、vLLM 這類 OpenAI 相容的端點。我們接的是同一台主機上的 llama-server:
hermes model
# 選擇 Custom endpoint,base_url 填入本機 llama-server 的位址
# http://127.0.0.1:8080/v1Code language: Bash (bash)
要注意的是上下文長度。Hermes Agent 的文件寫明推薦的模型都至少有 64K 上下文,快速入門文件也註明模型的上下文至少要 64,000 token,不到這個長度的模型在啟動時就會被擋下,這正是我們把 27B 的上下文開到 64K 的原因。
另外,Qwen 團隊的部落格提到,Qwen3.8-Max 擴大強化學習的訓練環境時,把不同的代理框架也納入考量,並在 Hermes 等框架上觀察到工作能力持續提升,不過那講的是旗艦 Max。27B 的模型卡只寫了對常見代理框架與開發工具的支援更廣,並沒有說 27B 專門為 Hermes 訓練過。
六項代理任務的耗時與驗證結果
六項任務都經過人工複核,而不是只看它自己回報成功:
| 任務 | 耗時 | 我們怎麼驗證 |
|---|---|---|
| 查 GPU、記憶體、硬碟剩餘空間,整理成表格 | 51 秒 | 數字正確,還主動說明顯示記憶體被 llama-server 佔用 |
| 寫 is_prime 程式、用 assert 寫測試並自己執行 | 71 秒 | 我們重跑 10 個 assert,全數通過 |
| 讀一篇文章整理 5 個重點並計算字數 | 51 秒 | 重點準確,字數 5,061 與我們自己計算的一致 |
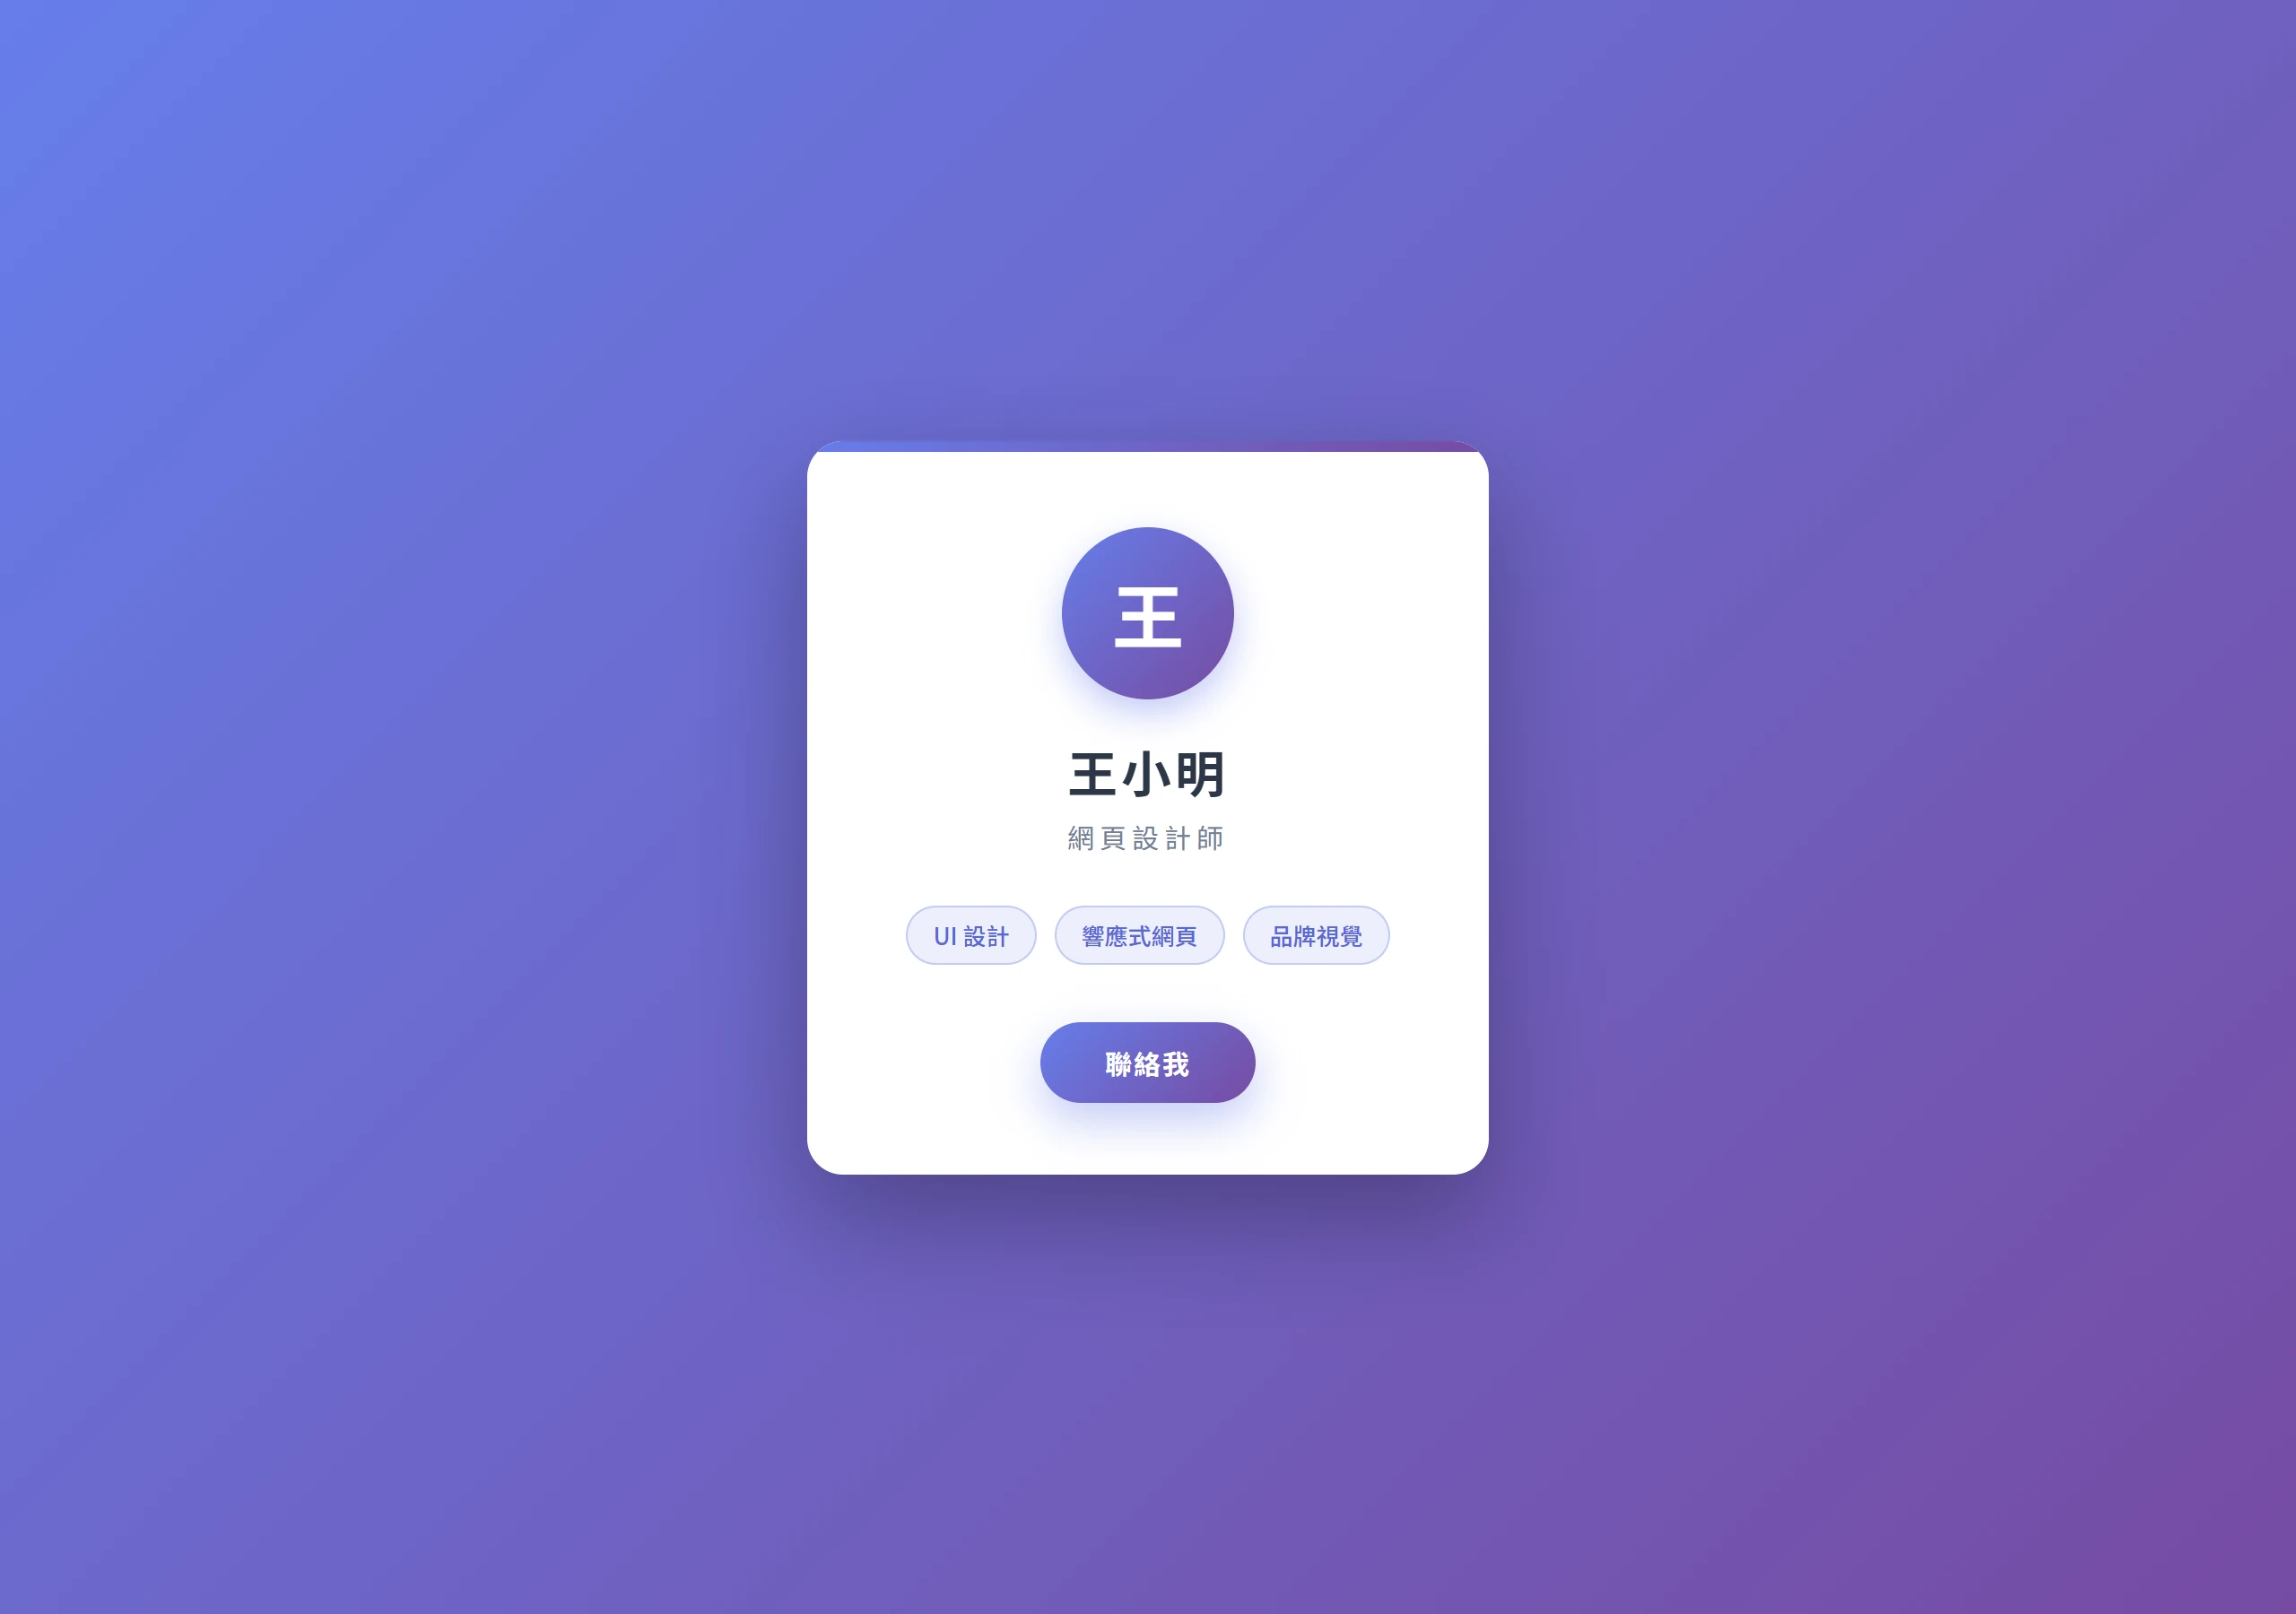
| 做「王小明/網頁設計師」的名片網頁並存檔 | 94 秒 | 檔案正確、樣式完整 |
| 跨對話記憶 | — | hermes chat 互動模式會記得,hermes -z 精簡模式不載入記憶 |
| 上網蒐集資料,寫約 1,500 字的文章 | 21 分鐘 | 執行紀錄確認實際搜尋 4 次、打開網頁閱讀 |
前四項都在 2 分鐘內完成,每一項的結果都經得起複核。寫質數程式那項,它不只寫完函式與測試,還會自己執行一次,確認通過才回報。
跨對話記憶的測試方式,是先請它記住喜歡的顏色與柴犬的名字,再開一個新對話詢問。用 hermes chat 互動模式時它記得,改用 hermes -z 精簡模式則不會載入記憶,兩種模式要依用途選擇,需要延續脈絡的工作就用互動模式。
上網寫文章會寫錯規格,繁體中文要另外加規則
最花時間的是上網寫文章。題目是寫一篇本地 LLM 的硬體需求與選購建議,要求至少參考 3 個來源、實際打開網頁閱讀。執行紀錄顯示它確實搜尋了 4 次、開了網頁來讀,全程 21 分鐘,文中的數字多半找得到出處。
不過規格數字還是寫錯了。它寫 Mac mini M4 Pro「最高 48 GB」、Mac Studio M4 Max「最高 64 GB」;依 Apple 支援網站的技術規格,Mac mini(2024)的 M4 Pro 機型可以設定到 64GB、Mac Studio(2025)的 M4 Max 機型可以設定到 128GB,兩處上限都寫低了。會上網查資料,不等於查到的數字都寫對,這跟前面事實題會出錯是同一件事,代理交出來的文章一樣要查證。
語言是另一個要處理的地方。一開始它的回答會混進簡體,例如「最喜欢的颜色是湖水绿」。我們在 ~/.hermes/SOUL.md(Hermes 存放人設與預設語氣的檔案)加上一條「一律使用台灣繁體中文」的規則後,同一題的回答就全部是繁體了。這個做法不用改模型、也不用調參數,想用 27B 當代理大腦的話,可以直接照這個方式設定。
還有一點要交代,Hermes Agent 內建的模型目錄不提供 4-bit 以下的量化版本,我們用的 3-bit 低於它建議的等級。這套組合跑得動,六項任務也都完成了,但它是在建議規格以下運作,穩定度要打點折扣看待。
適合交給 Qwen3.8-27B 的工作和使用限制
在 12GB 顯示卡、3-bit 量化版的條件下,依前面的實測結果,各種工作建議搭配的模式與設定如下:
| 工作情境 | 建議模式與設定 |
|---|---|
| 一般問答、摘要、寫程式草稿 | 非思考模式,回應快;程式一定要跑測試 |
| 需要準確的推理、程式、潤稿 | 思考模式,reasoning_effort 設成 low |
| 做網頁、畫圖、動畫 | 思考模式,輸出上限給足 1 萬~3 萬 token |
| 讀大量文件、長文問答 | 開 64K 上下文,一次放十幾篇文章 |
| 需要自動執行任務 | 接 Hermes Agent,系統提示寫明使用台灣繁體中文 |
low 在單輪的程式題上又快又準,但 Qwen 團隊提醒過,多輪代理任務裡調低 effort 不一定縮短總時間,自動化流程最好先用自己的任務實測,別直接把「low 比較快」套到所有情境。
使用上有四點已知的限制:
- 事實與規格數字會錯:年份、期間、硬體規格都出過錯,產出的內容要人工查證。
- 偶爾冒出簡體字與大陸用語:量化位元越低越明顯,要靠系統提示約束。
- 非思考模式寫程式結果不穩定:同一題三次有兩次沒有全過,程式一定要跑過測試再用。
- 無法和圖像生成模型同時開啟:在 12GB 顯示卡上,Qwen3.8 與 Qwen-Image 圖像生成模型無法同時載入,要輪流切換。
以上判斷只代表 RTX 3060 12GB、llama.cpp 與 UD-IQ3_XXS 這套條件,換成容量更大的顯示卡或位元更高的量化檔,表現可能不同。
一張 12GB 的 RTX 3060,就能讓 Qwen3.8 27B 算對數學、守住格式、讀完 5.8 萬 token 的長文,還能當代理的大腦上網寫稿;它也會把健保的開辦年份寫錯、偶爾冒出簡體字,輸出上限給得不夠時,還可能等不到答案。把它當成一位速度不快、需要有人把關的助手,先用 low 與足夠的輸出上限跑一輪自己的題目,比任何分數表都更能說明它適不適合留在你的電腦裡。