多數人以為,網站被 Google 收錄的頁面越多,代表內容越豐富、排名機會也越大。這個直覺放在一般文章、產品頁上大致成立,套到站內搜尋結果頁上卻正好相反,這種頁面被收錄得越多,離 Google 定義的規模化內容濫用就越近,不是越受青睞。
站內搜尋結果頁,指的是使用者在網站自己的搜尋框裡輸入關鍵字後,系統即時組出來的那一頁,網址常長得像 ?s=關鍵字 或 /search/關鍵字,WordPress 的預設搜尋機制就是這種寫法,多數 CMS 與電商平台的站內搜尋用的也是同一套原理。多數架站的人根本沒想過,一個搜尋框理論上能組出跟關鍵字排列組合一樣多的網址,而 Google 的爬蟲只要找得到連結,就有可能把每一個都爬進去、收進索引。
多數站內搜尋結果頁該被擋掉,只有極少數例外值得留下。
站內搜尋結果頁是查詢的暫時產物,不是編輯過的內容
一般的內容頁,不管是文章、產品介紹還是分類頁,都是網站經營者事先寫好、固定擺在那裡的東西,同一個網址,今天看跟明天看,內容大致一樣。站內搜尋結果頁完全不是這麼回事,它不是被寫出來的,是被查詢出來的。使用者在搜尋框打進什麼字,系統就即時撈資料庫、組出一頁列表,換一個關鍵字,就是完全不同的網址與內容,永遠沒有寫完的那一刻。
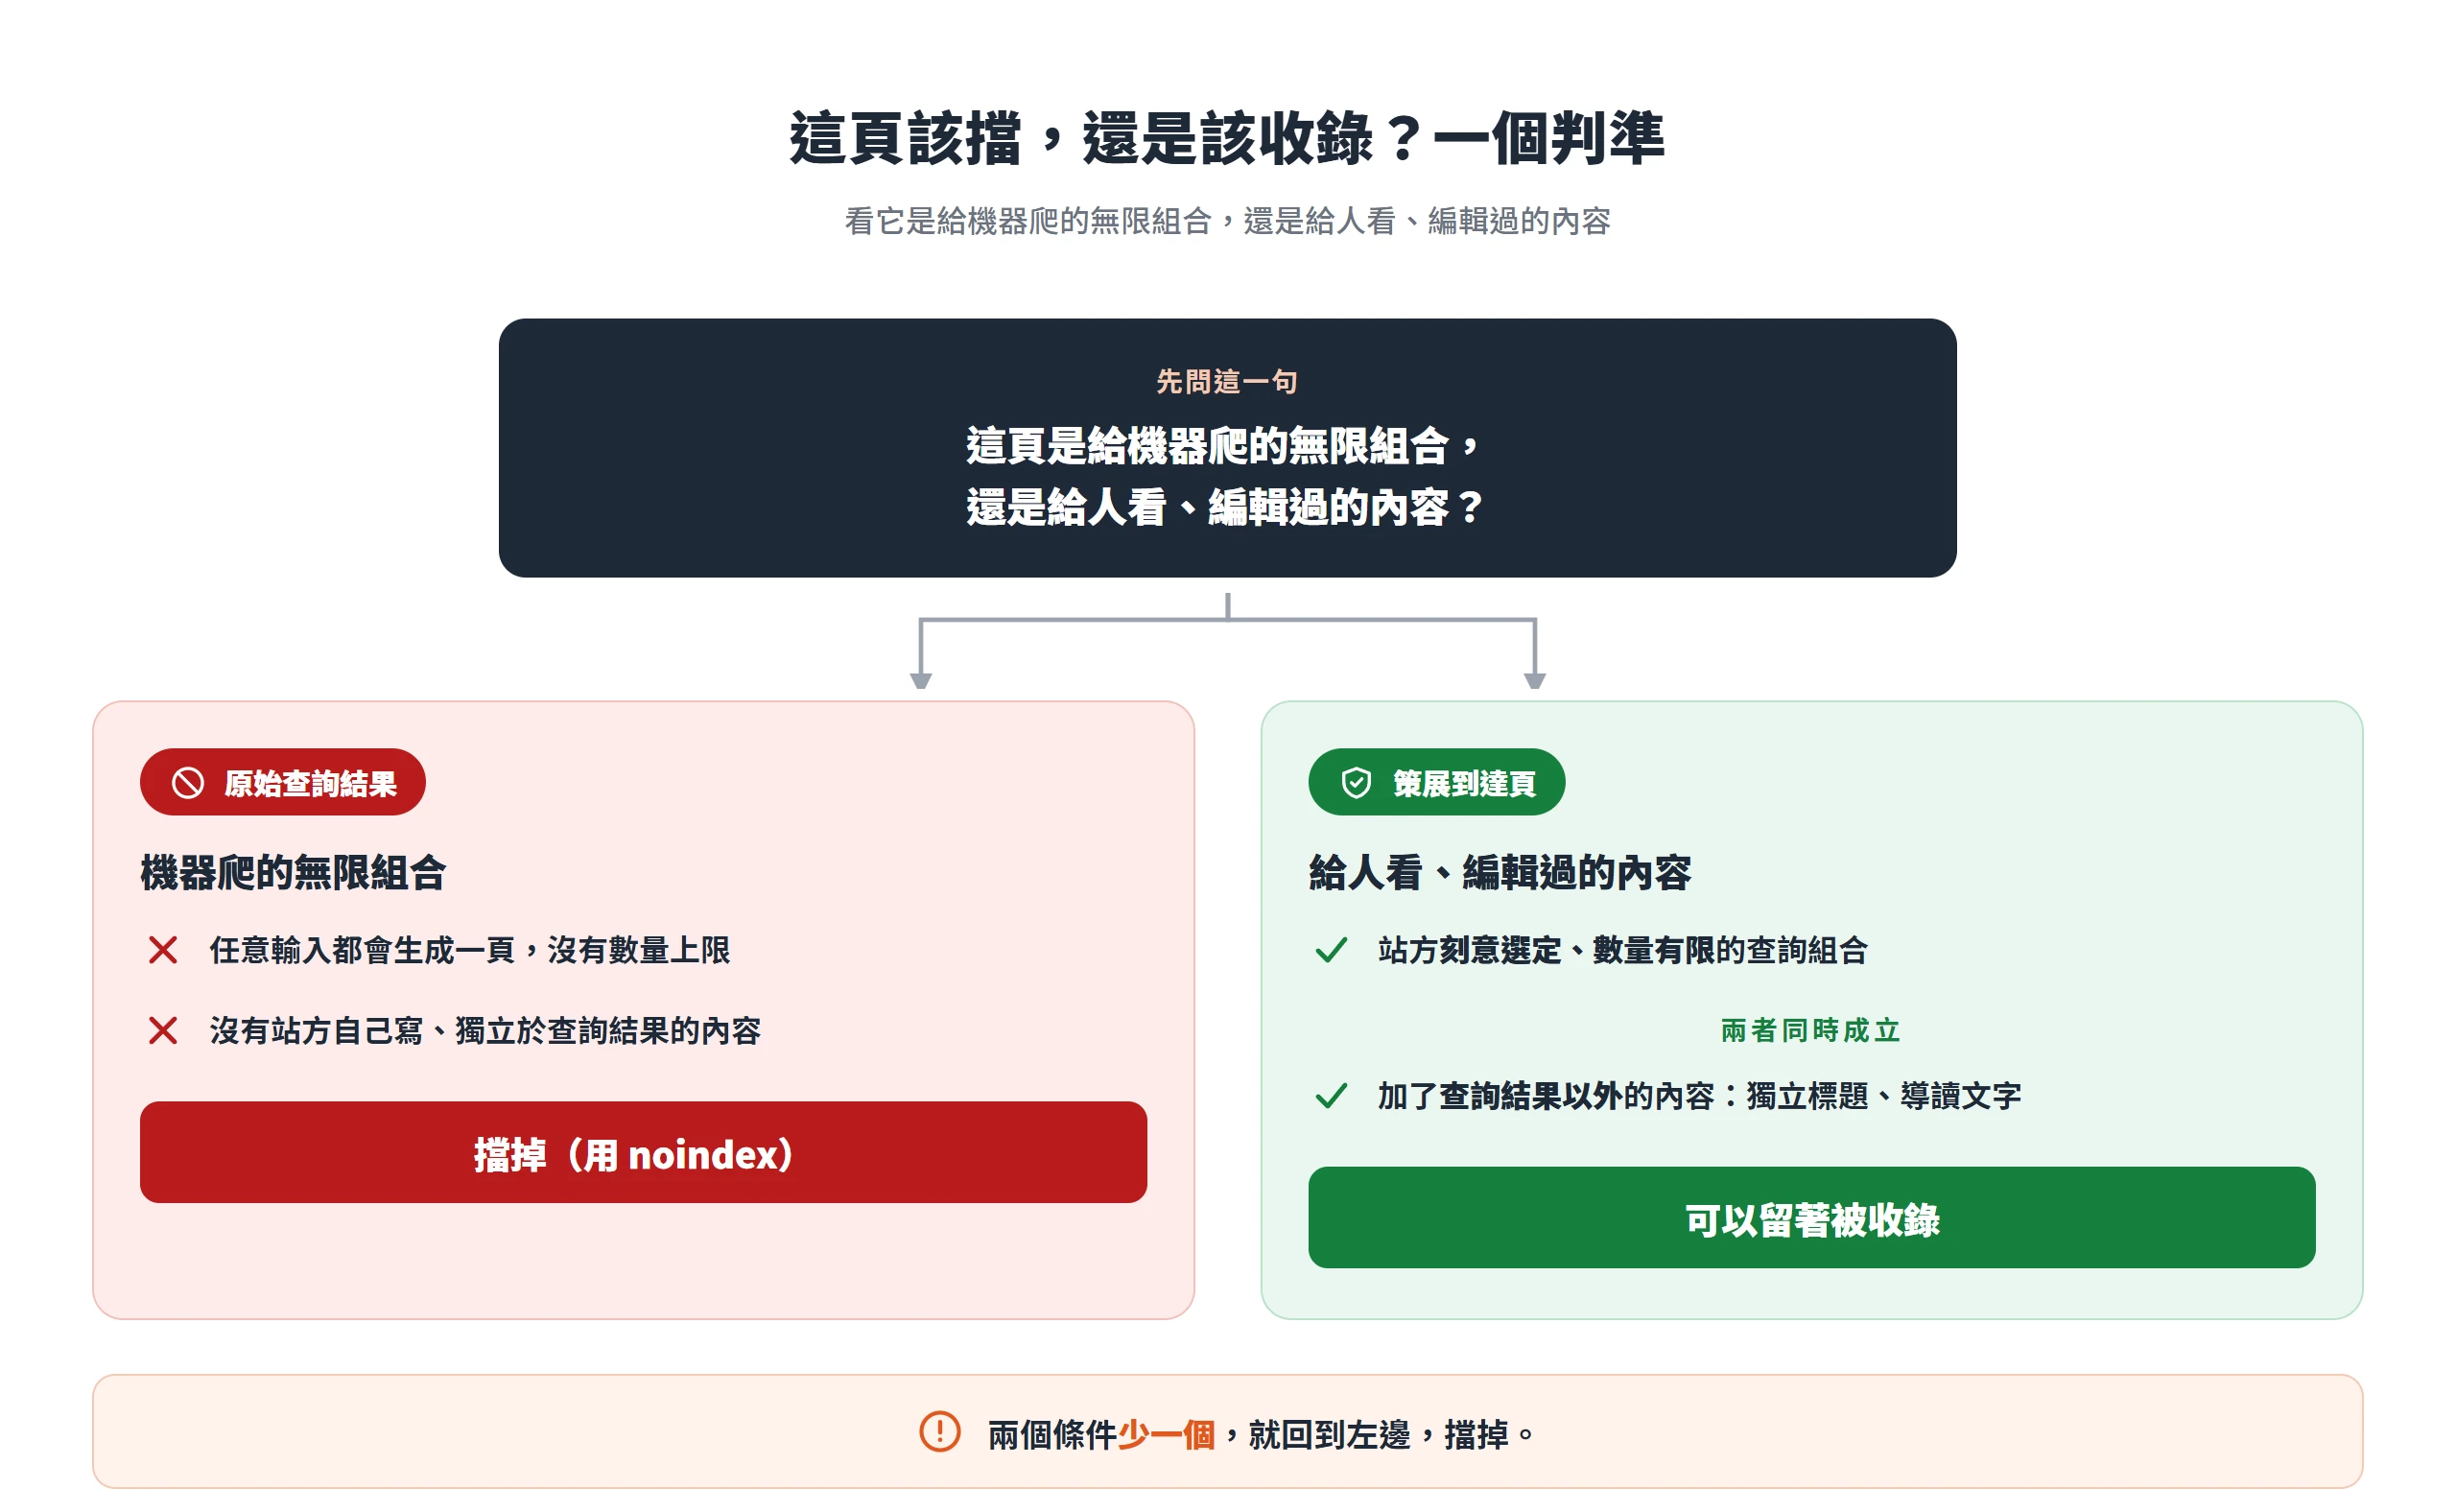
判斷這種頁面該不該被收錄,關鍵不是有沒有人搜過這個字,而是這頁是給機器爬的無限組合,還是給人看過、編輯過的內容。
同一個查詢入口能組合出無限多個網址
一個搜尋框,能讓使用者輸入任何字串,理論上每一種輸入組合都會產生一個獨立的網址,?s=A、?s=B、?s=A+B,每換一個字就是新的一頁。當站上同時存在多個篩選條件,分類加關鍵字、日期加關鍵字,組合數會用乘法往上疊,網址數量很快就遠遠超過網站實際擁有的內容數量。
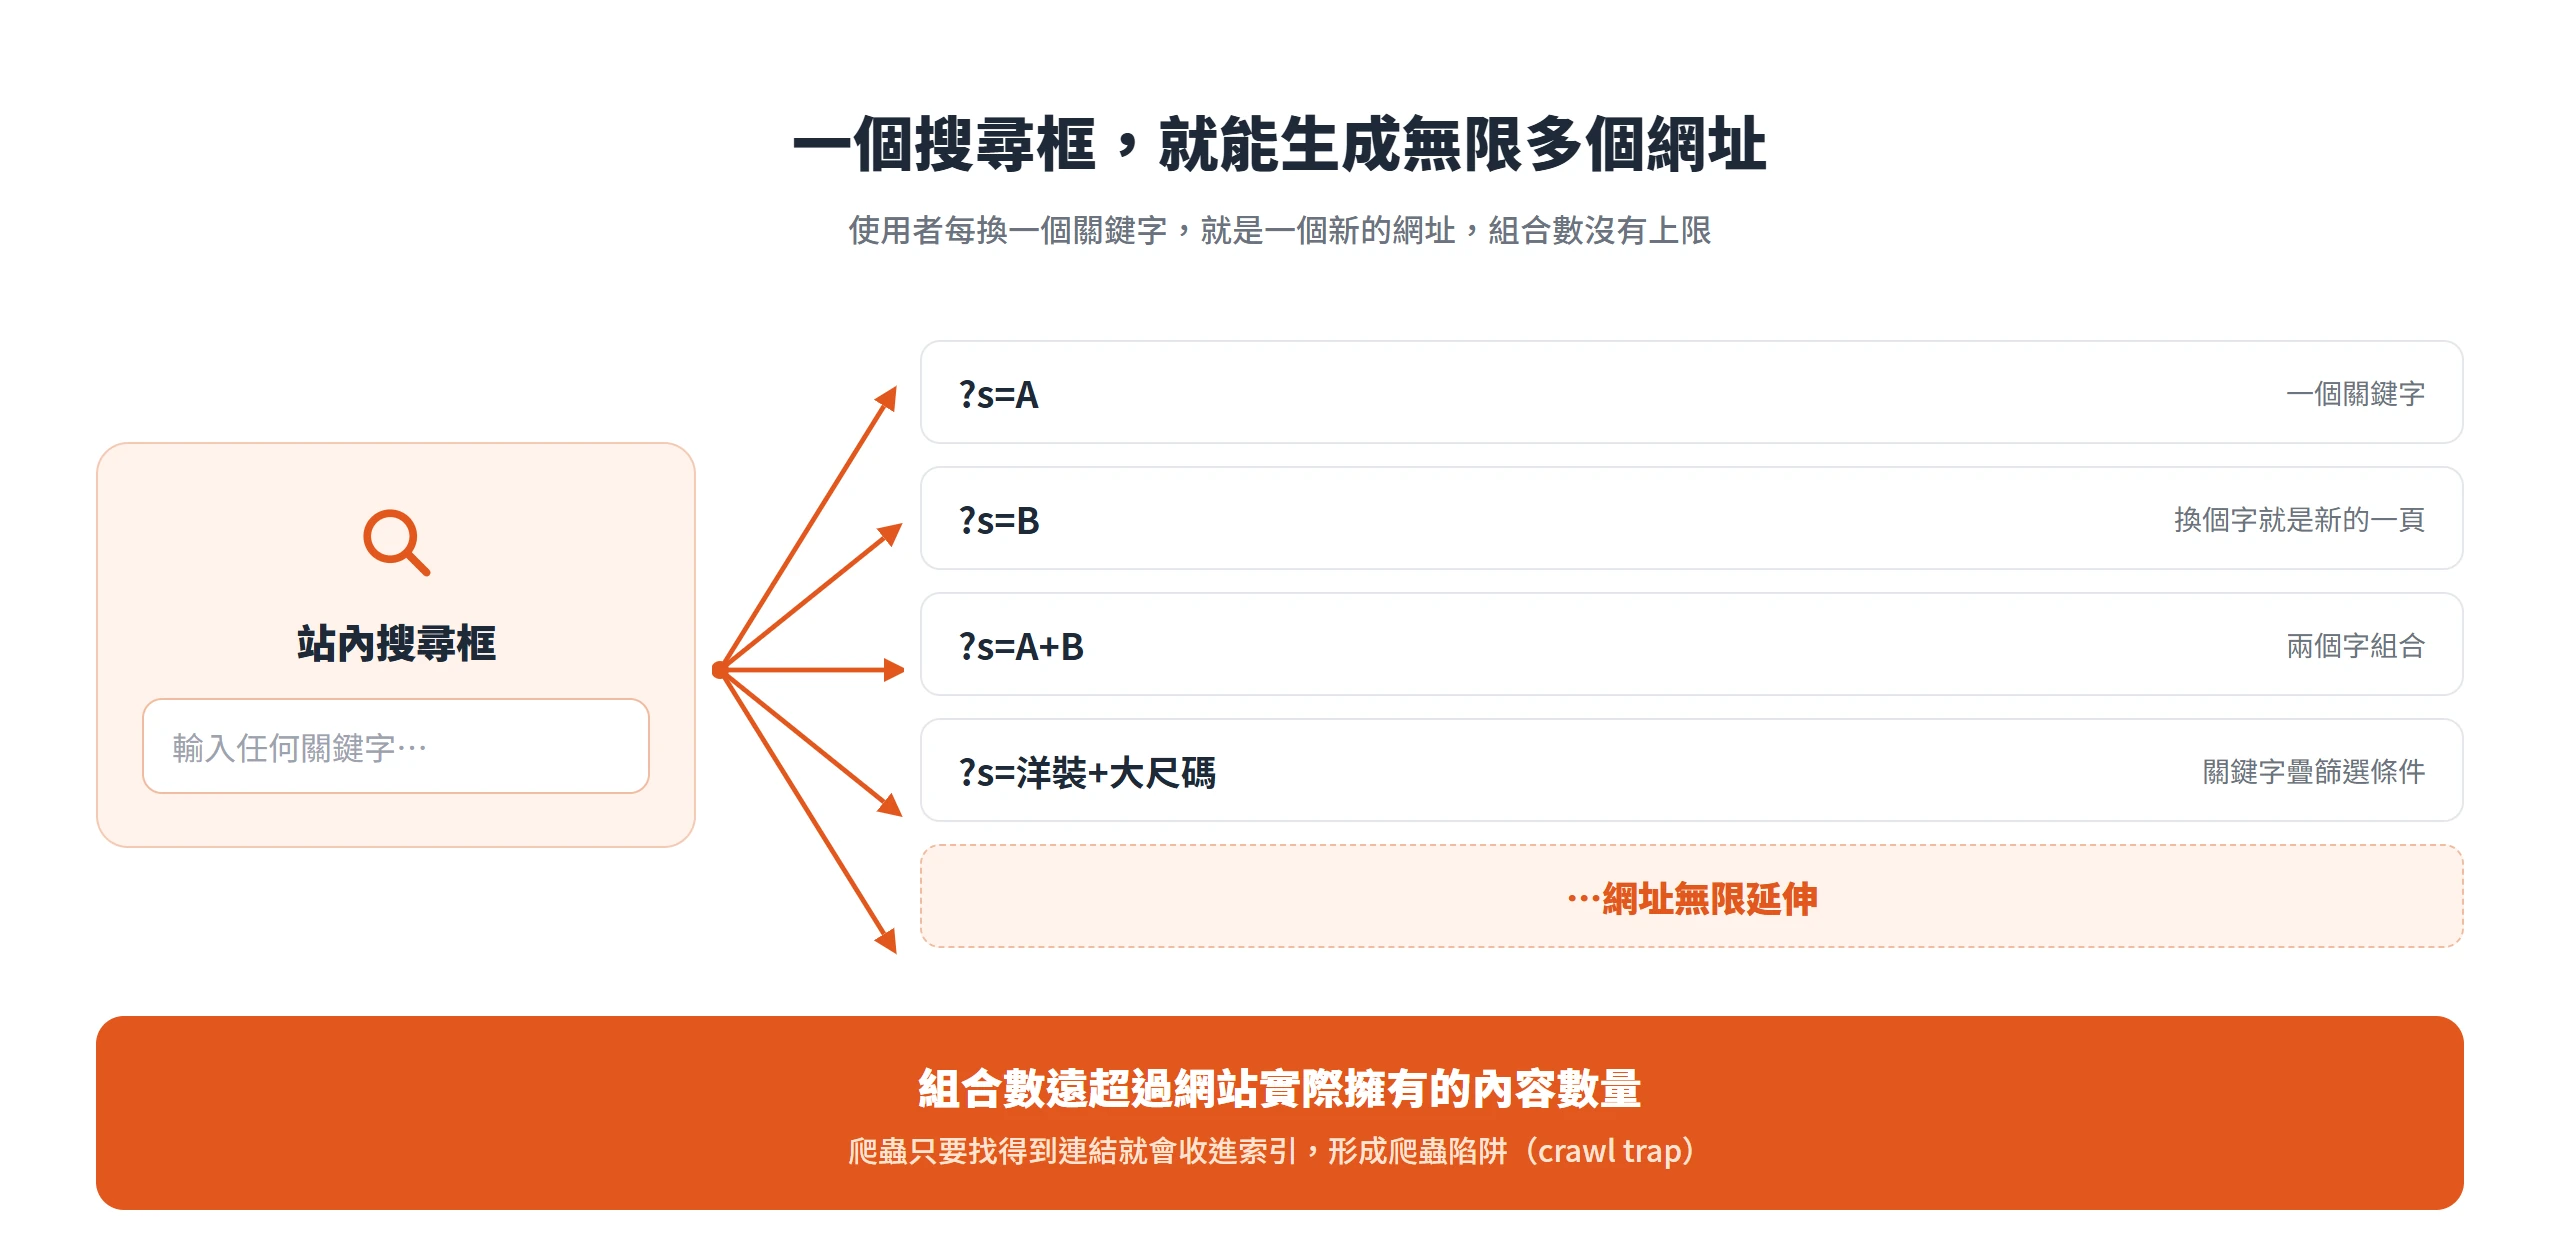
Google 對這種現象並不陌生。它在管理分層篩選(faceted navigation)網址的官方說明裡提到,電商目錄的篩選條件組合,會產生近乎無限的網址空間,數量龐大到爬蟲得先爬過才能判斷有沒有用,卻沒有任何一頁真正新增了編輯或商業上的價值。站內搜尋結果頁是同一種結構,差別只在篩選條件換成了使用者自己打的關鍵字,而且關鍵字不像篩選選項是站方預先定義的有限清單,組合數只會更沒有上限。
策展落地頁與原始查詢結果的分界
多數站內搜尋結果頁該被擋掉,但不是全部,例外的判準有兩個,而且要同時成立。第一,這頁有沒有站方自己寫的、獨立於查詢結果之外的內容,像標題、導讀文字或固定推薦。第二,這個查詢組合是不是站方刻意保留、數量有限的少數幾個,而不是任意輸入都會生成一頁。兩個條件少一個,這頁就只是原始查詢結果,不是策展過的內容。
國際 SEO 圈對哪些內部搜尋頁值得收錄的共識做法,印證了這條界線。當站方真的決定讓某個搜尋組合被收錄,通常會反過來把它做成一個真正的到達頁,有自己的標題、有導讀文字,並對其餘所有查詢組合套用 canonical 或 noindex,只留下少數幾個經過人工判斷值得留下的組合。判準從來不是這個查詢有沒有人搜,而是站方有沒有真的為它做了編輯工作。
規模化內容濫用政策明確點名爬取搜尋結果做頁面
前面幾節都是邏輯推演,如果只看到這裡,可能會覺得這只是一種偏好判斷。但 Google 現行公開的垃圾內容政策,把答案直接寫成白紙黑字的條文。在《Google 網頁搜尋垃圾內容政策》的規模化內容濫用(Scaled content abuse)一條裡,官方明確把爬取搜尋結果去生成大量頁面點名為違規手法之一,這不是業界猜測或間接推論的結果,是 Google 自己寫下來的政策條文。
政策原文對這一條的定義很直白,大量產生頁面的主要目的若是操縱排名,而不是幫助使用者,就構成規模化內容濫用。條文列舉的具體手法之一,是爬取來源、搜尋結果或其他內容去生成大量頁面,包括透過同義詞替換、翻譯等自動轉換手法,但幾乎沒有為使用者提供任何價值。搜尋結果三個字,直接被列進拿去生成大量頁面的素材這份清單裡。
這條政策原本描述的情境,是別人把你的內容整批爬走,再重新拼裝成頁面。但反過來看,一個網站自己開放搜尋引擎去爬、去收錄自己的搜尋結果頁,本質上製造出來的正是同一種東西,規模化、低價值的頁面,差別只在生成者是自己還是別人。Google 在意的是結果,不是動機有沒有惡意。
Google 對站內搜尋結果頁的立場向來沒有鬆動
這個立場不是這幾年才有的政策風向,Google 多年前就建議站方用 robots.txt 擋掉內部搜尋結果頁,以及其他對搜尋使用者沒有太大幫助的自動產生頁面。Google 的 John Mueller 後來在 Reddit 上的一則公開回覆裡,把理由講得更直白,如果站方沒辦法只挑出有意義的搜尋結果頁開放收錄,那就該把全部搜尋結果頁都設成不可收錄。
他寫道:if you can't limit the indexable search results pages, I would strongly recommend noindexing or robotting all of the search pages,並特別點名最沒有爭議的情況,especially if a search results page returns no results, there's no reason for it to be indexable,查無結果的搜尋結果頁完全沒有理由被收錄。
查無結果的頁面之所以是最沒有爭議的例子,是因為它連可能對使用者有幫助這個最後的辯護空間都沒有,讀者被導向一個什麼都沒有的頁面,等同落地頁徹底失效。這也呼應前面提到的判準,Mueller 說的沒辦法限制哪些搜尋結果頁可以被收錄,講的正是多數站方根本做不到策展,那就該預設全部擋掉。
讀者點進搜尋結果頁,通常拿不到比自己查詢更多的東西
把爬蟲的角度放一邊,單純想像一個外部讀者從 Google 搜尋結果點進一個網站的搜尋結果頁,這件事本身有沒有價值,多數情況下沒有。
讀者原本已經在 Google 打過一次關鍵字,點進來看到的卻是另一層搜尋介面,常常是空的,或跟原本輸入的字不完全對應,等於把剛剛做過的事重新做一次。這種體驗上的落差,不是加值,是浪費。查無結果的搜尋結果頁是最糟的情境,等於讓使用者白白多點一次卻什麼都沒拿到,跟落地頁失效沒有兩樣。
對照組是讀者點進一篇正常文章或分類頁時看到的東西,站方已經整理好、固定擺在那裡的內容。這中間的資訊落差,就是策展跟未經策展的差別。Google 在垃圾內容政策開頭定義的大量產生頁面若不是為了幫助使用者就構成濫用,本質上談的也是同一件事,頁面該不該存在,看的是有沒有真的對讀者有幫助,不是有沒有技術上可以生成。
robots.txt 與 noindex 處理的是兩個不同階段
多數站方遇到怎麼擋掉搜尋結果頁這個問題時,直覺是 robots.txt 的 disallow 跟 noindex 標籤一起上,當成雙重保險。Google 官方文件講得很明確,這兩個工具處理的是不同階段的問題,同時疊加反而會讓 noindex 完全失效。
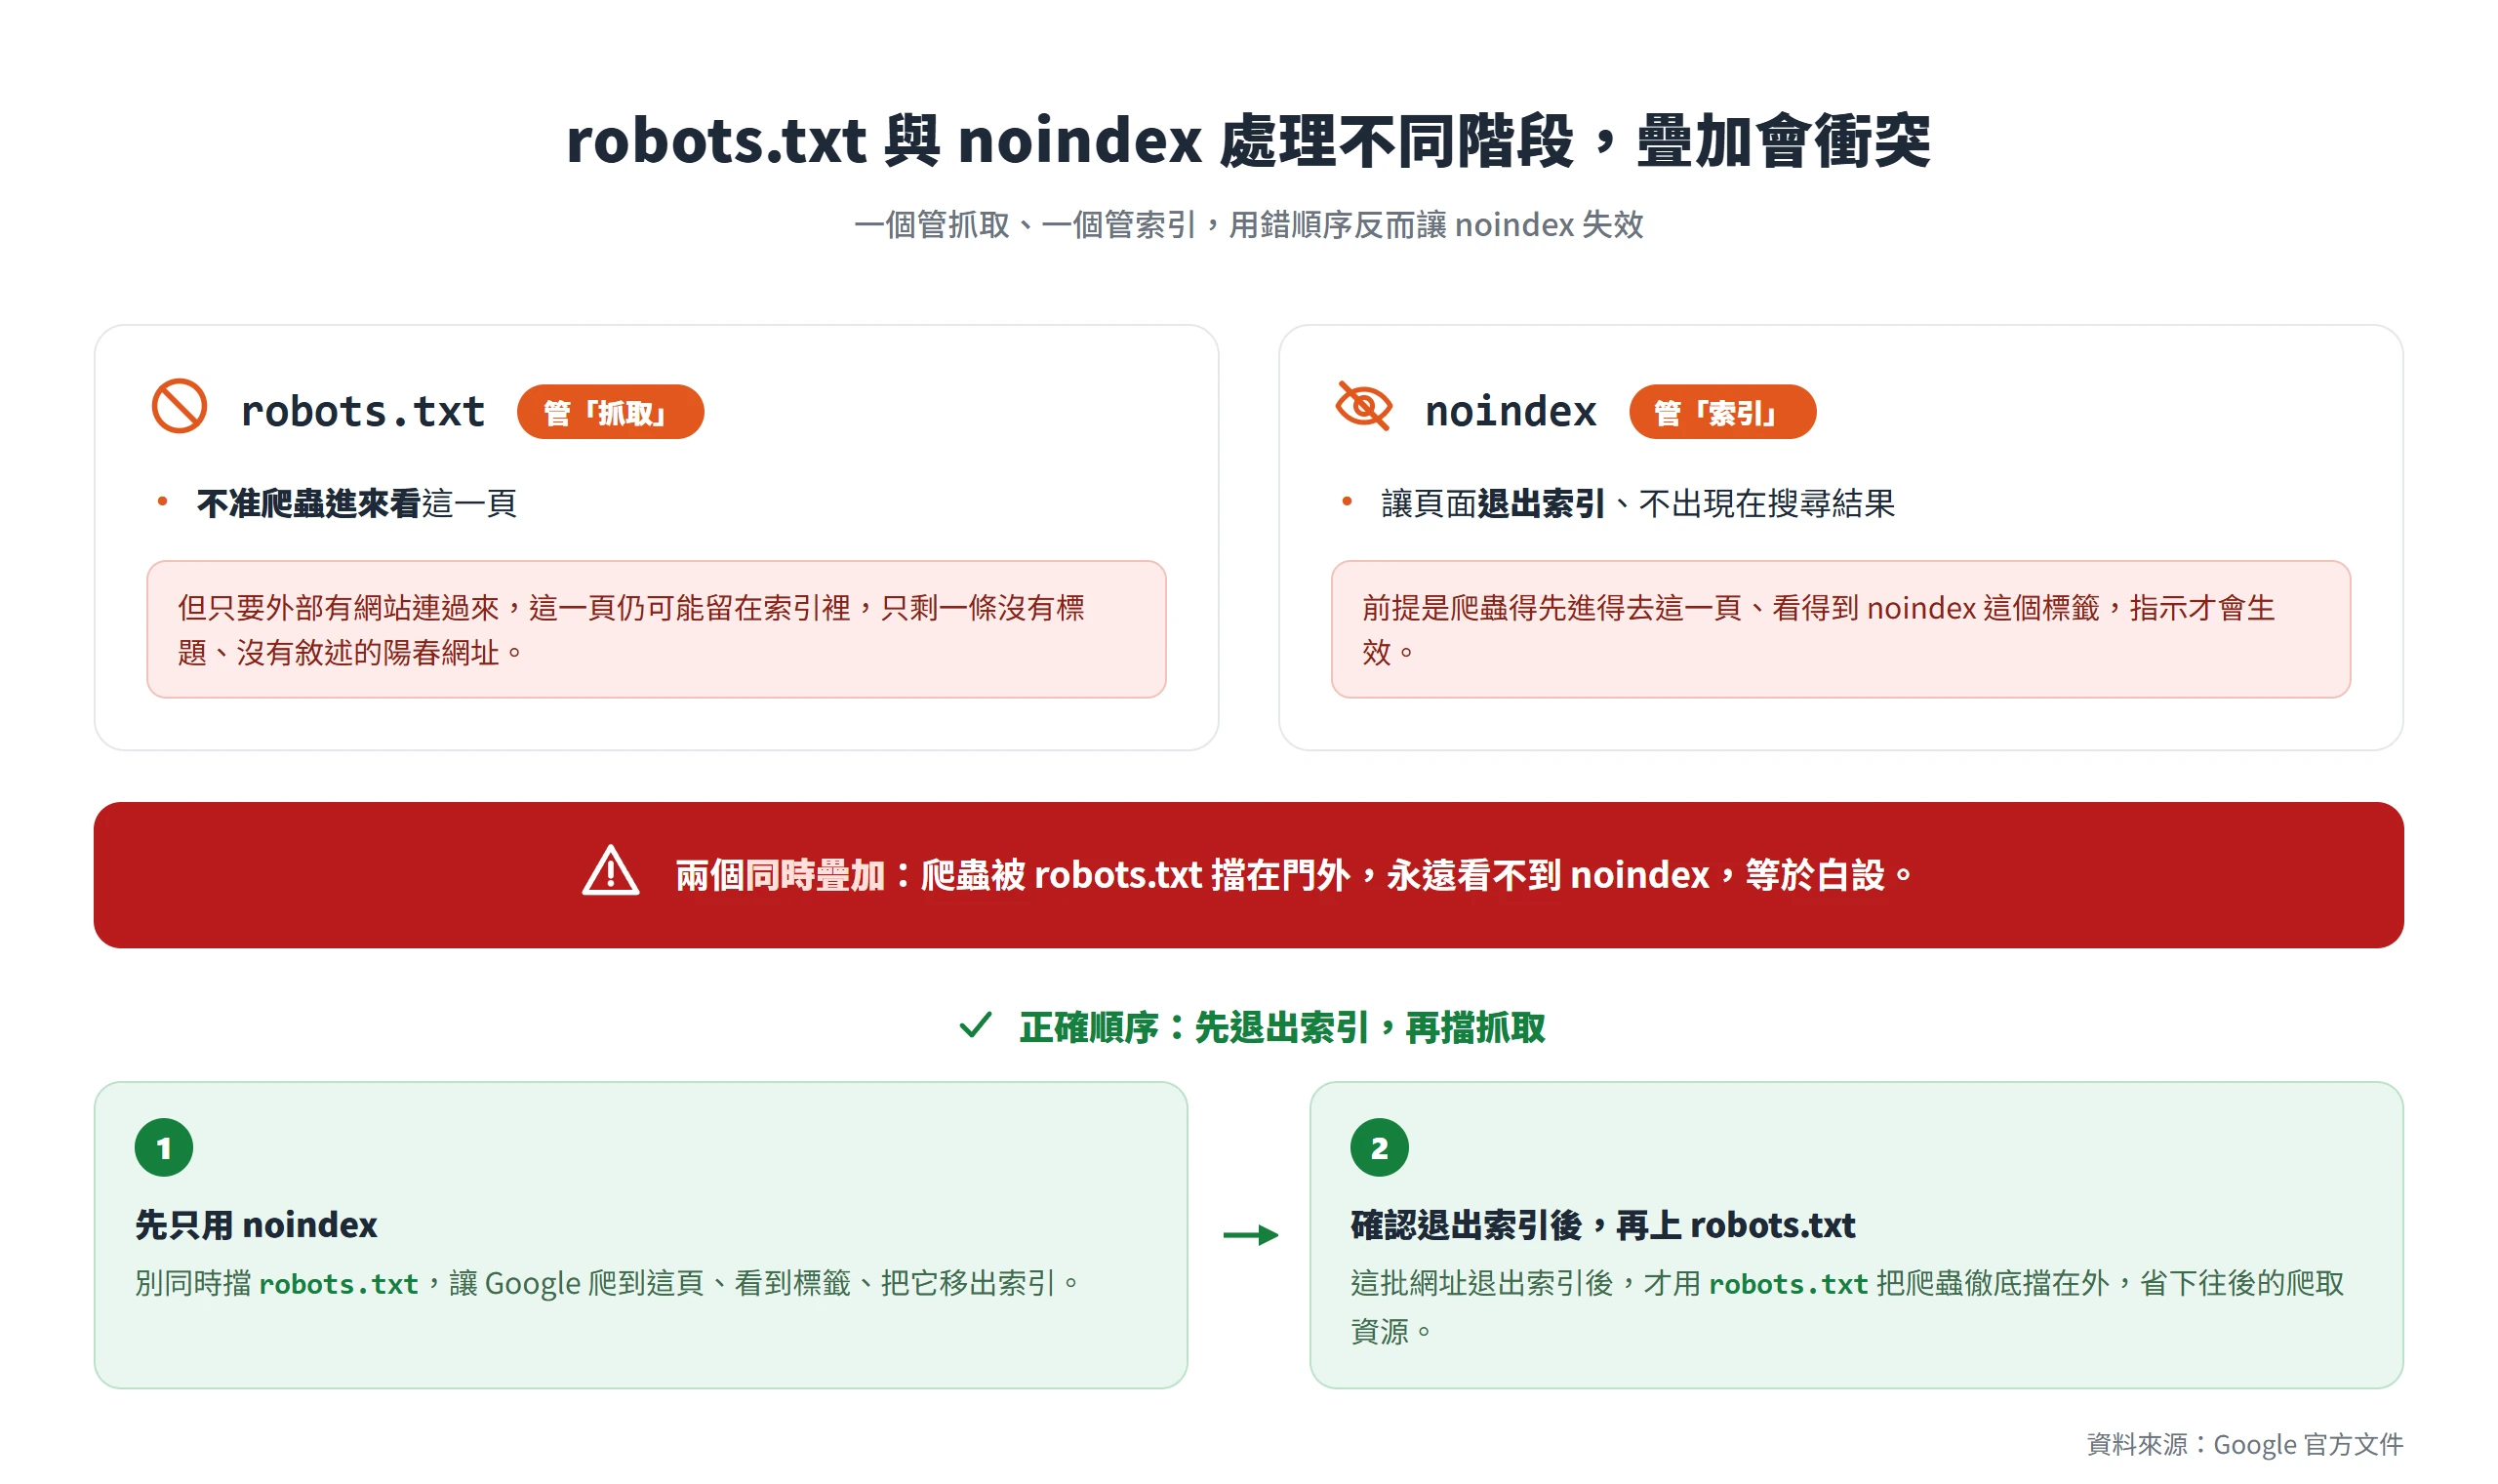
robots.txt 的 disallow,做的事只是不准爬蟲進來看這一頁,並不等於這一頁不會出現在搜尋結果裡。Google 官方文件寫得直接:A page that's disallowed in robots.txt can still be indexed if linked to from other sites.,只要外部有其他網站連到這個搜尋結果網址,Google 依然可能把它留在索引裡,沒有標題,沒有敘述,只剩一條陽春的網址列示。
noindex 能生效的前提,是爬蟲得先進得去這一頁,才看得到 noindex 這個指示。如果同時用 robots.txt 擋住了這一頁,爬蟲根本進不去,也就永遠看不到 noindex 標籤,兩個規則反而互相衝突。Google 官方也提醒過,同時疊加多條爬取與索引規則,可能會讓某些規則互相抵銷,原理正是如此。
正確的順序反過來做,先只用 noindex,不要同時擋 robots.txt,讓 Google 重新爬到這一頁、看到 noindex、把它從索引裡移除。等確認這批網址已經退出索引,才用 robots.txt 把爬蟲徹底擋在外面,省下往後的爬取資源。這個順序,也對得上 Google 官方對怎麼正式防止一個網址出現在搜尋結果裡給的建議,除了 noindex,官方列的作法還包括替伺服器上的檔案加密碼保護,或乾脆把頁面整個移除。
例外只留給被策展過的搜尋結果頁
不是所有站內搜尋結果頁都該一律擋掉,但例外真的很窄。只有站方主動介入,把某個查詢組合改造成有編輯內容的到達頁,才值得留著被收錄,沒有這層人工介入的,回到預設立場,擋掉。
判準一,這個網址是不是站方刻意選定、數量有限的組合,而不是任意輸入都會生成一頁。舉例來說,一個電商網站把連身裙加大尺碼這種高頻、固定會被搜的查詢組合,另外做成一頁有獨立標題與導讀文字的到達頁,這就是刻意選定。判準二,這個頁面是不是真的加了查詢結果以外的內容,而不是原封不動把搜尋結果列表直接當內容端出來。兩個判準同時成立,這個頁面本質上已經不是搜尋結果頁,是一般的到達頁,該用一般到達頁的 SEO 邏輯處理,不再適用預設擋掉這條規則。
想知道自己的網站有沒有踩到這個問題,可以先用 Search Console 的頁面報表,或者直接用 site: 加關鍵字查一次自己的網域,看看有沒有搜尋結果頁被收錄。找到之後,對照上面兩個判準逐一檢視,不成立的,就照前面提到的正確順序處理,先 noindex,確認退出索引後再上 robots.txt。
站內搜尋結果頁真正的問題,不是排名的技術細節,而是回到最基本的一件事,這個頁面是不是真的為了讀者而存在。多數搜尋結果頁答不出這個問題,它們是查詢當下才拼出來的組合,打字的人是使用者自己,不是站方。留著讓它被收錄,對讀者沒有額外的價值,對 Google 的印象也只會往規模化、低價值那個方向靠。
少數真正經過策展的例外,值得被留下。剩下的,擋掉是對的選擇,而且越早處理越省事,等到被判定成規模化內容濫用之後才回頭清理,要花的力氣遠比一開始就設好 noindex 多得多。