
多數人以為,只要幫網站裝上一顆 AI 客服機器人,退換貨天數、營業時間異動這些寫在網站上的問題,它自然就答得出來。實際測過才發現,機器人常常還是含糊帶過,甚至答出一個網站上根本沒寫過的答案。
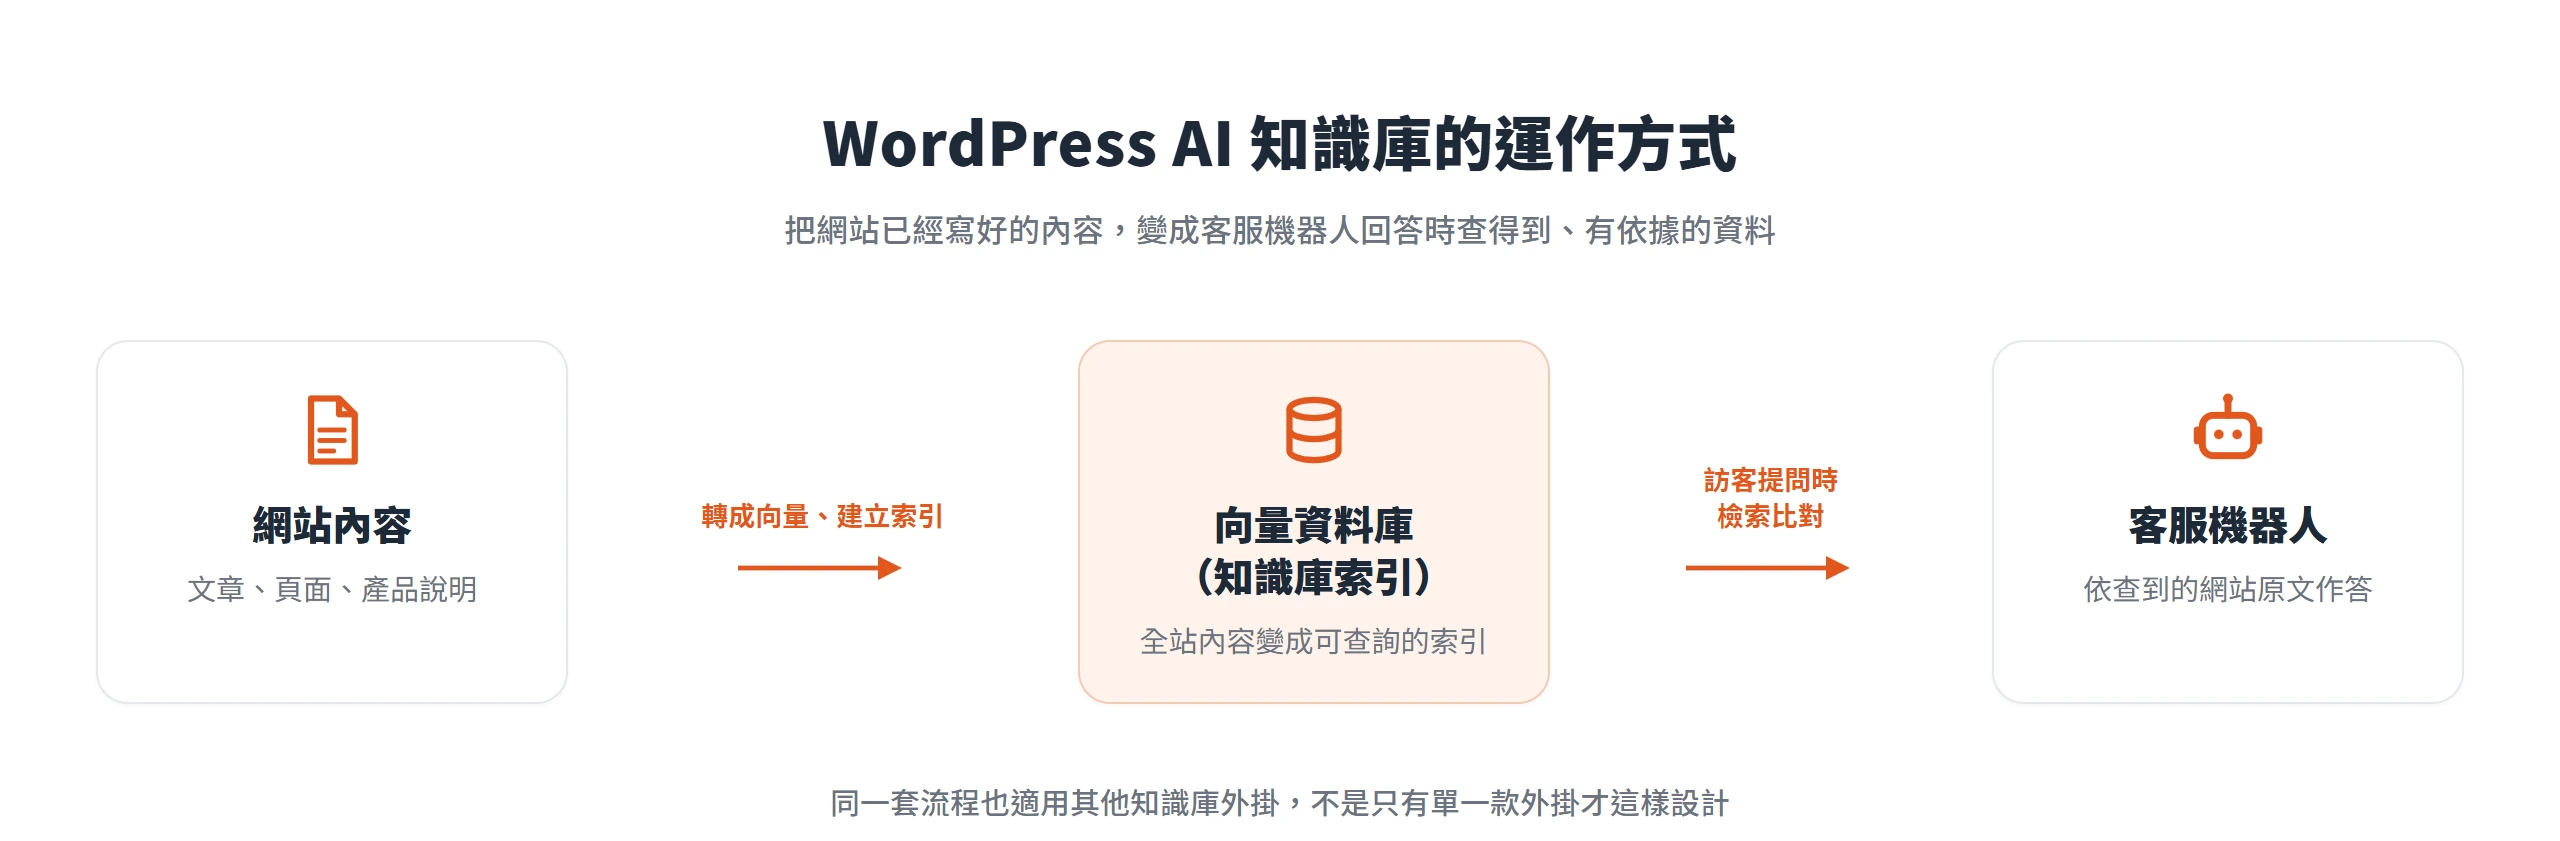
問題不在 AI 不夠聰明,而在它讀到的東西不對。多數聊天機器人預設只讀兩種依據:模型出廠時的通用訓練資料,加上(如果有開)訪客當下正在看的那一頁。退換貨政策寫在另一篇公告裡、營業時間標在頁尾小字,它就查不到。WordPress AI 知識庫要解決的正是這個落差,不是讓 AI 變得更博學,而是把網站上已經寫好的文章、頁面、產品說明,轉成 AI 回答時真正查得到、有依據的資料庫。
「讀當前頁面」跟「讀全站索引」是兩回事,客服機器人答得準不準,關鍵就卡在這個差別上。
WordPress AI 知識庫是什麼?讓客服機器人只依網站內容回答
先把「AI 知識庫」這個詞在 WordPress 情境下指什麼講清楚:它不是讓聊天機器人的模型變得更聰明、更博學,而是把網站上已經寫好的文章、頁面、產品說明,整理成 AI 回答問題時可以查詢、可以引用的依據。裝了知識庫,機器人回答的不再只是「它猜你可能想知道什麼」,而是「網站上真的這樣寫」。
常被混在一起的其實是兩種不同機制。第一種只讀「訪客目前正在看的那一頁」當背景資訊,換一頁,背景就跟著換一份;第二種是把全站內容都轉成可搜尋的索引,訪客問的問題不必發生在他當下瀏覽的頁面上,機器人也答得出來。以 AI Engine 這款外掛為例,它把這兩種機制都放在 Pro 版:「Content-Aware」功能的運作原理,是抓取使用者目前瀏覽那篇文章或頁面的內容,當作對話當下的背景資訊;官方文件也明白提醒,第三方頁面建構工具或某些頁面元件,可能讓這套機制讀不到內容,換句話說,這個機制天生只認「這一頁」,跳出這一頁就沒有依據了。要讓機器人跨頁回答,得靠同樣屬於 Pro 版的「Embeddings」功能,把文章與頁面內容轉成向量、建立可跨頁語義搜尋的知識索引,還需要另外接上 Pinecone 或 Qdrant 這類向量資料庫服務才能運作。
客服情境特別需要後面這一種。訪客的提問跟他當下瀏覽的頁面往往對不上,他可能正停在某個產品頁,問的卻是「退換貨要幾天」這種寫在別處公告的問題。只讀當前頁面的機制,遇到這種情況就等於沒有依據可用;要涵蓋這類跨頁提問,答案得靠全站索引,而不是那一頁碰巧寫了什麼。
沒有知識庫的客服機器人只靠通用訓練資料回答
沒有接上知識庫時,客服機器人回答問題的依據只剩兩種,模型出廠時累積的通用訓練資料,加上(如果有開啟)當前頁面的內容。這兩種都不等於「網站上寫的政策、規格、公告」,差別在於,通用訓練資料是模型在訓練階段看過的大量文字統計出來的通則,不是這個網站真正的規定。
這個落差會在具體問題上現形。訪客問退換貨天數、某項商品的規格數字、營業時間的最新異動,這些多半是網站上其實寫得清清楚楚的資訊,但機器人沒有依據可查,還是會用流暢的口吻給出一個答案,只是那個答案未必準確,甚至是模型自己拼湊出來的內容。這正是生成式模型已知的特性,缺乏具體依據時,它不會停下來說「不知道」,而是照樣用通順的語氣把話講完。
對客服場景來說,這種答得流暢但不精確,比答不出來更危險。訪客多半會直接把機器人給的答案當真,不會再去翻網站原文核對,如果那個天數、那個規格數字剛好答錯,等於是機器人替網站發布了一則錯誤公告。知識庫要解決的不是讓 AI 更會講話,而是讓它答得有依據,依據就是網站上真正寫過的內容,而不是模型自己補的通則。
適合餵進 AI 知識庫的內容類型與整理原則
「餵資料」不是把整個網站生肉倒進知識庫就好,內容要先整理過才真正有用。第一個原則是內容要新,過時的舊文章,像是改版前的價格頁、已經下架的活動辦法,如果還留在索引裡,機器人照樣會拿它來回答,訪客問到的答案跟現在的實際狀況對不上。
第二個原則是同一件事只能有一個版本。如果退換貨政策同時寫在一篇舊公告與一份新政策頁裡,兩邊用詞還不完全一致,機器人在檢索的當下可能挑到過時或錯誤的那一份,它不會自己判斷哪個版本才是現在有效的,只會找出跟問題語意最接近的那一段。
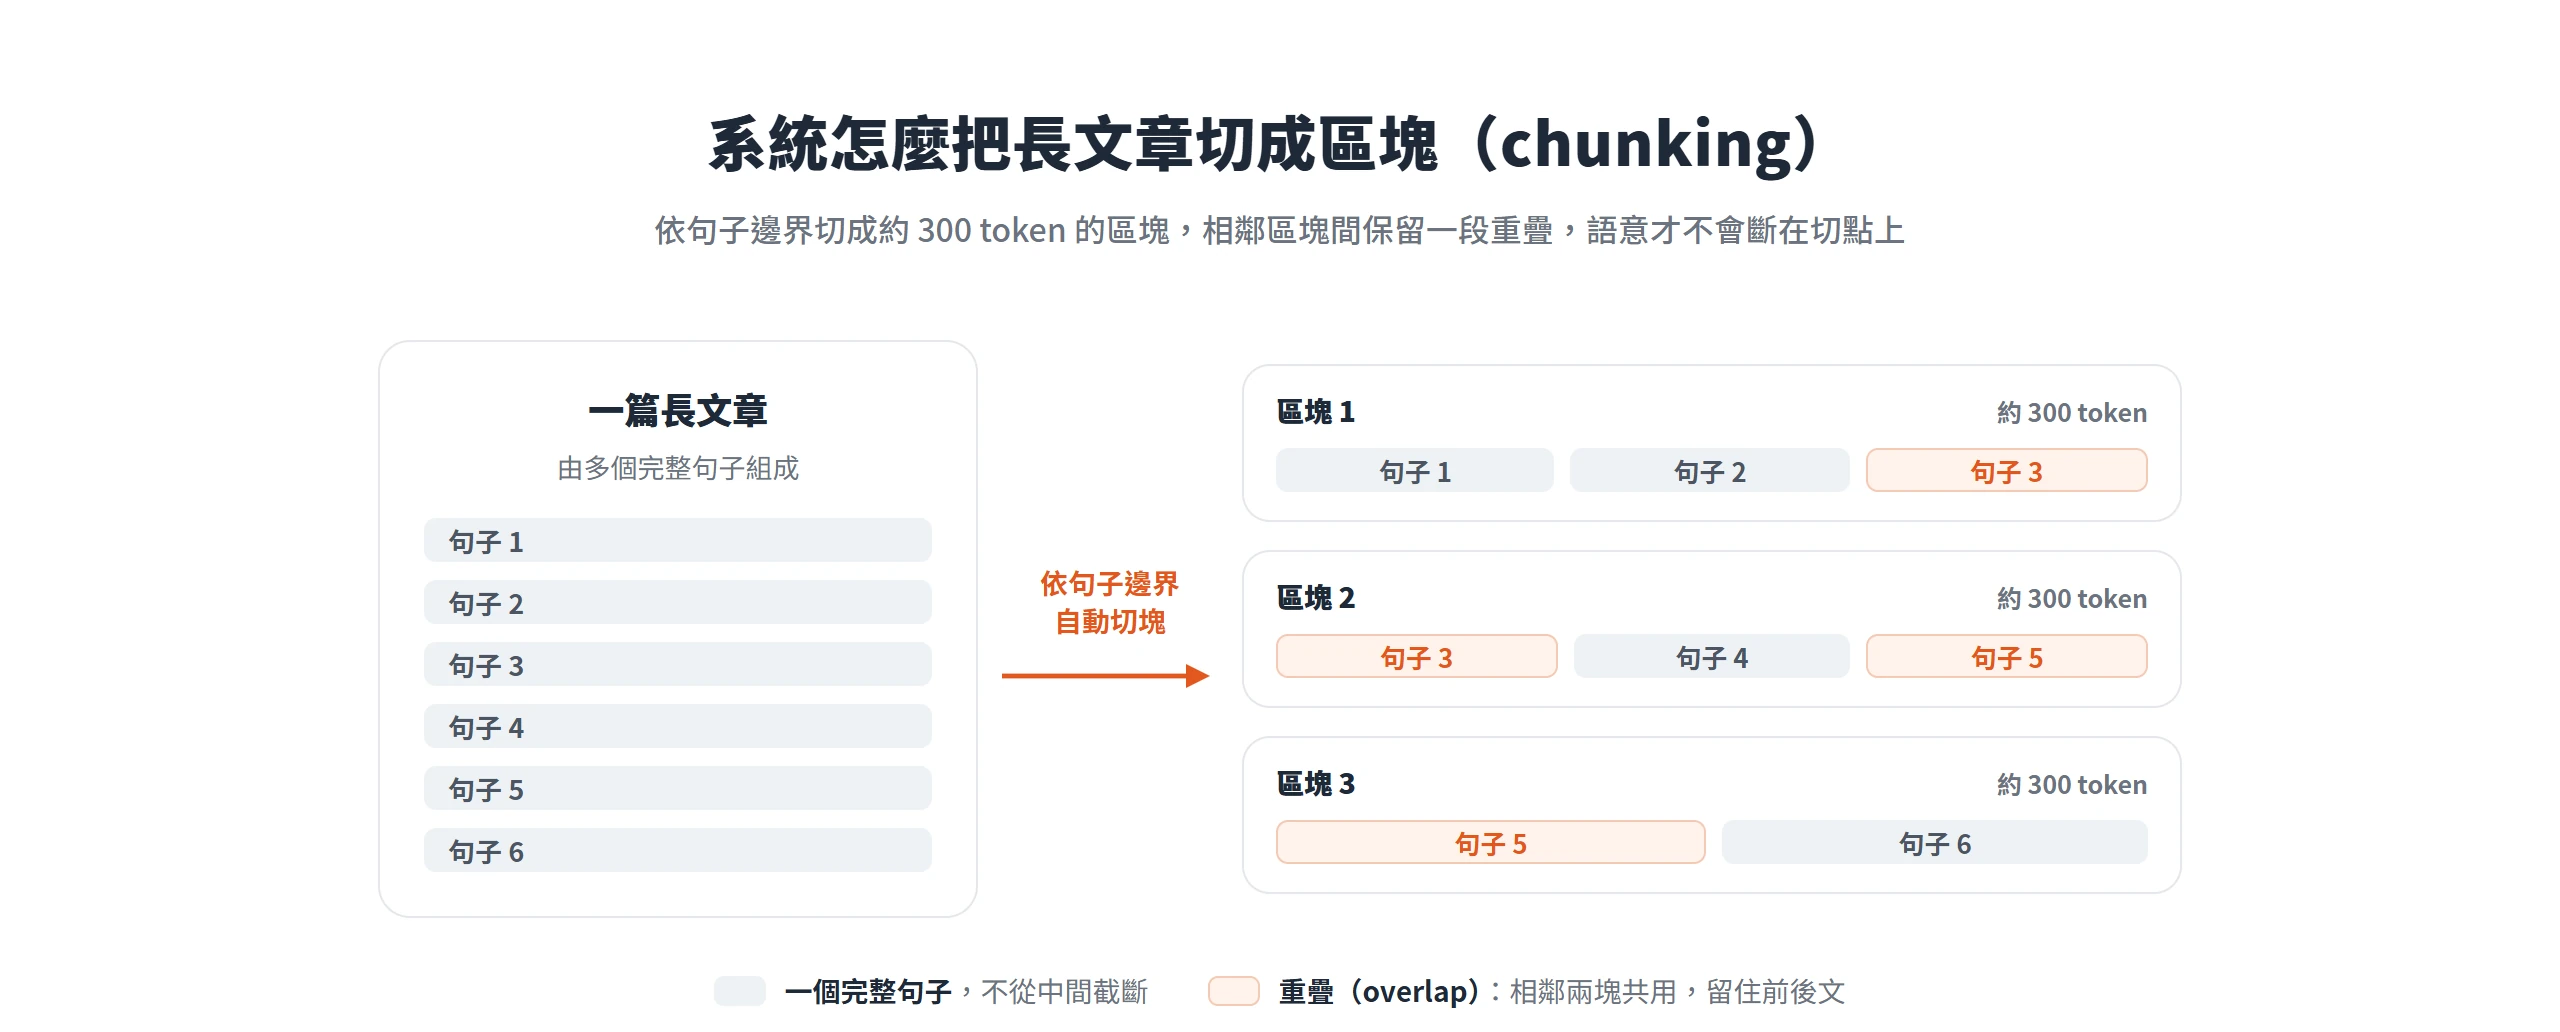
第三個原則是段落結構要清楚:內容要有標題、每一段只講一件事,盡量用純文字呈現。這條之所以重要,跟系統建索引時的實際做法有關,系統會把長文章切成一段一段較小的區塊分別處理,這個動作業界通稱「切塊(chunking)」。Amazon Bedrock 的官方知識庫文件說明了這個機制的運作方式,系統會把文件內容切成較小的區塊,分別轉成向量以利檢索比對;預設的切塊大小約 300 個 token,而且會依照句子邊界切,確保每個區塊裡的句子是完整的,不會從句子中間硬生生截斷;也可以設定區塊之間保留一部分重疊(overlap),讓相鄰兩個區塊留住一段前後文,避免語意剛好斷在切點上而遺漏脈絡。
這個切塊動作由系統自動完成,不必自己動手處理。但知道原理之後就會理解,為什麼段落界線清不清楚會直接影響回答準不準,段落分得清楚,系統切出來的每一塊才會真正對應到一個完整的意思,機器人找到那一段時,答案才會貼著問題走,而不是抓到一段話講到一半的殘句。
知識庫功能鎖在付費層級,還要另開一個向量資料庫帳號
在動手之前,有一個常見誤解得先說清楚,裝了外掛不代表知識庫功能就能用。多數外掛把「讀全站內容建索引」這類進階功能放在付費方案,免費版通常只提供「讀當前頁面」那種較輕量的機制。以 AI Engine 為例,官方產品頁列出的年費方案有 Starter(79 美元,可用於 1 個網站)、Standard(99 美元,可用於 5 個網站)、Professional(179 美元,可用於 20 個網站),另外也有終身制的方案(Standard Life 499 美元、Professional Life 799 美元)。頁面上明確把「Embeddings & Content Aware(建立知識庫)」列為 Pro 版新增的功能之一,免費版不含這一項。
除了外掛本身的費用,還有一筆容易被忽略的支出,知識庫要接上 Pinecone 或 Qdrant 這類向量資料庫服務,得自己在這些平台申請帳號、取得 API 金鑰。AI Engine 的官方教學也明白提醒,這款外掛跟這些服務並沒有合作關係,也就是說,這部分要花多少、用量怎麼計算,得自己跟該向量資料庫服務商確認,不是算在外掛的月費或年費裡。
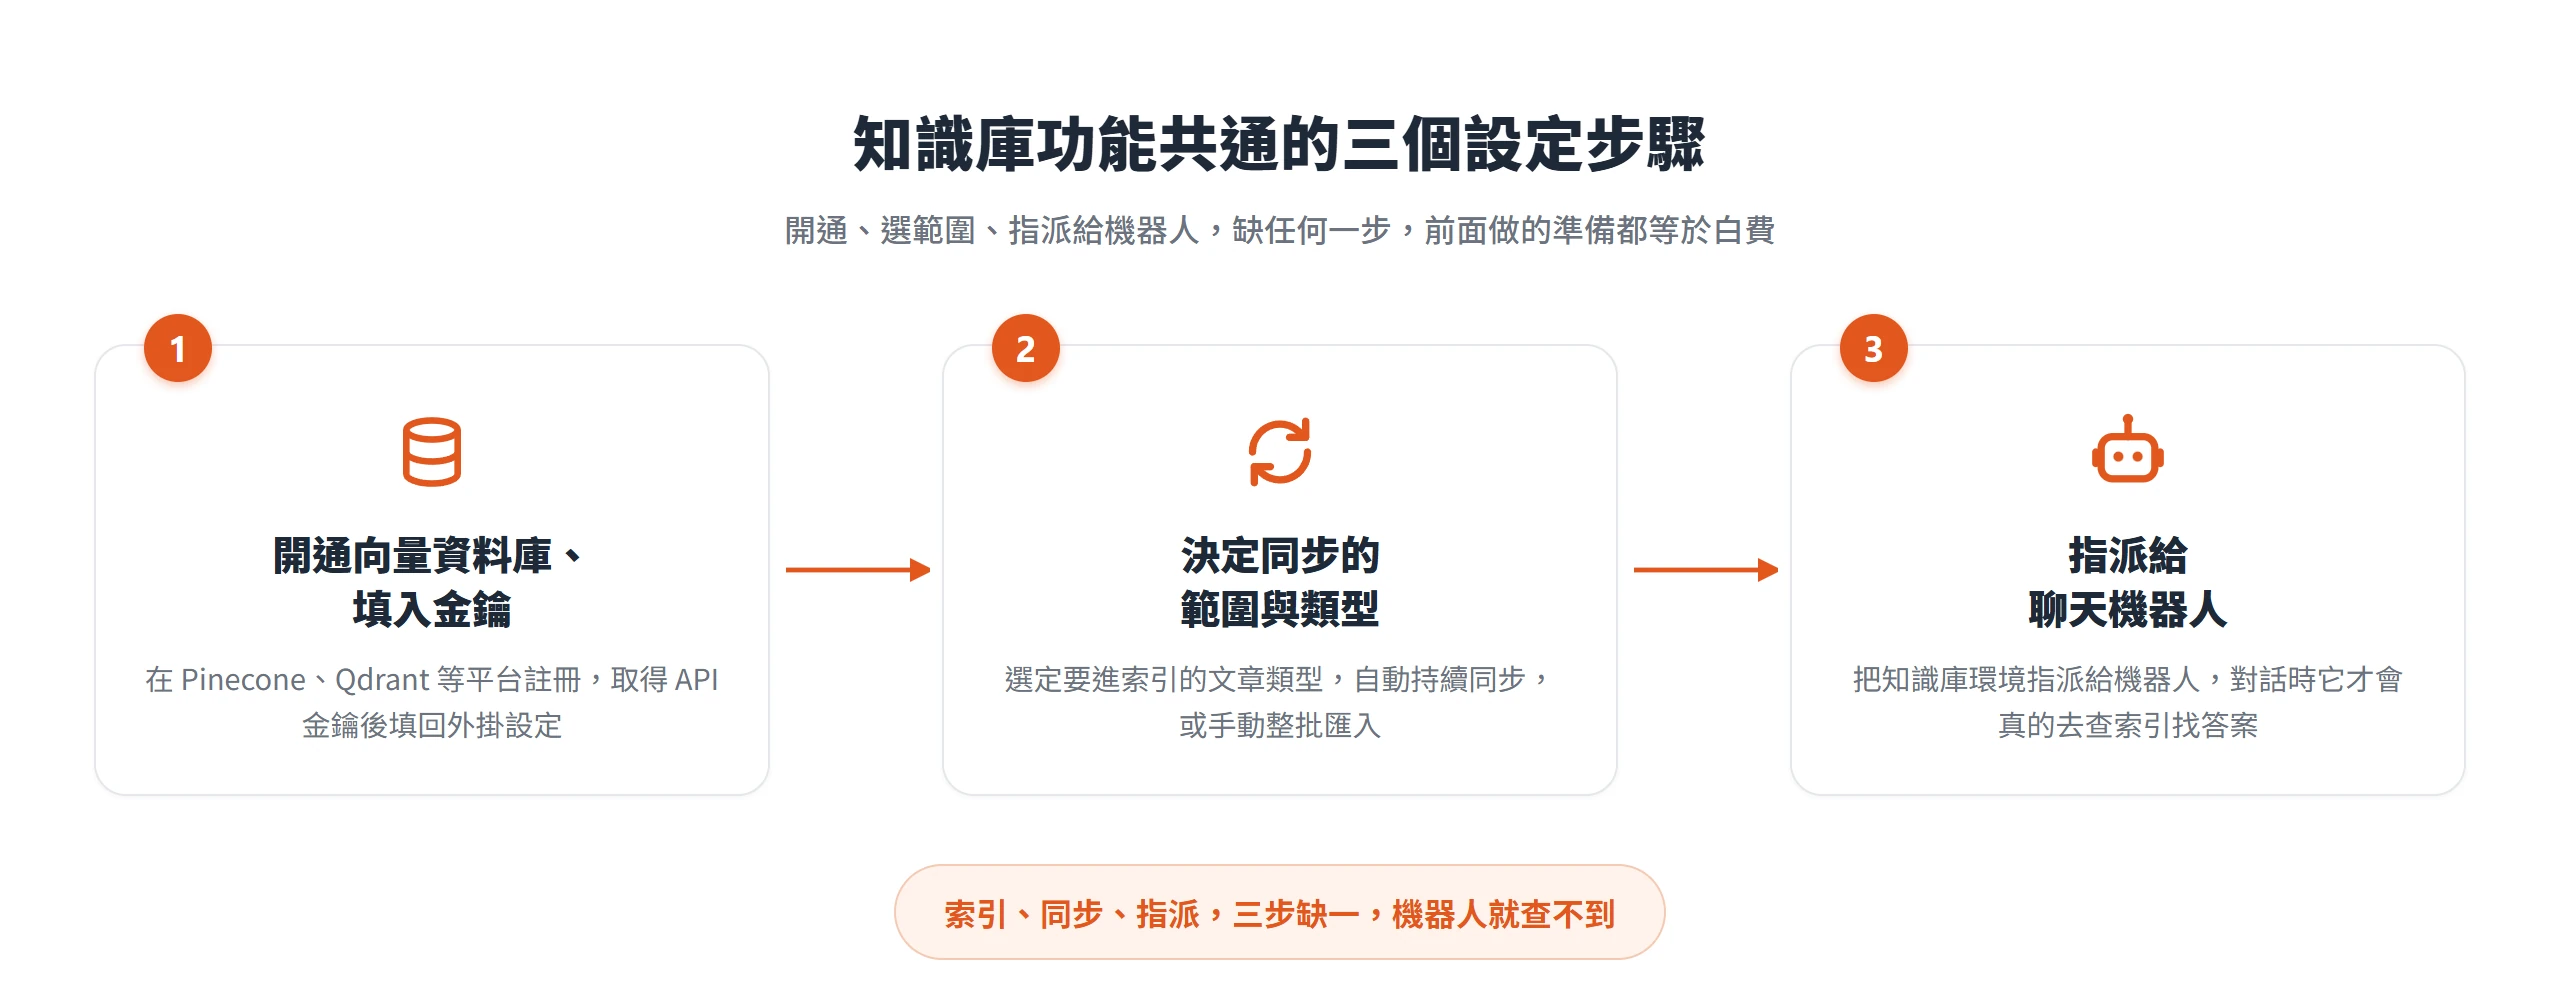
開通、選範圍、指派給聊天機器人,這三個動作是這類知識庫功能共通的流程,不是只有這一款外掛才這樣設計。
先開通向量資料庫帳號,再回外掛設定填入金鑰
具體的準備工作是先在 Pinecone 或 Qdrant 這類向量資料庫服務上完成註冊,建立一個專屬的空間,拿到一組連線用的金鑰。接著回到外掛的設定畫面,把這組金鑰填進去,它就會成為外掛裡可以選用的一個「環境」。
這一步的重點在於理解,知識庫並不是外掛自己憑空產出的一個資料庫。實際運作是外掛把整理過的內容送去自己開通的那個向量資料庫服務裡存放與檢索,外掛本身扮演的角色比較像中間的橋樑,負責把 WordPress 的內容轉換、傳送過去,真正的儲存與比對是在向量資料庫服務那一端完成。以 AI Engine 的官方教學為例,它支援 Pinecone 或 Qdrant 兩種向量資料庫供應商,需要先在該平台建立帳戶,再回到外掛的「Environments for Embeddings」設定裡新增這組連線資訊,之後才能在後續步驟裡選用這個環境。
決定同步進索引的文章範圍與類型
開通功能之後,同步範圍不會自動涵蓋全站所有內容,這一步要自己設定。常見的做法分成兩種。第一種是自動同步,設定好某個文章類型或分類之後,之後新增或修改的內容會持續自動同步進索引,不必每次手動處理。第二種是手動同步,自己指定要同步哪幾篇,或是整批匯入一次到位。以 AI Engine 為例,「Auto-Sync Posts」可以選擇要用的向量資料庫環境,並指定要自動同步的文章類型;「Push」則可以選擇全部同步,或是指定特定的文章編號,也支援用 CSV 或 JSON 格式批次匯入。
建議剛開始先從範圍小、內容確定正確的類型下手,例如常見問答頁、政策頁這類內容變動少、答案又相對明確的類型,確認回答品質沒問題之後再逐步擴大範圍,而不是一次把全站所有文章都倒進去。這樣做的風險是,一旦回答出了問題,連是哪一篇內容造成的都難以排查。
另外要記得,同步是在背景逐步處理的,不會馬上完成。AI Engine 官方文件寫明,建立或同步 embeddings 可能需要幾分鐘到幾個小時,處理中的項目會顯示 PENDING 狀態,得等它跑完才能看到完整的索引結果。
把知識庫指派給聊天機器人,回答才會真的查得到
索引建好只完成一半,還有一個關鍵動作最容易被忽略,那就是要到聊天機器人的設定裡,把這個知識庫環境指派給它,對話系統才會真的去查索引找答案。這一步沒做,即使索引已經建好、內容也都同步完成,機器人回答的方式也不會有任何改變,很容易讓人誤以為剛才那些設定沒有生效,其實只是漏了指派這個步驟。
AI Engine 的官方教學說明,把 embeddings 環境指派給聊天機器人之後,系統會在相關的對話裡,自動帶入知識庫查詢到的結果來組成回答。換句話說,索引、同步、指派這三個步驟缺一不可,少了任何一步,前面做的準備都等於白費。
正式上線前,先用常見問題測試知識庫的涵蓋度
設定完不代表可以直接上線,得先拿幾個具體問題去測試,而且要挑「網站上真的寫過,但泛用型 AI 答不出來」的那種問題,像是退換貨的實際天數、特定商品的規格數字、營業時間的最新異動。這幾類問題有一個共同點,答案都是網站自己的資訊,不是模型出廠時就知道的通則,拿來測最能看出知識庫有沒有真的接上。
如果機器人能準確帶出網站原文的說法,才算真的接上知識庫。如果測出來的答案還是模糊帶過,或者停留在過時的資訊,得回頭檢查兩件事:第一,是不是那篇內容根本沒被同步進索引範圍;第二,是不是索引還在背景處理中還沒完成。前面提過同步需要時間,處理中的項目會顯示 PENDING 狀態,遇到這種情況,等處理完成之後再測一次即可,不必急著懷疑設定本身出了問題。
自動同步沒涵蓋到的內容,得自己記得手動更新
知識庫不是建一次就永久有效。網站內容一旦改版,像是政策調整、營業時間變動、商品下架,如果索引沒有跟著更新,客服機器人會繼續拿舊資料回答,反而變成一個新的錯誤來源,而且訪客不容易發現這個答案已經過時。
要注意這件事,做法有兩層。第一層是確認自動同步有沒有真的涵蓋到常常異動的內容類型,像是公告、政策頁這類本來就會頻繁更新的頁面。第二層是,沒有開啟自動同步的內容,改完之後要記得手動重新同步,不能假設它會自己更新。
這也呼應前面提過的單一事實來源原則,如果舊文章改版之後沒有一併下架或修正,索引裡可能同時存在新舊兩個版本,機器人在檢索時仍有機率挑到舊的那一份來回答,新版本反而沒被用上。維護階段要處理的,正是把這種新舊並存的情況清乾淨,而不是只在第一次建索引時整理過就算數。
自訂 GPT 手動上傳資料,外掛知識庫直接讀網站文章
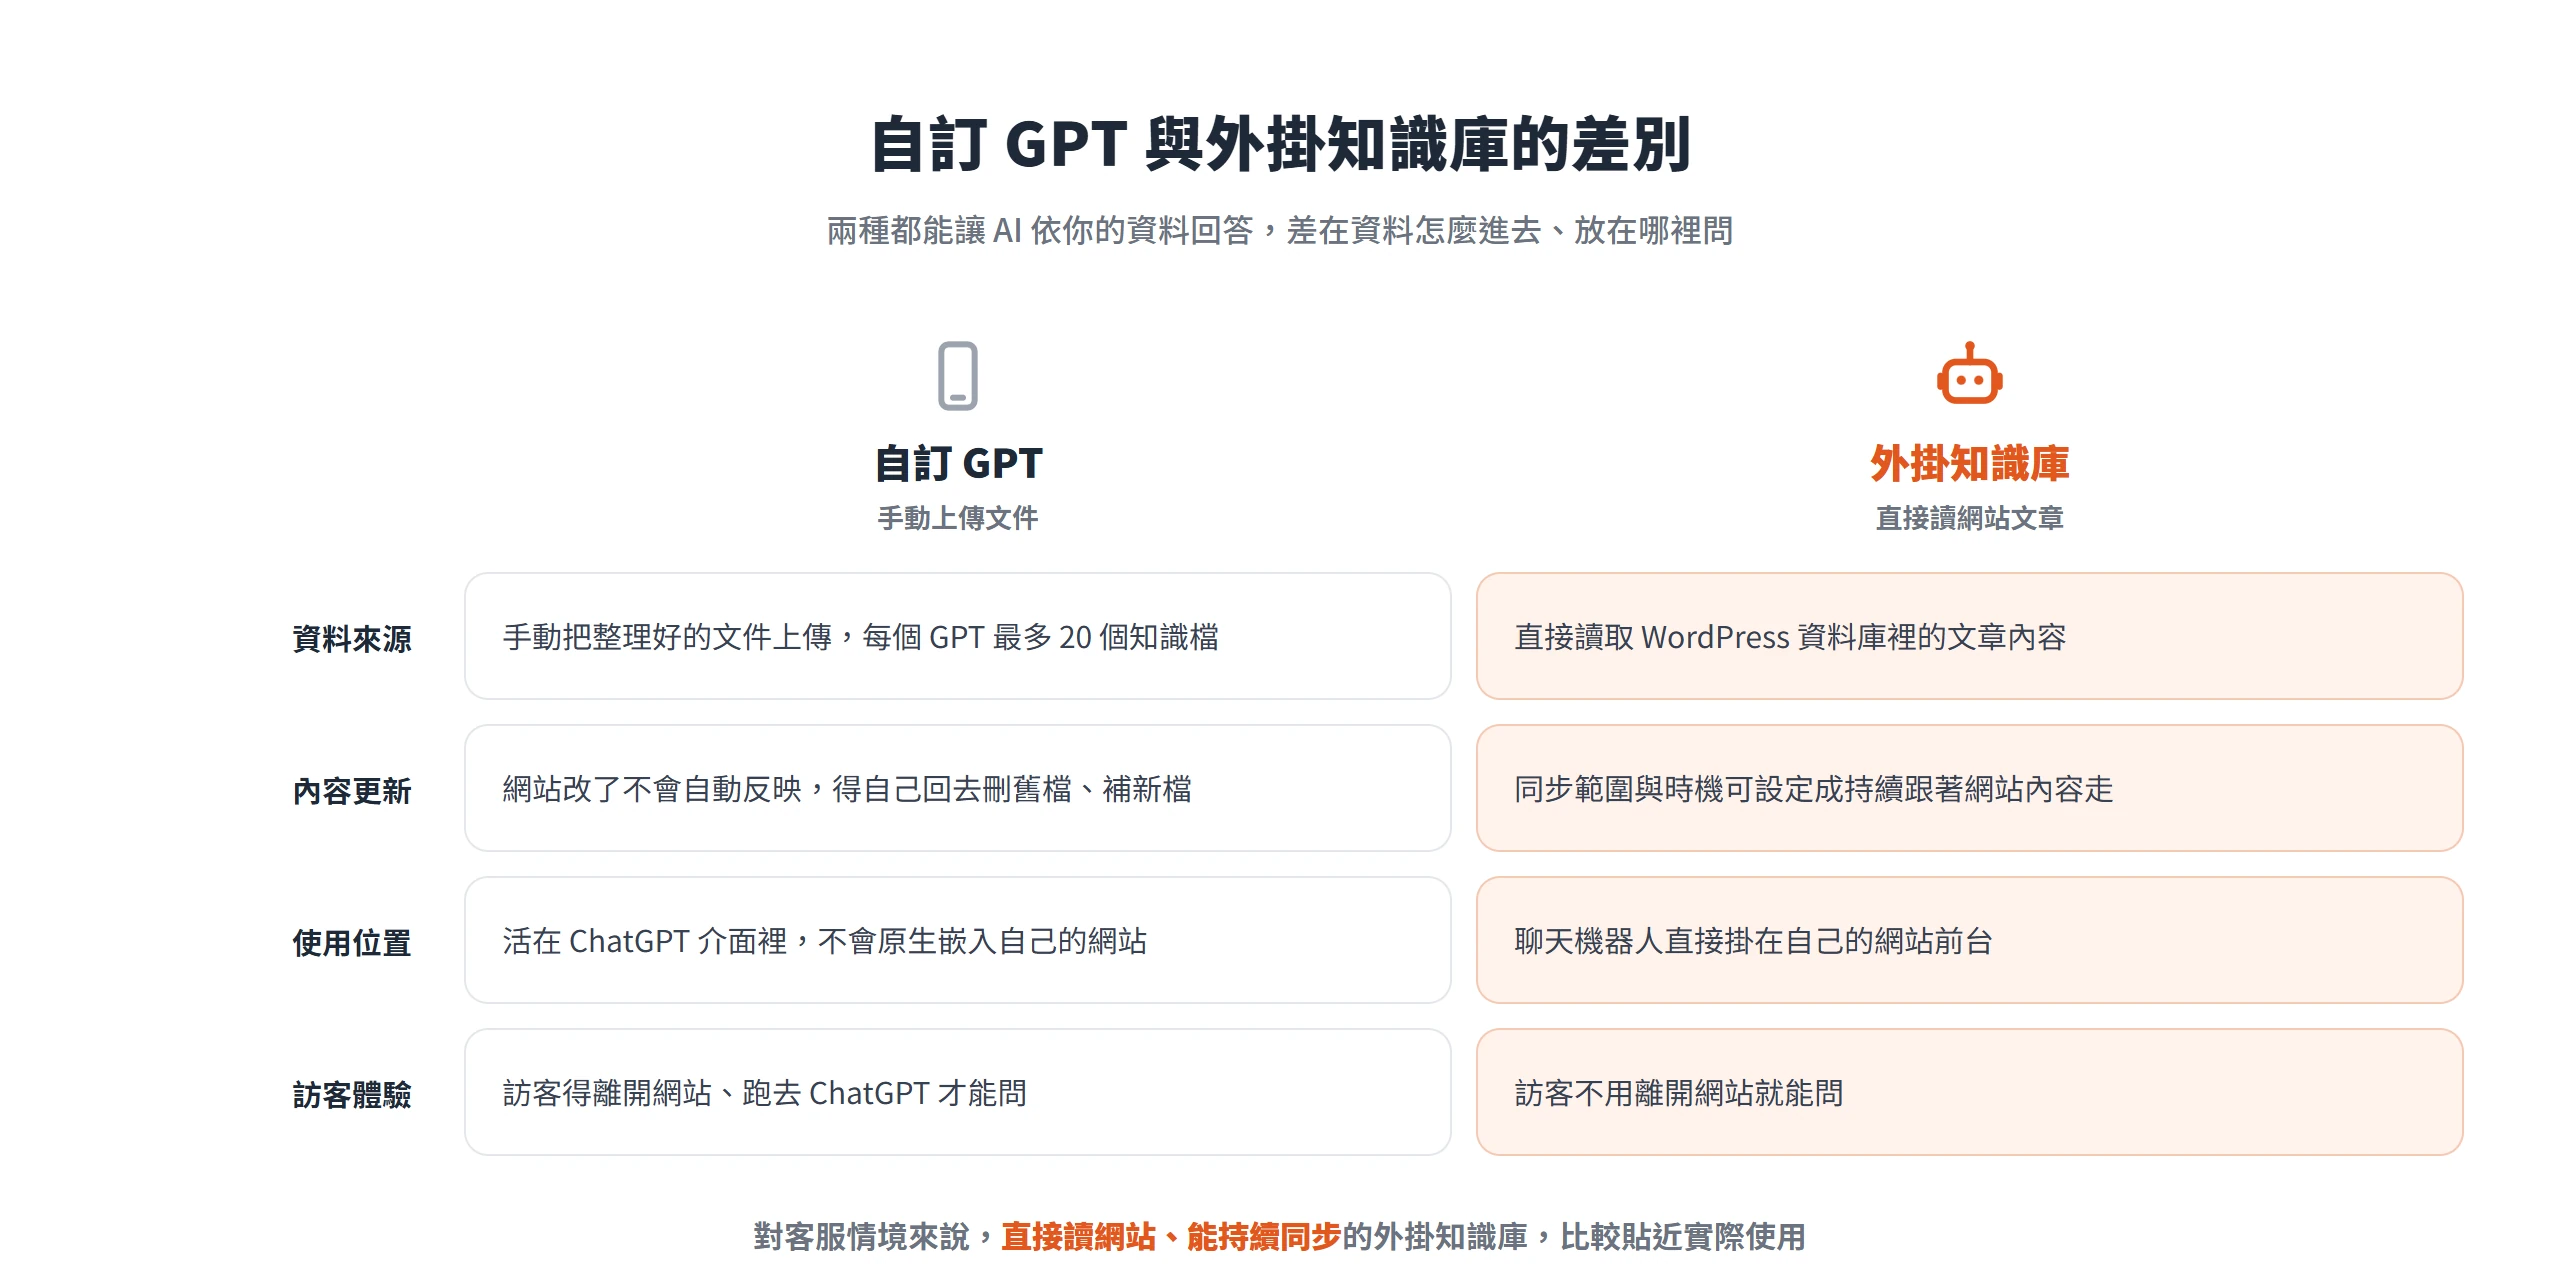
外掛內建知識庫還有另一種常見的替代做法:ChatGPT 的自訂 GPT。自訂 GPT 是把整理好的文件手動上傳到 OpenAI 的知識檔案區,數量與大小都有限制。OpenAI 官方的 File Uploads FAQ 說明,每一個自訂 GPT 在它的生命週期內,最多可以上傳 20 個知識檔案,單一檔案的大小上限是 512MB,文字或文件類的檔案則有 200 萬(2M)token 的上限,上傳的知識檔案會被保留,直到這個自訂 GPT 被刪除為止。
這種做法的問題在於,網站內容改了之後不會自動反映到自訂 GPT 裡,得自己記得回去刪掉舊檔案、補上新檔案,等於多了一份要另外維護的資料。外掛知識庫的做法不同,它直接讀取 WordPress 資料庫裡的文章內容,同步的範圍與時機可以設定成持續跟著網站內容走,不需要另外準備一份專門拿來上傳的文件。
自訂 GPT 是活在 ChatGPT 介面裡的助理,通常不會原生嵌入在自己的網站上,訪客得離開網站、跑去 ChatGPT 才能問。外掛做出來的聊天機器人則是直接掛在網站前台,訪客不用離開網站就能問,這對客服情境來說是比較貼近實際使用情境的做法。
接上 WordPress AI 知識庫之後,客服機器人回答的不再是模型自己猜的通則,而是網站上真正寫過的內容,退換貨天數、營業時間異動這類具體問題,訪客得到的答案才會跟網站原文對得上。剩下要注意的,是把它當成一項要持續維護的工作,不是設定一次就能放著不管的開關;內容改版、政策更新,索引也要跟著動,答案才會一直站得住腳。