
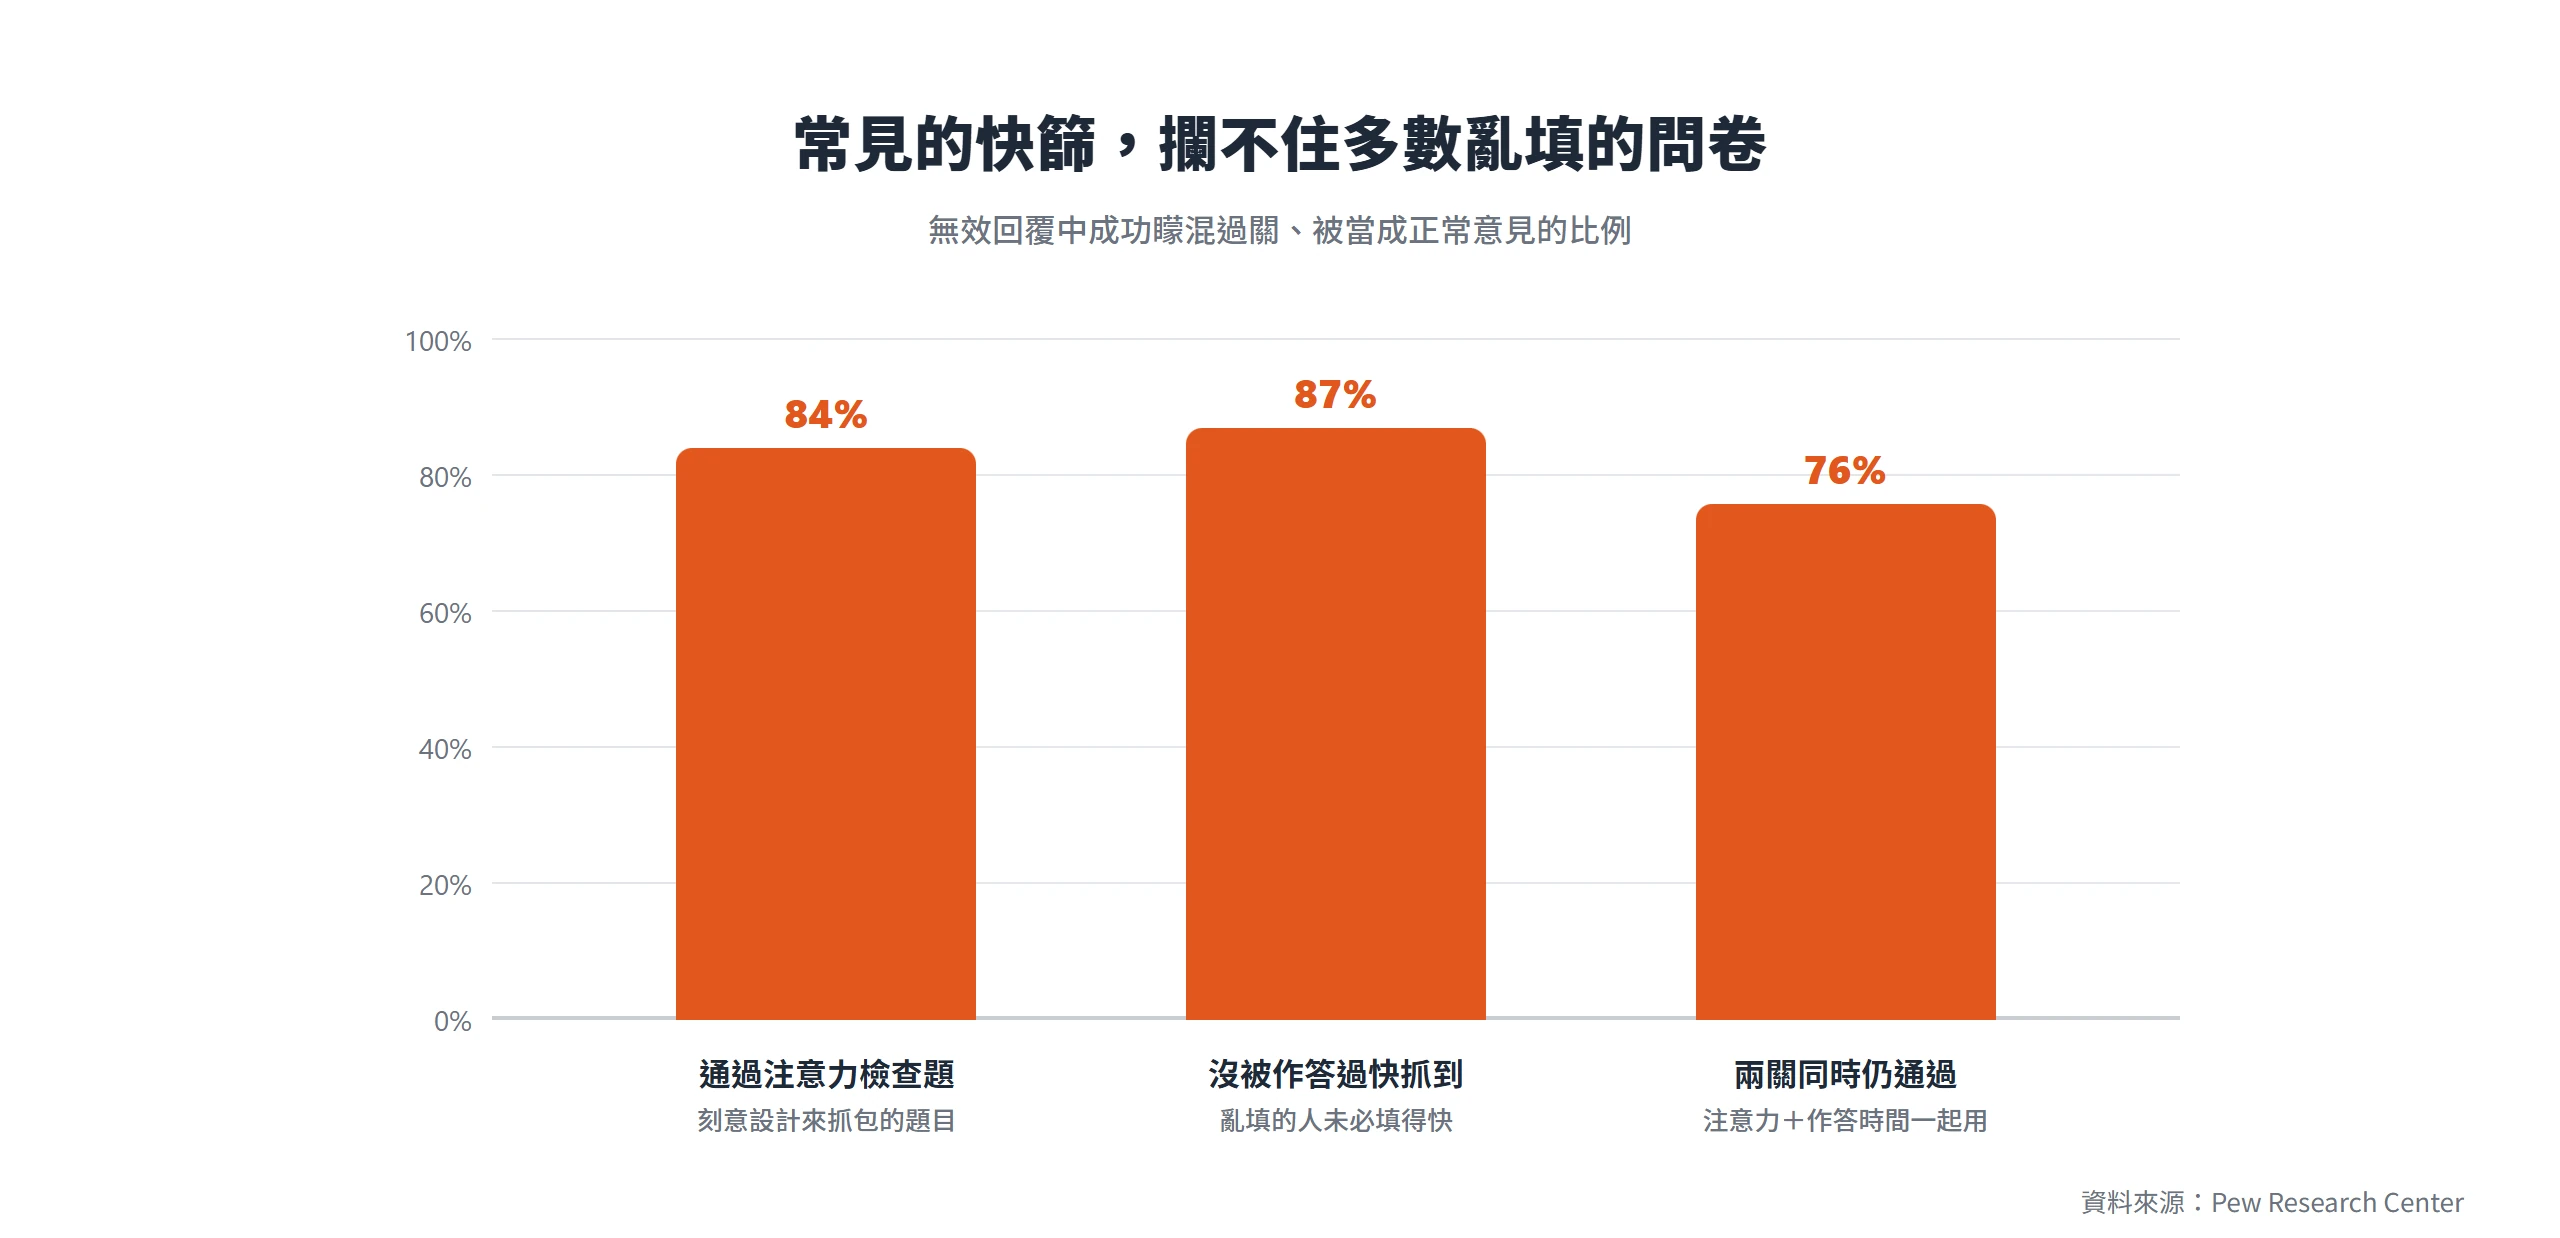
顧客問卷收回來,看起來規規矩矩的答案裡,藏著一群根本沒認真作答的人,而且抓不到。Pew Research Center 分析超過六萬份線上問卷回覆後發現,那些後來被判定為無效的回覆裡,高達 84% 早就通過了問卷裡專門設計來抓包的注意力檢查題。也就是說,單靠這一招,十份亂填的問卷裡只抓得到一份多一點,其餘的全部溜走,還被當成正常意見算進統計。
顧客問卷調查(Customer Survey)的價值,本來就建立在顧客願意說真話這個前提上。市場研究機構 Qualtrics 把問卷定位成企業少數能主動詢問顧客偏好、行為、喜好與人口輪廓的管道,藉此打造更貼合需求的產品與服務。但同一份資料也提醒,這份價值同時伴隨風險,資料公不公正、準不準,取決於題目本身中不中立、樣本夠不夠廣。換句話說,一份問卷做得好不好,不是看題目做得多漂亮、回收了多少份,而是看設計者有沒有把顧客可能給假答案這件事放在心上,從題目怎麼問、問誰、什麼時候問,到收回來又怎麼判斷可信度,每個環節都要注意。
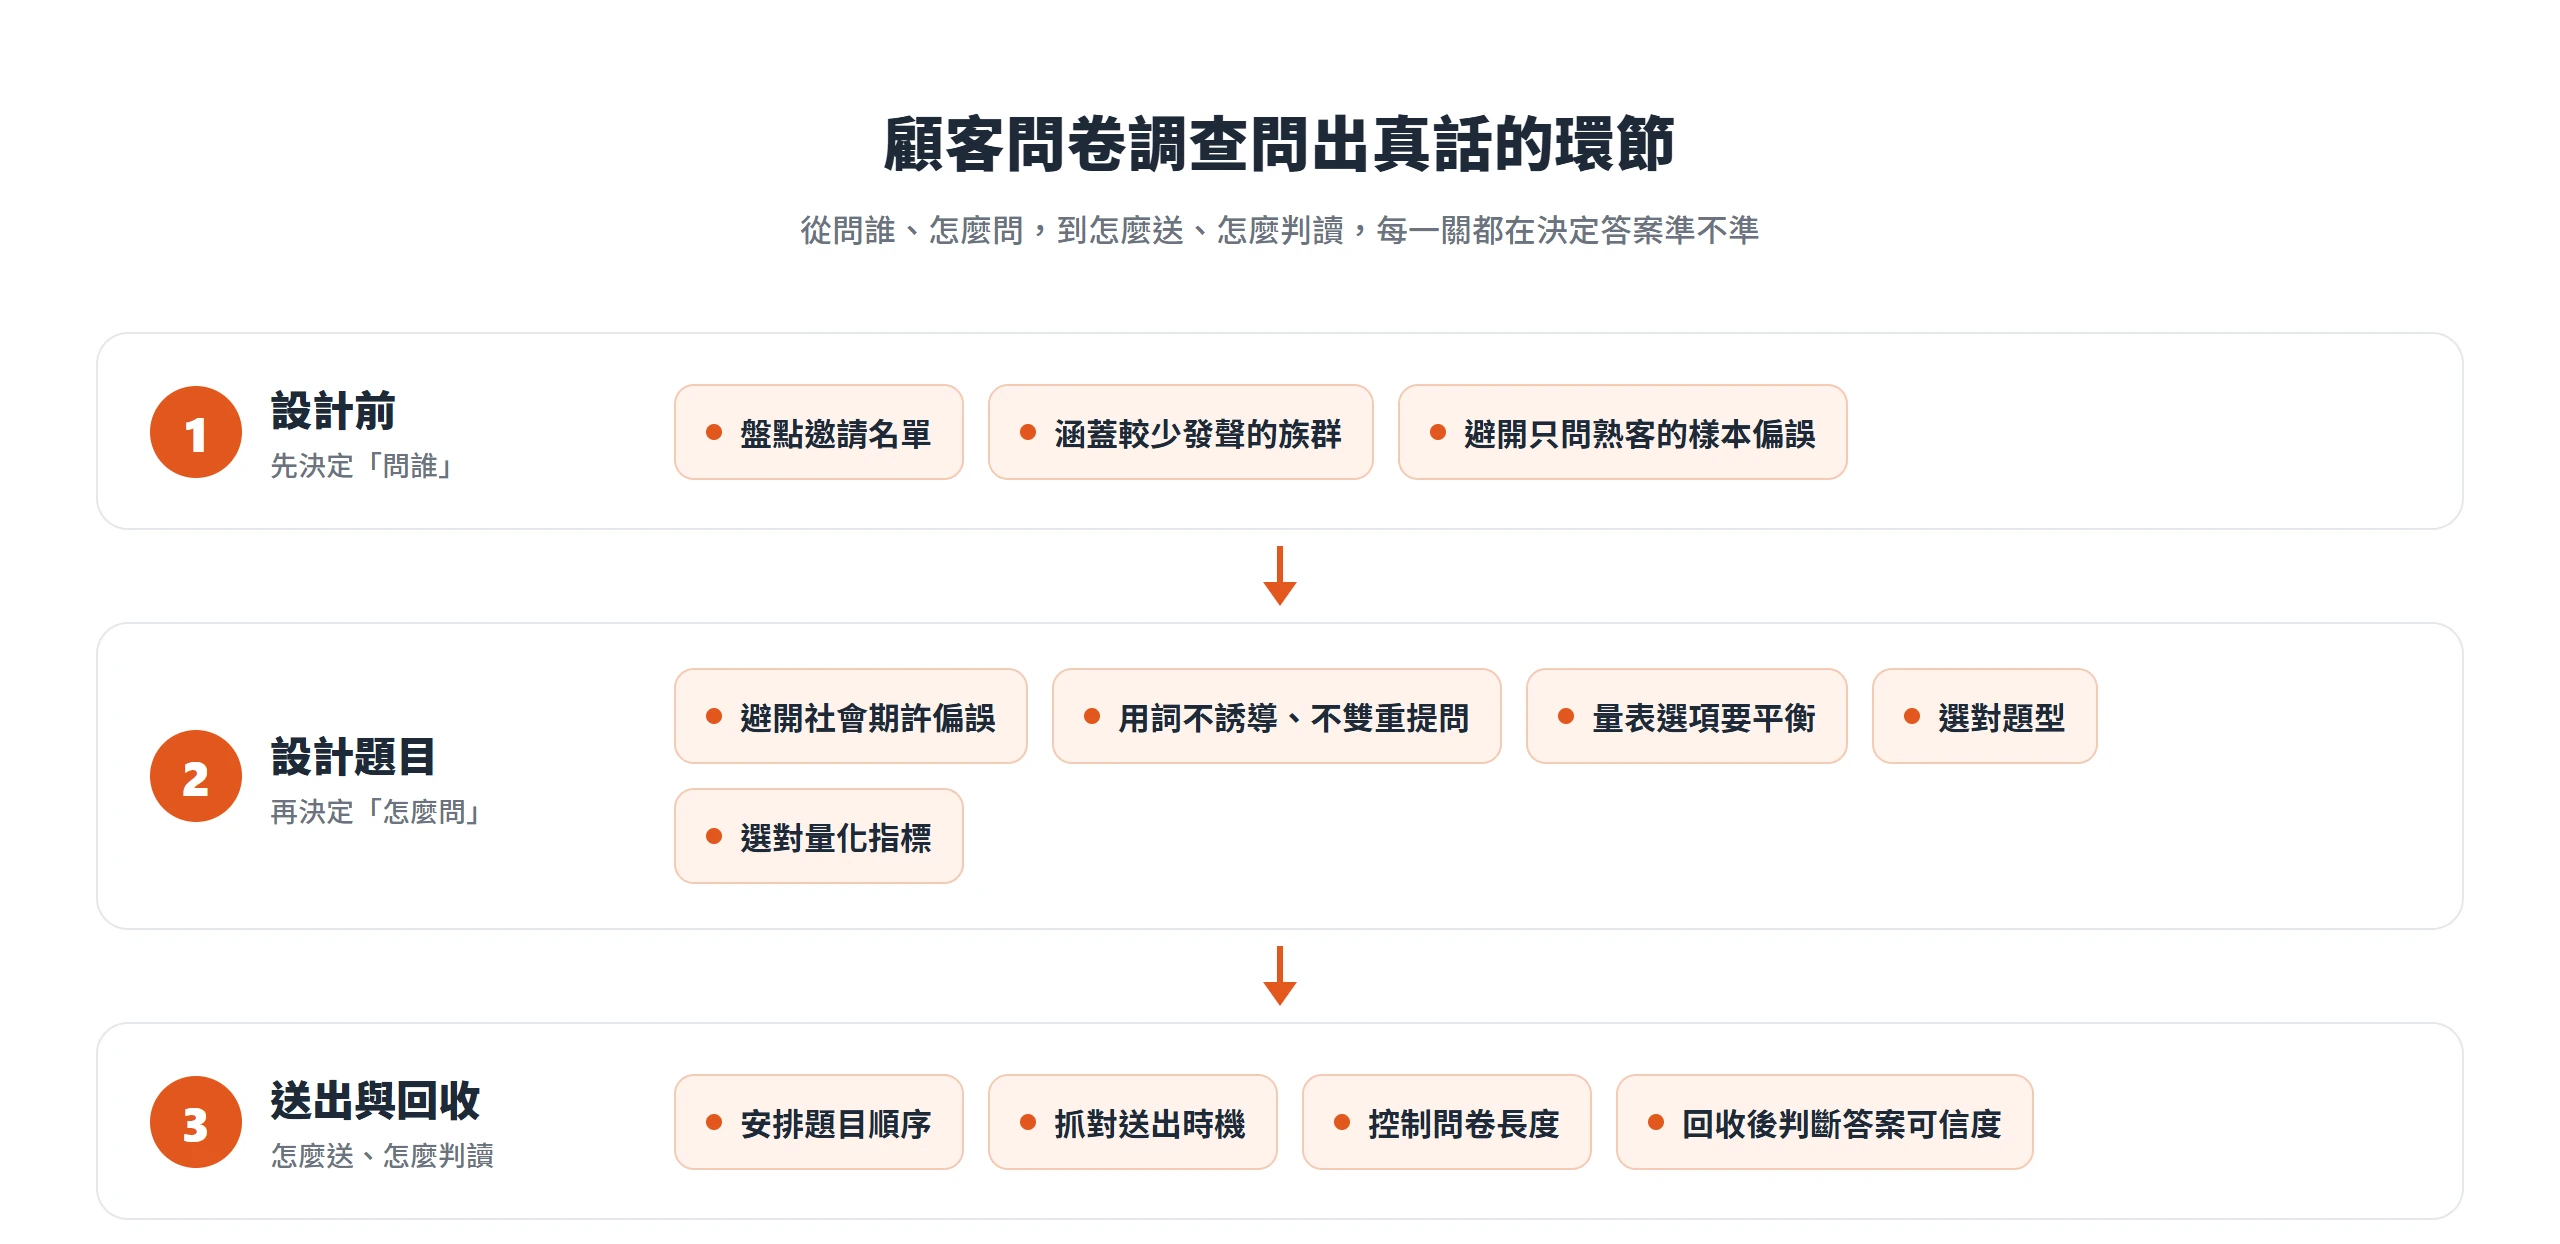
顧客願不願意說真話,牽涉的環節其實很多。樣本找對了沒、用詞有沒有誘導、量表怎麼設計、題目排在哪個順位,一路到收回來後怎麼判斷這份答案可不可信,每一關都可能悄悄讓答案偏離顧客心裡真正的想法。先從最根本的定位問題講起,顧客問卷跟後台的行為數據,該分別回答什麼問題。
行為數據看得到動作,問卷才問得到顧客心裡的原因
後台報表看得到顧客在哪一步放棄結帳、在哪個頁面停留最久、跳出率是多少,這些是行為數據能給的答案,精準,卻只停留在顧客做了什麼。它答不出為什麼。同一組顧客,可能因為運費太貴而放棄結帳,也可能因為找不到退換貨資訊而放棄結帳,行為紀錄看起來一模一樣,原因卻天差地遠。要分辨兩者,唯一的辦法就是直接開口問。
顧客問卷調查因此扮演的是行為數據補不上的那一塊,它能問的是原因、想法、偏好之間怎麼取捨,是後台報表推敲不出來的東西。Qualtrics 對問卷角色的定位也點出這一點,市場研究與問卷能提供的是顧客偏好、行為背後的想法、喜惡、收入與人口統計等資訊,幫助企業打造更貼合需求的產品與服務。只是行為數據幾乎不會被問法污染,後台怎麼記錄跳出率,不會因為工程師的措辭而改變;問卷正好相反,它是一段主動出題的過程,問誰、怎麼問、什麼時候問,每個環節都可能讓答案偏離顧客心裡原本的想法。先從最容易被忽略的一關談起,回答問卷的人,夠不夠代表全部顧客。
主動填答的顧客,未必代表全部顧客的聲音
一份問卷回收了三百份,看起來樣本夠大、有代表性,但這三百個人是誰,才是真正決定答案準不準的關鍵。這在問卷方法學裡稱為樣本偏誤(selection bias),是問卷失真最根本的源頭,比後面要談的用詞、心理效應都更早發生,因為題目都還沒設計出來之前,樣本組成就已經定案。
Qualtrics 把選樣偏誤列為調查偏誤的第一類,判準是三個問題:樣本是怎麼選出來的、真正完成問卷的有多少人、這個樣本是不是廣泛到能捕捉到最有價值的洞察。只發給主動回覆意願高的既有顧客,例如常來的熟客、剛好在使用中的活躍會員,蒐集到的意見會結構性地偏向這群人;安靜的、正在流失的、不滿意到懶得填的顧客,聲音天生就進不了這份問卷。
樣本的代表性從邀請名單就開始決定
這也是為什麼,設計問卷該做的第一個決定,不是題目怎麼寫,而是這份問卷要發給誰。多數品牌經營者容易把順序顛倒,先把題目擬好,才想到樣本夠不夠廣,這時候名單早已定型,想補也補不回來。
常見的樣本盲點大致有三種:只問固定會回應的熟客、只問剛好在使用產品或服務當下的顧客、只問留過聯絡方式的顧客。這三種名單湊出來的樣本,看起來人數不少,結構卻高度相似,都是比較願意跟品牌互動的那一群。設計問卷前,不妨先盤點手上的邀請名單,包括新舊顧客的比例、消費金額的分布、顧客來自哪些通路,盡量讓名單覆蓋到平常較少發聲的族群,而不是等問卷做完,才發現結果只反映了最活躍的那一小群人。
樣本選對了,只解決問誰這一半的問題;剩下的一半是,就算問對了人,顧客的回答本身也不見得完全誠實。
社會期許偏誤讓顧客把答案修飾得更討喜
顧客填問卷時,心裡除了誠實作答,通常還有另一個念頭,不想讓自己看起來很差。這個念頭不是刻意說謊,而是一種下意識的自我修飾,在問卷方法學裡稱為社會期許偏誤(social desirability bias)。就算問題問得完全中立,顧客的答案也可能悄悄往讓自己看起來更理性、更負責的方向偏移。
中央研究院人文社會科學研究中心調查研究專題中心典藏的一份研究計畫,主題正是社會期許偏誤的探討與防治,對這個現象的機制講得清楚,受訪者在自填問卷時,為了讓自己顯得符合社會期望,會用不完全真實的意願取代真正的意願作答。就算問卷完全匿名,受訪者仍會下意識調整答案,以維持自己是個理性、負責任的消費者這種自我形象,而且這個傾向不是少數個案,會系統性地拉動整份問卷的平均結果。
值得留意的是,匿名並不能讓這個偏誤消失,只能降低一部分程度。真正容易觸發的,是那些牽涉到顧客自我評價的題目,例如你有仔細比較過其他品牌嗎、你會不會衝動消費,這類問題本身就帶著一個社會標準答案,貨比三家是精明的、衝動消費是不理性的,顧客很難不往那個方向靠。設計這類題目時,與其直接問顧客有沒有仔細比較過,不如換成描述具體行為的問法,例如問顧客上一次購買前花了多久時間做比較,讓答案落在事實而不是自我評價上,顧客也比較不需要靠修飾答案來維護形象。
心理層面的偏誤很難完全消除,但另一種偏誤反而完全握在設計者手裡,題目怎麼寫,本身就可能先幫顧客定好了答案。
用詞裡的誘導和雙重提問
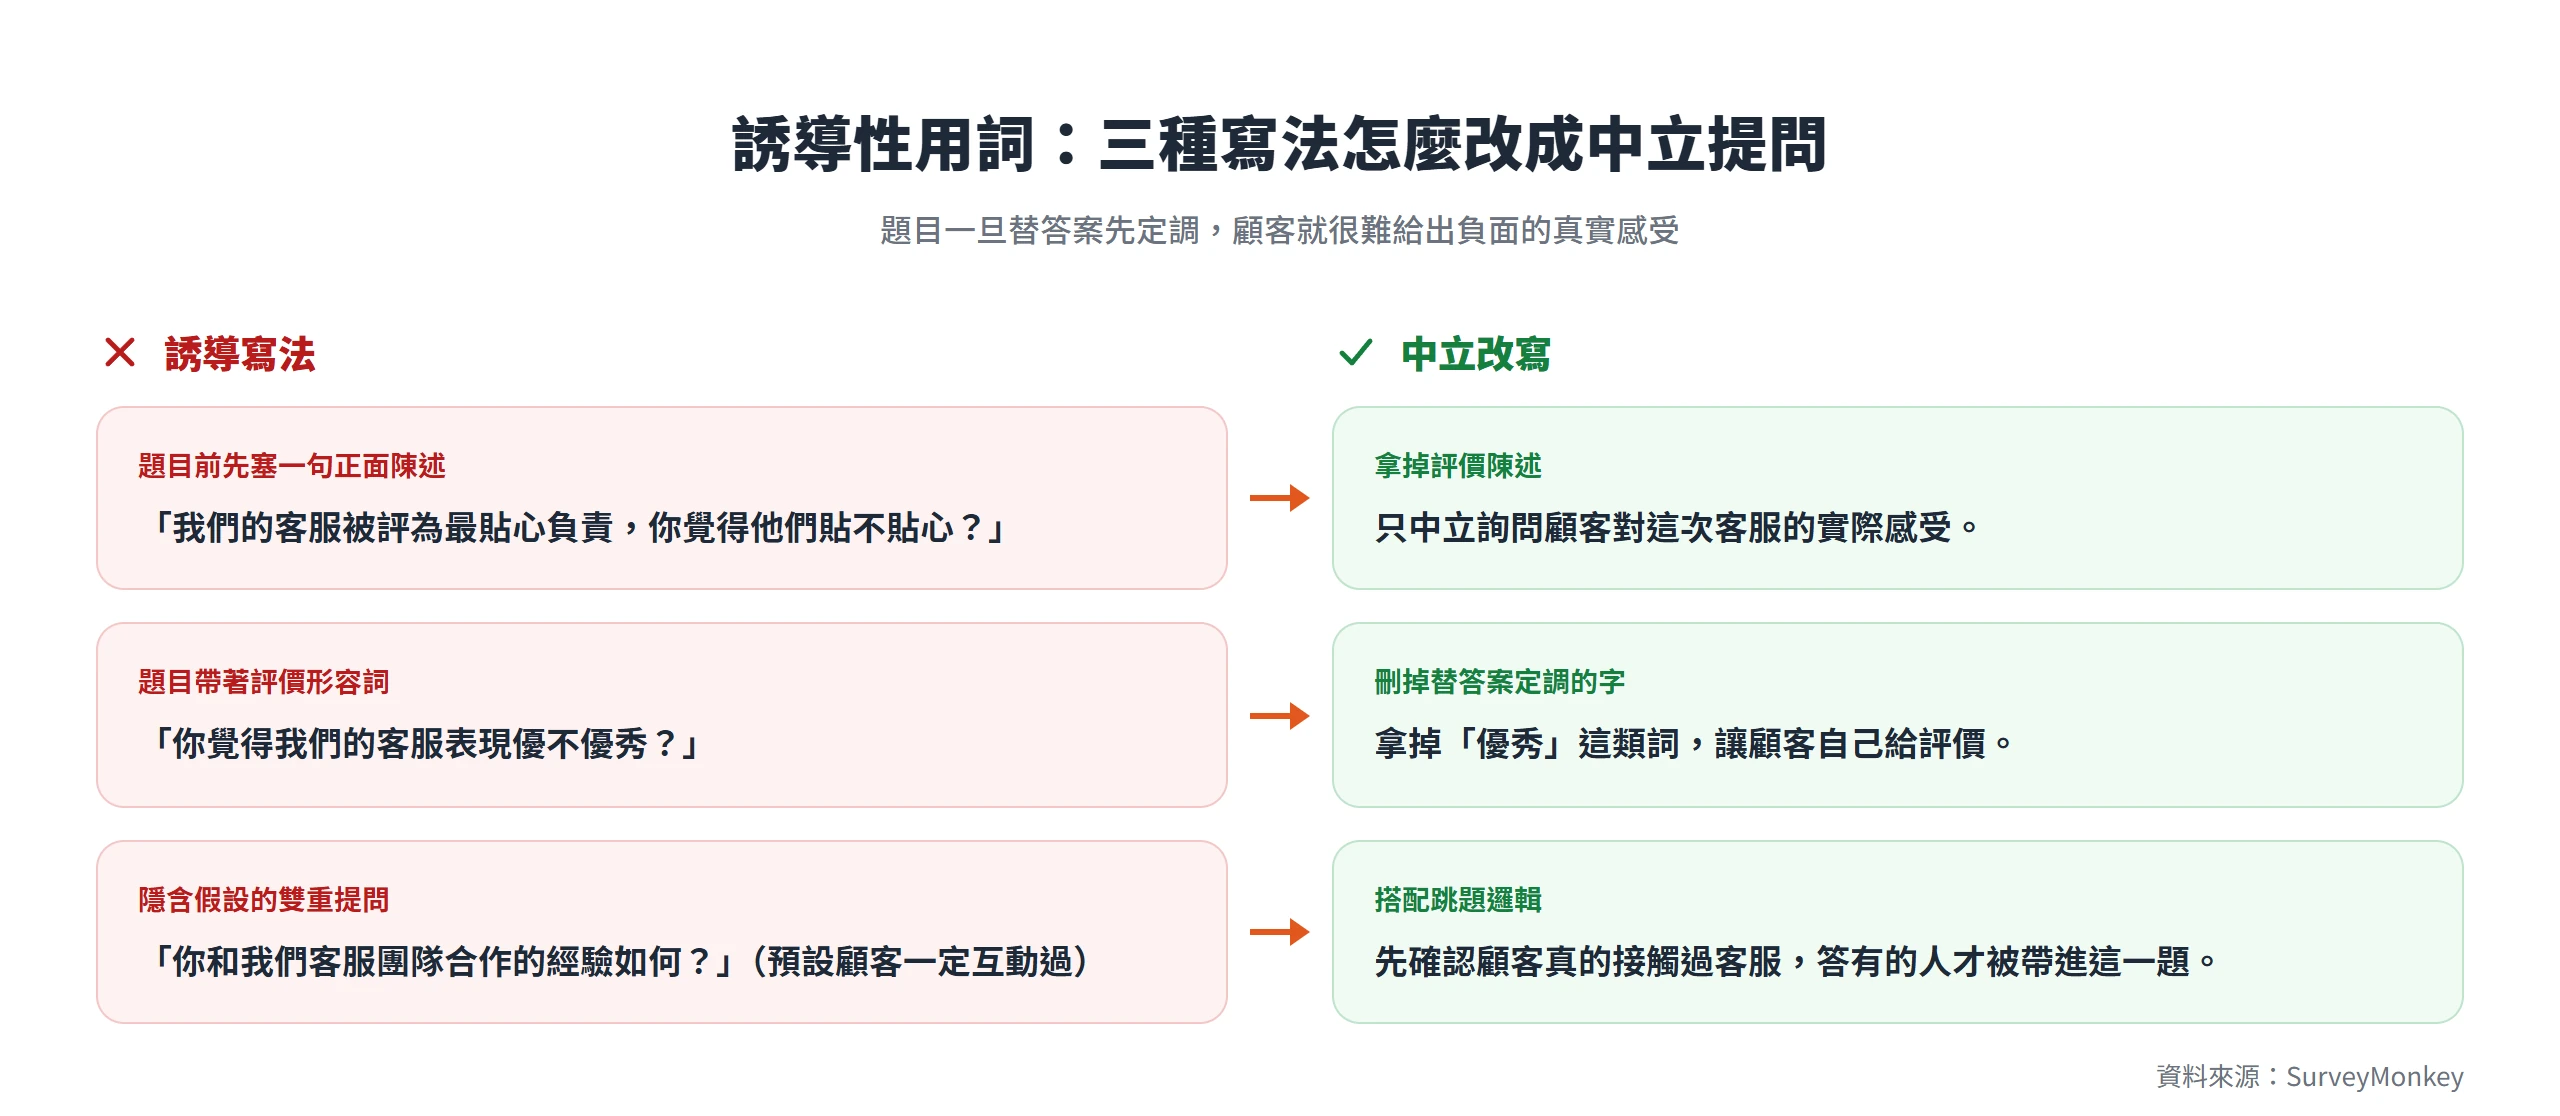
我們的客服團隊在業界被評為最貼心負責,你覺得他們貼不貼心。這句題目乍看只是想問顧客對客服的感受,實際上在提問之前就先塞進一句未經驗證的正面陳述,顧客幾乎很難在這個前提下給出負面答案。這就是誘導性用詞最典型的寫法,SurveyMonkey 官方指南就把這句拿來當反面示範。
另一種更隱蔽的誘導,是題目本身帶著評價性的形容詞。同一份指南舉的另一個例子是你覺得我們的客服表現優不優秀,問題裡的優秀一詞,已經先幫答案定了調,顧客要嘛附和,要嘛得費力反駁這個預設。要抓出這類問題,SurveyMonkey 建議的自我檢查方式很簡單,讀一次自己寫的題目,圈出裡面任何反映提問者自己意見或立場的字詞,能刪就刪;同時也要檢查題目裡有沒有不必要的修飾詞,例如稱某個選項最新、最受歡迎,這類詞本身就會影響顧客的作答方向。
藏在雙重提問裡的假設,逼顧客答一個不存在的經驗
誘導性用詞還有一種更難察覺的變形,藏在雙重提問與假設性提問裡。SurveyMonkey 同一份指南把你和我們客服團隊合作的經驗如何這句列為隱含假設的問法,它預設顧客一定合作過,而且已經有明確的經驗可以描述。顧客即使根本沒有正面感受,甚至從來沒跟客服互動過,也會被題目結構逼著擠出一個答案,因為題目沒有給沒有經驗這條路可以選。
改善方式並不難,先確認題目本身有沒有做出任何未經確認的假設;如果題目確實帶有假設,就得搭配跳題邏輯(skip logic),先用一題確認顧客真的有過這段經驗,答案是有的人才會被帶進下一題,答案是沒有的人則自動跳過,不會被逼著硬答一個不存在的經驗。
誘導藏在文字裡不容易發現,選項設計裡的誘導更容易被忽略,因為看起來只是幾個中性的選字。
失衡的量表選項預先框定了回答方向
量表選項如果偏向正面,答案在顧客動筆之前就已經被引導了。最常見的失衡例子是選項只設滿意、非常滿意、極度滿意,完全沒有對等的負面選項,顧客就算真的不滿意,也只能在沒那麼滿意和滿意之間硬選一個相對正面的答案,結果整份問卷回收回來,滿意度看起來永遠偏高。
這背後牽涉到另一個常見的心理傾向,默許偏誤(acquiescence bias),也就是顧客傾向一路選同意或偏正面的那一端,不太願意選擇偏負面的選項。Qualtrics 對回應偏誤的緩解建議是,平衡量表要讓正負面選項對稱、保留有意義的中性選項;如果發現顧客持續給出偏正面的答案,可以改用不鼓勵無腦附和的選項排列,例如把量表設計成絕對不會、大概不會、不確定、大概會、絕對會,這種需要顧客主動判斷方向的選項組合,比單純的同意、不同意二選一更能反映真實態度。
題目的用詞和選項的平衡度拿捏好之後,接下來要決定的是題型本身,封閉題、量表題、開放題,各自能挖到的資訊深淺不同。
封閉題、量表題與開放題取得的資訊深淺不同
封閉題(單選、複選)填答速度快,顧客只要點一下就能作答,但拿到的資訊也最淺,只能知道顧客選了哪一個,不知道為什麼選它。量表題往前推進一步,能把顧客的態度量化成強弱程度,方便跨顧客比較,但終究還是把答案框在幾個固定選項裡。真正貼近顧客原始想法的是開放題,顧客用自己的話回答,設計者事先設想不到的問題,常常就是從這裡冒出來的。
這三種題型沒有絕對的優劣,只看這一題想拿到什麼層次的資訊。需要快速分類、之後拿去做統計的,用封閉題;想測量態度強弱、方便比較的,用量表題;想聽到顧客自己的用詞、發現沒預期到的問題,才值得用開放題。開放題雖然最貼近真話,填答的門檻卻也最高,這一點下面會拆得更細。先從用得最頻繁的量表題講起,它的級距該設多少點,不是每一題都套用同一種答案。
量表級距要對應測量目標而非統一設成五點
很多人設計量表題時,習慣不假思索地套用五點量表,從非常不滿意排到非常滿意。這個做法在測量滿意度時沒問題,但換成別的測量目標,五點未必是最適合的級距,量表該設幾點,要看這一題想測量的是什麼。
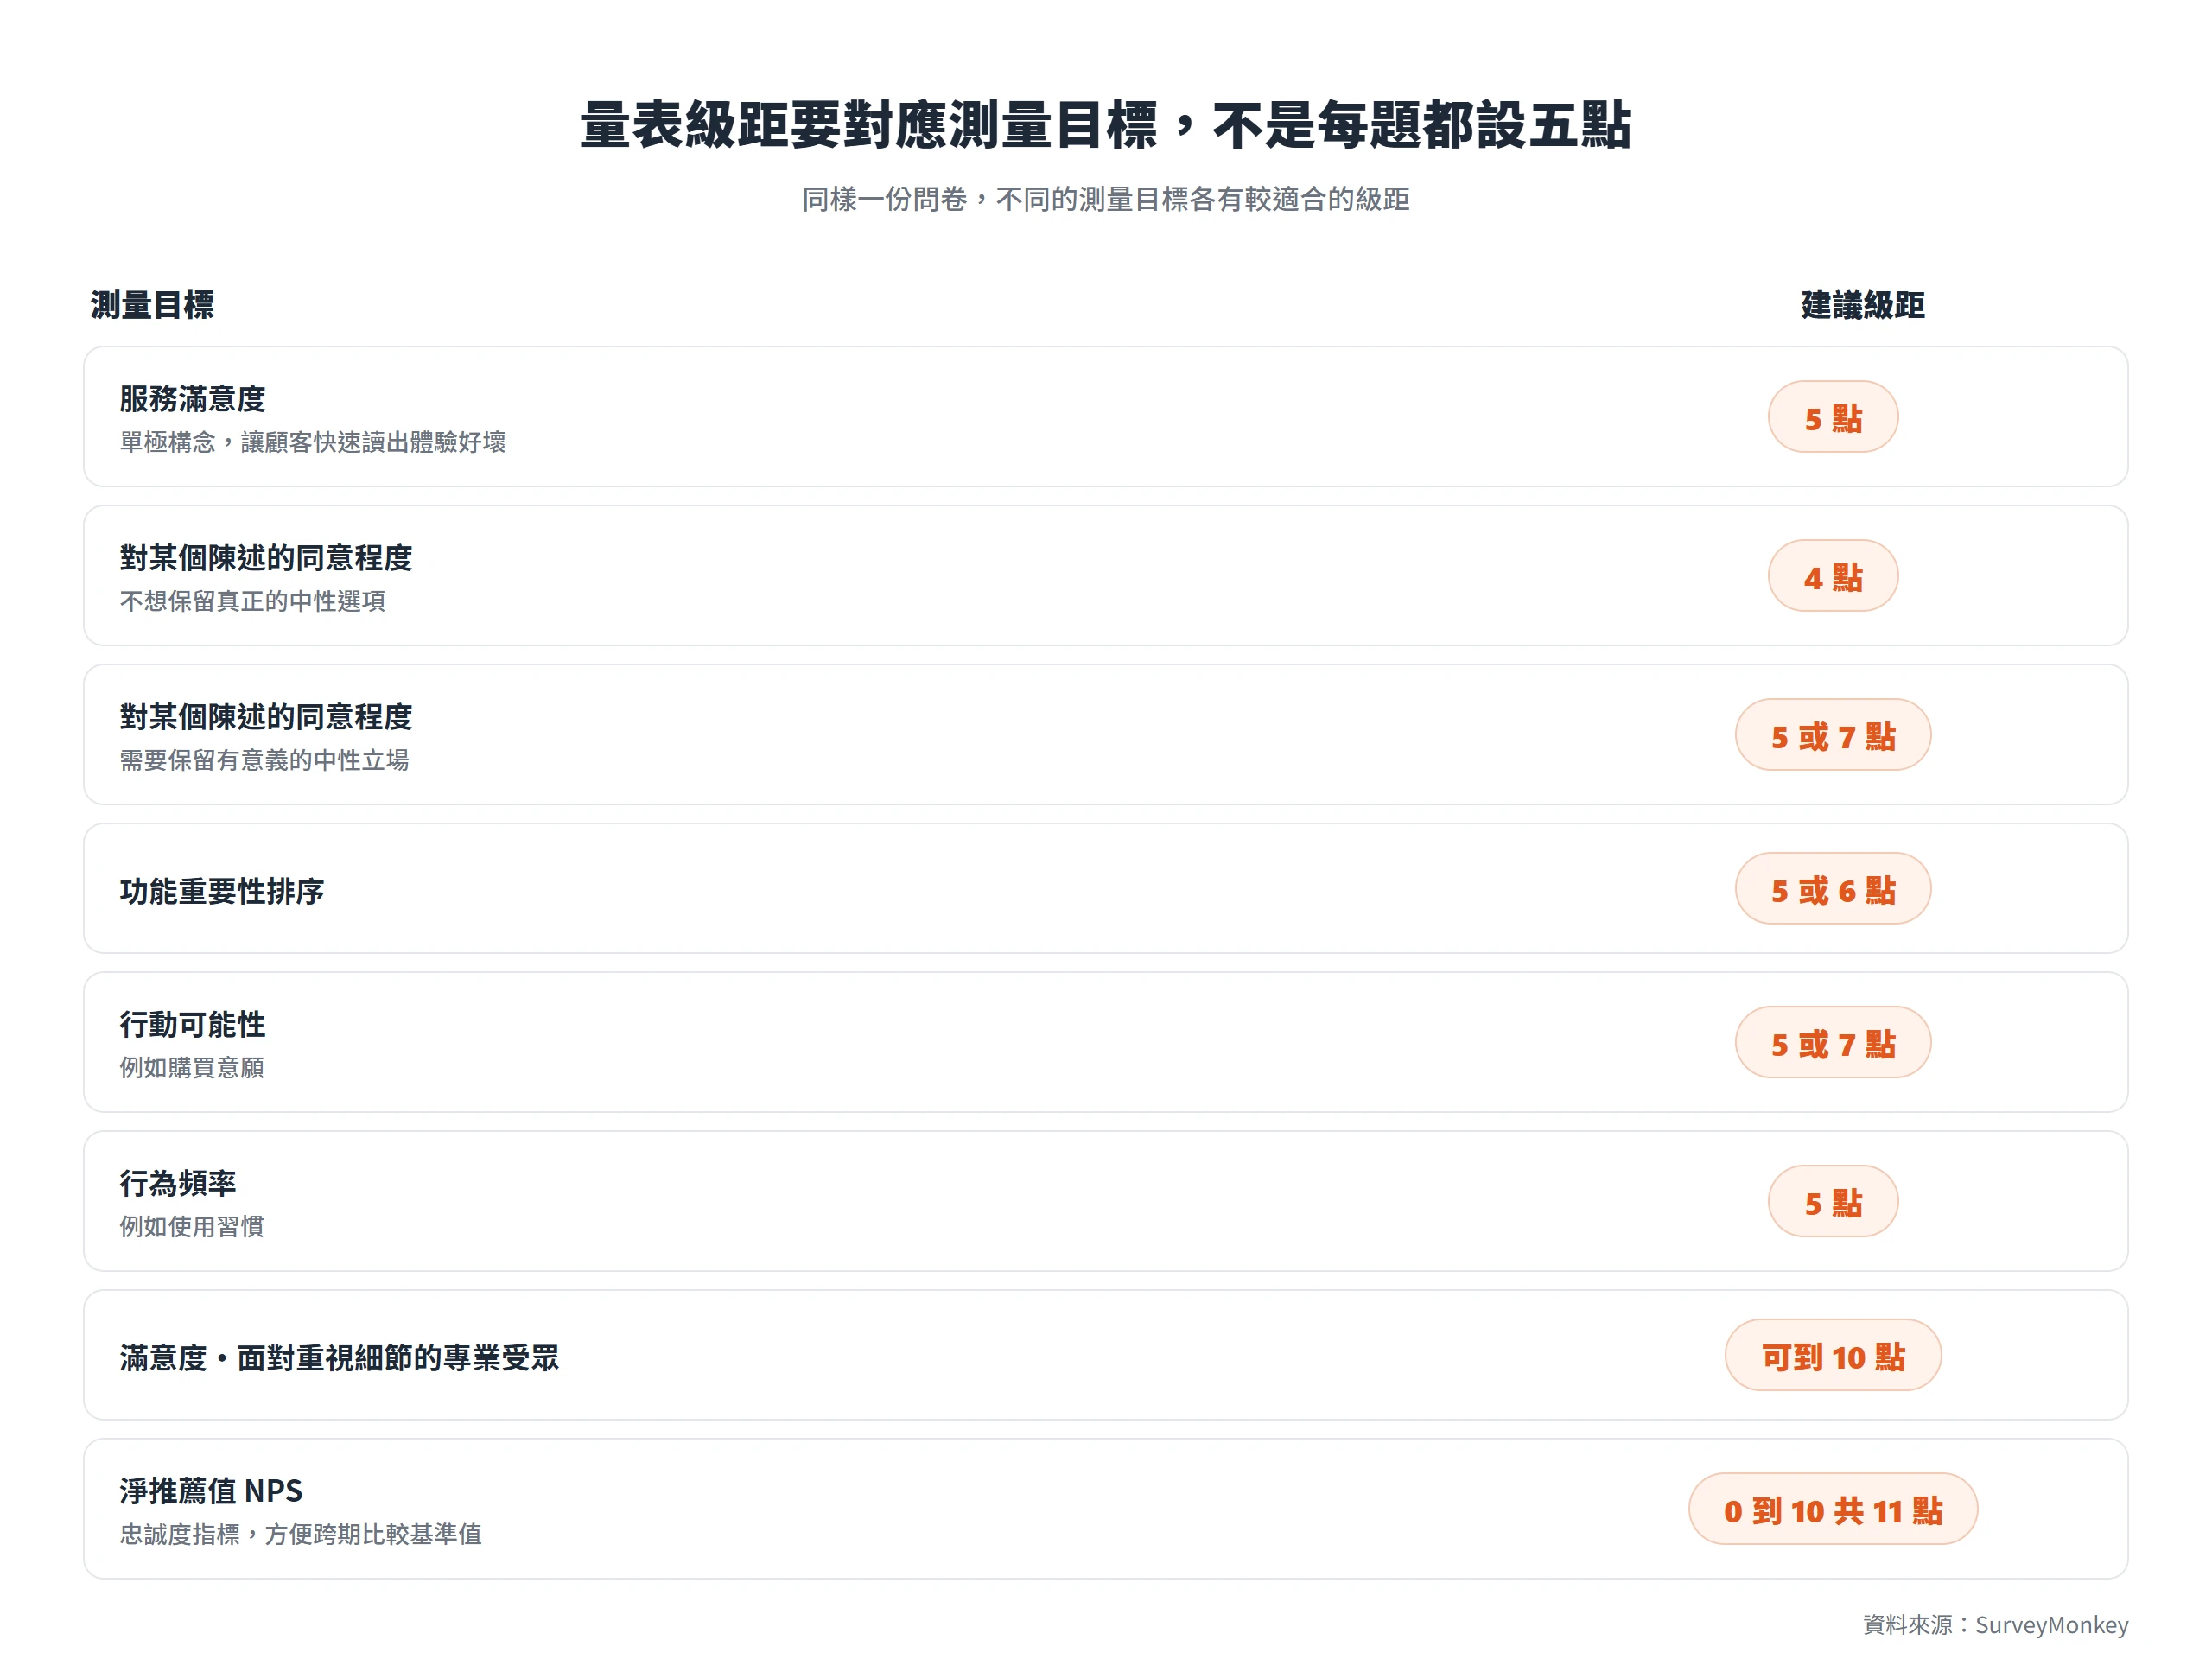
SurveyMonkey 官方指南依測量目標給出具體的建議級距。測量服務滿意度這種單極構念,建議 5 點,追求的是讓顧客能簡單快速地讀出體驗好壞;測量對某個陳述的同意程度,如果不想要真正的中性選項,建議用 4 點(偶數,強迫顧客選邊站),若同意程度需要保留有意義的中性立場,則建議 5 或 7 點;測量功能重要性排序,建議 5 或 6 點;測量行動可能性,例如購買意願,建議 5 或 7 點;測量行為頻率,例如使用習慣,建議 5 點;面對重視細節的專業受眾,滿意度甚至可以拉到 10 點;若是淨推薦值這種忠誠度指標,則固定用 0 到 10 共 11 點的數字量表,這樣才能跨期比較基準值。
至於奇數或偶數選項該怎麼選,其實判斷原則很直接。奇數量表保留一個中性選項,適合中立本身就是有意義、真實存在的答案時使用;偶數量表拿掉中點,是刻意設計成強迫選擇,逼顧客往正面或負面表態,但這個做法要謹慎使用,對真正抱持中立態度的顧客來說,被迫選邊反而會讓答案失真。
量表題的級距抓好了,接下來要處理的是另一個極端,開放題雖然最能問出真話,卻也是所有題型裡,顧客最容易中途放棄的一種。
開放題最誠實,卻也最容易被顧客中途放棄
開放題不設選項,顧客想寫什麼就寫什麼,是最能問到真實想法、也最容易發現設計者原本沒預期到的問題的題型。但它的門檻也最高,顧客得自己組織語言、打出完整的句子,比起封閉題點一下就能作答,開放題明顯更花力氣,填到一半放棄的機率也高出不少。
SurveyMonkey 官方針對完成率的研究提供了具體數字。問卷只放 1 題開放式問題時,完成率約 88%;放到 10 題開放式問題時,完成率降到約 78%,降幅達 10 個百分點,是所有題型中下滑最明顯的一種;矩陣式或評分表題目也有類似但較緩的下滑,1 題約 88%,10 題約 81%。同一份研究還發現,問卷第一題如果用選擇題開場,完成率約 89%,若第一題就用開放式問題開場,完成率則降到約 83%。
這組數字說明了兩件事。開放題不宜放在問卷最前面,顧客一翻開就要打字,還沒進入填答的節奏就先被勸退;整份問卷的開放題數量也要控制,精挑一兩題放在關鍵位置就好,不必每個問題都做成開放式,不然完成率會被拖著一路往下掉。
題型和級距都設計好之後,接下來要決定的是,這份問卷要拿哪個指標,回答什麼樣的決策問題。
滿意度、推薦意願、顧客費力度對應不同決策用途
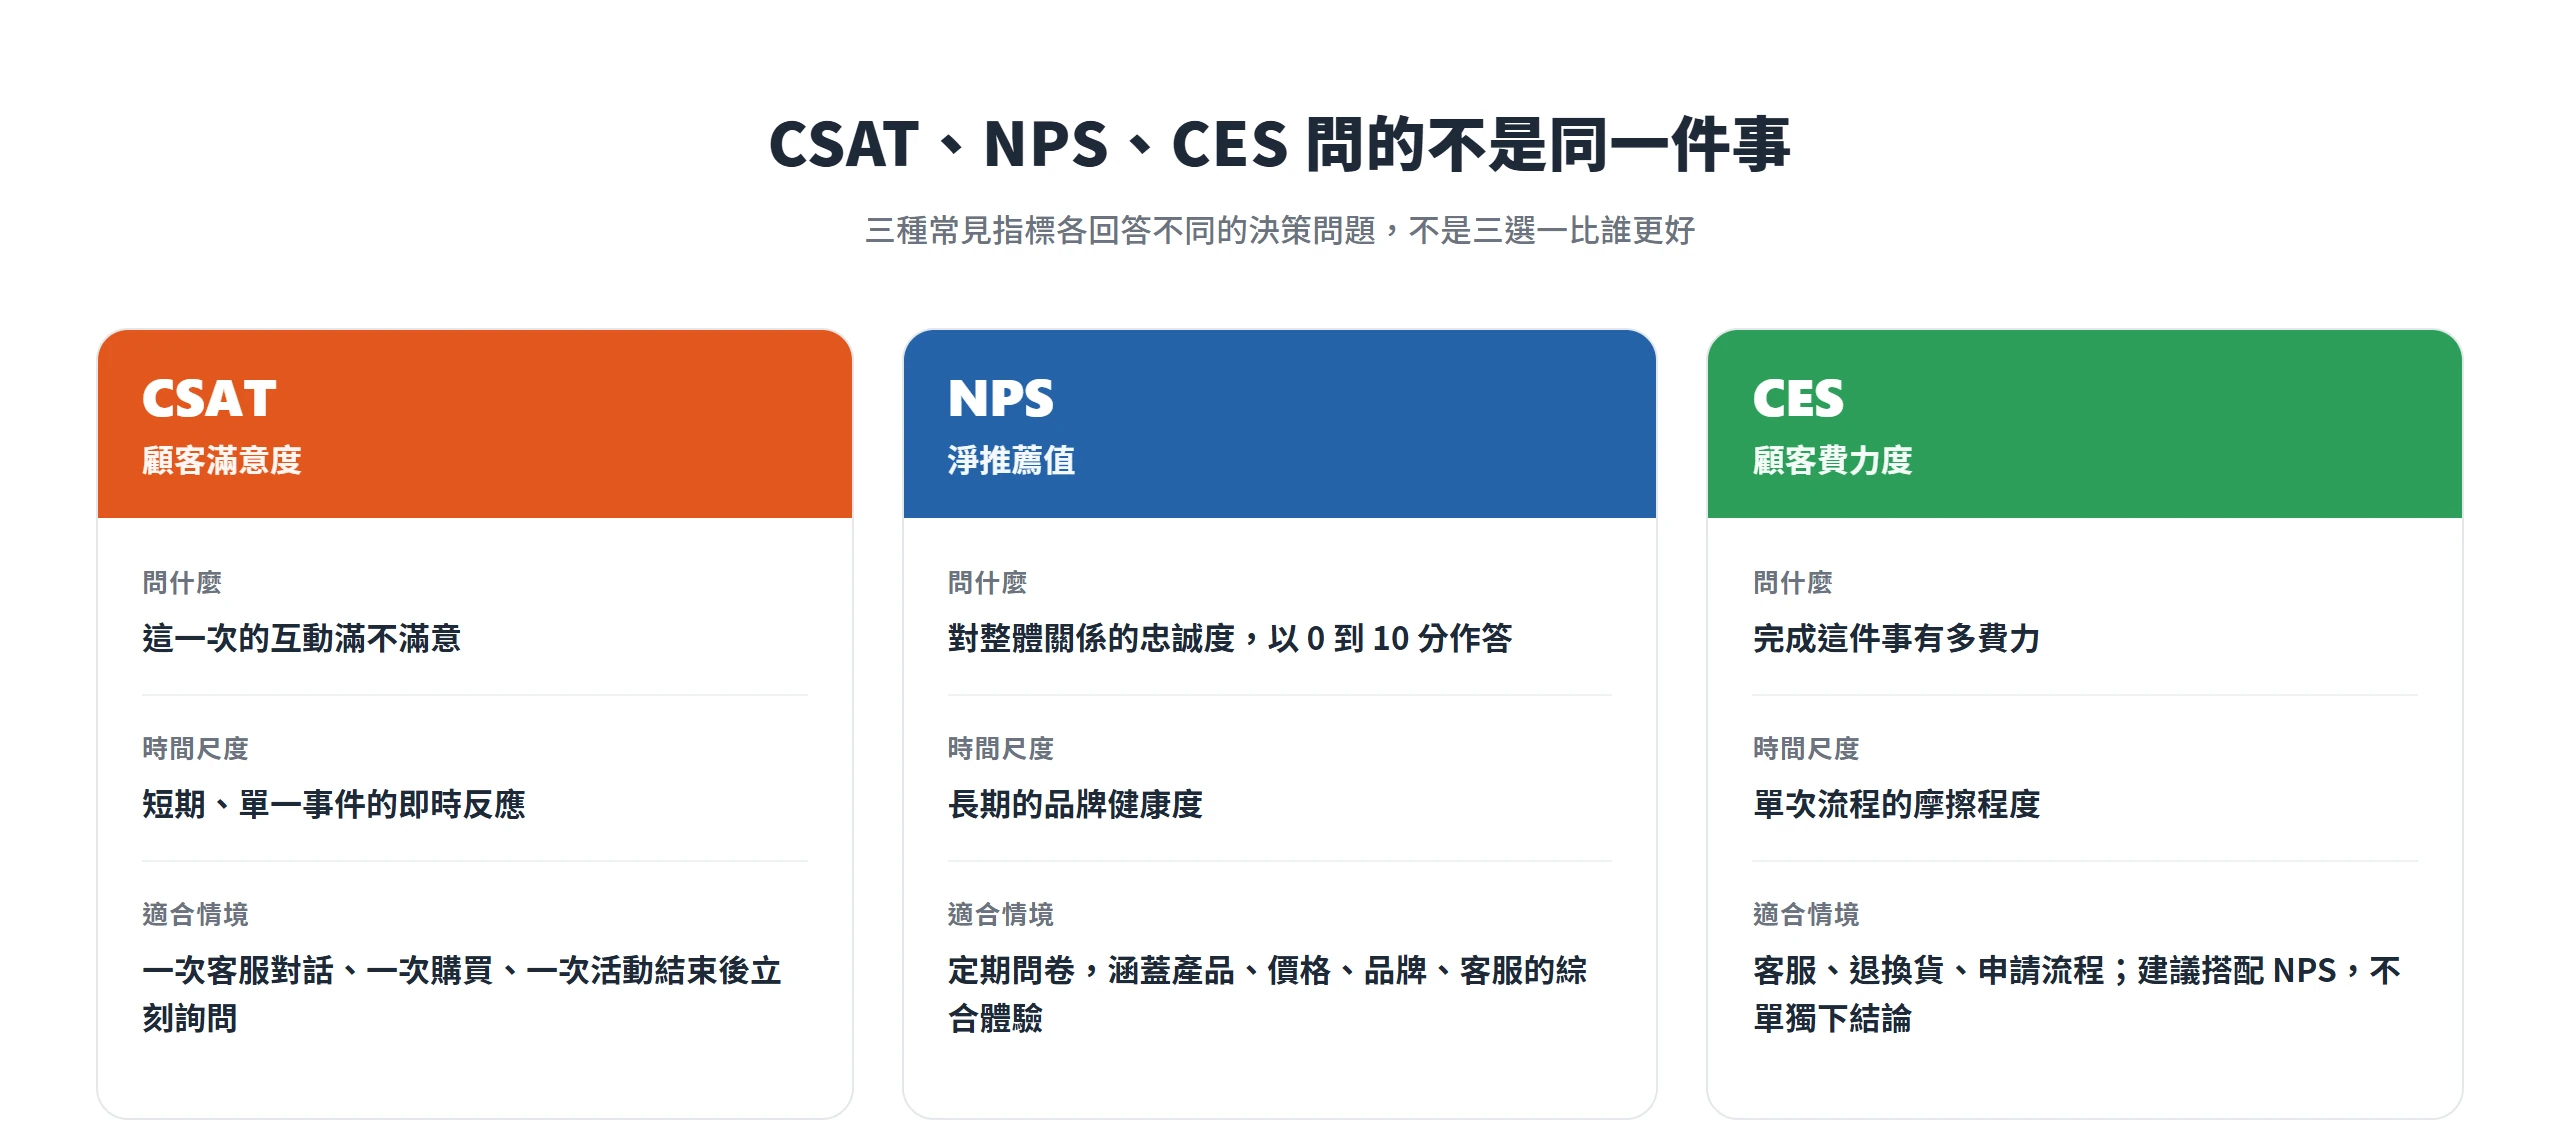
CSAT(顧客滿意度)、NPS(淨推薦值)、CES(顧客費力度)是問卷裡最常見的三種量化指標,但它們問的問題不一樣,適合的決策情境也不一樣,不是三選一比較誰更好,而是要看這次想回答的是哪一種決策問題。
CSAT 問的是這一次的互動滿不滿意,鎖定的是短期、單一事件的即時反應,適合在一次客服對話、一次購買、一次活動結束後立刻詢問,能快速知道這次體驗做得好不好。
NPS 問的則是顧客對整體關係的忠誠度,用你有多大可能把我們推薦給朋友或同事這句固定的提問,以 0 到 10 分作答:9 到 10 分是推廣者,對品牌忠誠度高,很可能主動推薦;7 到 8 分是中立者,對品牌沒有特別的好惡;0 到 6 分則是貶低者,可能對外傳播負面口碑。NPS 涵蓋的是產品、價格、品牌、客服的綜合體驗,適合追蹤長期的品牌健康度,不適合拿來評估單一一次互動。
CES 問的是完成這件事有多費力,適合客服、退換貨、申請流程這類希望降低顧客摩擦的情境,部署快、也很直覺,但只看 CES 容易誤判,顧客可能跟品牌整體關係很好,只是這一次互動剛好不順,若只看這次的費力度分數,會誤以為這位顧客不忠誠。Qualtrics 因此建議 CES 要跟 NPS 搭配使用,而不是單獨拿來下結論。CES 之所以被拿出來當獨立指標,背後是 CEB(現為 Gartner 旗下研究機構)的一份研究,該研究發現高費力度的服務互動中,96% 的顧客事後對品牌變得更不忠誠,相對之下,低費力互動只有 9% 的顧客變得不忠誠,這個落差正是費力程度該被獨立量測的原始依據。三個指標並不互斥,一份問卷可以視情境搭配使用,單次互動後問 CES 或 CSAT,定期問卷再放 NPS 追蹤長期關係。
決定好要問哪個指標之後,下一個容易被忽略的環節,是這些題目在問卷裡排在第幾題,順序本身就會影響答案。
問題排列的順序會把答案帶往前面設下的框架
同一組題目,換個順序問,答案可能就不一樣。這是因為前面問過的題目,會在顧客心裡先建立一個框架,顧客會不自覺地拿這個框架去回答後面看似無關的題目,問卷方法學上稱為脈絡效應(context effect)。Pew Research Center 的官方問卷設計指南就明確提醒,問卷中較早問到的題目,可能會影響顧客回答後面題目的方式,設計問卷時必須特別留意這個順序效應。
敏感題目的位置也是同樣的道理。收入、教育程度、年齡這類人口統計題目,除非是用來判斷受訪資格,或決定接下來要問哪個分支的問題,否則不應該放在問卷一開始;就算必須問,也建議先安排幾題比較輕鬆、能引起興趣的題目,讓顧客先進入填答的節奏,再問這類容易讓人有戒心的問題。
如果同一題要在不同時間點重複發送、用來追蹤變化,那麼題目的用詞與在問卷中的相對位置,都必須維持完全一致,順序或措辭有任何改動,這一題前後兩次收到的答案就失去可比較的基礎,等於白白浪費了原本可以拿來看趨勢的資料。
順序安排好之後,還有一個常被忽略的變數,問卷送出的時間點,同樣會左右顧客回想起來的,是清晰的實情還是模糊的印象。
問卷送出的時間點決定顧客回想的是印象還是實情
問卷送得太早,顧客可能根本還沒真正體驗完,答案自然不完整;送得太晚,顧客手上只剩下一個模糊的整體印象,細節早就想不起來了。時機本身就是設計的一部分,不是問卷做完、隨手就送出去的附加動作。
SurveyMonkey 官方的時機指南建議,交易型與單次事件型問卷,例如客服互動剛結束、活動剛落幕,應該盡快送出,通常是互動結束後立即發送,或活動結束後 24 到 48 小時內送出,讓顧客的印象還新鮮,回想起來的細節也比較準確。
如果問卷需要提醒顧客填答,節奏也有講究。第一次提醒安排在送出後 48 到 72 小時效果較好,第二次也是最後一次提醒,則安排在第 7 天左右;再往後追加提醒的效果會遞減,甚至可能讓顧客感到被打擾,反而影響對品牌的觀感。
時機抓對了,接下來要留意的是問卷本身的長度,每多問一題,都是在跟顧客的耐性借時間。
每多一道題目就流失一批耐性用盡的顧客
10 題的問卷完成率約 89%,40 題掉到約 79%,足足少了 10 個百分點。多問一題的代價,遠比想像中高。SurveyMonkey 官方針對完成率的研究提供了明確對照,問卷 10 題時平均完成率約 89%,20 題時降到約 87%,30 題時約 85%,40 題時則降到約 79%。
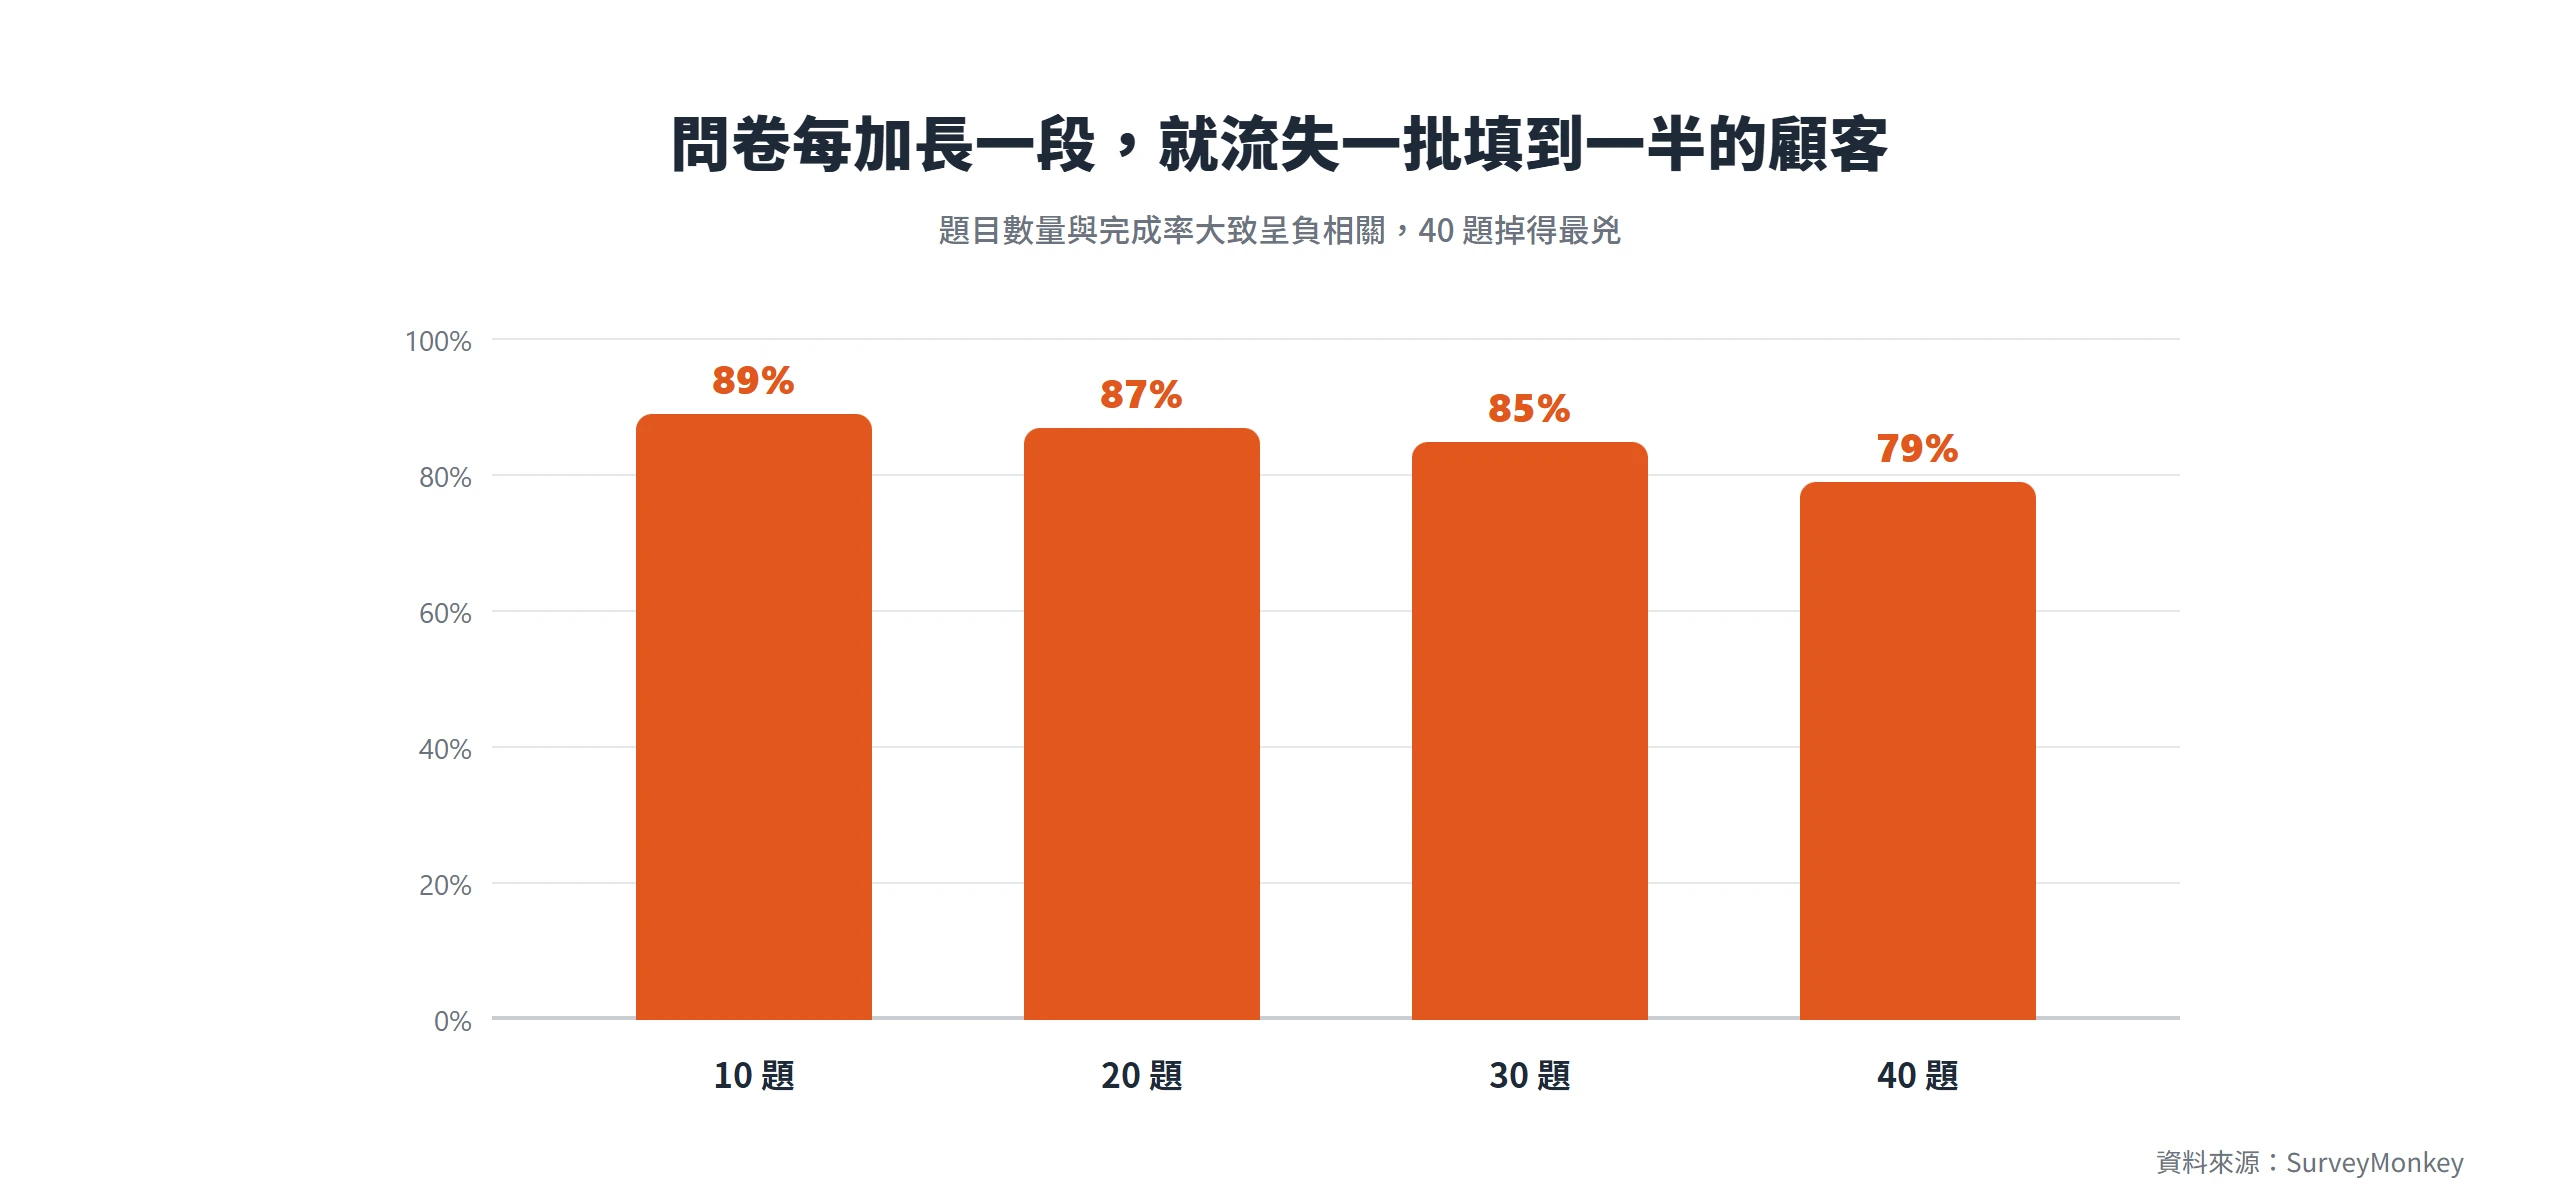
這組數字說明題目數量與完成率大致呈負相關,設計問卷時該優先問的是這一題真的非問不可嗎,而不是想到什麼就往上加。事後能從其他管道查到的資訊,例如顧客的消費金額、購買頻率,後台資料庫本來就有,就不必再拿問卷問一次,徒增顧客的填答負擔。
題目本身的文字也值得精簡,尤其是第一題。第一題的字數每多一個字,都可能讓一部分顧客在還沒進入狀況前就先放棄。與其把每題都寫得鉅細靡遺,不如把整份問卷瘦身到只剩下真正需要知道的問題,讓顧客能在耐性用盡之前填完。
題目設計、順序、時機、長度都處理到位,問卷回收之後,還有最後一關要處理,怎麼判斷收回來的每一份答案,是不是真的可信。
作答時間與選項一致,最容易被亂填問卷矇混過關
作答時間過短、同一組題目全選一樣的答案,是判斷問卷是否被亂填最常見的兩個訊號。但這兩招看起來合理,能真正抓到的無效回覆,卻遠比想像中少。
Pew Research Center 一份針對線上問卷資料品質的研究提供了具體數字。在該研究判定為無效的回覆裡,高達 84% 早就通過了問卷裡刻意設計、有明確正確答案的注意力檢查題;另外 87% 的無效回覆,也沒有被作答過快這個常見指標抓到,多數刻意亂填的人並不會用最快速度隨便亂點,反而可能花更長的時間作答,讓人誤以為填得很認真。即使同時使用注意力檢查與作答時間兩種快篩,仍有高達 76% 的無效回覆兩關都能通過,單靠這兩招幾乎攔不住多數的亂填問卷。
同一份研究示範了一種更有效的做法,把同一份問卷裡多道開放式問題,逐題比對不同受訪者的文字答案相似度,如果同一組受訪者在三題以上的開放題答案都高度相似,就值得人工複查是否為重複作答。不過研究也提醒,如果相似的答案只是很好、不確定這種內容太短的通用字詞,並不足以當作重複作答的證據,直接刪掉反而可能誤刪正常回覆。
換句話說,資料品質沒有一套自動化的萬能篩子,快篩工具能先抓出最明顯的一批,但真正要判斷一份答案可不可靠,終究得回到人工複查,而且要留意分寸,別把一個疑似訊號當成確鑿證據就直接刪除。
從樣本怎麼選、用詞會不會誘導、量表級距怎麼設,到題目排在第幾題、什麼時候送出、收回來又怎麼判斷可信度,顧客問卷調查要問出真話,靠的從來不是單一一個技巧,而是整條鏈路每一個環節都要做到位。任何一關沒處理好,前面辛苦寫對的題目、找對的樣本,都可能被後面的環節悄悄稀釋掉。
回到最前面那組數字,84% 的無效回覆能通過注意力檢查,並不代表這套機制沒用,而是提醒設計者,任何一種檢查方法都有它的死角,不能只靠一招就放心。問卷做得好不好,最終還是要回到那個最基本的判準,顧客給出的這個答案,是不是他們心裡真正想說的話。