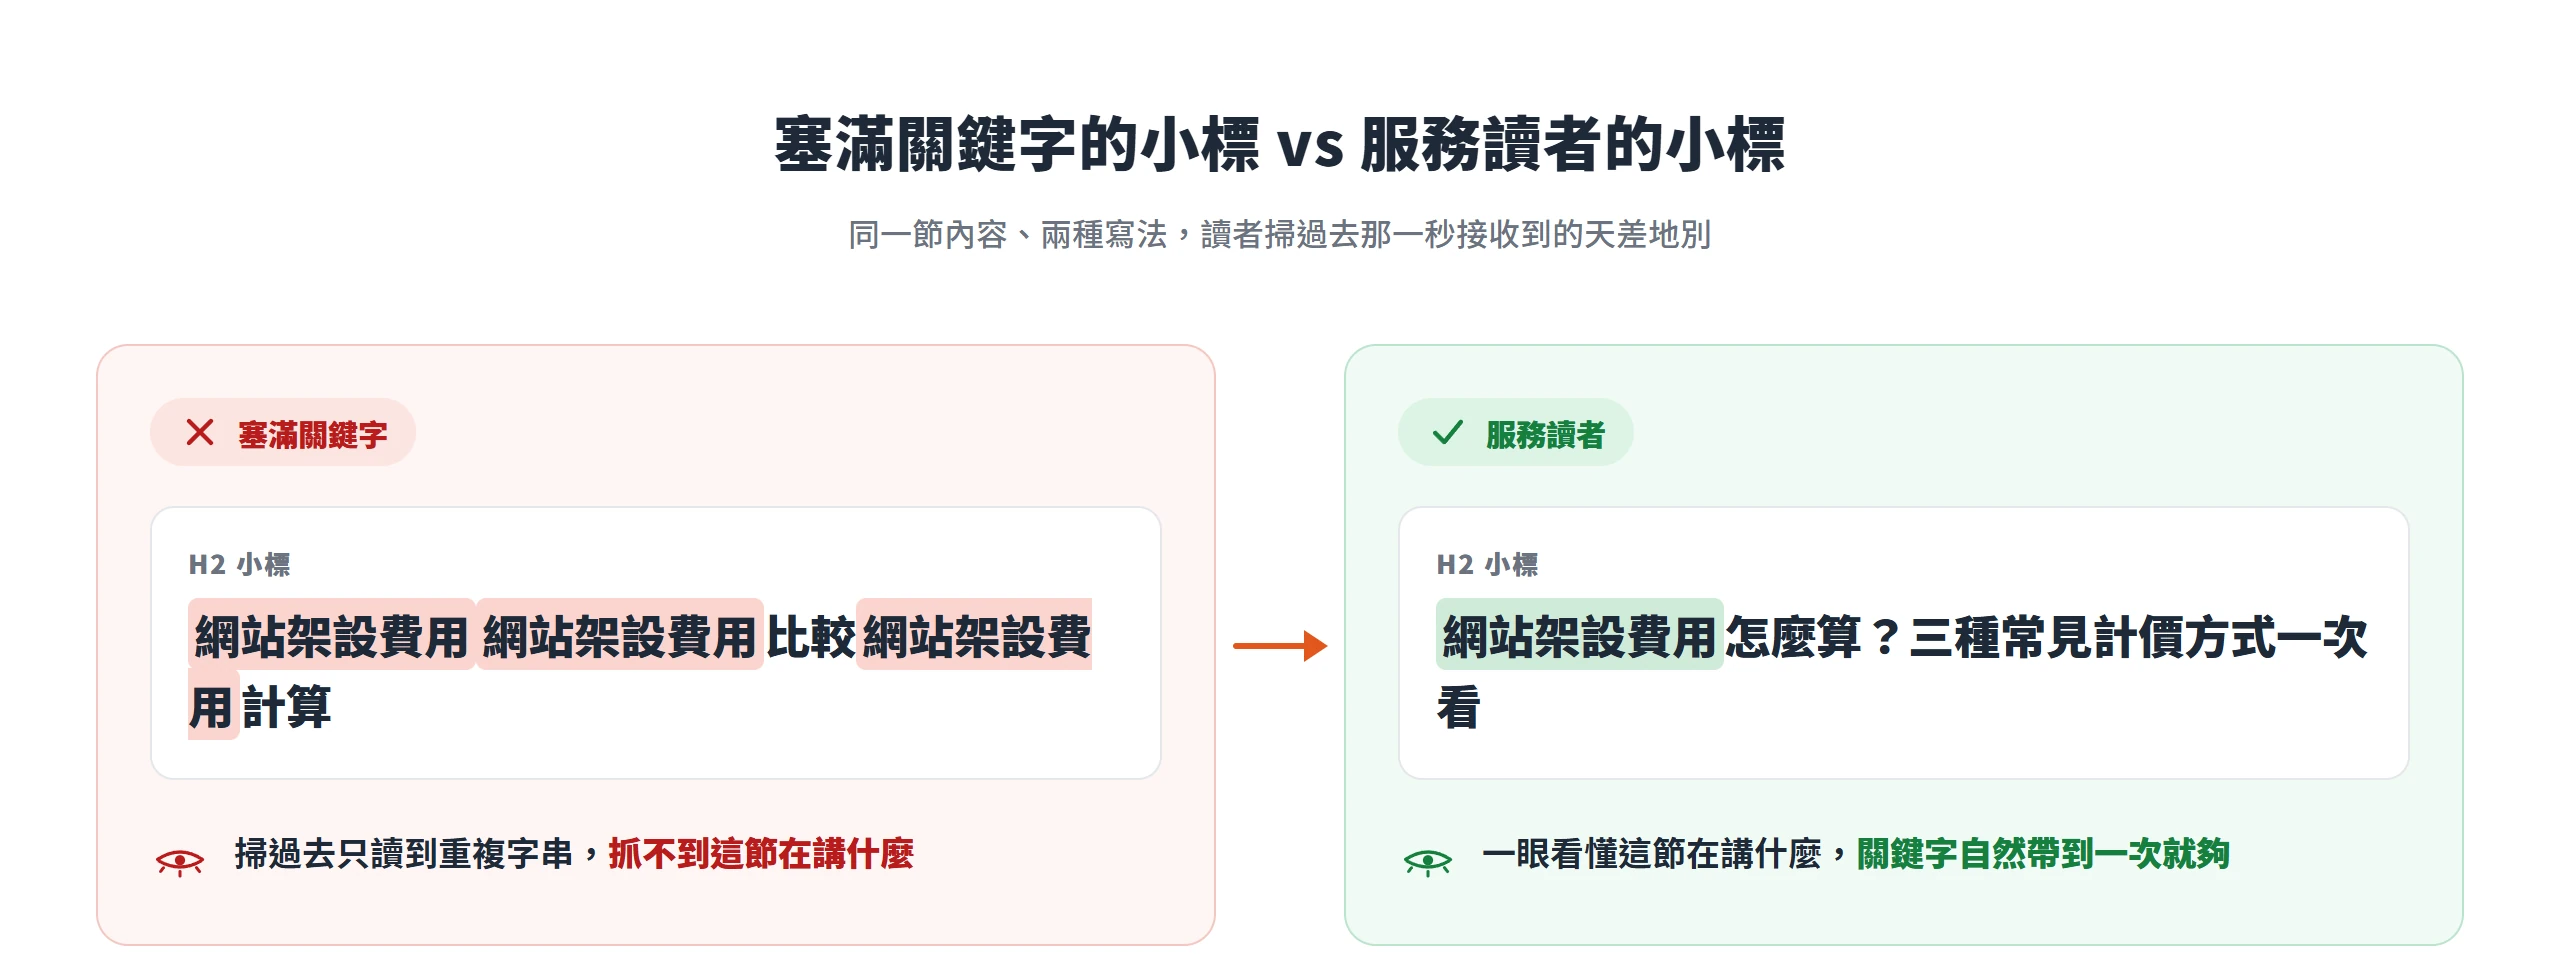
多數人以為,一個小標裡把主打的關鍵字多寫幾次,搜尋引擎就會多給一點加分,這個做法看起來像技術上的加分題,其實對讀者是扣分題。你點進一篇教學文,滑到某個小標寫著「網站架設費用網站架設費用比較網站架設費用計算」,眼睛掃過去,卻分不清這節在講「怎麼算」還是「行情多少」。這種小標並不少見,本來該幫讀者定位重點,卻先讓人摸不著頭緒。
小標塞滿關鍵字(keyword stuffing)的代價,不是排名掉幾名這麼單純。它先讓讀者在掃讀那一秒抓不到重點,信任感跟著下滑,而搜尋引擎與 AI 摘要現在判斷內容好壞,看的也早就不是字詞出現幾次,是語意講不講得通。這個做法為什麼還在流傳、又會付出什麼代價,先從它的來歷講起。
小標塞滿關鍵字的做法,源自舊版 SEO 教學留下的慣性
早期的 SEO 教學把 H1、H2、H3 這幾層標籤教成「關鍵字容器」,理由不是空穴來風。搜尋引擎在演算法發展的早期階段,確實把標題與標籤裡出現的字詞當成排名參考訊號之一,比對的邏輯也相對直接,這個位置出現了什麼字,系統就記一筆。這套判斷方式被寫進大量操作手冊、範本與課程,久而久之形成「小標=擺放關鍵字的位置」這個慣性認知,一路傳到現在,變成很多人下筆前的自動反應。
問題不在於這套邏輯曾經有效,而在於它沒有跟著搜尋引擎的判斷方式一起演進。Google 官方在說明搜尋垃圾內容政策時,開宗明義把這種操弄行為定義出來:「Keyword stuffing refers to the practice of filling a web page with keywords or numbers in an attempt to manipulate rankings in Google Search results.」這句定義本身就在說明,這是一個長期被辨識、長期存在的操弄模式,Google 也一直都在點名。這個慣性現在要付出的代價,遠比多數人以為的更直接。
關鍵字堆疊的小標讓讀者掃讀白費工夫
多數讀者打開一篇網頁文章,並不是逐字往下讀,而是用掃讀的方式抓重點。Nielsen Norman Group 針對使用者閱讀網頁的眼動追蹤研究指出,使用者「並不逐字閱讀頁面上的每個字,而是進行掃讀」,這份研究依效能由低到高把掃讀行為分成四種模式:F 型模式、點狀模式、層狀蛋糕模式,以及效能最高的承諾模式。這幾種模式的共同前提,是使用者本來就不打算把每一段文字都讀完,而是在快速移動的視線裡找線索。
小標的第一功能正是替讀者導航,讓讀者一眼判斷這一節在講什麼,值不值得停下來細讀。這份研究也建議內容應該「用有意義的小標題分塊」,用意就是把重點濃縮成一句話,讓讀者掃過去就能接收到。一旦小標失去這種具體語意,導航的功能也一併消失。
關鍵字堆疊型小標,問題正好卡在這裡。它讀起來像一串關鍵字清單,不像一句完整的判斷句。讀者掃過去的瞬間抓不到那節實際在講什麼,這個小標等於白放了。這是塞滿關鍵字換到的第一筆代價,跟排名企圖完全無關,是讀者體驗上的直接損失,而且發生在讀者還沒決定要不要往下讀的那一刻。
層狀掃讀模式裡,小標抓不到重點就等於沒放
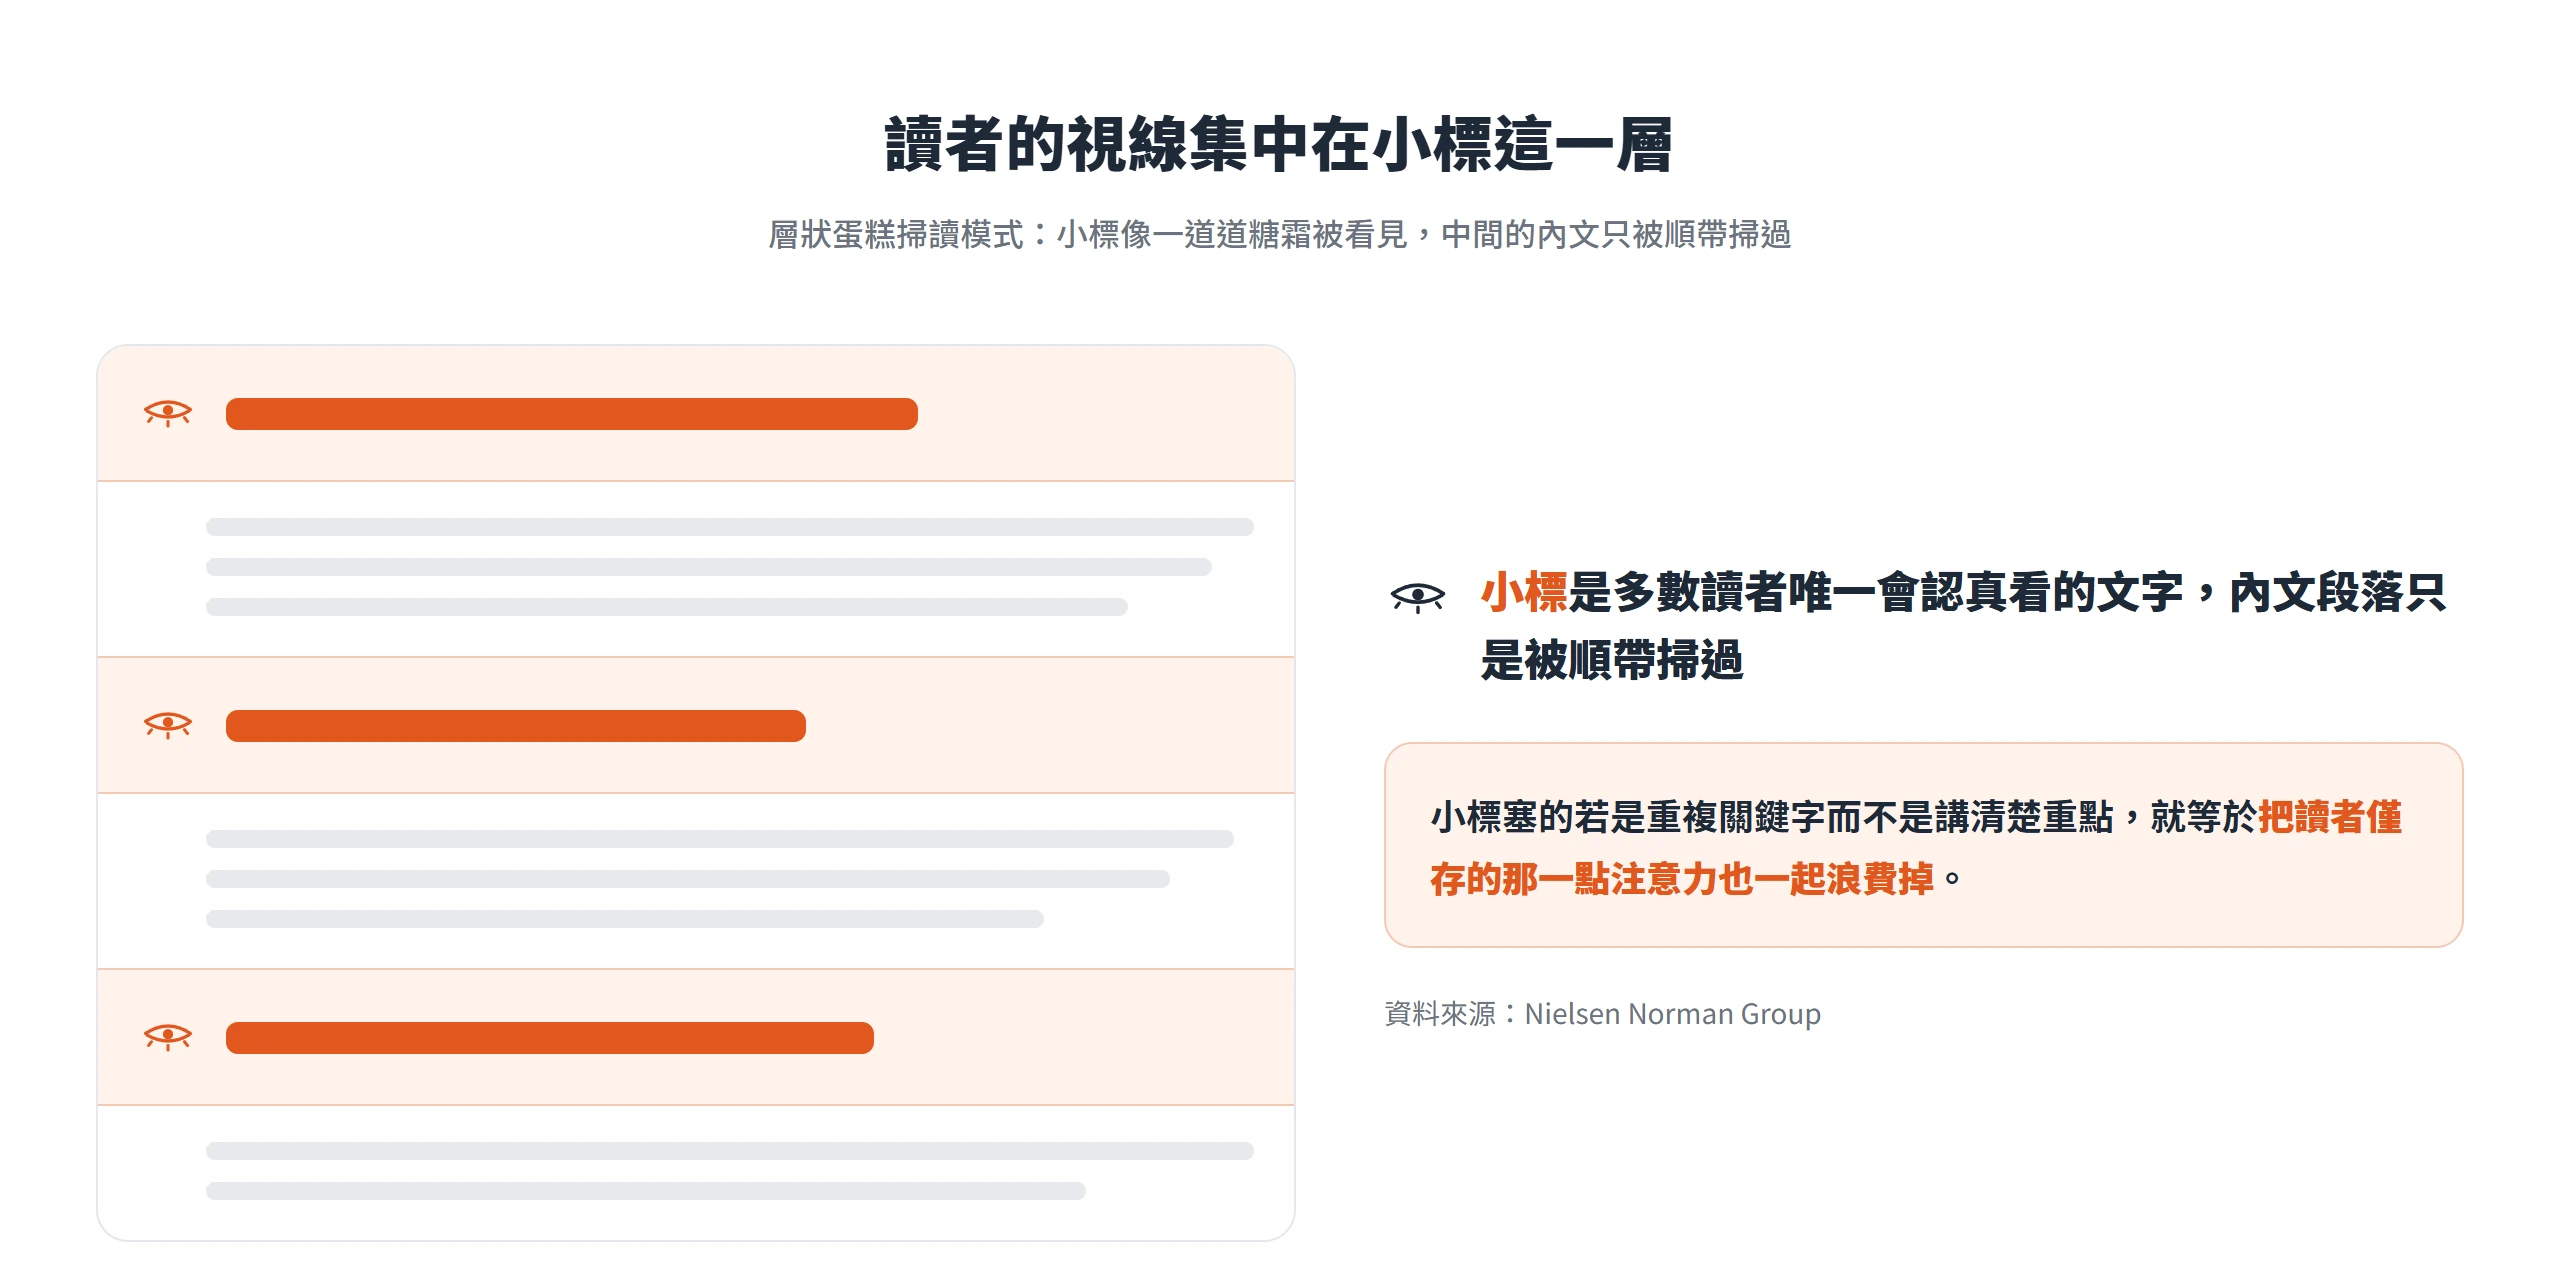
前面提到的層狀蛋糕模式,具體展開來看更能說明小標的分量。這份研究描述的眼動熱圖顯示,使用者的視線集中在標題與小標這一層,標題之間的內文段落幾乎不被關注,整體視覺呈現水平條紋,像一塊蛋糕被切成好幾層、每層都澆上一道糖霜。換句話說,小標其實是多數讀者唯一會認真看的文字,內文段落只是被順帶掃過。如果這個位置塞的是重複關鍵字而不是講清楚重點,就等於把讀者僅存的那一點注意力也一起浪費掉了。
這種掃讀傾向並不是單一研究的偶然發現。Nielsen Norman Group 更早一份原始的 F 型掃讀研究,以 232 名受試者的眼動追蹤資料,首度記錄使用者閱讀網頁時的水平與垂直視線軌跡,證實「掃讀而非逐字讀」是長期一致的行為模式,後續層狀蛋糕模式等分類都是建立在這個基礎上。這份研究對小標寫法也給出具體建議:小標、段落與條列項目都應該「用帶有資訊量的詞語開頭,讀者才會在視線掃過內容左側時注意到」。這句話反過來也說明了關鍵字堆疊型小標的問題。它的開頭往往不是資訊量最高的詞,而是為了湊次數硬塞進去的重複字詞。
堆滿關鍵字的小標讓內容顯得沒有可信度
讀者判斷一篇內容可不可信,很大程度來自版面與資訊設計是否用心,而不是單純看內容本身的事實是否正確。小標是讀者接觸內容的第一層,如果小標讀起來不像正常語句,而像一串關鍵字列表,等於在讀者還沒進入正文前,就先露出一個訊號——這篇內容是為了排名而寫,不是為了回答我的問題。可信度在這個瞬間就先扣分了。
史丹佛大學的 Persuasive Technology Lab 針對網路可信度所做的準則研究,把版面與內容用心程度列為判斷可信度的重要依據。準則第六條提到,網站應該留意「版面、字體排印、圖片與一致性等問題」;第九條談到內容不該帶推銷腔調,建議「內容要清楚、直接、真誠,而非帶有推銷腔調」;第十條則直接點出,「文字與連結上的瑕疵會損害一個網站的可信度」。這份研究花三年時間、訪問逾 4,500 人才得出結論,指出使用者判斷可信度時,最先注意到的多半是版面與資訊設計層面,一旦懷疑內容帶有操弄或推銷意圖,就會直接影響停留的意願。
這件事解釋了為什麼關鍵字堆疊型小標的代價,比演算法懲罰更早發生也更難挽回。演算法要調降排名,多半是事後的統計判斷;但讀者對可信度的判斷,發生在他決定要不要繼續往下讀的那一秒,而且一旦覺得不可信,很少會再給第二次機會。
搜尋引擎判斷小標的標準已經換成語意理解
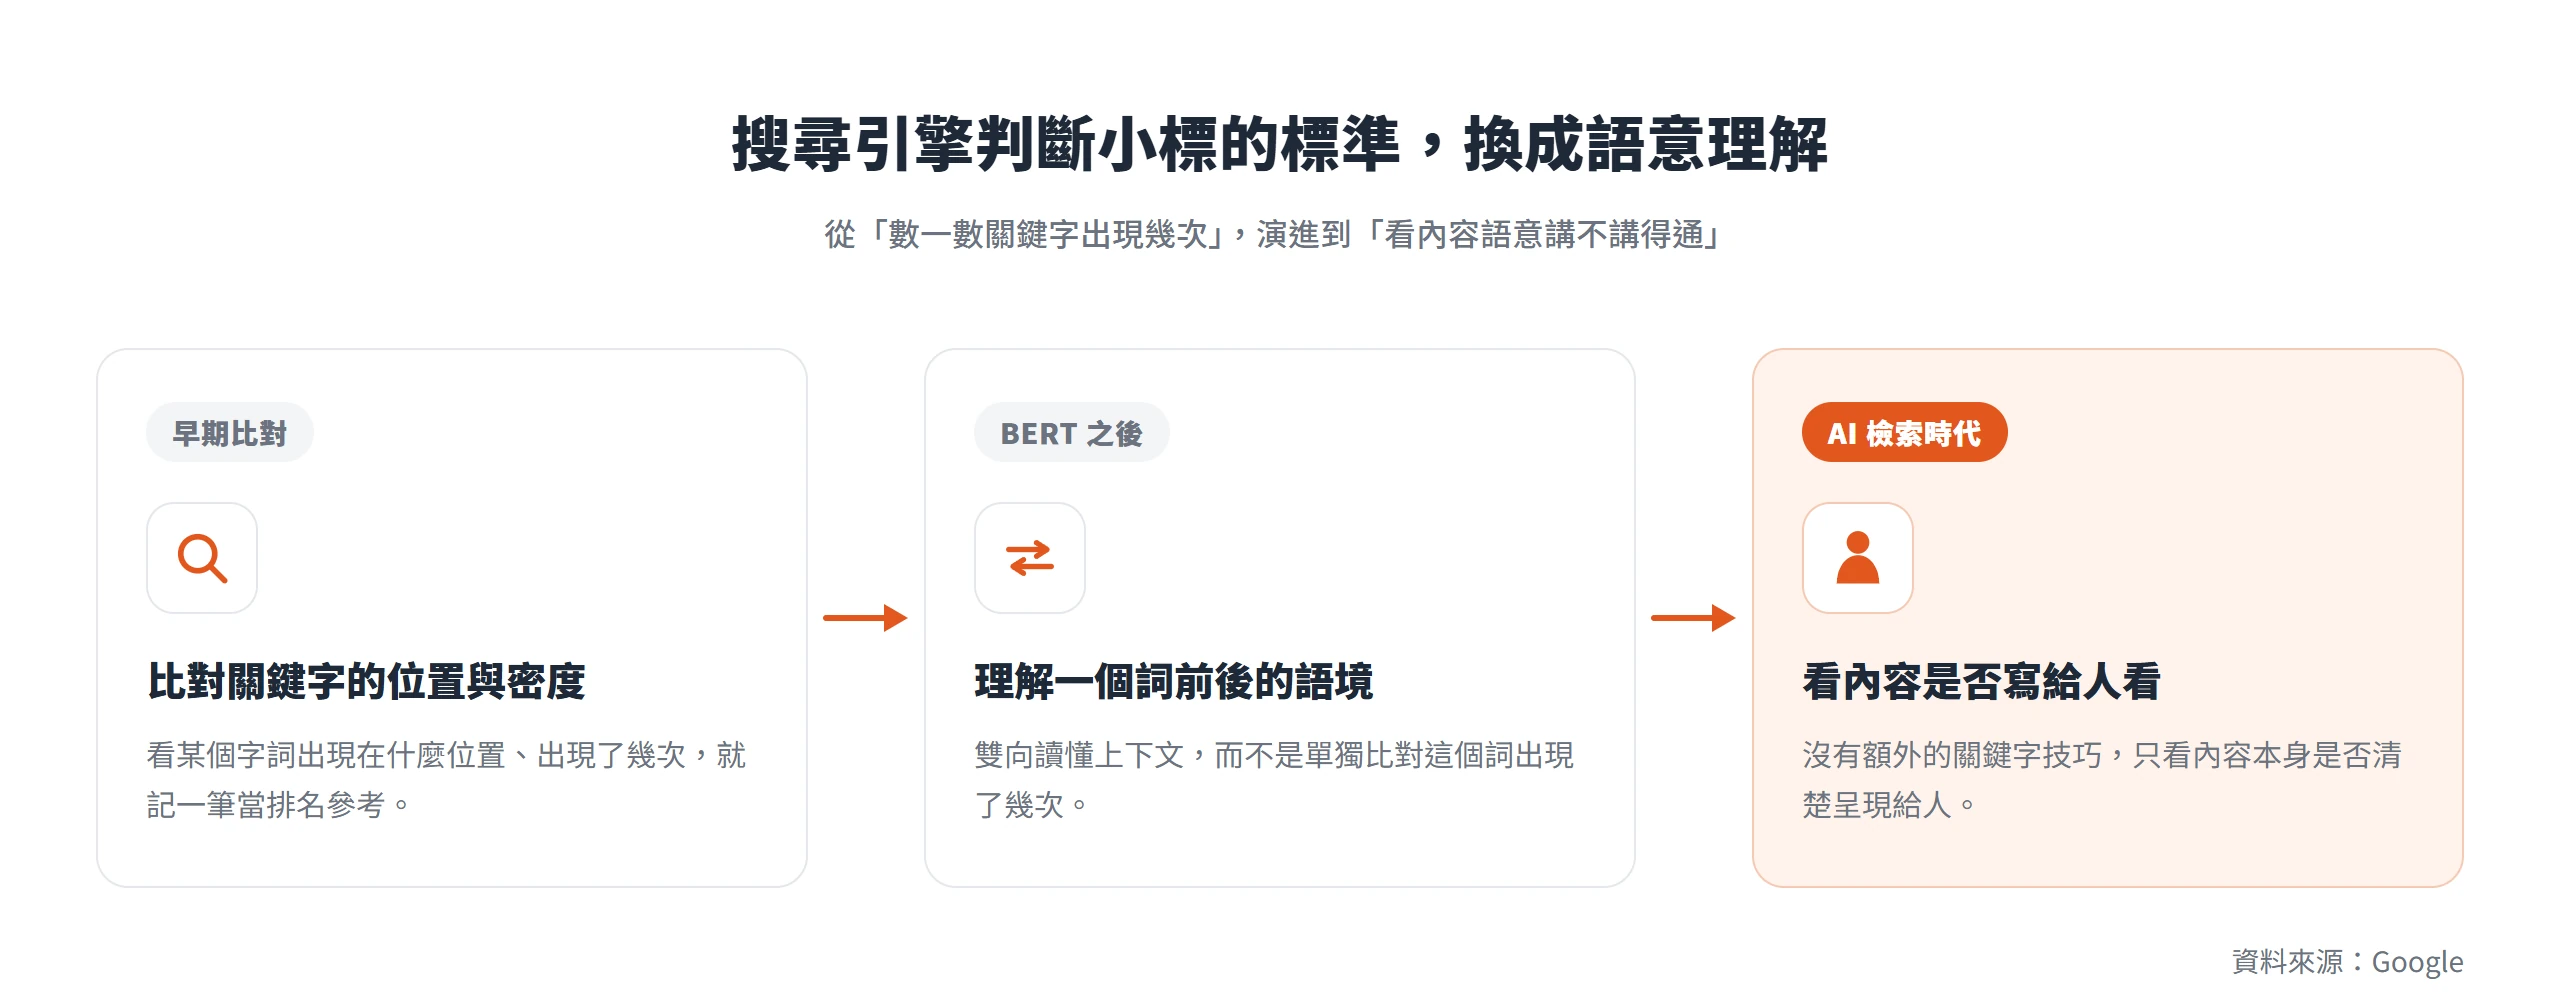
讀者體驗與信任成本之外,演算法層面的代價,才是「現在更不划算」這個判斷的核心依據。搜尋引擎與 AI 檢索判斷內容品質的方式,已經從「比對關鍵字出現位置與密度」演進到「理解語意與上下文」。這裡統整三個具體事實:Google 官方把關鍵字堆疊明文列為要處理的操弄手法、BERT 之後系統理解的是上下文而不是單獨比對關鍵字、Google 針對 AI Overviews 與 AI Mode 的官方說明也強調沒有另外的優化技巧,只看內容本身是否清楚呈現給人看。這三件事合起來,說明的是同一件事,關鍵字堆疊過去或許能討好比較原始的比對機制,現在只是在跟一個已經不這樣運作的系統打錯目標。
Google 明文把關鍵字堆疊列為要處理的內容
Google 官方的搜尋垃圾內容政策文件,對關鍵字堆疊的定義寫得很直接:「Keyword stuffing refers to the practice of filling a web page with keywords or numbers in an attempt to manipulate rankings in Google Search results.」文件也舉出具體的違規態樣,包括「沒有實質附加價值、純粹羅列電話號碼的清單」,以及「大量列出想要排名的城市與地區名稱的文字區塊」,還有重複使用相同詞彙導致語句不自然的情況。
這不是坊間的猜測或臆測,是 Google 白紙黑字列出的操弄手法,而且明講後果,觸犯這項政策的頁面「可能在搜尋結果中排名下降,或完全不出現在結果中」。換句話說,小標裡刻意重複塞入關鍵字,不是無傷大雅的排版習慣,是官方文件裡點名的操弄手法,付出的代價寫得清清楚楚。
BERT 之後,系統讀的是語境不是單獨字詞
搜尋引擎理解語言的方式,早已從比對關鍵字進化成理解上下文。Google 官方部落格在說明 BERT 這項技術時提到,「BERT models can therefore consider the full context of a word by looking at the words that come before and after it」,意思是系統能雙向理解一個詞前後的語境,而不是單獨比對這個詞出現了幾次。
文章裡舉了一個實際的查詢例子,使用者搜尋「do estheticians stand a lot at work」,過去的系統可能把「stand」誤解成某種技術術語,BERT 之後系統能正確理解這句話問的是「美容師工作時是不是常常站著」。文章也提到,這項技術讓使用者搜尋時可以講得比較自然,不必再用生硬拼湊的關鍵字組合去遷就搜尋引擎,那種為了討好演算法而刻意堆砌詞彙的搜尋方式,Google 自己稱為「keyword-ese」。這段說明直接印證,系統現在讀的是語境,不是字詞排列本身,小標裡硬塞的重複詞彙,對理解上下文的系統來說並不會加分。
AI 摘要看的是內容寫不寫給人看,不是關鍵字密度
AI Overviews 與 AI Mode 這類生成式檢索功能,也沒有另外的關鍵字技巧可以鑽。Google 官方文件明講:「There are no additional requirements to appear in AI Overviews or AI Mode, nor other special optimizations necessary.」內容要被選用的前提,是頁面本身已經被索引、有機會出現在一般搜尋結果並帶有摘要,而且「重要內容以文字形式呈現」。
搭配 Google 另一份說明「怎樣算是對人有幫助的內容」的官方文件來看,這個方向更清楚:「We recommend that you focus on creating people-first content to be successful with Google Search, rather than search engine-first content made primarily to gain search engine rankings.」文件也列出自我檢核的問題,例如「這份內容主要是為了吸引搜尋引擎造訪而做的嗎」。這兩份文件合起來說明,AI 摘要功能判斷內容的基礎,仍然是內容本身有沒有寫給人看、有沒有清楚呈現,跟塞滿關鍵字的小標邏輯正好相反。
小標裡出現關鍵字不等於就是堆疊
關鍵字堆疊的代價講得再清楚,也不代表小標裡完全不能出現關鍵字,矯枉過正、連正常出現一次都不敢寫,反而是另一種誤判。真正構成堆疊的判準,就在 Google 官方定義裡已經寫清楚的那句話,「不自然」且「重複到失去語意」,例如同一組近義詞在小標裡反覆出現,或是硬把不相關的地名、型號塞進同一個小標。單純出現一次的關鍵字,並不落在這個門檻裡。
如果一個技術性專有名詞、錯誤代碼、產品全名本身就是讀者搜尋的那個詞,而且沒有更自然的替代說法,原樣寫進小標不算堆疊,是精準指稱。清單文、盤點文逐項用工具名或產品名當 H3,也是同樣的道理,那是命名慣例,不是塞字。
找不到更自然說法的專有名詞,原樣寫進小標不算堆疊
判斷這種例外成不成立,有一個具體的問法,把這個詞從小標拿掉,讀者還認得出這一節在講什麼嗎?認不出來,代表這個詞是必要資訊,不是為了塞次數而重複。舉個去識別化的示意例子:假設一篇排水系統故障診斷的教學文,某個小標真的就是在講某個特定錯誤代碼,直接把這個代碼寫進小標,是在準確回答讀者要找的東西,讀者搜尋的本來就是這串代碼,換成模糊的說法反而讓人找不到這一節。
這跟堆疊行為,方向完全相反。堆疊是把不相關或重複的詞硬塞進去湊次數,換掉不影響語意;這種例外情況是把讀者真正在找的那個精確字串原樣寫出來,拿掉反而讓小標失去導航作用。兩者的差別不在關鍵字出現與否,而在這個詞對讀者理解這一節內容是不是必要的。
把小標寫給讀者看懂,關鍵字自然會落在該出現的位置
代價與例外收束起來,其實是一個很直接的判斷原則,寫小標的優先順序應該是讀者掃過去能不能馬上看懂這一節在講什麼,關鍵字自然融入即可,不必刻意塞,也不必刻意迴避。
具體的做法是,先把這一節真正的重點寫成一句完整、有主詞受詞的判斷句,關鍵字通常會自然出現在描述主題的名詞裡,不需要另外硬加。如果一個關鍵字硬是塞不進一句自然的判斷句,代表這個位置根本不該放這個關鍵字,該檢討的是這一節的內容規劃本身,而不是想辦法把字塞進去湊數。
這個原則不是憑空喊出來的立場,而是呼應前面引用的官方依據,Google 講的「people-first」,Nielsen Norman Group 建議小標「用帶有資訊量的詞語開頭」,兩者指向的都是同一件事,把小標寫給讀者看懂,關鍵字自然會落在它該出現的位置,不需要另外堆疊。
小標塞滿關鍵字換來的那點短期排名,抵不過讀者掃讀時的一次卡頓,也抵不過搜尋引擎與 AI 檢索現在真正在看的東西。把每個小標當成一句要講給讀者聽的話來寫,比想辦法在裡面多塞幾次關鍵字,划算得多。