Perplexity 的 Spaces,在 2026 年 7 月 30 日改名成了 Projects;原本叫 thread 的對話串,說明文件裡現在也寫成 session。照著舊教學找這些入口,會發現畫面上的字對不上。
比改名更大的變化是,Perplexity 早就不只是一個附連結的搜尋框。輸入框旁多了 Research 與 Model Council 這類模式,答案旁的引用多了來源標籤,側邊欄還放著 Projects。功能變多了,初學者反而更難分辨哪些是日常會用到的,哪些只是延伸。
要替這些功能排出先後順序,得先弄清楚這套工具與一般聊天式 AI 在運作上有什麼不同。
Perplexity 是什麼?
Perplexity 是一款 AI 搜尋引擎。你問一個問題,它會即時搜尋網路,把找到的資料整理成對話口吻的簡短答案,並且在答案裡用編號標出引用,點編號就能跳到原始網頁。Perplexity 的 Help Center 說明,這樣設計是為了讓使用者能自己查證,而不是只能相信一段沒有出處的文字。
一般聊天式 AI 助手是以對話為出發點,Perplexity 則是以搜尋為出發點,所以答案呈現的方式也不同,每個說法旁邊幾乎都掛著編號。
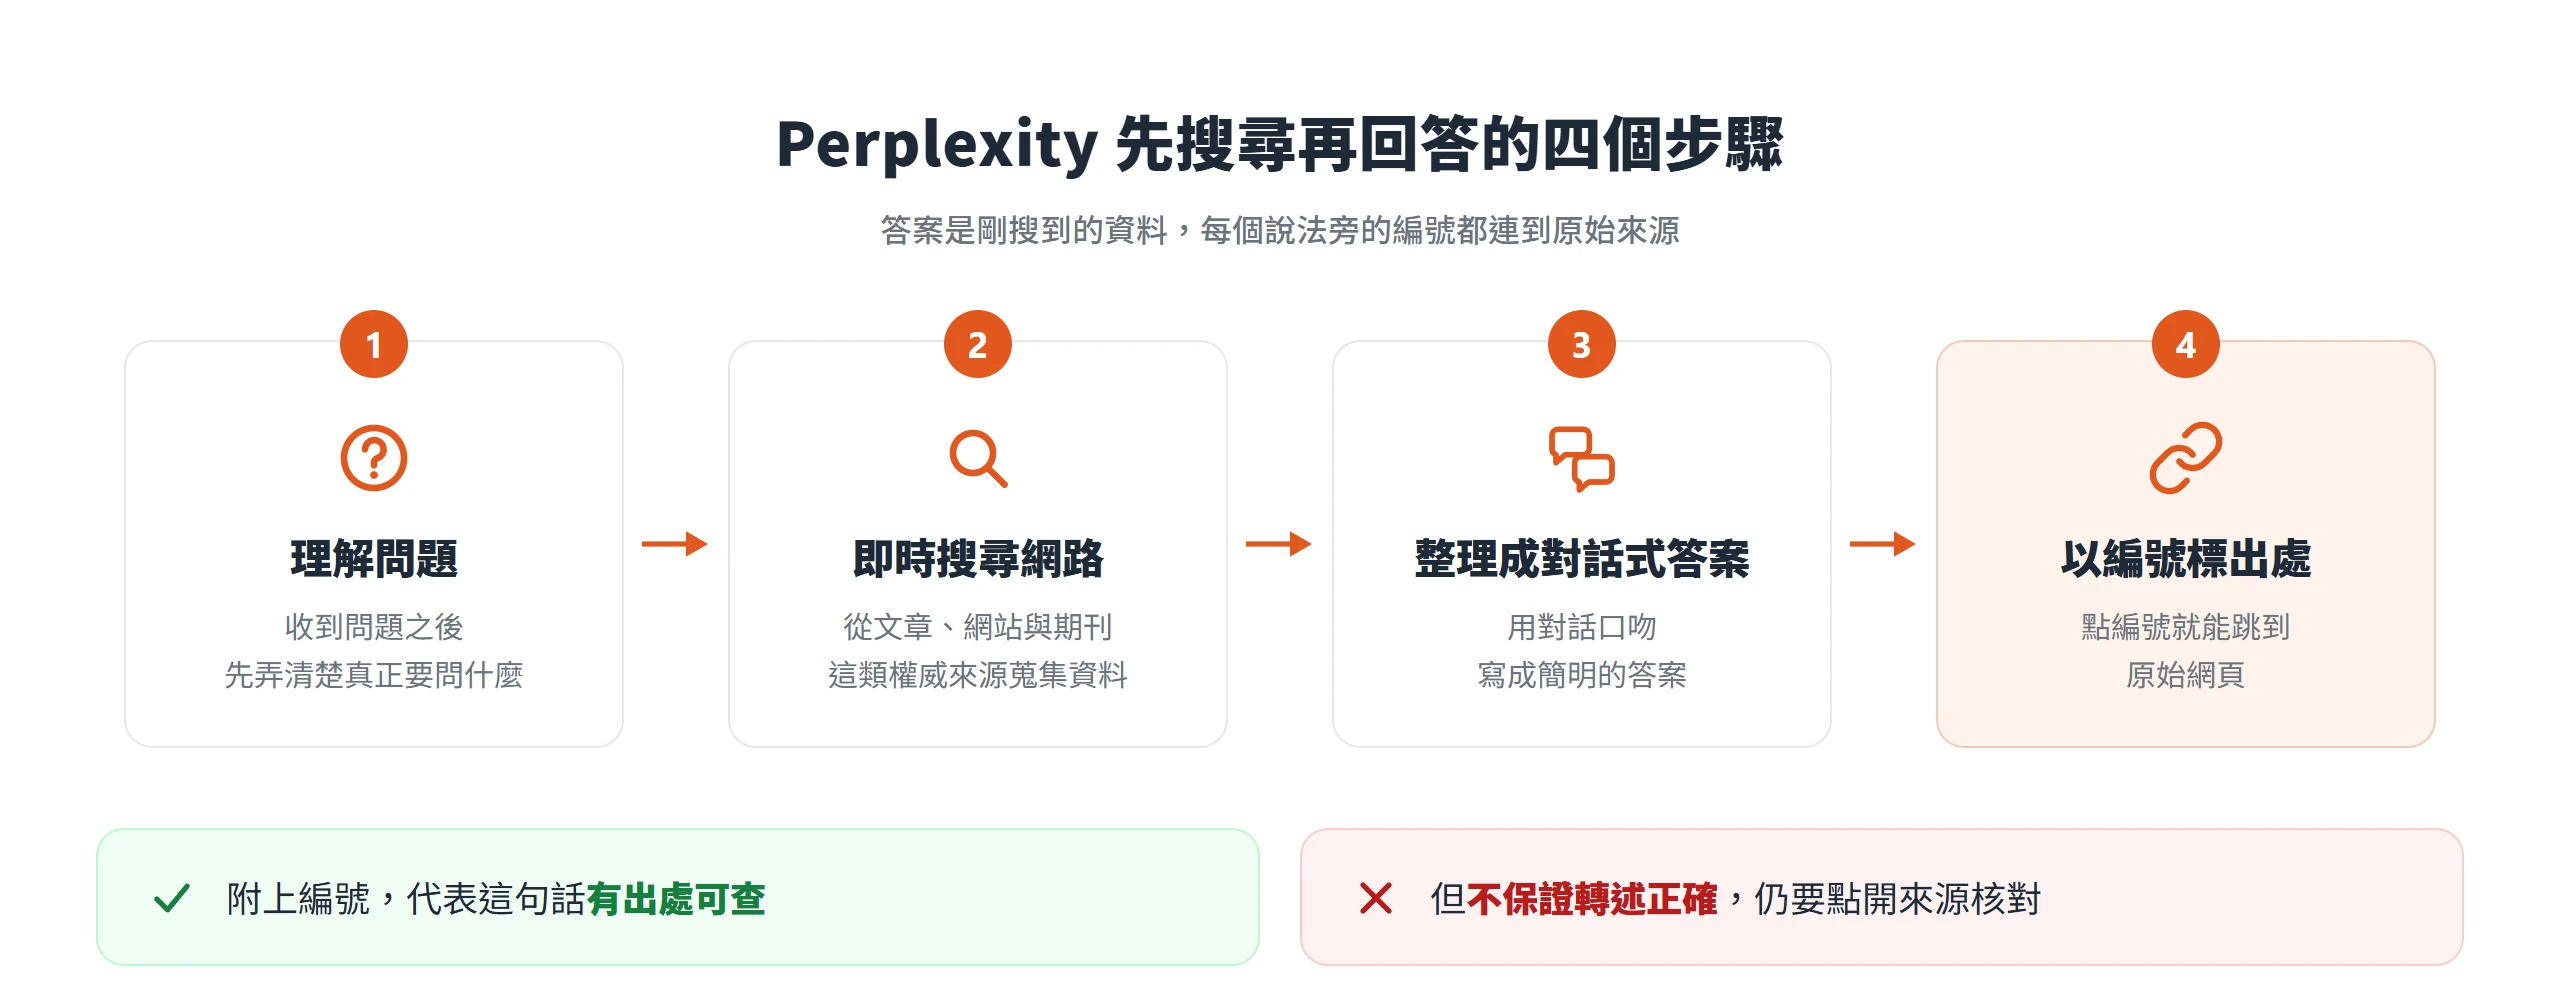
先搜尋網路再回答,每個說法都標上來源編號
Perplexity 的處理順序有四步。收到問題之後,先理解問題真正要問什麼,再即時搜尋網路,從文章、網站與期刊這類權威來源蒐集資料,接著整理成簡明的對話式答案,最後在答案裡以編號標出每個說法的出處。這個順序決定了它的答案是「剛搜到的東西」,而不是只靠模型訓練時學到的舊知識。
這也是編號會成為整個產品核心設計的原因。答案旁的每個編號都連到原始來源,使用者可以直接點開,看那一頁有沒有寫出這句話。不過,附上編號只代表「有出處可查」,並不保證那一句話被轉述得正確,所以不論用 Perplexity 的哪一種模式,點開來源核對都是少不了的一步。
Perplexity 搜尋之外的 Computer、Comet 瀏覽器和 Create files and apps
Perplexity 現在的產品不只有搜尋,搜尋與研究仍是最核心的一塊,周邊還有 Computer、Comet 瀏覽器與 Create files and apps。
Computer 在 2026 年 2 月 25 日推出,定位是能規劃、研究並交付多步驟工作的 AI 協調者,從一個任務出發,自己拆解步驟、呼叫工具再把成果交回來。Comet 則是 Perplexity 自家的瀏覽器,內建 AI 助手,2026 年 3 月登上 iOS 之後,已涵蓋桌面版、Android 與 iOS。Create files and apps 原本叫 Labs,可以產出報告、試算表、儀表板與簡單的網頁應用,屬於 Pro 以上的功能。
搜尋介面裡的 Research 與 Projects 也跟 Computer 相通,Research 已經可以在 Computer 裡使用,Projects 則是 Computer 長期工作的中樞,所以這兩項功能在兩邊都看得到。Comet 與 Computer 本身的操作,屬於另一個獨立的主題。
登入方式、介面位置與繁體中文設定
第一次使用前,先弄清楚三件事就夠了:要不要註冊、輸入框與選單在哪裡、回答要用哪一種語言。
Perplexity 的帳號可以跨裝置共用,網頁版、手機 App 與桌面版登入同一組帳號,對話紀錄會一起同步。
未登入也能提問,但對話只保留 14 天
不註冊也能直接在 perplexity.ai 提問,只是未登入時建立的對話屬於匿名對話,Help Center 寫明這類對話會在 14 天後過期,而且無法復原。想把對話長期留下來,就得註冊。
註冊可以用 Email,也可以直接用 Google 或 Apple 帳號登入,註冊之後提問,一樣會得到附引用的回答。登入之後建立的對話會自動存進 Library,可以隨時回頭翻閱,也能自行決定要刪除哪些。
輸入框的 + 選單集中了檔案、來源與模式
新版輸入框把幾項常用動作收進 + 圖示:上傳檔案、管理來源、選擇模式。依 Perplexity 的更新記錄,Deep Research、Model Council、Create files and apps 與 Learn step by step 都在這個選單裡。
側邊欄則是另一個入口,裡面有 Library 與 Projects。Library 是舊對話的所在位置,網址是 perplexity.ai/library,說明文件有時也稱它為 History 頁。Projects 則是長期主題的工作區。
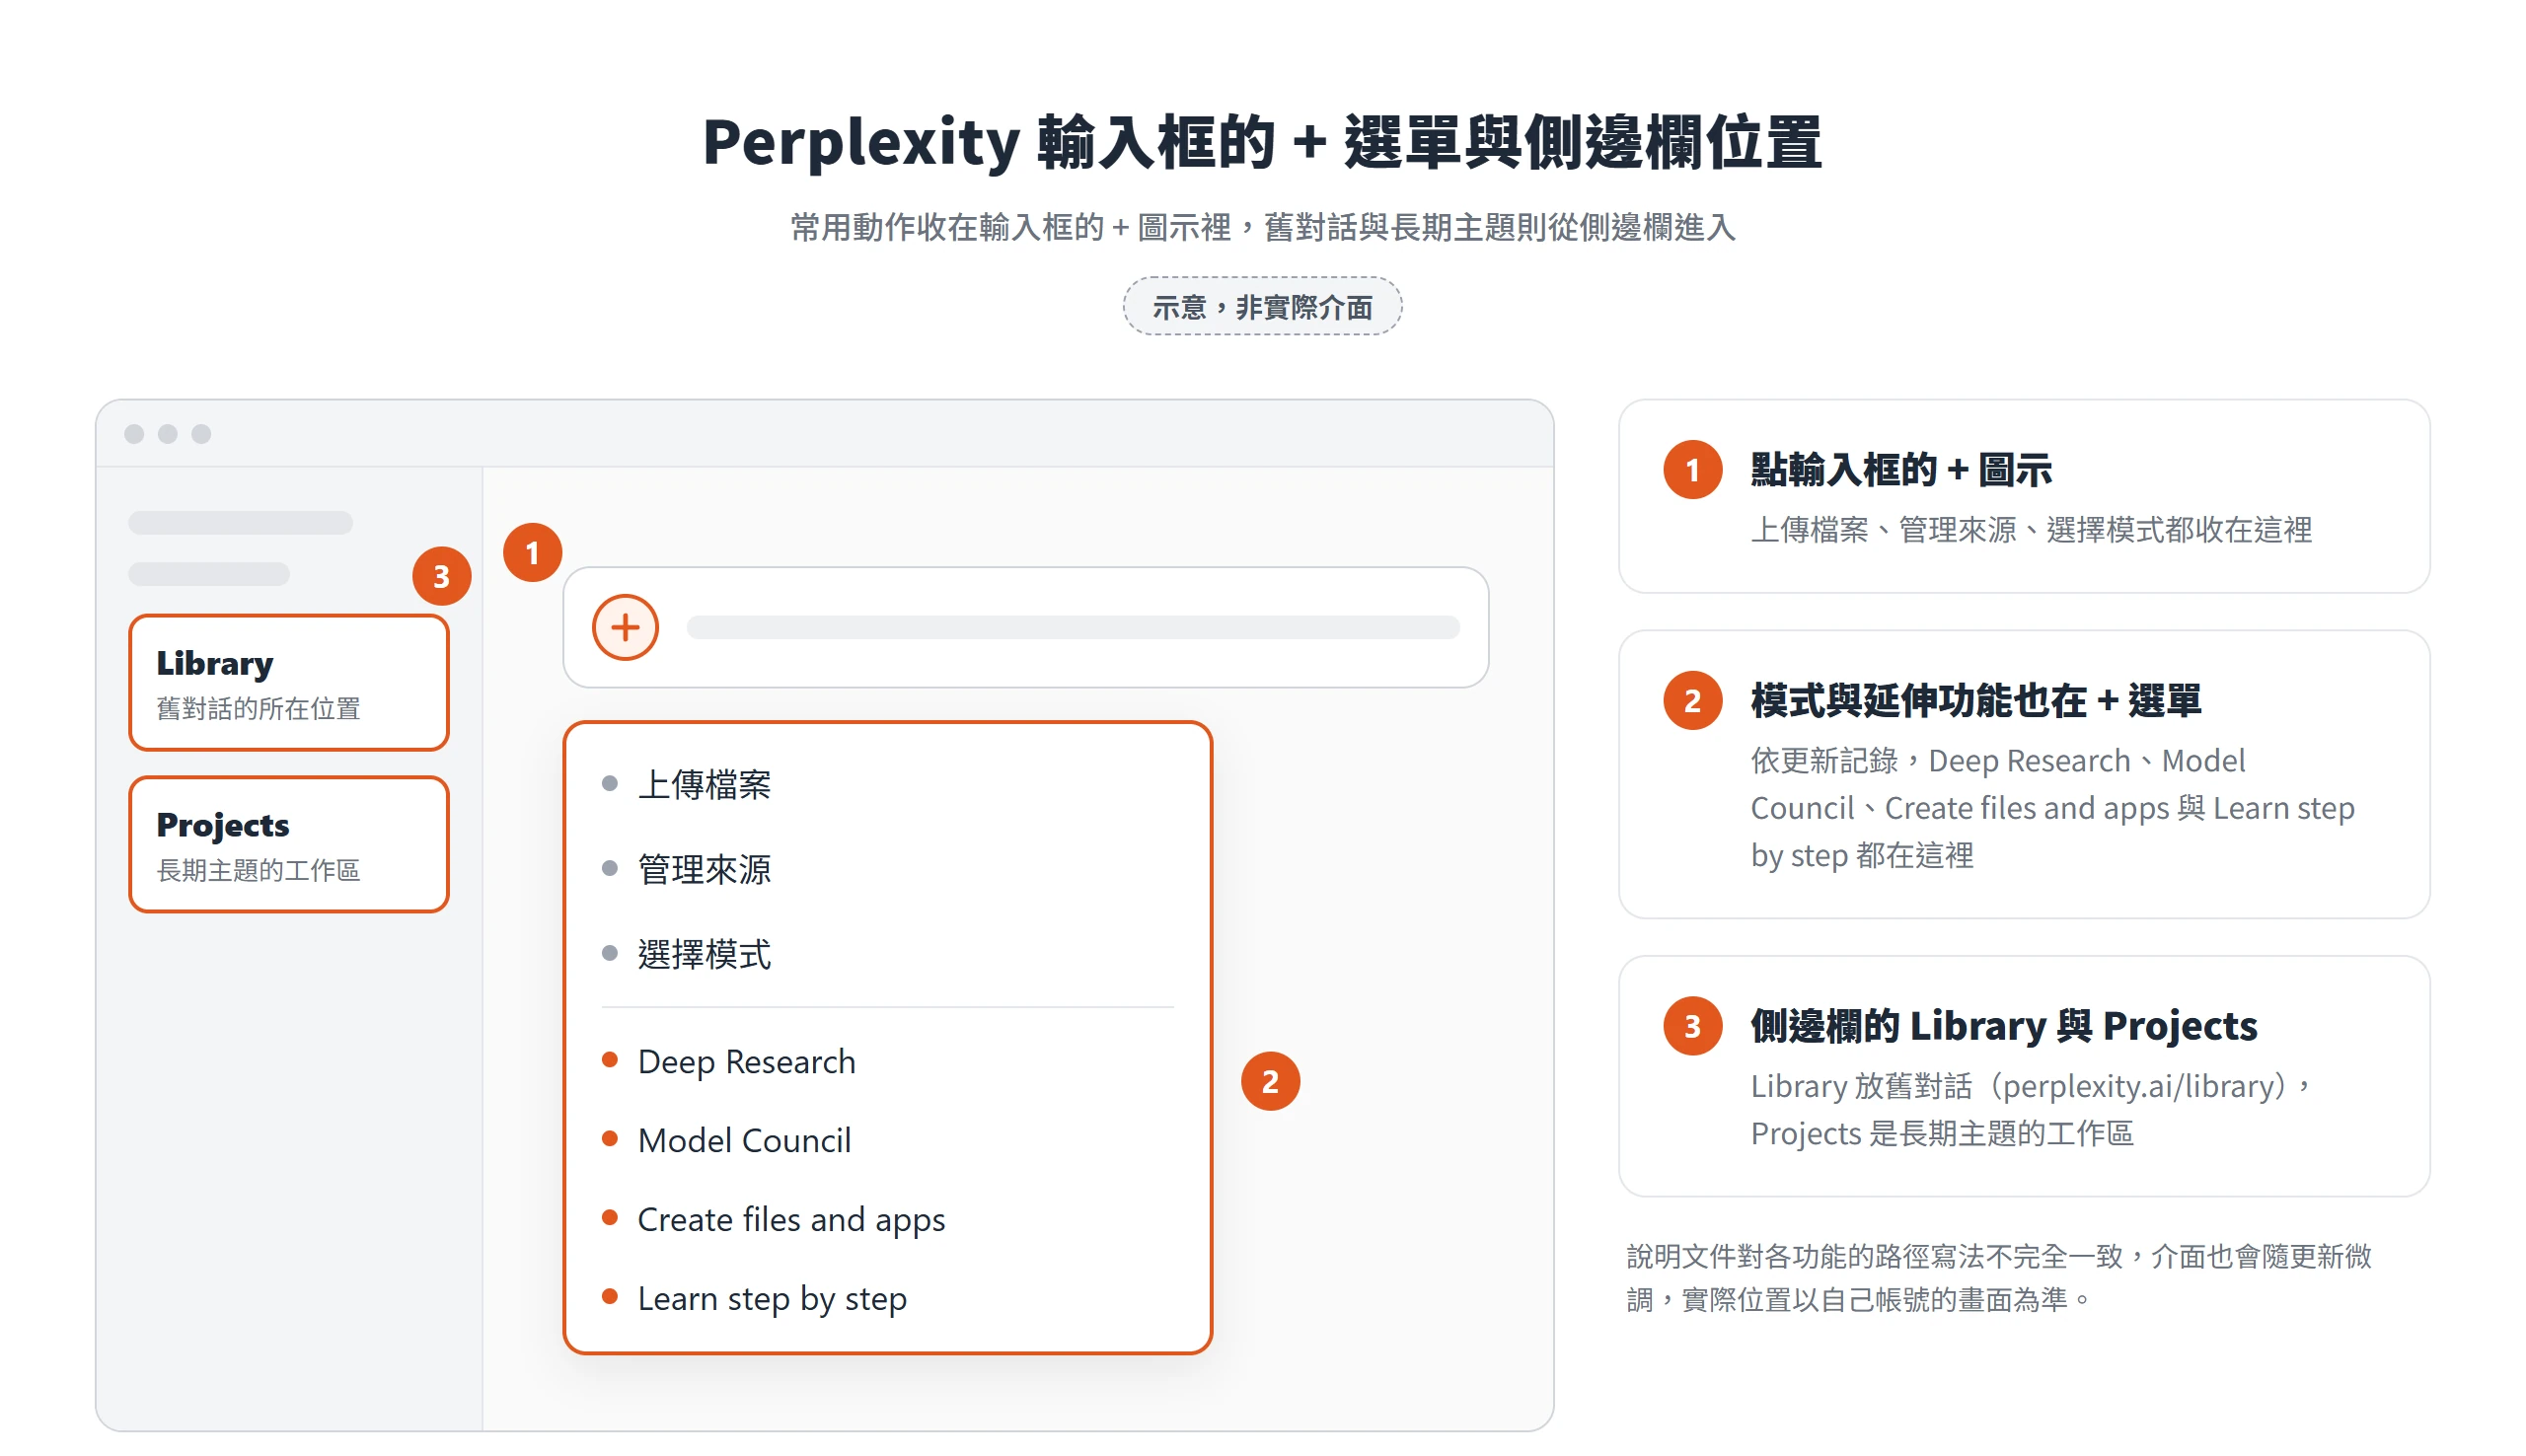
說明文件對各項功能的路徑寫法並不完全一致,例如 Model Council 的步驟,是寫成「點搜尋框下方的 Search 再選模式」。介面也會隨更新微調,所以遇到文字對不上的時候,以自己帳號畫面上實際看到的選項為準,再用功能名稱去找。
繁體中文的回答語言要在介面語言之外另外設定
台灣讀者最容易搞混的地方,是介面語言與回答語言其實是分開的兩項設定。
介面語言會依瀏覽器與作業系統的設定自動判斷,也可以在設定裡用下拉選單改。回答語言則是另一個選項,在 Preferences 裡叫 Preferred response language,決定 Perplexity 用哪一種語言回覆。設定入口是點畫面左下角的頭像,再從選單進入設定。手機上也能用繁體中文,2025 年 4 月的產品更新記錄已列出行動版 App 支援繁體中文。
用中文提問時,引用的網頁不一定是中文,所以點開來源編號時,看到英文頁面是正常的,答案本身仍會以中文呈現。如果發現回答的用字偏向簡體地區的習慣,可以在問題裡直接寫明「請用台灣慣用的繁體中文」,事先把要求說清楚,比事後逐字修改省事。要讓每次都照這個規則走,可以把 Projects 的指令欄固定寫上「用繁體中文回答,金額換算成新台幣」。
回答讀起來是否真的是台灣用語,仍得自己看過一遍,常見的簡體用語與核對方法可以另外對照。
向 Perplexity 提問時寫清楚意圖、背景、呈現形式
Perplexity 的說明文件把提問的核心原則寫成一句話:清楚說明意圖,並提供細節。給得越具體,答案越貼近需要,這個原則對搜尋模式與研究模式都適用。
具體的做法有四種。第一,不要只丟一個詞,與其只寫「inflation」,不如改寫成「美國目前的通膨率是多少」。第二,補上背景,說明自己是首次購屋者,再問有哪些補助,Perplexity 才知道要往哪個方向找。第三,放進關鍵詞,例如「通勤用、兩百美元以內的降噪耳機」,把預算、用途這些限制直接寫進去。第四,指定呈現的形式,是要摘要、表格、條列還是步驟。開頭也可以直接寫動作,像「搜尋」「建立簡報」,用平常說話的語言就夠了,不必刻意寫成什麼固定句型。
台灣讀者可以再多補三樣東西:地區、年份、想引用的來源類型。這三項不是 Perplexity 的指引,而是從它的運作方式推出來的寫法,因為它是即時搜尋網路,問題裡有地區與年份,搜尋範圍就會收得更窄,寫明來源類型則比較容易避開部落格與廣告型內容。
舉兩組例子說明差別。第一組,籠統問法是「台灣老年人口比例」,具體問法是「台灣 65 歲以上人口占總人口的比例,用主管機關的統計,並標出統計年份」。後者把來源類型與年份都寫進去,點開引用之後,要核對也容易得多。第二組,籠統問法是「幫我找降噪耳機」,具體問法是「通勤搭捷運用、預算 3,000 元內、要能接電話的降噪耳機,用表格列出重量與續航力」。兩者的差別在於,後者已經替 Perplexity 把要比較的欄位定好了。
兩個例子都是依說明文件的原則改寫的示範,實際答案會隨當時搜尋到的網頁而不同,照抄不一定會得到一樣的結果。具體問法還有一個好處,問題本身已經寫明年份與來源類型,點開引用時,很快就能判斷那一頁對不對得上。
追問讓同一串對話越問越深
追問是 Perplexity 的核心用法,也是它跟一次性搜尋最大的不同。在同一個對話裡,系統記得前面問過什麼、答過什麼,所以不必每次重述背景。
說明文件現在把一串對話稱為 session,舊教學寫的 thread 指的是同一件事。每個 session 會包含最初的問題、所有追問、所有回覆,以及用到的所有來源。
系統建議的追問與自己下的追問
每個答案底下都會附幾個系統建議的追問,點一下就能送出,不想用的話也可以自己輸入。自己追問時,搜尋模式、來源、附件與語音都能搭配,不必另開新對話。Research 執行到一半時,也可以直接追加問題,不需要等報告完成。
追問的價值在於把答案打磨到可用,而不是重複問同一件事。拿「台灣 65 歲以上人口占總人口的比例」這個問題來說,得到答案之後,至少有三種追問各解決不同的問題。「這個比例是哪一年的統計」解決的是年份不明,因為統計數字會隨年度更新,沒標年份的答案不能直接引用。想看趨勢,可以接著要求「改用表格列出近 5 年」,處理的是呈現方式,表格比一段文字清楚。最後一種是「只看主管機關公布的資料」,針對來源品質,把範圍收窄到原始統計單位。
這三種追問的共通點,是每一次都針對上一個答案裡讓人不放心或不好用的地方下指令,而不是泛泛地說「再詳細一點」。
換主題或換來源範圍時另開新對話
同一個 session 擅長延伸同一個主題。Perplexity 的說明文件指出,在同一個對話中頻繁換題目時,它可能需要額外的引導才不會跑偏。判斷標準很簡單:主題換了,或需要的來源類型換了,就另開新對話。
來源範圍也是同樣的道理。舊版的 Focus 聚焦模式,說明文件的寫法是同一個對話中途不能切換,要用就在新對話開頭啟用;現行介面把這項功能改以來源選單呈現,是否仍有相同限制要看實際畫面。比較穩當的做法是,需要換來源範圍時,一律從新對話的第一個問題開始選。
另開新對話不會丟掉舊對話,舊的那一串仍在 Library 裡,之後想接著問還是可以回去。
對話紀錄放在 Library,保存期限依類型而異
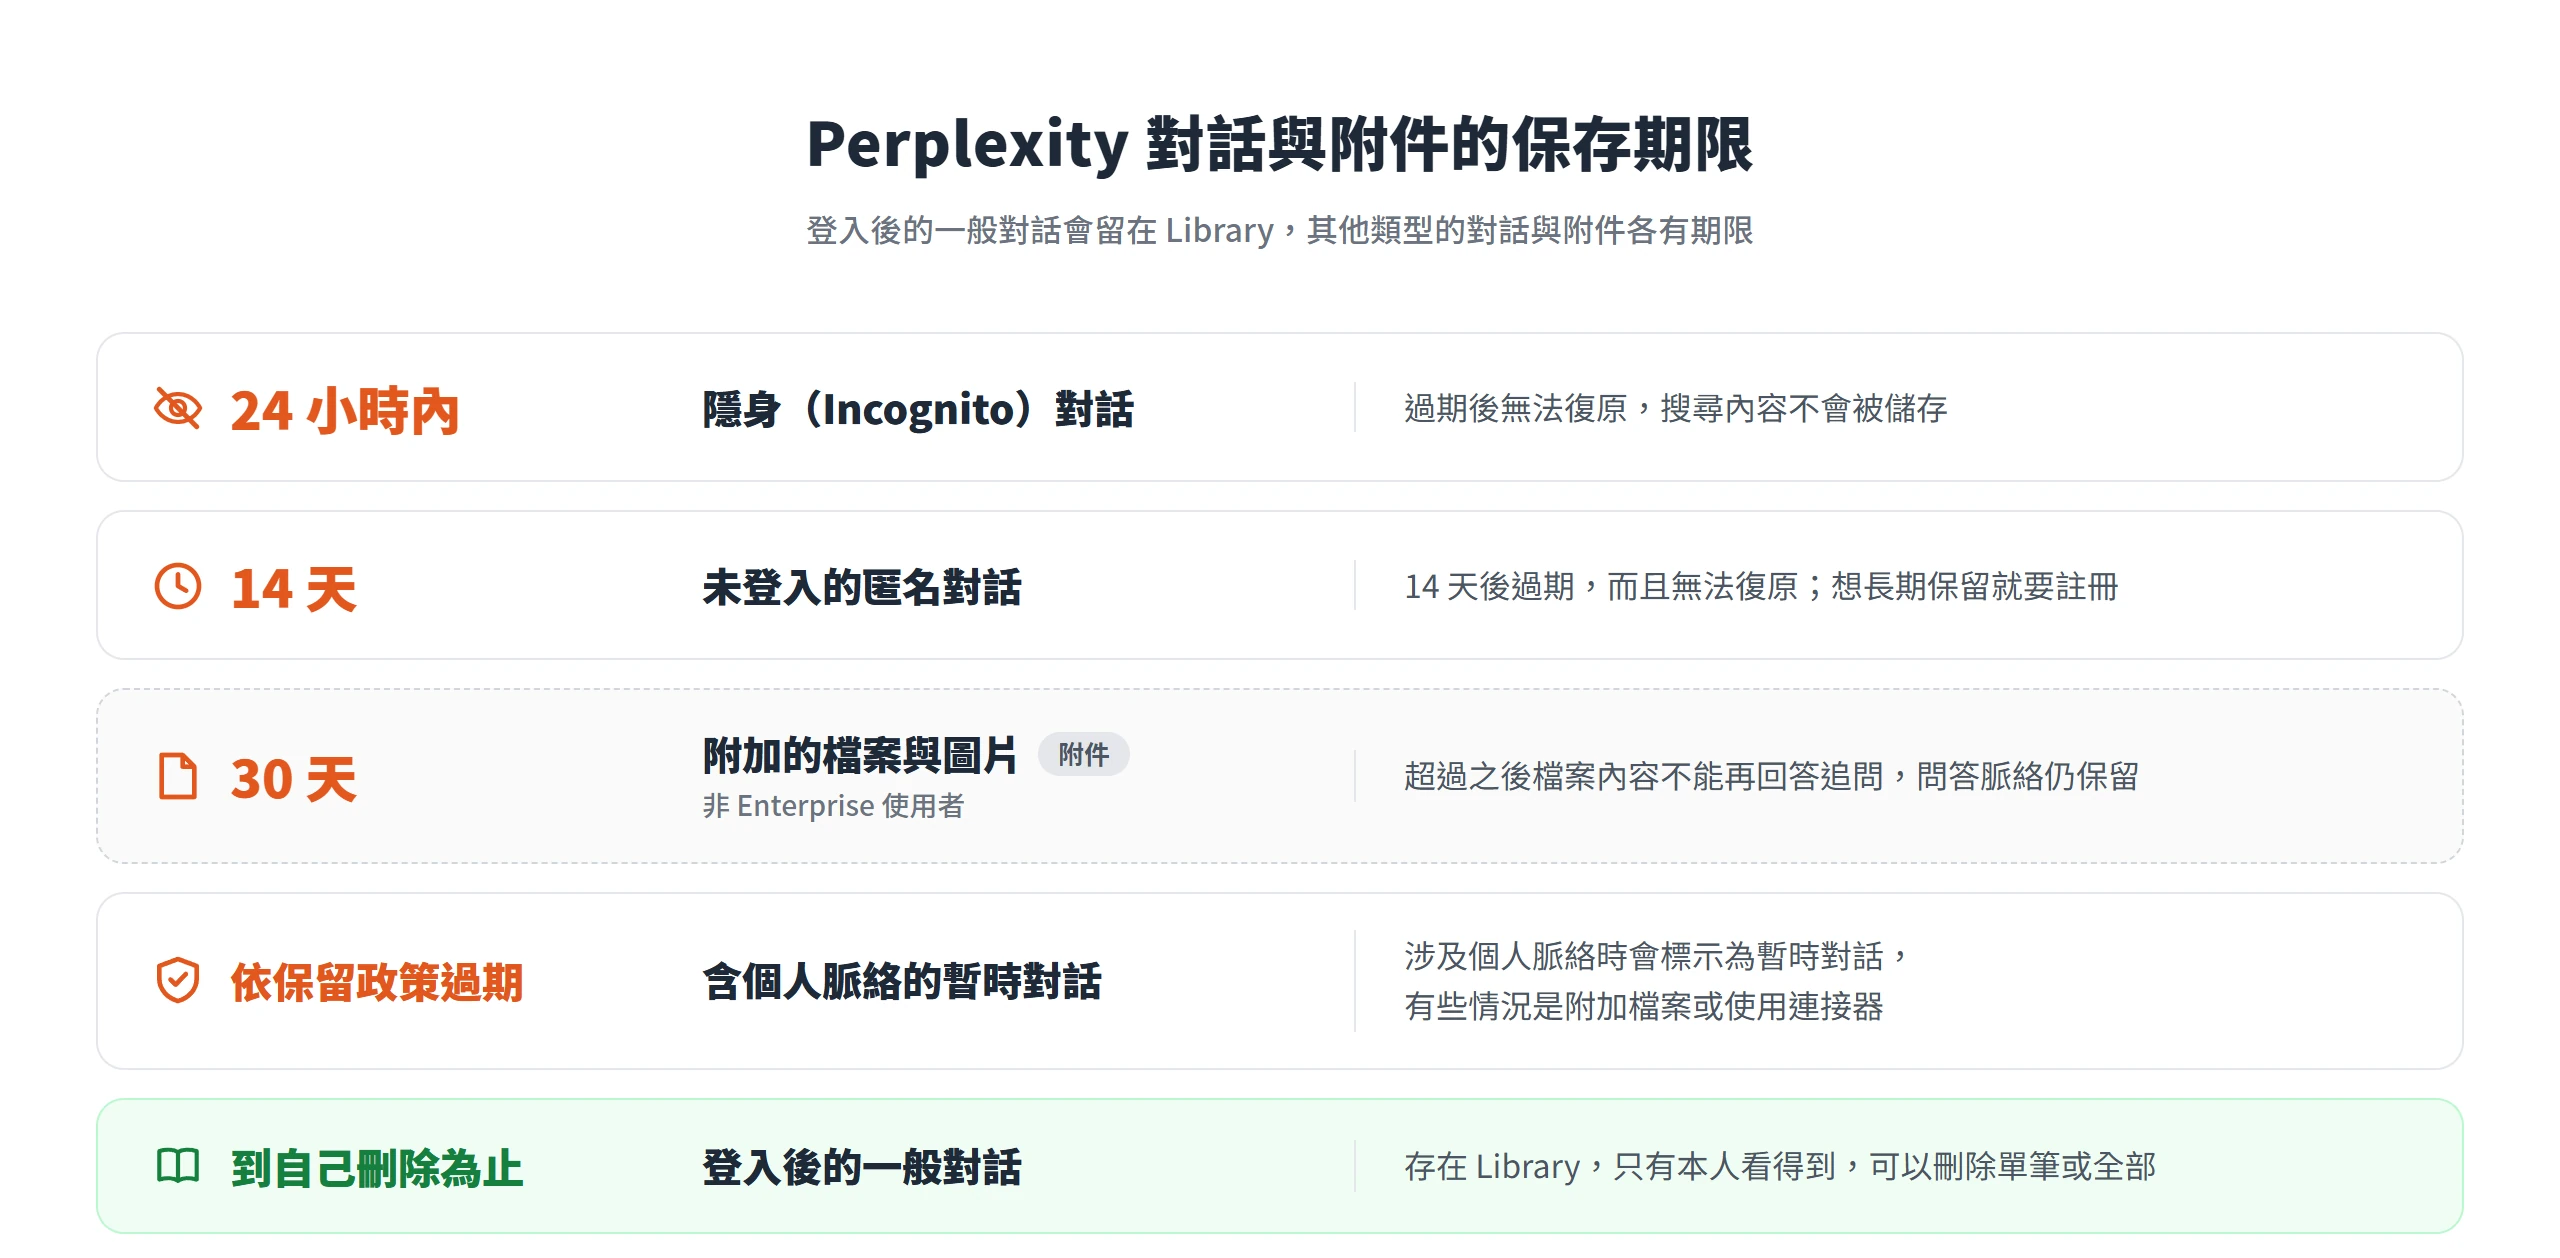
登入之後的對話都放在 Library,只有本人看得到,也可以自行刪除單筆或全部。不同類型的對話,保存規則也不一樣:
| 對話類型 | 保存方式 |
|---|---|
| 登入後的一般對話 | 存在 Library,保存到使用者自己刪除為止 |
| 未登入的匿名對話 | 14 天後過期,無法復原 |
| 隱身(Incognito)對話 | 24 小時內過期,無法復原,搜尋內容不會被儲存 |
| 含個人脈絡的暫時對話 | 涉及個人脈絡時會標示為暫時對話,有些情況是附加檔案或使用連接器,會依隱私與資料保留政策過期 |
另外要分清楚「對話」與「附件」的期限。非 Enterprise 使用者附加的檔案與圖片,保存 30 天,超過之後,檔案內容就不能再拿來回答追問,不過先前的問答脈絡仍然保留在那個 session 裡。換句話說,一個月前上傳的文件,現在追問時要重新上傳一次。
隱身對話適合不想留紀錄的問題;至於資料是否用於訓練,是另一項獨立的設定,要到設定頁另外調整。
搜尋、Research 與 Model Council 的使用時機
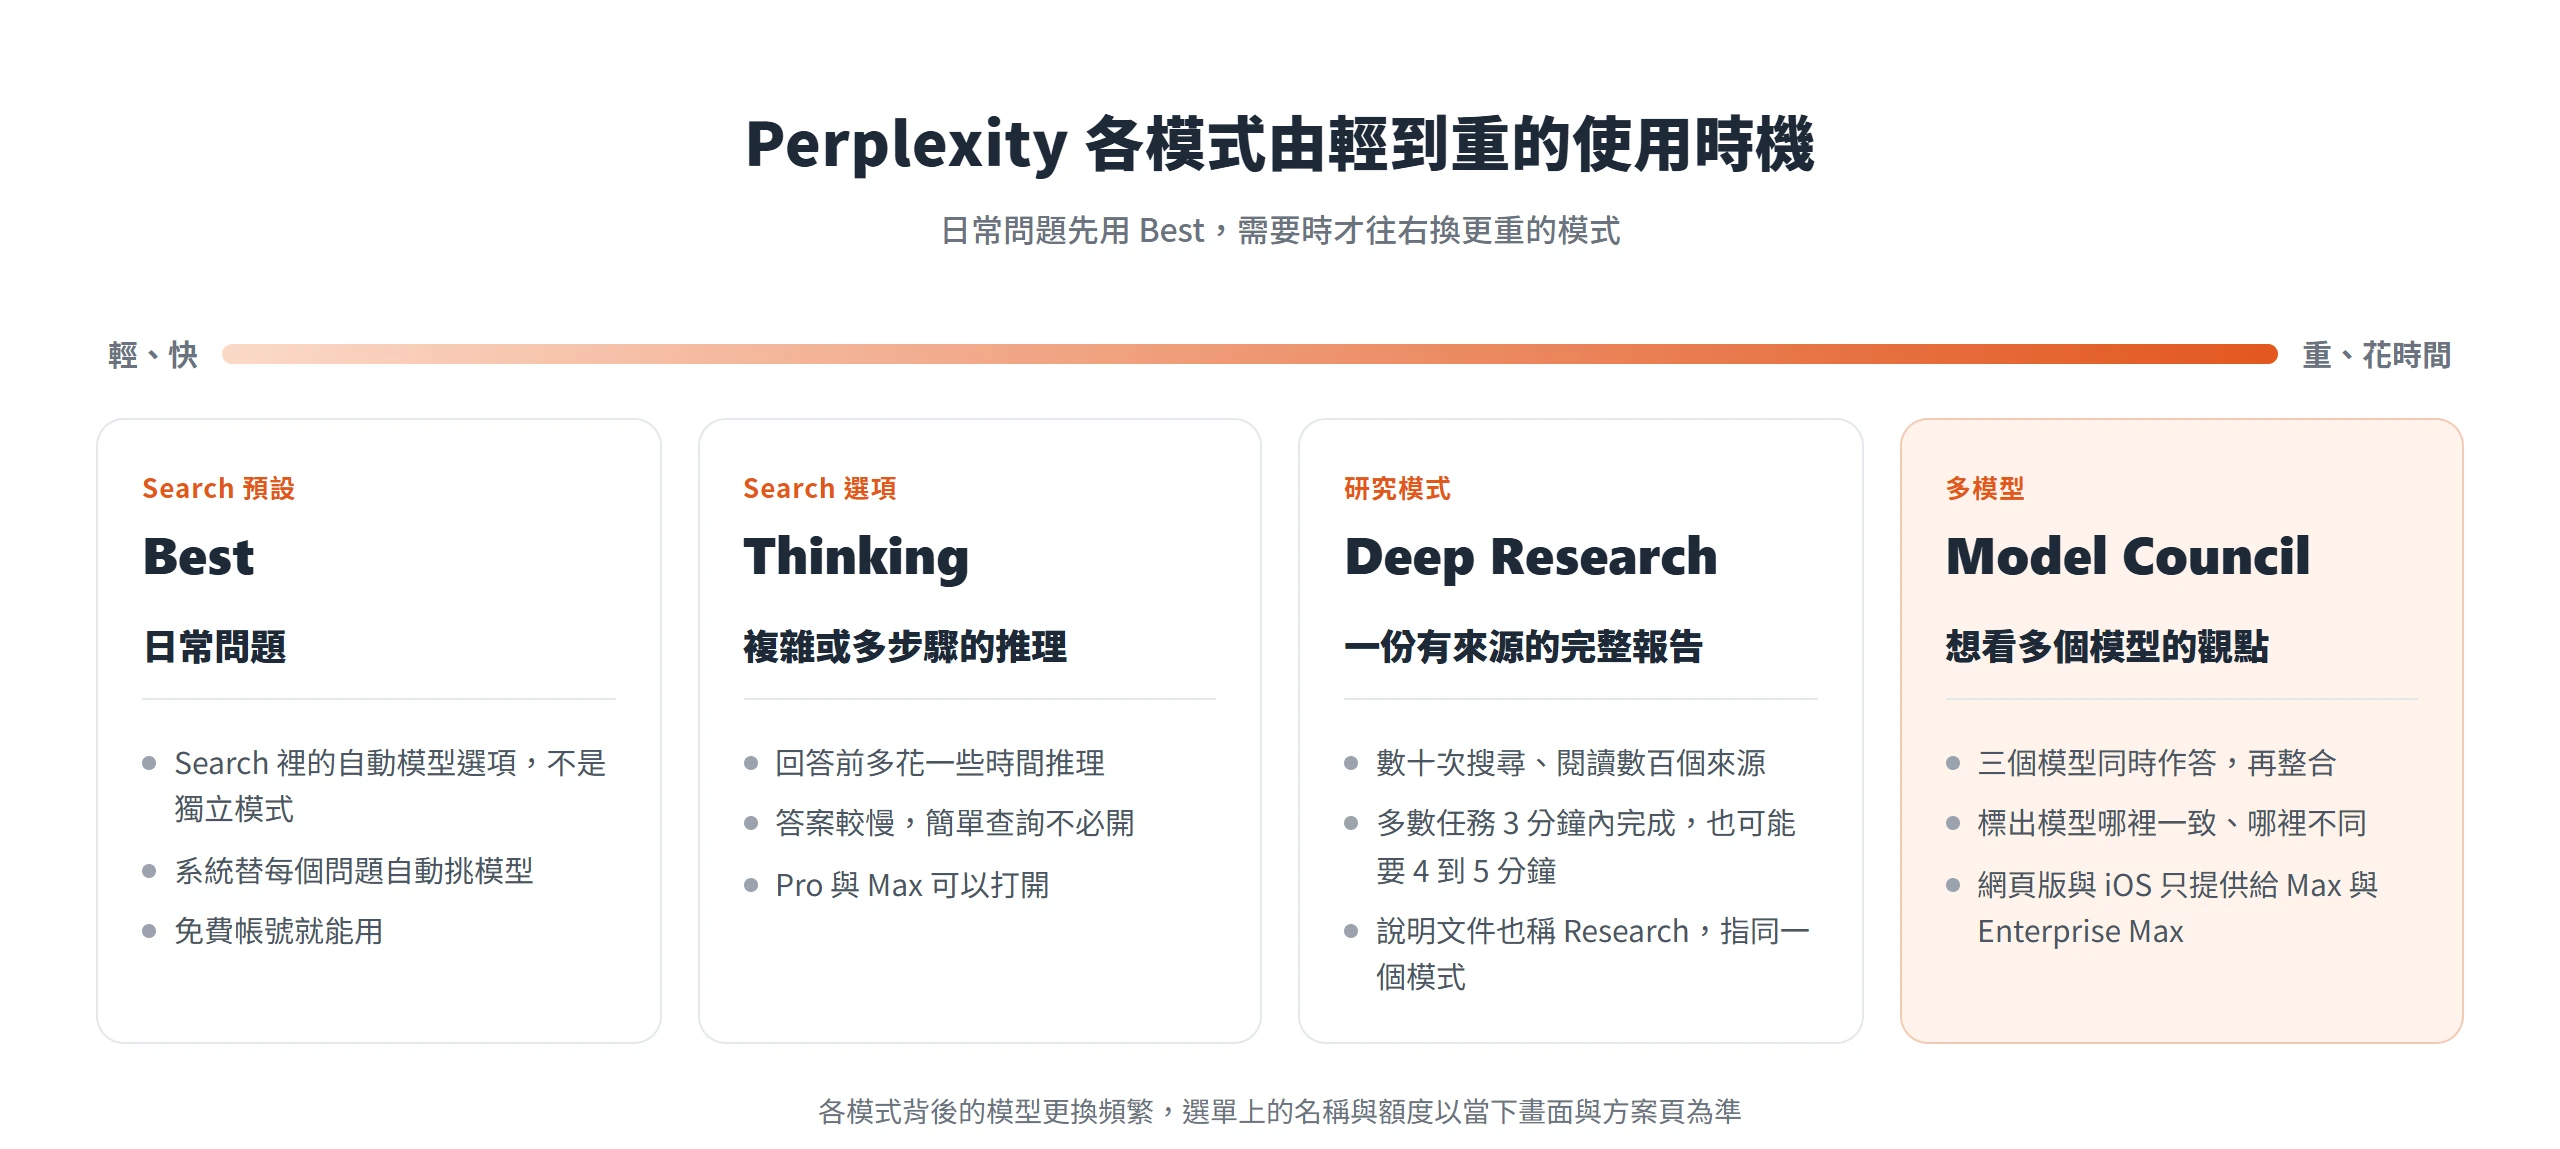
模式一多,很容易想把每個問題都交給最強的那一個。Perplexity 的說明文件則給了一個由輕到重的順序:日常問題用 Best,需要複雜推理時開 Thinking,要一份完整報告用 Deep Research,想看多個模型的觀點才用 Model Council。
要注意的是,同一件事在說明文件裡的稱呼並不統一,Research 與 Deep Research 並存,指的是同一個研究模式。實際畫面以自己帳號上的名稱為準。
預設搜尋裡的 Best、Thinking 和 Pro Search
預設的 Search 模式搭配 Best 選項,系統會替每個問題自動挑合適的模型。Best 並不是獨立的模式,而是 Search 裡的自動模型選項,使用者不必自己決定要用哪一個。
免費帳號可以用 Best,也有有限次數的 Pro Search,但無法手動選進階模型;Pro 與 Max 則可以針對每次查詢指定偏好的模型,也能打開 Thinking,讓模型回答前多花一些時間推理。Thinking 適合複雜或多步驟的問題,代價是答案會慢一些,所以簡單的事實查詢不需要開。
Pro Search 是輸入框裡針對複雜問題的多步驟搜尋,會把問題拆成幾個小步驟,再從更多來源整理結果。它有次數限制,說明文件在不同頁面給的免費額度並不一致,實際次數以方案頁當下的說明為準。各模式背後用的模型也更換得很頻繁,選單上的模型名稱以當下畫面為準。
Research 會花數分鐘讀完大量網頁再交出報告
當你要的是「一份有來源的完整報告」,而不是一個答案時,才輪到 Research。依說明文件,它會進行數十次搜尋、閱讀數百個來源,對資料推理之後,自主交付完整報告。說明文件寫多數研究任務在 3 分鐘內完成,也提醒一次回覆可能要 4 到 5 分鐘,所以不適合拿來問即時的小問題。
遇到範圍很廣的題目,Research 會在開始前先問幾個釐清問題,讓第一次產出的結果更貼近需要,研究進行中也能追加問題。模型由系統自動挑選,使用者不能手動指定。免費方案可以使用,次數有限,付費方案的額度較高,確切次數以方案頁為準。完成後的報告可以匯出成 PDF 或文件。
2026 年 6 月 11 日,Perplexity 宣布 Deep Research 也進入了 Computer。報告裡每個事實性說法都帶有行內的編號引用,連到實際的來源網址,產出的結果還能接著做成簡報、儀表板或網站。需要把研究結果變成交付物時,這是比單純看報告更完整的路徑,不過它也歸在 Computer 的使用範圍裡。
Model Council 讓三個模型各答一次再整合
Model Council 把同一個問題同時交給三個模型,再由一個整合模型讀完所有輸出,產出一份答案,並指出模型之間哪裡一致、哪裡不同。它適合投資研究、複雜決策、創意發想,以及需要驗證的情境,因為多個模型的共識與分歧,本身就是一種參考。
使用方式是到首頁,點搜尋框下方的 Search 選單,選 Model Council,輸入問題送出。網頁版固定使用三個模型,預設是 Anthropic、OpenAI、Google 各一個旗艦模型,可以在搜尋框切換,每個模型也能分別開啟 Thinking。
資格上要特別留意,網頁版與 iOS 只提供給 Max 與 Enterprise Max 方案,Free、Pro 等方案在網頁版不能使用,而且網頁版每月有查詢次數上限。不過在 Computer 裡,它以技能的形式提供給所有付費方案,可以選 2 到 8 個模型,並以點數計費。
附上來源的答案仍需要自己查證
前面提到的每一種模式,共通的特色都是附上來源。但「有來源」與「答案對」是兩件事。Perplexity 把查證變得比較容易,卻沒有替使用者完成查證。
點開來源編號後核對原文的三件事
查證的第一步是把「有出處」落實成一個動作:點答案裡的編號,打開來源頁,檢查三件事。
第一,那一頁是否真的出現這個說法或數字。第二,頁面的發表與更新日期是什麼,是否過時。第三,它是原始出處,還是別人整理的二手文章。這三項是從使用方式整理出來的做法,不是 Perplexity 的指引。
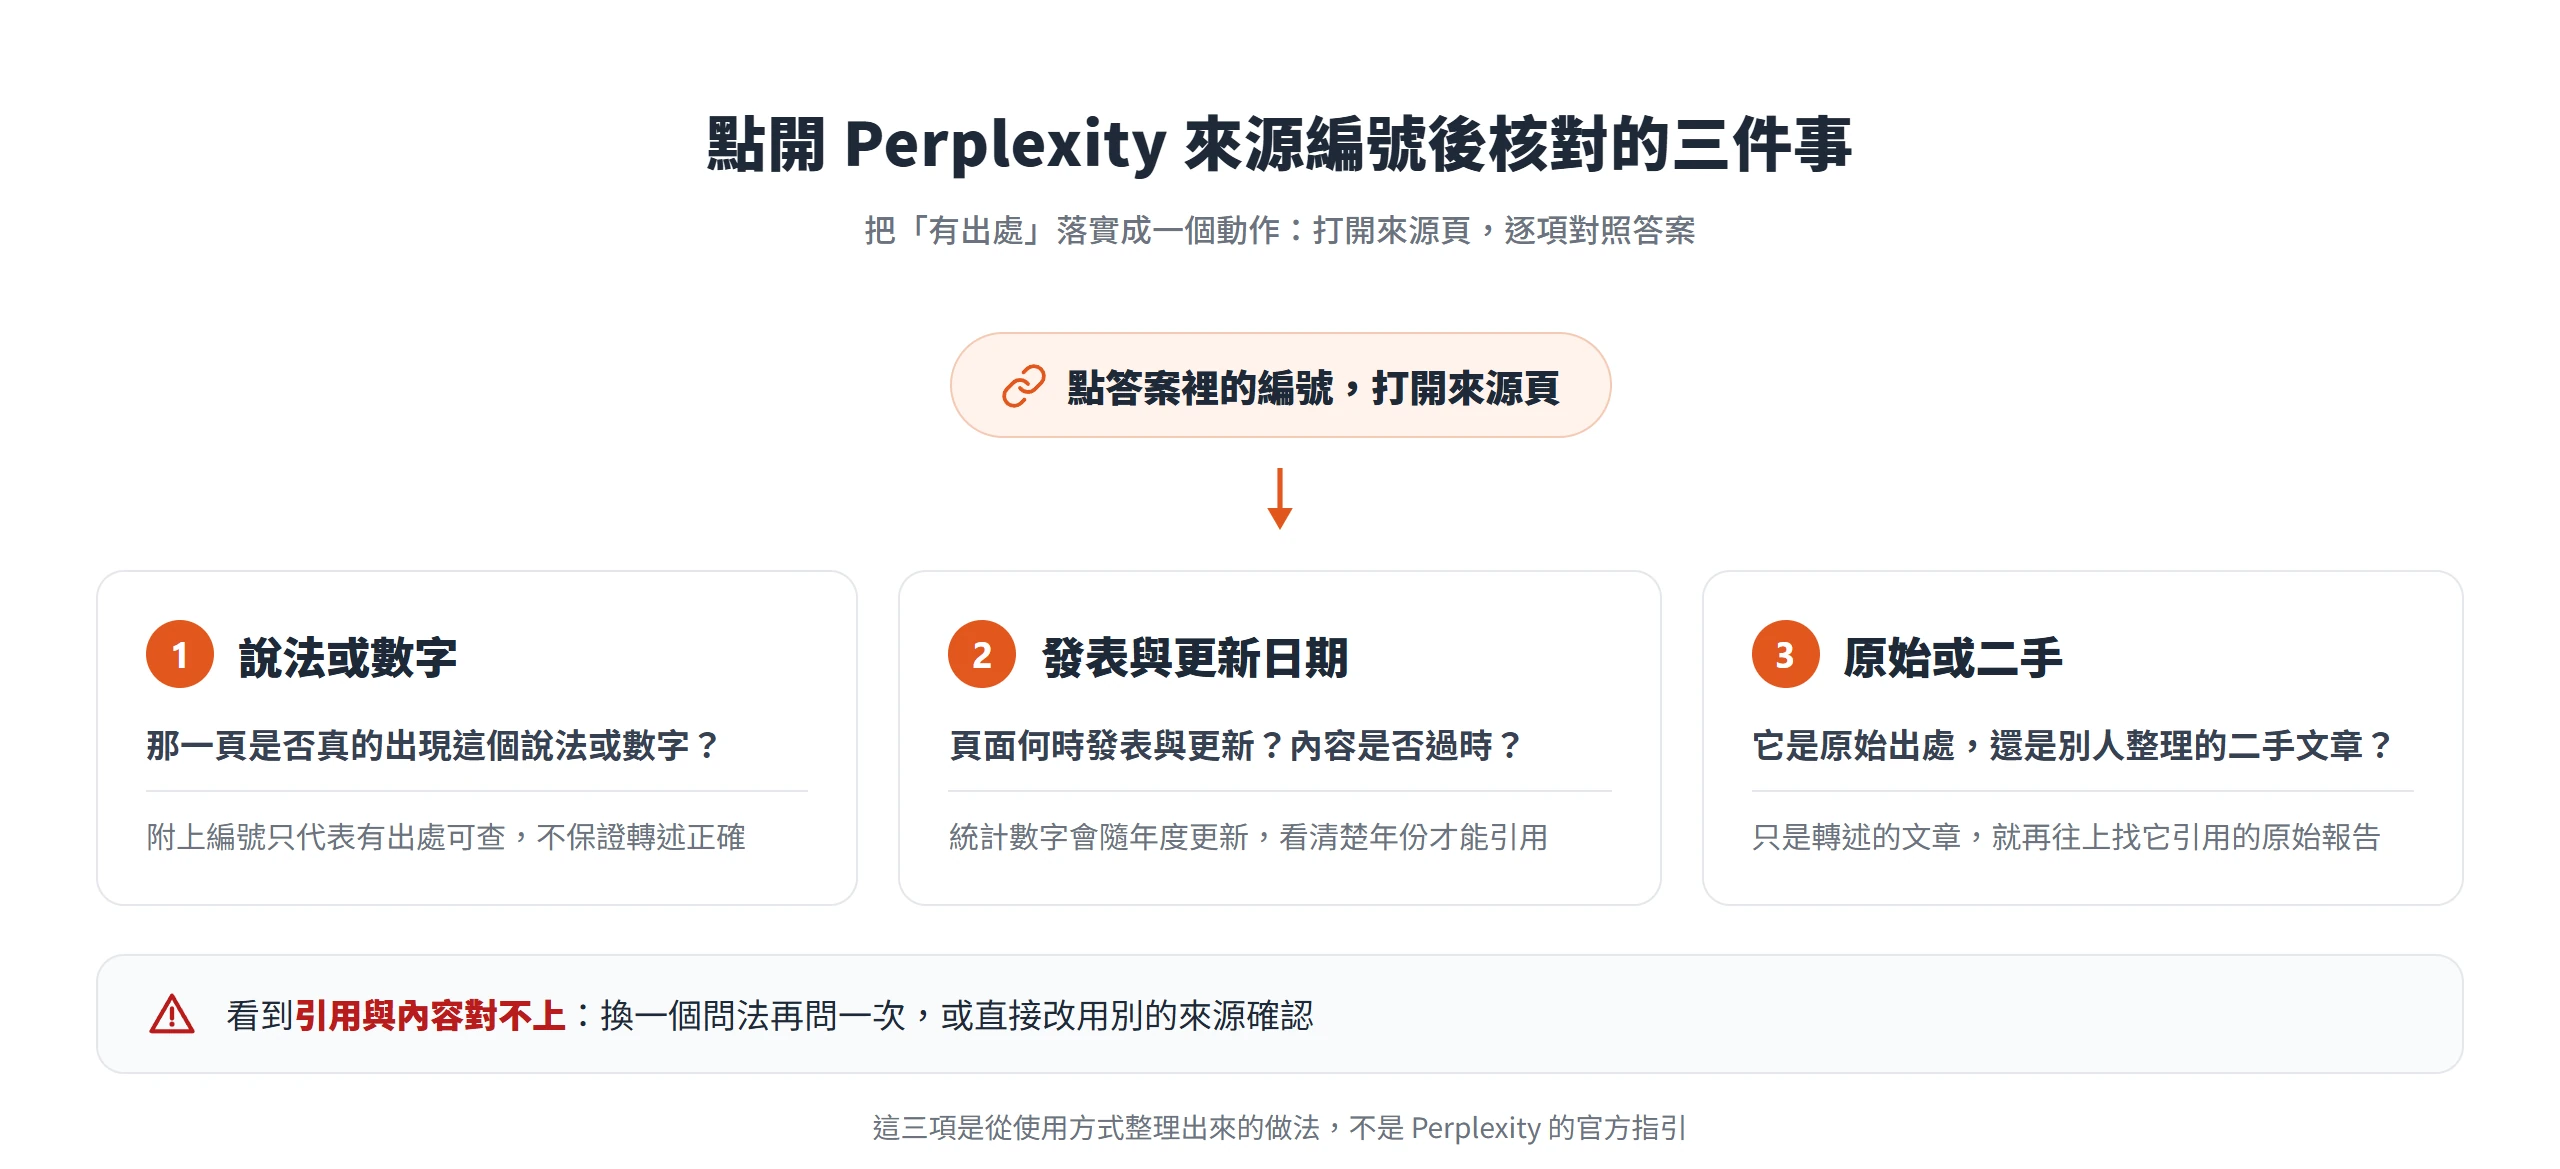
舉例來說,答案寫了某項統計是 X,你點開對應的編號,如果來源頁是統計機構本身,就看數字與年份對不對得上;如果只是一篇轉述的文章,就再往上找它引用的原始報告。如果看到引用與內容對不上,可以換一個問法再問一次,或直接改用別的來源確認。
來源標籤 Government、Academic、Trusted 的意義和限制
現在部分引用旁邊會出現盾牌圖示,並帶有三種標籤之一:Government、Academic 或 Trusted。
Government 指政府機關的正式網站,Academic 指科學類網站,Trusted 則是範圍較廣的類別,指在結果中出現頻率夠高、並在自身專業領域發布資訊的網站。標籤評的是整個網站,而不是單一頁面或單一句話。評定時會檢查幾個客觀的問題,例如網站是否更正自己的錯誤、是否標明各篇的作者、是否把新聞與廣告和意見分開。
這個標籤有幾點要分清楚。Perplexity 的合作夥伴關係、付費與其他商業安排,都不影響標籤。多數網站沒有標籤,沒有標籤不代表品質差,只是尚未評定。標籤也不是對網站內容的背書,意思是「這個網站符合某些客觀條件」,不是「這一頁的這句話一定正確」。所以它可以用來快速判斷來源類型,不能拿來取代點開來源頁核對。
兩項國際研究都發現 AI 搜尋的引用會出錯
AI 搜尋的引用需要核對,不只是理論上的提醒,兩份國際研究都實際檢驗過 AI 工具引用新聞的情形。
第一份是哥倫比亞新聞評論(CJR)的 Tow Center 在 2025 年 3 月 6 日發表的測試。研究者測試 8 個生成式搜尋工具,共 1,600 次查詢:從 20 家出版商各隨機抽 10 篇文章,擷取原文段落,請工具指出文章標題、原出版商、發表日期與網址。整體來看,這些工具有超過 60% 的查詢回答不正確;其中 Perplexity 免費版有 37% 答錯。研究還發現,付費版 Perplexity Pro 答對的題數比免費版多,但錯誤率反而更高,原因是它傾向給出肯定卻錯誤的答案,而不是直接拒答。
這項測試的範圍很窄,只限於「新聞文章的出處歸屬」,而且是 2025 年 3 月的快照,不能外推成 Perplexity 整體的準確率。
第二份是歐洲廣播聯盟(EBU)在 2025 年 10 月發表的〈News Integrity in AI Assistants〉。研究由 22 個公共媒體機構參與,涵蓋 18 個國家與 14 種語言,由記者評估超過 3,000 則 ChatGPT、Copilot、Gemini 與 Perplexity 的回答。結果是近半數的回答至少有一項重大問題,約三分之一有嚴重的出處問題,約五分之一有重大的準確性問題,包含幻覺與過時資訊。這項研究的對象是新聞內容,上述數字是所有受測 AI 助手合計的結果,不是針對某一個工具。
兩份研究放在一起,指向同一件事:不論用哪一種 AI 搜尋,引用都需要自己核對。
重要資訊從追問出處到回原始網站的查證順序
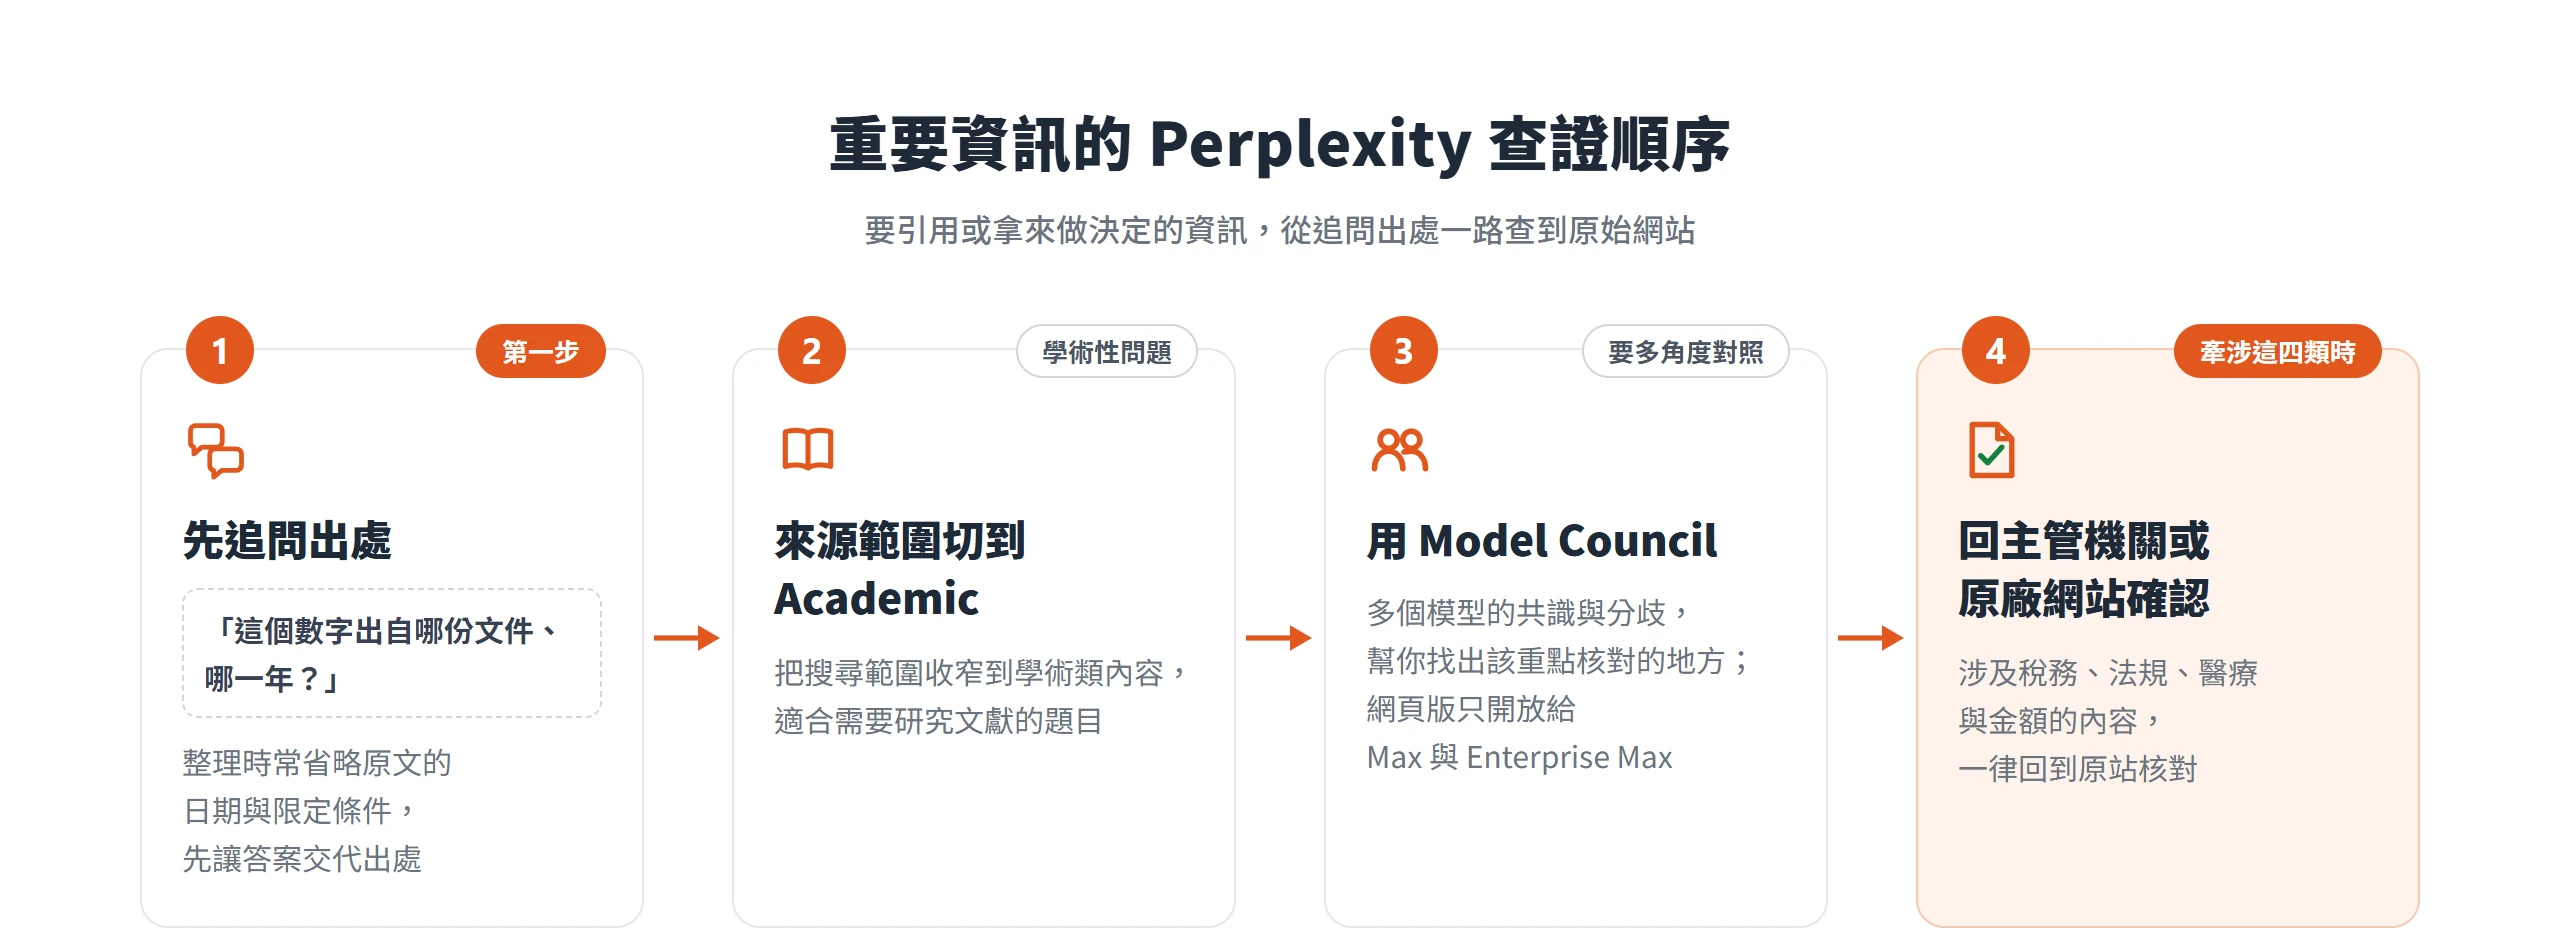
遇到需要引用或要拿來做決定的資訊,可以依下面的順序查證。
先追問出處。直接問「這個數字出自哪份文件、哪一年」,因為答案是整理過的,原文的日期與限定條件在整理時常被省略。這一步能讓答案交代出處,也方便後面核對。
學術性的問題,把來源範圍切到 Academic。輸入框可以選來源類型,包含一般網頁(Web)與 Academic,後者把搜尋範圍收窄到學術類內容,適合需要研究文獻的題目。實際選單的名稱與選項,以畫面為準。
要多角度對照,就用 Model Council。它的適用情境包含驗證,多個模型的共識與分歧可以幫你找出該重點核對的地方。不過它在網頁版只開放給 Max 與 Enterprise Max 方案,其他付費方案需要在 Computer 裡使用。
最後,凡是牽涉到稅務、法規、醫療與金額的內容,一律回到主管機關或原廠的網站確認。原因在於 Perplexity 給的是整理後的答案,不是原件,標籤與引用都不能代替這一步。
由 Spaces 改名而來的 Projects 集中管理長期主題
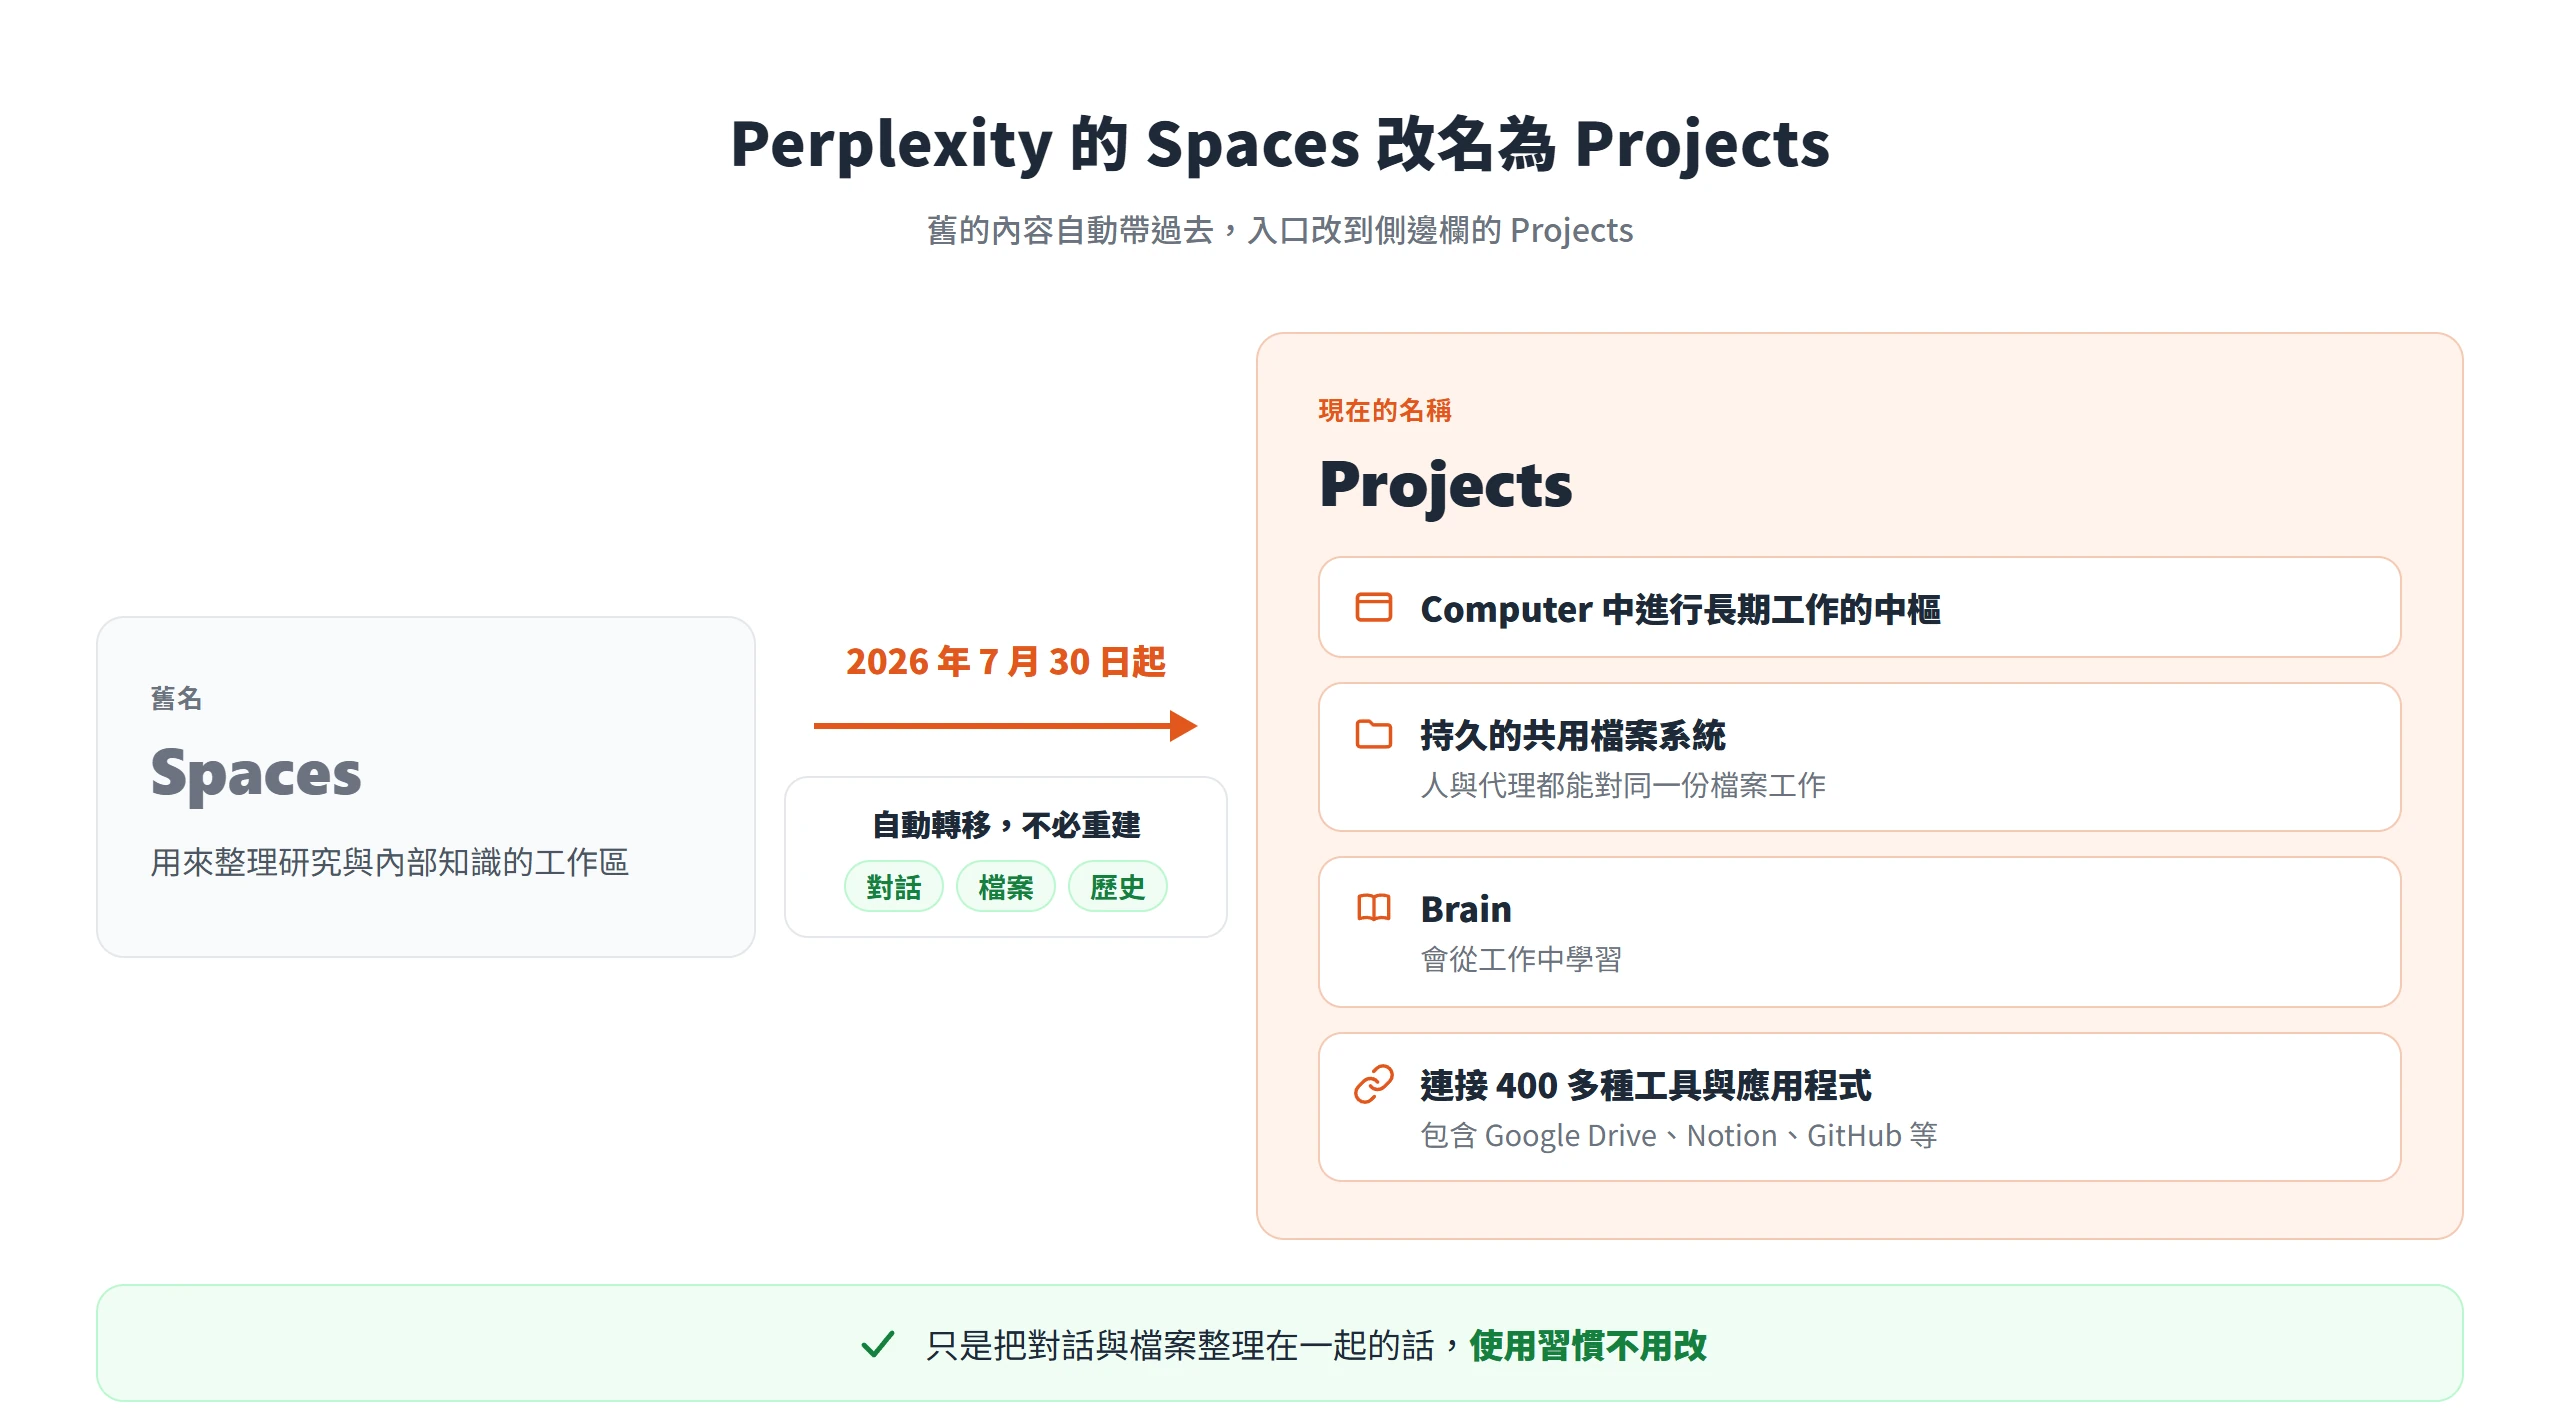
2026 年 7 月 30 日起,Spaces 改名為 Projects。如果你是從舊教學搜到 Spaces 的操作方式,現在對應的位置就是側邊欄的 Projects。
Projects 適合需要長期處理的主題,例如追蹤某個產業的動態,或準備一份得花幾週完成的報告。把相關的對話、檔案與指令集中在一處,每次回來都不用從頭交代背景。Perplexity 宣布 Projects 開放給所有 Computer 使用者,而 Computer 需要付費訂閱,免費帳號是否能建立,以實際畫面為準。
舊 Spaces 自動轉移,不必重建
Spaces 原本是用來整理研究與內部知識的工作區。改名成 Projects 之後,原有的對話、檔案與歷史都會自動帶過去,使用者不用重新設定。
這次改動也不只是換名字。Projects 現在被定位為 Computer 中進行長期工作的中樞,每個 Project 有持久的共用檔案系統,人與代理都能對同一份檔案工作;另外還有一個會從工作中學習的 Brain。Projects 也能連接 400 多種工具與應用程式,包含 Google Drive、Notion、GitHub 等。
若只是延續舊 Spaces 的用法,也就是把對話與檔案整理在一起,改名之後的使用習慣不用改。
建立 Project 的入口與專屬指令寫法
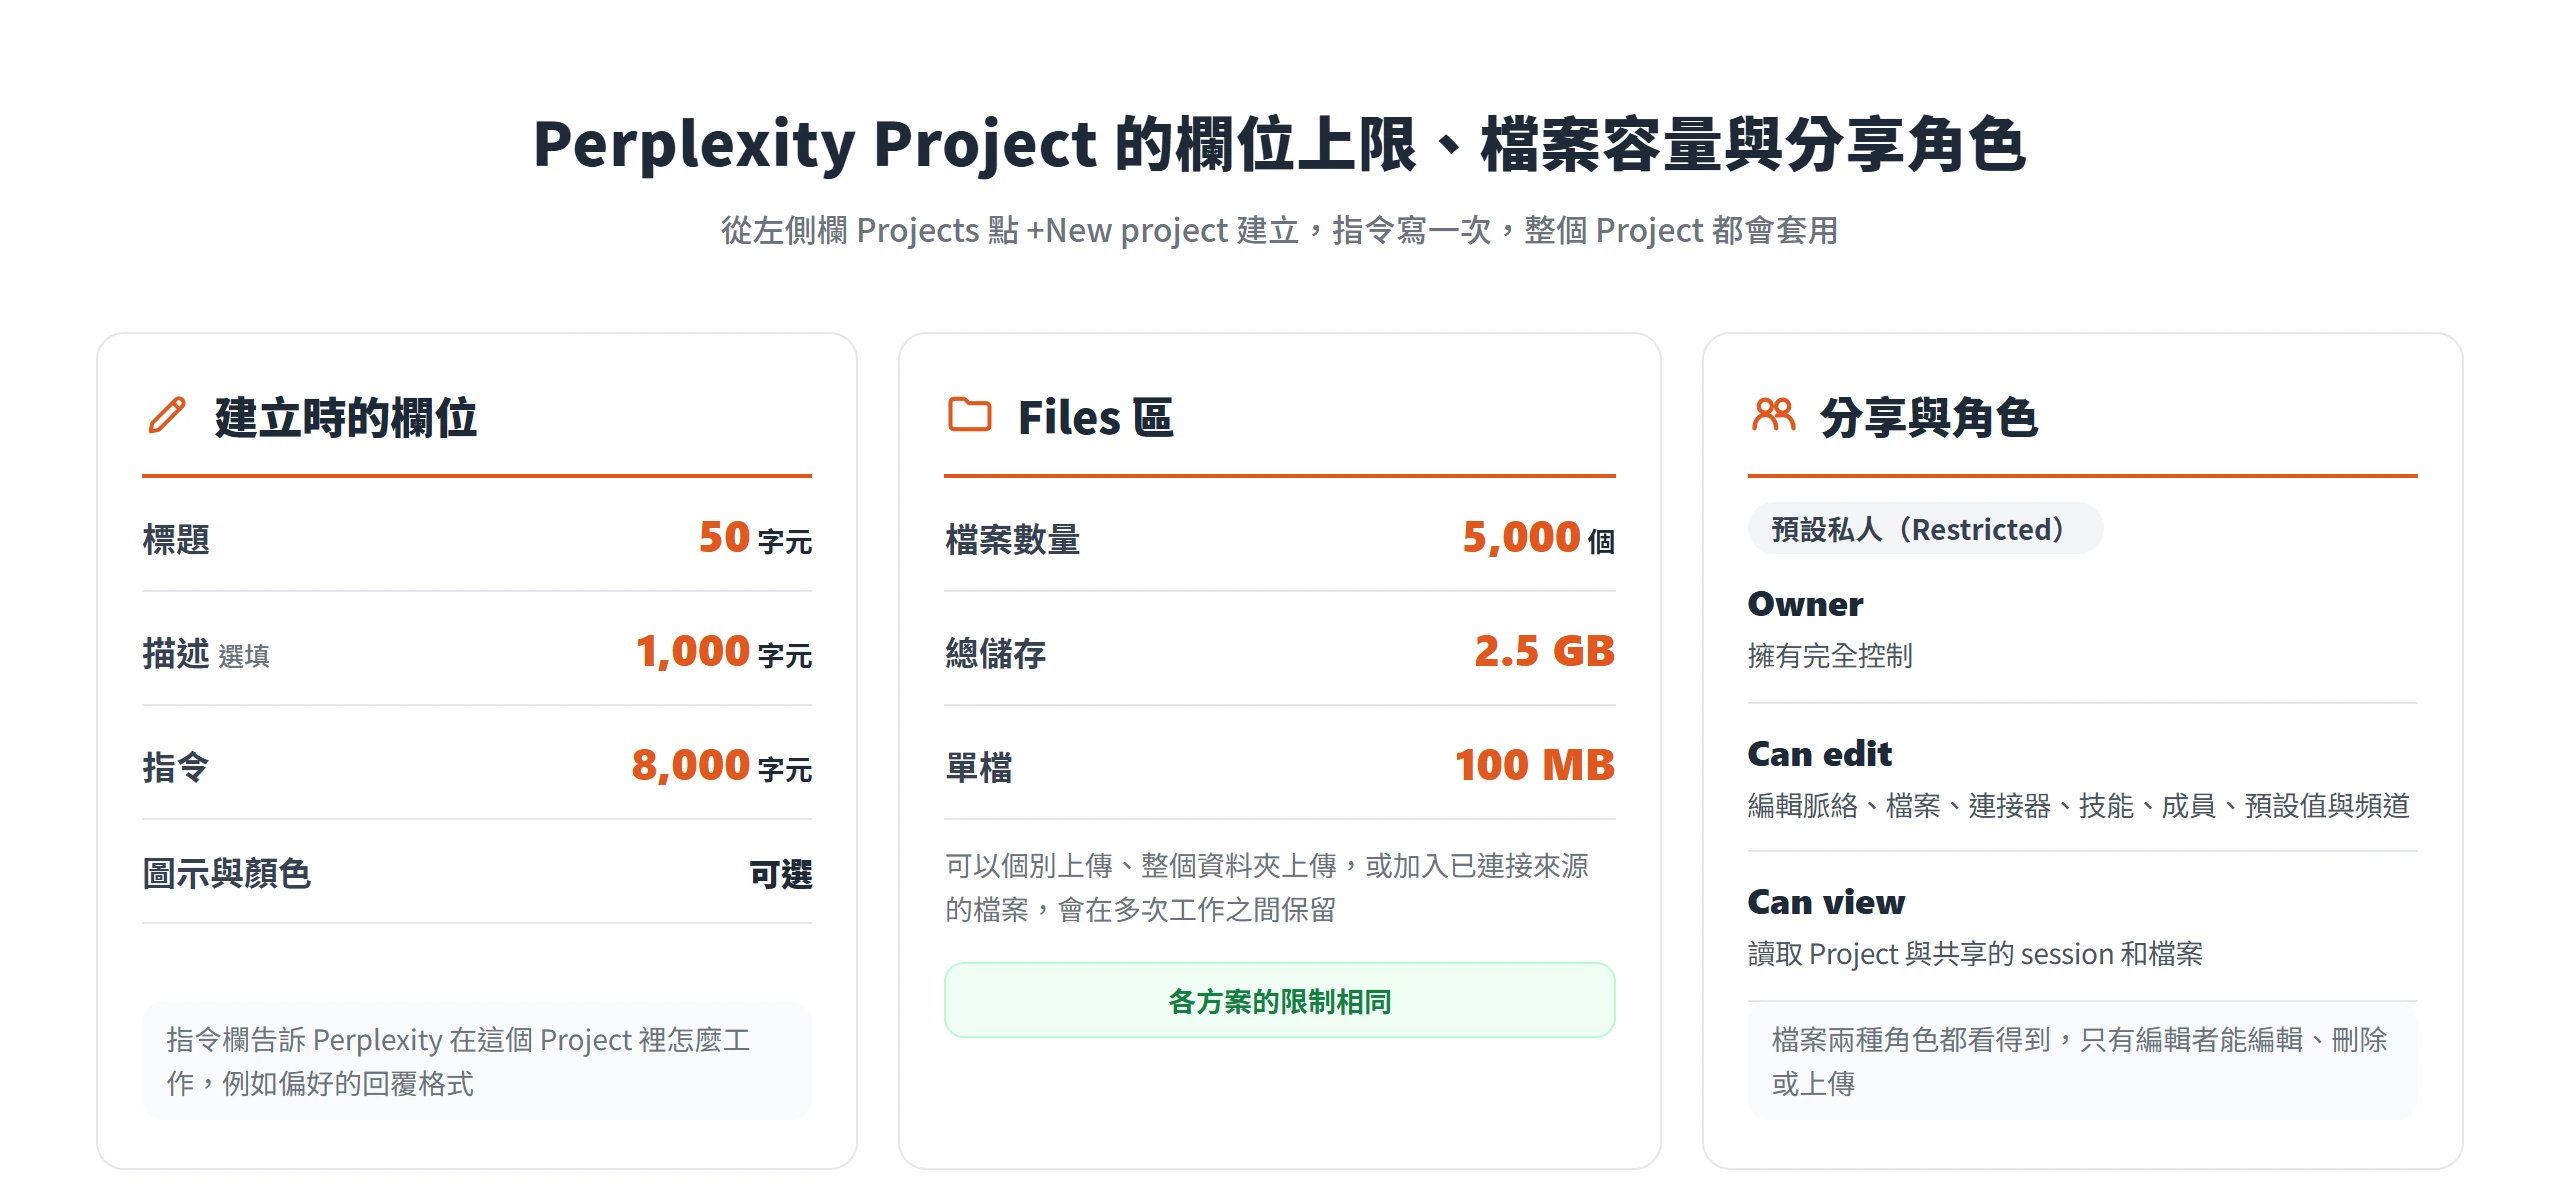
建立 Project 的入口在左側欄,點 Projects,再點 +New project。標題上限 50 個字元,描述選填,上限 1,000 個字元,還可以選圖示與顏色。指令欄的上限是 8,000 個字元,用來告訴 Perplexity 在這個 Project 裡怎麼工作,例如偏好的回覆格式。
指令欄的價值在於,偏好只要寫一次,之後整個 Project 內的工作都會套用。以下是兩組寫法的示範:
用繁體中文回答,金額換算成新台幣,優先引用政府機關與國際組織的網站。Code language: plaintext (plaintext)這個 Project 用來整理 AI 搜尋工具的內部分享簡報。每次回答先寫資料的日期,再列出新增的內容。Code language: plaintext (plaintext)第一組固定了語言、幣別與來源偏好,適合大多數需要台灣在地情境的 Project。第二組則針對特定主題,指定每次的輸出格式,這樣隔週回來追蹤時,內容結構比較容易保持一致。
如果已經有一段聊得不錯的對話,不必從零開始建 Project,可以直接從既有的 session 建立,Perplexity 會依該對話建議標題、描述與指令。在 Computer 的任務中,也可以用 Convert session to project,把任務轉成 Project。
專案檔案、分享權限與 Brain 記憶
每個 Project 都有 Files 區,可以個別上傳,也可以整個資料夾一起上傳,也能加入已連接來源的檔案,這些檔案會在多次工作之間保留。依說明文件,每個 Project 最多 5,000 個檔案、總儲存 2.5 GB、單檔 100 MB,各方案的限制相同。
Project 預設是私人(Restricted),可以從右上角的成員清單或 Share 按鈕管理分享。角色有三種:Owner 擁有完全控制;Can edit 可以編輯脈絡、檔案、連接器、技能、成員、預設值與頻道;Can view 可以讀取 Project 與共享的 session 和檔案。在檔案權限上,檢視者與編輯者都看得到檔案,但只有編輯者能編輯、刪除或上傳。
Brain 是 Computer 的記憶系統,在任務之間研究 Project 的檔案與 session,再更新它所知道的內容,讓下一次任務從累積的脈絡開始,而不是每次重來。說明文件描述的是 Brain 的運作方式,並沒有提供它對工作效率影響的量化數字。
讓 Perplexity 根據上傳的檔案和圖片回答
只用文字提問時,Perplexity 的依據是網路上搜到的資料。上傳檔案之後,它還會讀取檔案內容,答案就能對照你手上的文件,而不只是通用資料。這是兩種提問方式最大的差別。
上傳的方式有兩種:從輸入框的 + 選單選上傳檔案,或是直接把檔案拖進對話。可以上傳純文字、程式碼、PDF 這類文字檔,也支援圖片、音訊與影片。單檔上限是 40 MB,注意這與 Projects 的單檔 100 MB 是兩套不同的限制。
免費、Pro 與 Max 的檔案上傳都不是無限的,各方案有每週滾動的額度,Max 的額度較高。貼上或附加的圖片,以及從 Google Drive 等連接來源附加的檔案,都計入同一個額度。說明文件沒有列出確切的次數,帳號設定裡也看不到剩餘額度,用完之後再附加檔案時,會跳出提示。
附加了檔案的對話,有些情況下會被標示成暫時對話,附加的檔案則在 session 裡保存 30 天。上傳前要先想一下,檔案裡有沒有個人或機密資料,需要保留的內容也別只靠 Perplexity 存放。
一個合理的做法,是上傳一份公開的政府統計 PDF,問兩個具體的問題,例如某一年的數字是多少、不同類別的比例差多少,然後把答案與 PDF 原文逐項對照。這個做法延續的是前面查證的習慣,確認答案寫的確實是檔案裡的內容。上傳檔案雖然讓答案有了明確的依據,但讀取與整理的過程仍可能出錯,核對這一步不能省。
記憶功能與資料用於訓練的設定
使用者可以自己控制兩類資料:Perplexity 記住什麼,以及自己的資料是否用於改善模型。兩者在設定中的位置與預設值不同,而且「關閉」不等於「刪除」。
記憶可以分開開關,也能逐筆刪除
記憶的設定在 Settings 的 Memory 裡,記憶與搜尋歷史是兩個獨立的權限,可以各自開關。關掉之後,Perplexity 在之後的回答裡就不再參考它們。
需要留意的是,關閉記憶不會清除既有的記憶。要刪除,得到 Memory 裡的 Manage memories,在那裡可以搜尋、篩選,用垃圾桶圖示刪除單筆記憶,或一次清除全部。刪除之後,Perplexity 可能會保留已清除記憶的紀錄,最長 30 天,用於安全、除錯,以及避免記憶立刻重新生成。
使用隱身模式時,記憶與過往搜尋一律關閉,隱身中提的問題,永遠不會被保留或寫入記憶。所以敏感的問題改用隱身模式,比事後逐筆刪除更徹底。
AI 資料用途預設開啟,關閉後只影響新資料
另一類設定是對話資料是否用於訓練。免費、Pro 與 Max 帳號的 AI 資料用途預設是開啟的,意思是資料可能被用來改善 AI 模型。這個開關在設定頁的英文名稱是 AI data retention,部分說明文件也稱為 AI Data Usage。可以點左下角的個人頭像進入設定,到 Preferences 頁把它關掉。
關掉之後,只有關閉日期之後收集的資料不再用於訓練,先前已經收集的訓練資料無法刪除或移除。關閉也不影響核心功能,不過資料仍可能為了服務運作、法遵與產品改善而被處理,所以它不是「資料完全不留」的意思。Enterprise 方案的資料永遠不用於 AI 訓練。
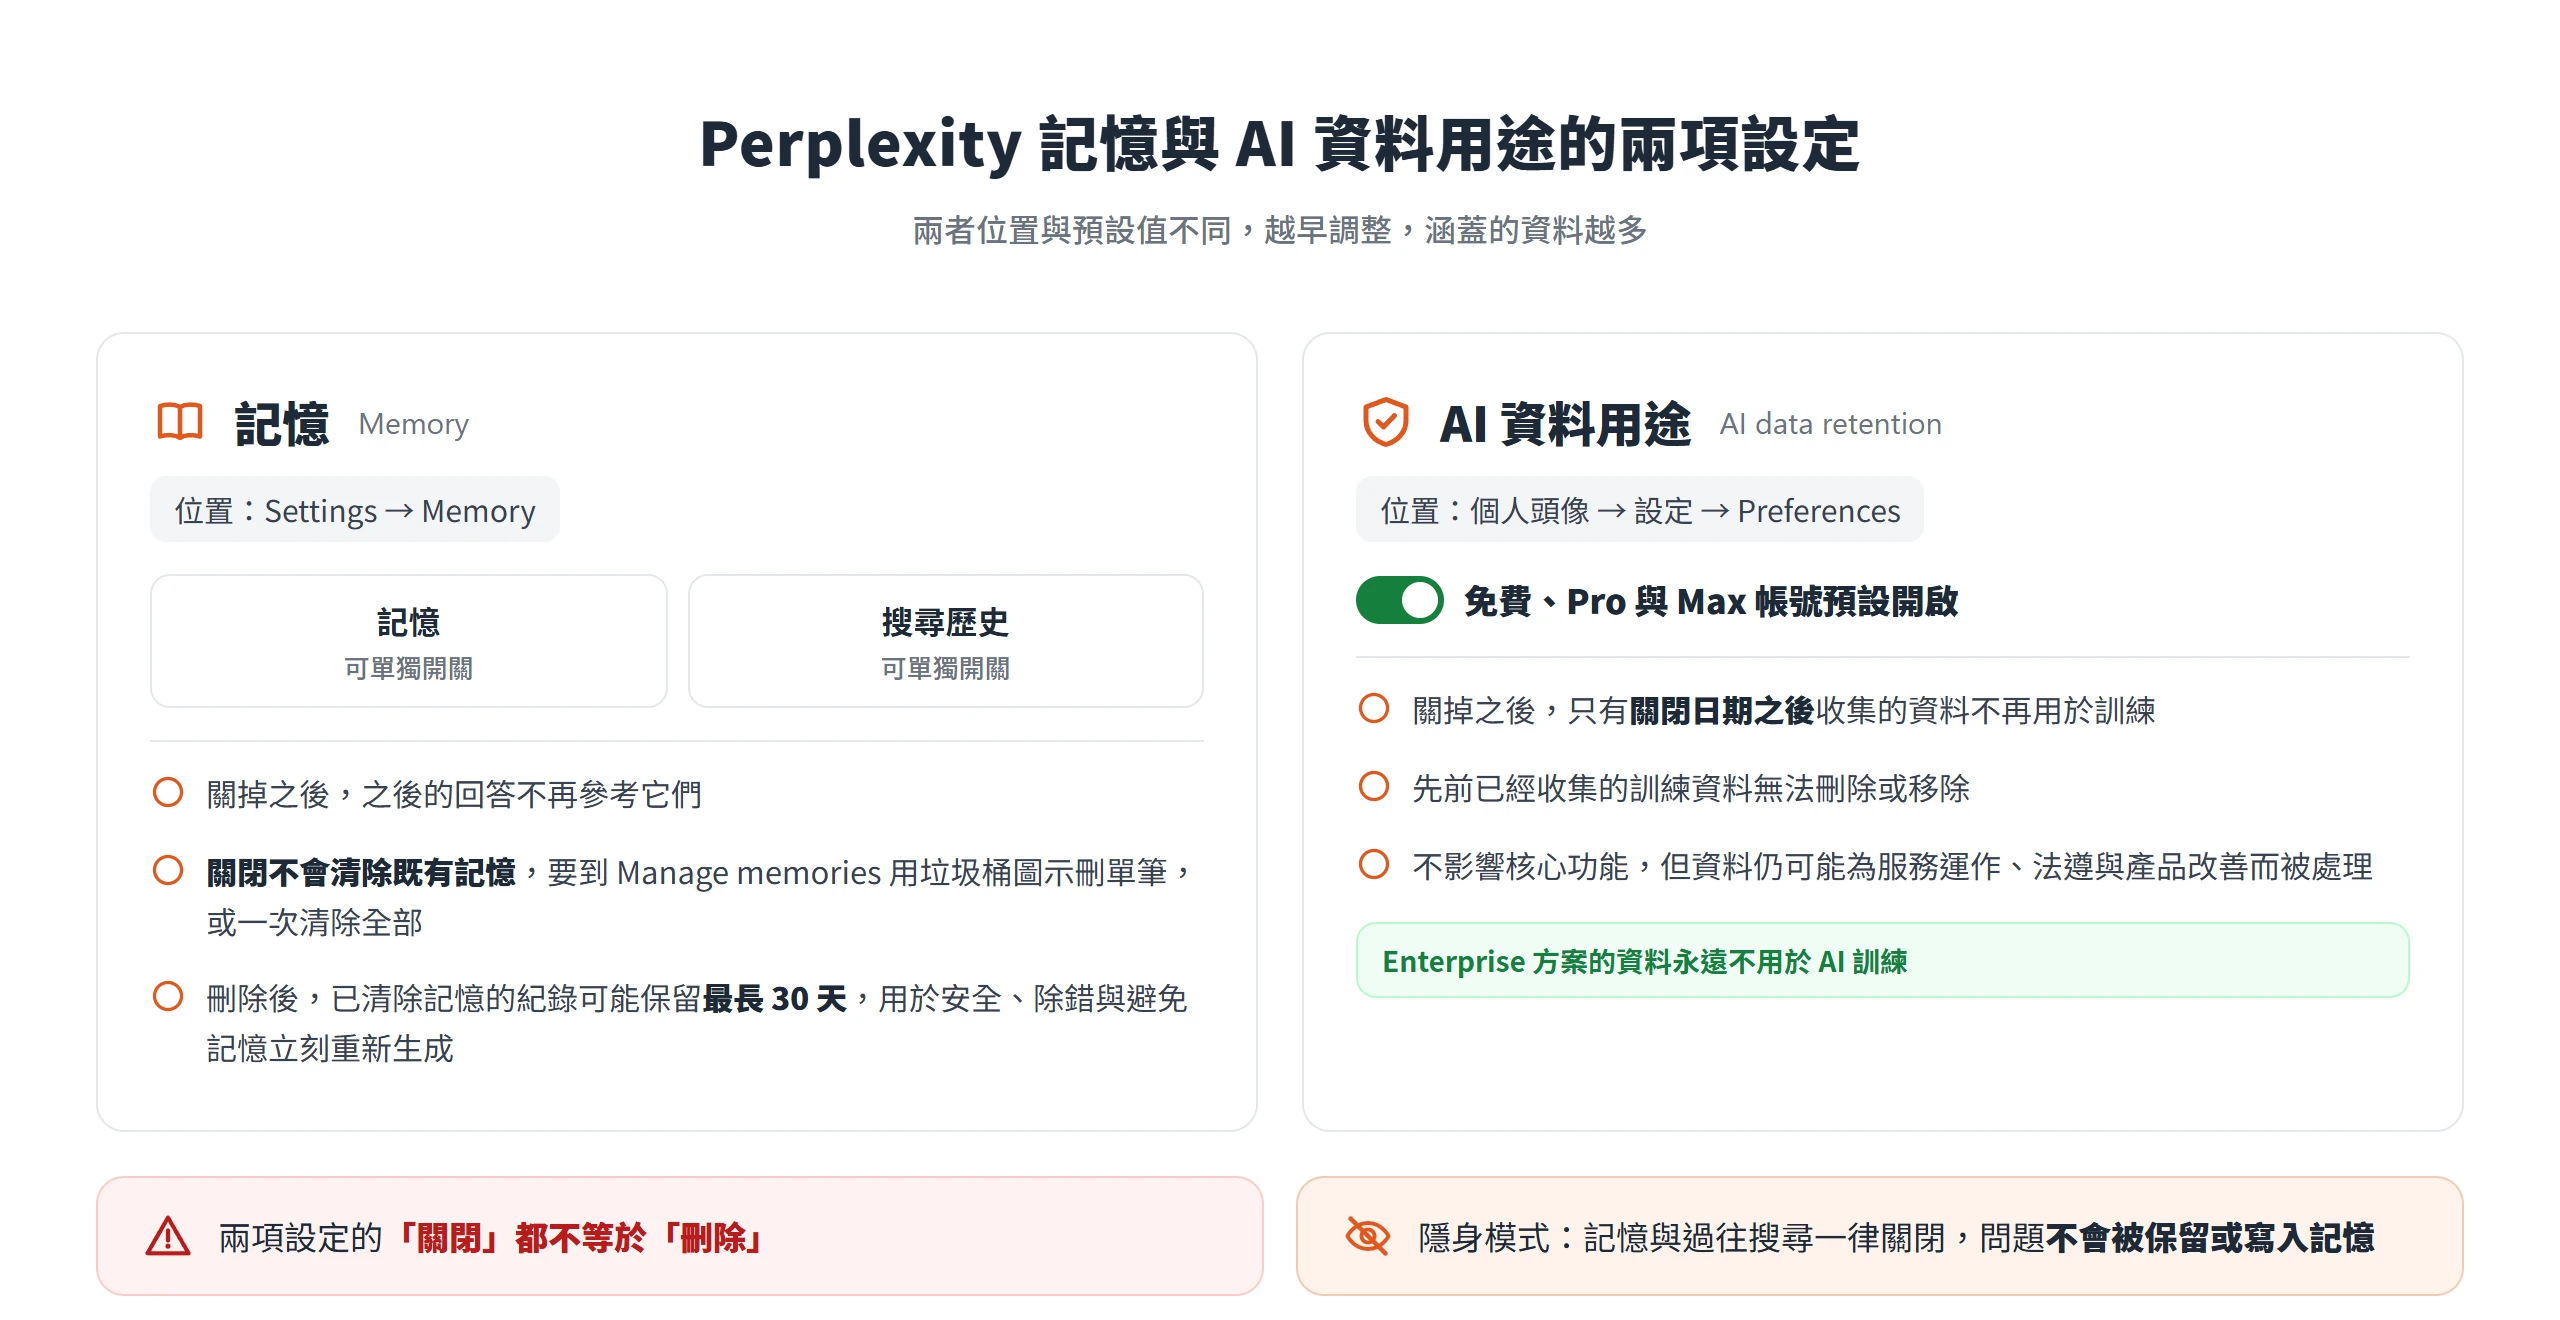
這兩項設定有個共通點,越早調整,涵蓋的資料越多。如果打算把 Perplexity 當日常工具,建議一開始就把這兩個設定檢查一遍。
Perplexity 免費帳號的範圍與付費方案新增的功能
免費帳號與付費方案的差別,從結構上看,主要是用量與功能的範圍。以下依 2026 年 8 月底的 Perplexity 方案頁整理,額度的確切次數會隨時調整,以方案頁當下的說明為準。
| 方案 | 定位 | 主要功能範圍 |
|---|---|---|
| Free | 每月 0 美元,有限的每日使用量 | 附引用的搜尋、基本 AI 模型、有限次數的 Pro Search、Research 與檔案上傳 |
| Pro | 每月 20 美元 | Computer、Deep Research、可選擇模型、Create files and apps、更高的用量上限與記憶 |
| Max | 每月 200 美元 | 比 Pro 更高的額度、較新功能的優先使用權,網頁版與 iOS 的 Model Council |
| Enterprise Pro/Enterprise Max | 企業方案 | 資料永遠不用於 AI 訓練 |
再看前面提過的幾項功能,Research 在免費方案有次數限制,Pro 與 Max 的額度較高。Model Council 在網頁版與 iOS 只提供給 Max,在 Computer 裡則是所有付費方案都能用。Computer 與 Create files and apps 都列在 Pro 以上,Projects 則開放給所有 Computer 使用者。
不論選哪一種方案,Perplexity 都把「附上來源」當成答案的預設格式,但來源只讓核對變得容易,核對仍得自己動手。下一次用它查資料時,可以挑一個自己本來就熟悉的主題,點開幾個編號,看來源頁有沒有講出同一句話。幾次下來,哪些類型的問題它整理得可靠、哪些要再三確認,自然就有底了。