多數人以為字體設計的功夫,都花在把每個字畫得漂亮上,但一套中文字體開工之前,最先要回答的其實是要畫多少個字。教育部公布的常用字表就有 4,808 字,Unicode 收錄的漢字更超過十萬個;相較之下,拉丁字母的基本字集只有幾百個字形。
字數只是第一道關。只有一畫的「一」,和筆畫多到幾乎擠成一團的「鬱」,要放進同樣大小的方框,還得看起來一樣重、一樣穩;同一個「骨」字,繁體中文、簡體中文與日韓的寫法又不盡相同。這些取捨,正是字體設計和「挑一款現成字體來用」最根本的差別。
這幾道難題怎麼應對,多半在專案起步時就要先想好。
字體設計是什麼?
字體設計指的是把一整套文字畫成能輸入、能排版的字型,由 type designer(字體設計師)或字體工作室完成。它的範圍比很多人想的大:除了決定每個字的輪廓,還要處理間距、字重、字形替換,最後交出一個能在各種裝置上安裝使用的字型檔。
有幾件相鄰的事不在這個範圍裡。Logo 標準字只畫品牌名稱那幾個字,目的是讓一個名字長得獨一無二;挑選字體,是從現成的字型裡找出適合的那一款;字體分類,則是在分辨不同風格之間的差異。這三件事都會用到字體設計的成果,但都不需要把一整套字畫出來。
既然已經有那麼多字體,為什麼還有人繼續做新的?Google Fonts Knowledge 指出,新字體常來自幾種動機:設計師想復刻歷史字體、想捕捉平面設計的潮流、發現市場上有缺口,或是機構委託訂製。訂製字體通常為需要獨特風格的機構而設計,也常專屬該機構使用。Monotype 介紹字體設計師 Carl Crossgrove 的文章提到,他參與復刻的 Walbaum 是一款約有 200 年歷史的字體。復刻從既有素材出發,不是從空白頁開始,但目的和從零設計的字體一樣,都是補上一個缺口,或帶來新鮮感。
理由還有另一層。同一份說明拿音樂打比方,假如覺得歌已經夠多就不再寫新歌,世界會少掉很多東西;字體也一樣,它替文字加上一層視覺語氣,每一套字體都有自己的聲調。它也讓文件能呈現層級,例如用較深的標題,區分標題與說明文字的主從。
動筆之前,先用需求書定下用途與字集
字體設計不是從畫第一個字開始的。經驗豐富的設計師通常在專案初期先寫一份需求書,把後面所有取捨的依據固定下來。Google Fonts Knowledge 列出需求書要回答的五個問題:
- 這套字體要用在哪裡,是沉浸式的長文,還是短標題?
- 有沒有特殊要求,例如極小字級仍要清晰,或要在電子閱讀器、虛擬實境環境裡運作?
- 要支援哪些語言與字元,需不需要小型大寫、延伸數學符號這類替代字形?
- 需要幾個字重與樣式?Regular、Italic、Bold、Bold Italic 是多數設計師預期的基本配置,也可能需要更多字重或不同寬度。
- 市場上已經有哪些字體,新字體是否夠獨特而值得製作?
把答案寫成明確的需求書,有一個很實際的好處,就是專案範圍不會越做越大。字體是一項極容易擴張的工作,多支援一種語言、多做一組字重,工作量都跟著增加;沒有白紙黑字的依據,製作時間很容易一路拉長。
用途也會直接反映在字體的骨架上。Adobe 東京字體團隊的 Ryoko Nishizuka 是 Source Han Sans 的主要設計者,她說設計前必須先仔細考慮預定用途,是標題還是內文、屬於什麼內容類型,再決定易讀性與其他設計特徵有多重要。Adobe 對 Source Han Sans 的說明是,風格偏向適度現代,筆畫經過簡化、粗細一致,讓它在平板與手機這類小型裝置上更好讀,同時能用在軟體選單這類單行短句,也能用在電子書這類長段文字。
對中文字體來說,需求書裡最關鍵的一題是字集範圍。Adobe 的 Ken Lunde 建議,基於實務考量,要限制字型的字集與語言涵蓋範圍。字集範圍必須在動筆之前決定,不能畫到一半再看情況,因為一套中文字體的工作量,大半取決於這個數字。Monotype 承接品牌委託的訂製字體也是同樣的順序,先釐清語氣與使用場景,再往下談範圍。
從手繪草稿到字型檔的開發流程
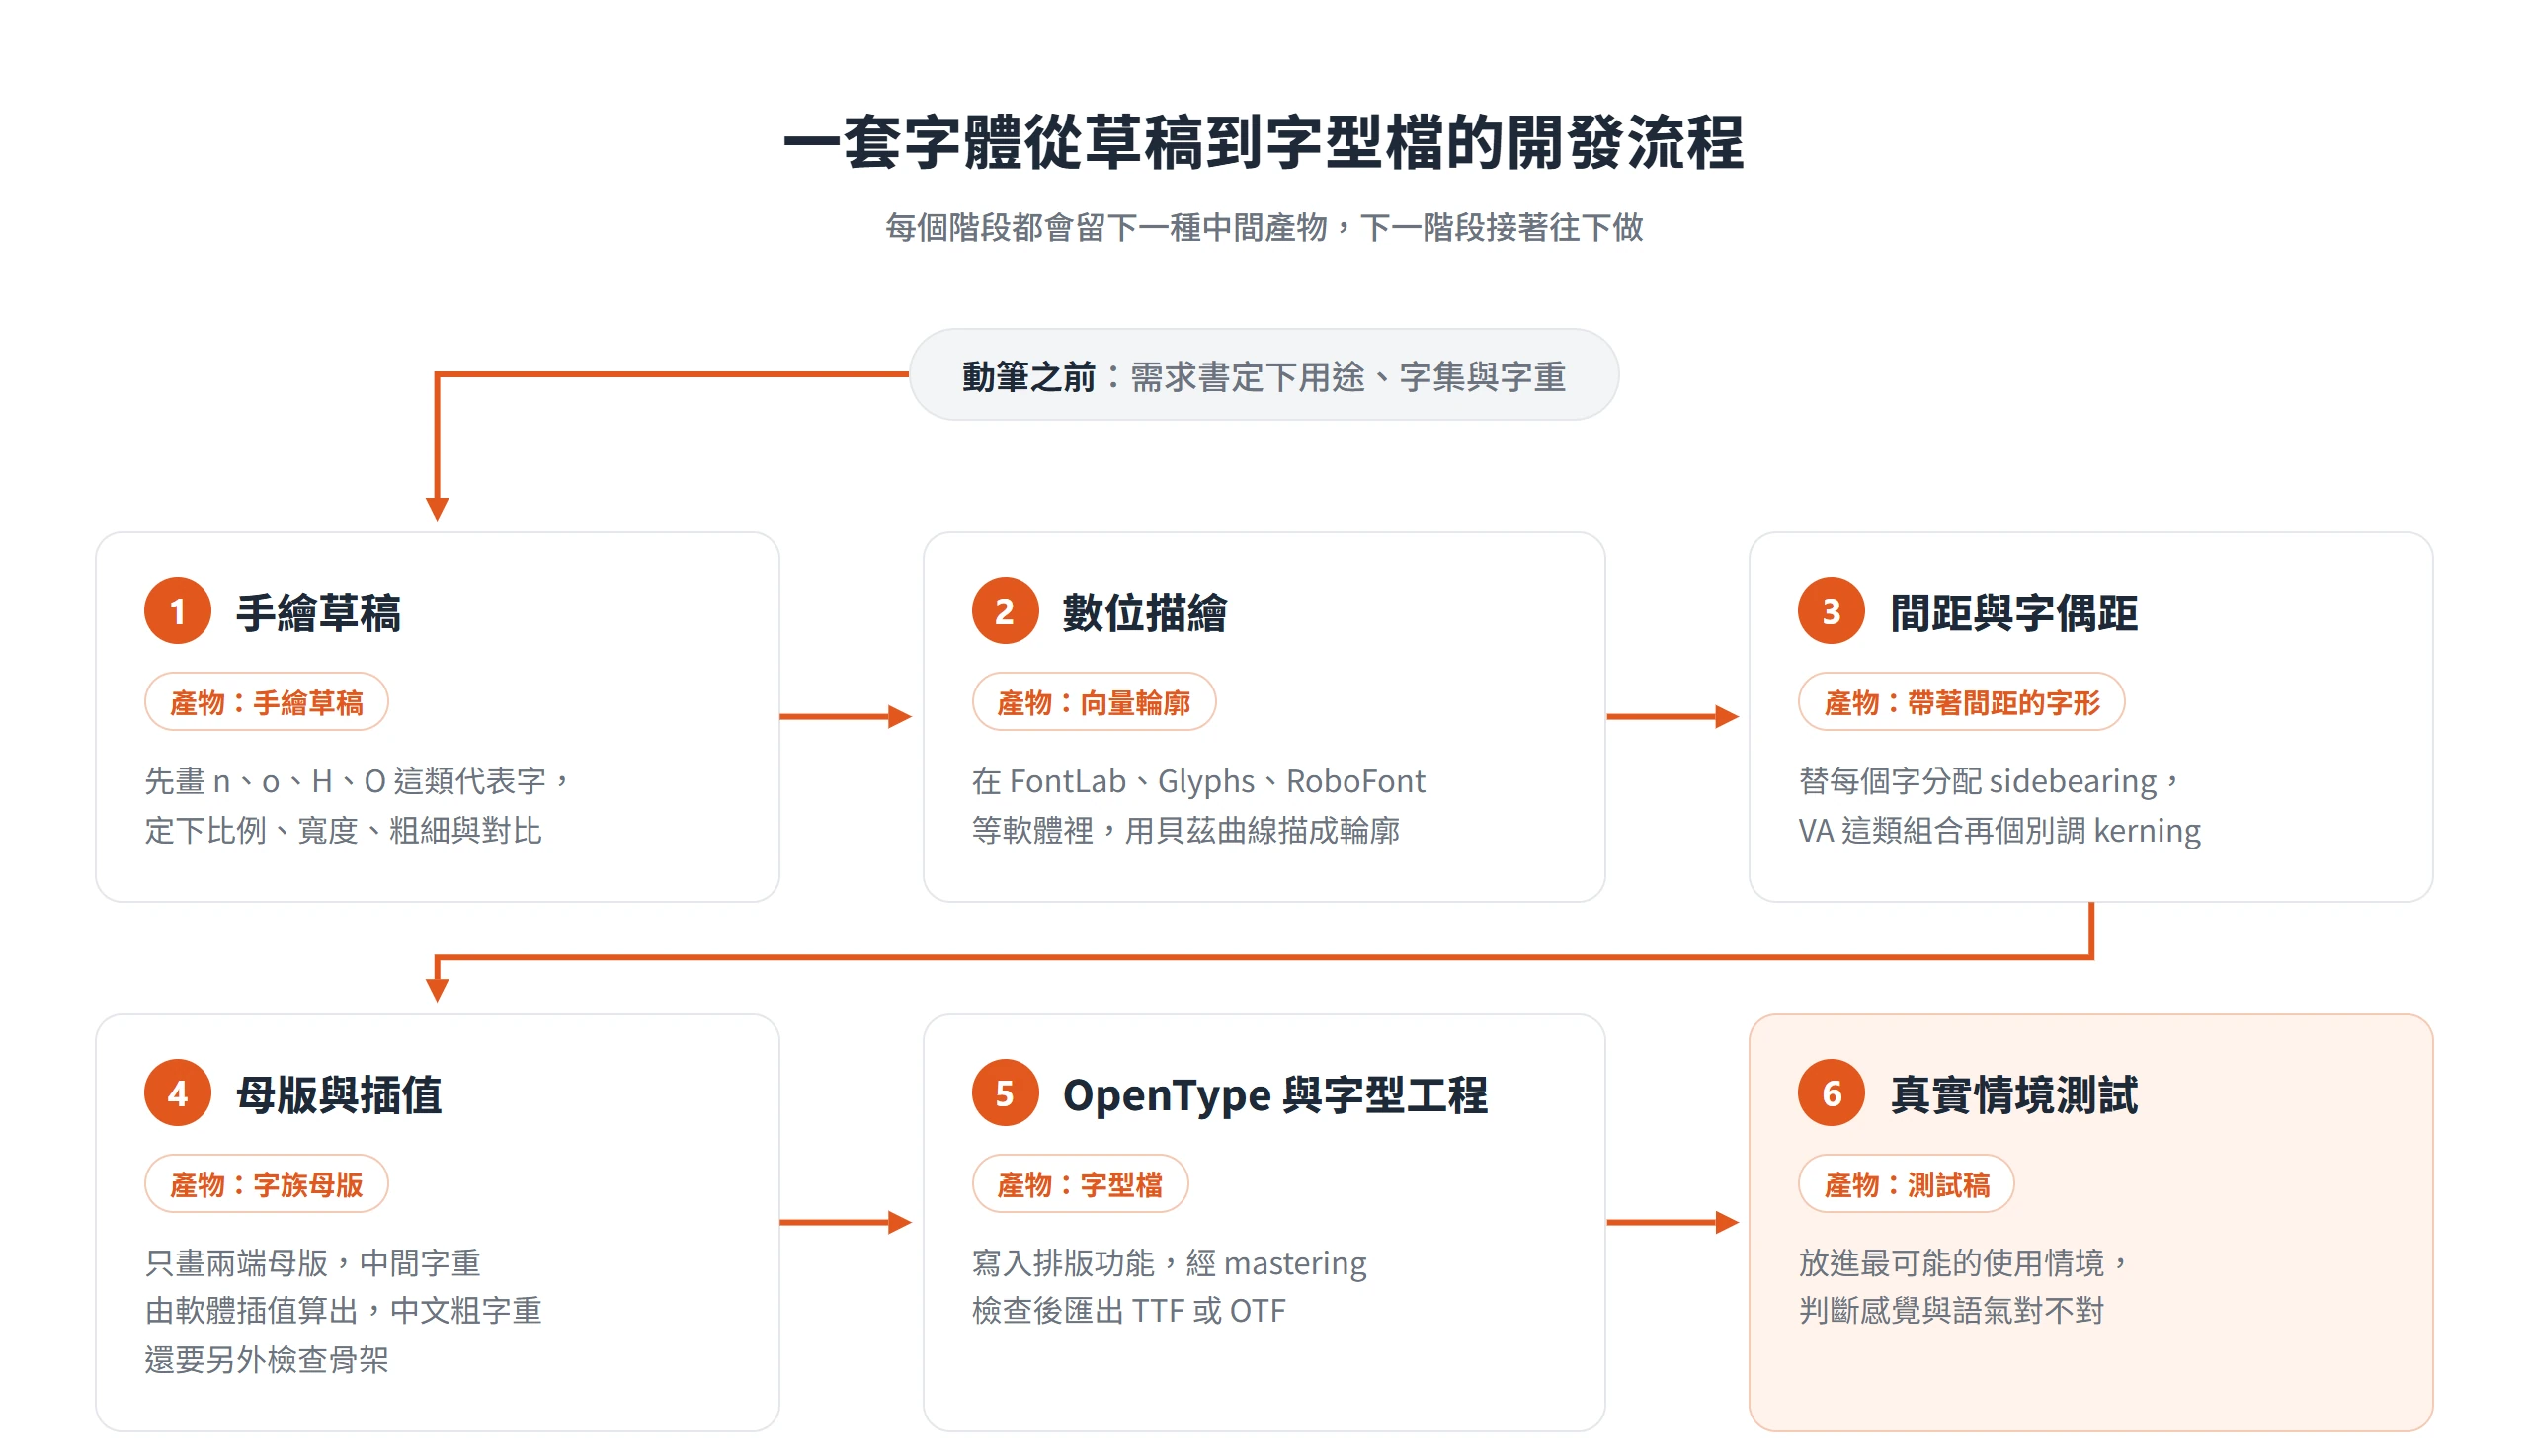
一套字體從草稿變成能安裝的字型檔,過程中會產生好幾種中間產物:手繪草稿、向量輪廓、帶著間距的字形、字族母版、字型檔,最後還有放進真實版面的測試稿。這條主幹流程拉丁與中文字體大致共通,只是每個階段做的事不同,各自要做一組決定。
手繪草稿先從決定風格的幾個代表字畫起
雖然字體最終是數位檔,概念探索常從手繪草稿開始。設計師不會從 A 一路畫到 Z,而是先畫幾個最能代表整套字體形狀與屬性的字,例如小寫的 n、o,再接大寫的 H 與 O。這幾個字決定了比例、高度、寬度、粗細與對比,Google Fonts Knowledge 也強調,一致性是字體好讀的關鍵。
草稿階段只看得到輪廓。Crossgrove 形容,手和鉛筆的階段只有外形,仍然很粗糙凌亂,沒有上墨或填色,就看不出設計在清晰黑白下的樣子。字數增加以後,也常得回頭調整先前畫好的字,讓某些形狀彼此更協調。
處理漢字的設計師同樣先從少數字起手,並且很重視「放一段時間再看」。Nishizuka 在日文字體的工作裡,是有了大致意象後先畫假名,假名大多完成後才開始做漢字,做漢字期間完全不看假名。她也會把做好的字收起來 1 到 2 個月,再用新的眼光回頭看,修改會變得比較容易;如果眼睛又看熟了,就再收起來 1 到 2 個月。
數位描繪把草稿變成貝茲曲線輪廓
草稿定案後,就轉成向量輪廓。最常用的方式是貝茲曲線(Bézier curves):每條線由起點、終點,以及用來調整形狀的離曲線控制點定義。這些向量圖形組成每個字形,所以一個字形,其實就是一組曲線。
繪製多半在專業的字型編輯軟體裡進行,FontLab、Glyphs、RoboFont 是常見的幾款。這類軟體不只是畫圖工具,還能定義間距等度量,也能撰寫控制字形外觀與運作的程式碼,所以從這一步開始,「畫字」和「做字型」就合為一件事了。
間距與字偶距決定排版的節奏
字形畫好之後,每個字的左右還要分配一段空白,稱為 sidebearing,作用是把字與字隔開。目標是每個字都分到成比例的空間,不同的字組合在一起時,節奏才會一致。設計師在繪製早期,就會先把初始的字母排成單字,觀察彼此的關係。
全部畫完、間距定好以後,還要檢查每一種可能的字形組合。像 VA 這種形狀互相影響的組合,會需要稱為 kerning(字偶距)的個別調整,這些資料也存在完成的字型檔裡。
中文的情況不太一樣。中文字多半設計成塞滿同一個全形方框、等寬排列,間距的工作重心因此和拉丁字母不同。
母版與插值自動補出字族的中間字重
字族在字重或字寬這類軸線上有兩個以上的樣式時,兩端之間的中間樣式,可以由軟體自動產生,這個過程稱為插值(interpolation)。例如需要五個字重,設計師可以只畫最細與最粗兩個,軟體再自動算出中間的三個。真正有輪廓的兩端稱為 masters(母版),中間字重的手繪則是選配。
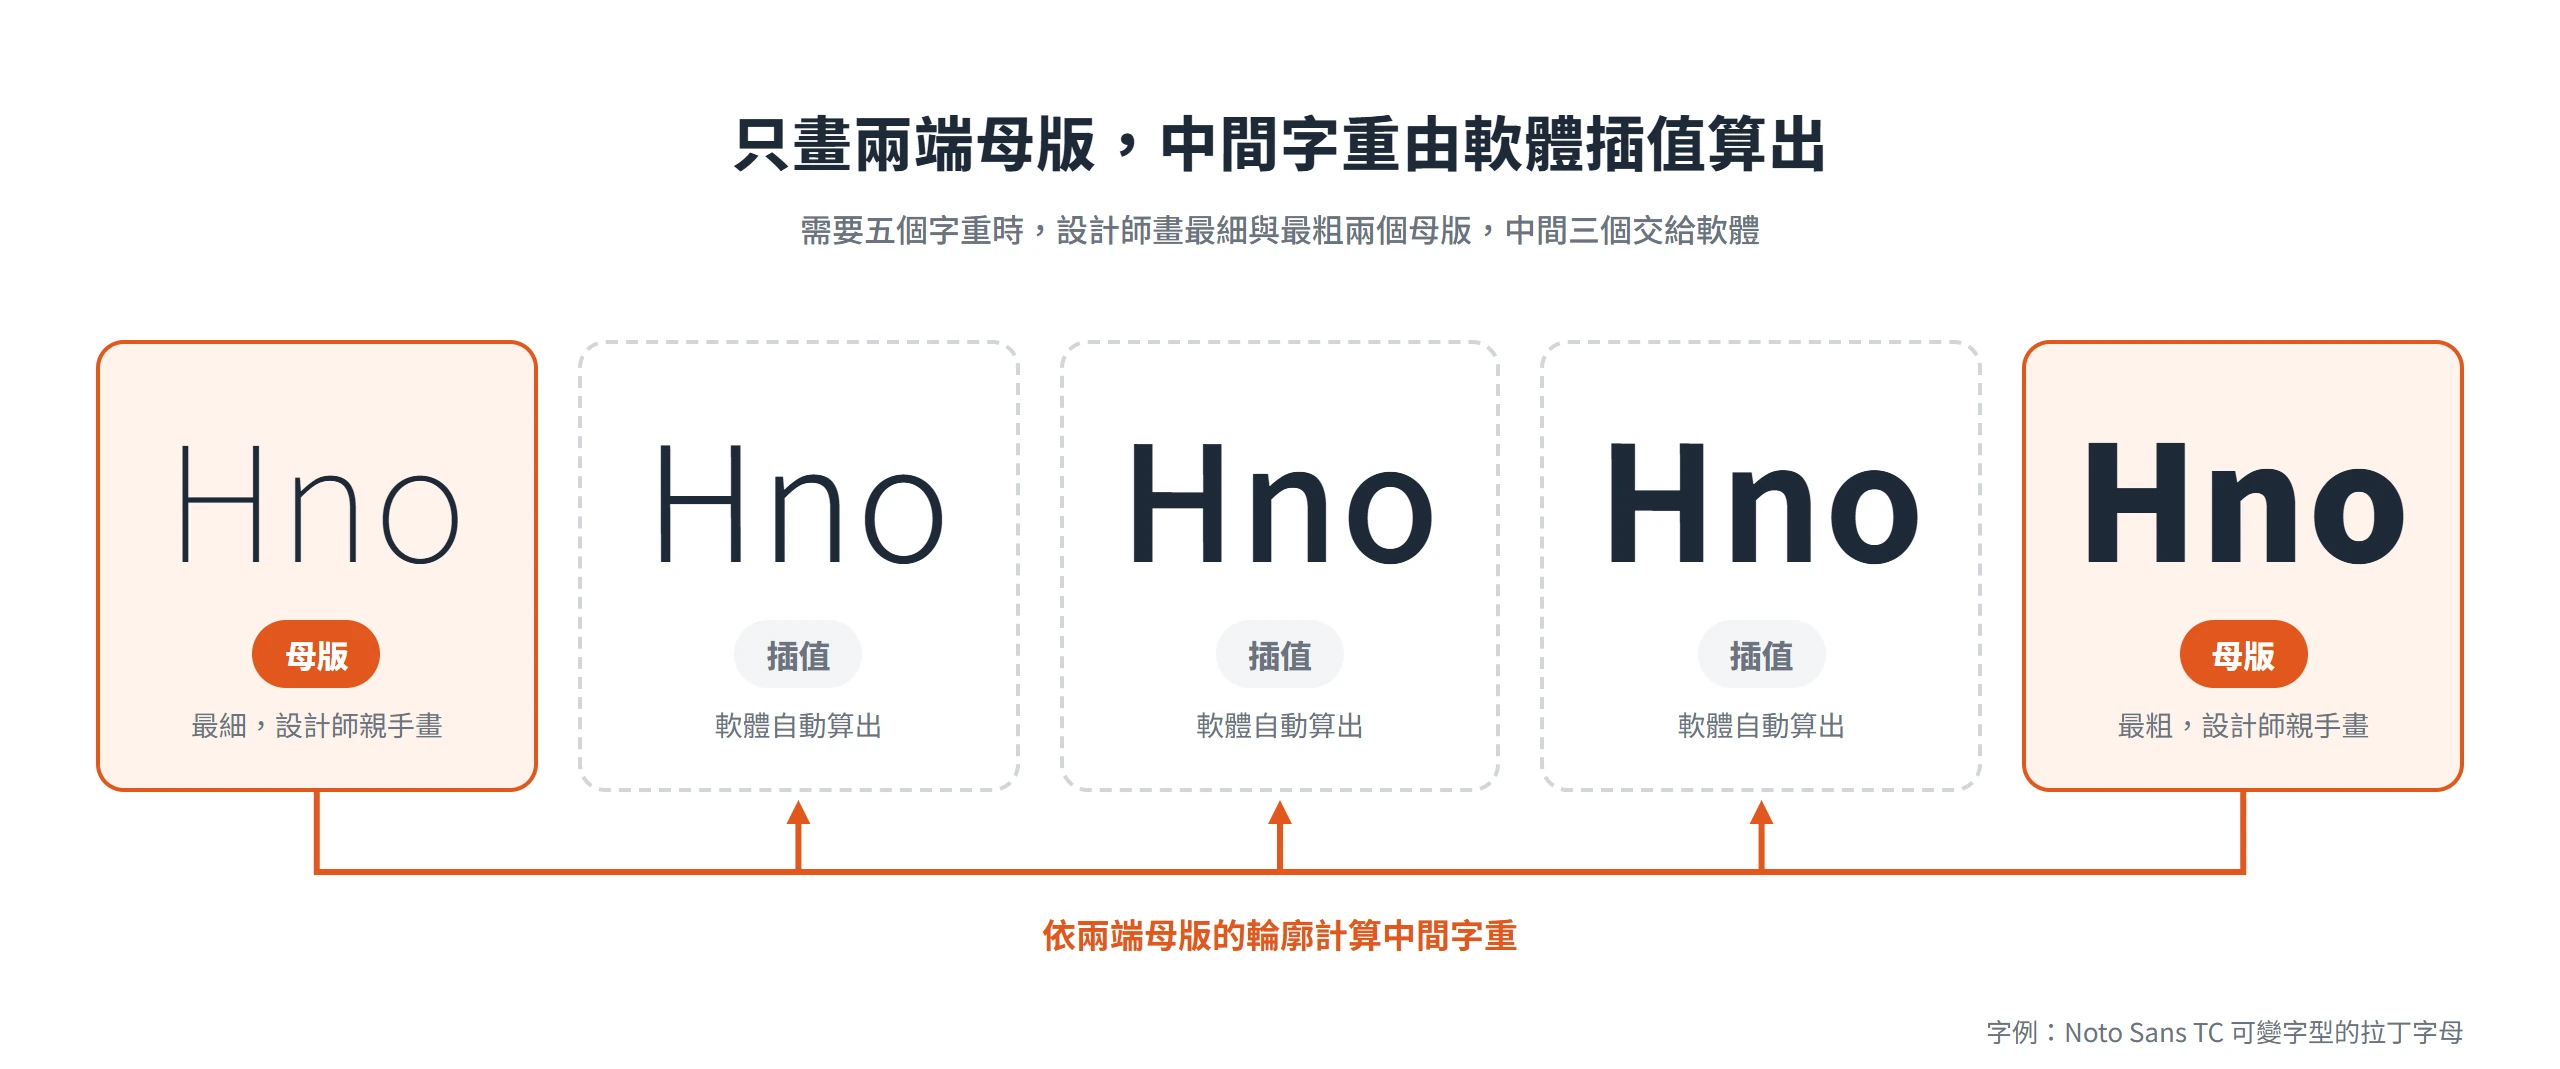
這個機制替大型字族省下大量工作。像 Google 的 Noto Sans CJK 一個字族就有 7 個字重,如果每個字重都要從頭畫一遍,工作量會難以想像。
不過插值並不是萬用解。中文的字固定放在方框裡,粗字重沒辦法單靠兩端之間的自動計算得到,最粗的字重往往得重新安排筆畫與留白。
OpenType 功能與字型工程讓輪廓成為可安裝的字型檔
輪廓畫完,不等於字體做完。設計師可以在字型編輯軟體裡撰寫排版功能,用 OpenType 技術讓字形依設定被替換或調整,例如依語言設定自動替換特定字形,或是在開啟某項功能時,換成風格替代字。檢查設計與程式是否無誤、運作正確的階段稱為 mastering,確認後匯出 TTF 或 OTF,才是真正能安裝到電腦上的字型檔。
Monotype 一篇談字型工程的文章說明,字型其實是由資料與程式碼組成的軟體。資料包括字形輪廓、水平與垂直度量、字型家族與樣式名稱,以及版權與商標字串;程式碼則包括引導小字級顯示的 TrueType 指令(hinting),以及協助排出正確字形順序與組合的 OpenType 版面碼。
Monotype 的字型工程師 Guy Mayger 說,字型工程師負責把設計團隊交出的字體設計轉成高品質的字型軟體,工作包括定義並檢查必要的 OpenType 功能、偶爾微調輪廓,以及維護管理資料。工程上的一大難題是垂直度量,不同作業系統與應用程式使用它的方式並不一致。更新既有字型時,只要度量改變,已經開啟的文件就會重新排版,多數客戶無法接受這種變動,所以工程師必須維持相容。
字體放進真實情境測試後才算定稿
最後一個階段,是放進真實使用情境檢驗。Crossgrove 指出,把所有東西用同一字級、黑白字母表展示,幫助有限;客戶要看到提案和開發稿出現在最可能的使用情境中,才能判斷設計的感覺與語氣對不對,有時用客戶自己介面與顏色做的 mock-up,會更有建設性。
設計師之間也會互相看稿。個人專案開發期間,Crossgrove 會讓工作室其他成員看幾次進度,多一雙眼睛有助於抓出弱點,收尾時也能抓到小錯和鬆散的細節。
字體完成後,設計師與字體公司會製作稱為 specimen(字體樣張)的視覺材料,說明字體的特色、示範使用方式,並描述最適合的文字類型。對想挑字體的人來說,樣張也是判斷一套字體適不適合的第一站。
中文造字先要面對字數與字集範圍
中文與拉丁字母最直接的差距是字數。這裡的「字數」其實有三層:Unicode 收了多少漢字、教育部的字表規定了多少字、單一字型檔實際裝得下多少字形。三個數字各自代表不同的意義,混在一起看,就會誤判一套字體的工作量。
Unicode 收錄超過十萬個漢字,字型只收其中一部分
根據 Unicode Consortium 公布的字元統計,Unicode 18.0 收錄的漢字已超過十萬個。Unicode 標準在說明各擴充區時,把其中大部分標為罕用或歷史用字,也就是日常幾乎碰不到的字。沒有任何一套字體會把它們全部畫完。
Google 在說明 Noto Sans CJK 時指出,完整支援中日韓文字需要數萬個字元,三種語言共用大部分的表意文字,但也有只屬於單一語言,或其中兩種語言的字。實際的字型,都是依用途挑出一個子集來做,子集要多大,取決於前面需求書裡定下的用途。
教育部常用、次常用與罕用三張字表的字數
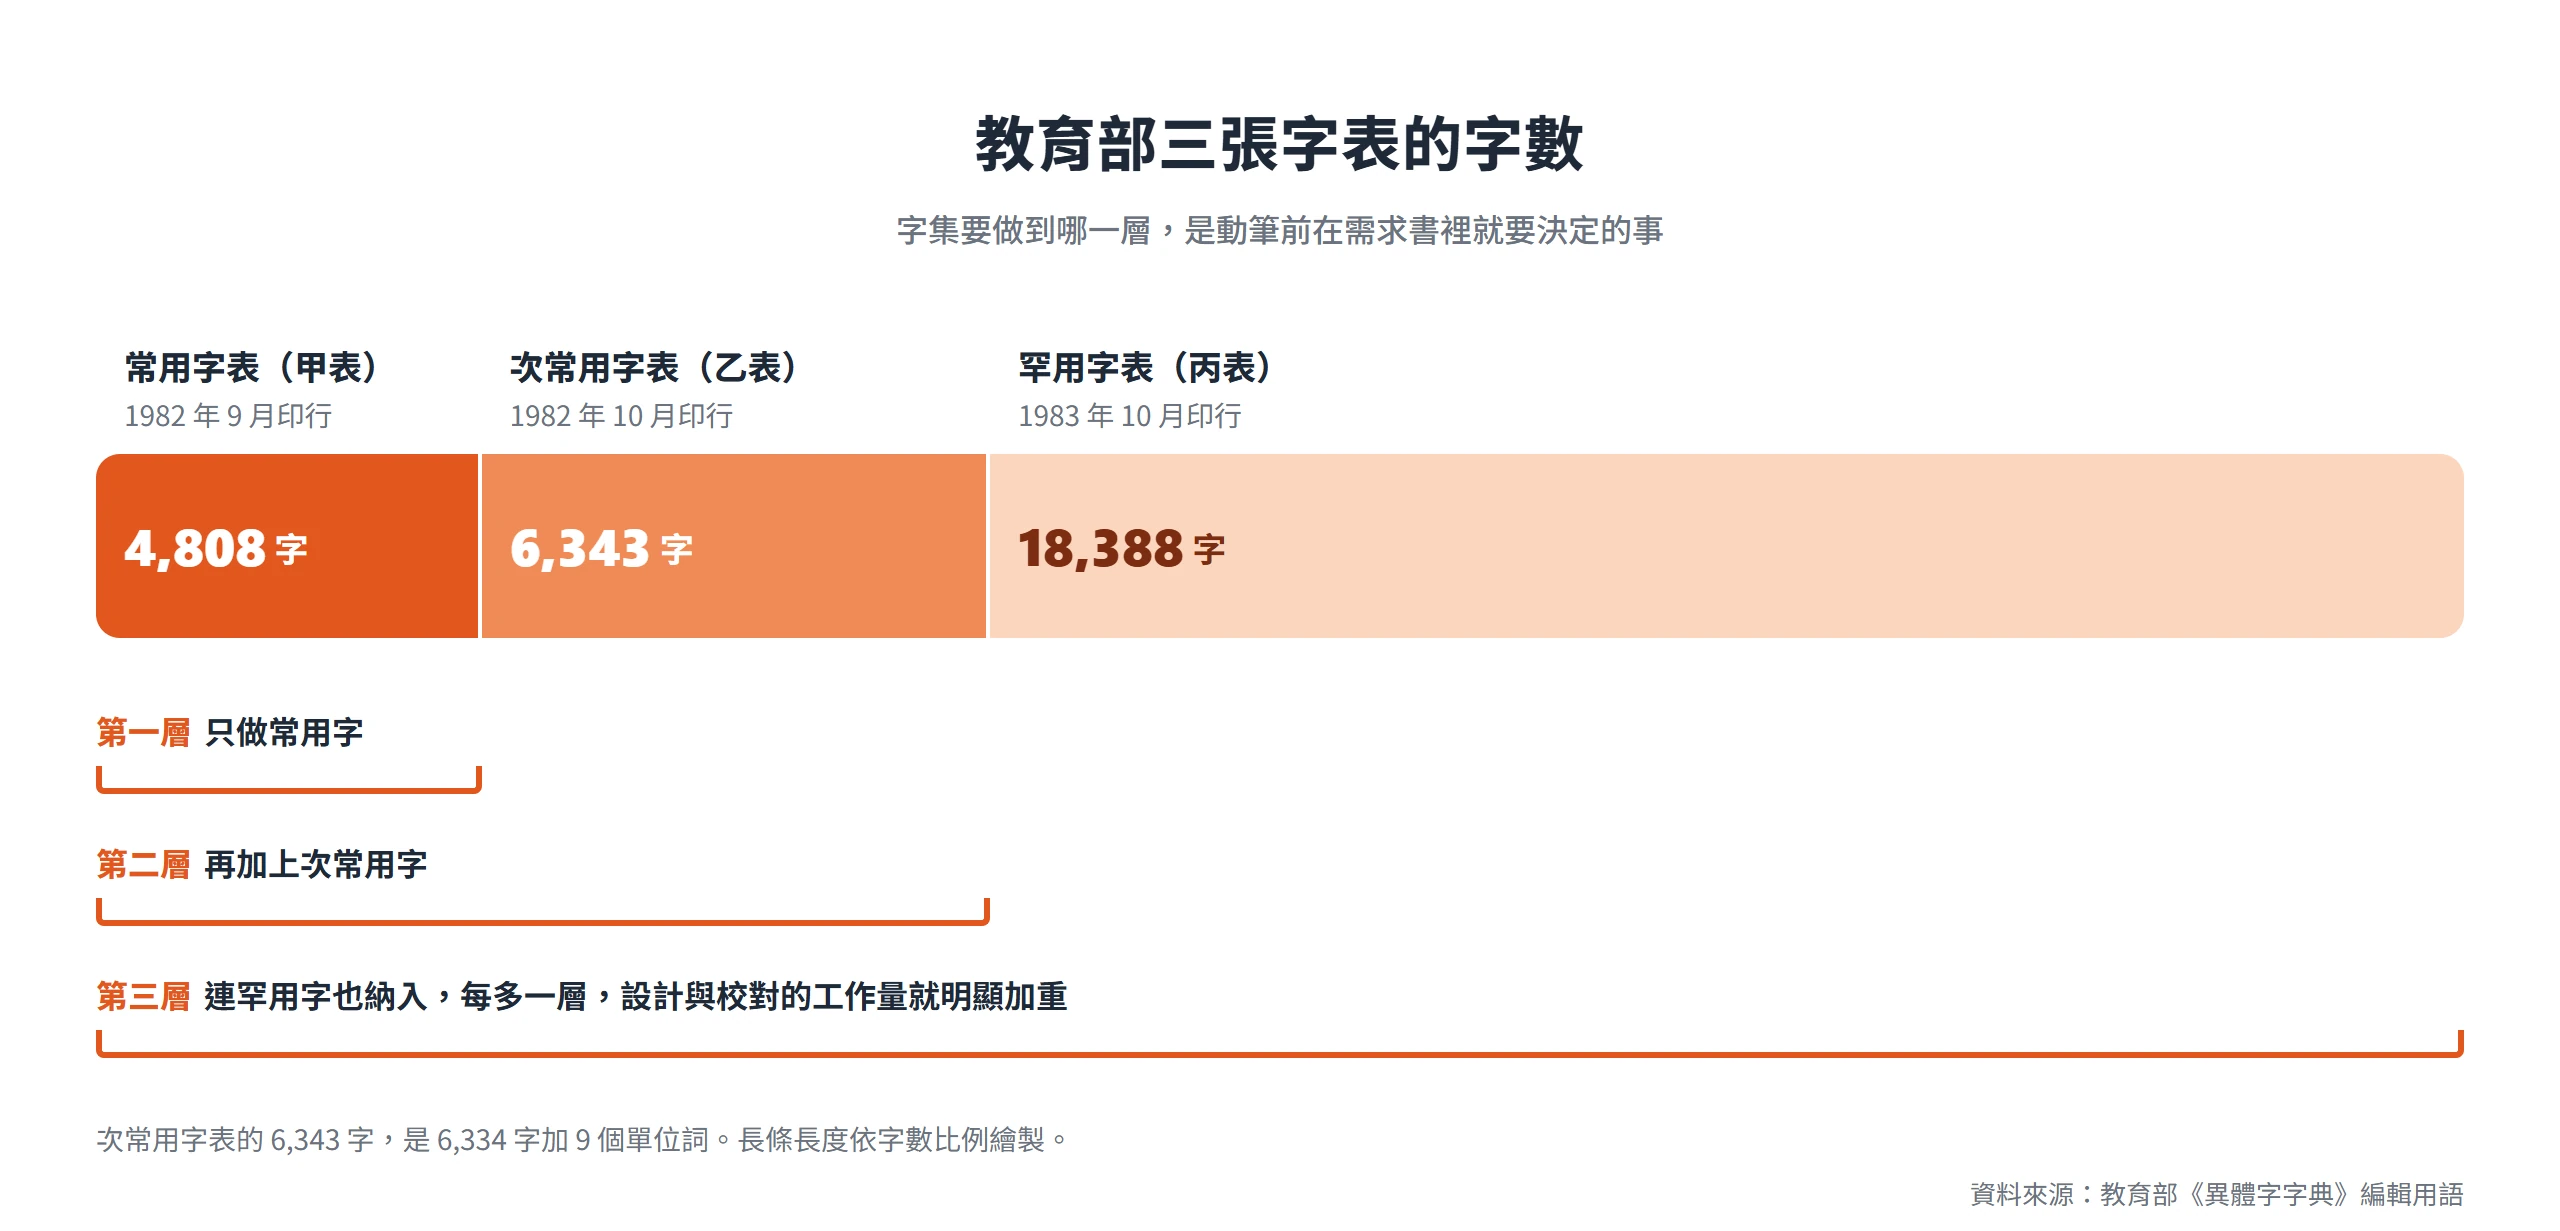
台灣的繁體中文字體,最常對照的範圍是教育部公布的三張字表。教育部《異體字字典》的編輯用語,列出了各表的印行時間與字數:
| 字表 | 印行時間 | 字數 |
|---|---|---|
| 常用字表(甲表) | 1982 年 9 月 | 4,808 字 |
| 次常用字表(乙表) | 1982 年 10 月 | 6,343 字(6,334 字加 9 個單位詞) |
| 罕用字表(丙表) | 1983 年 10 月 | 18,388 字 |
教育部其他文件記載的次常用字與罕用字數量略有出入(例如次常用字 6,341 字、罕用字 18,414 字),上表採用的是異體字字典編輯用語的數字。字集要做到哪一層,是需求書要決定的事。只做常用字是 4,808 字;往下做到次常用字,要再加上乙表的 6,343 字;連罕用字也納入,則還有丙表的 18,388 字。每多一層,設計與校對的工作量就明顯加重。
字表與字型是兩回事。字表定義的是範圍,字型負責把範圍裡的每個字一個一個畫出來。教育部另外還有國字標準字體的楷書、宋體與方體字形標準,是繁體字形寫法的依據。
單一字型檔最多只能容納 65,535 個字形
除了設計工作量,字型檔格式本身也有硬上限。Adobe 說明,OpenType 格式支援的字形數上限是 65,535 個,Source Han Sans 的每個字重都用到這個上限,整個字族合計接近 50 萬個字形。
即使把字形塞到上限,還是放不下所有想放的字。Ken Lunde 說,超過 3,000 個額外的日文字形,就是因為這個上限而必須排除。
對照之下,Google Fonts 的拉丁基本字集 GF_Latin_Core 只有 324 個字形。這也是為什麼中文字體的字集範圍是取捨,不是想收多少就收多少,因為每多收一個字,花掉的都是設計時間,以及這個上限裡剩下的位置。另外有個容易混淆的地方。字集指的是收哪些字,字形指的是實際畫出來的圖;一個字碼可以對應多個字形,例如不同地區的寫法或替代字形,所以字形數量會比字數更多。
部件可以重複使用,每個字仍得逐一調整
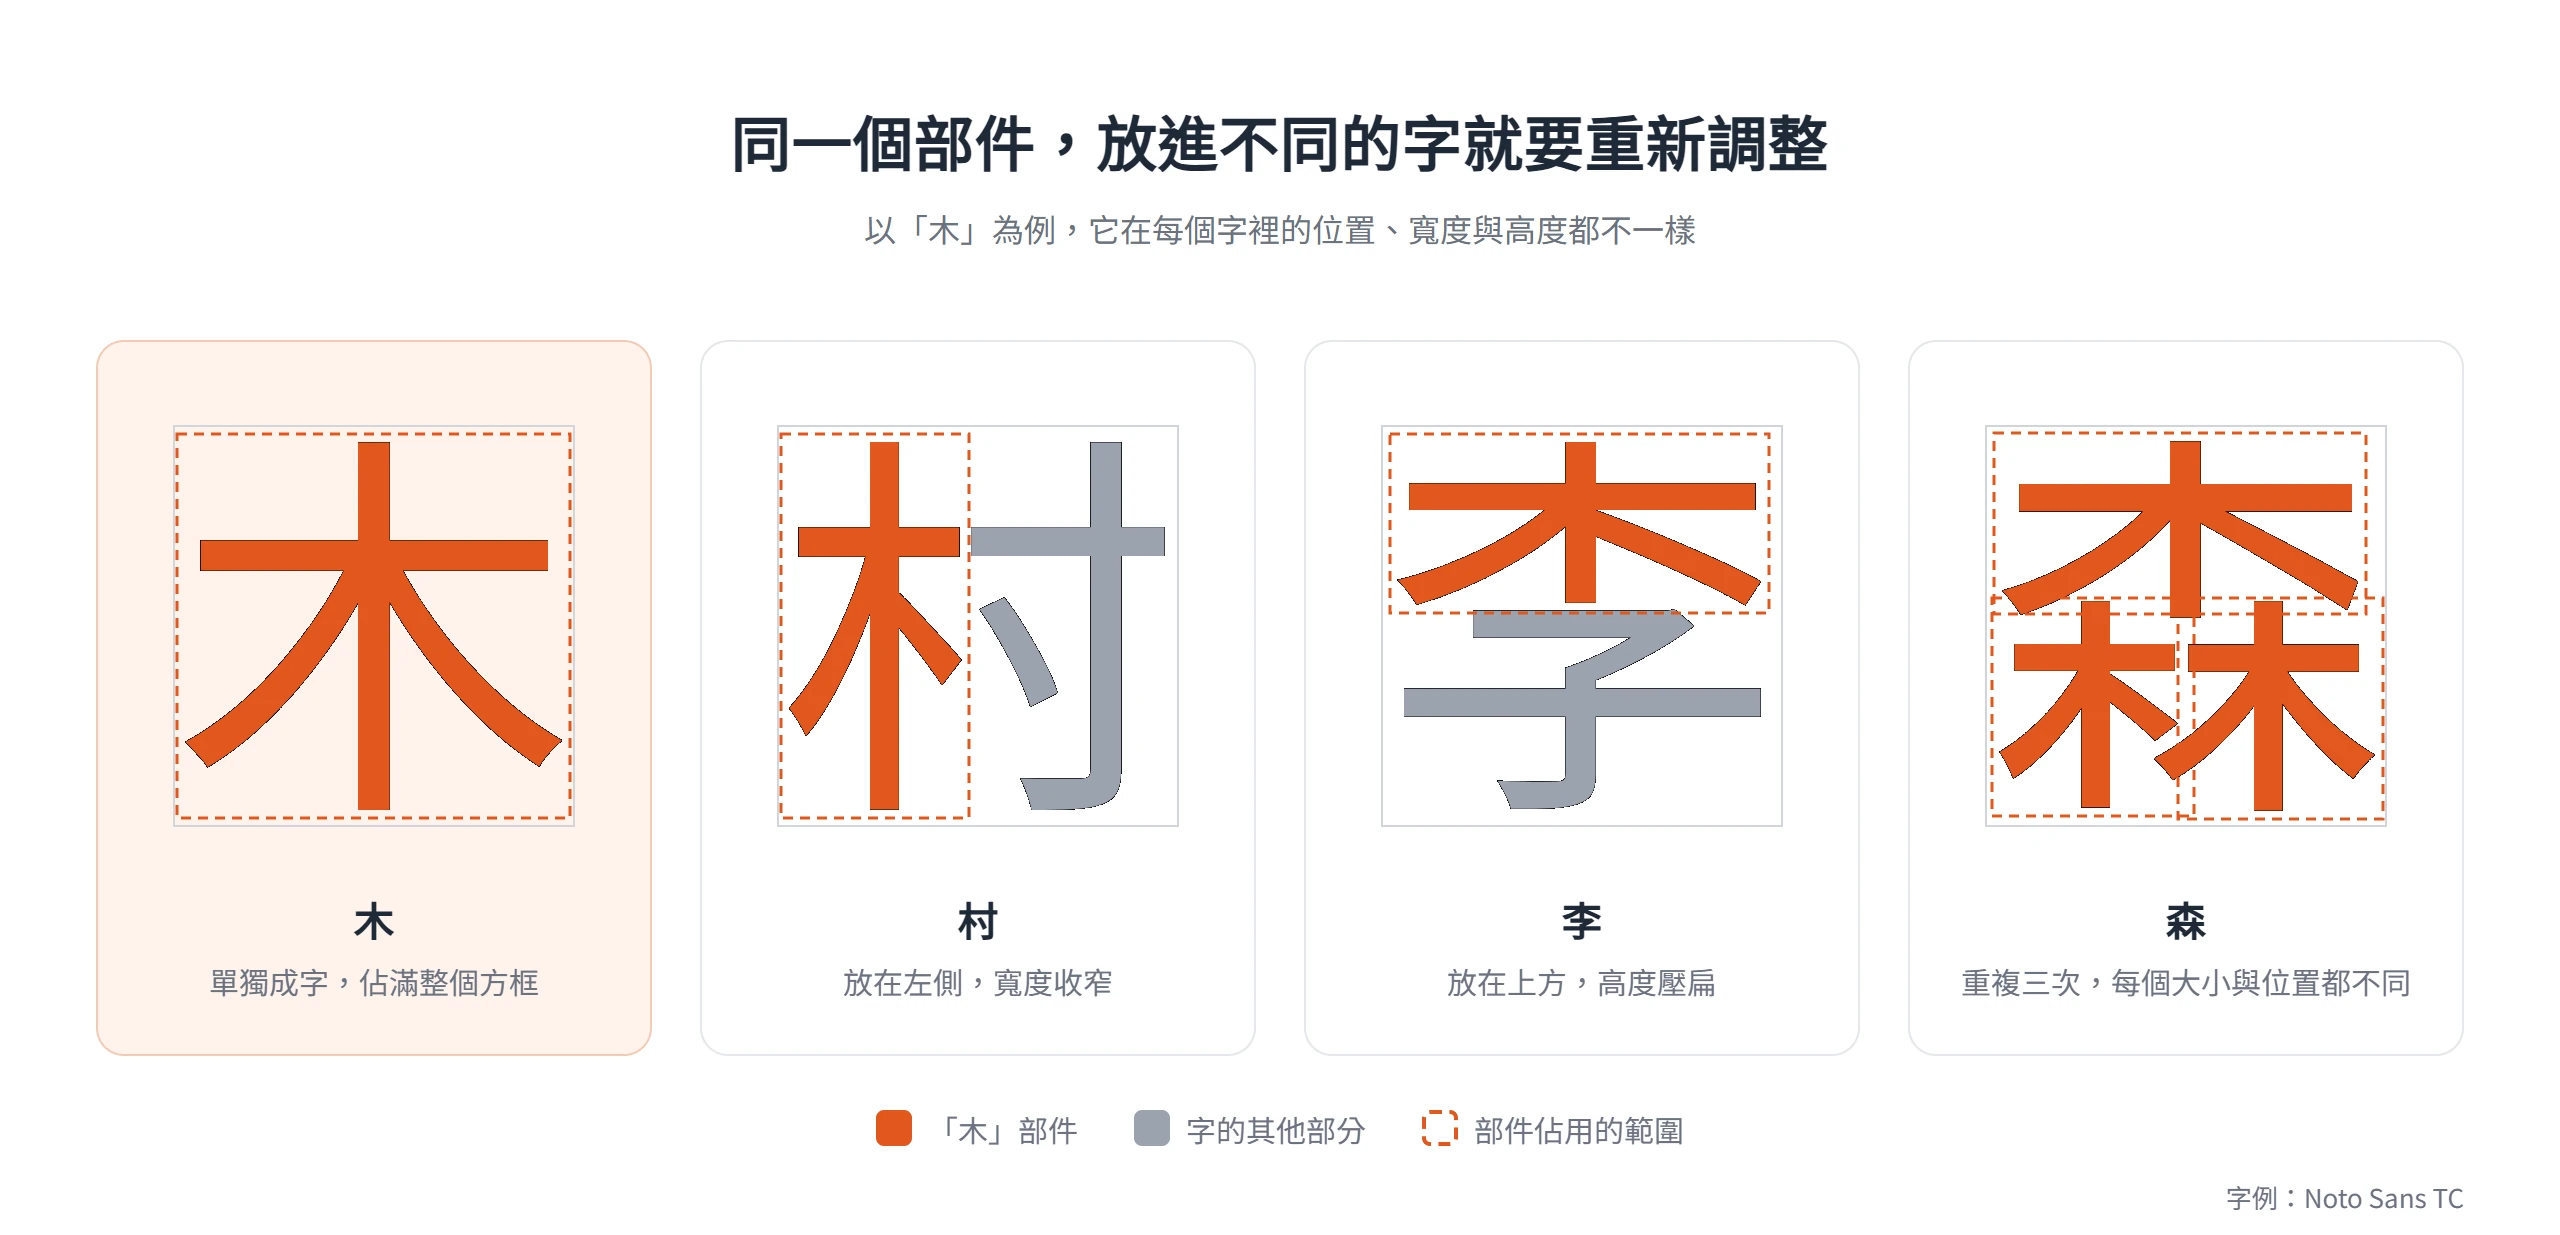
面對數千到數萬個字,字體團隊不是一個字一個字從零開始畫,而是把漢字拆成偏旁部件,重複利用。不過重複利用不等於複製貼上,部件放到不同的字裡,仍得逐一調整。
大型漢字專案常先做縮小字集,再逐版擴充
Adobe 的 Ken Lunde 回憶,他進 Adobe 的第一個專案是 Cube,這是以 multiple master 技術為基礎的 element(部件)系統,用於 Kozuka Mincho 與 Kozuka Gothic,對後來的 Source Han Sans 也很關鍵。他建立了第一個可運作的 Element Library,成果包含約 300 個漢字關鍵字形,在 1991 年底向 Adobe 的創辦人展示。
Adobe 的日文字體 Kazuraki,則能看出字集的規模如何逐版增加。Lunde 在 ATypI 2012 的簡報裡列出了三個版本的規模。原型有 1,223 個字形,其中 297 個是漢字;第 1 版有 2,973 個字形、1,082 個漢字,已經出貨;第 2 版有 3,776 個字形、1,483 個漢字,涵蓋當時全部 1,006 個學習漢字。這三個版本都由同一支腳本產出。
Nishizuka 提到,Kazuraki 製作耗時,收錄的漢字數量因此不足,常有人要求擴充字形。這也說明了為什麼漢字多的專案,常先完成一個縮小字集的版本,再逐步擴充。
偏旁部件靠工具重用,細節由設計師逐字校準
漢字的結構天然可以拆成部件,所以字體團隊會建立部件庫來重複使用。Source Han Sans 的漢字,一開始就是以 Kozuka Gothic 為基礎,而 Kozuka Gothic 就是用修改過的 element 做出來的。Nishizuka 也提到,專案啟動時,團隊使用的是公司內部仍在開發中的漢字製作應用程式。
部件放進不同的字之後,粗細與位置仍得依整個字重新判斷。Typotheque 一篇討論超粗中文字體的文章,用「鬱」示範怎麼處理複雜字,先拆成上下兩個一級部件,再各自拆成二級部件,接著判斷哪些筆畫是部件裡的主筆、哪些落在外緣,這些筆畫要加粗。即使筆畫位在字的內部,只要它是整個字裡主要的橫畫,也不能忽略;與旁邊筆畫成對稱形的筆畫,要一起加粗,否則字會失衡。
工具面也有對應的設計。Glyphs 的智慧型部件(Smart Components)最初就是為了設計 CJK 字形而做的,能複用偏旁,也可以用在拉丁字母。固定不變的一般部件無法調整,舉例來說,把 n 的肩部複用到 m 或 h 時,m 的肩部通常要稍微變窄,h 的分叉則要下移,這時就需要能變形的部件。
AI 生成字庫多從部件組合切入,品質仍待突破
電腦自動補字也是近年的研究方向。目前可查到的代表性研究,多半是 arXiv 上的預印本,發表時不經同行審查,只能視為研究方向,不能當成已經證實的結論。
其中一份 2024 年的預印本觀察到,多數漢字可以拆成經常重複使用的部件,因此提出以部件組合的方式,從少量部件產生大量向量漢字。作者蒐集了一個含超過 9 萬個漢字、並附上部件與版面資訊的資料集,主張在大規模、結構複雜的漢字上,表現優於現有的向量字體生成方法。
另一份 2025 年的綜述預印本,整理了深度學習時代的中文字體生成研究,目標是依據一些參考樣本,建立新的中文字庫,並依所需參考樣本的數量,分成 many-shot 與 few-shot 兩類方法。作者也指出,如何提升生成的中文字圖像的整體品質,仍然是難題。
從這兩份預印本來看,研究的重點放在用少量樣本學習風格,以及先拆部件再組合,後者正對應字體團隊一直以來重用部件的做法。
筆畫多寡懸殊的字都得放進同一個方框
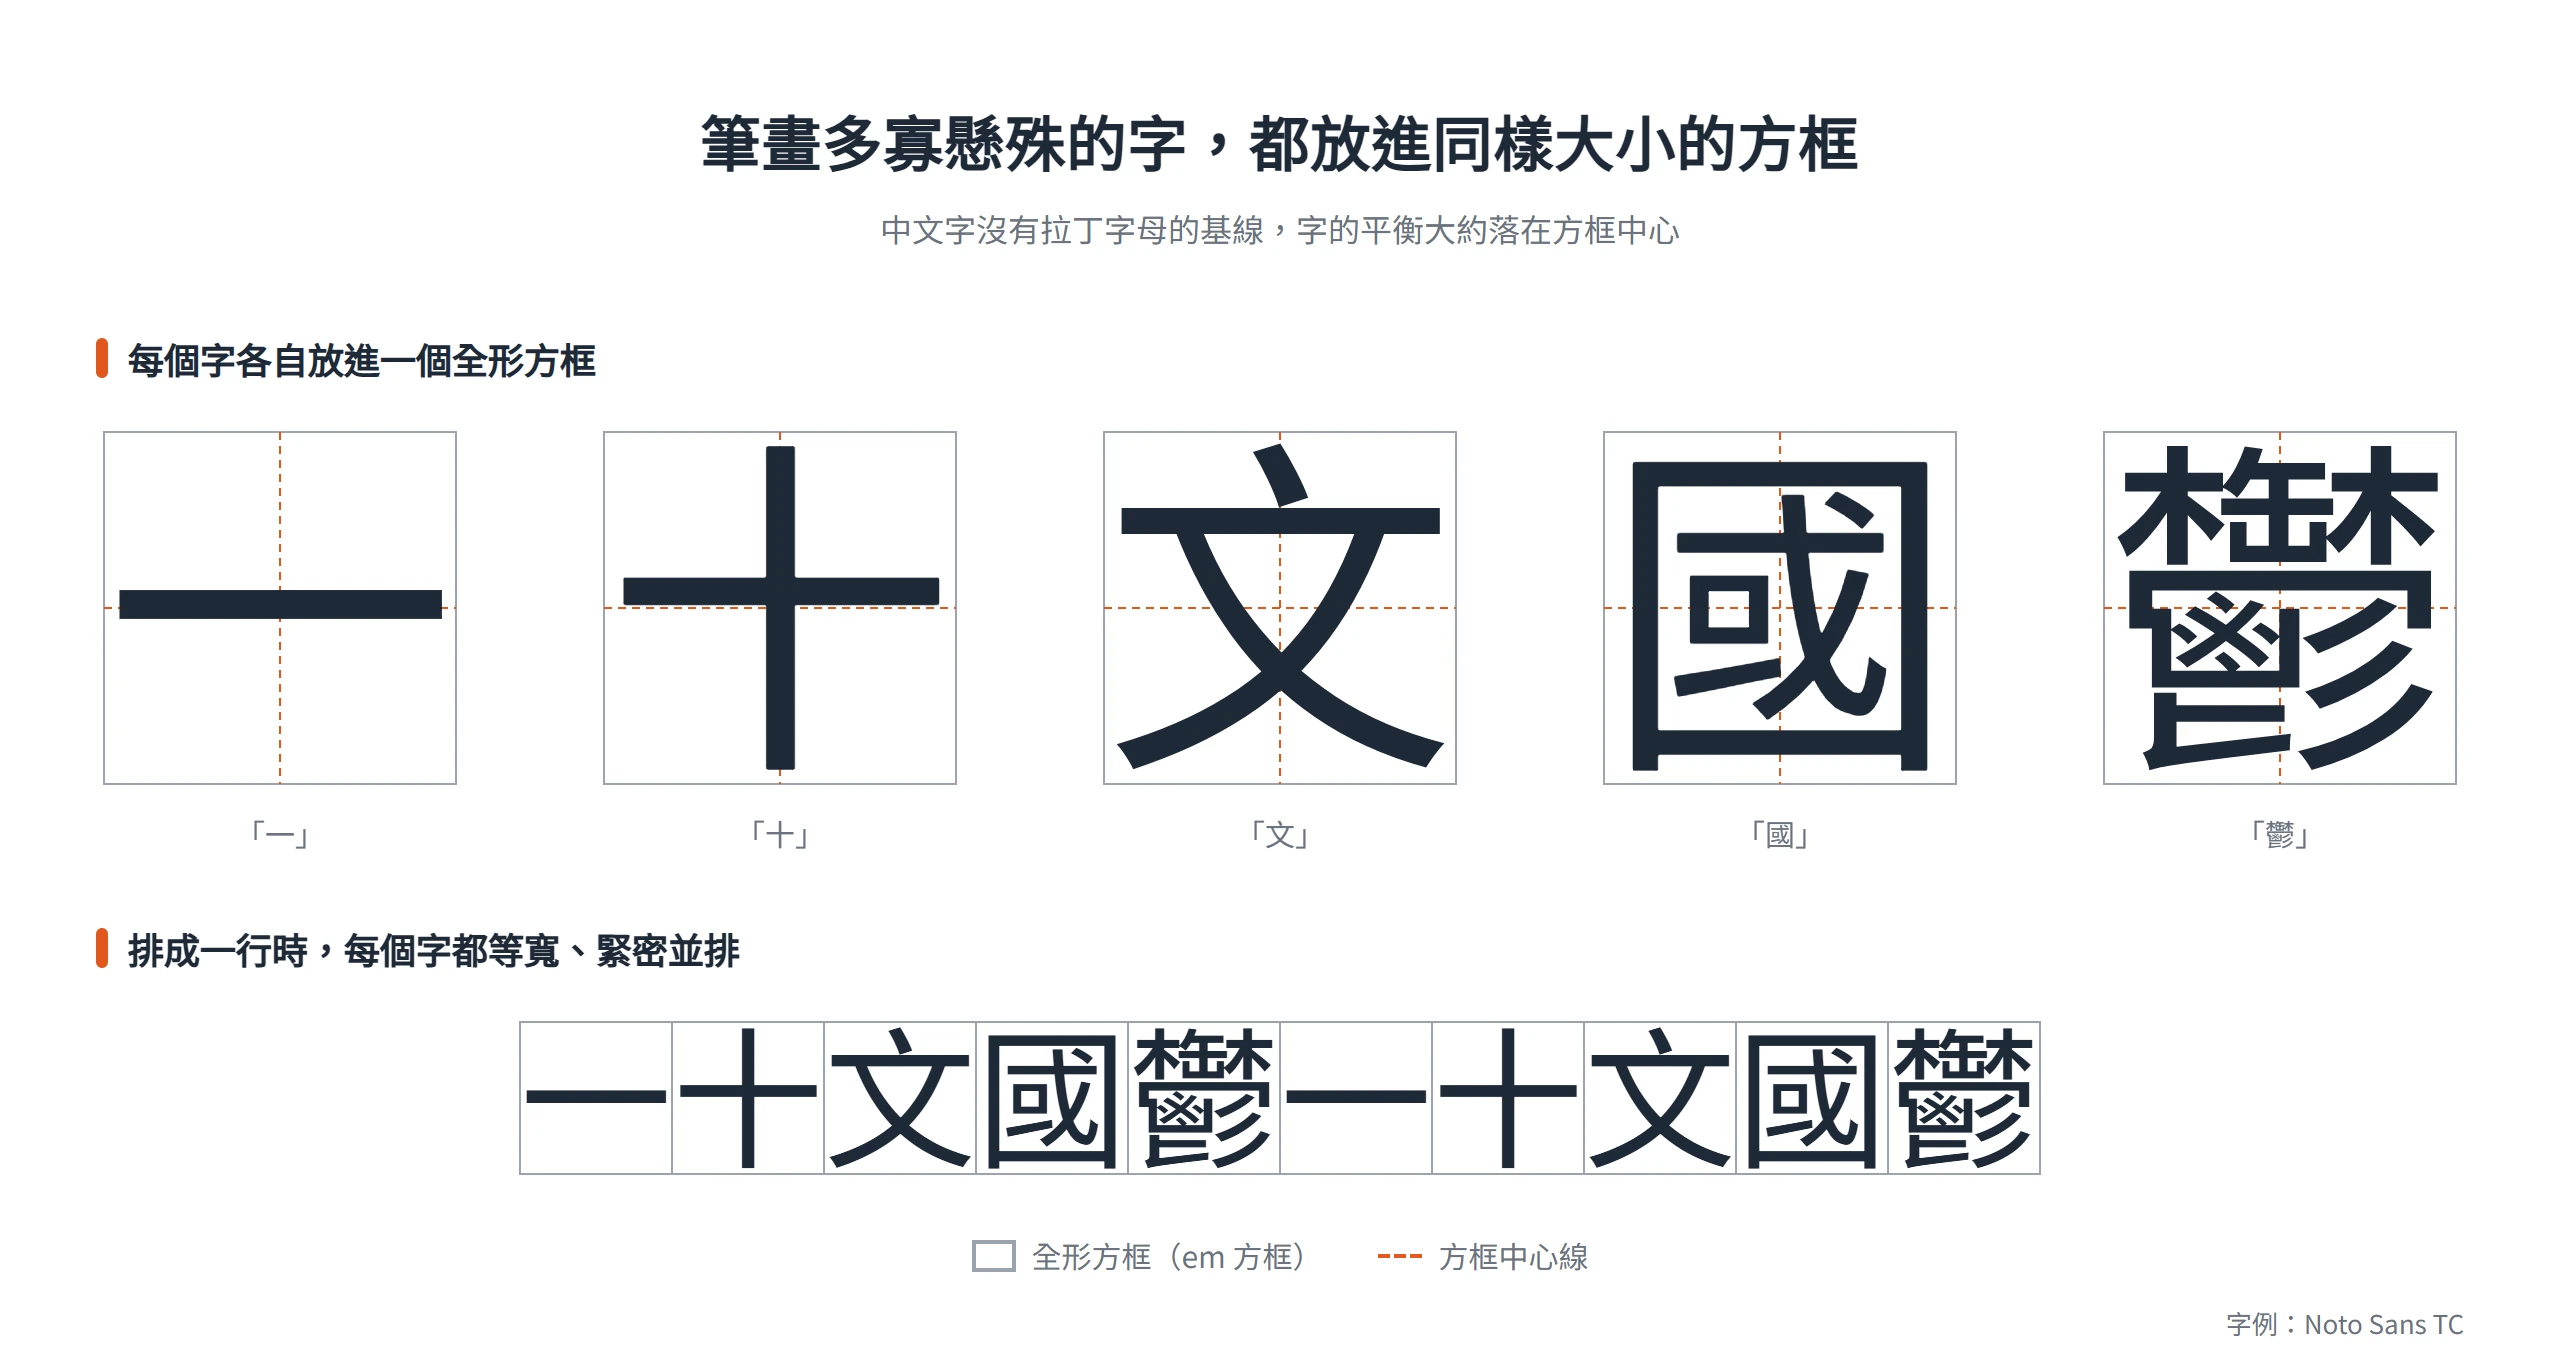
只有一畫的「一」和筆畫繁多的「鬱」,要在同樣大小的方框裡看起來一樣重、一樣穩,是中文造字最核心的設計難題。解法不是把每個字畫得一樣粗,而是依筆畫的主次,重新分配粗細與留白。
方框與重心取代了拉丁字母的基線
Google Fonts Knowledge 指出,拉丁字體多半預設是比例字寬,多數 CJK 字體卻是等寬,中文與日文字體設計成塞滿整個 em 方框。W3C 的《中文排版需求》同樣寫到,原則上中文排版使用的漢字與標點,比例皆為 1:1 的正方形,彼此緊密排列。
因為是方框,CJK 字體沒有基線的概念,字的平衡大約落在 em 方框的中心,適當的重心取決於字體設計與書寫方向。重心通常設在中間,但可以上移或下移;重心偏高的字體,看起來通常較精緻典雅,偏低的則較隨性。
Monotype 在介紹自家 M Ying Hei 時,把較寬的「中宮」(字的中央部分)類比成拉丁字體的大 x-height,說這讓字內有更多空間,並提升了螢幕、印刷與看板上的易讀性。這是 Monotype 對自己設計取捨的說法,但它點出的是,方框內的空間怎麼分配,會是中文字體風格的主要變數。
另外,中文也沒有真正的斜體。Google Fonts Knowledge 指出,CJK 文字並沒有斜體,有時只是為了設計效果,把字形做成偽斜體;需要強調時,習慣改用引號、括號、著重點、粗體或換色。
疏密不同的字靠筆畫粗細取得一致的視覺重量
筆畫少的字,可以把每一筆統一加粗,但筆畫多到一定程度,就需要更細膩的方法。最直覺的做法,是盡量壓縮留白、讓每一筆粗一點,只是複雜的字會因此變得過黑過重,小字級甚至看不清楚。
Typotheque 提出的第二種做法,是加強某些主要筆畫、減弱其他筆畫,也就是拉大粗細對比。他們用一個遮蓋實驗佐證:遮住字的中心時,人們通常仍能靠輪廓認出字;遮住輪廓、只露出中心,則很少人認得出來。所以外緣筆畫和主筆一樣重要。
團隊實作時發現,設計師對粗細對比的詮釋並不一致,大致可分成兩種取向。maximise darkness 是先把留白壓縮到最黑,再加上對比;maximise boldness 則是先加強粗細對比,不過度壓縮留白。他們也做了讀者調查,多數受訪者認為字要達到一定的黑度才算夠重,團隊最後取兩個方向的平衡。
中文字重加粗時方框不會跟著變寬
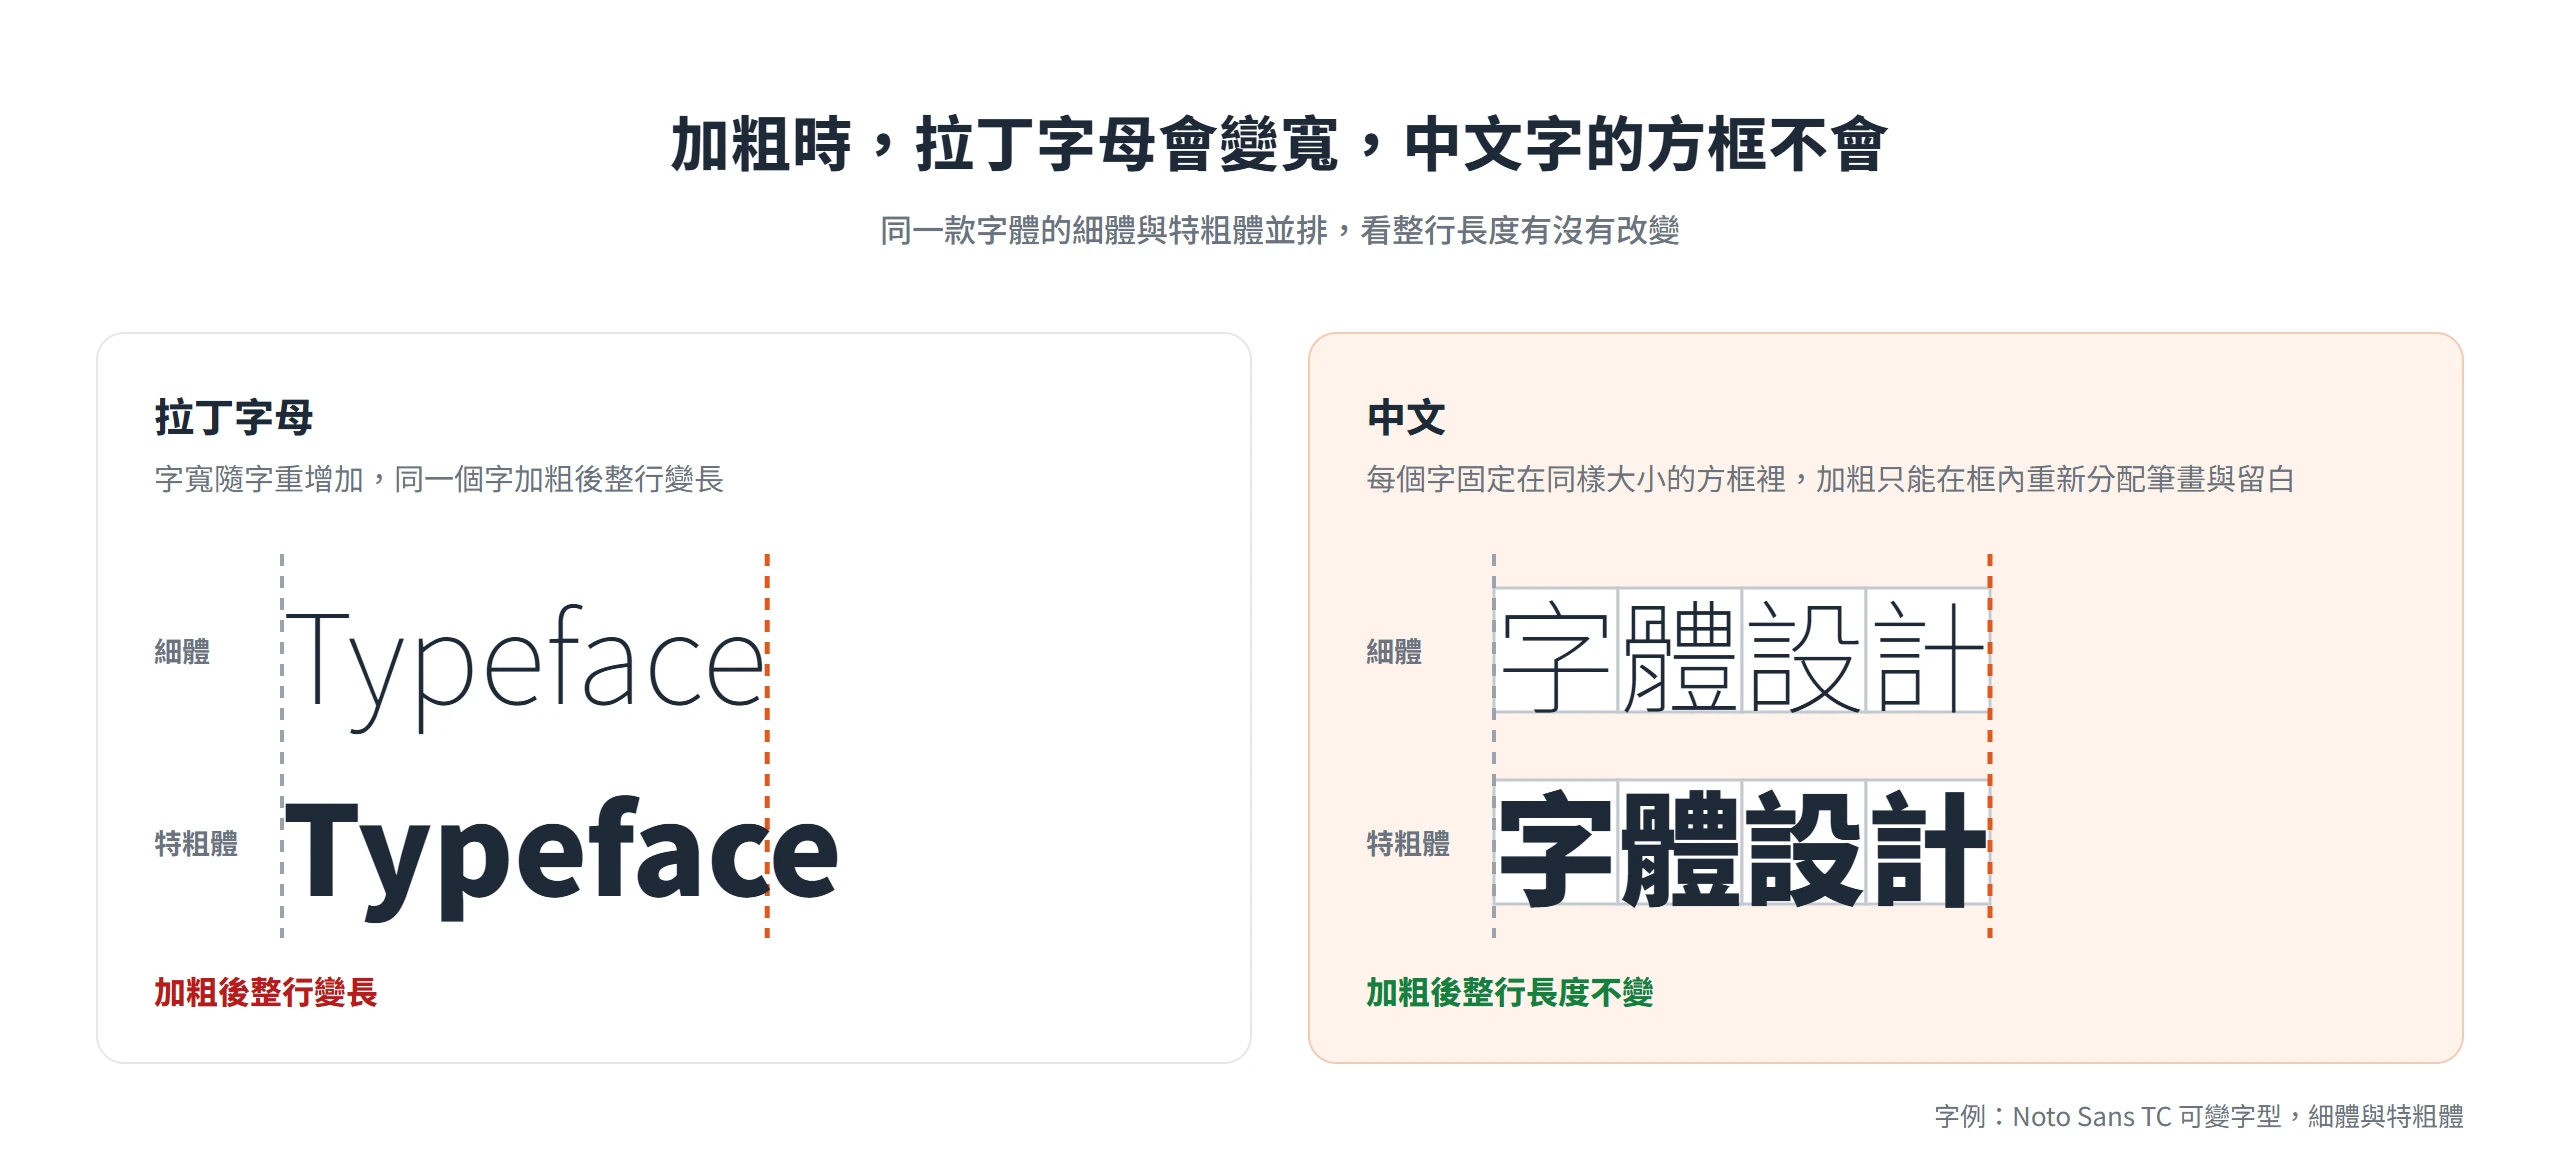
拉丁字母加粗時,字寬跟著增加,整行文字也會變長;中文沒有這個餘地。Typotheque 指出,自活字印刷以來,中文字體的每個字都被限制在固定大小的字框內,不論字多複雜,都必須塞進同樣的空間,文字長度不應該因為字重增加而改變。粗字重因此只能在有限的空間裡,重新分配筆畫與留白。
宋體的情況更特別。同一篇文章提到,宋體的橫畫不會隨字重增加而變粗,所以超粗的宋體不能和常規字重共用同一套骨架,否則不變的細橫畫會留下過多空白,造成超粗與常規字重之間的視覺比例失真。設計超粗宋體時,要時常觀察留白比例,用它來檢查結構是否一致、準確。
這也是前面提到插值有其限制的原因。兩端母版之間可以自動計算,但最粗字重的骨架要另外設計與檢查,不能只靠從常規字重往外推。
同一個字在各地區的標準字形並不相同
同一個 Unicode 字碼,在繁體中文、簡體中文、日文與韓文裡,標準寫法可能不同。設計中文字體時,得先確定照哪個地區的標準來畫。
繁簡日韓共用的漢字各有慣用字形
Google 用「骨」字來說明這件事。中日韓三地的漢字都源自古漢字,但在各地的語言中獨立演變,同一個字的形狀因語言而異。「骨」在簡體中文、繁體中文與日韓字形裡,內部上方與下方的寫法不盡相同。
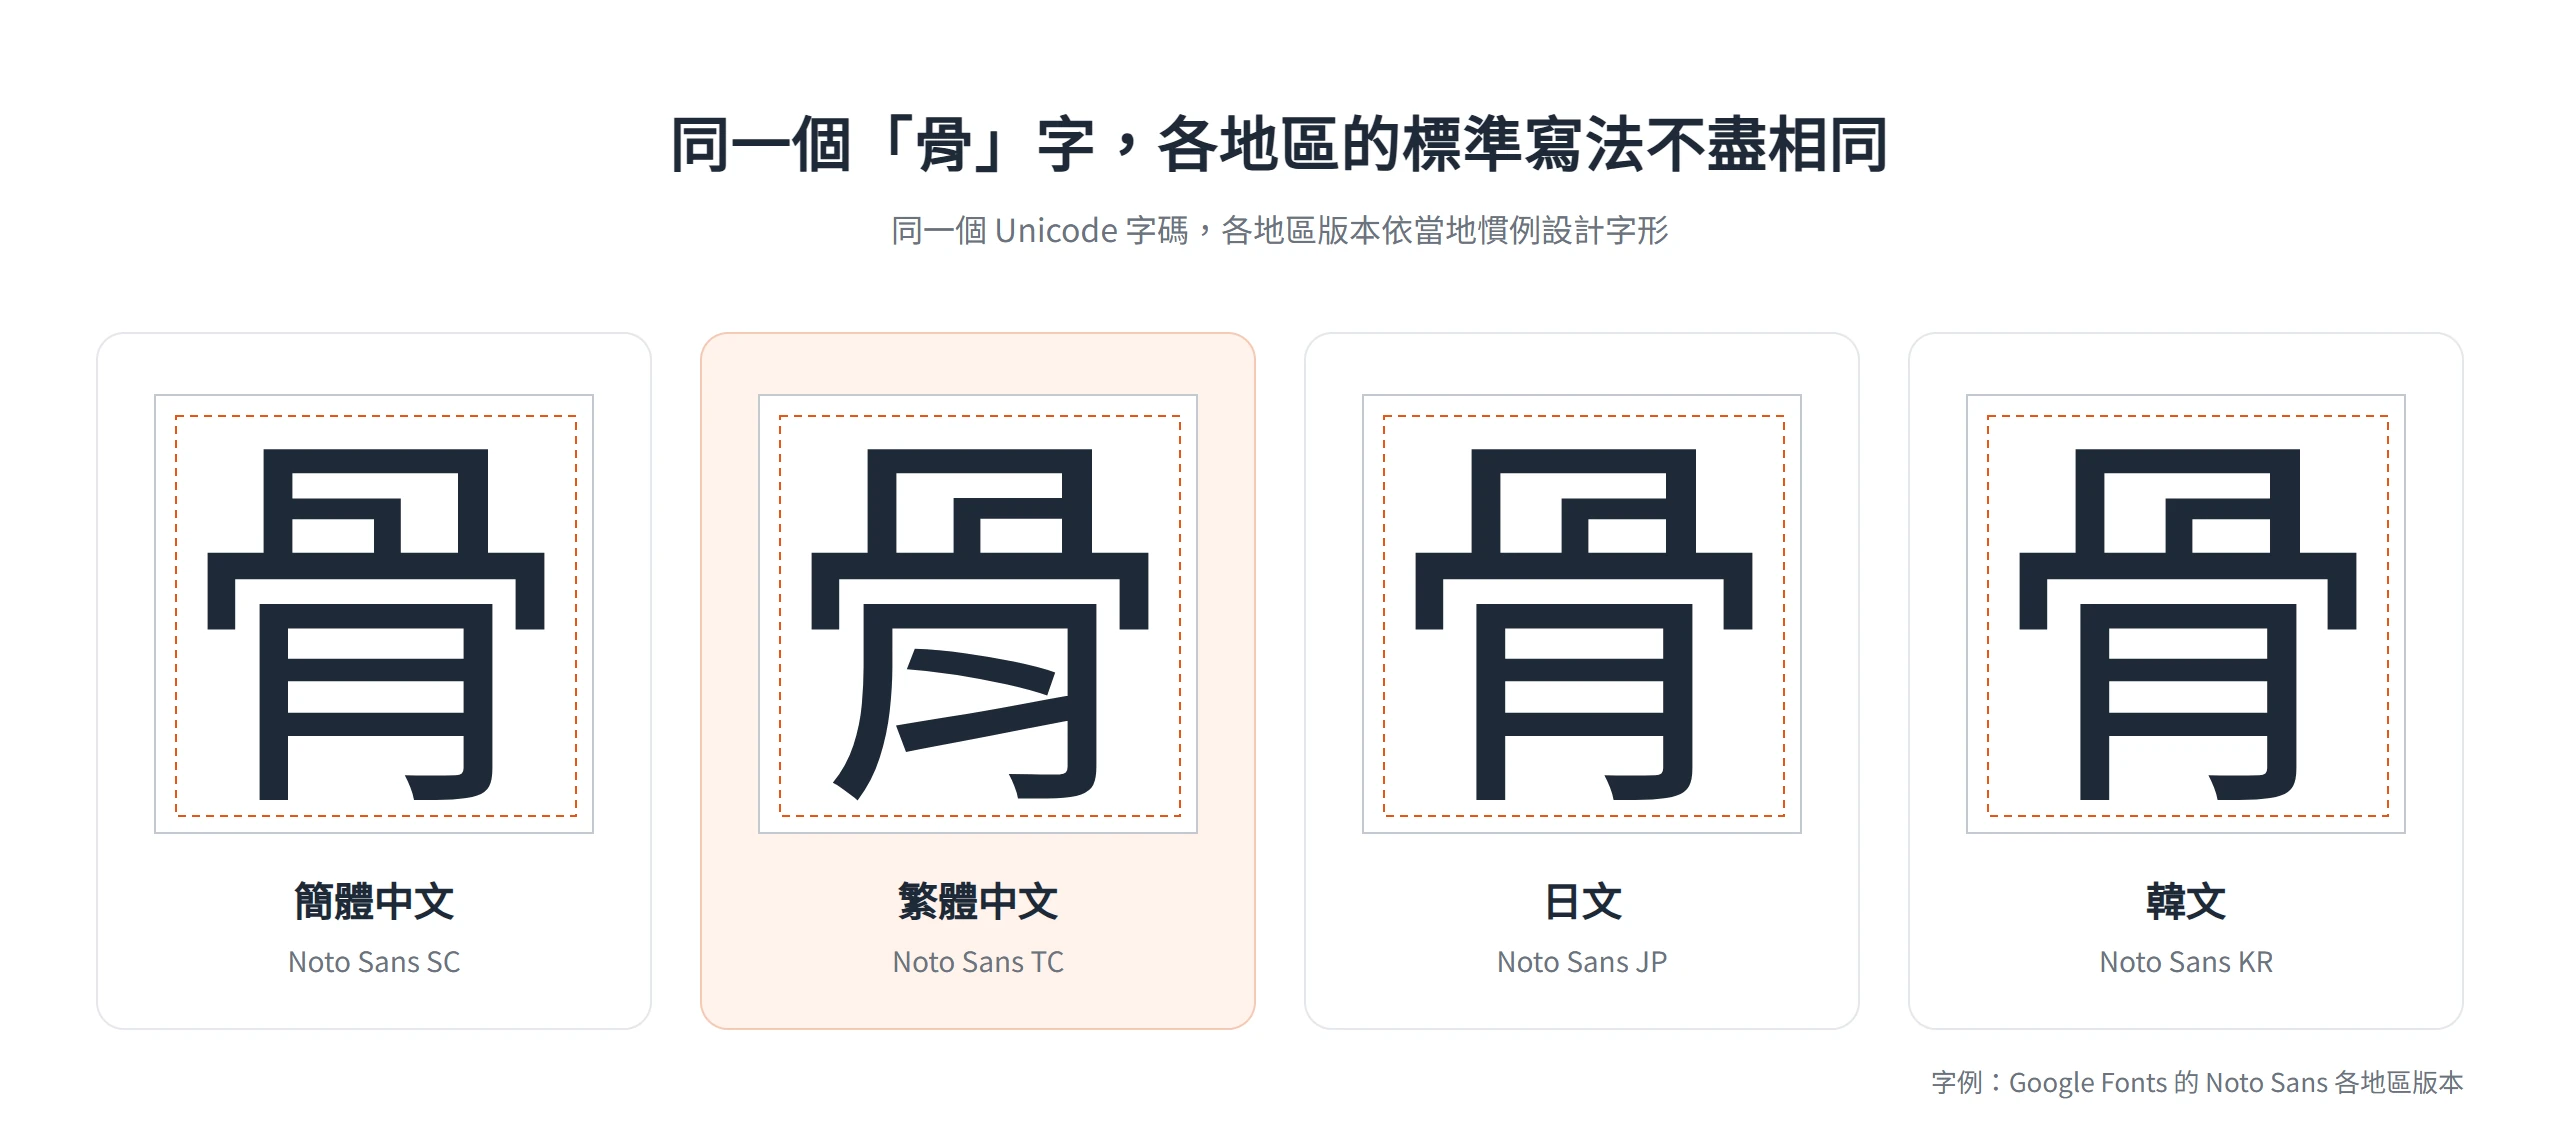
正因為三地共用大部分的字、寫法卻不盡相同,Noto Sans CJK 的主要設計目標之一,是讓每種文字保有符合地區慣例的獨特外觀,同時彼此和諧。設計時不能拿一地的寫法,直接套用到其他地區。
思源宋體繁體版依循教育部標準字體,標準本身也需核對
繁體字形要對照哪一份標準?以 Google 與 Adobe 合作推出的開源襯線字體 Noto Serif CJK TC(思源宋體繁體版)為例,Google 在 2017 年發布時說明,它支援 BIG5 字符,繁體中文字形依據台灣教育部的國字標準字體規範。這裡只拿這一款當例子,不代表所有繁體字型都照同一套標準。
標準本身,也需要核對。Adobe 的 Ken Lunde 撰文提到,Google 的吳光哲在教育部方體母稿裡發現問題:「敻」(U+657B)的攵部件寫法不對,「鶛」(U+9D9B)的比部件右側寫法不對,正確寫法可以在宋體與楷書的標準裡找到,教育部回覆也確認了這些錯誤。文章的結論是,資料量這麼大的標準難免出現個別錯誤,字型團隊較好的做法是不複製錯誤,並回報給標準單位。
Source Han Sans 的跨國分工靠統一字形規格與在地設計師
Source Han Sans 是 Adobe、Google 與三家在地字體公司(日本的 Iwata、韓國的 Sandoll Communication、中國的 Changzhou SinoType)共五家公司合作的成果。各語言的漢字,需要有多年在地設計經驗的字體公司才處理得好,因此這三家公司負責繪製大部分的字形。Nishizuka 負責底層設計,Ken Lunde 則管理字形集與 Unicode 對應規格,整併夥伴交來的字形內容,並產出最終字型。
Lunde 說,最困難的任務,是判斷哪些字形可以跨地區共用、哪些不行。多家公司的資料要整併成運作一致的單一字形集,所以每個字形都有一個以 Unicode 為基礎的唯一工作名稱,有助於自動化產出各種資源。團隊在過程中也發現各國標準有錯誤與不一致的地方,並回報給相關的標準機構。
Nishizuka 則指出,跨國設計很難理解國外的設計意圖,逐一判斷某個怪異寫法是錯誤還是刻意設計,相當耗時,最好由在地設計師為在地製作字形。放到訂製字體上也一樣,要做繁體中文字體,台灣讀者慣用的寫法,交給熟悉這套寫法的設計師判斷最可靠。
訂製品牌字體前,先談定使用情境與字集範圍
前面講的流程與難處,轉成品牌方與設計師真正用得上的判斷,就是先談語氣與使用場景,再談字集範圍與期程。即使不打算自己造字,這些判斷也能用來看懂一份訂製字體的提案。
品牌字體從語氣與使用場景出發
Crossgrove 說,品牌常希望與競爭者區隔、提升辨識度,或是希望字體在各種裝置與環境下更好讀,也可能兩者兼具;拓展新地區、改版或新增產品,也是常見的原因。Monotype Studio 會與客戶密切合作,了解對方的機會、挑戰與品牌個性。
Monotype 為品牌做的訂製字體,起點是客戶對語氣與聲音的想法,以及字體會在哪裡被看到、被使用的明確畫面。有時風格感受只是細微的差別,功能更重要;時尚或化妝品牌則常把字母的外顯風格擺在第一位。這兩種取向,決定了後面設計的重心。
提案階段則要回到前面說的真實情境測試。同一字級的黑白字母表看不出語氣對不對,把字體放進品牌自己的介面、顏色與版面裡,才判斷得出感覺是否符合。
字集範圍與字重數量決定工作量與期程
把前面的中文難處收成兩個變數,就是字集多大、字重幾個。字集範圍可以分層來想:只含拉丁字母、含中文常用字、擴到次常用字、再到罕用字,每往上一層,就是前面看過的字數再往上加。字重和字寬的數量,則決定母版與檢查的次數,而中文的粗字重,還得另外檢查骨架。
前面提過 Lunde 建議限制字集與語言涵蓋範圍,這對品牌字體同樣適用;如果品牌需要中文、日文與拉丁字母混排,也要在設計階段就一起考慮。Monotype 為一家中國網路服務公司開發全球字體家族時,就把中文、日文與拉丁字元之間的和諧,列為重點。
期程方面,Crossgrove 說,單一設計本身就可能占去設計師數月甚至數年的人生。簡單的展示字體,從概念草稿到完成可能只要 3 個月,大型複雜的字族則可能需要數年,實際長短取決於優先順序,以及設計師能多專注在開發上。字集範圍與字重數量越大,期程就越容易落在後面這一端,所以期程要和字集範圍一起談。
字體設計看起來像是畫字的工作,實際上是一連串取捨:字集收到哪一層、粗字重的骨架怎麼分配、依哪個地區的字形標準。這些答案越早寫下來,後面每一步越有依據。下次評估一套新字體,或打算委託訂製時,先問清楚它要用在哪裡、收了多少字、照哪個地區的標準畫,就能看出這套字體背後做了哪些決定。