7 個常用的 AI detector 一起檢查同一批 91 篇托福作文,這些作文全是真人寫的,結果平均有 61.3% 被判成 AI 產生。同一批檢測器看美國八年級生的作文,卻判得近乎完美。這是史丹佛大學研究團隊 2023 年發表在《Patterns》期刊的實驗,它點出一件很多人沒意識到的事,那就是檢測器亮出的百分比,量的是文字「長得像不像機器寫的」,而不是「誰寫的」。
這件事有切身的代價。一份報告被標上 AI率 38%,作者明明是一字一句自己打出來的,卻得開始解釋;反過來,一篇真的靠 AI 擬稿的文章拿到很低的分數,也不代表它就沒問題。AI檢測給出的是統計上的估計,各個工具的算法、單位與適用範圍都不一樣,同一個數字換一個工具,意思可能完全不同。
分數能證明多少,取決於它是怎麼算出來的,而這些算法偏偏有幾個固定的盲區。被質疑的時候能不能把話說清楚,或是自己用 AI 輔助寫作時該怎麼揭露才站得住腳,都要先知道這些盲區在哪裡。
AI detector 是什麼?
AI detector 是一類工具的統稱,做的事是估算一段文字有多像機器寫出來的。中文常見的說法有 AI檢測、AI偵測、AI檢測器,英文則是 AI detector 與 AI checker,這幾個詞在這篇指的都是同一類工具;至於 AI率,則是這類工具輸出的比例數字,例如「AI率 38%」。
| 常見說法 | 在這篇指的是 |
|---|---|
| AI detector、AI checker、AI檢測器 | 估算文字像不像機器寫的工具 |
| AI檢測、AI偵測 | 用這類工具檢查文字的動作 |
| AI率 | 工具輸出的比例數字,各工具的算法與單位並不相同 |
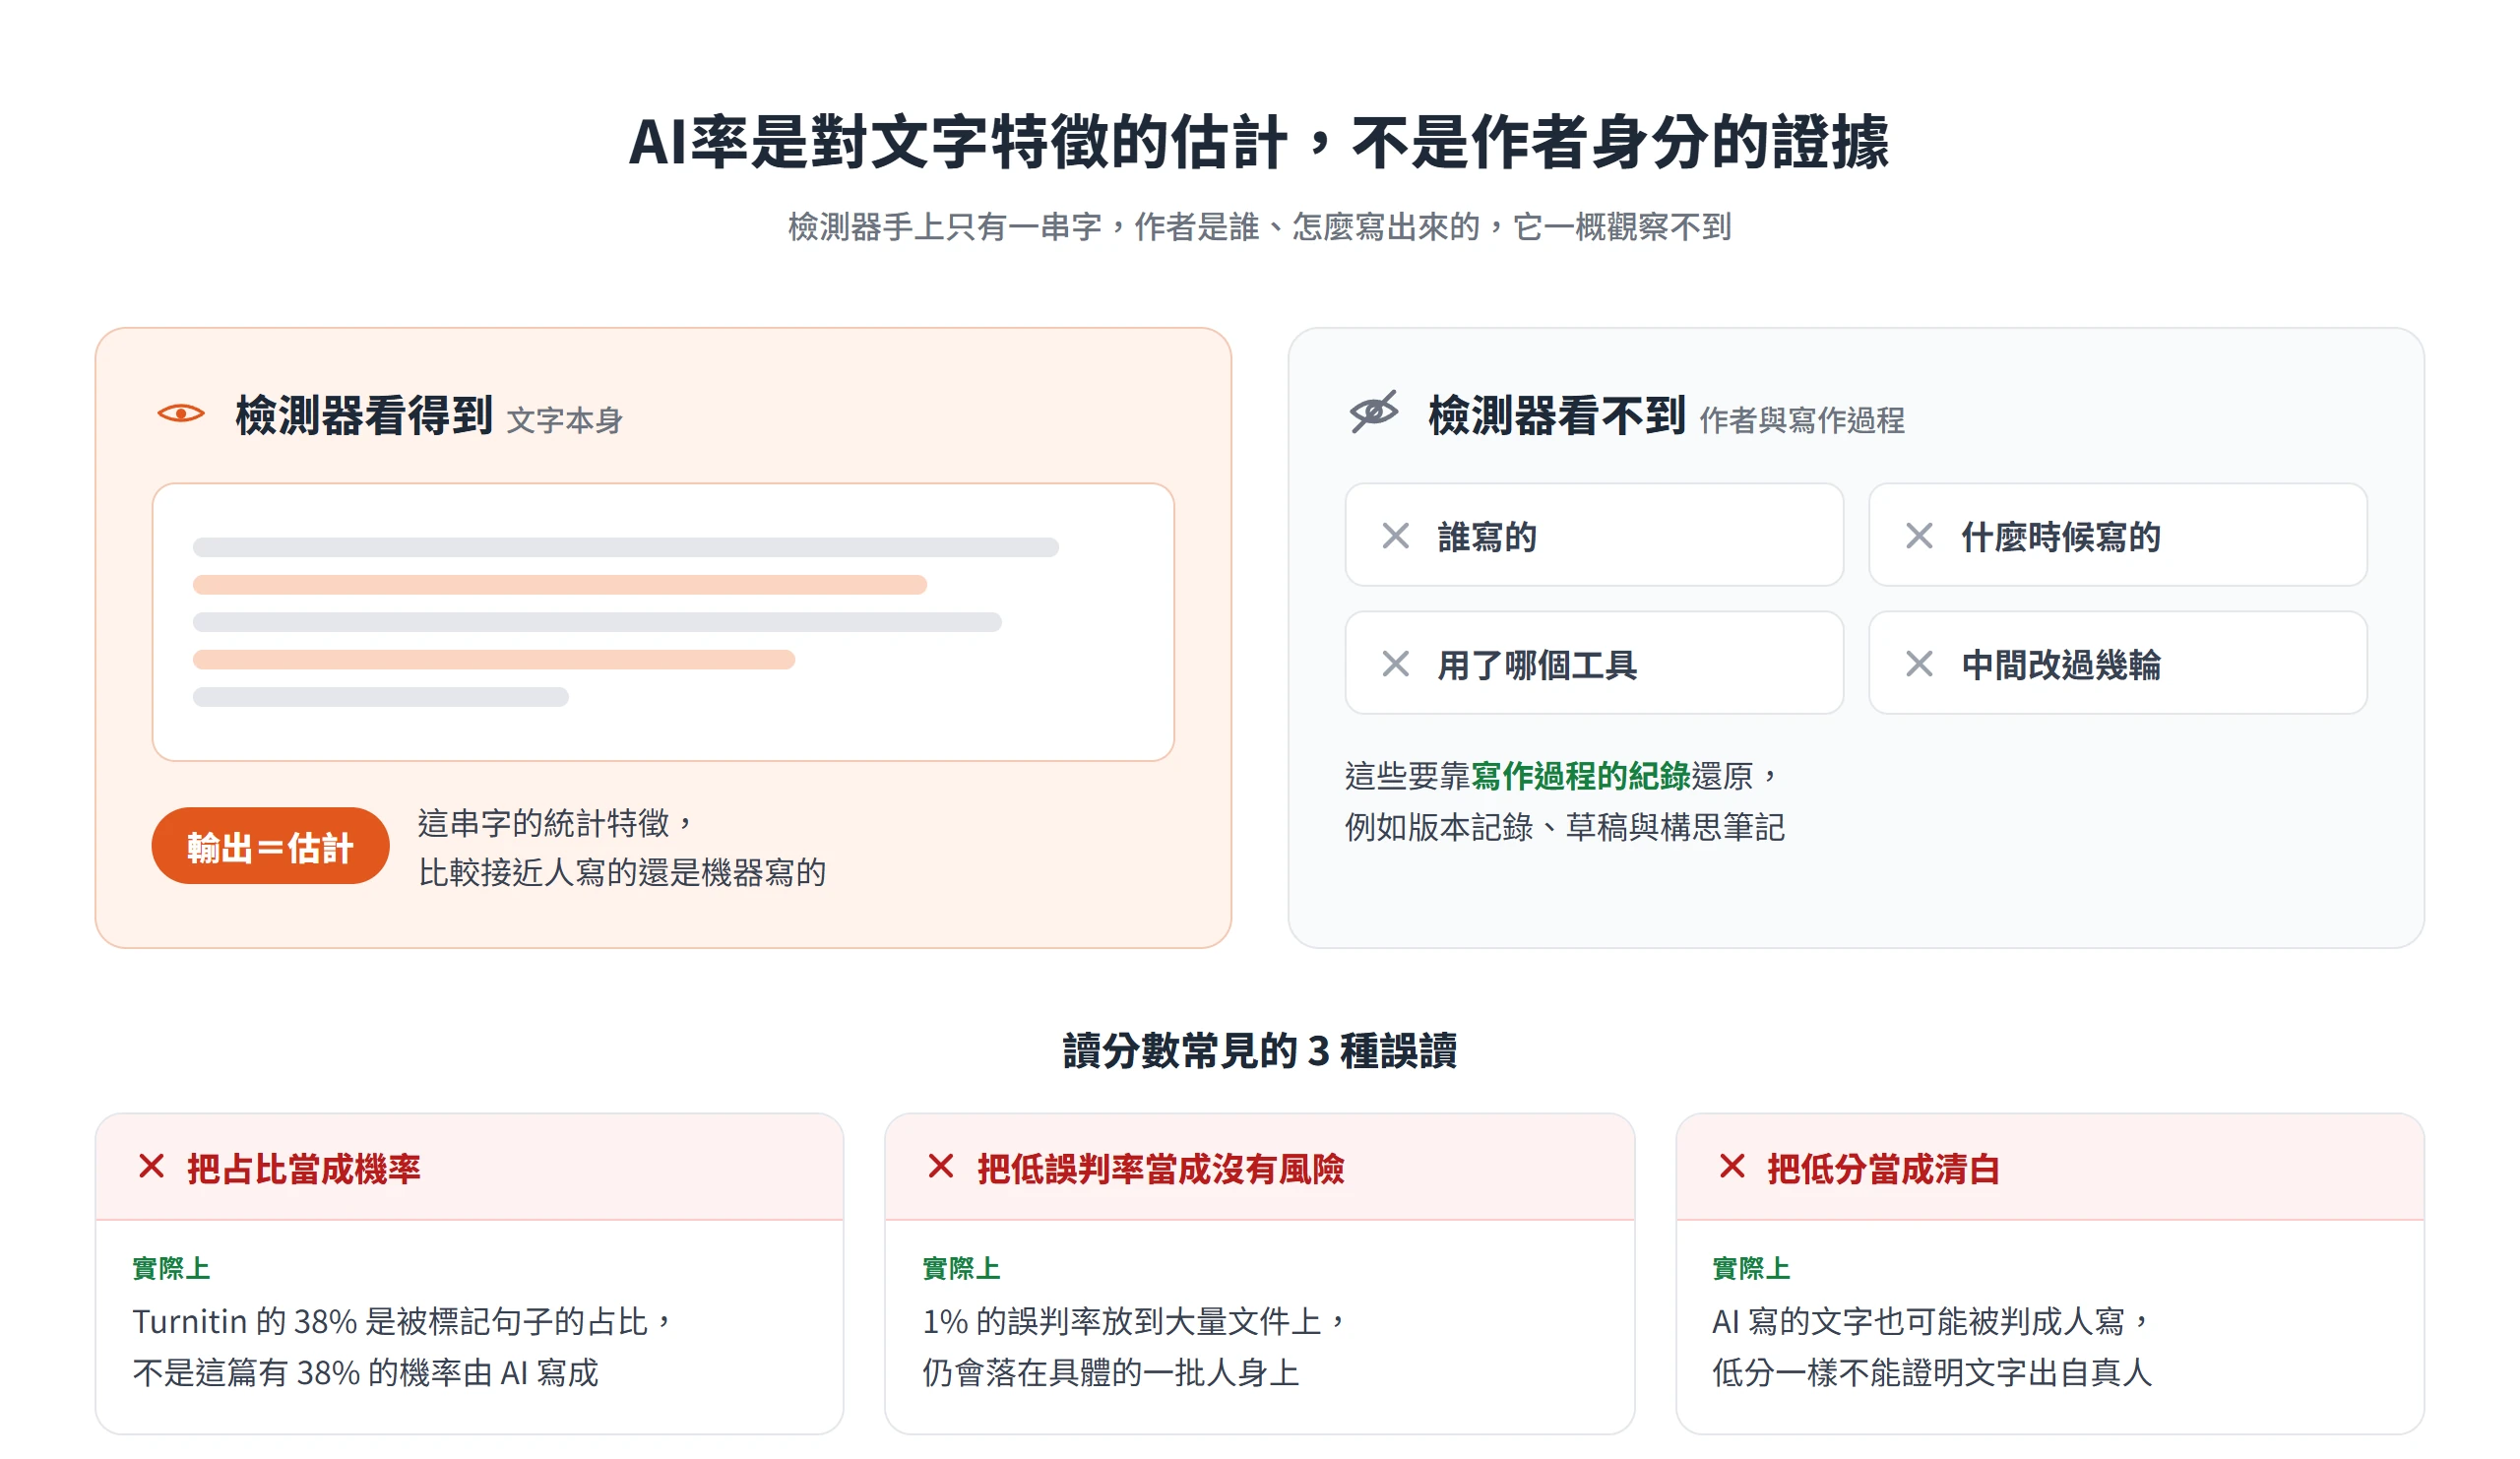
這類工具最重要的一個觀念,是它能看到的只有文字本身。誰寫的、什麼時候寫的、用了哪個工具、中間改過幾輪,它一概觀察不到。假設王小明自己寫了一段文字,另一個人則請 AI 擬稿、再逐句改過,這兩段到了檢測器手上都只是一串字,它只能回答「這串字的統計特徵,比較接近人寫的還是機器寫的」。所以它輸出的是估計,不是查證。
工具廠商自己也是這樣定位的。Turnitin 在說明頁寫明,它的 AI 書寫偵測模型可能判斷錯誤,人寫的、AI 產生的、經 AI 改寫的文字都有可能被誤認,因此不該作為對學生採取不利行動的唯一依據。GPTZero 說它的分類器是用來標出「可以開啟對話」的情況,例如老師和學生之間,結果不該用來懲處學生。堪薩斯大學教學卓越中心的文章,則主張把這些結果當成資訊,而不是指控。三個說法的共通點,是把分數看作請人進一步查看的訊號,而不是裁決。
AI檢測器背後的 3 種技術路線
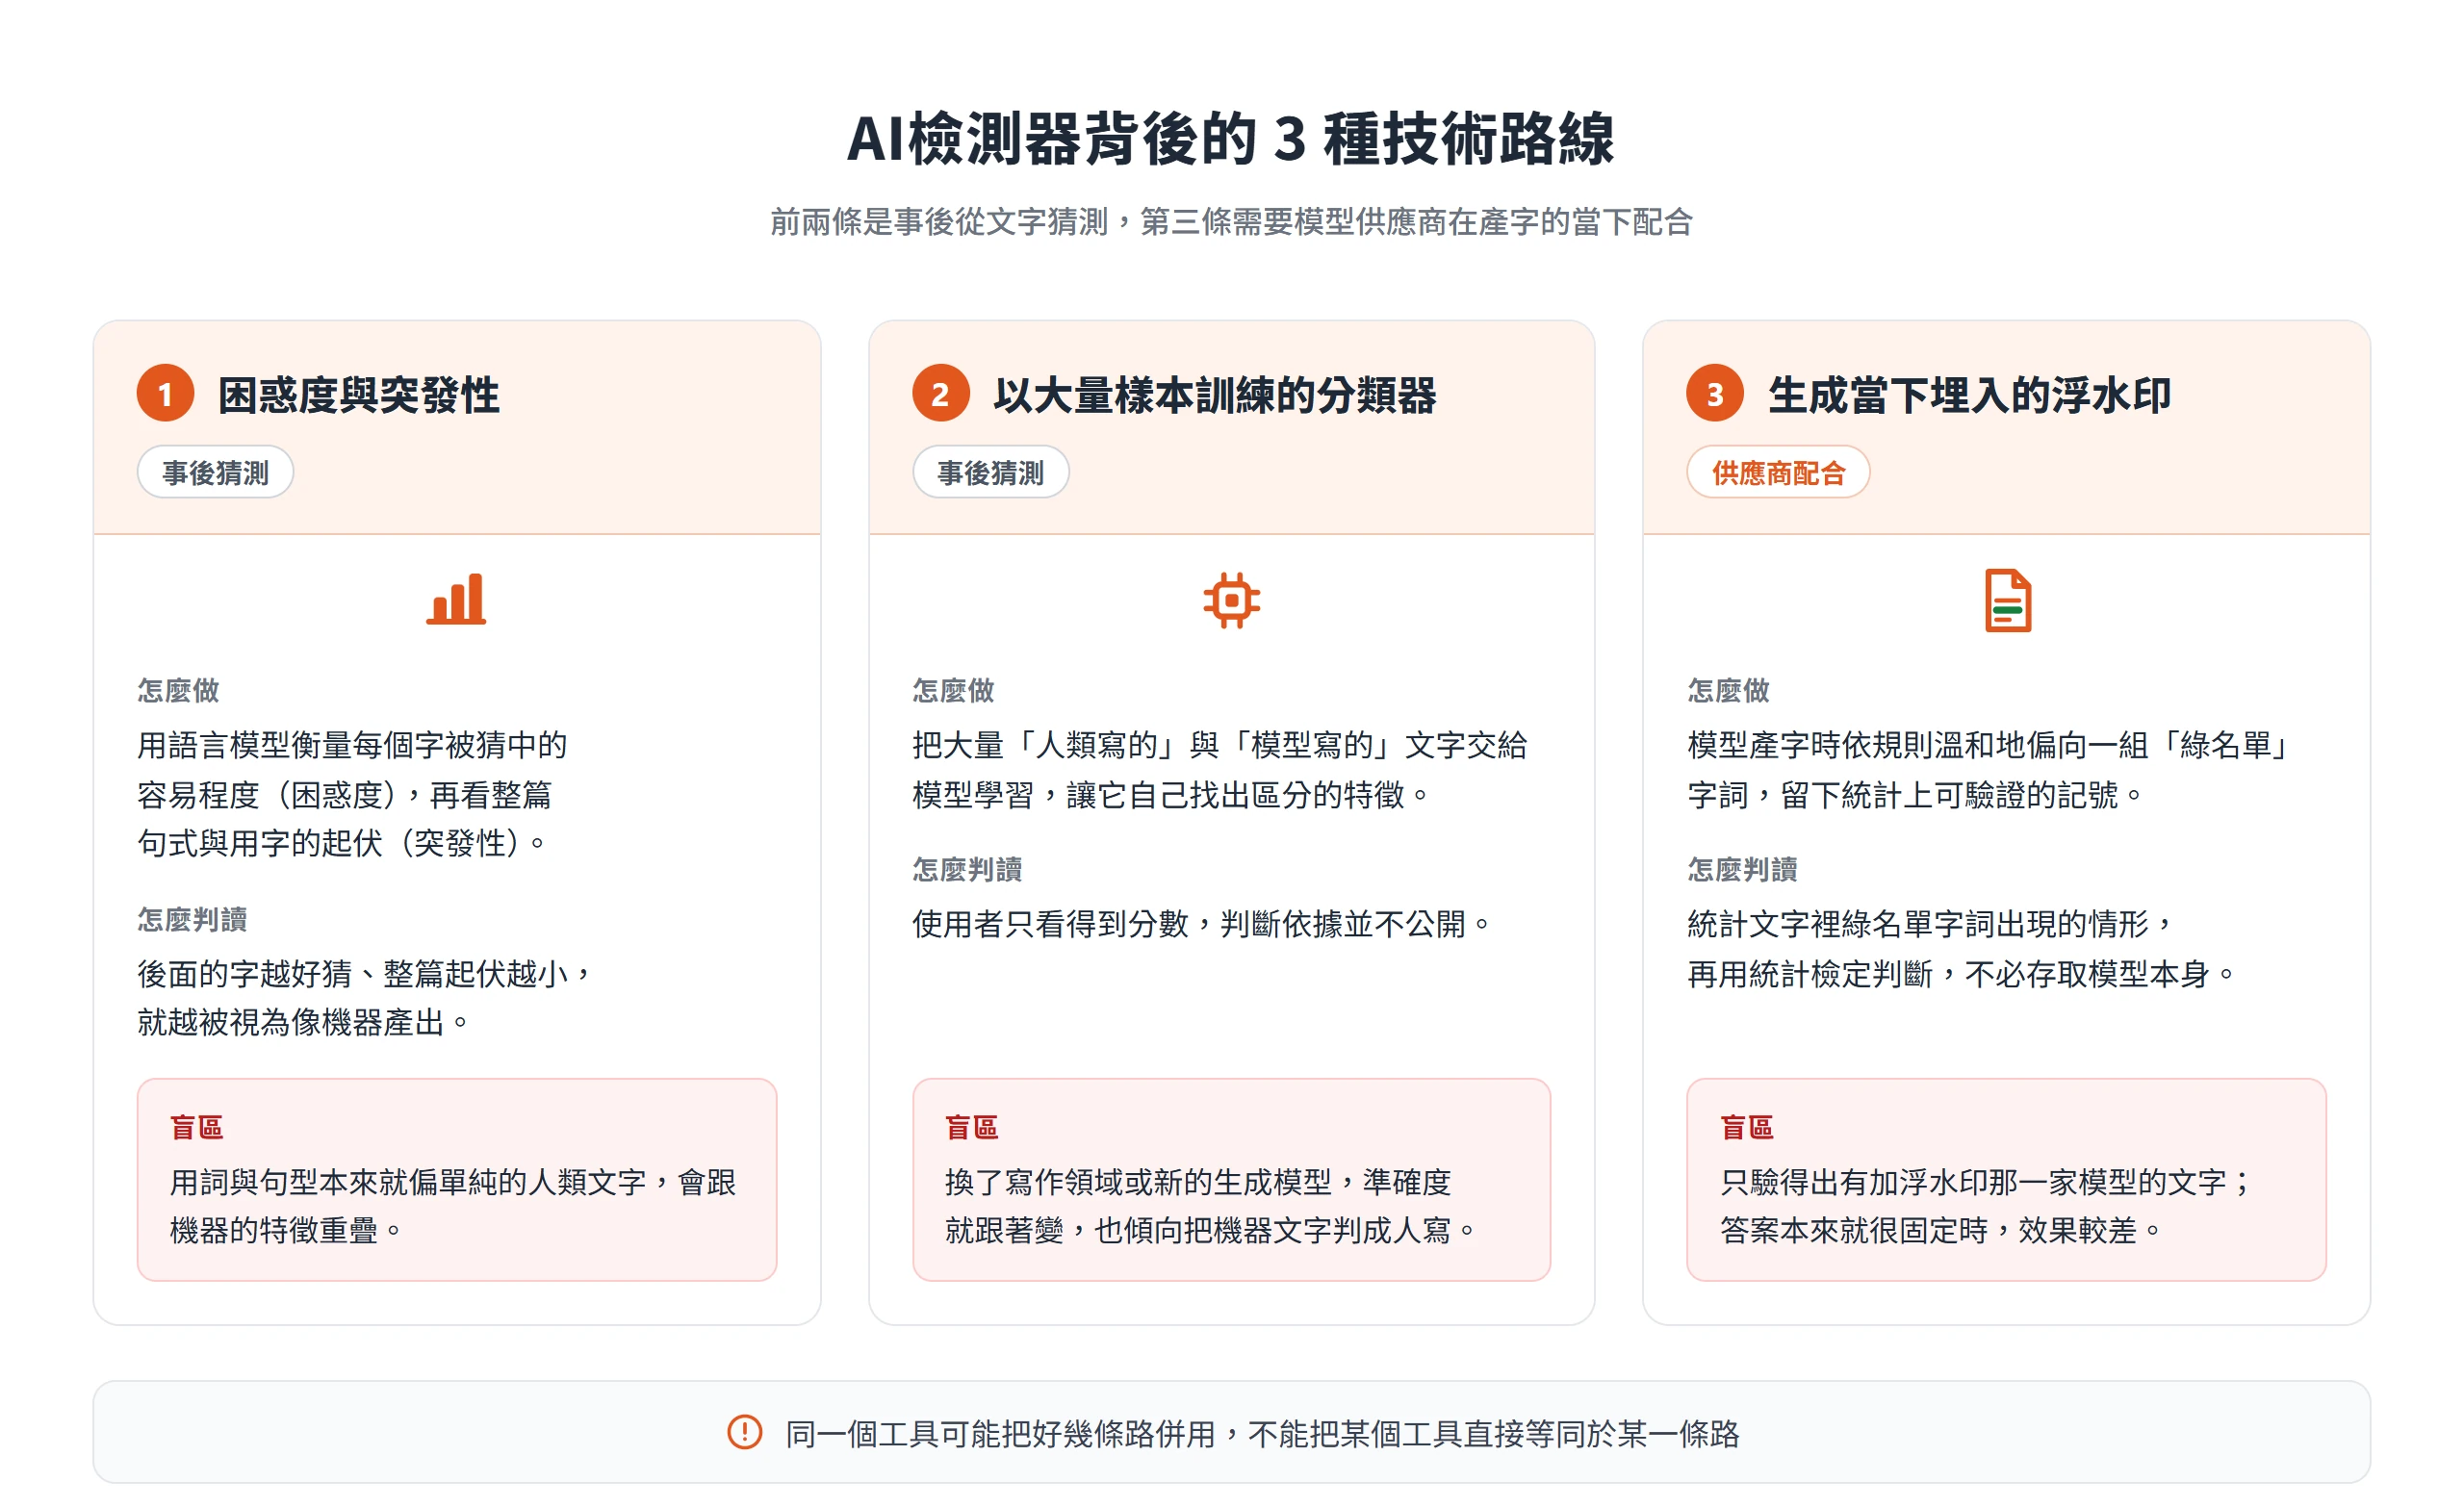
市面上的檢測工具,做法大致可以歸成三條路:計算文字的統計特徵、用大量樣本訓練分類器、在生成的當下就埋入浮水印。前兩條都是事後猜測,第三條則需要模型供應商在產字的時候配合。
同一個工具可能把好幾條路併用,所以不能把某個工具直接等同於某一條路。這三條路各有擅長抓到的訊號,也各有天生的盲區,知道盲區在哪,才看得懂分數為什麼會錯。
衡量文字可預測程度的困惑度與突發性
最早期的 AI偵測工具多走這條路。做法是拿一個語言模型當尺,衡量每個字被它猜中的容易程度。這個指標叫困惑度(perplexity),可以理解成模型對下一個字的「驚訝程度」,後面接的字越好猜,困惑度越低,文字就越像機器產出。GPTZero 的技術說明舉過一個例子,一句自我介紹的英文開頭「I am an AI」,後面接 assistant 幾乎是預料中的事,困惑度很低,接 potato 就出人意料,困惑度很高。
突發性(burstiness)看的則是整篇文字的起伏。人寫東西常常長短句交錯、用字忽高忽低,機器產出的句式與困惑度往往比較平均,整份文件的波動小,就會被視為更像機器。
這條路的基本假設是人類寫得比較出人意料,而這個假設本身就是誤判的來源,因為只要寫的人用詞與句型本來就偏單純,就會跟機器的特徵重疊。另外也不能說所有檢測器都在算困惑度。GPTZero 自己註明,從 2023 年秋天起,它已經改用深度學習架構,不再以困惑度與突發性做偵測。零樣本方法如 DetectGPT,則是利用語言模型取樣出的文字傾向落在機率函數負曲率區域這個性質,不需要另外訓練分類器。
以大量樣本訓練出來的分類器
另一條路是把大量「人類寫的」與「模型寫的」文字交給模型學習,讓它自己找出區分的特徵。好處是能吸收統計法抓不到的樣式,缺點是它學到的範圍就是它的能力範圍,所以換了寫作領域,或是換了新的生成模型,準確度就跟著變。
M4 基準研究(Wang 等人,EACL 2024)的結論很直接,偵測器很難在沒見過的領域或生成模型上維持表現,而且遇到這種情況時,傾向把機器產生的文字判成人寫。換句話說,漏抓的風險會隨著文字離訓練資料越遠而升高。
使用者能看到的通常只有分數,判斷依據並不公開。范德堡大學在決定停用 Turnitin 的 AI偵測功能時就指出,Turnitin 沒有詳細說明它怎麼判定一段文字是不是 AI 產生的,最多只說它在找 AI 寫作常見的樣式,卻沒有說明或定義那些樣式是什麼。不同工具對同一篇文字也常給出不同的結論。前面提到的托福作文實驗裡,7 個檢測器一致判成 AI 的作文只占 19.8%,至少被其中一個檢測器判成 AI 的卻高達 97.8%,而這些作文全是真人寫的。
生成當下埋入記號的浮水印
這條路不是事後猜,而是模型在產字的當下就依規則偏向某些字,留下統計上可驗證的記號。Kirchenbauer 等人提出的做法,是在生成每個字之前,先隨機劃出一組「綠名單」(green)字詞,取樣時溫和地偏向這組字;驗證的人只要統計文字裡綠名單字詞出現的情形,再用有 p 值的統計檢定就能判斷,過程中不需要存取語言模型本身。
Google DeepMind 的 SynthID-Text 是已經實際部署的例子,2024 年 10 月發表在《Nature》,已用在 Gemini 的回應上。這篇論文自己也把限制寫得清楚,包括浮水印需要提供文字生成服務的各方協調;文字經過編輯,例如被另一個 LLM 改寫,偵測效果就會變弱;在模型輸出的熵較低、也就是答案本來就很固定時,效果比較差;無法偵測沒有加浮水印者產生的文字;開源模型也很難強制套用。
實際上,浮水印只有在文字出自「有加浮水印的那一家模型」時才驗得出來,拿一般的檢測器去查,通常驗不出這種記號。圖像與影片的內容憑證、浮水印則是另一套機制,來源標示的做法也不同。
檢測工具自己寫明的限制與下架紀錄
有些檢測工具把限制白紙黑字寫在說明頁上。Turnitin、GPTZero,以及已經下架的 OpenAI 分類器,都有公開文件可查,廠商自己承認的使用邊界,比任何外部評比都更直接。
這些邊界幾乎都在講同一件事,也就是工具是為「夠長、寫得完整、語言對得上」的散文設計的,離這個條件越遠,結果越不可靠。
Turnitin AI 書寫報告的散文、字數與語言門檻
Turnitin 說明頁上的報告百分比,指的是整份文件裡的「qualifying text」之中,被模型判定為可能由 AI 產生、或可能由 AI 產生後又經 AI 改寫工具修改的比例。qualifying text 指的是長篇寫作格式裡的散文句子,也就是論文、報告、文章這種由段落組成的文字。詩、劇本、程式碼,以及條列、表格、註解書目這類非散文或短格式的內容,模型並不能可靠偵測。
文件本身也有門檻。散文部分至少要有 300 個單字(words),上限是 30,000 個單字,而且必須用支援的語言寫成,目前的清單是英文、西班牙文、日文、阿拉伯文、德文、荷蘭文與土耳其文。結果介於 1% 到 19% 時,報告不顯示分數,改顯示星號(*%),因為 Turnitin 自己的測試發現,百分比落在 0 到 19 之間時誤判的比例較高。偵測 AI 改寫工具修改過的文字,目前也只有英文版的模型做得到,西班牙文、日文等其他語言版本還沒有這項功能。
這些限制的來由,Turnitin 產品長 Annie Chechitelli 在 2023 年 5 月發表的說明裡有交代。說明提到,實際使用的結果和實驗室測試不一樣,有三種情況誤判比較多,分別是偵測到的 AI 書寫低於 20% 的文件、文件開頭與結尾的幾句,以及人機混寫文件的句子層級標記。Turnitin 也因此把可評估的最低字數從 150 個單字提高到 300 個單字。
GPTZero 的機率分類與準確度限制
GPTZero 的 FAQ 與 API 說明把輸出講得很明確。它回傳的是文件層級的分類,分成 HUMAN_ONLY、MIXED、AI_ONLY 三類,並附上每一類的機率,以及高、中、低三種信心等級。至於逐句標示,說明裡明確提醒,它不應單獨用來判定整篇文章含有 AI 內容,只是在文件被判成 MIXED 或 AI_ONLY 時,指出工具認為哪些句子是 AI 寫的。
它也承認準確度會隨資料而變。文字越長,準確度越高,所以文件層級的結果比段落層級可靠,段落層級又比句子層級可靠。訓練資料雖然涵蓋多個領域,但大多數是成年人寫的英文散文,語言支援另外列出西班牙文、法文、德文等。分類器也沒有針對「生成之後被大幅修改過的文字」做過訓練。
對於機器產生或高度程序化的文字,它可能誤標為 AI,因此建議用在描述性較強的段落。從這些自述可以看出,GPTZero 給自己的定位是標出值得進一步談談的情況,而不是做判決。
OpenAI 下架自家分類器的紀錄
OpenAI 在 2023 年 1 月 31 日推出一個文字分類器,用來標示一段文字是否可能由 AI 寫成。公告一開始就寫明它「並不完全可靠」。在一組英文的挑戰資料上,只有 26% 的 AI 文字被正確標成「可能是 AI 寫的」,同時有 9% 的人類文字被誤標成 AI。文字少於 1,000 個字元時非常不可靠,建議只用在英文,也不該當作主要的判斷工具,而是搭配其他方法一起看。
同年 7 月 20 日,OpenAI 在公告開頭補了一句,說明由於準確率偏低,這個分類器已經不再提供。做出偵測工具的模型廠商,因為準確率不足而自己收掉這項工具,是相當少見的案例。公告也承認,AI 寫的文字經過編輯就能避開分類器,而且神經網路分類器遇到跟訓練資料差異很大的輸入時,有時會極度自信地給出錯誤的判斷。
OpenAI 的教育者說明頁後來講得更直接。問到偵測器有沒有用,答案是「依我們的經驗,沒有」,他們的研究顯示偵測器不夠可靠,不足以讓教育者據此做出可能帶來長期後果的判斷。同一頁還提醒,ChatGPT 自己並不知道哪些內容是 AI 生成的,問它「這是你寫的嗎」,得到的答案是隨機的,沒有事實基礎。所以把文章貼給 ChatGPT 問「這是 AI 寫的嗎」,並不能算一種檢測。
AI率是對文字特徵的估計,不是作者身分的證據
前面講的原理,歸結起來只有一件事,就是檢測器的輸出是對文字特徵的判斷,沒有任何一個環節拿得到作者身分。所以拿到 AI率 38% 這類數字時,要回頭看該工具的說明頁,弄清楚這個數字算的是什麼、單位是什麼、哪個區間本來就不可靠。
讀分數時常見三種誤讀,分別是把占比當成機率、把低誤判率當成沒有風險、把低分當成清白,每一種都很容易發生,也都有具體的數字可以對照。
百分比算的是被標記的文字占比
以 Turnitin 為例,AI率的定義是被判為可能由 AI 產生的 qualifying text,占整份文件的比例。所以「38%」不是說 AI 貢獻了 38% 的內容,也不是說這篇文章有 38% 的機率是 AI 寫的,它講的只是工具認為「被標記的句子」大約占了這麼多。
占比和機率是兩種不同的量,不同工具的單位也不同。GPTZero 回傳的是各個類別的機率,它的解釋是,90% 表示在相似的文件上,偵測器有 90% 的時候判對,也就是「對這個分類有多少把握」,不是文件裡 AI 文字的占比。把 Turnitin 的門檻拿去套 GPTZero 的數字,兩邊算的根本不是同一件事。
混寫的文件還有一個麻煩。Turnitin 說明頁寫明,一份文件若包含幾種不同的寫作類型,百分比和標示的句子可能對不上。再加上 0 到 19% 的低區間本來就是誤判較多的地方,所以看到低分、或百分比與標示對不上時,更該回頭看被標記的句子是什麼,而不是只盯著數字。
低誤判率乘上大量文件,仍是可觀的人數
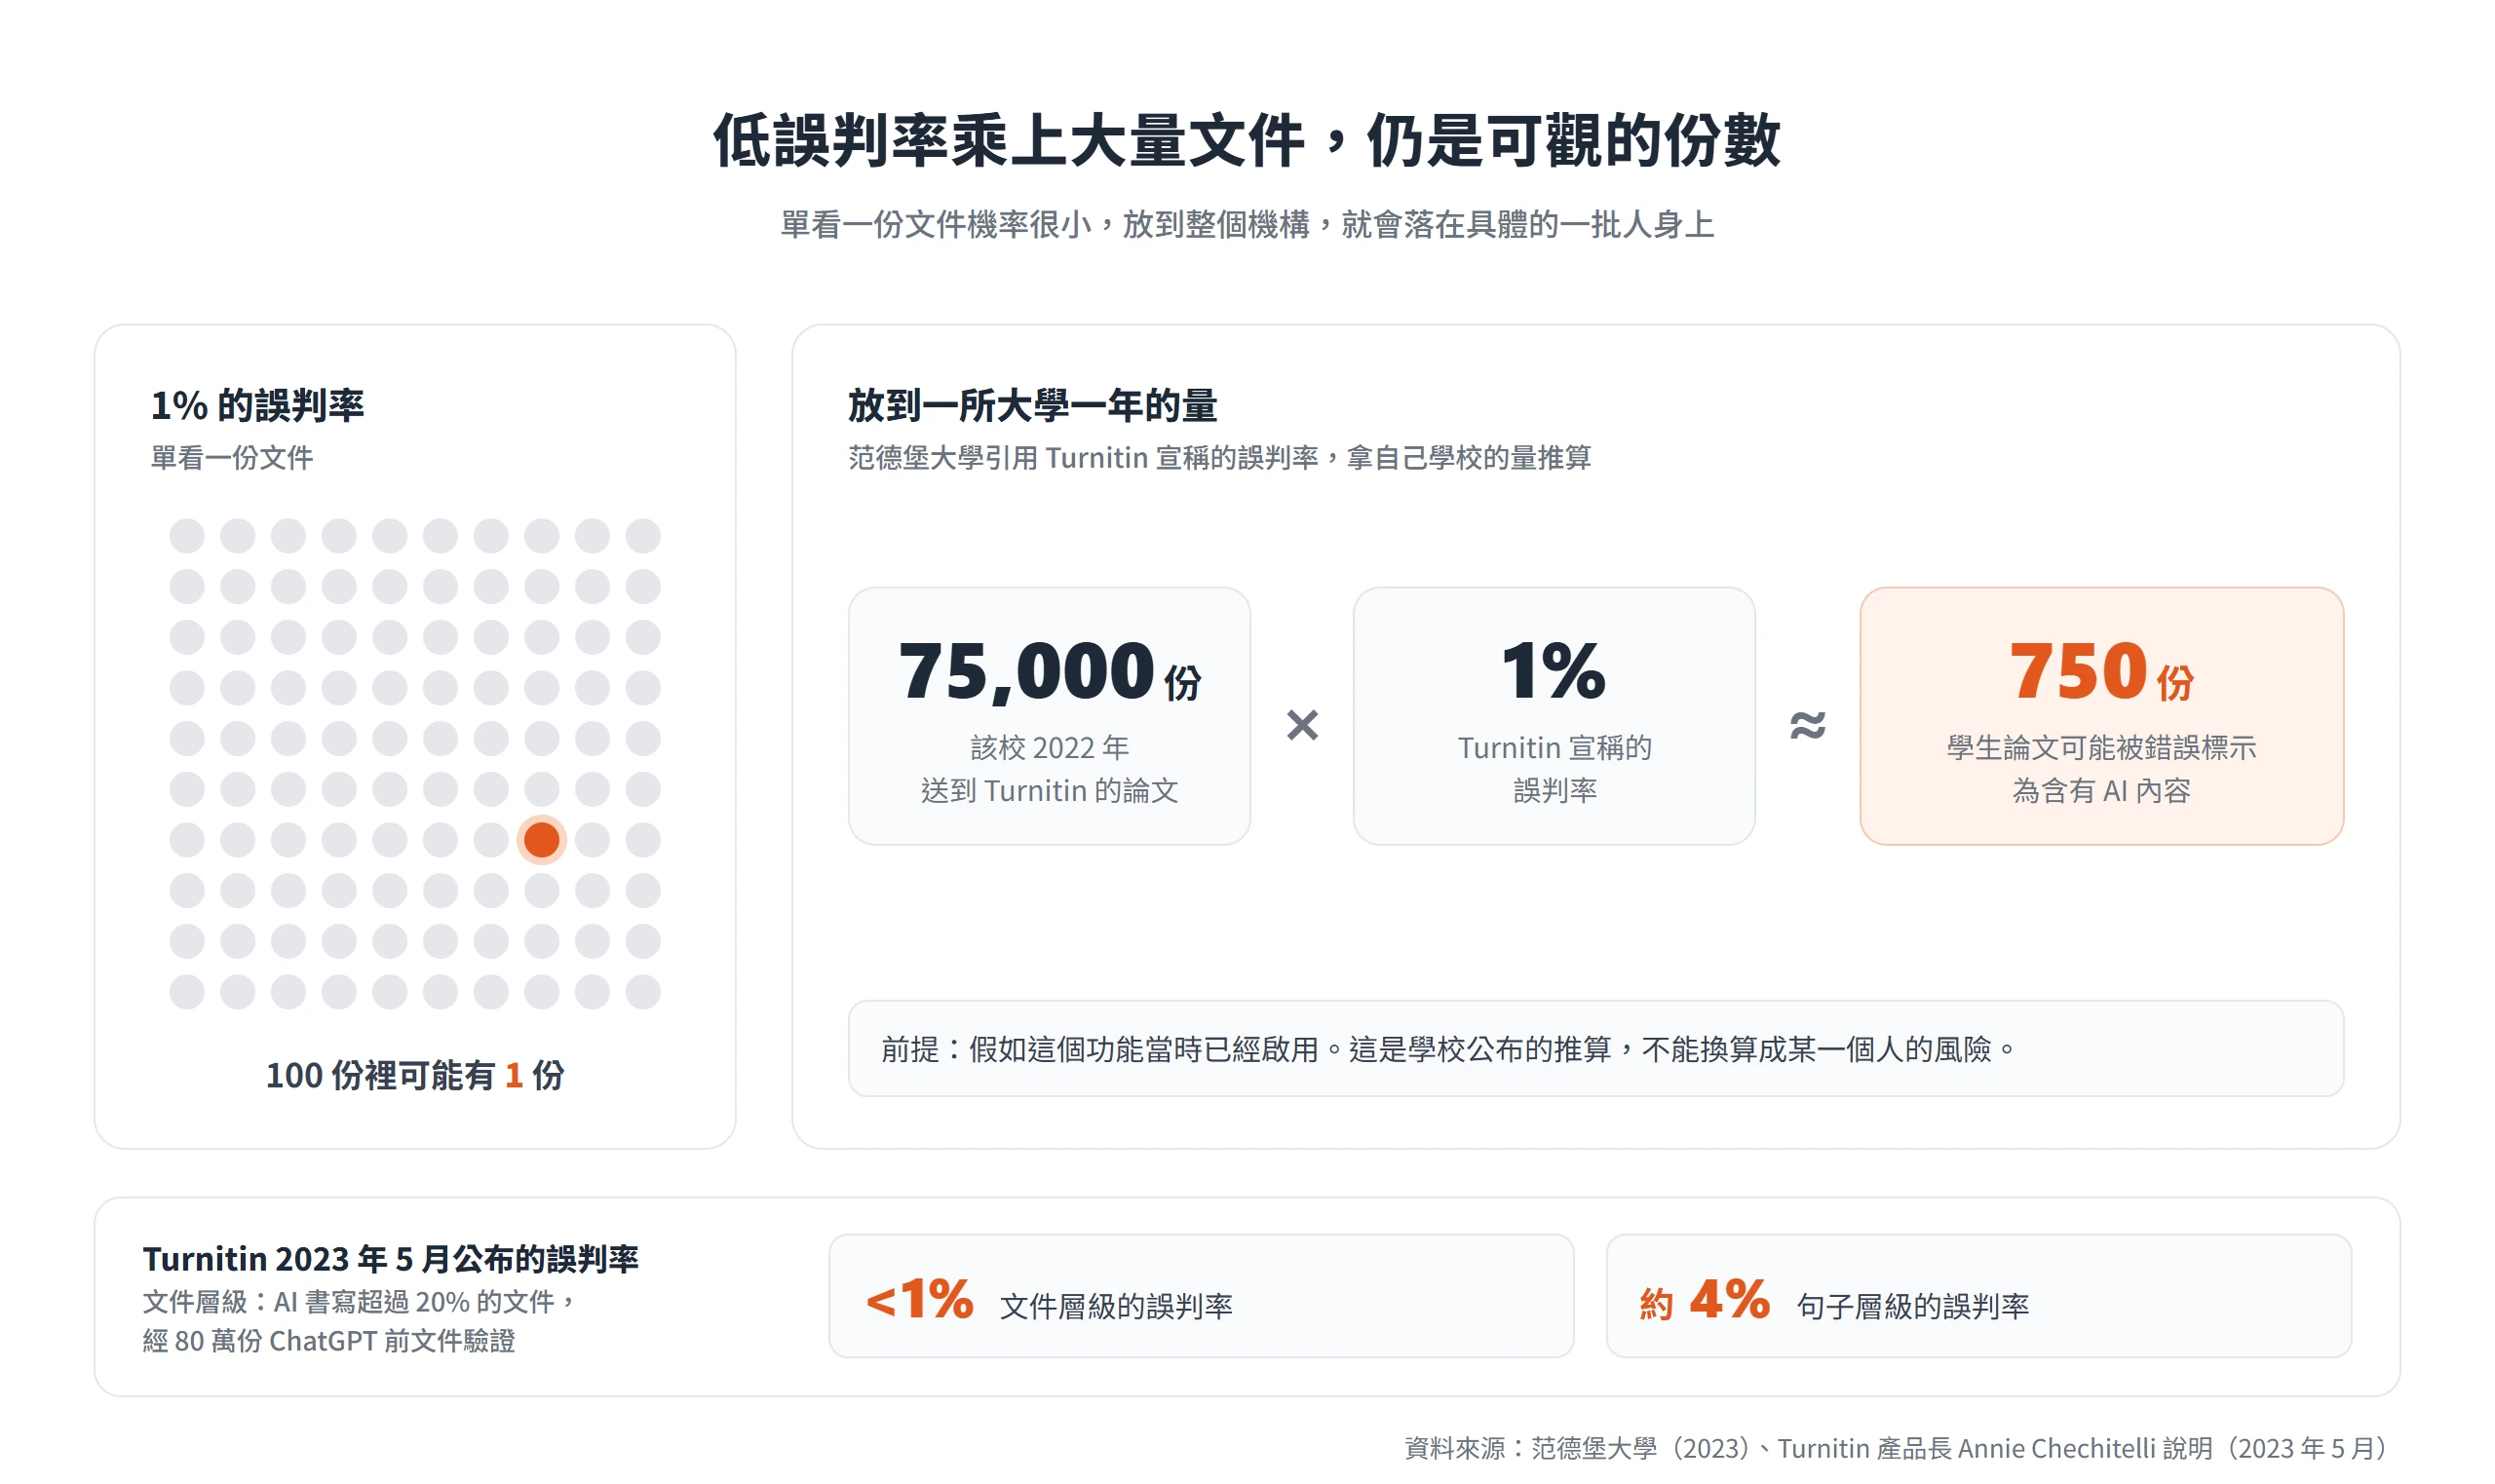
1% 的誤判率聽起來很小,換算成實際份數就是另一回事。范德堡大學引用 Turnitin 宣稱的 1% 誤判率,拿自己學校的量算了一次。該校 2022 年送了 75,000 份論文到 Turnitin,假如這個功能當時已經啟用,大約就有 750 份學生論文可能被錯誤標示為含有 AI 內容。
Turnitin 自己公布的數字也在這個量級。Chechitelli 在 2023 年 5 月的說明中提到,Turnitin 拿 80 萬份 ChatGPT 推出之前寫成的學術文件重新測試,在 AI 書寫超過 20% 的文件裡,文件層級的誤判率低於 1%;同一份說明另外公布的句子層級誤判率則約 4%。單看一份文件,是 100 份裡可能有 1 份的機率;放到整個機構,每個學期都會落在具體的一批人身上。
這些是廠商或學校已經公布的數字,不是自己算出來的準確率,也不能直接換算成某一個人的風險。但這些數字說明了一件事,那就是被標記的那一份,有可能剛好就是自己一字一句寫出來的,所以拿到分數的人有理由請對方說明依據,而不是默默接受。
分數偏低也不能證明文字出自真人
誤判有兩個方向,一是人寫的被標成 AI,二是 AI 寫的被判成人寫。後者在前面其實已經出現過。M4 研究指出,偵測器遇到沒訓練過的領域或新的生成模型,傾向把機器文字判成人寫;OpenAI 的分類器公告也承認,AI 寫的文字經過編輯就能避開偵測。
Sadasivan 等人的研究又往前一步。他們發現,對 AI 文字做遞迴改寫之後,偵測率會明顯下降,文字品質卻只略微降低。理論分析也顯示,最佳偵測器的 AUROC(衡量偵測器分辨兩類文字能力的指標)和人、機文字分佈之間的 Total Variation 距離(兩種分佈的差距)相關,語言模型越像人,偵測就越困難。這裡只需要記住結論,也就是偵測結果會隨改寫而改變,所以低分一樣不能當證據。
因此檢測器的結果,無論高低,都只能當作需要再查的線索。高分不能直接指控,低分也不能拿來證明一篇文章完全沒有 AI 參與,這也是不能只靠檢測器把關的原因。
容易被誤判的 4 種文字情境
研究與廠商說明裡反覆出現的誤判情境,可以整理成四種。它們的共同點,是文字的統計特徵剛好跟機器的特徵重疊,或是工具的前提條件不成立。知道自己要寫的東西屬於哪一種,動筆之前就能預期風險。
遇到這四種情境,分數都應該打折看待。比較穩當的處理,是補充說明寫作背景、提供過程紀錄,而不是把文字改成不像自己的樣子。
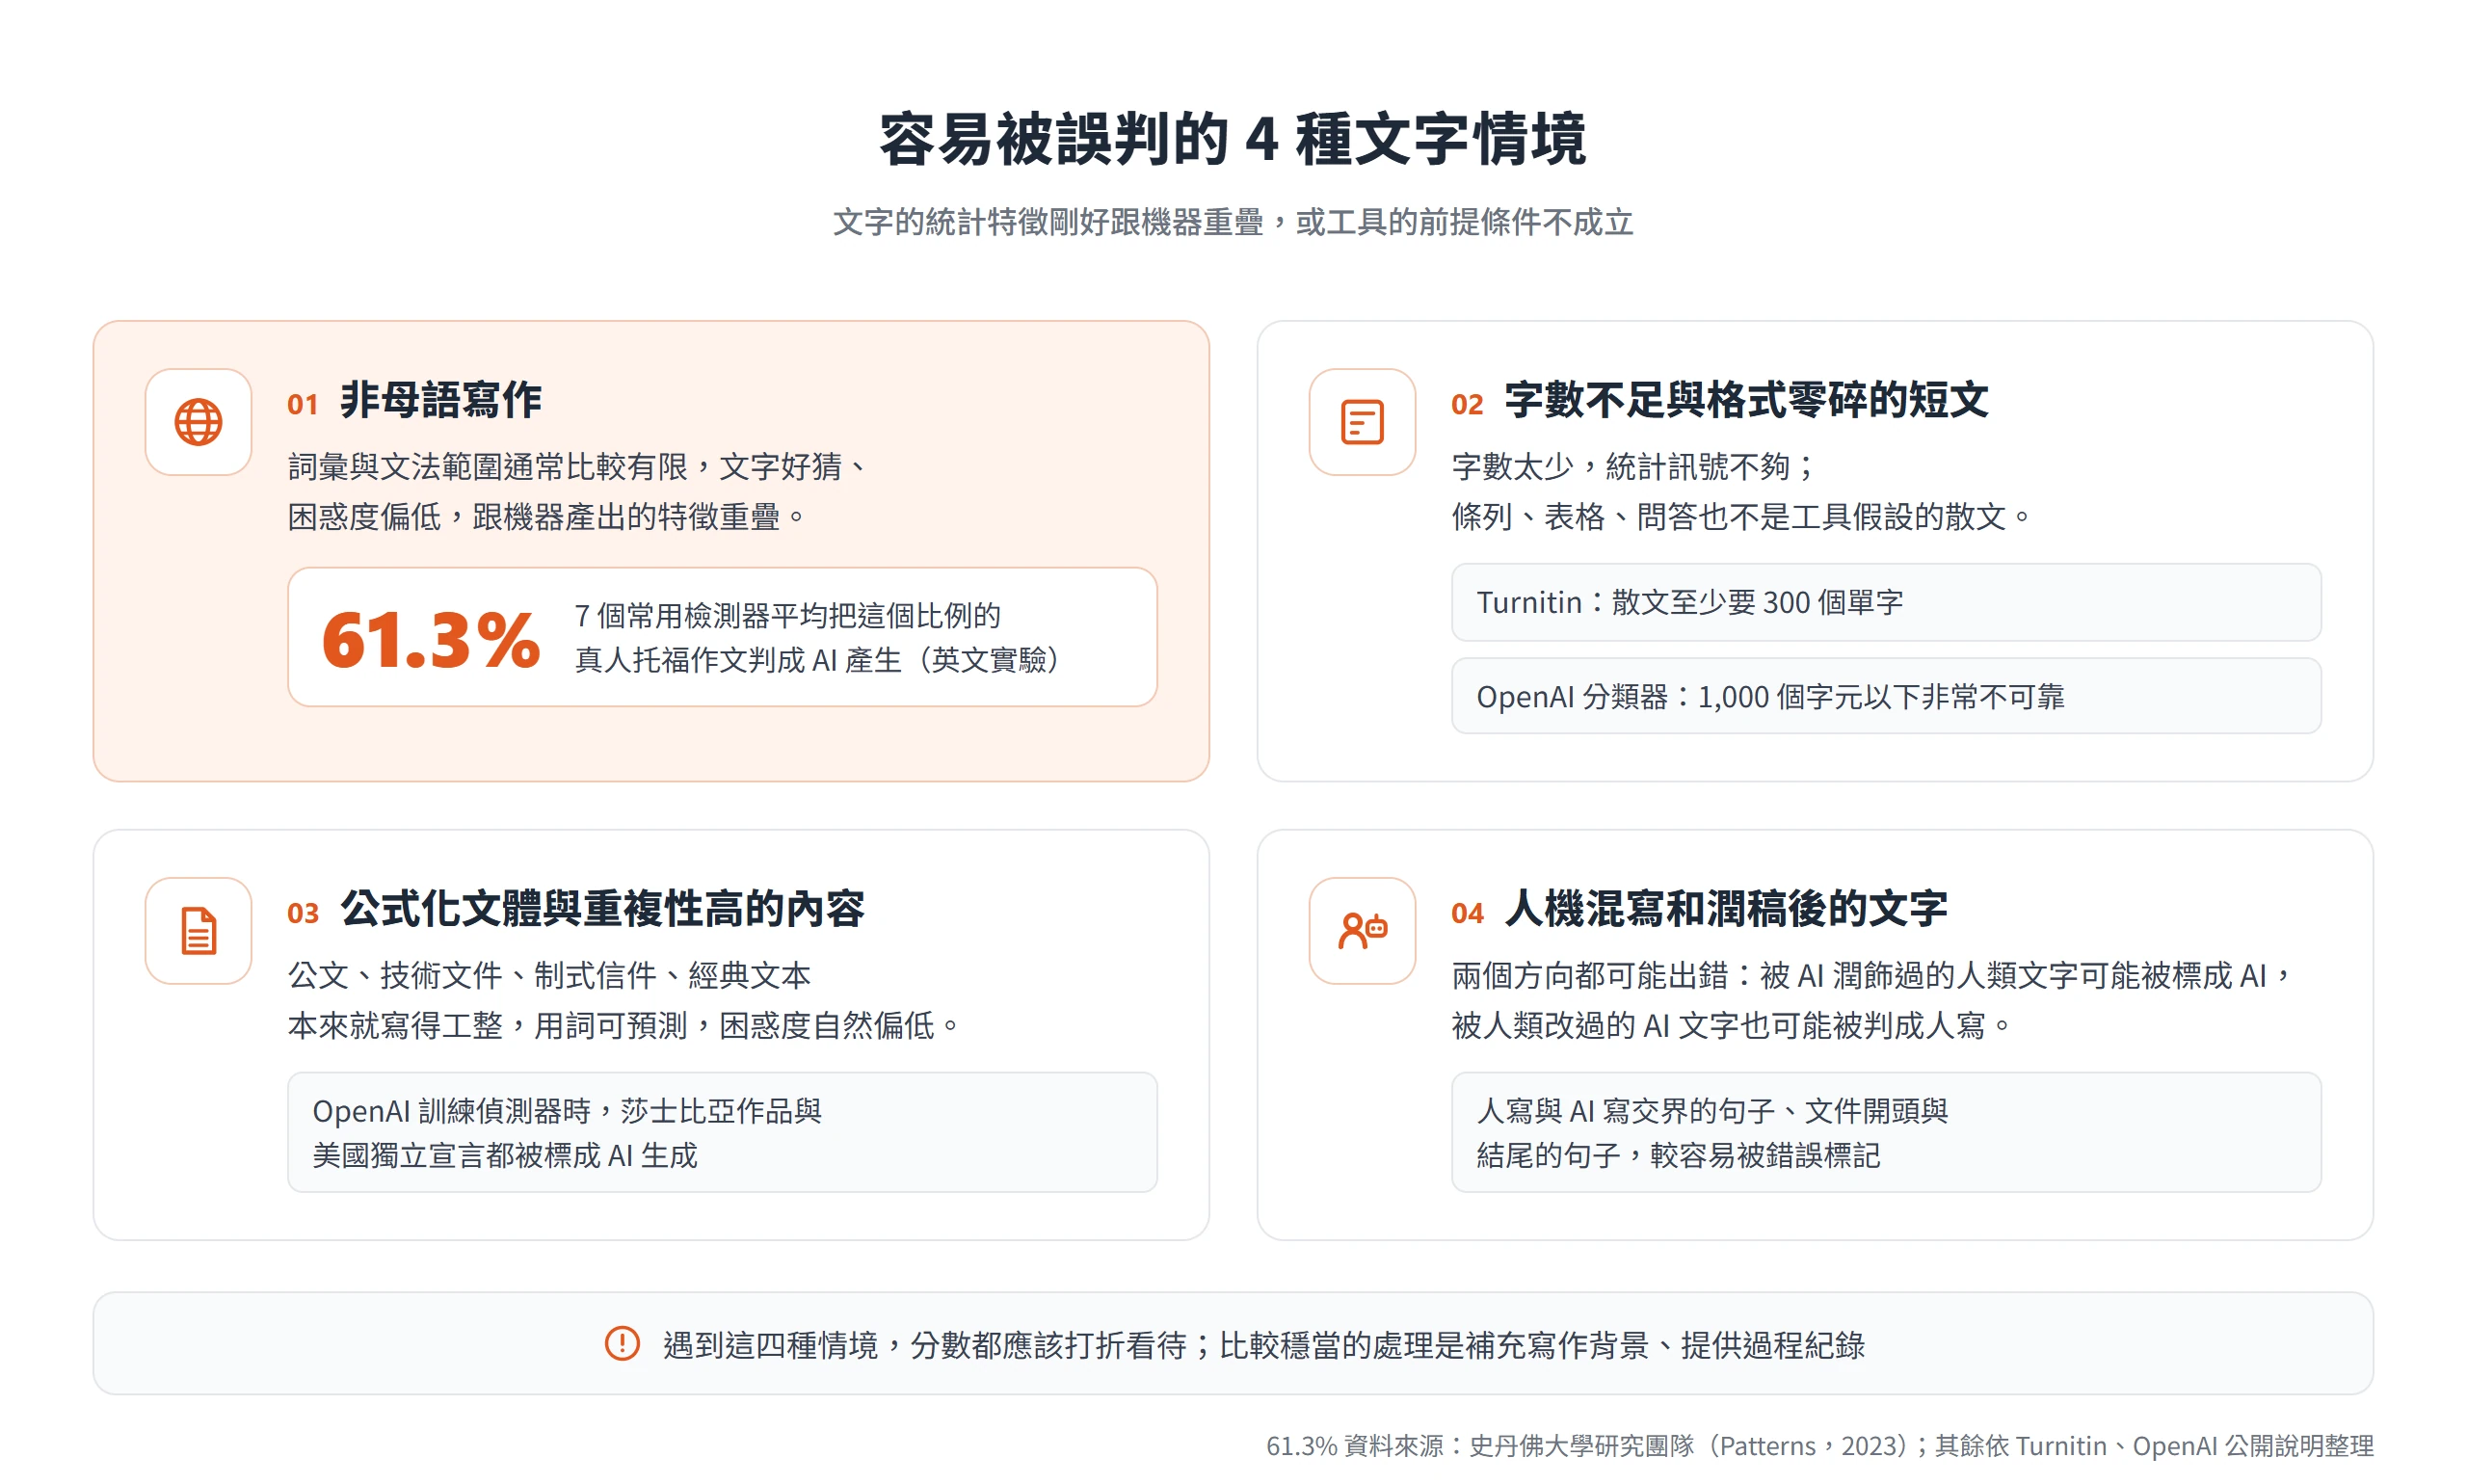
非母語寫作,被判定為 AI 的比例偏高
在台灣,用英文寫報告、申請文件、留學文書是很常見的事,這一種情境也最貼身。史丹佛大學的研究團隊把 91 篇托福作文(來自一個中文論壇)與 88 篇美國八年級生作文,分別交給 7 個常用檢測器。美國學生的作文幾乎都判對,托福作文卻平均有 61.3% 被誤判為 AI 產生。其中有 18 篇(19.8%)連 7 個檢測器都一致判成 AI,89 篇(97.8%)至少被一個檢測器判成 AI。
研究團隊追查的原因是困惑度。非母語寫作者的詞彙與文法範圍通常比較有限,文字比較好猜,困惑度偏低,剛好跟機器產出的特徵重疊。他們做了一個對照實驗,請 ChatGPT 把托福作文的用詞改得更豐富,誤判率從 61.3% 降到 11.6%;反過來把美國八年級生作文的用詞簡化,誤判則明顯增加。這個實驗是用來證明機制,不是在建議把文字改寫成某種樣子。
OpenAI 的教育者說明頁也提到,偵測器可能不成比例地影響正在學英文的學生,或是寫作特別公式化、精簡的學生。史丹佛大學的 James Zou 也提醒,目前的檢測器明顯不可靠,把它當成解決作弊問題的方法時要非常謹慎。
這項研究的對象是英文寫作,61.3% 這個比例只屬於這組實驗,不能搬去推論中文寫作也是同樣的比例。如果你是非母語者而被標了高分,這份研究與工具的說明頁就可以當作請對方重新看待分數的說明材料。
字數不足與格式零碎的短文
字數太少,統計訊號就不夠;條列、表格、問答、簡短回覆又不是工具設計時假設的散文。兩種情況都讓結果不穩,短文的分數浮動大,格式零碎的段落,有些工具乾脆不評。
數字上看得很清楚。OpenAI 的分類器對 1,000 個字元以下的文字非常不可靠;Turnitin 要求至少 300 個單字的散文,條列、表格、註解書目這類短格式,它不能可靠偵測;GPTZero 則明講準確度隨文字量增加,文件層級優於段落層級,段落層級又優於句子層級。
想讓檢測結果有一點參考價值,交給工具的就應該是完整的長文,而不是拿一句話、一個段落或一張表去問。拿片段問出來的結果,剛好落在所有工具都承認最不可靠的區間。
公式化文體與重複性高的內容
公文、課程報告的固定格式、技術文件、制式信件、經典文本,本來就寫得工整,用詞可預測,困惑度自然偏低,看起來就跟機器的產出很像。OpenAI 自己訓練偵測器的時候,連莎士比亞的作品與美國獨立宣言,都被標成 AI 生成。
OpenAI 分類器的公告還舉了一個極端的例子,也就是前 1,000 個質數的清單,不管誰來寫,答案都一樣,所以根本無從判斷是人寫的還是 AI 寫的。文字越可預測,檢測器就越沒有線索。GPTZero 同樣提醒,它的分類器可能把機器產生或高度程序化的文字誤標成 AI,所以應該用在描述性較強的段落。
所以越規格化的文體,例如實驗報告、標準回信、制式簡介,分數的參考價值就越低。前面提到 OpenAI 說明頁的提醒,寫作特別公式化或精簡的學生更容易受到影響,指的也是這類文字。這類文體被標了高分時,直接說明文體本身就有固定格式,並出示寫作過程的紀錄,比爭論分數合不合理更有效。
人機混寫和潤稿後的文字
實務上最常見的文字,既不是純人寫,也不是純 AI 寫,例如有人先寫、再讓 AI 校對潤飾,也有人讓 AI 先擬稿、自己再大幅修改。偵測器對這類文字最不穩,兩個方向都可能出錯,被 AI 潤飾過的人類文字可能被標成 AI,被人類改過的 AI 文字也可能被判成人寫。
Turnitin 的說明指出,混合人類與 AI 內容的文件比較容易出現句子層級的誤判,人寫與 AI 寫交界的句子尤其明顯,文件開頭與結尾的句子也較容易被錯誤標記。它的 AI 產生類別本來就把「經 AI 改寫工具修改」的文字算進去,英文版還另外偵測改寫工具,等於工具自己也承認,改寫會影響結果。
中文的人機協作文字,近期也有專門的測試。C-HAT-Bench(Yang 等人,2026 年 9 月公開於 arXiv)以 5,000 篇人類寫作的中文原文為基礎,用 6 個生成模型做出超過 24 萬個變體,拿來測試 21 個偵測器。作為對照的是「接續人類開頭由模型續寫」的設定;換成人機協作的寫作模式後,文件層級偵測器的平均 AUROC 比對照設定相對下降 12.0%,降幅最大的單一偵測器相對下降 44.4%。研究也指出,偵測器在某一種生產方式下的表現,不能可靠地預測它在另一種方式下的表現。
中文文章的 AI檢測結果缺少充分驗證
繁體中文文章拿去跑 AI檢測,結果比英文更難判讀,因為公開的驗證數據多半來自英文,中文的證據不但少,彼此也不一致,所以更要把分數當成線索。
先看工具自己怎麼說。Turnitin 的 AI偵測支援語言清單是英文、西班牙文、日文、阿拉伯文、德文、荷蘭文與土耳其文,清單裡沒有中文。OpenAI 當年的分類器建議只用在英文,在其他語言的表現明顯比較差。GPTZero 則說明,它的訓練資料大多數是成年人寫的英文散文,另外列出西班牙文、法文、德文等語言支援。
再看研究。前面談過的誤判研究,包括托福作文、1,000 個字元的門檻、人機混寫的比較,幾乎都是英文實驗,它們的比例不能直接套到中文。
中文專屬的評測有幾組可以參考。M4 基準的中文資料來自百科(Baike)與 Web QA 問答,每則答案超過 100 個中文字。其中一組實驗用 XLM-R 偵測器偵測 ChatGPT 產生的文字。訓練與測試都用中文資料時,準確度可達 99.4%;拿中文訓練的偵測器去測英文各領域,準確度則掉到 61.8%。這是特定的實驗設定,它說明的是準確度綁在訓練與測試資料的分佈上,既不能推出「中文偵測不準」,也不能當成任何一種語言組合的通則。
另外,C-ReD 這份 2026 年的中文基準指出,先前的中文基準受限於模型多樣性不足與資料同質;C-HAT-Bench 則顯示,中文人機協作文字的偵測表現會下降。這些都是近年才出現的基準測試,結果還需要更多獨立研究來驗證。
所以中文的檢測結果經過獨立驗證的程度更低,更不能當證據。用工具看看沒有問題,但拿它的分數去判斷「誰寫的」,背後的證據基礎還很有限。
被判定為 AI 之後的處理順序
被老師、主管或客戶拿著一個分數質疑時,順序可以這樣走,先弄清楚對方依據什麼,再用寫作過程還原事實,最後依場合走對的管道。整個過程都是準備證據與溝通,分數只是請你說明的起點。
語氣盡量不要對抗,因為對方多半也只是拿到一個自己不太確定怎麼讀的數字。堪薩斯大學教學卓越中心就提到,教師、系主任與行政人員都說過,不確定該怎麼解讀和使用這些結果。另外,所在機構的規範優先,這裡的做法是準備材料的方向,取代不了學校或公司自己的流程。
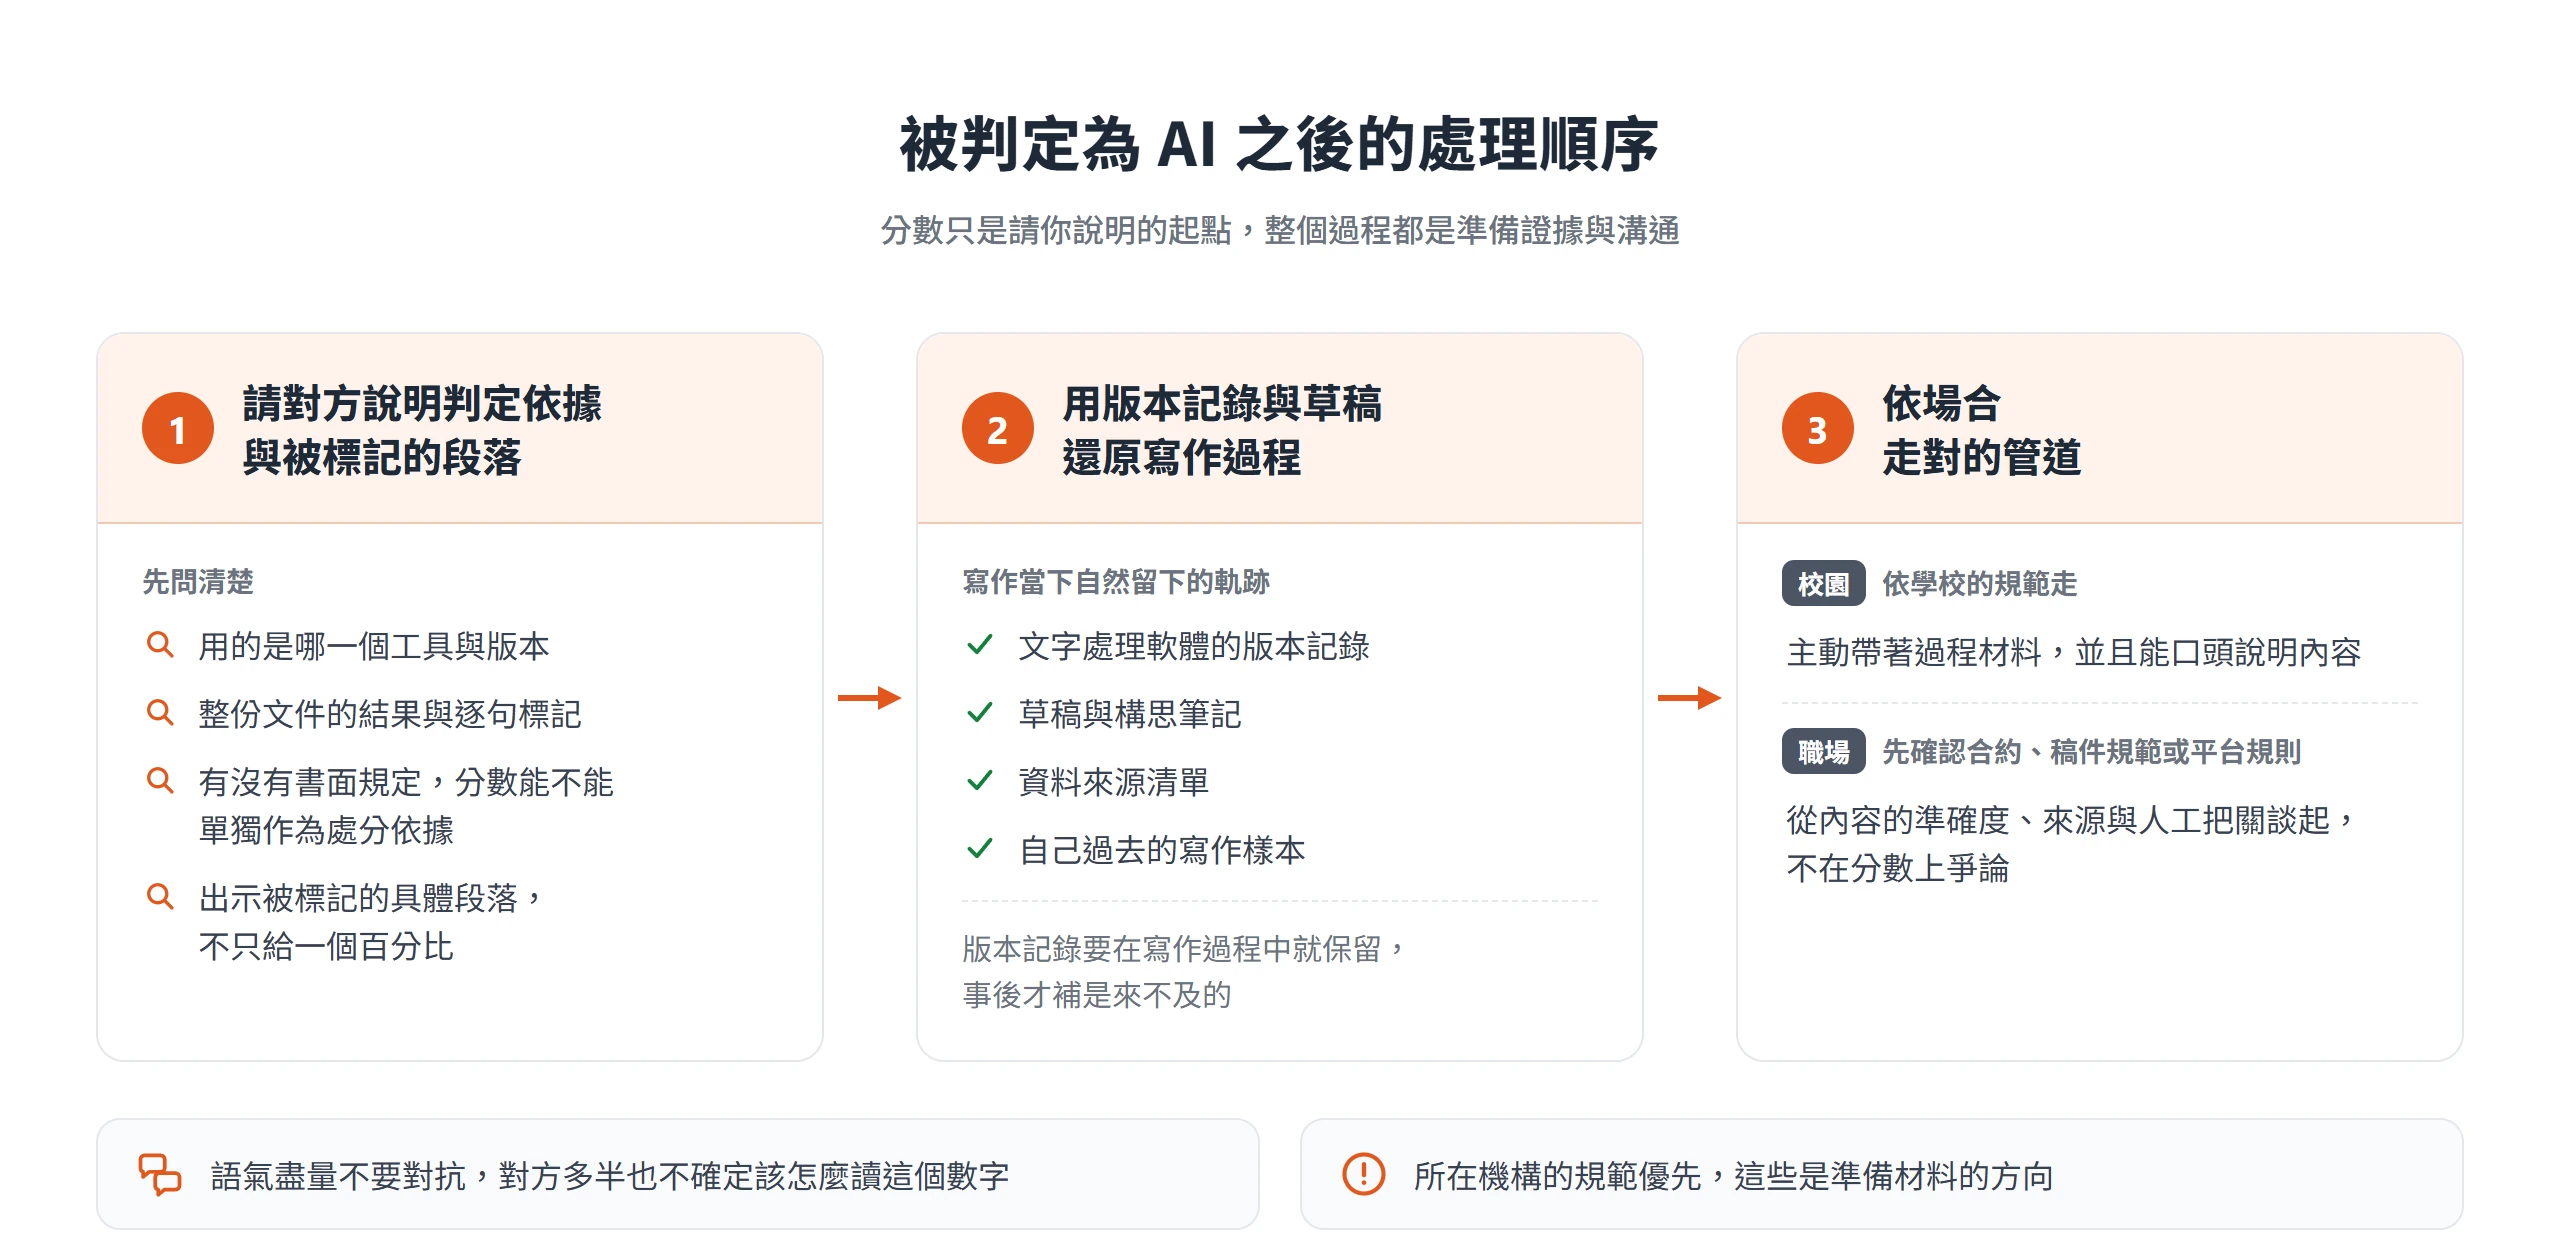
先請對方說明判定依據與被標記的段落
第一步是問清楚三件事,包括用的是哪一個工具與版本;整份文件的結果與逐句標記長什麼樣子;學校或公司有沒有書面規定,這個分數能不能單獨作為處分的依據。
工具廠商自己就寫了「不應該是唯一依據」。Turnitin 的說明頁與密西根州立大學的說明頁,用的是幾乎相同的措辭,內容是 AI 書寫偵測工具可能不準,不應作為對學生採取不利行動的唯一依據,還需要進一步審查與人的判斷。GPTZero 說結果不該用來懲處學生,OpenAI 的教育者說明頁則說偵測器的可靠度不足。
接著請對方出示被標記的具體段落,而不是只給一個百分比。有了段落,才談得上對照:這段是不是公式化的文體、是不是非母語寫作、是不是短到無法評估,前面談過的這些情境,都能在這一步派上用場。
用版本記錄與草稿還原寫作過程
最有說服力的,是寫作當時就留下的軌跡:文字處理軟體的版本記錄、草稿、構思筆記、資料來源清單,還有自己過去的寫作樣本。這些東西的價值,在於它們是寫作當下自然產生的,不是被質疑之後才補出來的。
以 Google 文件為例,版本記錄可以看到更新過檔案的使用者,以及他們所做的變更,也可以替重要的版本命名,命名過的版本不會被系統合併,每份文件最多可有 40 個已命名版本。但它有限制,檔案擁有者可以刪除版本記錄,刪除後無法復原;沒有命名的修訂版本,系統有時也會合併。所以版本記錄要在寫作過程中就保留,事後才補是來不及的。
GPTZero 建議的證據類型很類似,包括草稿、修訂記錄與構思筆記,而且它建議看有沒有長期的寫作模式,而不是只看單一一次事件。寫作過程如果用了 AI 輔助,OpenAI 的教育者說明頁提到,分享 ChatGPT 的對話連結可以讓老師看到使用的方式,這也是一種清楚的揭露。范德堡大學則建議,把這份文字跟學生過去的作品比對風格、語氣與水準。
這一步的前提是紀錄必須是真實的寫作軌跡,所以留紀錄與其說是被質疑時才做的準備,不如說是平常就該養成的習慣,例如用有版本記錄的工具寫、重要稿件存幾個命名版本、筆記與資料來源留著不刪。
校園與職場各自適用的處理管道
校園與職場的處理方式不同,不適合混成一套流程。校園的重點是依學校的規範走,各校細節不一樣,這裡不列特定學校的做法。從老師的角度,GPTZero 建議請學生在受控的環境裡展示對內容的理解,並提出寫作過程的材料;范德堡大學則建議先跟學生談,有些學生在被適當詢問時,會直接說明用了什麼。對被質疑的學生來說,主動帶著過程材料、並且能口頭說明內容,是最直接的回應。
職場的順序不一樣,要先確認合約、稿件規範或平台規則,對 AI 輔助有沒有要求,包括要不要揭露、可以用在哪些環節。沒有明文規定的時候,與其在分數上爭論,不如談內容本身,例如資料是否正確、來源查不查得到、有沒有人把關。
Google 對搜尋內容的說明可以當作參考的方向,它不是客戶合約,但看得出評斷的重心在哪。Google 指出,生成式 AI 在研究主題、替原創內容加上結構時很有用;但用 AI 工具大量產出對使用者沒有附加價值的頁面,可能違反垃圾內容政策中的大規模內容濫用(scaled content abuse);發布前則必須人工查核並審閱內容的準確性。這幾點指向同一件事,就是內容有沒有價值、是否正確,比有沒有用過 AI 更接近評斷的重心。與客戶溝通時,可以從內容的準確度、來源與人工把關談起。
正當使用 AI 輔助寫作並主動揭露
被質疑的根本解法,不是研究怎麼躲過偵測,而是把 AI 的參與程度說清楚,把內容的責任扛起來。檢測器只能猜,揭露與紀錄卻是自己能掌握的。
不是每種用法都需要揭露,也不是每個場合的規則都一樣,核心是依場合規定。最常見的揭露要素有三個:用了什麼工具、用在哪個環節、人工檢查了哪些部分;至於責任,永遠在署名的人身上。
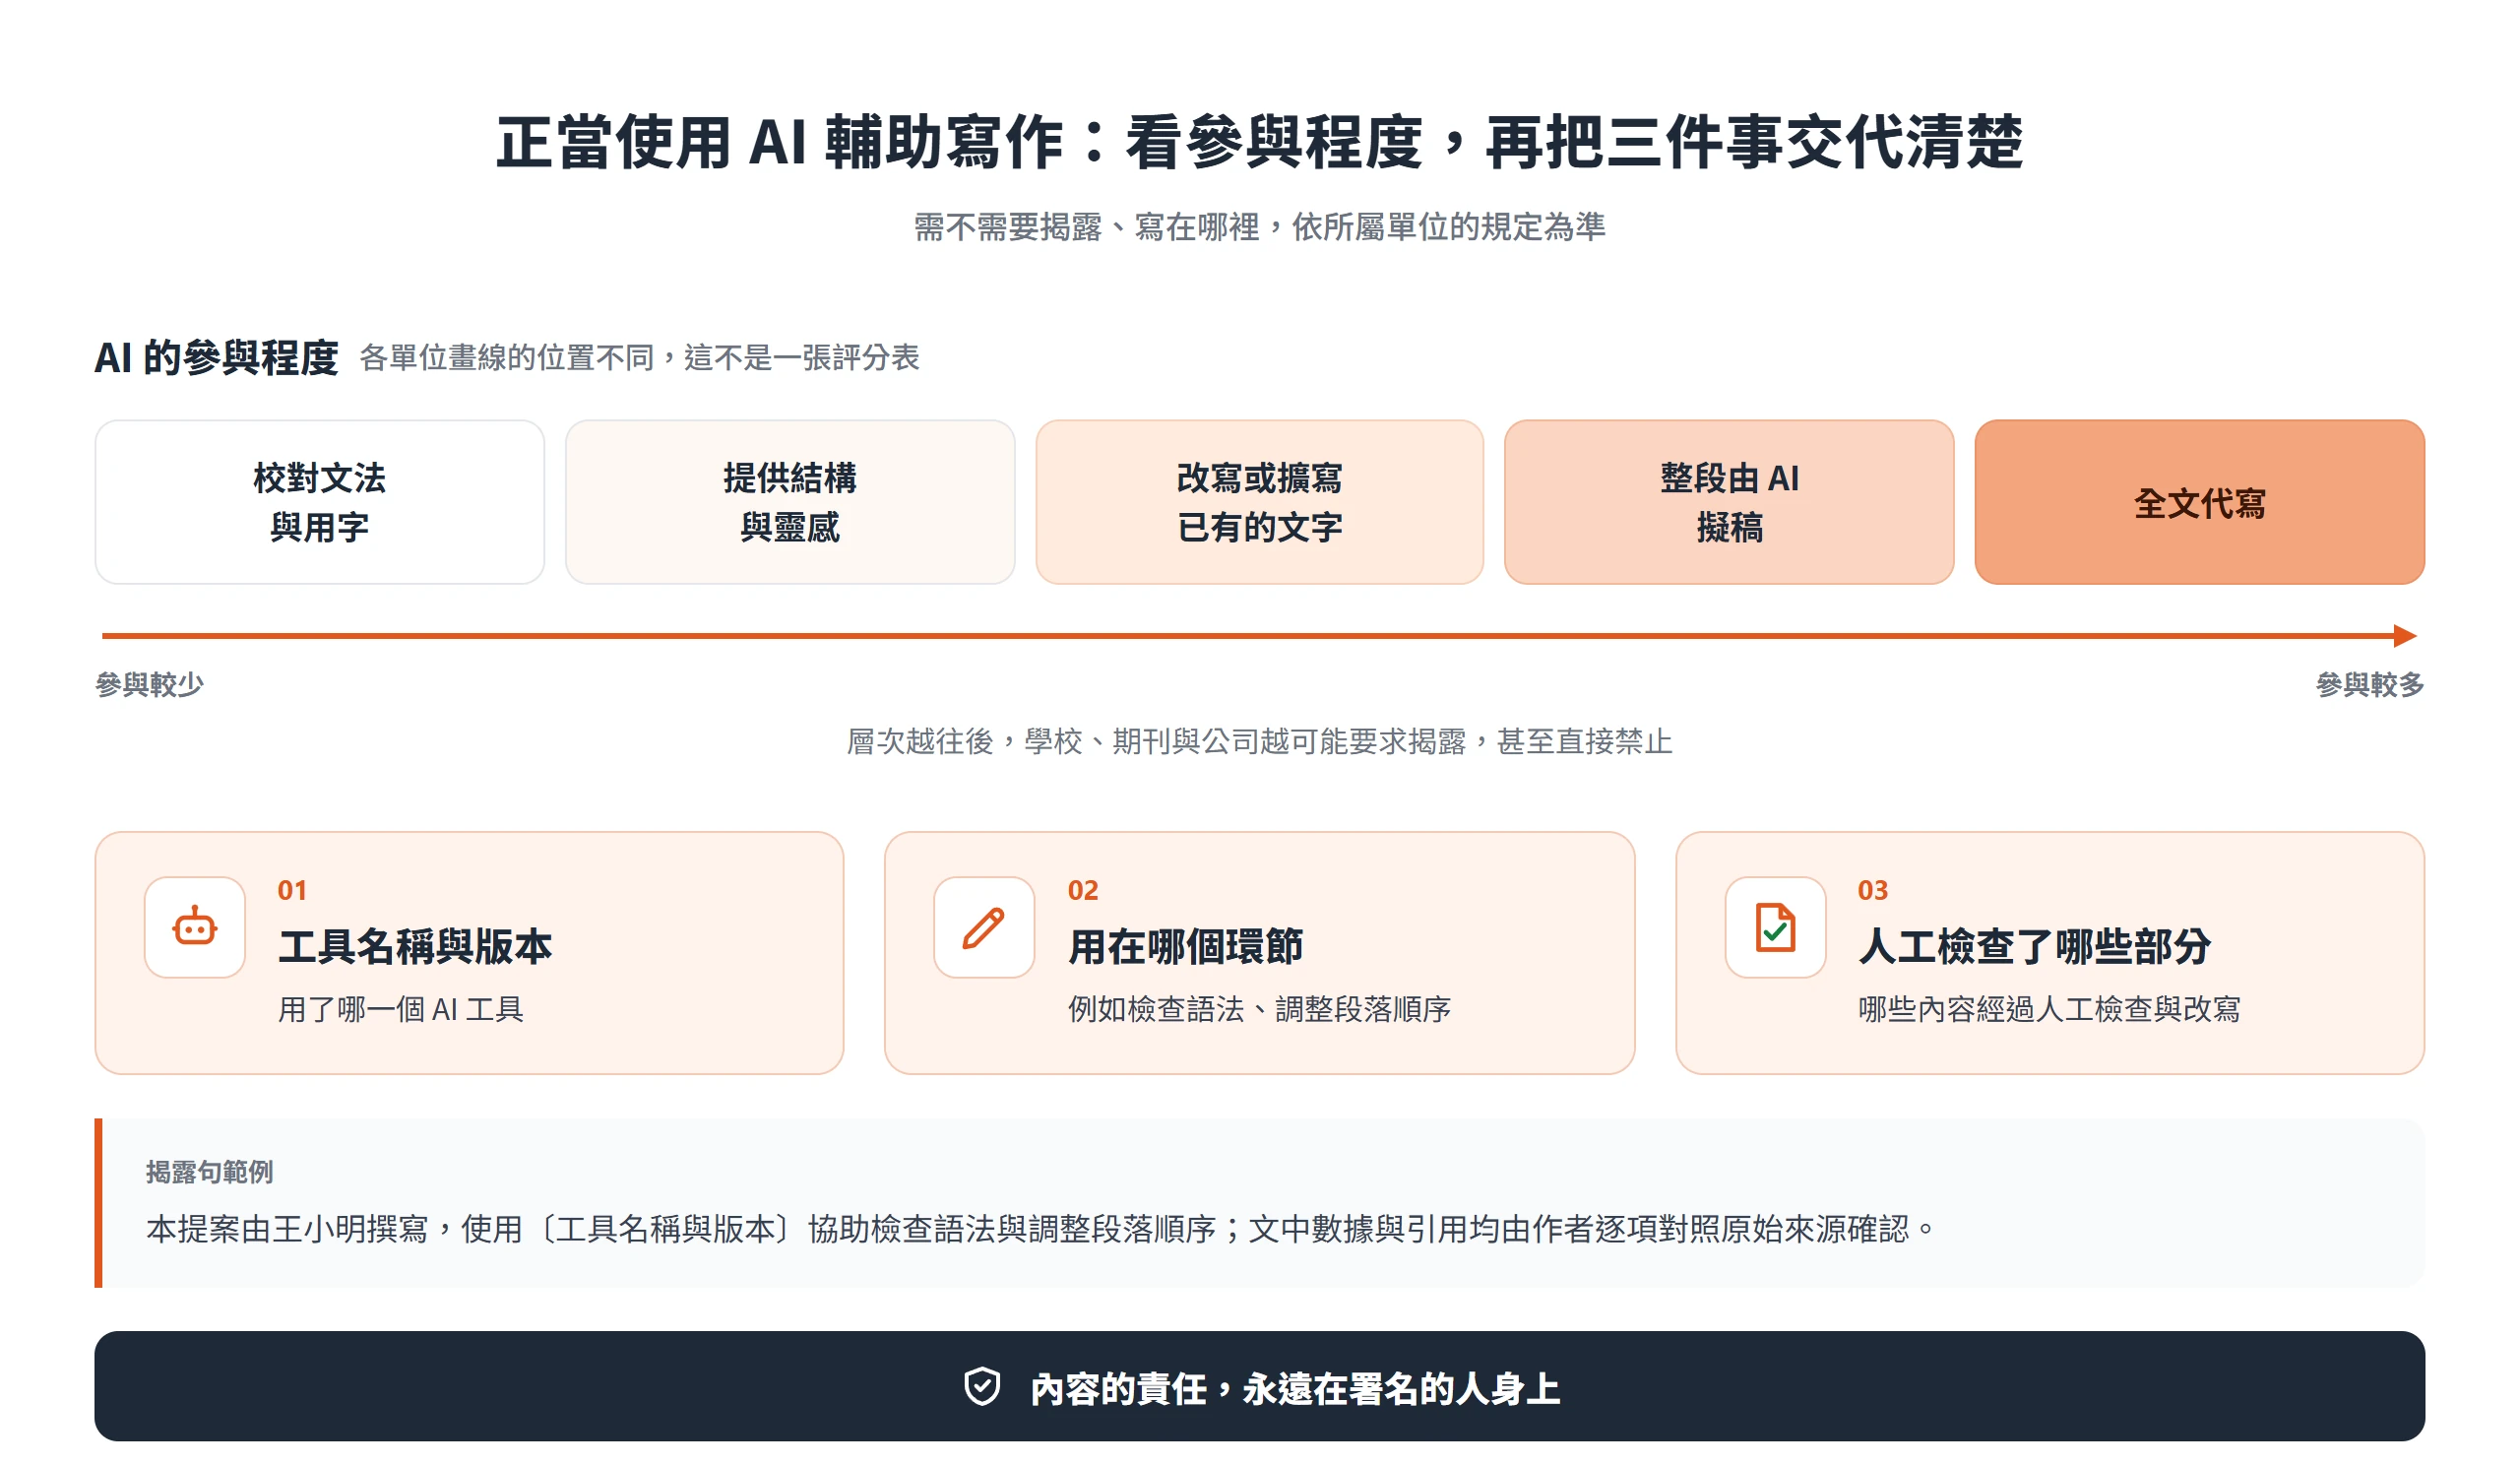
依參與程度區分校對、改寫與代寫
AI 的參與大致可以分成幾個層次:校對文法與用字、提供結構與靈感、改寫或擴寫已有的文字、整段由 AI 擬稿、全文代寫。層次越往後,學校、期刊與公司越可能要求揭露,甚至直接禁止。王小明用 AI 檢查報告的文法,和請 AI 擬出整份提案的初稿,所受到的要求通常就不一樣。這不是一張評分表,各個單位畫線的位置不同,要看自己所屬單位的文件。
國際期刊的政策是一個清楚的例子。國際醫學期刊編輯委員會(ICMJE)規定,ChatGPT 這類 AI 工具不能列為作者,因為它們無法為作品的準確、完整與原創性負責;作者應在投稿時揭露,並於投稿信與稿件適當的章節說明使用方式,也要對所有用到 AI 的內容負責。
台灣政府的做法也有類似的揭露原則。國科會在 2023 年 8 月於行政院院會報告《行政院及所屬機關(構)使用生成式 AI 參考指引(草案)》,其中提到機關把生成式 AI 當作業務輔助時,應適當揭露,也須客觀專業地判斷生成的資訊。這份指引的適用對象是行政院及所屬機關,在這裡只是當作「揭露」原則的例子,並不是一般民眾日常寫作需要遵守的規範。
揭露要寫明工具、用途與人工把關
揭露的句式可以很簡單,重點是三件事交代清楚:工具名稱與版本、使用在哪個環節、哪些內容經過人工檢查與改寫。例如:
> 本提案由王小明撰寫,使用〔工具名稱與版本〕協助檢查語法與調整段落順序;文中數據與引用均由作者逐項對照原始來源確認。
換成團隊的情境,龐果設計的客戶提案可以這樣寫,初稿由設計師撰寫,AI 工具只用在整理會議紀錄的重點,最終內容經過主管逐項檢查。讀的人看到這三個要素,就知道 AI 的角色有多大,責任由誰承擔。
Google 對網站內容的說明也提到,分享內容是怎麼產生的,可以讓讀者得到更多脈絡。學術與出版的場合可能有固定的位置,ICMJE 要求的是投稿信與稿件適當的章節;APA 與 MLA 也已經有引用生成式 AI 的格式,細節以兩家的格式說明為準。另外,保留與 AI 的對話紀錄,既是揭露的材料,也是被質疑時的證據。
對內容負責仍是作者的事
揭露只是透明,品質仍要自己把關。Google 的說明提醒,生成式模型並不是在檢索事實,而是依訓練資料預測可能出現的字詞序列,所以輸出可能含有不準確的內容,也就是常說的幻覺(hallucinations)。因此在發布之前,必須人工查核並審閱所有 AI 生成的內容。
范德堡大學同樣指出,AI 文字生成器可能會憑空編造出整個來源。所以 AI 寫出來的事實、數字與引用,都要自己回到原始資料確認。一份附了漂亮引用、卻查不到出處的文章,被質疑的風險遠比一個分數高。
回到最初那份被標上 AI率 38% 的報告。分數沒辦法證明作者是誰,也沒辦法替誰辯護,AI detector 能做的,是指出哪些地方值得多看一眼;真正站得住腳的,是寫作的過程紀錄,以及內容經得起查證。
下次被問起,或是自己要交一份用過 AI 輔助的稿子,先問清楚所屬單位的規則,寫作時順手留下版本記錄與來源清單,用到 AI 的地方直接說明。這幾件事不需要等被質疑才做,平常就養成習慣,分數高低就不會是唯一的說法。