多數設計團隊把「先看數據」當成不會出錯的護身符,只要轉換率、點擊率、留存曲線這些數字過關,這個決策就算通過驗證。問題是,數據能證明的永遠只是使用者在現有介面裡已經做出的選擇,證明不了本來還有一條沒被端上檯面的更好路徑。
我不認為數據不可信,問題也不在團隊執行不力或分析工具不夠精準。數據導向設計(data-driven design)這套方法論本身就有一條內建的邊界,任何量化系統天生只看得到已經被設計進介面的選項被選中的結果,看不到那些從一開始就不存在的選項。這條邊界一旦被忽略,團隊很容易把數字看成一片綠燈,誤讀成已經做到最好。
這條邊界具體會在哪些情境裡顯形,又該怎麼判斷什麼時候數據依然撐得住拍板,先從數據本身唯一記得住的那一半講起。
數據記得住的是已發生的選擇而非沒被端上的選項
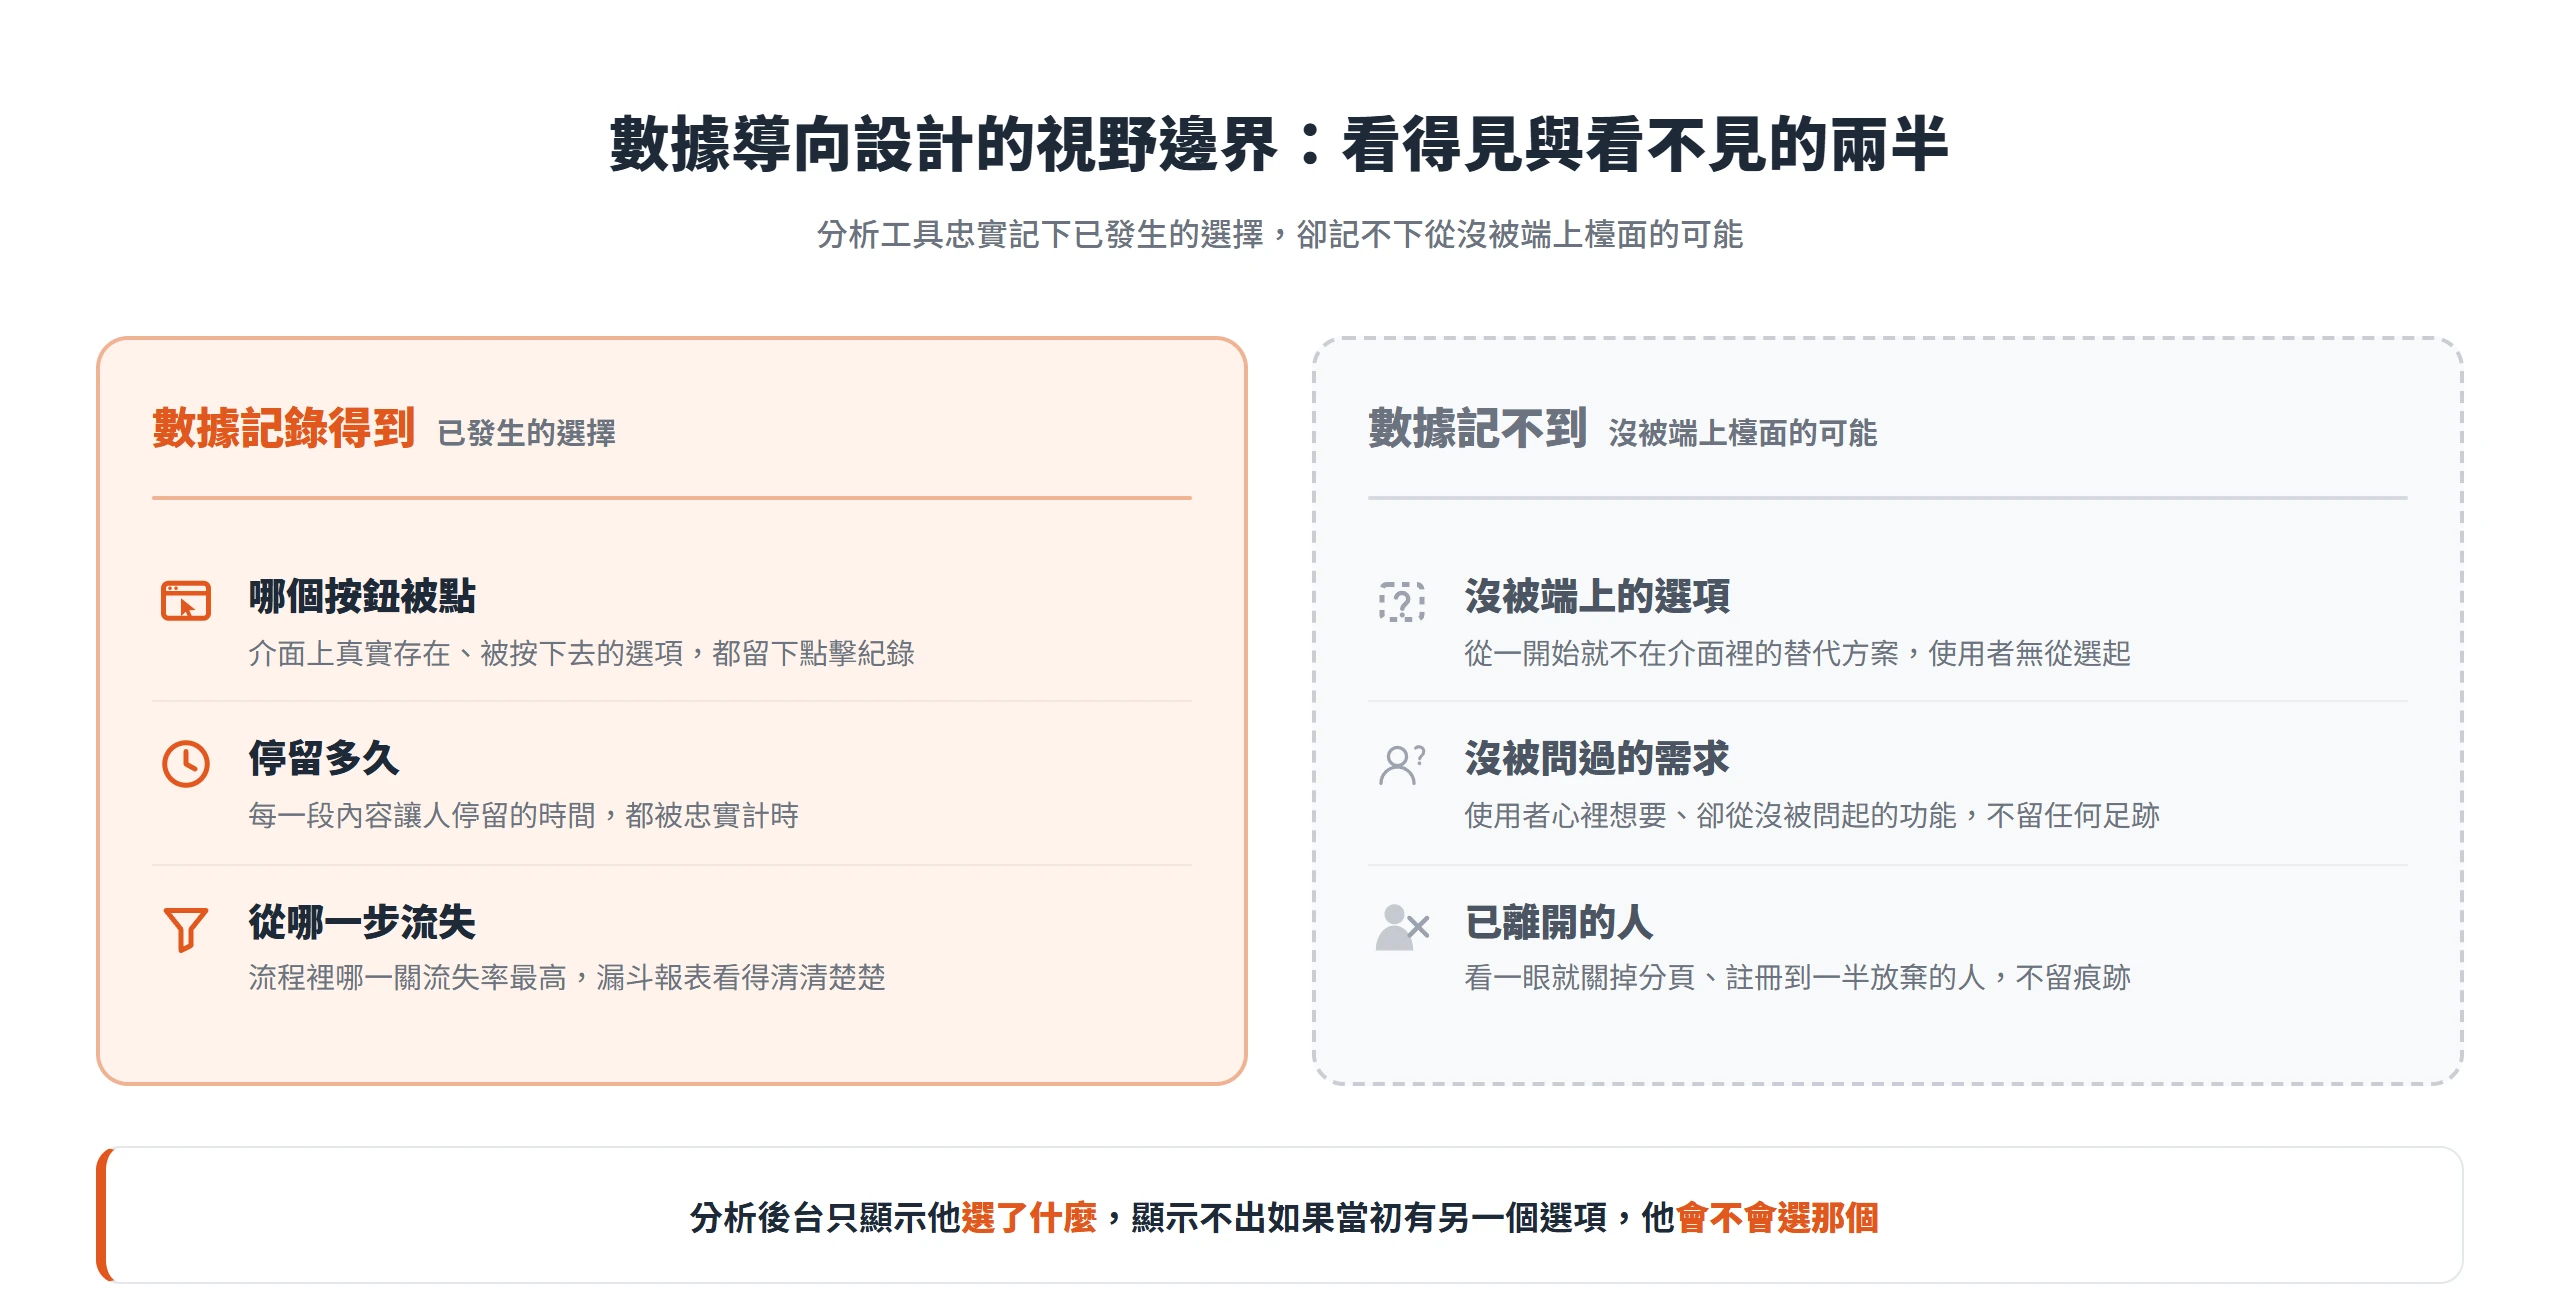
GA4、熱圖、轉換率報表能做的事其實很單純,就是把使用者在你已經設計出來的介面裡按了什麼、停留多久、從哪裡離開,忠實地記錄下來。這些工具擅長回答已經發生的行為,哪個按鈕被點得最多,哪一段內容讓人停留最久,哪一步流程流失率最高。它們回答不了的,是那些從一開始就沒被端上介面的選項。使用者沒辦法點擊一個不存在的按鈕,也沒辦法在問卷裡勾選一個從沒出現過的功能;任何分析後台都只能顯示他選了什麼,不會顯示如果當初有另一個選項,他會不會選那個。
這個限制不是分析工具做得不夠好,而是整套量化方法論,經濟學裡的顯示性偏好(revealed preference),本身內建的邊界。這套理論的核心假設是,只要觀察一個人實際做出的選擇,就能反推出他真正的偏好,不需要開口問他。但這個推論成立的前提,是研究者得先知道這個人當時面對的是完整的選擇集合,他手上有哪些選項可以選。ScienceDirect 的經濟學條目說明,顯示性偏好法的核心限制正是無法反映使用者對未被選中選項的相對評價;一旦研究者不清楚使用者實際面對的完整選擇集合,顯示性偏好的推論本身就會失效。要補上這塊落差,得靠陳述性偏好(stated preference),也就是開放式訪談、問卷這類質化方法,直接問使用者如果當初有這個選項,他會不會選。
落到設計場景裡,這條學理背景幾乎是逐字對應的。使用者從沒被問過的需求、產品團隊從沒端上介面的替代方案,不會留下任何數據足跡,不會出現在轉換漏斗裡,不會出現在熱圖的任何一個像素上,也不會被任何一支 A/B 測試量到。分析工具能告訴你留在流程裡的人選了 A 還是 B,但答不出有沒有一個 C 選項能讓更多人留下來,因為 C 從來就不存在於介面裡,也就不存在於任何一份數據報表裡。
盯著同一個指標太久,數字會開始說謊
轉換率明明持續往上,團隊卻隱約覺得體驗沒有真的變好,這種落差多半是 Goodhart’s Law(古哈特定律)在起作用。這條定律最早由倫敦政經學院的經濟學家 Charles Goodhart 於 1975 年提出,他當時的原始陳述其實更技術性:「任何被觀察到的統計規律性,一旦被拿來做管制、刻意施加壓力,就會趨於崩潰。」後來人類學家 Marilyn Strathern 在 1997 年把這個概念濃縮成更廣為流傳的說法:「當一個衡量指標變成目標,它就不再是一個好的衡量指標。」道理不難理解,指標原本只是一支溫度計,用來間接反映某個你真正在乎的東西,體驗好不好、產品有沒有解決問題。可是一旦這支溫度計被團隊拿來當成要達成的目標本身,人就會開始想辦法讓溫度計的數字上升,而不是去改善溫度計原本要量測的那件事。
套用在產品或敏捷團隊的日常裡,這個誤用相當常見,一旦某個特定指標被當成績效目標,個人或團隊就會傾向直接操弄、優化那個指標本身,而不是優化它原本要代表的品質,行為因此失真。轉換率一旦變成人人盯著的 KPI,常見的操作是把按鈕做得更大、拉高彈窗出現的頻率、把原本三步驟的流程硬壓成一步,每一項都能讓轉換率的數字往上跳,卻沒有一項真的讓使用者更清楚知道自己在做什麼。指標升高了,體驗卻可能同時在變差,只是這個變差不會反映在你正在盯著的那支溫度計上,因為那支溫度計量的從來就是有沒有人按下去,不是按下去的人清不清楚自己在按什麼。
更麻煩的是,這個過程不會一次到位,而是分階段惡化。指標一開始是感測工具,忠實反映體驗狀態;被當成目標之後,它變成團隊實際追逐的對象,體驗本身反而退居第二;等到操弄手法用老了、數字漲不動了,指標最後常常淪為維持門面的儀式,每週報告照樣附上那條上升的曲線,底下的體驗品質卻早就沒人真的在追蹤。
反覆微調容易卡在局部最佳值而錯過更好的方向
持續針對現有介面跑 A/B 測試,每一輪都能看到轉換率小幅往上,這種持續進步的感覺很容易讓團隊誤判自己已經接近最佳解。實際情況常常只是卡在一座小山丘的頂端,旁邊還有一座更高的山,只是團隊從來沒有離開現在這座山去試過。
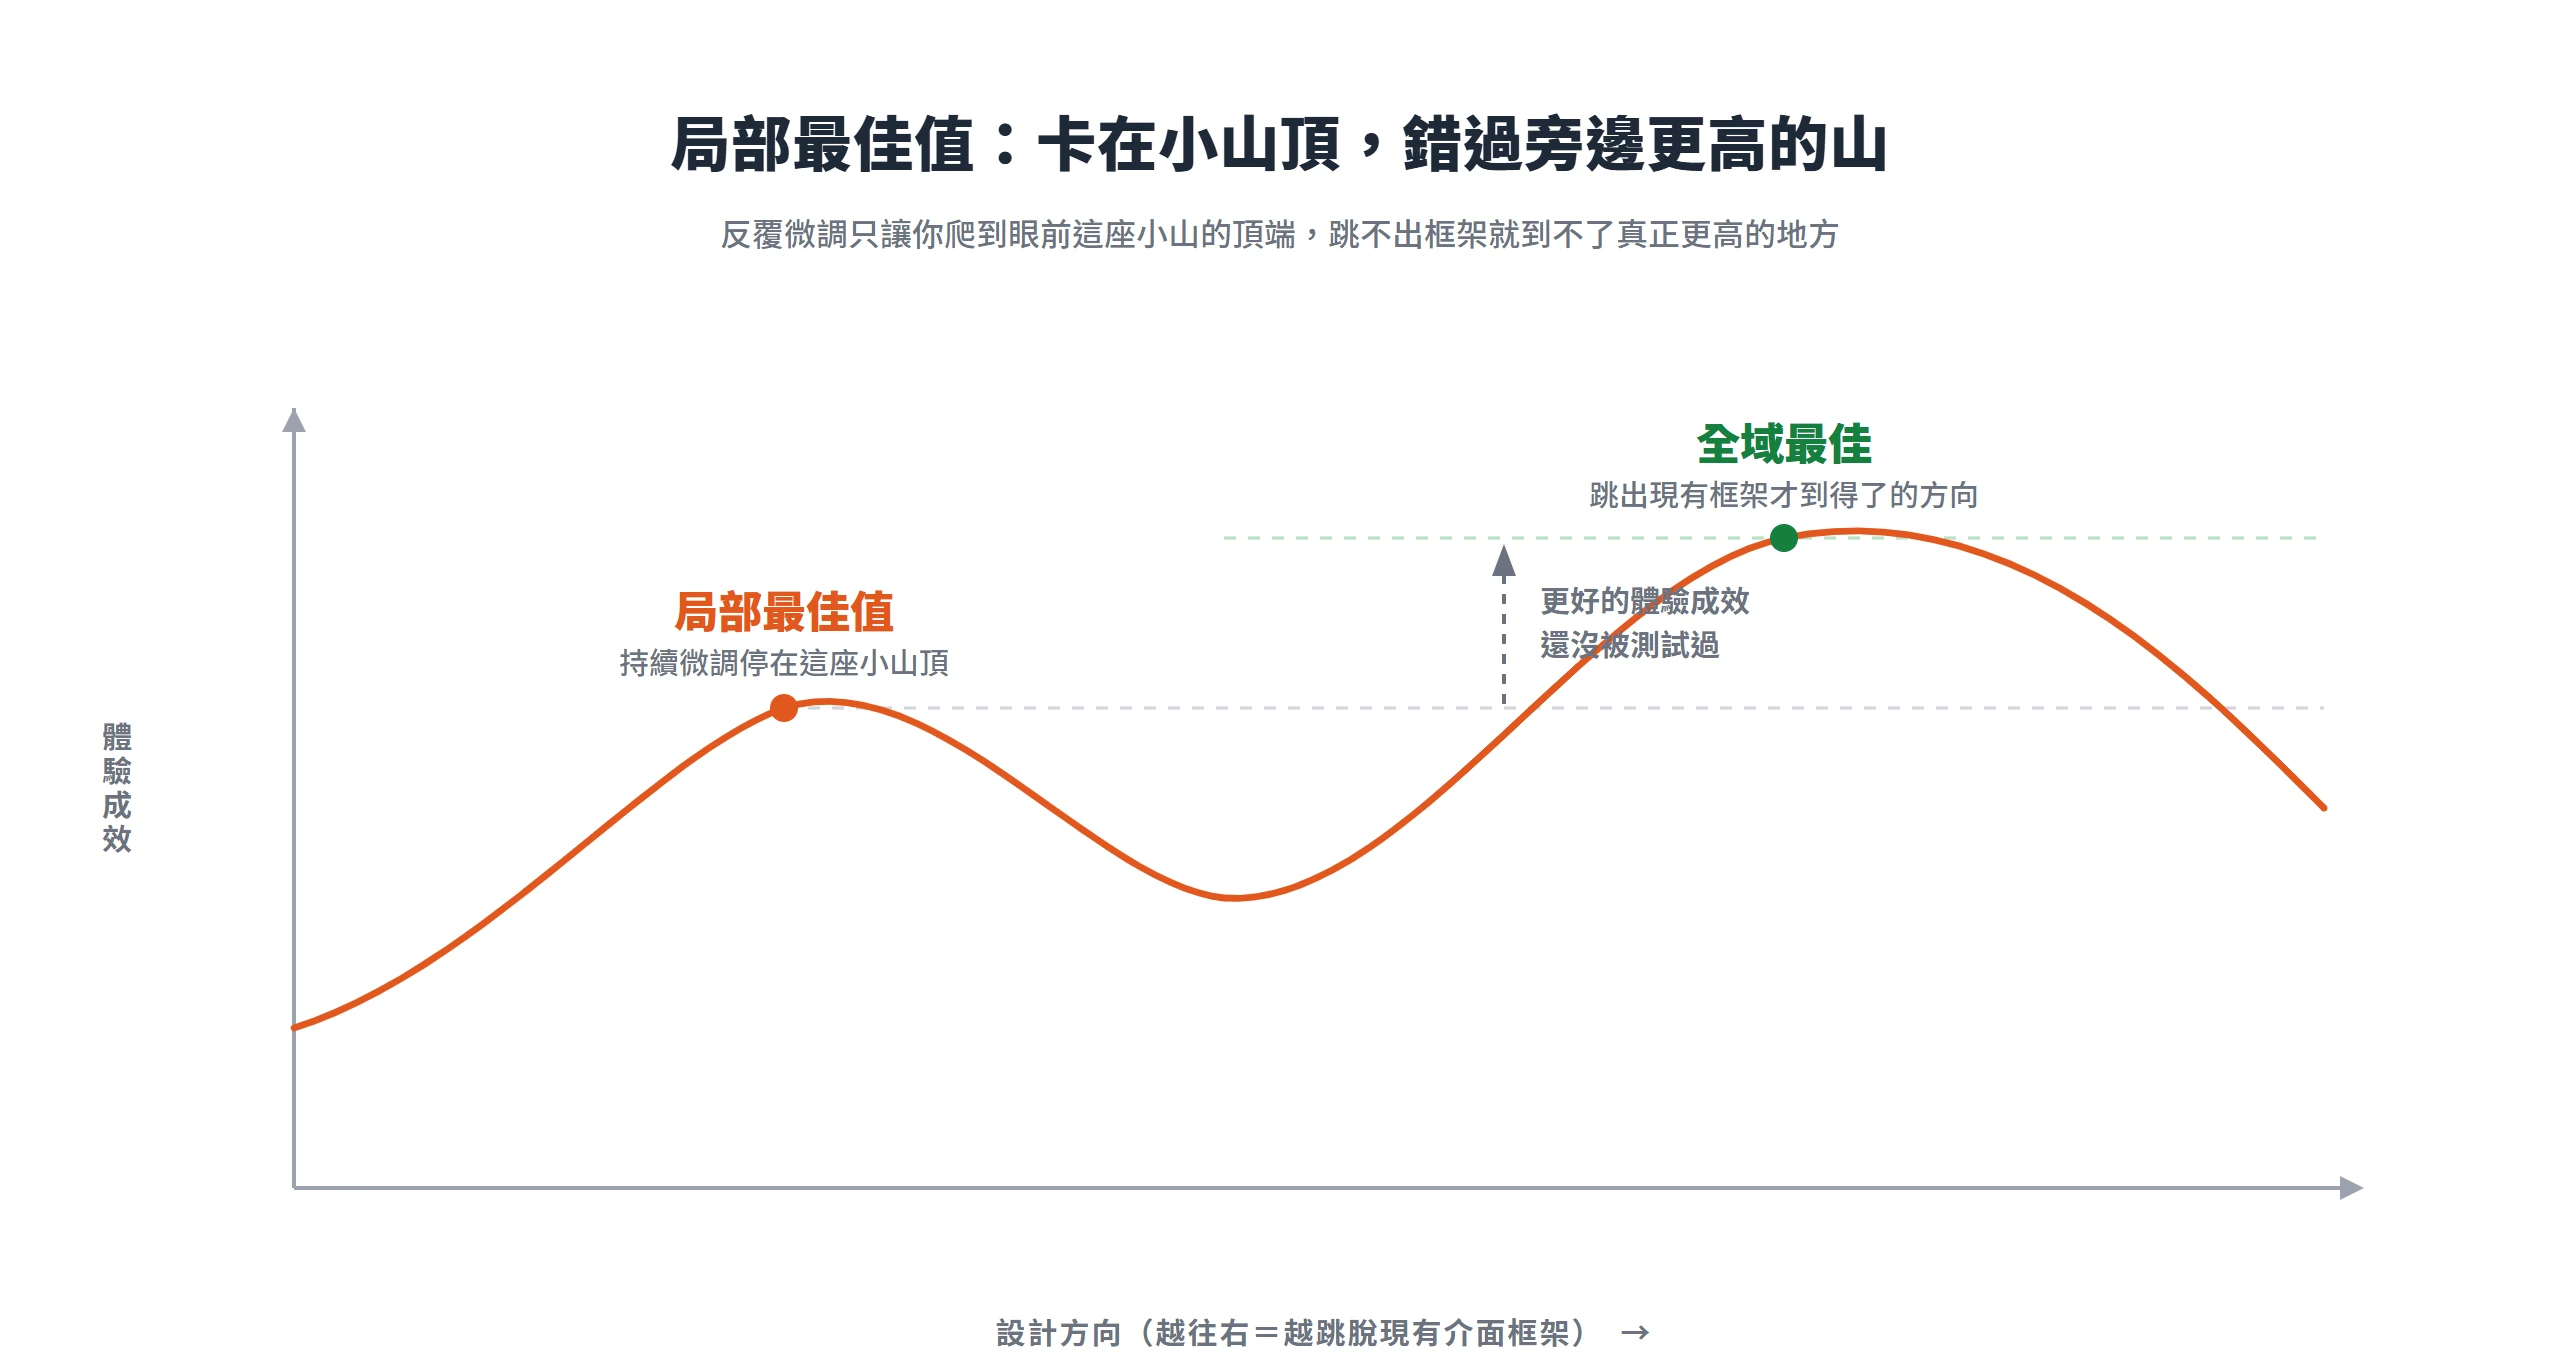
這個陷阱之所以成立,是因為漸進式優化天生只回答一種問題,也就是這一版比現有版本好還是壞。它不會去驗證一個完全不同的方向會不會比現在這整座山都好,因為那個方向根本沒被放進測試名單裡。連續幾次小幅提升,很容易被誤讀成已經做對了的訊號,但那只證明現在這條路走得比昨天更順,不代表這條路本身就是對的路。
微幅優化只驗證「比現況好一點」,不驗證這是不是對的方向
每一輪 A/B 測試都以現有版本當對照組,這個設計本身就決定了測試贏家只能是現有做法的加強版。介面上的文案改得更順、按鈕位置調得更順眼、流程少了一個步驟,這些都會贏過現有版本,也都值得做,但它們共享同一個侷限,一個完全跳脫現有框架的介面邏輯如果沒被真的拿來跑一次測試,永遠沒有機會被驗證是不是更好。
Interaction Design Foundation 在〈What is Local Maxima in UX〉指出,UX 的局部最佳值是一種設計看起來已經達到最佳體驗、實際上還有更好的做法沒被發掘的狀態,而團隊盲目依賴數據做小幅反應式修正時最容易卡在這裡。長期停留在局部最佳值不只是錯過進步的機會,還會壓抑創新,體驗因此暴露在被競爭對手超車的風險裡,因為對手可能去解決了一個團隊從來沒有測試過的更深層需求,而不是繼續在同一座山頭上跟自己比賽。
需要養成期才看得出效果的方向,撐不過短週期測試
局部最佳值陷阱最容易犧牲掉的,是那些需要一段養成期才看得出成效的方向,調整品牌調性、重新設計整套資訊架構、換一套需要使用者重新學習的操作邏輯。這類投資的共同特徵是,剛換上去的頭幾週數字通常不會立刻變好,使用者需要時間重新適應,轉換率甚至可能先小幅下滑,要撐過這段陣痛期,效果才會顯現。
問題是,兩週一次的 A/B 測試週期根本等不到這段陣痛期結束。跟這種需要養成期的方向對打,維持現況、只把某個按鈕改個顏色的版本幾乎穩贏,因為後者的效果立刻反映在下一輪報表上。《美國行政科學季刊》(Administrative Science Quarterly)2025 年一項針對消費品公司新品開發的研究指出,缺乏方法論多元性(methodological pluralism,量化與質化分析並重)是組織做不出突破性新品成果的常見原因;《哈佛商業評論》2024 年 9 月號的〈Where Data-Driven Decision-Making Can Go Wrong〉也點出類似的常見誤區,組織衡量的往往是容易衡量的東西,而不是真正重要的東西。短週期、單一指標的測試機制,正是這種偏誤具體展現的樣子,組織長期只做得出小修小補,真正需要方向調整的專案永遠排不進待辦清單的前面。
轉換率上升未必代表使用者真正達成目標
轉換率上升是好消息,但它只回答了有多少人完成了這個動作,答不出他們是怎麼完成的。使用者可能是用一條更迂迴、更讓人挫折的路徑才勉強走到終點,多按了兩次上一步、在某個欄位反覆填錯又修正、甚至先離開頁面查了資料才回來完成,這些過程都不會被壓縮進轉換率這一個數字裡,數字本身只會告訴你他最終還是完成了。
Nielsen Norman Group 在〈Quantitative vs. Qualitative Usability Testing〉裡明確指出,量化研究只能告訴你使用者執行某個任務的頻率有多高,但這個數字算好還是算差,需要脈絡才能判斷;量化方法適合回答多少、多常,質化方法才適合回答為什麼、要怎麼調整。文章同時提醒,量化研究如果沒有在每個細節都做到精確,得出的數字反而會誤導決策方向。
也就是說,轉換率上升與使用者真正達成目標之間,可能存在一段沒被量到的落差,數字上升掩蓋掉的,恰恰是體驗變差的事實。要看清這段落差裡發生了什麼,得靠質化方法補上:訪談使用者剛才那趟流程走得順不順,可用性測試觀察他在哪一步猶豫、哪一步差點放棄。什麼時候一定要補這一塊?只要轉換率這個單一數字開始跟團隊對這個功能的直覺產生落差,覺得應該更順但數字沒有明顯反映,或數字很好看但團隊心裡對某個環節仍有疑慮,就是該補質化研究,把數字底下使用者實際經歷的那一半問出來的時候。
留在數據裡的都是還沒離開的人,離開的人不留痕跡
二戰期間,美軍統計小組觀察轟炸機返航後的彈孔分布,發現機翼與機身是彈孔最密集的地方,軍方原本打算就在這些地方加裝更厚的裝甲。任職哥倫比亞大學統計研究小組的 Abraham Wald 卻指出,這個判斷剛好顛倒了方向。
美國數學學會(American Mathematical Society)在〈The Legend of Abraham Wald〉這篇公眾推廣專欄裡詳述了這個案例,指出能被檢視、統計到彈孔分布的,都是中彈了還能撐著飛回來的那批飛機。機翼、機身彈孔密集,恰恰證明這些部位就算中彈,飛機還是扛得住、飛得回來;真正該補強裝甲的,是那些幾乎沒有彈孔紀錄的引擎與駕駛艙,因為中彈打在那裡的飛機根本沒有能力飛回來,自然也不會出現在這批被統計的樣本裡。軍方後來採納了 Wald 的建議,調整了裝甲配置。
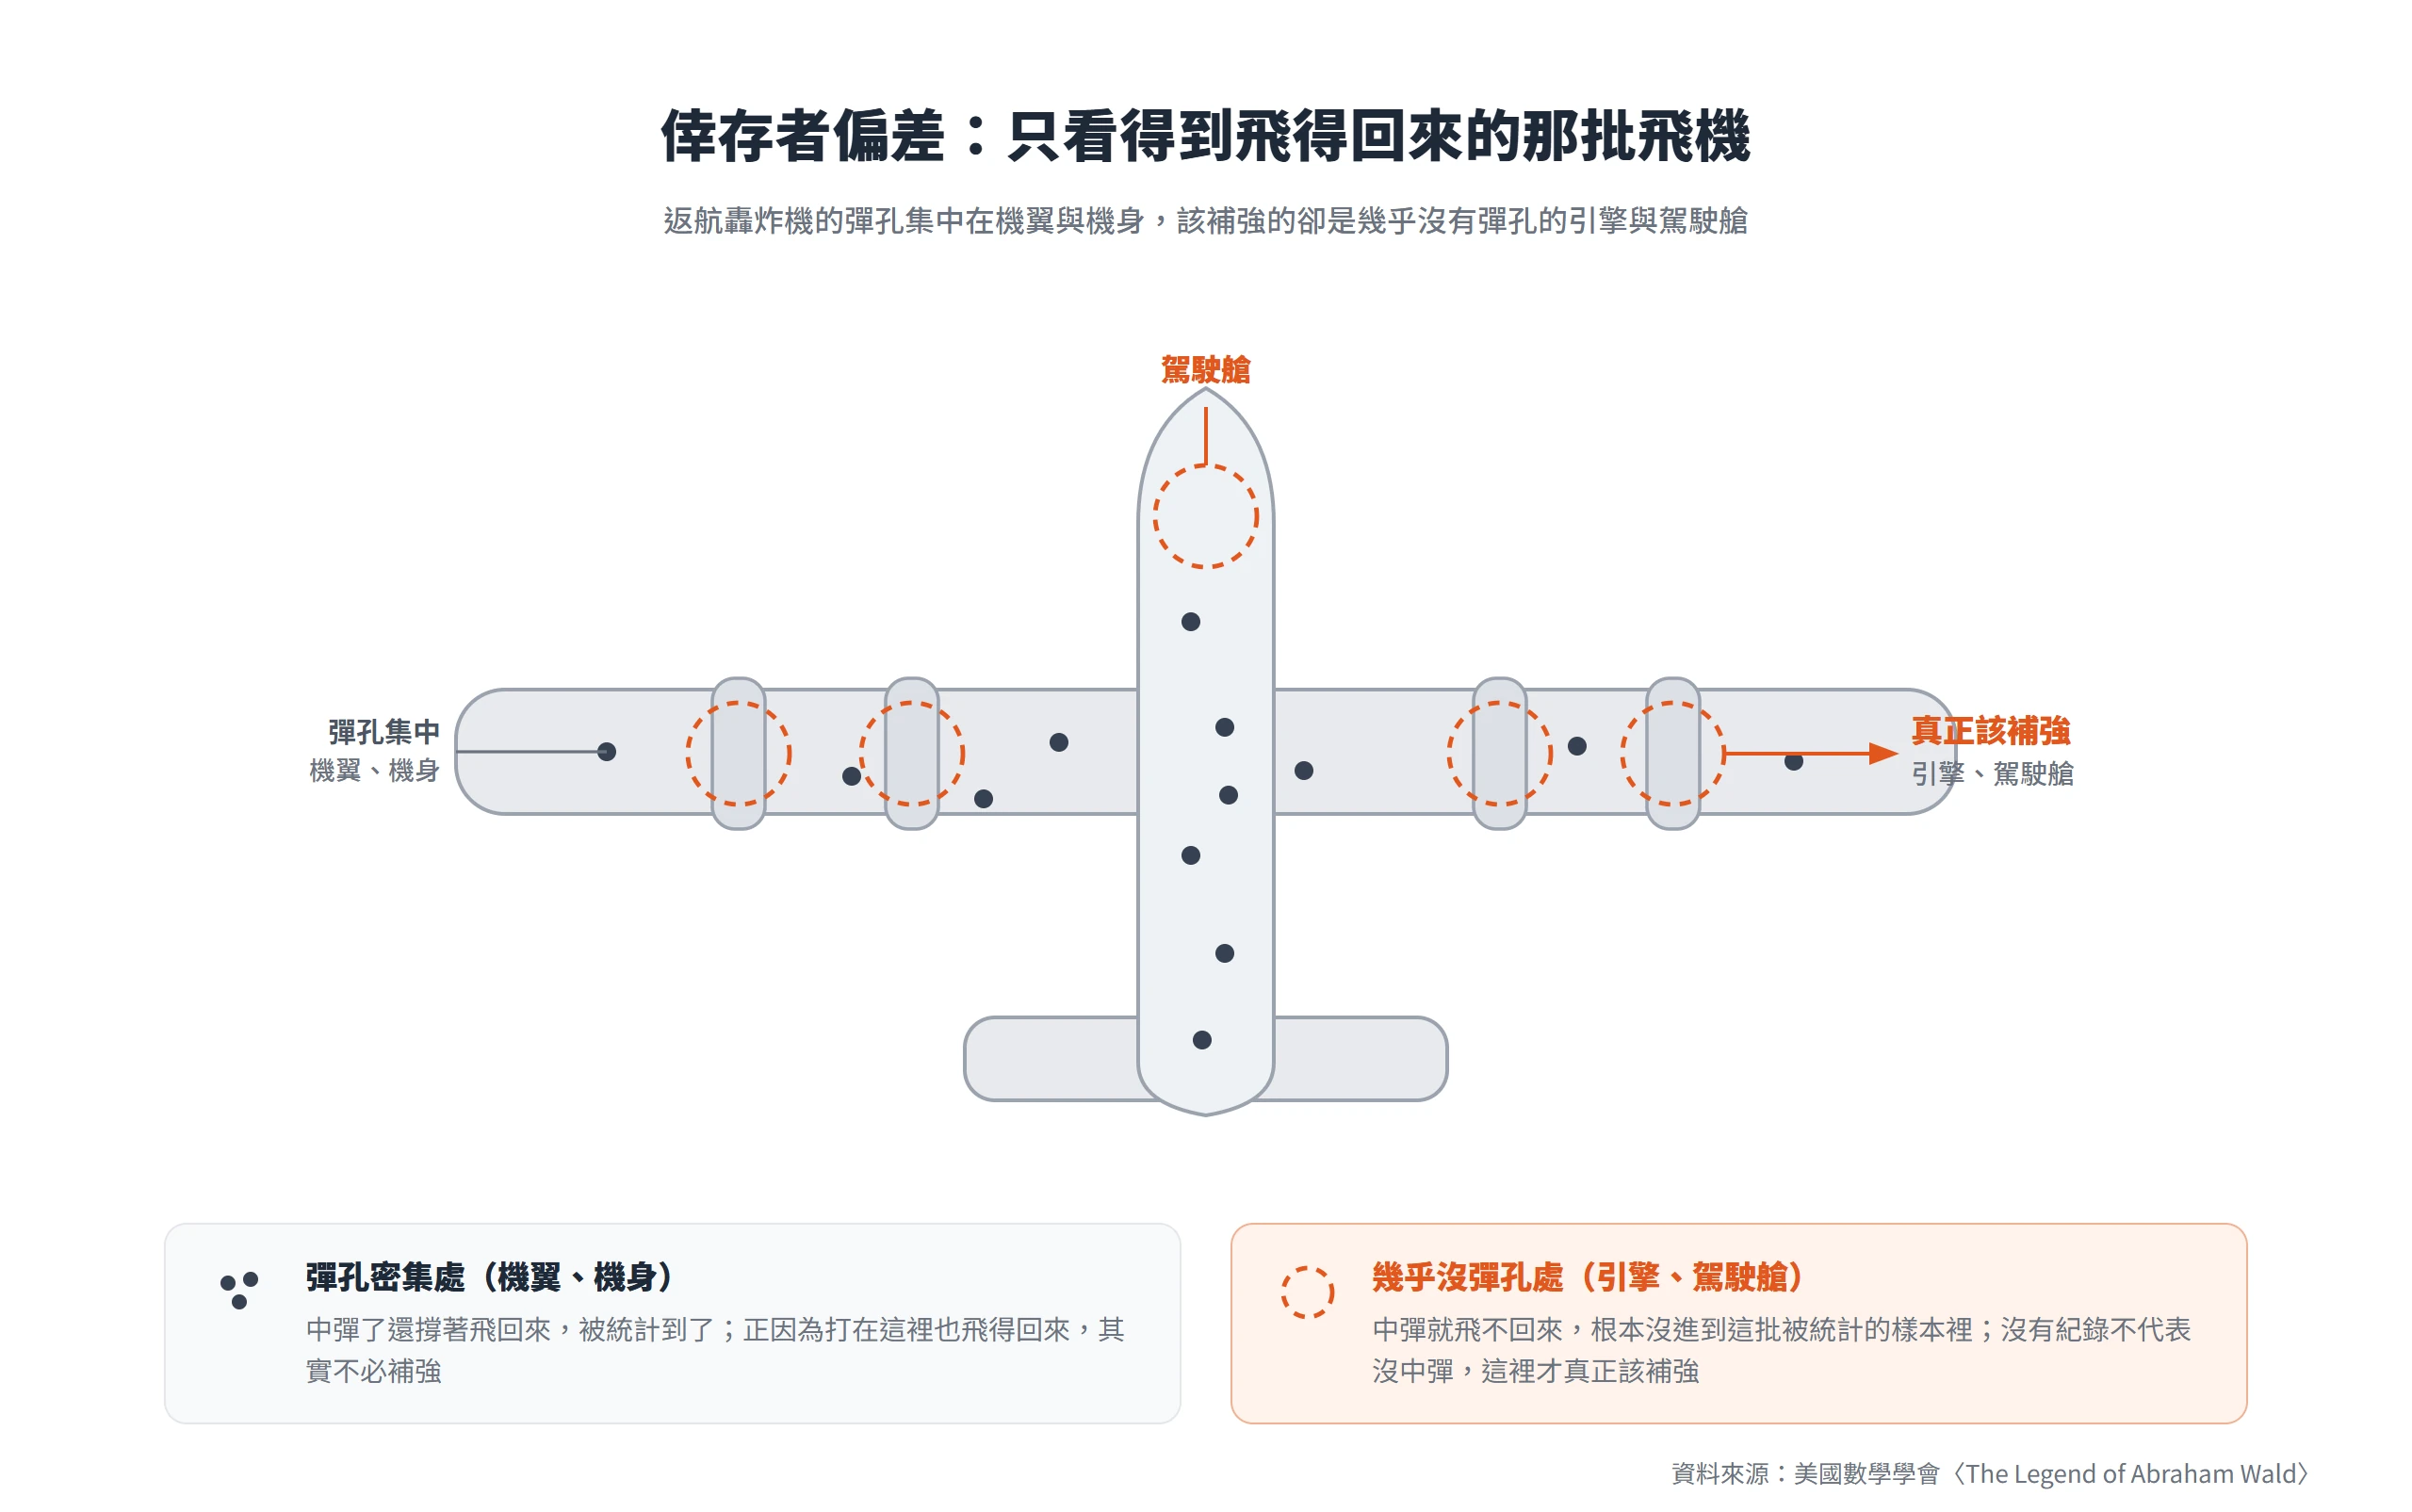
這個推論放進產品數據裡,幾乎是逐字對應的倖存者偏差。留存曲線、轉換漏斗裡呈現的,永遠是還留在系統裡的使用者的行為軌跡,他們點了哪個按鈕、卡在哪一步之後還是完成了、用了多久才上手。那些看了首頁一眼就關掉分頁的人、註冊表單填到一半就放棄的人、下載了 App 用一次就再也沒打開過的人,從來不會出現在任何一張儀表板上,因為他們早在被記錄下來之前就已經離開了。
只優化現有活躍使用者的體驗,邏輯上等同於只加固還飛得回來的那幾個部位,這些使用者已經證明了自己願意忍受目前的介面,再怎麼幫他們把體驗磨得更順,都碰不到真正讓潛在使用者卻步的那個環節,因為那個環節的資料缺口是系統性的、結構性的,不是團隊漏看了哪一格報表就能補上的。
數據夠不夠當決策依據,要看這次改動的風險與方向
前面五個場景講的都是數據方法論的邊界在哪裡,不是數據不可信。分析工具依然是設計決策裡最誠實的一份紀錄,問題從來不在工具本身,而在於團隊有沒有分清楚,這次改動是數據本來就管得到的那種,還是已經踩進數據看不到的那塊灰色地帶。
數據對低風險、可逆的小改動說了算
文案怎麼寫、按鈕用什麼顏色、版面間距留多寬,這類單一變數、流量夠大、而且改壞了也能立刻改回來的低風險決策,正是數據導向決策最站得住腳的場景。問題定義本來就很清楚,只差哪個版本表現比較好這一個答案,A/B 測試正是為了回答這種問題設計出來的工具,硬要在這種決策上加一層質化訪談,反而只會拖慢原本可以一週內拍板的事。
《哈佛商業評論》那篇文章強調,領導者要判斷一份分析的內部效度(是否真的回答了那個問題)與外部效度(結果能不能類推到其他情境)。對於問題定義清楚、樣本量足夠的單一變數優化來說,量化測試本身就具備足夠的內部效度,不需要額外的方法論介入去補強,這正是前面幾節的邊界不適用的地方。
數據在方向與品牌判斷裡只是提問起點
換一套品牌調性、決定要不要砍掉現有的核心功能重做、要不要為了長期留存犧牲短期轉換率,這類牽涉方向與品牌判斷的決策,數據能提供的只是一個提問的起點,不是答案本身。當某個指標停滯不前、或某個環節的流失率忽然異常,正確的下一步不是直接照著數字改介面,而是先問一句為什麼,找幾位使用者做深度訪談或可用性測試,把數字背後那些沒被看到的選擇、被沉默掉的那群使用者問出來,再決定要不要真的跳出目前這座局部最佳值的山頭,做一次方向調整。
這不是要放棄數據,而是把數據放回它原本該待的位置,也就是提出正確問題的起點,而不是唯一或最終的決策依據。前面提到那份《美國行政科學季刊》的研究也呼應這一點,真正做出突破性新品成果的組織,往往是同時大量倚重量化與質化分析的那一群,而不是把其中一種當成唯一依據。最後要不要跳出目前這座局部最佳值的山頭、往哪個方向調整,終究還是需要人來拍板。
下一次看著儀表板上那條漂亮的曲線,值得多問自己一句,這條曲線證明的,是這個決定真的做對了,還是只證明留在這套介面裡的人剛好選了這個選項。數據永遠誠實地記錄著已經發生的事,但設計要面對的,從來是那些還沒被端上檯面的可能。