把一個網頁的原始碼整份交給 AI,有點像把整本雜誌連廣告插頁、目錄與頁碼一起影印,再請對方只挑其中一篇專欄來摘要。內容明明都在,只是被導覽列、追蹤腳本、彈出視窗與樣式碼包得太厚,模型得先花力氣剝掉這些東西,剝不乾淨還會被雜訊帶偏。Firecrawl 做的就是這道剝皮工序,你給它一個網址,它回傳整理好的 Markdown,或是你指定欄位的 JSON。
這件事聽起來單純,現行的 Firecrawl 卻已經長成一組不小的工具箱。網路上不少舊寫法停在前一代的介面,類別名、方法名與計價都和現行文件對不上,照抄很容易越改越亂。
能力一多,最容易發生的就是選錯端點、白白耗掉額度,所以每一種功能的用途與計費方式,比參數表本身更值得先弄清楚。
Firecrawl 是什麼?
Firecrawl 是一個把網址轉成大型語言模型讀得動的內容的服務。它會替你處理 proxy、快取、rate limit 與需要 JavaScript 才會出現的內容,輸出乾淨的 Markdown、HTML、結構化 JSON、截圖與頁面裡的連結,並附上標題、描述、Open Graph、狀態碼這類 metadata。除了網頁,它也能處理網址上的 PDF 與 DOCX。
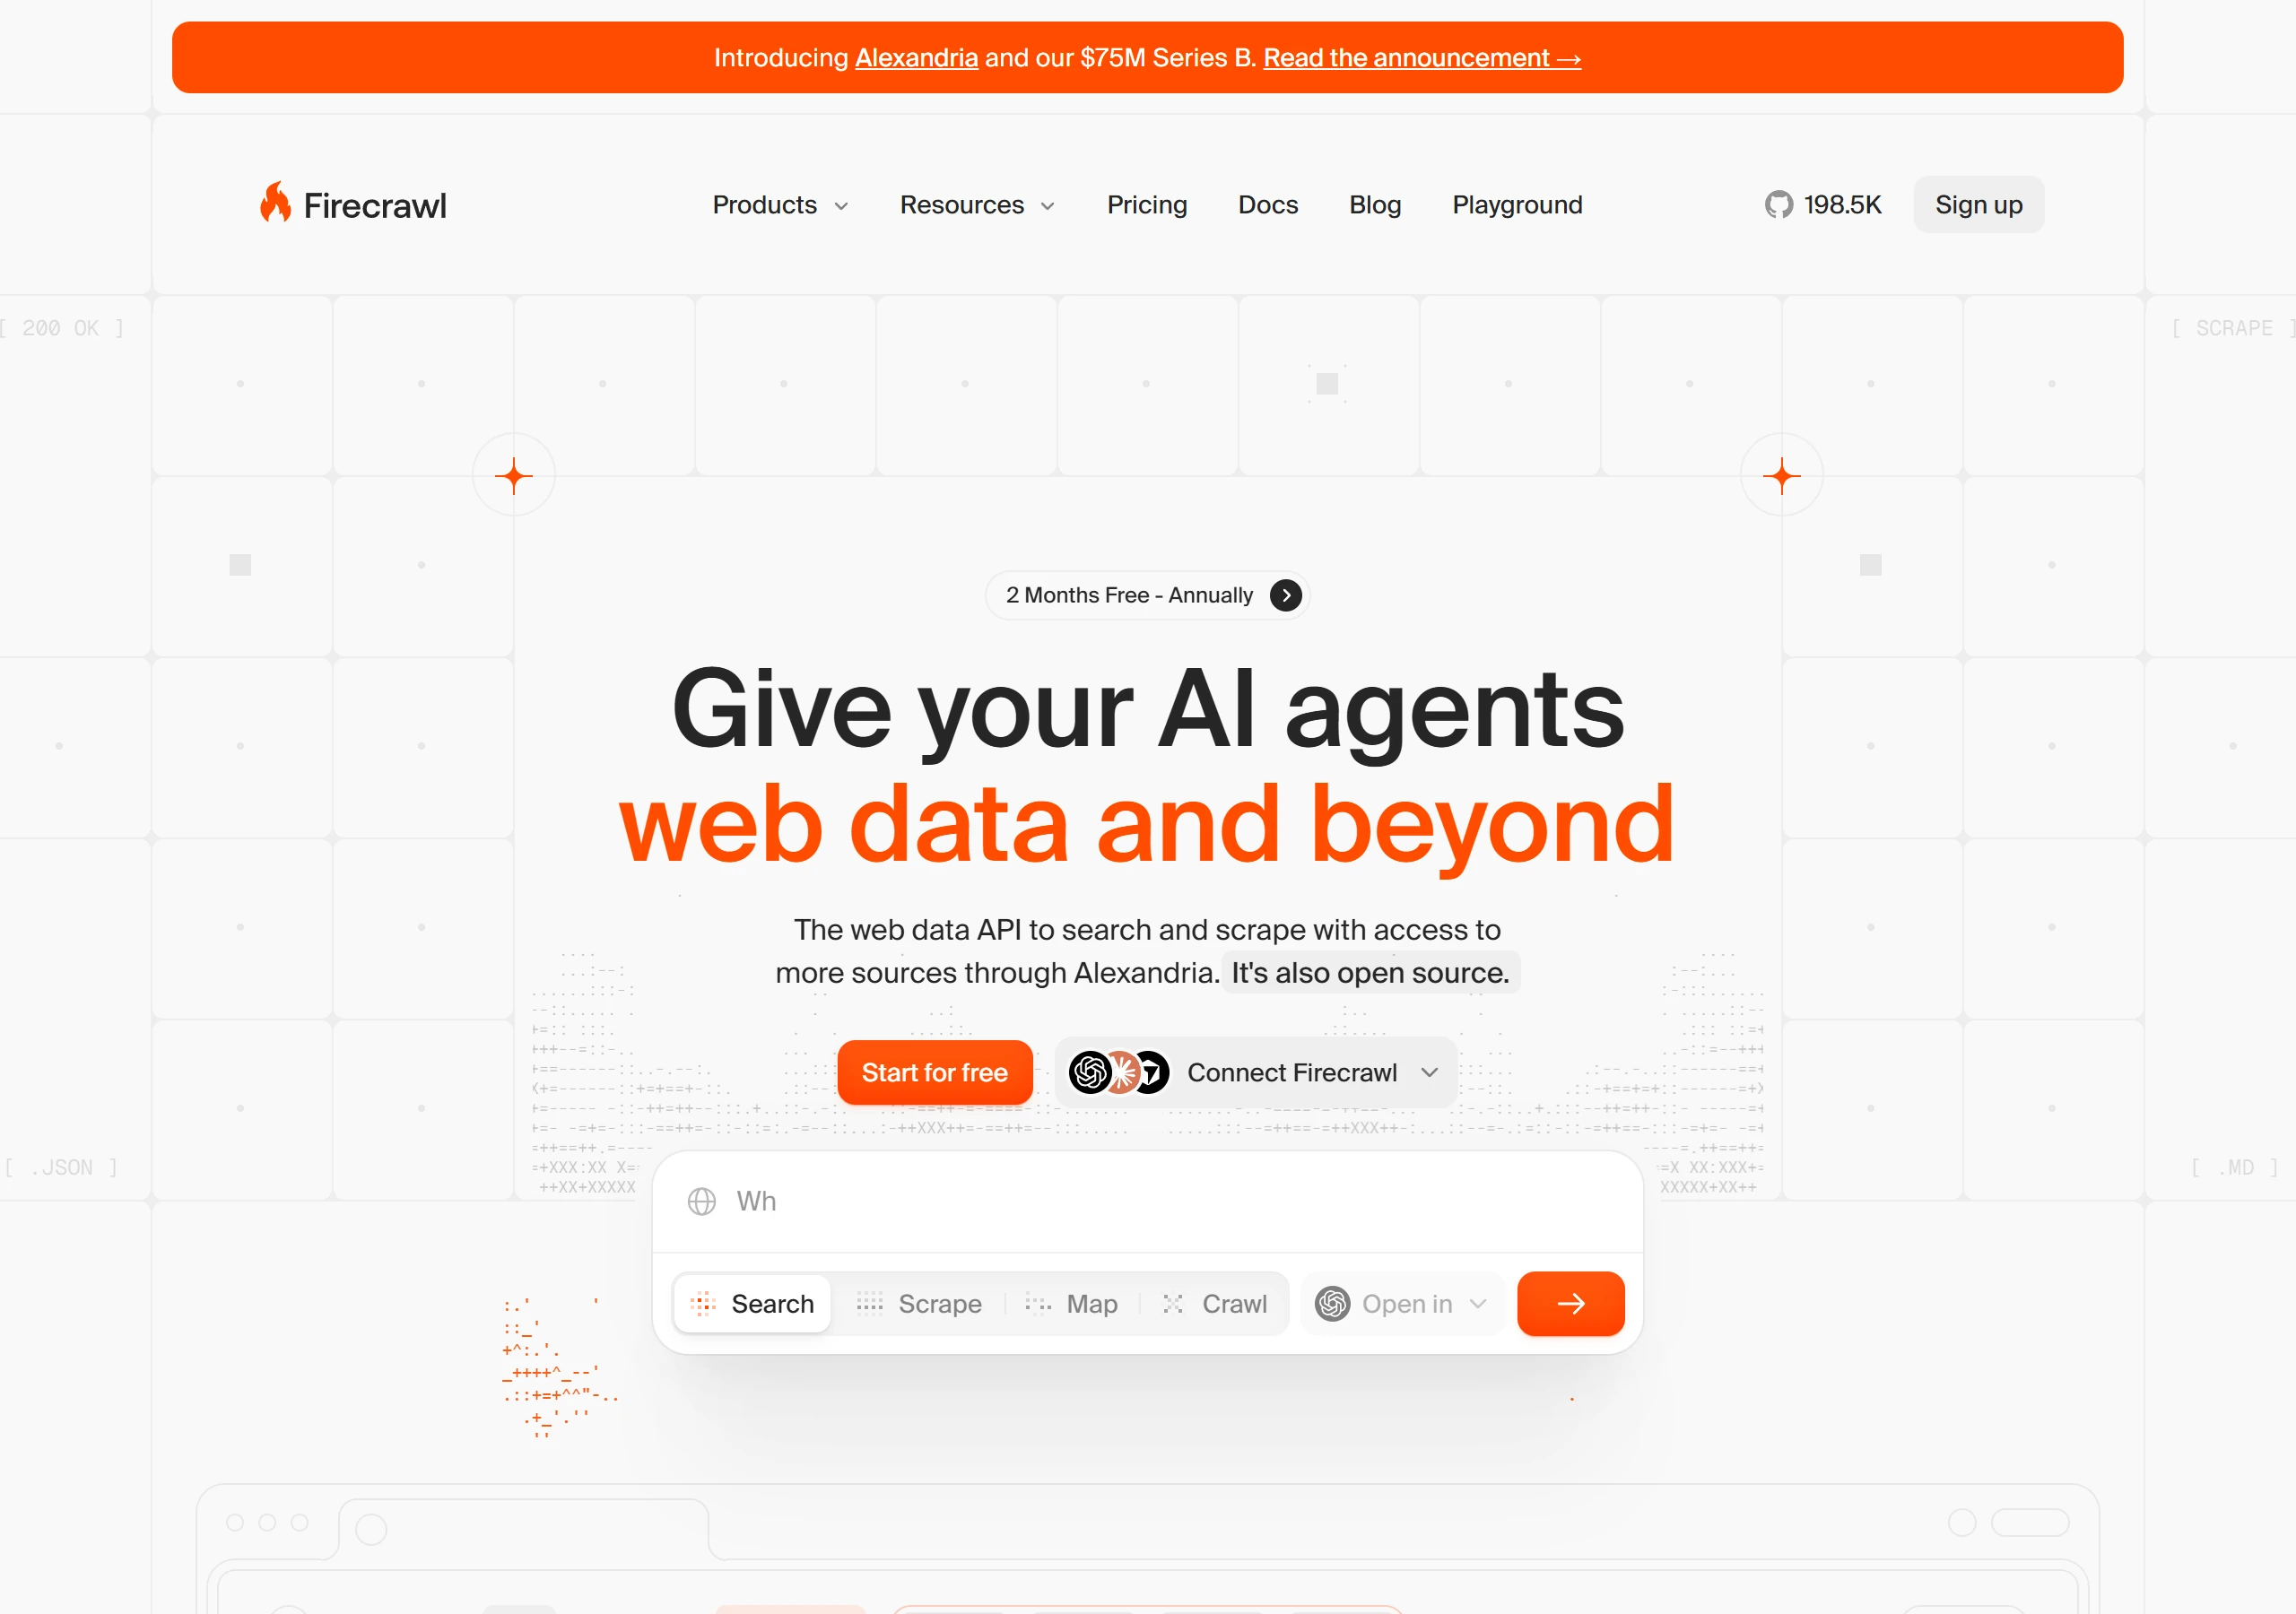
頁面裡的導覽列、廣告、腳本與樣式會佔掉模型的上下文額度,也會稀釋重點。Markdown 保留了標題、段落、清單與表格的結構,又沒有那些雜訊,交給模型時省額度,也比較不容易讀歪。
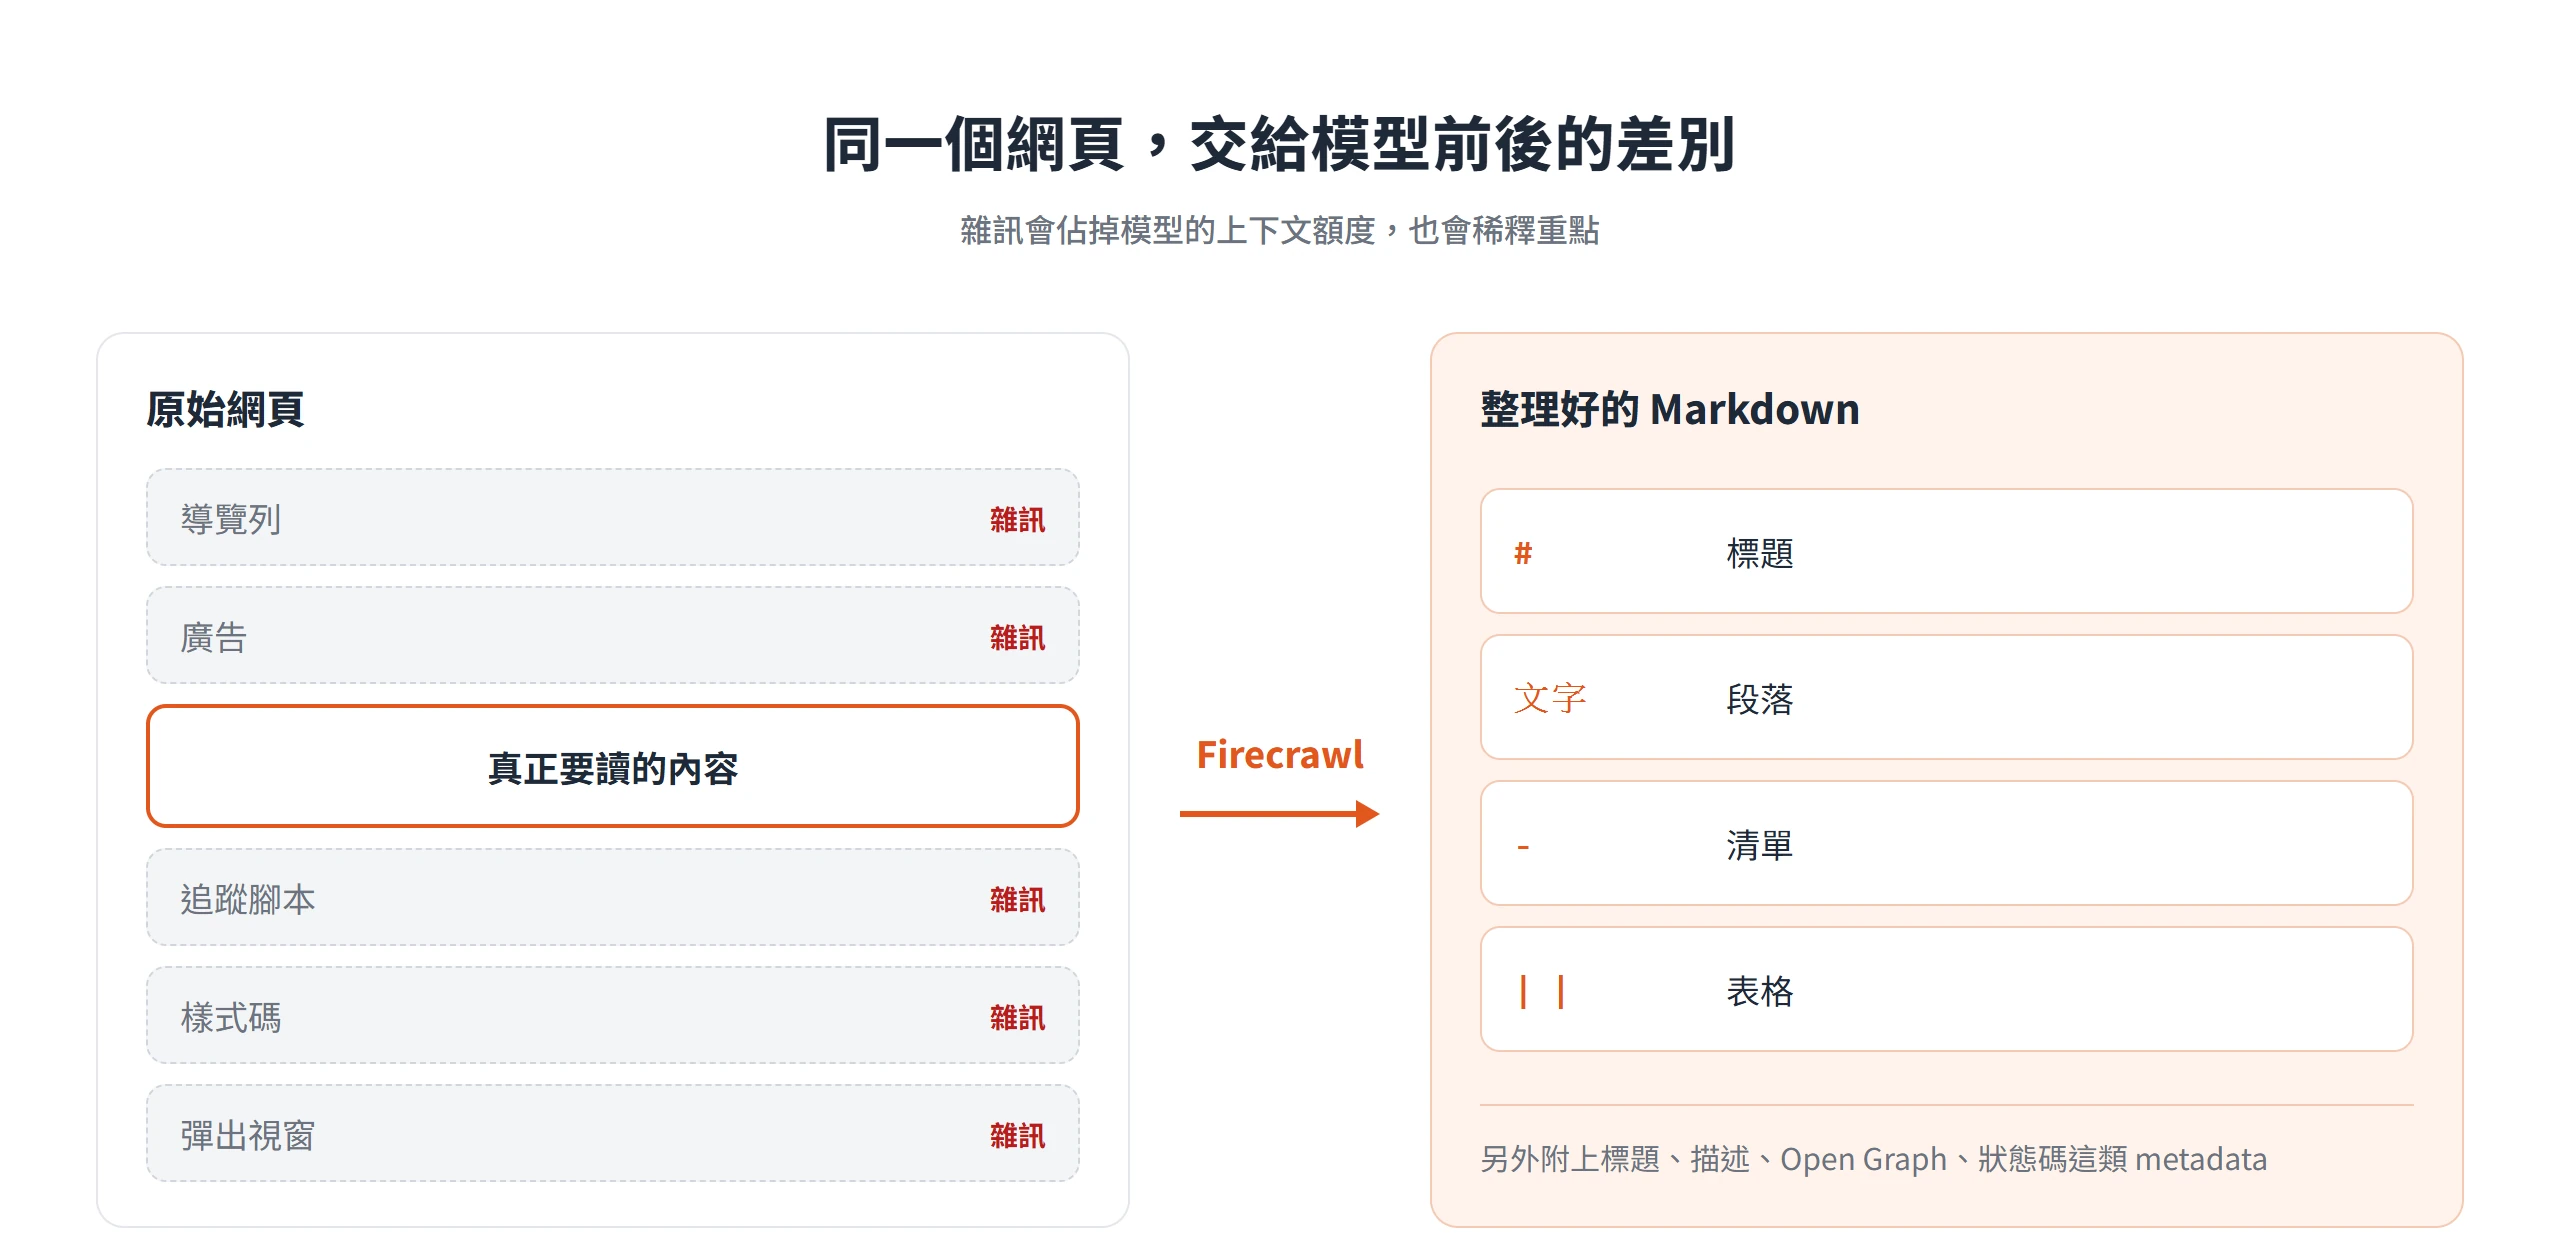
現行版本的主要能力可以分成八項:
- Search:用關鍵字搜尋,並把每筆結果的全文一併帶回來。
- Scrape:把單一網址轉成 Markdown、JSON 或其他格式,是最基礎的一項。
- Crawl:從起始網址出發,遞迴抓取整個網站或某個區塊。
- Map:只列出網站有哪些網址,不抓內容。
- Interact:接續已抓取的頁面,做點擊、填表與擷取動態內容。
- Agent:用自然語言描述想要的資料,由它自己搜尋、瀏覽並整理。
- Parse:把本機的 PDF、Word、Excel 等檔案轉成 Markdown 或結構化資料。
- Monitor:定期檢查網頁有沒有變動。
Firecrawl 同時有雲端託管版與開源版本,原始碼放在 GitHub,兩者的功能並不相同。
安裝 Python SDK 並完成第一次 scrape
最短的路徑只有三步,分別是安裝套件、設定金鑰、呼叫一次 scrape。示範網址用 example.com,它是專門給文件與測試用的網站;後面部分程式碼沿用 Firecrawl 文件的網址,只是示範寫法。
先安裝套件。現行的套件名是 firecrawl,類別是 Firecrawl,方法叫 scrape:
pip install firecrawlCode language: Bash (bash)搜到的舊文章若寫 FirecrawlApp 或 scrape_url,那是前一代留下的名稱,不要照抄。firecrawl-py 則是另一回事,這個套件名目前仍與 firecrawl 同步發布,Firecrawl 的 LlamaIndex 整合頁也還在用它,不過 Python SDK 頁寫的安裝指令是 firecrawl。金鑰以 fc- 開頭,可以設成環境變數 FIRECRAWL_API_KEY,或直接傳給 Firecrawl 類別,下面用傳入的寫法:
from firecrawl import Firecrawl

firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")

doc = firecrawl.scrape("https://example.com", formats=["markdown", "html"])
print(doc)Code language: Python (python)
要用 curl 或其他語言直接打 REST API 也行,端點是 POST /v2/scrape,請求內容只要放網址與想要的格式:
curl -X POST https://api.firecrawl.dev/v2/scrape \
  -H "Authorization: Bearer fc-YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://example.com", "formats": ["markdown", "html"]}'Code language: Bash (bash)
回應的結構大致如下,內容為示意。SDK 會直接回傳 data 這一層,所以用 Python 時,doc 裡看到的是 markdown、html 與 metadata:
{
  "success": true,
  "data": {
    "markdown": "...",
    "html": "...",
    "metadata": {
      "title": "Example Domain",
      "sourceURL": "https://example.com",
      "statusCode": 200,
      "contentType": "text/html"
    }
  }
}Code language: JSON / JSON with Comments (json)
請求失敗時,SDK 會丟出帶有描述的例外,建議用 try 與 except 包住呼叫。
不帶 API 金鑰也能呼叫,但受 IP 限流
Firecrawl 文件寫明,部分請求不需要帳號或 API 金鑰就能使用,只是限流較低。以 Python SDK 來說,建立 Firecrawl 物件時可以不傳金鑰,此時 scrape、search 與 interact 仍可呼叫,依呼叫端的 IP 限流;其他方法一律需要金鑰。
這個設計適合先看看輸出長什麼樣子,再決定要不要到 Firecrawl 網站建立帳號取得金鑰。
API 回應裡的兩層狀態碼要分開看
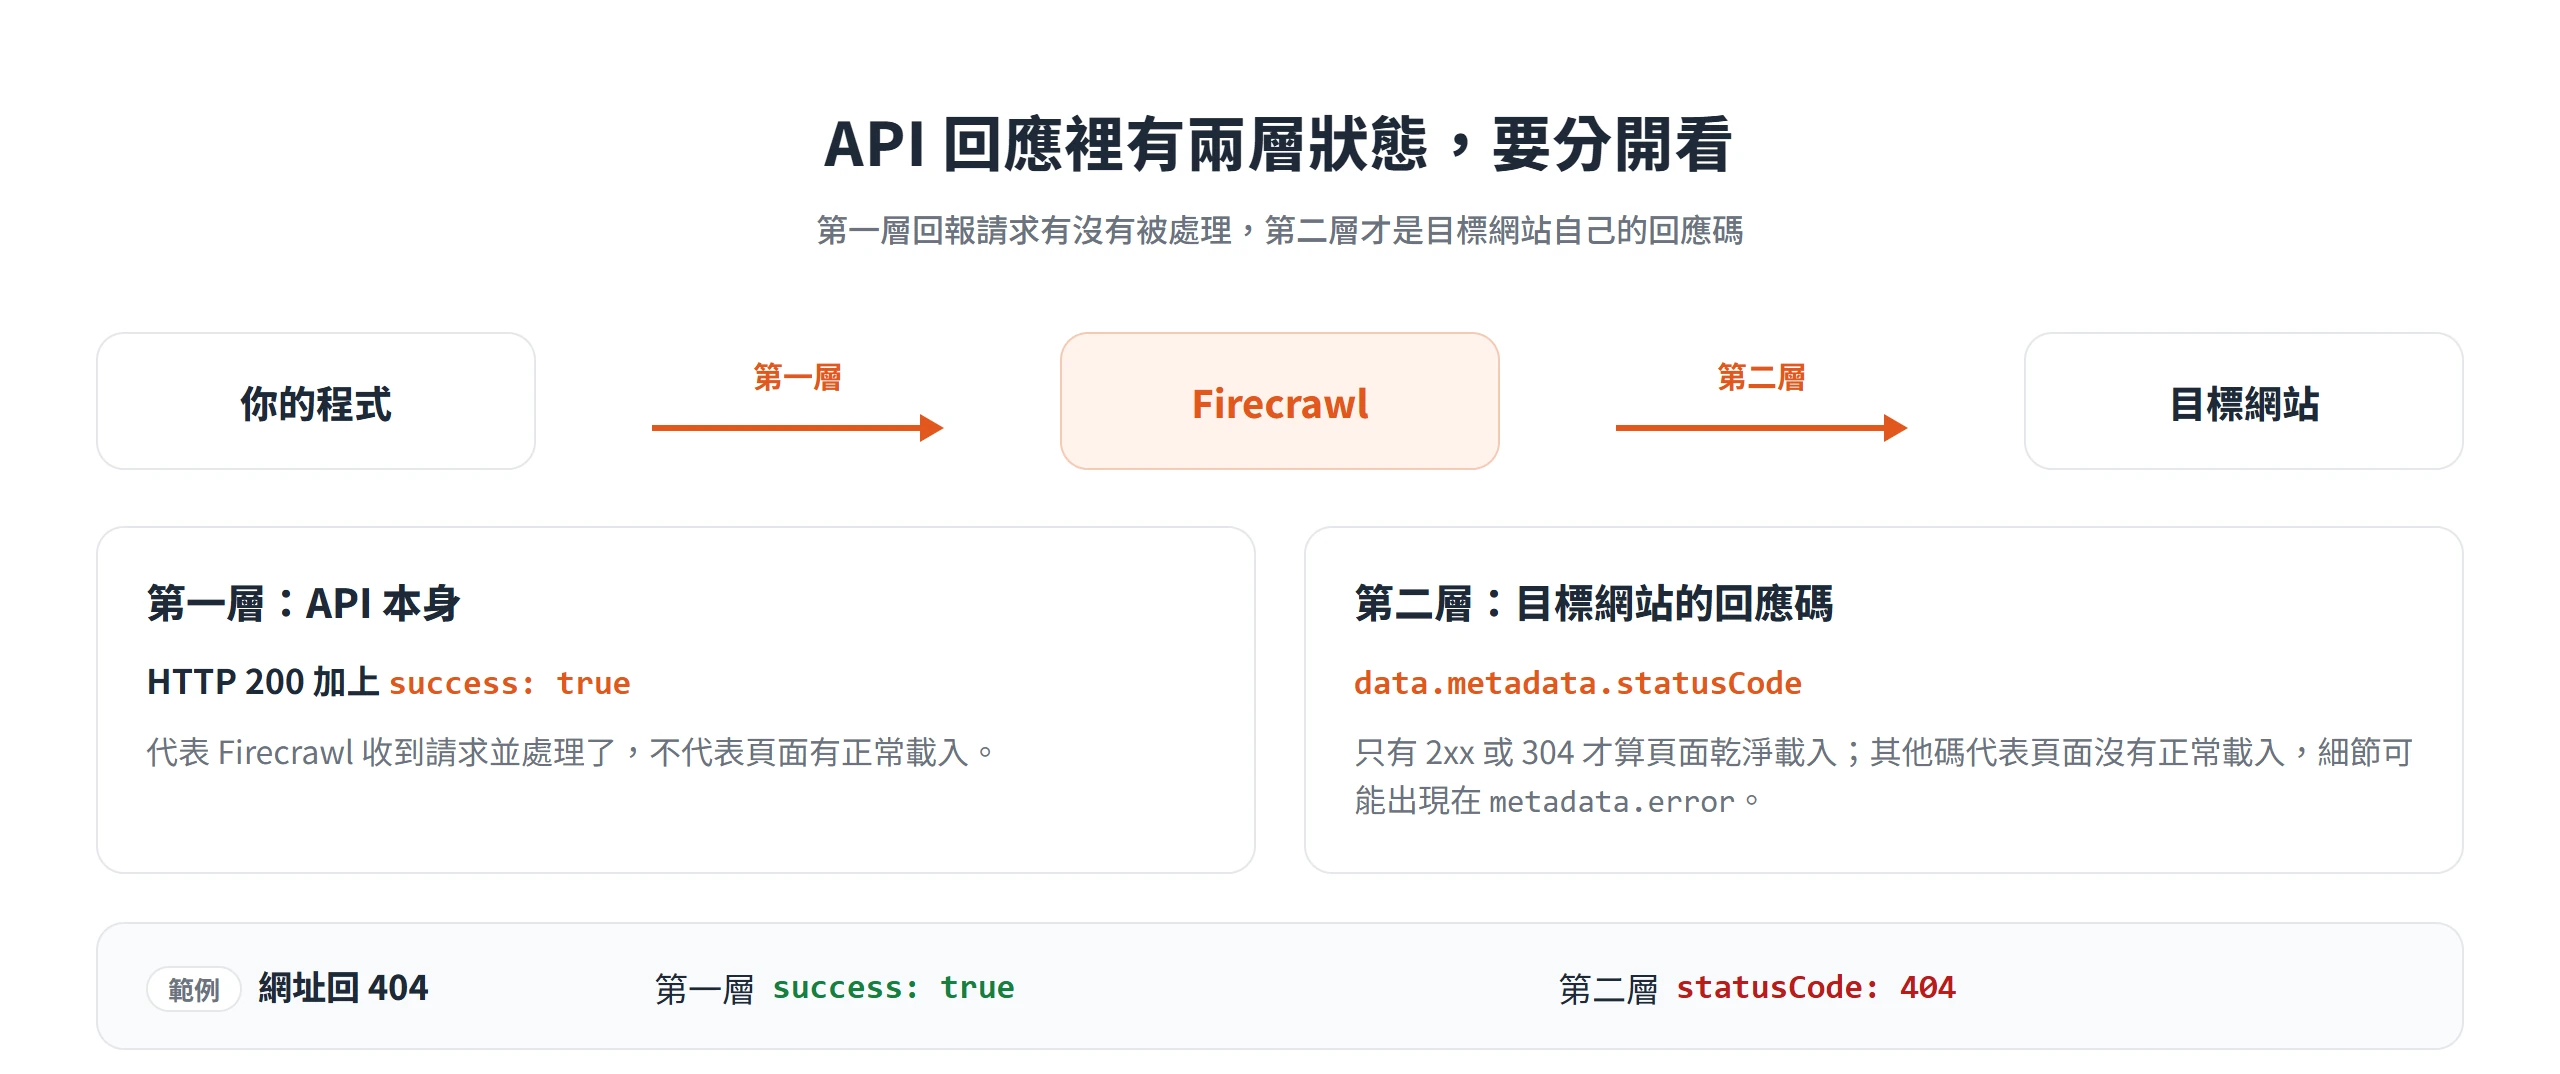
新手最容易踩的地方,是把 success: true 當成目標網站回了 200。回應其實有兩層狀態。第一層在 API 本身,HTTP 200 加上 success: true,代表 Firecrawl 收到請求並處理了;第二層在 data.metadata.statusCode,那是目標網站自己的回應碼,只有 2xx 或 304 才算頁面乾淨載入,其他碼代表頁面沒有正常載入,細節可能會出現在 metadata.error。
所以對一個會回 403 或 404 的網址,API 層照樣回報成功,頁面層才看得到問題。寫程式時,建議把 statusCode 的檢查放進流程,不要只判斷 success。
scrape 把單一網址轉成可交給模型的內容
scrape 是最常用的功能,也是其他功能的基礎,crawl 對每一頁走的就是同一條 scrape 流程。它適合已經知道要抓哪一個網址的情境;不知道網址、或要抓整個網站,才輪到後面的 search、map 與 crawl。
Markdown、HTML、截圖與 links 等輸出格式
formats 陣列決定這次請求要哪些輸出,可以同時放好幾個,部分格式會另外加收 credits。常用的格式整理如下:
| 格式 | 內容 | 適合的用途 |
|---|---|---|
markdown | 整理過的 Markdown | 直接交給模型閱讀 |
html | 清理過的 HTML | 需要保留標籤結構 |
rawHtml | 完全未改動的 HTML | 自己解析屬性或標籤 |
screenshot | 頁面截圖,可設 fullPage、quality、viewport | 留存畫面或檢查版面 |
links | 頁面裡的連結 | 找出站內其他頁面 |
json | 依 schema 擷取的欄位 | 只要固定幾個欄位 |
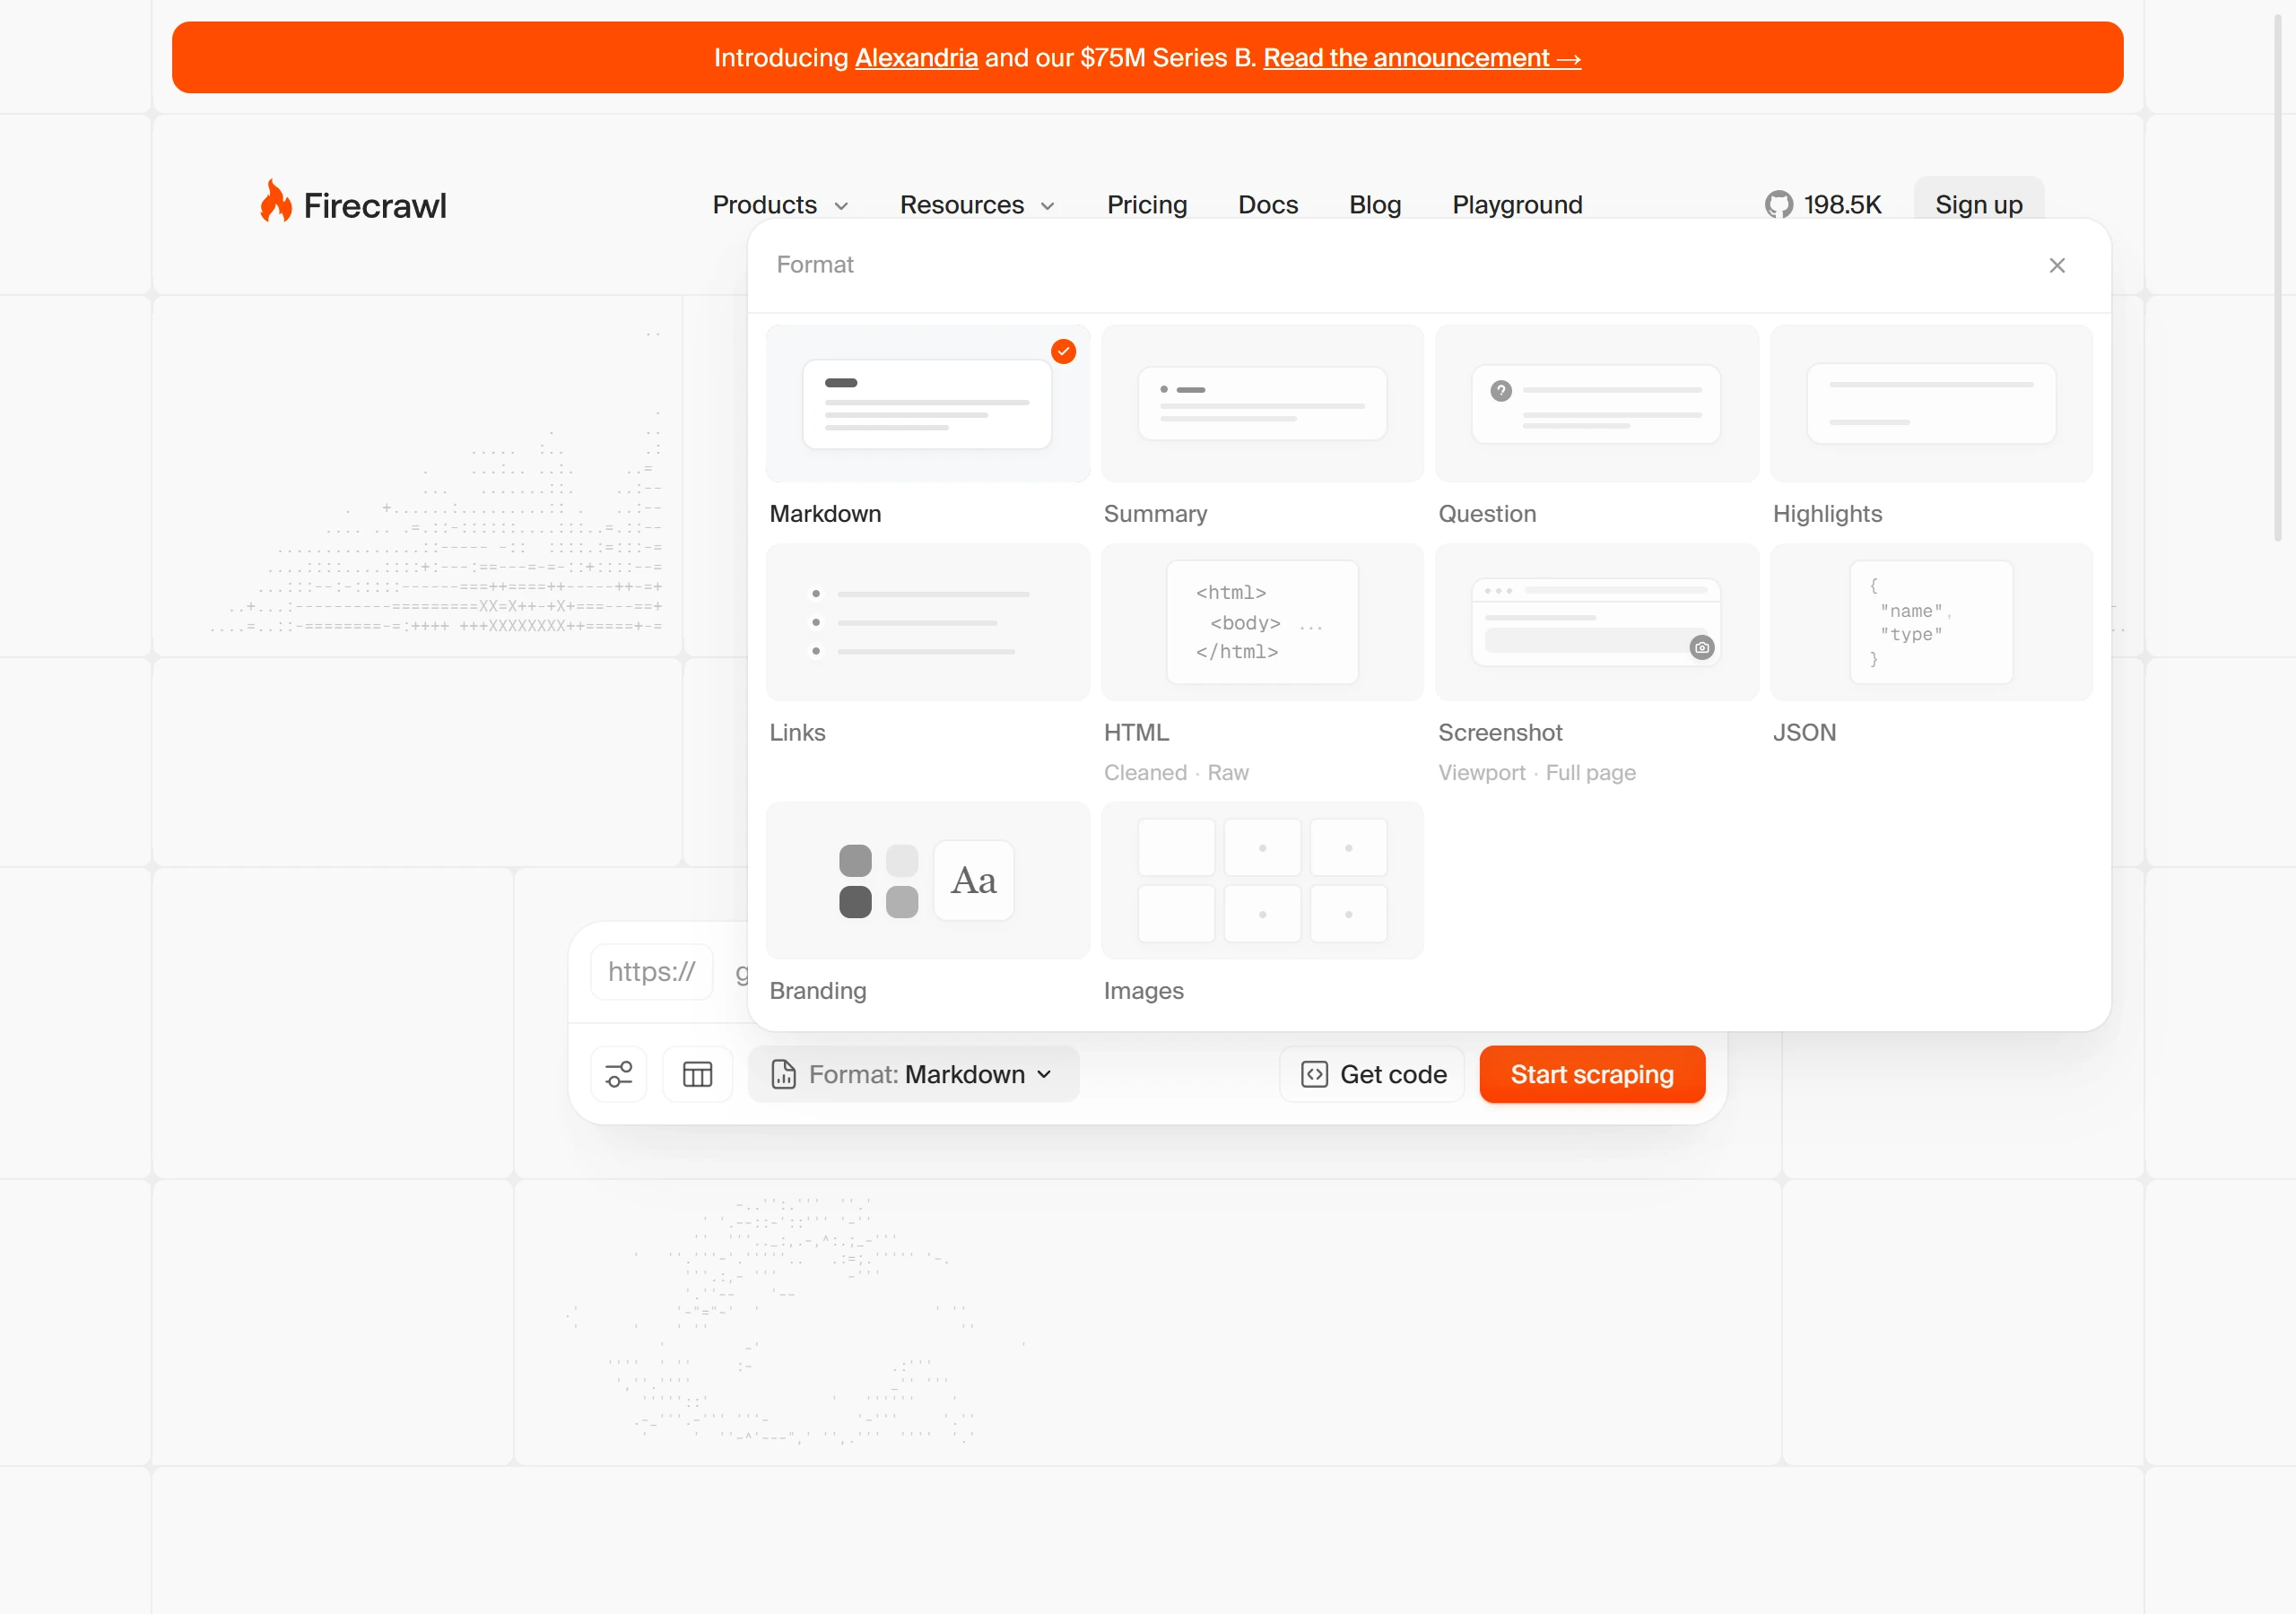
截圖網址只保留 24 小時,需要留存的話要自己下載。比較少用的格式裡,product 能從頁面上的結構化資料取出商品資訊,不用 LLM 也不用寫 schema;audio 與 video 可以從 YouTube 這類支援的網站取得音訊或影片;question、highlights 與 query 則可以直接對頁面提問或取回相關段落。
scrape 預設只留主要內容並快取 2 天,動態頁面另加等待或動作
onlyMainContent 預設就是 true,在產生 Markdown 之前,先用決定式的 HTML 過濾把導覽列、頁尾這類非主要內容去掉,過程不使用 LLM。想精準控制時,用 includeTags 與 excludeTags 指定要保留或排除的標籤;不想過濾的話,把它設成 false 就能拿到整頁。
有些頁面的內容要等載入完成、或先點一下才會出現。Firecrawl 本身有智慧等待,若還不夠,可以用 waitFor 額外加毫秒數。更進一步,actions 可以在擷取前依序執行寫入、按鍵、點擊、等待與截圖等動作。步驟一多,或需要根據畫面判斷下一步,就該改用後面的 Interact。
maxAge 預設是 172800000 毫秒,也就是 2 天,意思是 2 天內抓過的頁面可能直接回傳快取內容;設成 0 就略過快取,每次重抓。
用 JSON 格式與 schema 取出固定欄位
當需要的不是整頁文字,而是固定幾個欄位,例如公司簡介、是否開源、有沒有支援單一登入,就用 json 格式搭配 schema 與可選的 prompt。v2 的寫法是把 schema 放進 formats 裡的物件,Python 常用 Pydantic 的 model_json_schema() 產生,Node 則用 Zod;擷取結果放在 data.json。
from firecrawl import Firecrawl
from pydantic import BaseModel

class CompanyInfo(BaseModel):
    company_mission: str
    supports_sso: bool
    is_open_source: bool
    is_in_yc: bool

firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")

result = firecrawl.scrape(
    "https://firecrawl.dev",
    formats=[{
        "type": "json",
        "schema": CompanyInfo.model_json_schema(),
    }],
    only_main_content=False,
    timeout=120000,
)
print(result)Code language: Python (python)
這個格式一次只處理一個網址,要處理多個網址、依網址規則或自己探索頁面,得改用 Agent;舊的 /extract 端點已經被取代。擷取是在轉好的 Markdown 上進行,HTML 屬性已經被去掉。欄位太多時結果會比較不穩定,文件建議超過 30 個欄位就拆成 2 到 3 次請求,每次 10 到 15 個。
另一個常見的誤會是 minItems 與 maxItems。把 minItems 設成 20,並不會讓模型多找出項目,反而可能讓它編造內容,要控制完整度,請在 prompt 裡說明。
抓取多個頁面時,依情境選用 map、crawl 或 batch scrape
要抓的往往不只一頁,這時可以先分清楚手上的情境。只想知道網站有哪些網址,用 map;要整個網站或某個區塊的內容,用 crawl;已經有一份明確的網址清單,用 batch scrape。選對端點,才不會一上來就整站爬、白耗額度。
map 只列出網站已知的網址,不抓頁面內容
map 回傳的是網站的網址清單,不抓頁面內容,所以速度很快。它的來源主要是網站的 sitemap,輔以搜尋引擎結果與先前爬過的快取資料,因此偏重已知的頁面,可能漏掉部分連結。需要更完整、更即時的覆蓋時,改用 crawl;若只想要單一頁面裡的連結,用 scrape 的 links 格式。
from firecrawl import Firecrawl

firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")

res = firecrawl.map(url="https://firecrawl.dev", limit=50, sitemap="include")
print(res)Code language: Python (python)
search 很實用,它會依關鍵字篩選,並把最相關的網址排在前面,適合在 crawl 之前先看一眼範圍。map 的費用不隨 limit 增加,拿它先探路,成本很低。
crawl 以 limit、路徑規則與深度圈出範圍
crawl 從起始網址出發,找出連結與 sitemap 裡的子頁並逐頁抓取,scrapeOptions 會套用到每一頁。重點是怎麼圈出範圍,才不會抓得太多:
from firecrawl import Firecrawl

firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")

job = firecrawl.crawl(
    url="https://example.com/docs/",
    limit=100,
    max_discovery_depth=2,
    include_paths=["docs/.*"],
    exclude_paths=["blog/.*"],
    scrape_options={"formats": ["markdown"], "only_main_content": True},
)
print(job.status, job.completed, job.total)Code language: Python (python)
limit 預設是 10000,意思是最多抓 10,000 頁,頁面是邊處理邊計費。額度不足時 crawl 可能回 402,但 Firecrawl 文件各頁對啟動前額度檢查的細節寫法不一,別把它當成保險,額度有限時,自己把 limit 設成想抓的頁數最穩當。
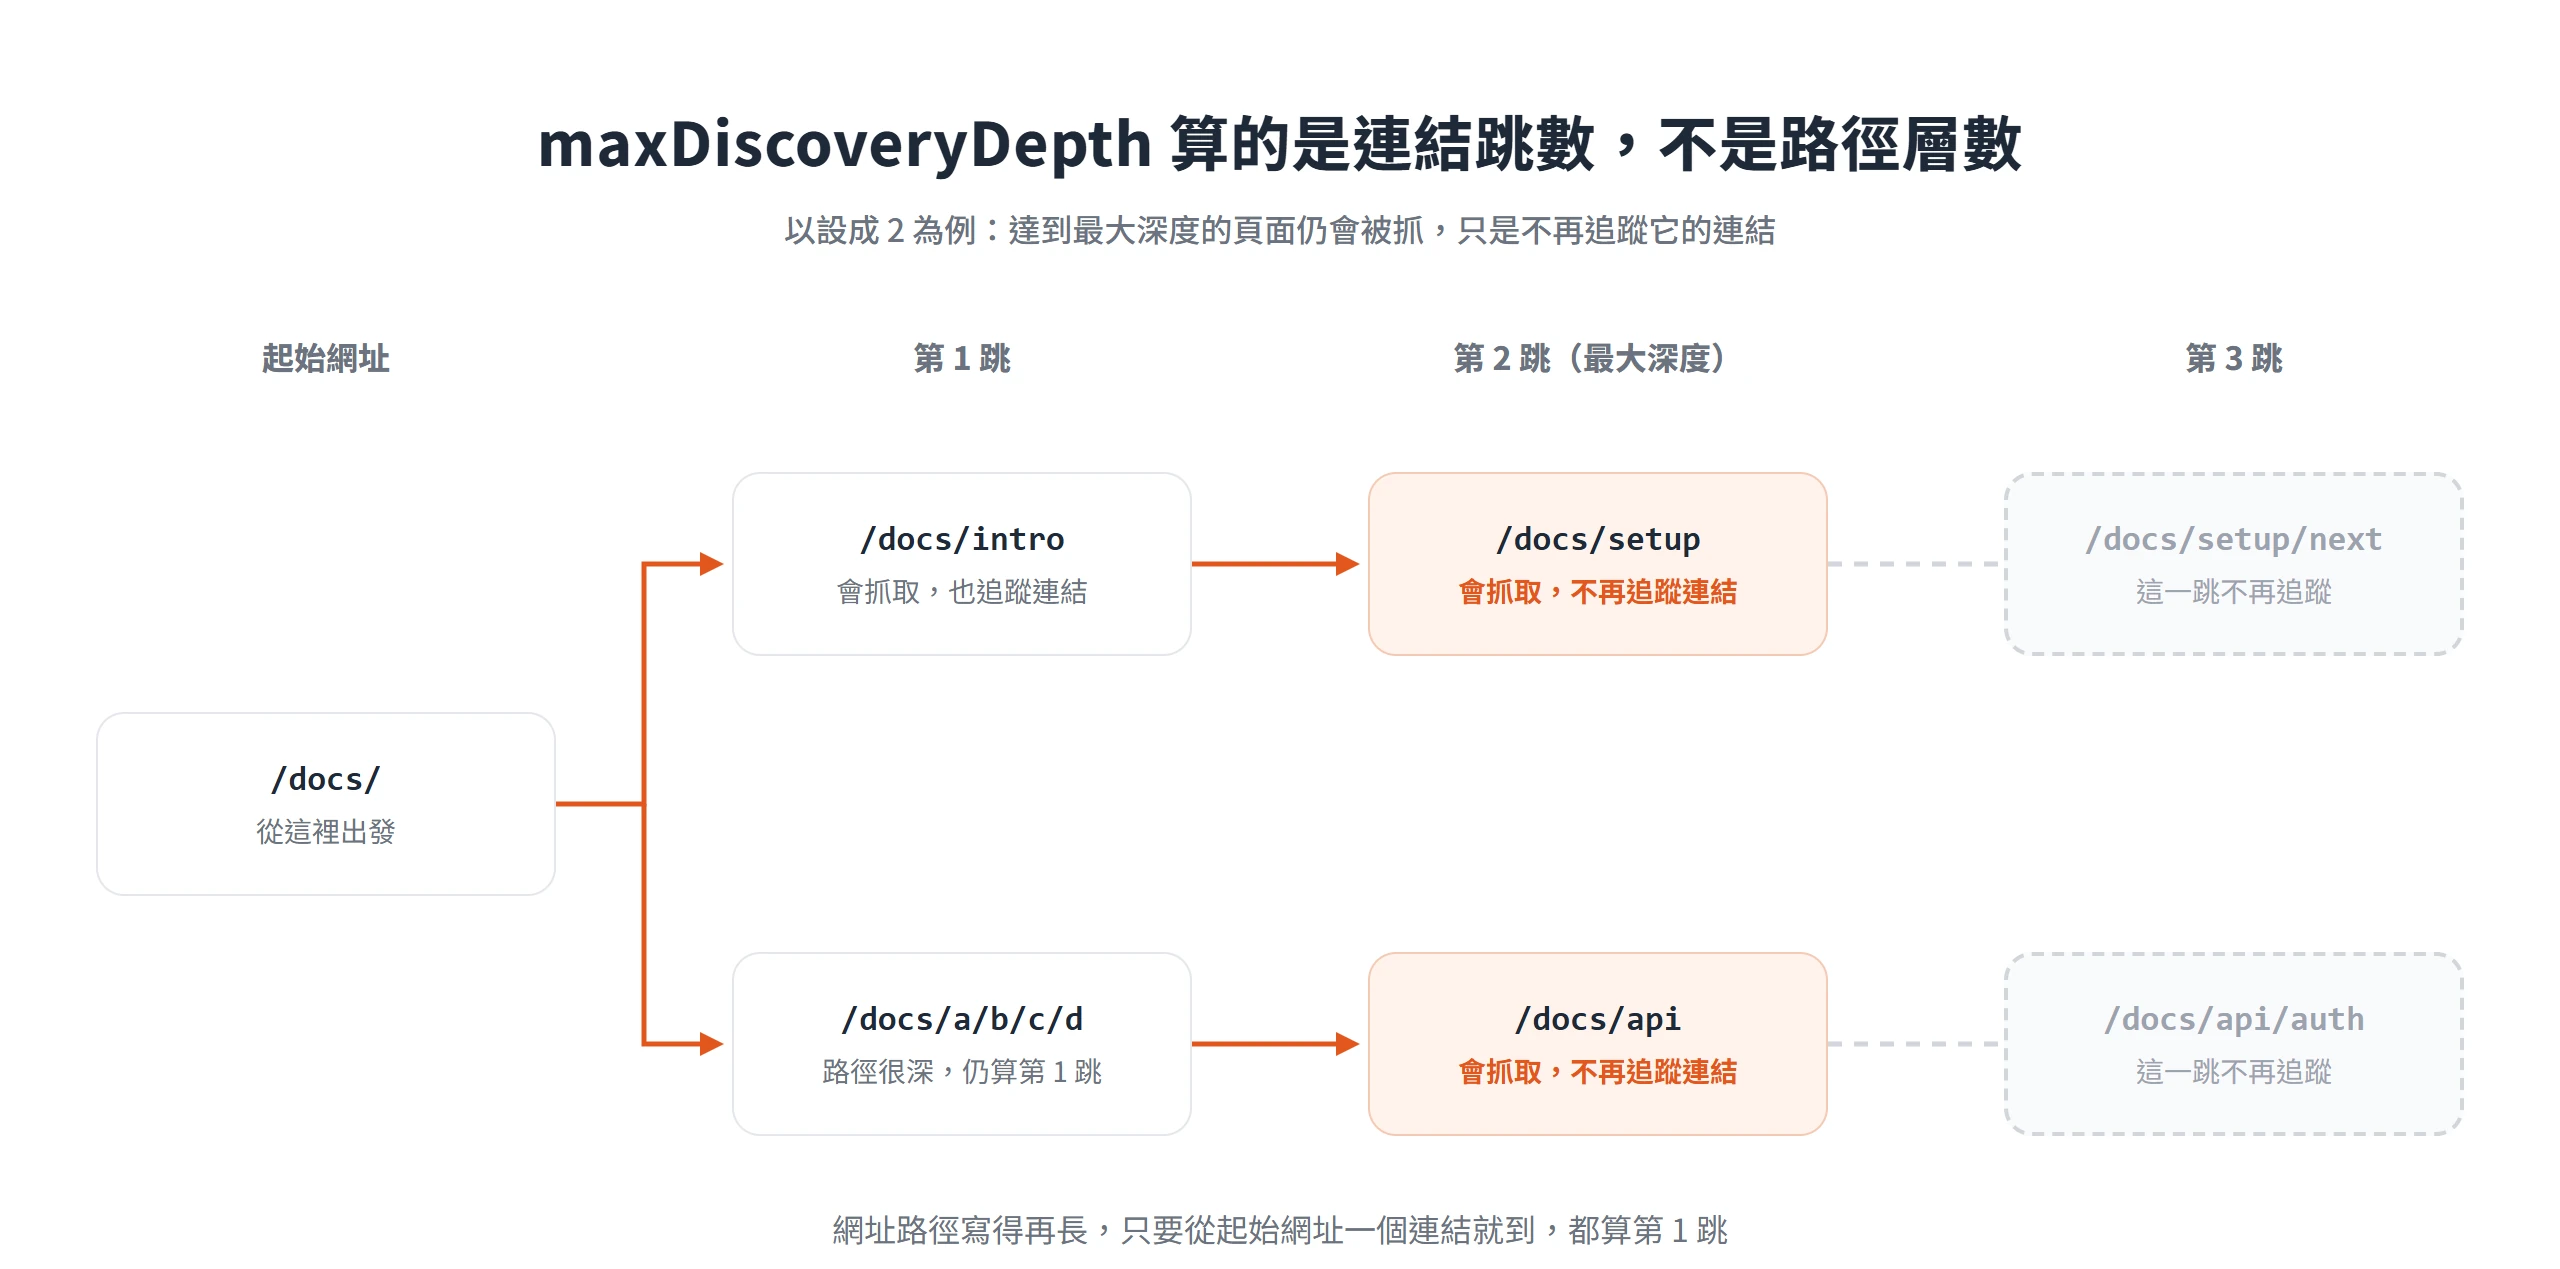
maxDiscoveryDepth 限制的是連結探索的跳數,不是網址路徑的層數,達到最大深度的頁面仍然會被抓,只是不再追蹤它的連結。includePaths 與 excludePaths 是 RE2 風格的正規表示式,比對的是網址的 pathname,無效的規則會回 400。預設只走起始網址底下的子路徑,不跟隨子網域與外部連結,要放寬才設 crawlEntireDomain、allowSubdomains 或 allowExternalLinks。其餘控制節奏與 sitemap 的參數,可以查 Firecrawl 的 Crawl 文件。
crawl 非同步執行,完成後仍要檢查失敗頁面
送出 crawl 之後,API 會回傳一個工作 id。Python SDK 的 crawl() 會等到工作完成,並自動處理分頁;想立即返回,改用 start_crawl(),再用 get_crawl_status() 查詢進度。結果在 API 上保留 24 小時。
工作完成不代表每一頁都成功。completed 等於 total 時,仍要用 GET /v2/crawl/{id}/errors 檢查,它會回傳 errors 與 robotsBlocked 兩個陣列,前者列出抓取失敗的頁面,後者列出被網站 robots.txt 擋下的網址。另外,因為頁面是併發抓取,每次執行的結果可能略有差異,想讓結果穩定一點,可以把 sitemap 設成 only,只用 sitemap。
想即時掌握進度,可以用 SDK 的 WebSocket watcher,或設定 webhook。webhook 請求都帶 X-Firecrawl-Signature 簽章標頭,收到之後要先驗證,沒驗證通過就不要處理。
batch scrape 適合已經有網址清單的情況
batch scrape 可以想成「給定明確網址清單版的 crawl」,它不探索連結,只抓你給的網址。典型的串法是先用 map 或 search 挑出要抓的網址,再把清單交給 batch scrape。同步的 batch_scrape() 會等到全部完成;非同步的 start_batch_scrape() 立刻回傳工作 ID,之後用 get_batch_scrape_status() 查詢,結果同樣在 API 上保留 24 小時。
from firecrawl import Firecrawl

firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")

start = firecrawl.start_batch_scrape(
    [
        "https://example.com/page-1",
        "https://example.com/page-2",
    ],
    formats=["markdown"],
)
status = firecrawl.get_batch_scrape_status(start.id)
print(status.status, status.completed, status.total)Code language: Python (python)
batch scrape 在計價表上沒有獨立項目,可以比照 scrape,以每頁約 1 credit 估算,隨頁面完成逐步扣除。
search 依關鍵字搜尋,可一併取回各頁全文
手上只有問題、沒有網址時,用 search。和一般搜尋 API 只回網址與摘要不同,Firecrawl 的 search 把「搜尋」與「取回內容」併成一次呼叫,每筆結果可以直接帶著全文回來。文件也提醒,需要有根據的完整答案時,別只靠搜尋摘要,應該進到 scrape 取得全文。
limit 對每一種來源各自計算,設成 5 並同時搜尋 web 與 news,最多會拿到 10 筆。sources 可選 web(預設)、news 與 images。scrapeOptions 可以放任何 scrape 選項,例如 formats: ["markdown", "links"],讓每筆結果帶回全文。
categories 可以限定結果的性質,例如 research(學術類網站)、pdf、developer 與 gov(政府出版品)。Firecrawl 文件註明,research 類別只是把網頁搜尋限定在 arxiv.org、nature.com、PubMed 這類學術網站,回傳的仍是一般網頁,放在 data.web;要搜尋論文本身,得改用 Research Index 的 GET /search/research/papers,它涵蓋 PubMed、bioRxiv、medRxiv 與 arXiv 的論文摘要。時間與網域等其餘篩選參數,可以查 Firecrawl 的 Search 文件。
回應依來源分成 web、images 與 news,Python 的呼叫很簡短:
from firecrawl import Firecrawl

firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")

results = firecrawl.search("firecrawl", limit=3)
for item in results.web or []:
    print(item.title, item.url)Code language: Python (python)
費用是每 10 筆結果 2 credits,不足 10 筆時進位計算;若加上 scrapeOptions 取回全文,則另外依 scrape 的費用計算。
互動操作與自動蒐集交給 interact 和 agent
當資料藏在需要點擊、輸入才出現的頁面,或根本不知道該去哪個網址找,scrape 就不夠用了。依 Firecrawl 文件的建議推導,能用單次 scrape 解決的,先用 scrape;要在已知頁面上點一點、填一填,用 interact;連網址都不知道、需要自己導覽蒐集,才輪到 agent。後兩者都比 scrape 貴,也更不可預期。
interact 接續 scrape 的頁面操作,用完要停止 session
流程分三步。先用 POST /v2/scrape 抓取頁面,從 data.metadata.scrapeId 取得識別碼;再對 POST /v2/scrape/{scrapeId}/interact 下指令;結束後用 DELETE 同一路徑停止 session。指令可以是白話的 prompt,也可以是 Node(預設,搭配 Playwright)、Python 或 Bash 程式碼。
from firecrawl import Firecrawl

firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")

result = firecrawl.scrape("https://example.com", formats=["markdown"])
scrape_id = result.metadata.scrape_id

firecrawl.interact(scrape_id, prompt="Click the More information link")

firecrawl.stop_interaction(scrape_id)Code language: Python (python)
寫 prompt 時,一次只給一個清楚的任務,多步驟的操作就連續呼叫,session 的狀態會延續。
session 預設 TTL 是 10 分鐘,閒置 5 分鐘也會到期,文件特別強調用完一定要停止,避免不必要的計費。費用依 session 長度,以秒計算、最低 1 分鐘,只跑程式碼的 session 每瀏覽器分鐘 2 credits,用到白話 prompt 的 session 每瀏覽器分鐘 7 credits,另外 scrape 本身再計 1 credit。
agent 在不知道網址時自行搜尋,並依 schema 整理
agent 可以說是「資料版的 deep research」,它接受一段自然語言的描述,可以附上起始網址與 schema,然後自己搜尋、瀏覽、蒐集,最後依 schema 整理。如果已知單一網址,用 scrape 的 JSON 格式更便宜,也是同步回傳。
prompt 是必填,其他常用的參數有三個:urls 讓它聚焦在指定頁面,schema 定義要回傳的欄位,maxCredits 是這次任務最多可以花的 credits,預設 2,500。model 現行一律是 spark-2,舊的 Spark 1 名稱已淘汰,並導向 spark-2。
from firecrawl import Firecrawl
from pydantic import BaseModel
from typing import List, Optional

firecrawl = Firecrawl(api_key="fc-YOUR_API_KEY")

class Founder(BaseModel):
    name: str
    role: Optional[str] = None

class FoundersSchema(BaseModel):
    founders: List[Founder]

result = firecrawl.agent(
    prompt="Find the founders of Firecrawl",
    urls=["https://firecrawl.dev"],
    schema=FoundersSchema,
    model="spark-2",
    max_credits=100,
)

if result.status == "completed":
    print(result.data)
elif result.stop_reason == "credit_limit_reached":
    print(result.partial)Code language: Python (python)
agent() 會等到結果,start_agent 則回傳工作 ID,讓你輪詢或接 webhook。如果任務達到 maxCredits,工作會以失敗收尾,stopReason 是 credit_limit_reached,不會回傳完整的 data,不過可能附有部分結果,使用前需要檢查。一次執行約回傳 150 到 200 列資料,更大的任務要自己拆開。
計價是依實際工作量計算,每位使用者每日有 5 次免費執行,多數執行約消耗數百 credits,所以設 maxCredits 當保險很重要。
解析本機檔案與追蹤網頁變動
有兩個容易被漏掉、卻對「把資料餵給 AI」很實用的能力,一個是把手上的檔案轉成 Markdown,另一個是知道某個網頁有沒有變動。前者是 parse,後者靠 change tracking 與 monitor 兩層機制。
parse 把本機的 PDF、Word、Excel 轉成 Markdown
parse 的對象是只存在自己電腦或內部系統、沒有公開網址的檔案;已經放在網址上的 PDF 與 DOCX,scrape 會自動辨識,不需要用到它。Firecrawl 文件對 parse 的描述是把 PDF、Word、Excel、PowerPoint 等文件,轉成乾淨的 Markdown、逐頁內容、版面區塊與結構化 JSON,適合在把規格書、報告或內部文件交給模型之前先處理。
PDF 的逐頁內容與版面區塊能幫助後續程式判斷內容的位置,不會只拿到一大串連續文字。
change tracking 重抓時比對變動,monitor 依排程檢查
change tracking 是 scrape 的一種格式。在 formats 加上 changeTracking,同時也要有 markdown,同一個網址再抓一次,它會用 changeStatus 回報這頁是 new、same、changed 或 removed。模式有 git-diff、json 或兩者並用:git-diff 回傳類似程式碼比對的差異,json 則依指定欄位回傳前後的值。
比對的範圍限於自己的團隊,所以就算別人抓過,自己第一次抓取一定是 new;而且需要完全相同的網址、markdown 格式與 tag。includeTags、excludeTags 與 onlyMainContent 如果在兩次之間改過,比對就會失準。基本追蹤與 git-diff 模式不另外加費,json 模式每頁 5 credits。
monitor 則是排程化的版本,不必自己用定時器反覆呼叫 scrape。它有三種目標:指定的頁面、整站 crawl 與網路搜尋;排程可以用 cron,也可以用白話描述,例如「daily at 9am」,最短間隔是 5 分鐘。通知可以透過 webhook、Email 或 Slack,還能加上白話的目標描述,讓 AI 判斷這次變動是否有意義。
費用依目標而定,scrape 目標每個網址每次檢查 1 credit;crawl 目標每個發現的頁面每次檢查 1 credit;網路搜尋目標每 10 筆結果 2 credits。開啟 AI 判斷時,每個被判斷的變動頁面或搜尋結果再加 1 credit。
把 Firecrawl 接進 Claude 與其他 AI 工具的 3 種路徑
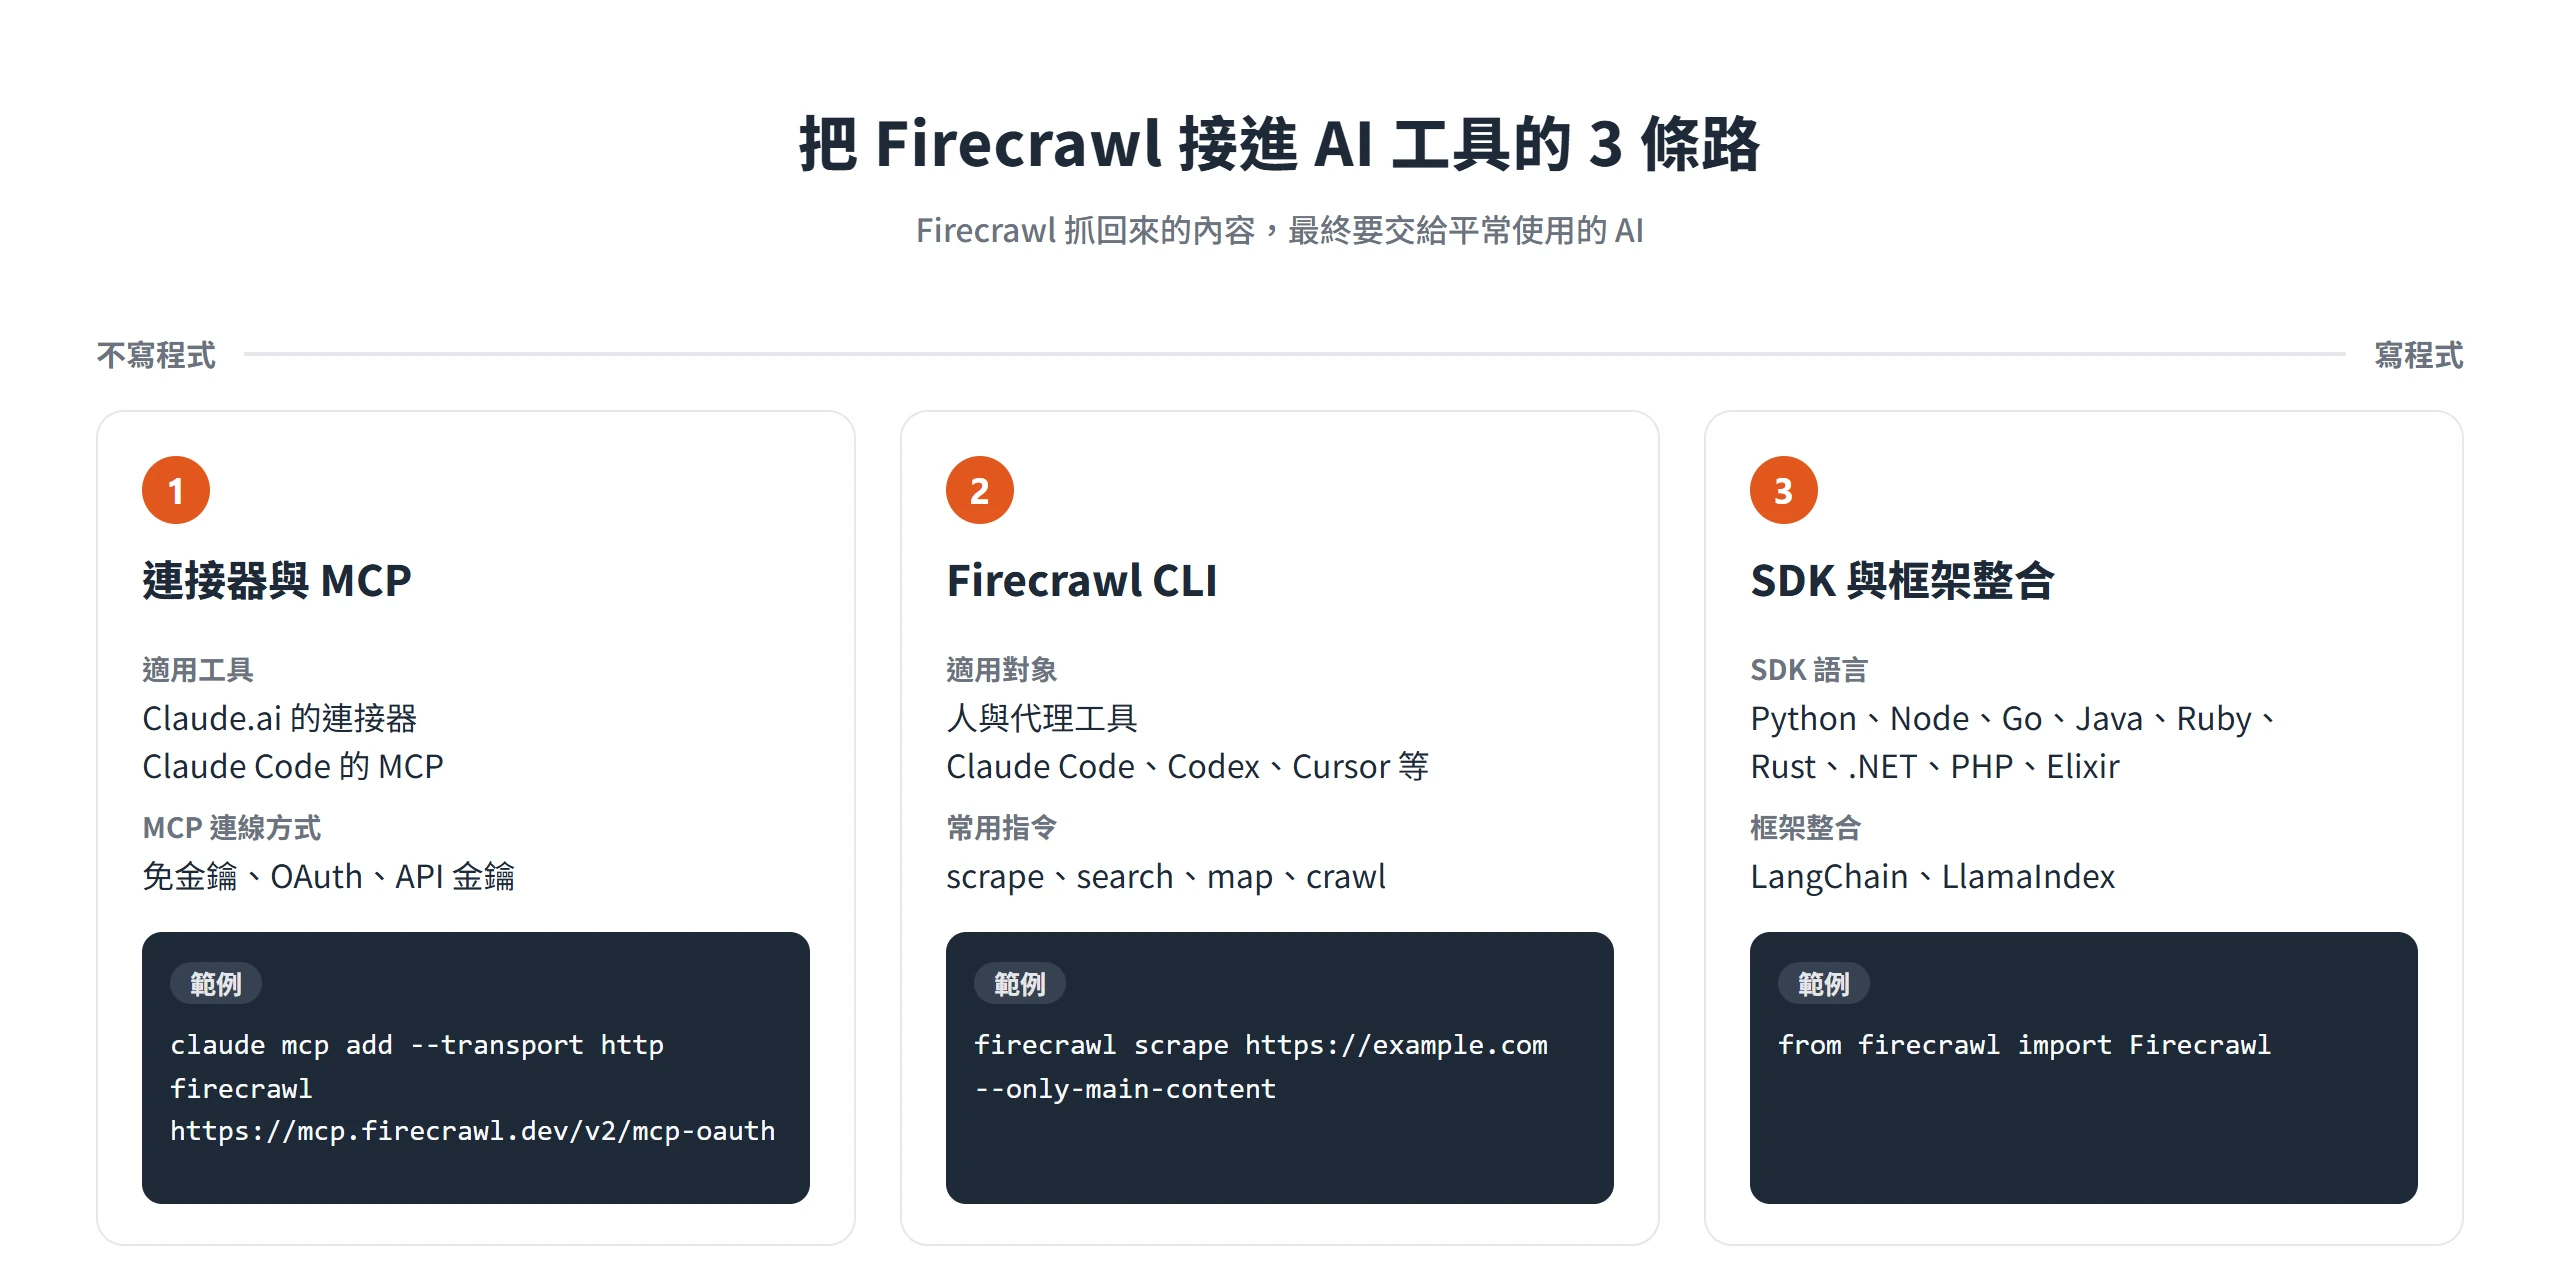
Firecrawl 抓回來的內容,最終要交給平常使用的 AI。依「不寫程式」到「寫程式」的順序,有三條路:Claude.ai 與 Claude Code 的連接器和 MCP、CLI,以及 SDK 與框架整合。
MCP 的 3 種連線方式與 Claude.ai、Claude Code 的設定
MCP 有三種連線方式。免金鑰版涵蓋 Search、Scrape 與 Parse,在每日額度內使用;OAuth 版透過瀏覽器登入帳號,不必在對話裡處理金鑰;API 金鑰版以 Bearer 方式帶金鑰,適合不需要人看管的情境,金鑰要用環境變數引用,不要放進對話。ChatGPT 與 Codex 另有原生連接器。
在 Claude.ai,到 Claude 的連接器目錄開啟 Firecrawl 連接器,連接帳號並授權,之後在新的對話中啟用 Firecrawl,就能請 Claude 搜尋或讀取網頁。在 Claude Code,則先在終端機加入 MCP 伺服器:
claude mcp add --transport http firecrawl https://mcp.firecrawl.dev/v2/mcp-oauthCode language: Bash (bash)加入之後,進入 Claude Code 輸入 /mcp,選擇 firecrawl,完成瀏覽器登入即可。連上之後,MCP 會提供 firecrawl_scrape、firecrawl_search、firecrawl_map、firecrawl_crawl、firecrawl_parse、firecrawl_agent、firecrawl_interact 這類工具,分別對應前面介紹的功能。
Firecrawl CLI 的 4 個常用指令,人與代理工具都能使用
CLI 同時是人用的命令列工具,也是 Claude Code、Codex、Cursor 等代理工具取用 Firecrawl 的載體。安裝有兩種,一行指令為偵測到的代理工具引導設定,或是用 npm 全域安裝。安裝技能之後要重啟代理工具,它才找得到新技能。
npx -y firecrawl-cli@latest init --all --browser
npm install -g firecrawl-cliCode language: Bash (bash)
最常用的四個指令,分別對應 scrape、search、map 與 crawl:
firecrawl scrape https://example.com --only-main-content
firecrawl search "web scraping tutorials" --limit 10
firecrawl map https://example.com --search "blog" -o urls.txt
firecrawl crawl https://example.com --limit 100 --max-depth 3 --waitCode language: Bash (bash)
只選一種格式時,CLI 直接印出原始內容;選多種格式,則印成 JSON;-o 把結果存成檔案。想把網頁存成 Markdown 或 HTML 檔,再手動餵給 AI,可以這樣下指令:
firecrawl scrape https://example.com --html -o page.htmlCode language: Bash (bash)search 加上 --scrape 與 --scrape-formats markdown,可以順便取回全文;firecrawl --status 能看目前的驗證狀態、併發與剩餘 credits。
Firecrawl SDK 與 LangChain、LlamaIndex 的框架整合
Firecrawl 提供的 SDK 涵蓋 Python、Node、Go、Java、Ruby、Rust、.NET、PHP 與 Elixir,方法與參數大致對應。Python 另有非同步的 AsyncFirecrawl,搭配 await 使用,適合需要同時處理多個請求的程式:
import asyncio
from firecrawl import AsyncFirecrawl

async def main():
    firecrawl = AsyncFirecrawl(api_key="fc-YOUR_API_KEY")
    doc = await firecrawl.scrape("https://example.com", formats=["markdown"])
    print(doc)

asyncio.run(main())Code language: Python (python)
框架整合方面,LangChain 可以把它當文件載入器或代理工具,LlamaIndex 則當文件讀取器使用。在 RAG(檢索增強生成)的流程裡,Firecrawl 負責的是最前面那一段,也就是用 map 或 crawl 取得網站的頁面,轉成乾淨的 Markdown,之後再交給切塊與向量庫處理。
Firecrawl 的 credits 計價規則與各方案額度
最怕的狀況,是不知不覺把額度用光。把計價拆成可預估的規則,就能用「頁數乘上單價」自己估算。以下價格與額度,依 Firecrawl 定價頁 2026 年 9 月 4 日生效的版本,單位是美元,實際內容以定價頁為準。
各項操作消耗的 credits
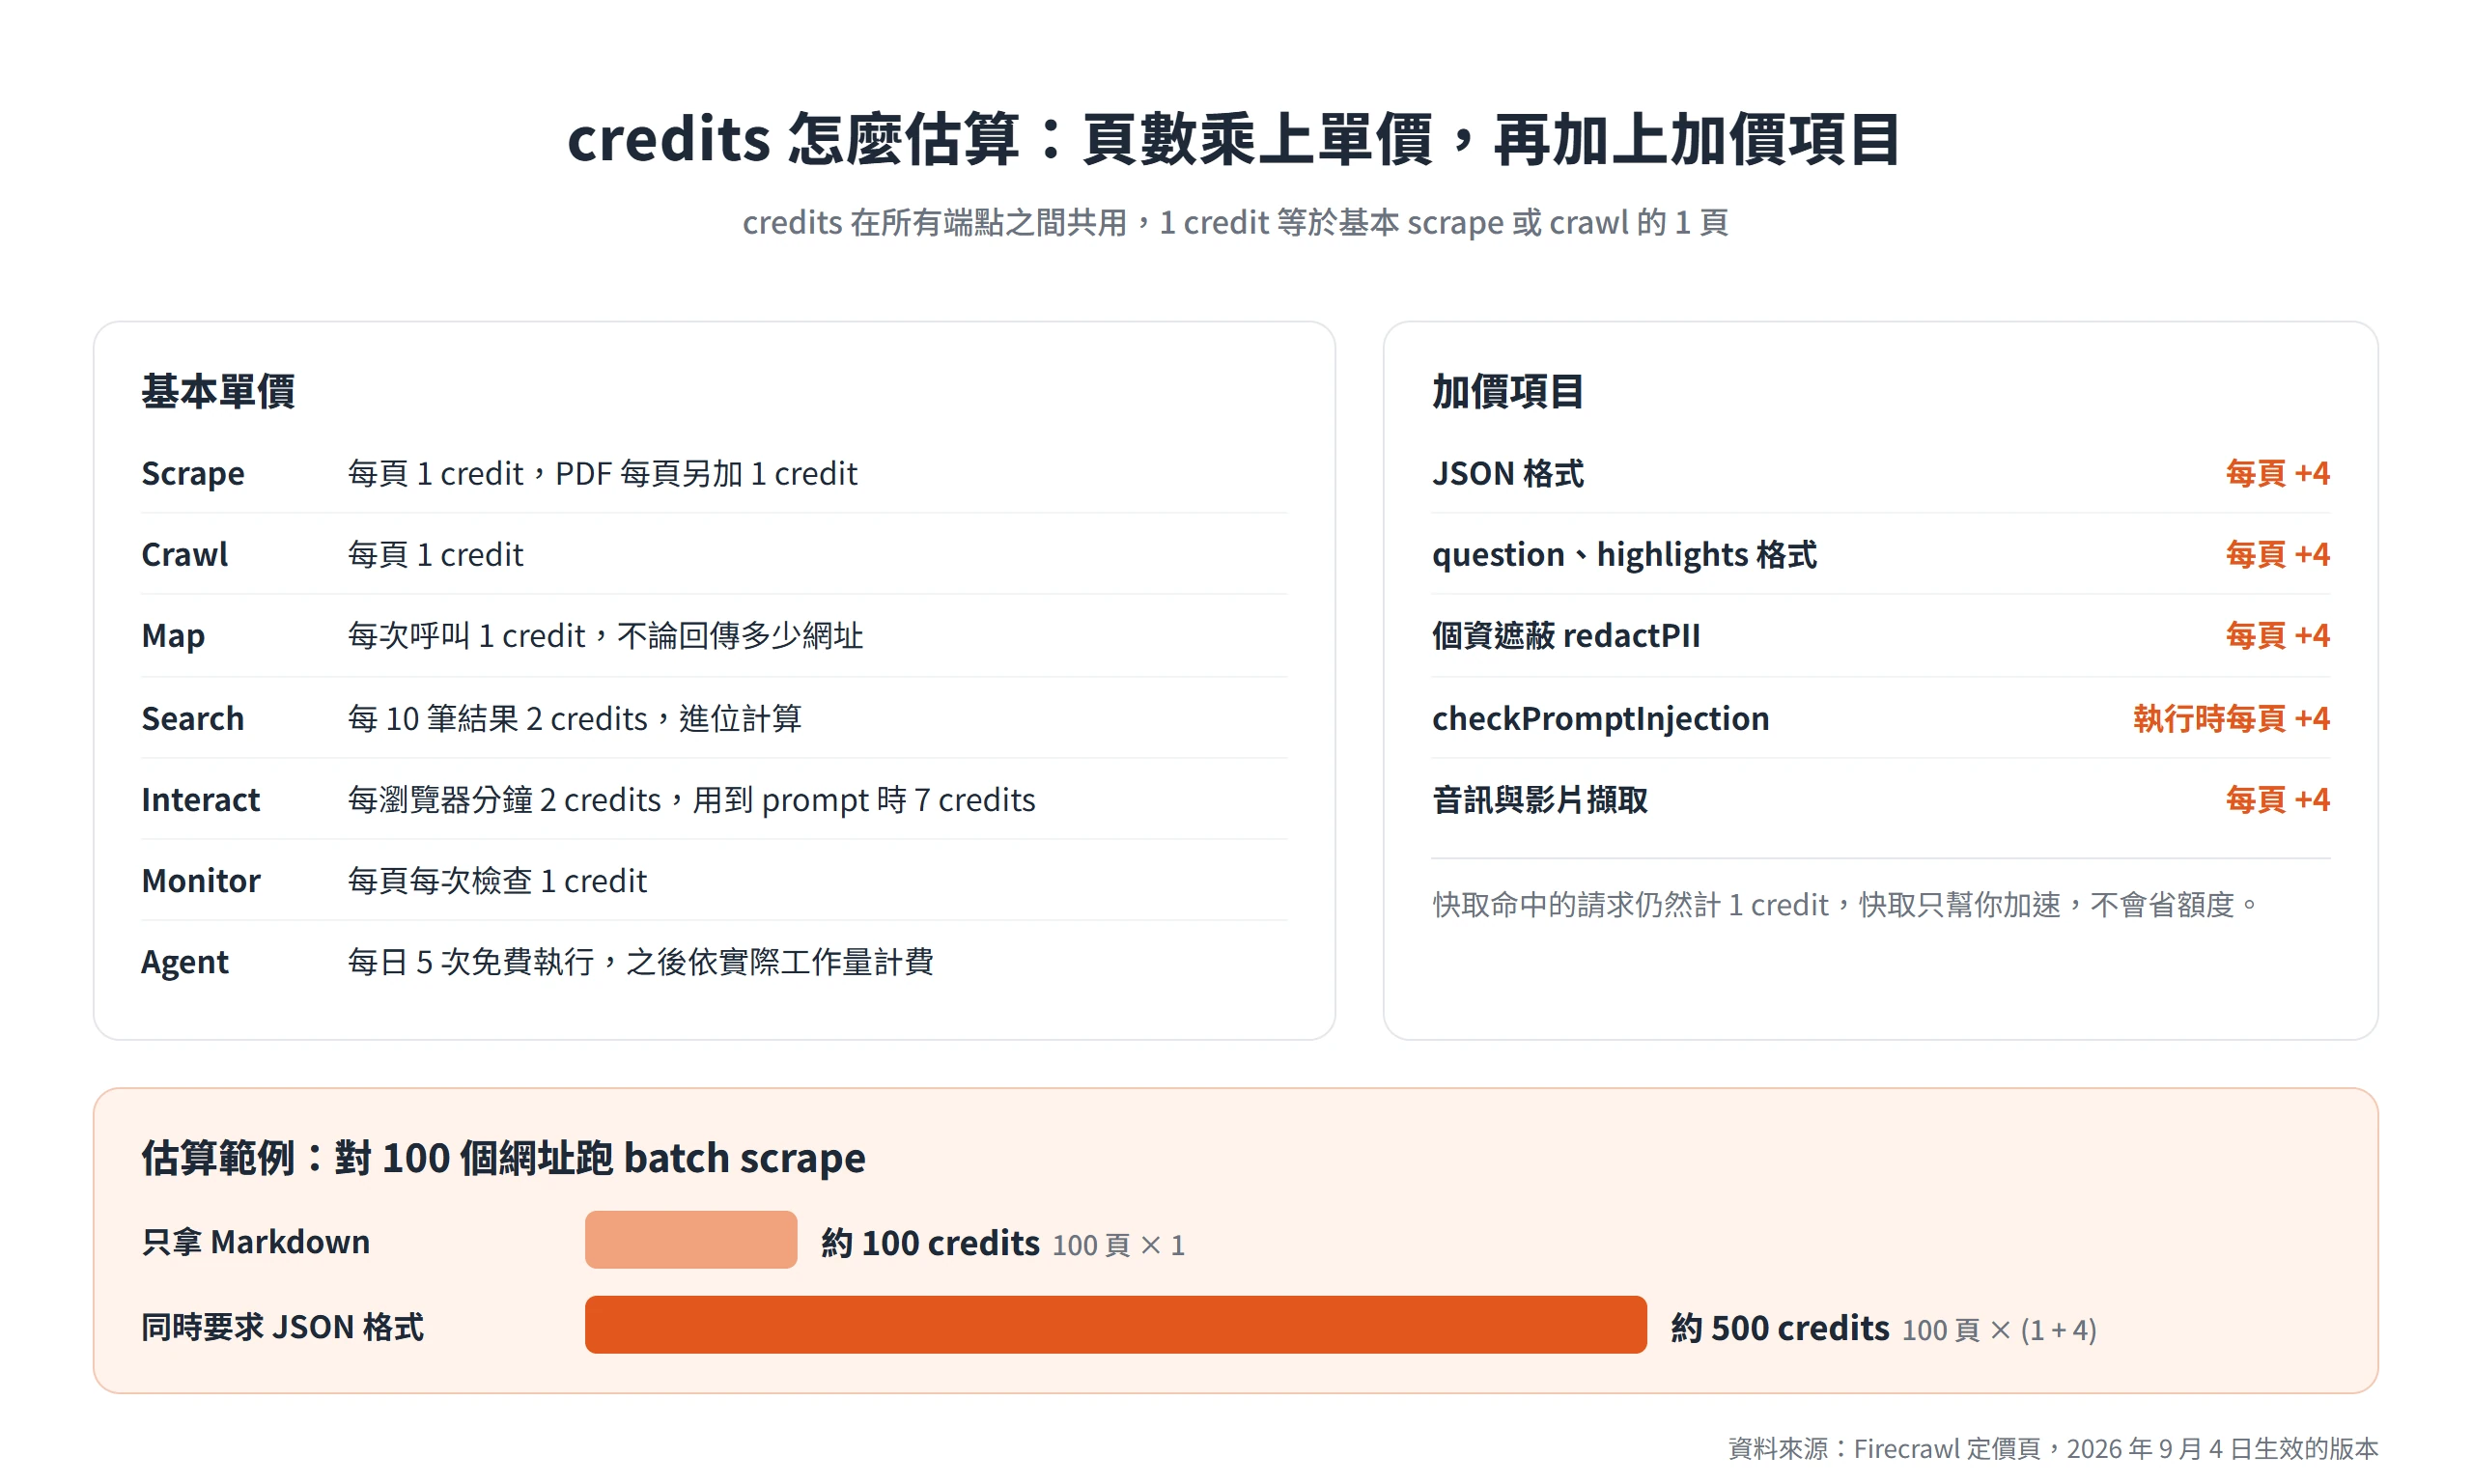
credits 在所有端點之間共用,基本單位是 1 credit 等於基本 scrape 或 crawl 的 1 頁,各項操作的單價如下:
| 操作 | 費用 |
|---|---|
| Scrape | 每頁 1 credit,PDF 每頁另加 1 credit |
| Crawl | 每頁 1 credit |
| Map | 每次呼叫 1 credit,不論回傳多少網址 |
| Search | 每 10 筆結果 2 credits,進位計算 |
| Interact | 每瀏覽器分鐘 2 credits,用到 prompt 時 7 credits |
| Monitor | 每頁每次檢查 1 credit |
| Agent | 每日 5 次免費執行,之後依實際工作量計費 |
除了基本單價,有幾項加價要留意。JSON 格式、question 與 highlights 格式,每頁都要多算 4 credits;個資遮蔽(redactPII)每頁 +4;checkPromptInjection 執行時每頁 +4,若檢查跑完後請求失敗,例如偵測到注入而被擋下,則計 5 credits;音訊與影片擷取每頁 +4。快取命中的請求,仍然計 1 credit,快取只幫你加速,不會省額度。
用一個簡單的例子估算,對 100 個網址跑 batch scrape,只拿 Markdown,大約是 100 credits;若同時要求 JSON 格式,每頁多 4 credits,就變成約 500 credits。
Free 到 Scale 各方案的月費、額度與併發
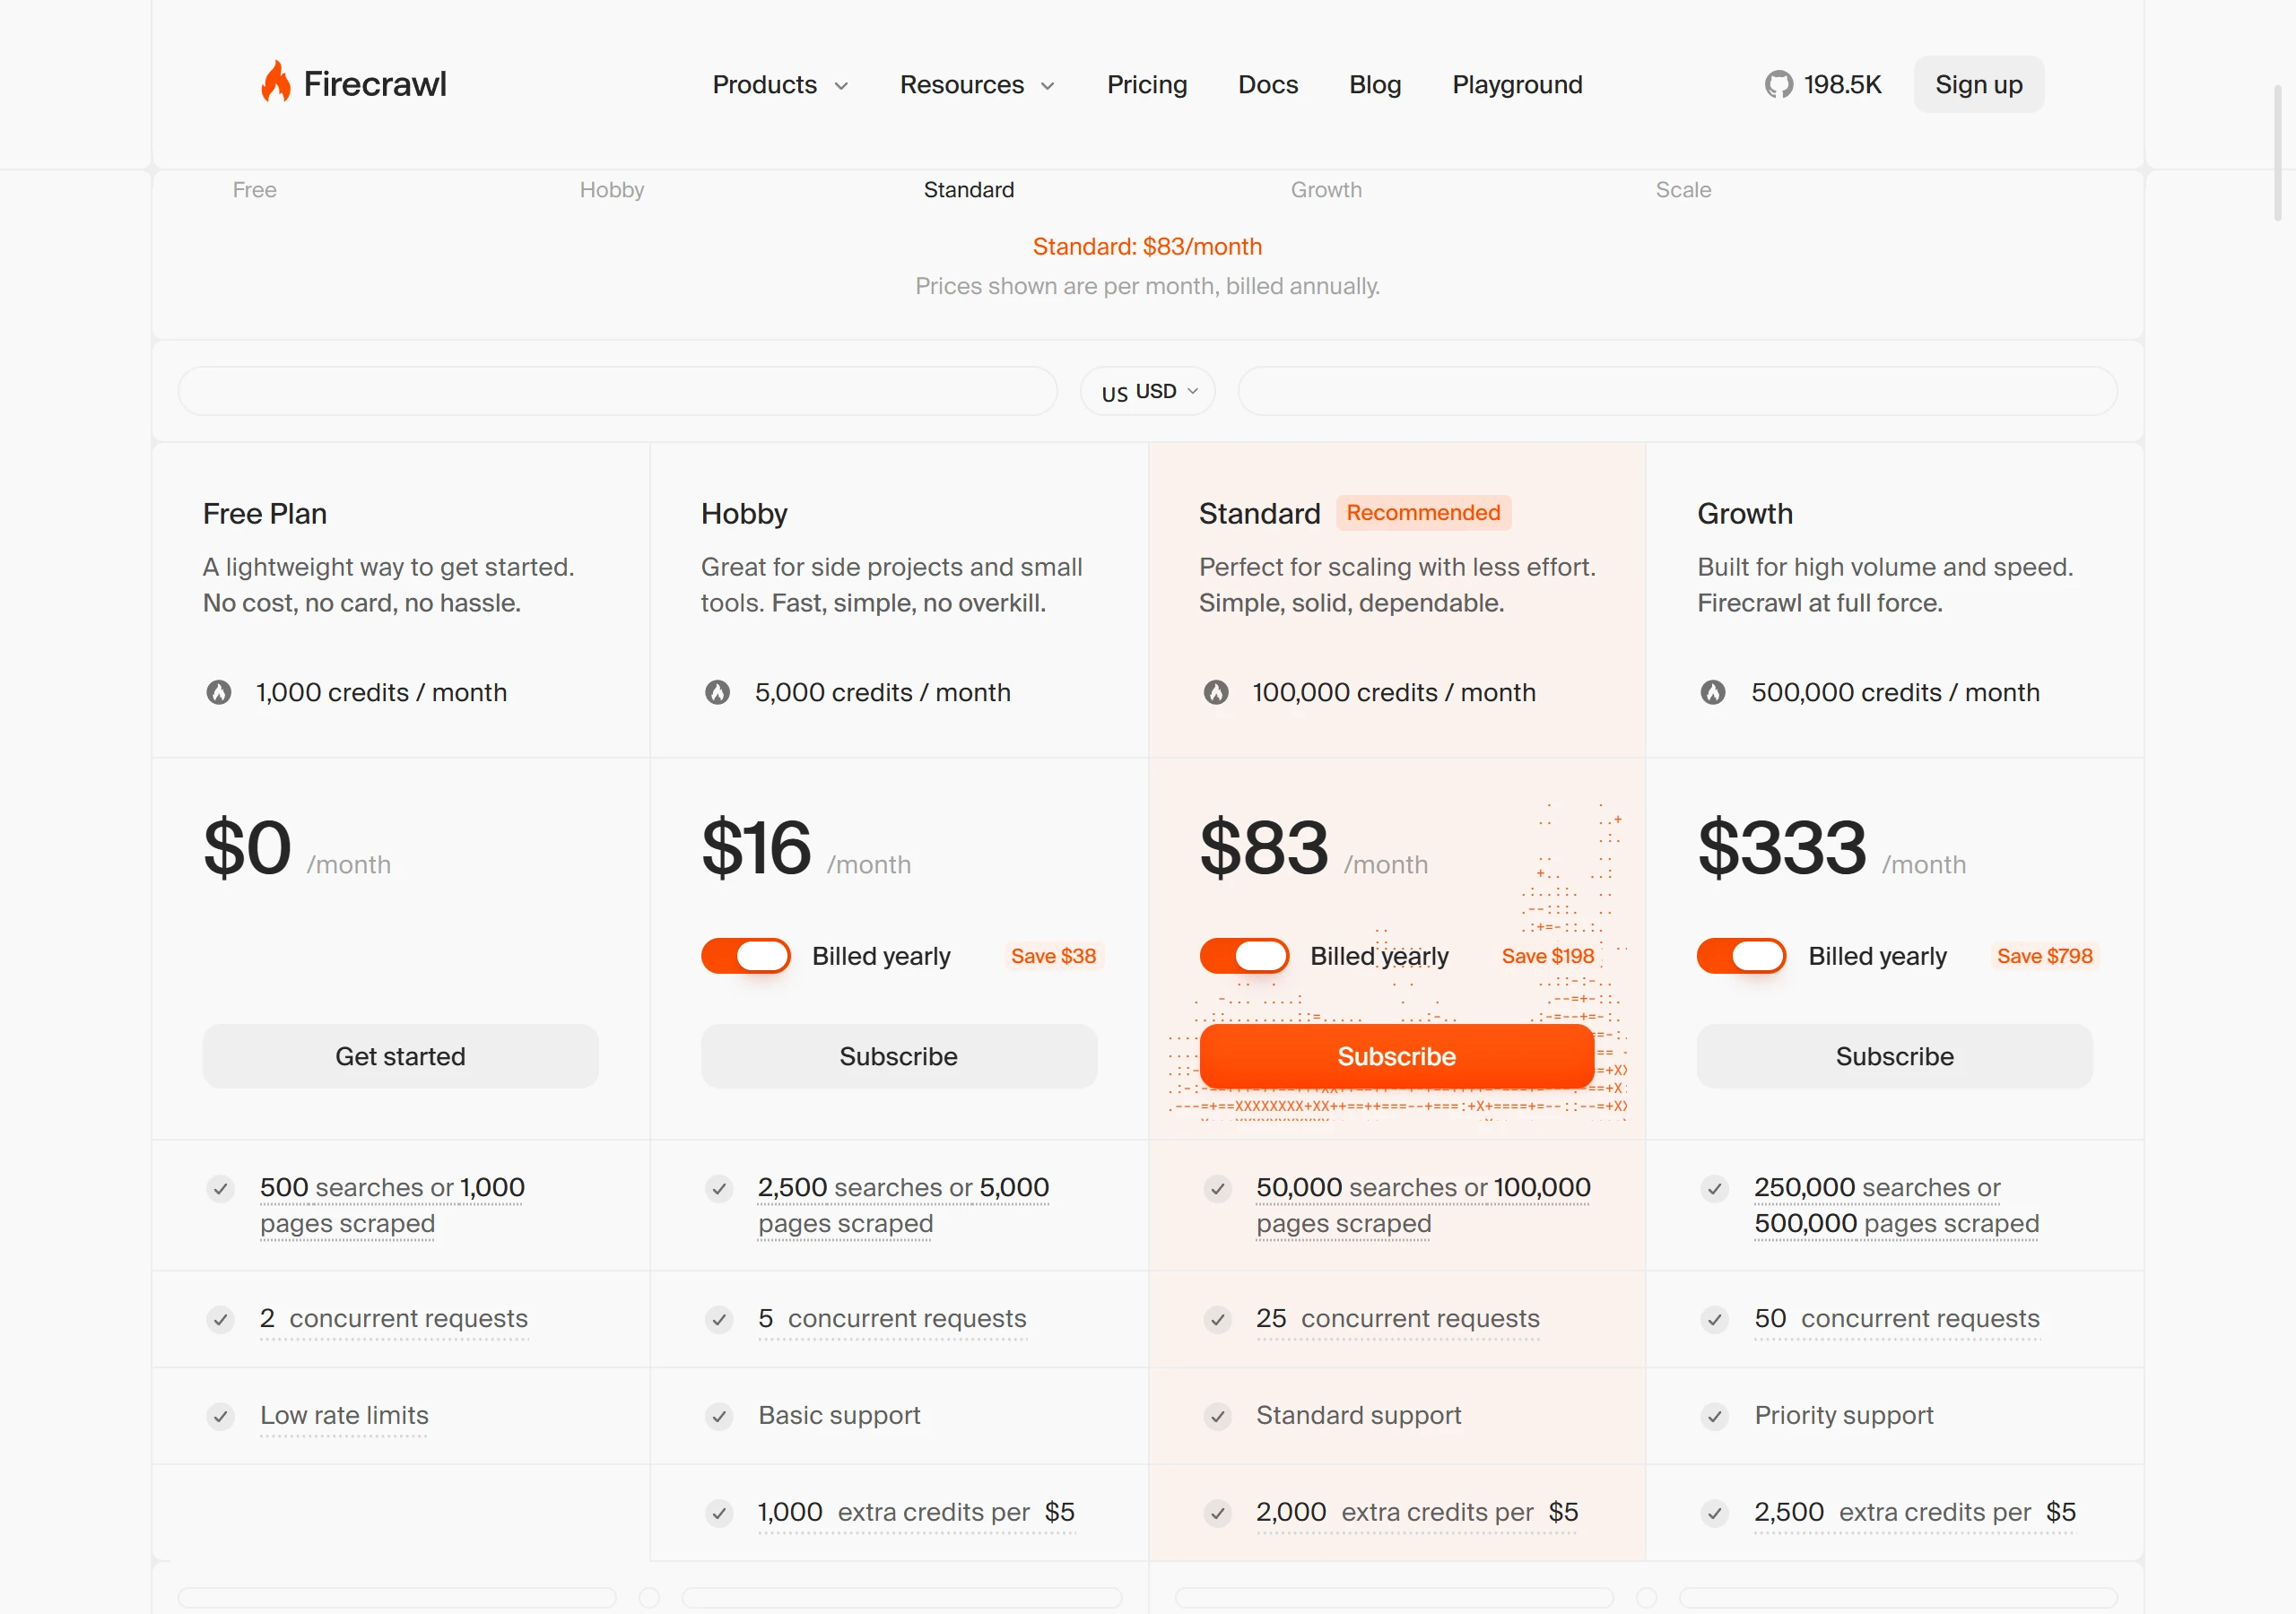
方案分為 Free、Hobby、Standard、Growth 與 Scale,另有客製的 Enterprise。額度與併發隨方案放大,額度每月刷新:
| 方案 | 月付 | 年付折合每月 | 每月 credits | 併發 |
|---|---|---|---|---|
| Free | $0(不需要信用卡) | 不適用 | 1,000 | 2 |
| Hobby | $19 | $16 | 5,000 | 5 |
| Standard | $99 | $83 | 100,000 | 25 |
| Growth | $399 | $333 | 500,000 | 50 |
| Scale | $749 | $599 | 1,000,000 | 100 |
| Enterprise | 客製 | 客製 | 客製 | 客製 |
每分鐘的速率限制也隨方案而不同。scrape、map 與 search 在五個方案分別是 10、100、500、5,000 與 10,000 次;crawl 與 agent 則分別是 2、20、100、1,000 與 2,000 次。
未用完的 credits 一般不會滾存到下個月;Billing 頁寫明年繳的 Scale 方案可保留一個月,年繳的 Enterprise 方案可保留兩個月,定價頁則把 Enterprise 的滾存列為客製。付費方案可以另外購買額外的 credits,以 5 美元為一個增量:Hobby 每 5 美元可得 1,000 credits,Standard 是 2,000,Growth 是 2,500,Scale 是 5,000。Free 方案沒有隨用隨付的選項。
額度用完與失敗請求的計費
Free 方案,以及沒有開啟隨用隨付的付費方案,額度用完後,會消耗 credits 的請求回 HTTP 402,而且不會扣信用卡。開啟隨用隨付的方案,則是餘額歸零時,自動加購一個增量並刷卡;每月支出上限可以自己設定,到達上限、超額緩衝也用完後,請求回 402,直到下個週期。
失敗請求的計費,判斷的標準是「有沒有回傳文件」,不是目標網站的狀態碼。回傳錯誤狀態的頁面,例如 403 或 404,因為文件仍然有被回傳,照樣計 1 credit;沒有回傳任何文件,就是 0 credits。
批次與 crawl 是隨頁面處理完成,逐步計費,不是送出工作時一次扣完,所以費用可能稍後才出現在帳上,查詢進度本身不消耗 credits。
自架開源版與雲端版的功能差異和維運責任
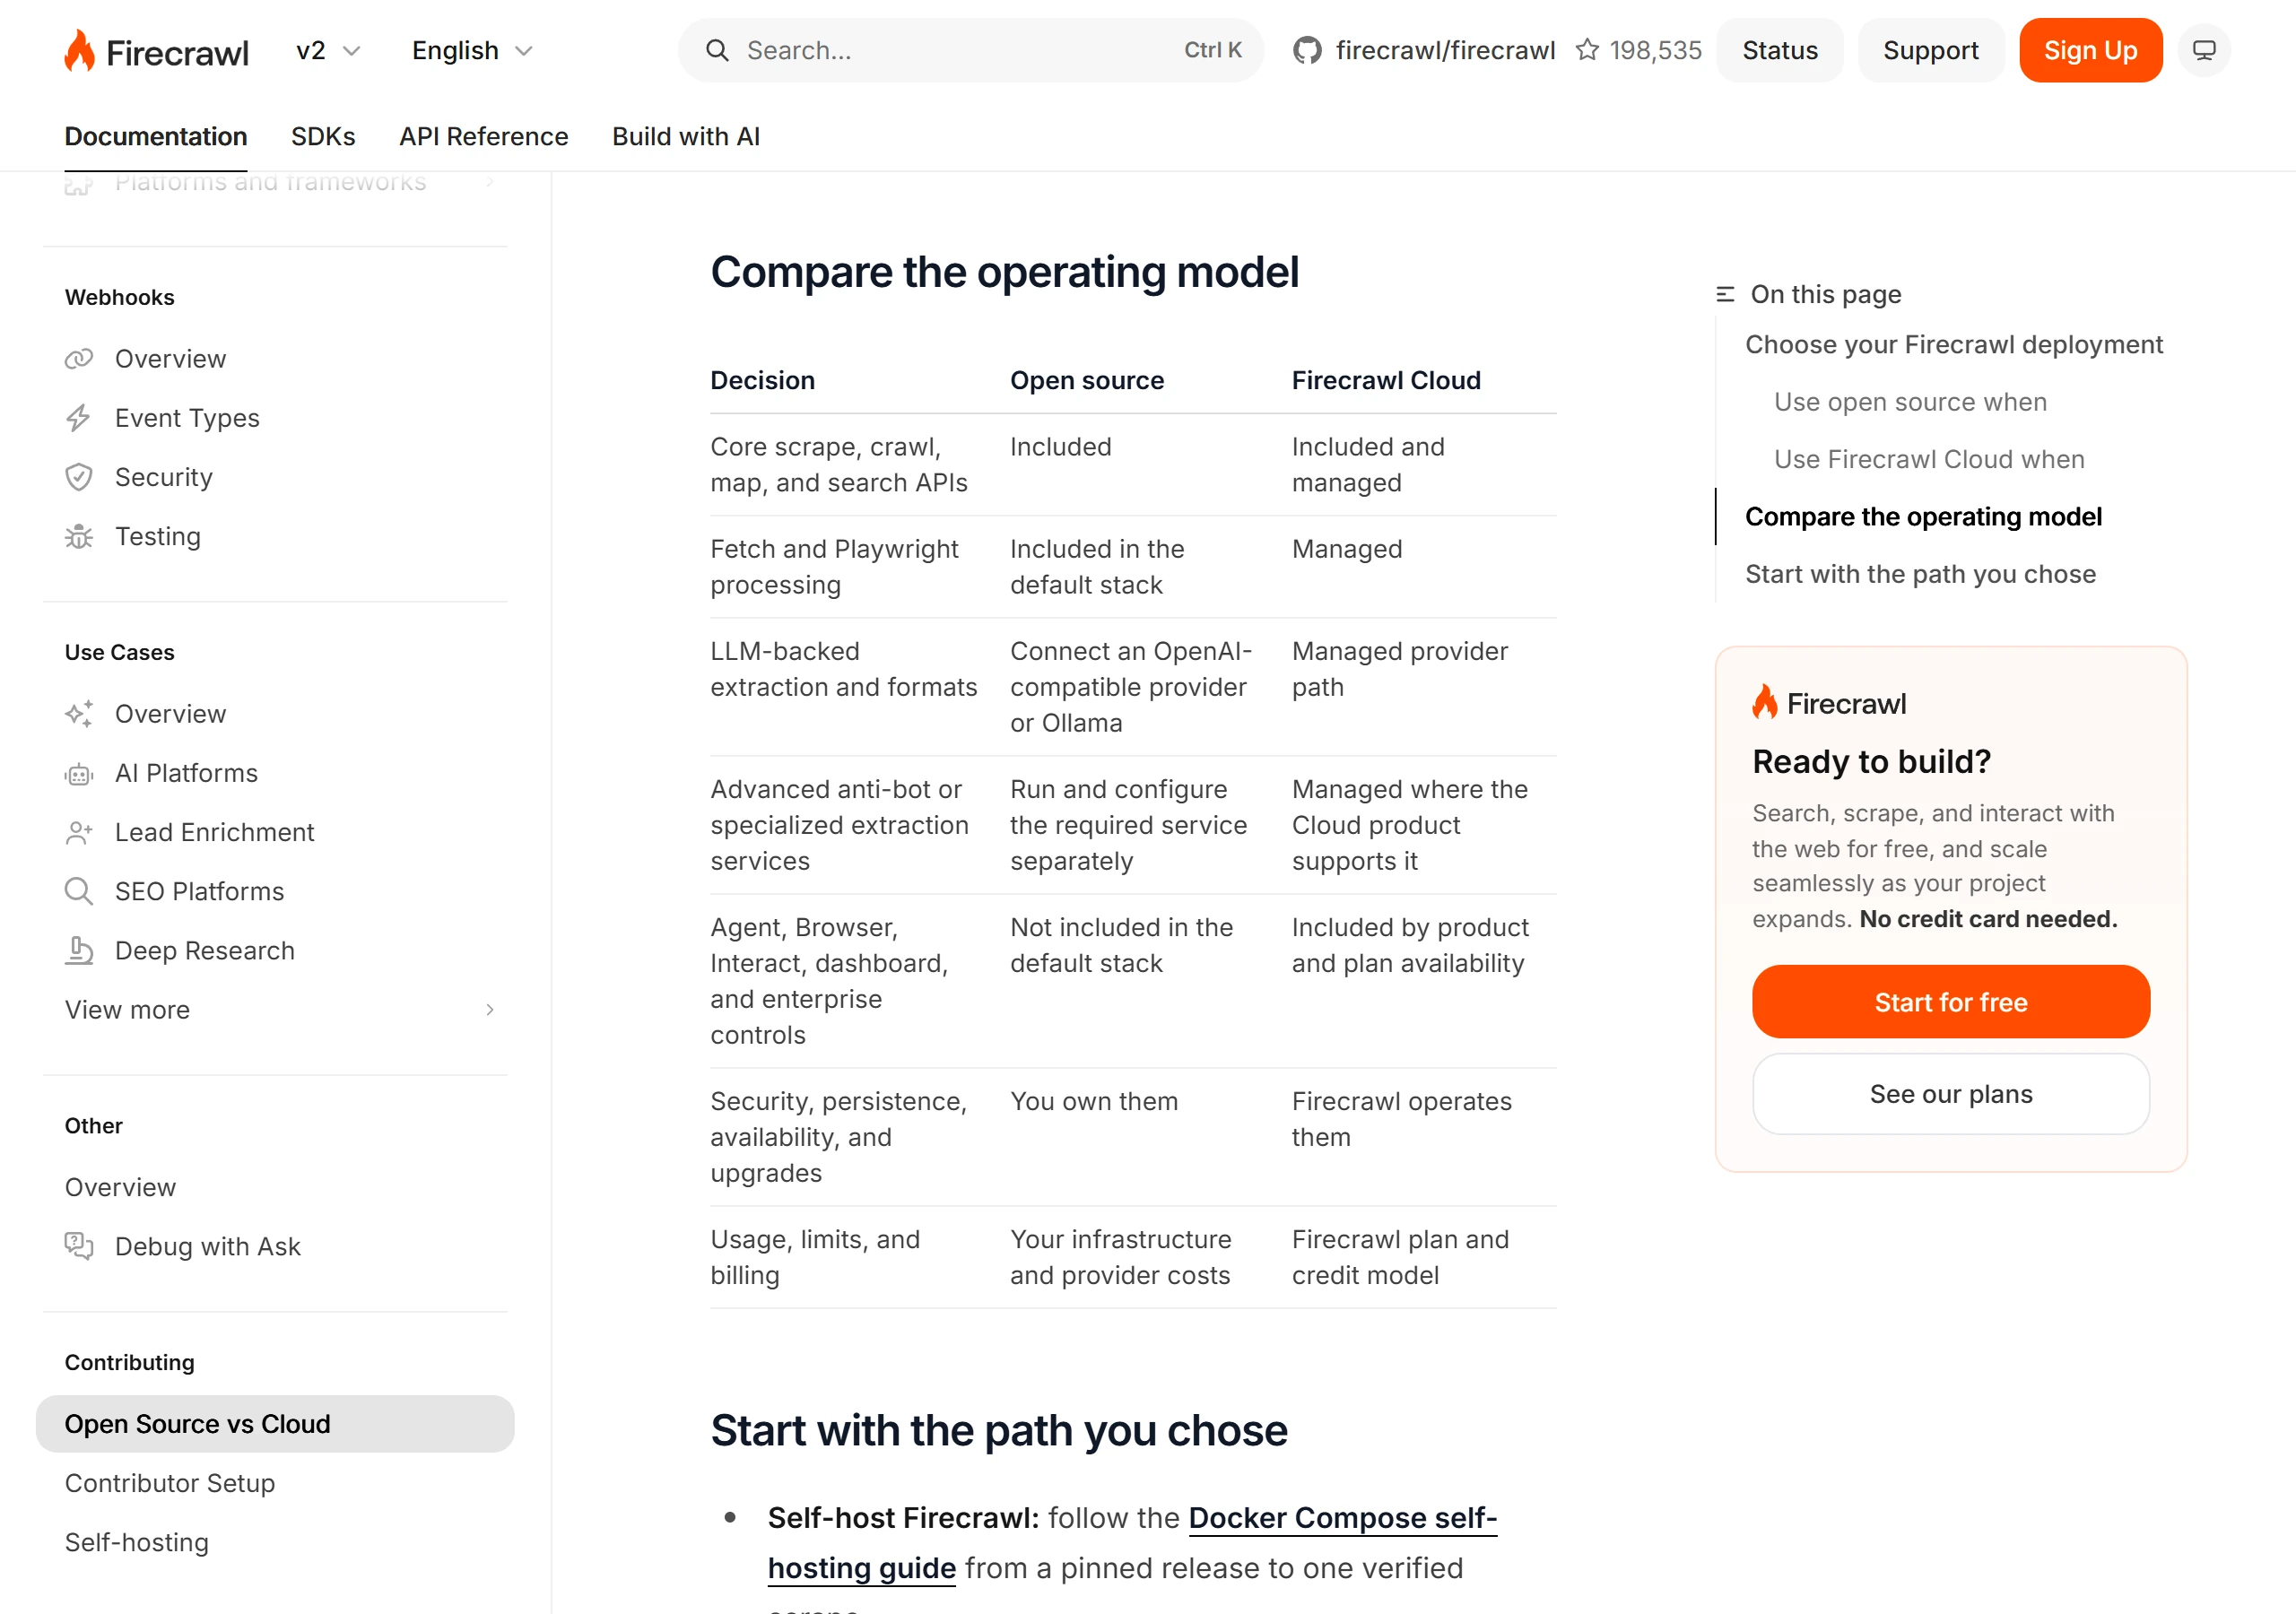
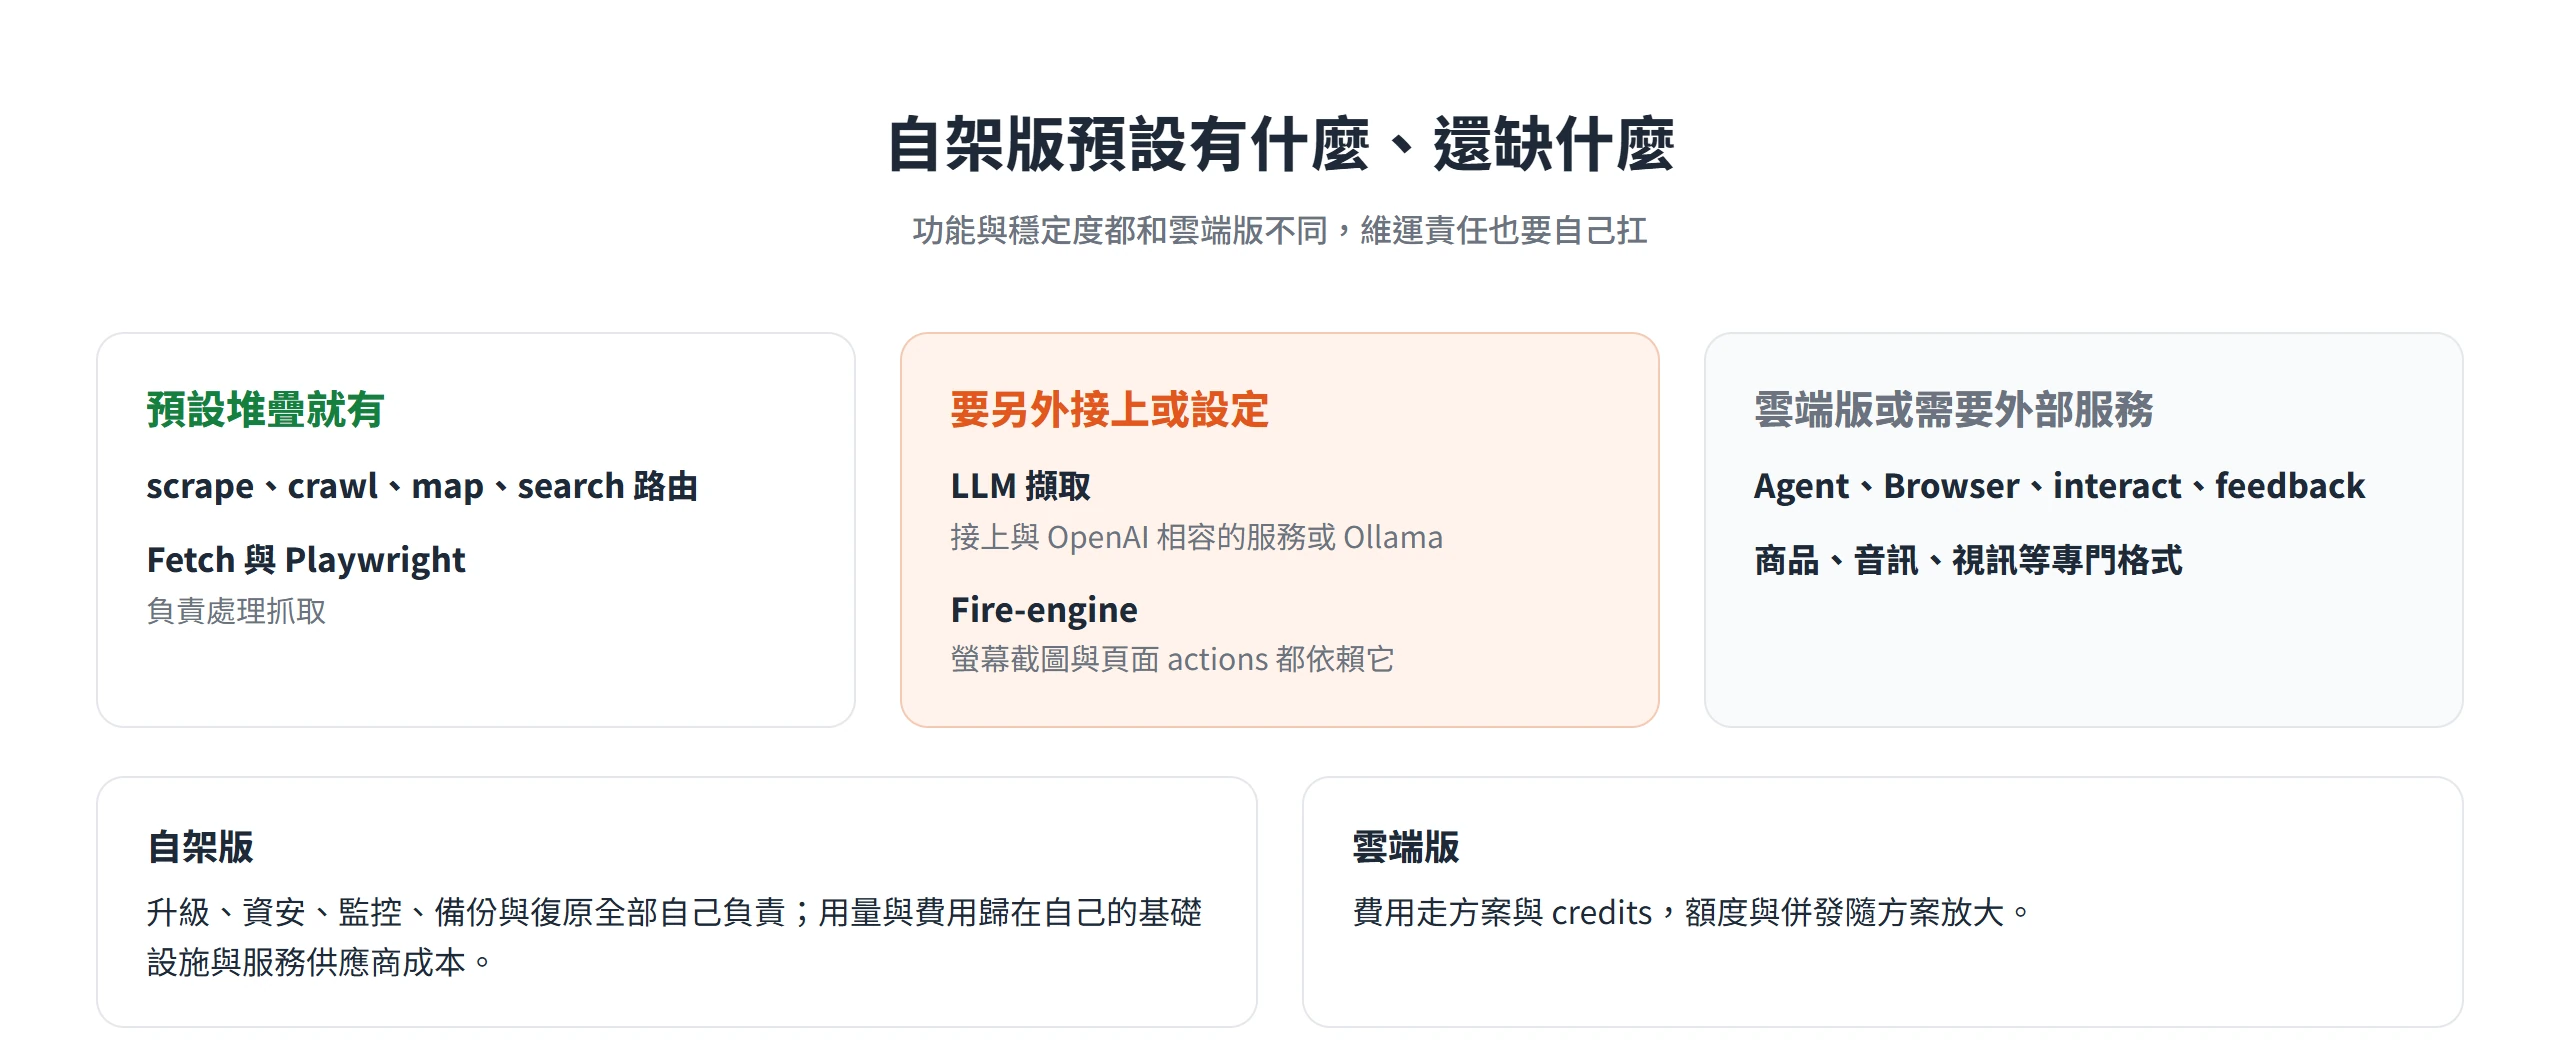
開源、可自架,是不少人對 Firecrawl 感興趣的原因,不過自架適合想自己掌控環境、也能接受維運責任的人,它的功能與穩定度,與雲端版並不相同。
授權是 AGPL-3.0,SDK 與部分介面元件則是 MIT。預設的堆疊包含 scrape、crawl、map 與 search 路由,抓取以 Fetch 與 Playwright 處理;需要 LLM 擷取時,要另外接上與 OpenAI 相容的服務或 Ollama。下面這些,預設堆疊並不包含:
- Fire-engine:進階的抓取服務,螢幕截圖與頁面 actions 都依賴它,需要另外執行與設定。
- Agent、Browser、interact 與 feedback:屬於雲端版,或需要外部服務。
- 商品、音訊、視訊等專門格式:同樣屬於雲端版或需要外部服務。
需求是 Git、Docker 或 Docker Compose v2、curl,以及可用的 3002 埠。依 Firecrawl 自架文件,快速啟動的步驟大致如下,文件釘定的版本是 v2.11.162,不要把它當成最新版:
git clone https://github.com/firecrawl/firecrawl.git
cd firecrawl
git checkout v2.11.162

cat > .env <<'EOF'
USE_DB_AUTHENTICATION=false
POSTGRES_USER=postgres
POSTGRES_PASSWORD=replace-with-at-least-32-random-characters
POSTGRES_DB=postgres
EOF

docker compose up --build -d
curl --fail http://localhost:3002/v0/health/readinessCode language: Bash (bash)
這個快速啟動版停用了驗證,只適合在可信任的網路使用;文件明講它不是正式環境的架構,沒有持久儲存、TLS 與高可用,升級、資安、監控、備份與復原,全部要自己負責。CLI 連到自架服務時,用 --api-url 或環境變數 FIRECRAWL_API_URL 指向它。費用方面,Firecrawl 文件的比較表把自架版的用量與費用歸在自己的基礎設施與服務供應商成本,雲端版才走方案與 credits。
抓取網頁要留意的網站規範與資料風險
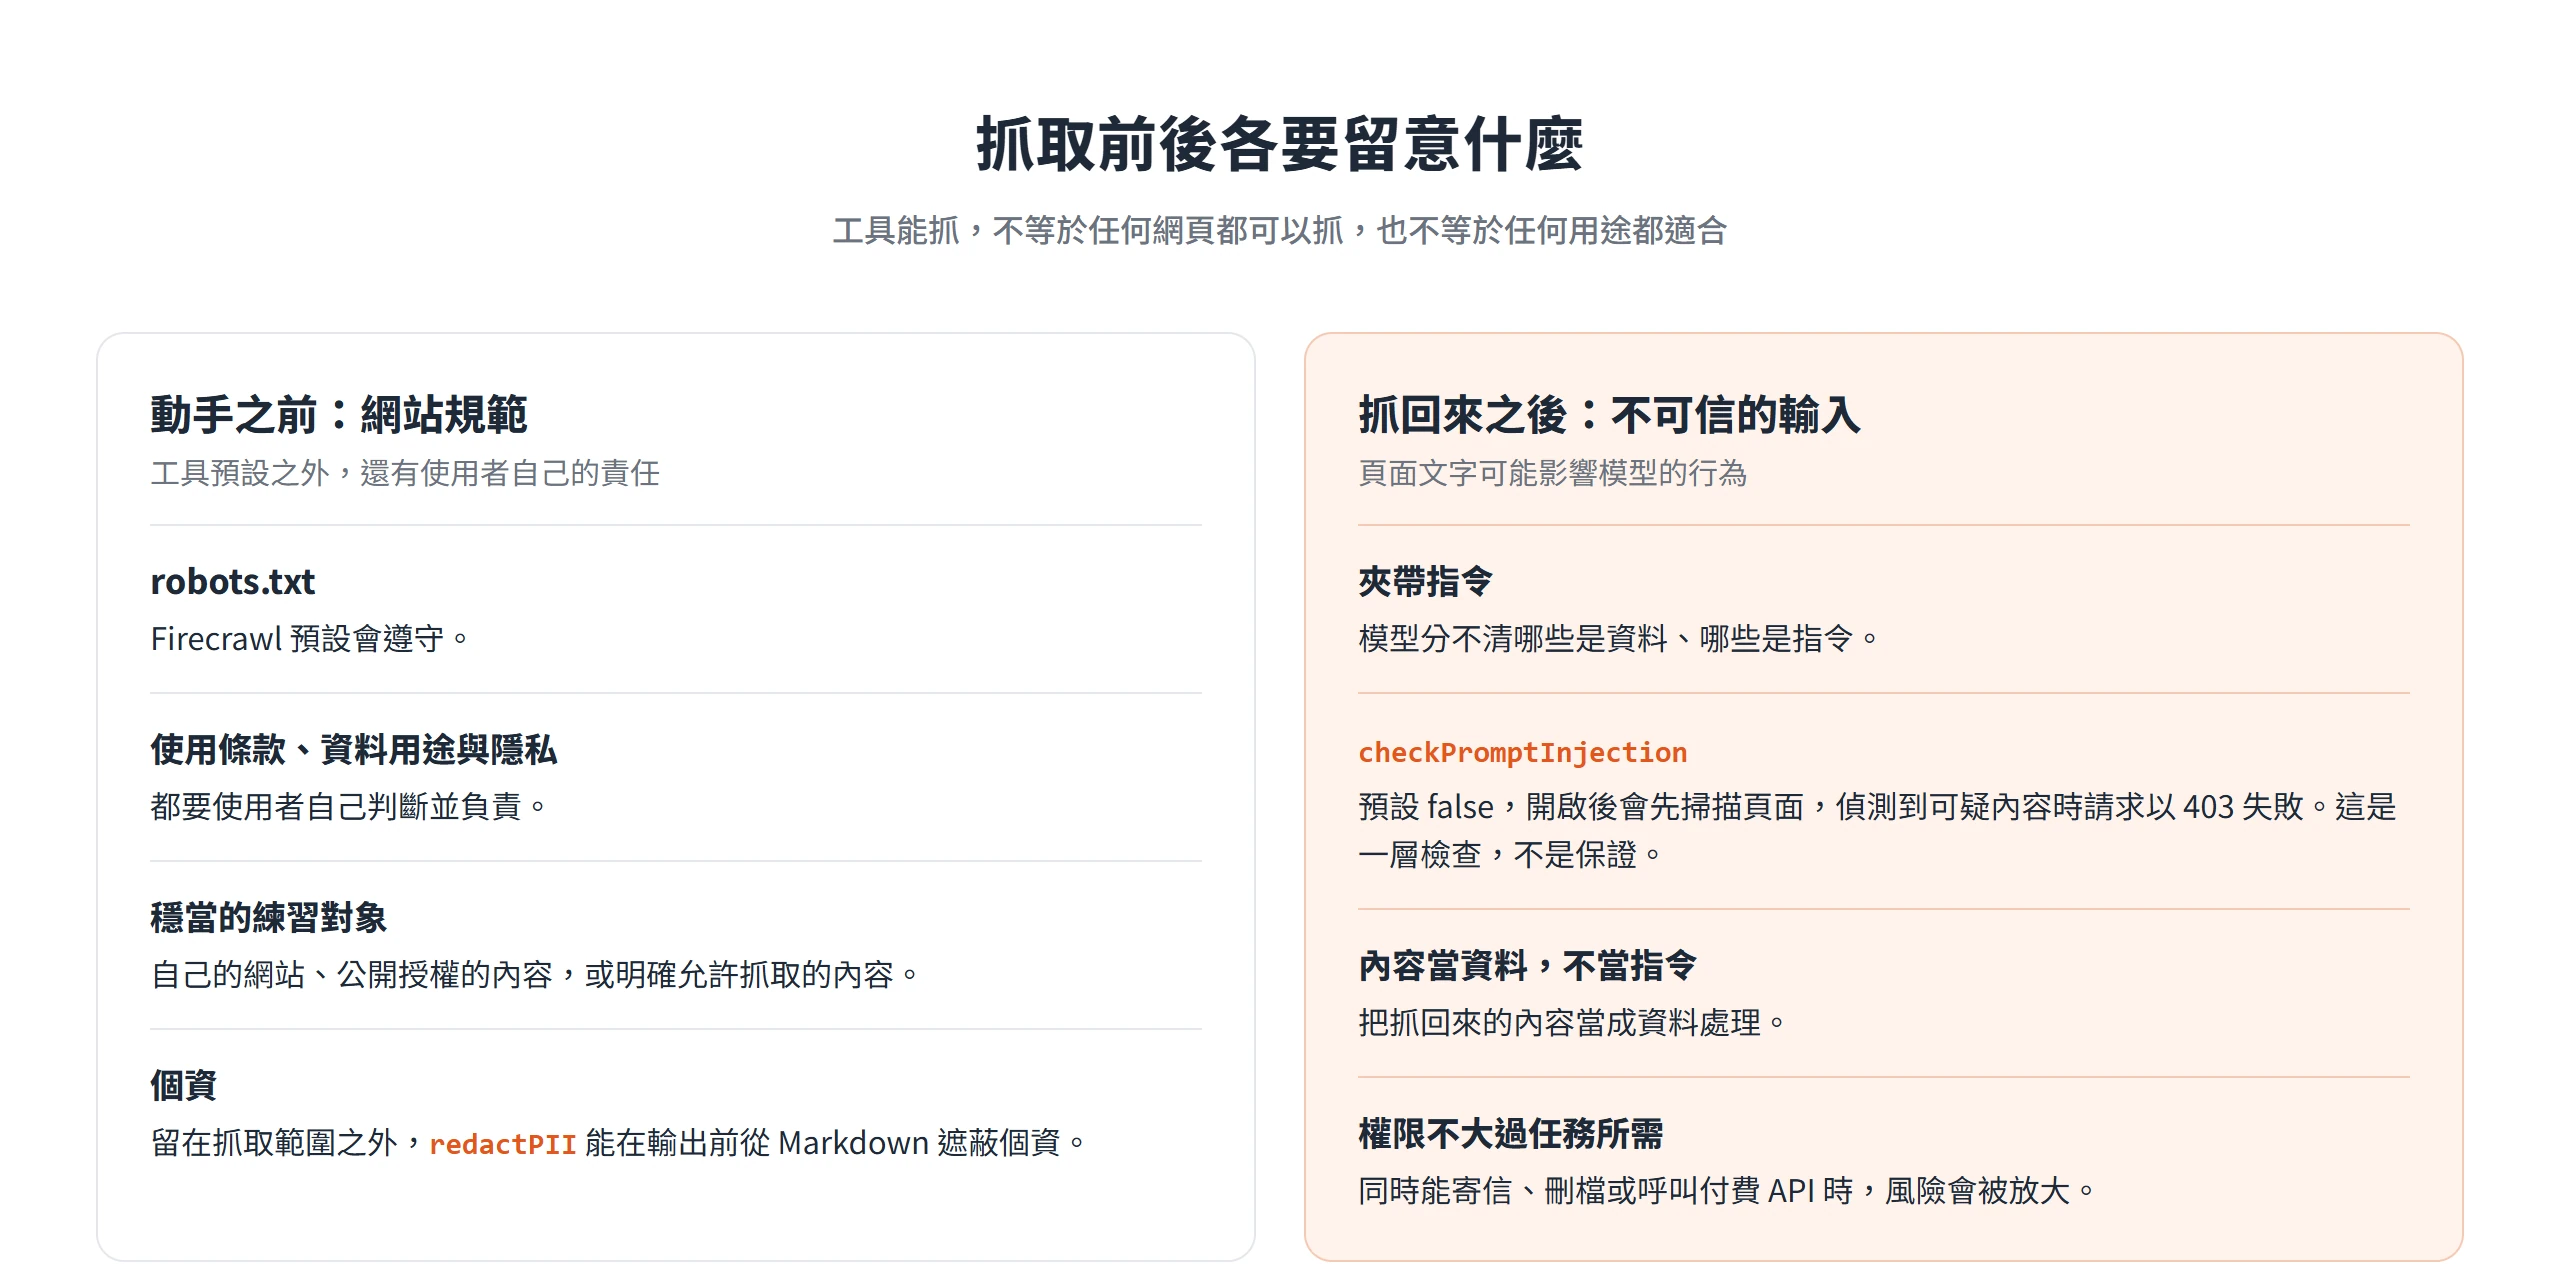
工具能抓,不等於任何網頁都可以抓,也不等於任何用途都適合。動手之前要先看網站的規範與資料用途,抓回來之後,也要留意內容交給 AI 時可能帶來的風險。
robots.txt 預設遵守,使用條款由使用者自行負責
Firecrawl 預設會遵守網站的 robots.txt。ignoreRobotsTxt 與 robotsUserAgent 這兩個選項,文件載明僅限 Enterprise 方案,這裡只是帶過這項限制,不是教學。
比工具預設更重要的,是使用者自己的責任。Firecrawl 的 GitHub README 說明,最終使用者必須自行負責尊重網站的政策,並遵守適用的隱私政策與使用條款。網站的使用條款、資料用途與隱私,都要自己判斷,工具不會替你把關。
比較穩當的練習對象,是自己的網站、公開授權的內容,或明確允許抓取的內容,例如把自家網站的內容整理成 AI 知識庫。個資則要留在抓取範圍之外,Scrape 提供 redactPII 選項,能在輸出前從 Markdown 遮蔽個資。
抓回來的網頁內容可能夾帶對模型的指令
網頁內容是不可信的輸入。抓回來的文字如果直接交給有工具權限的 AI,頁面裡夾帶的「忽略先前指令、改做某件事」這類文字,可能影響模型的行為,因為模型分不清哪些是資料、哪些是指令。
Firecrawl 提供 checkPromptInjection 選項,預設是 false。開啟之後,會在 json、summary、question 這類 LLM 格式執行前,先掃描頁面;偵測到可疑內容時,請求以 403 失敗,錯誤碼是 SCRAPE_PROMPT_INJECTION_DETECTED。檢查執行時,每頁多算 4 credits;若檢查跑完後請求失敗,包含偵測到注入而被擋下,則計 5 credits;如果無法掃完全部內容,scrape 會帶警告繼續,這項檢查不計費。
這個機制是一層檢查,不是保證。比較踏實的做法,是把抓回來的內容當成資料,不當成指令,給 AI 的權限也不要大過任務所需。讓它讀網頁的同時,也能寄信、刪檔或呼叫付費 API,風險就會被放大。
Firecrawl 的工具箱很大,但上手不需要一次用完。先拿自己的網站,或像 example.com 這樣的測試網址,跑一次 scrape,確認 statusCode 與輸出的 Markdown 符合預期;再把 crawl 的 limit 調到一個不怕燒光的數字,看看 credits 怎麼消耗。接著再決定,是要接進 Claude 讓日常對話直接取用,還是用 SDK 放進自己的流程,把 firecrawl 當成資料進入 AI 之前的那道清洗工序。