
多數團隊把要不要用 React、Vue 這類框架,當成純粹的開發效率選擇,好用就上,團隊寫起來順手,使用者點按鈕的反應也快,似乎沒有壞處。其實同一套判斷,擺到搜尋引擎與 AI 助理眼裡,答案完全不同,這群「讀者」看到的往往不是精心做出來的畫面,而是一段還沒執行完的程式碼。
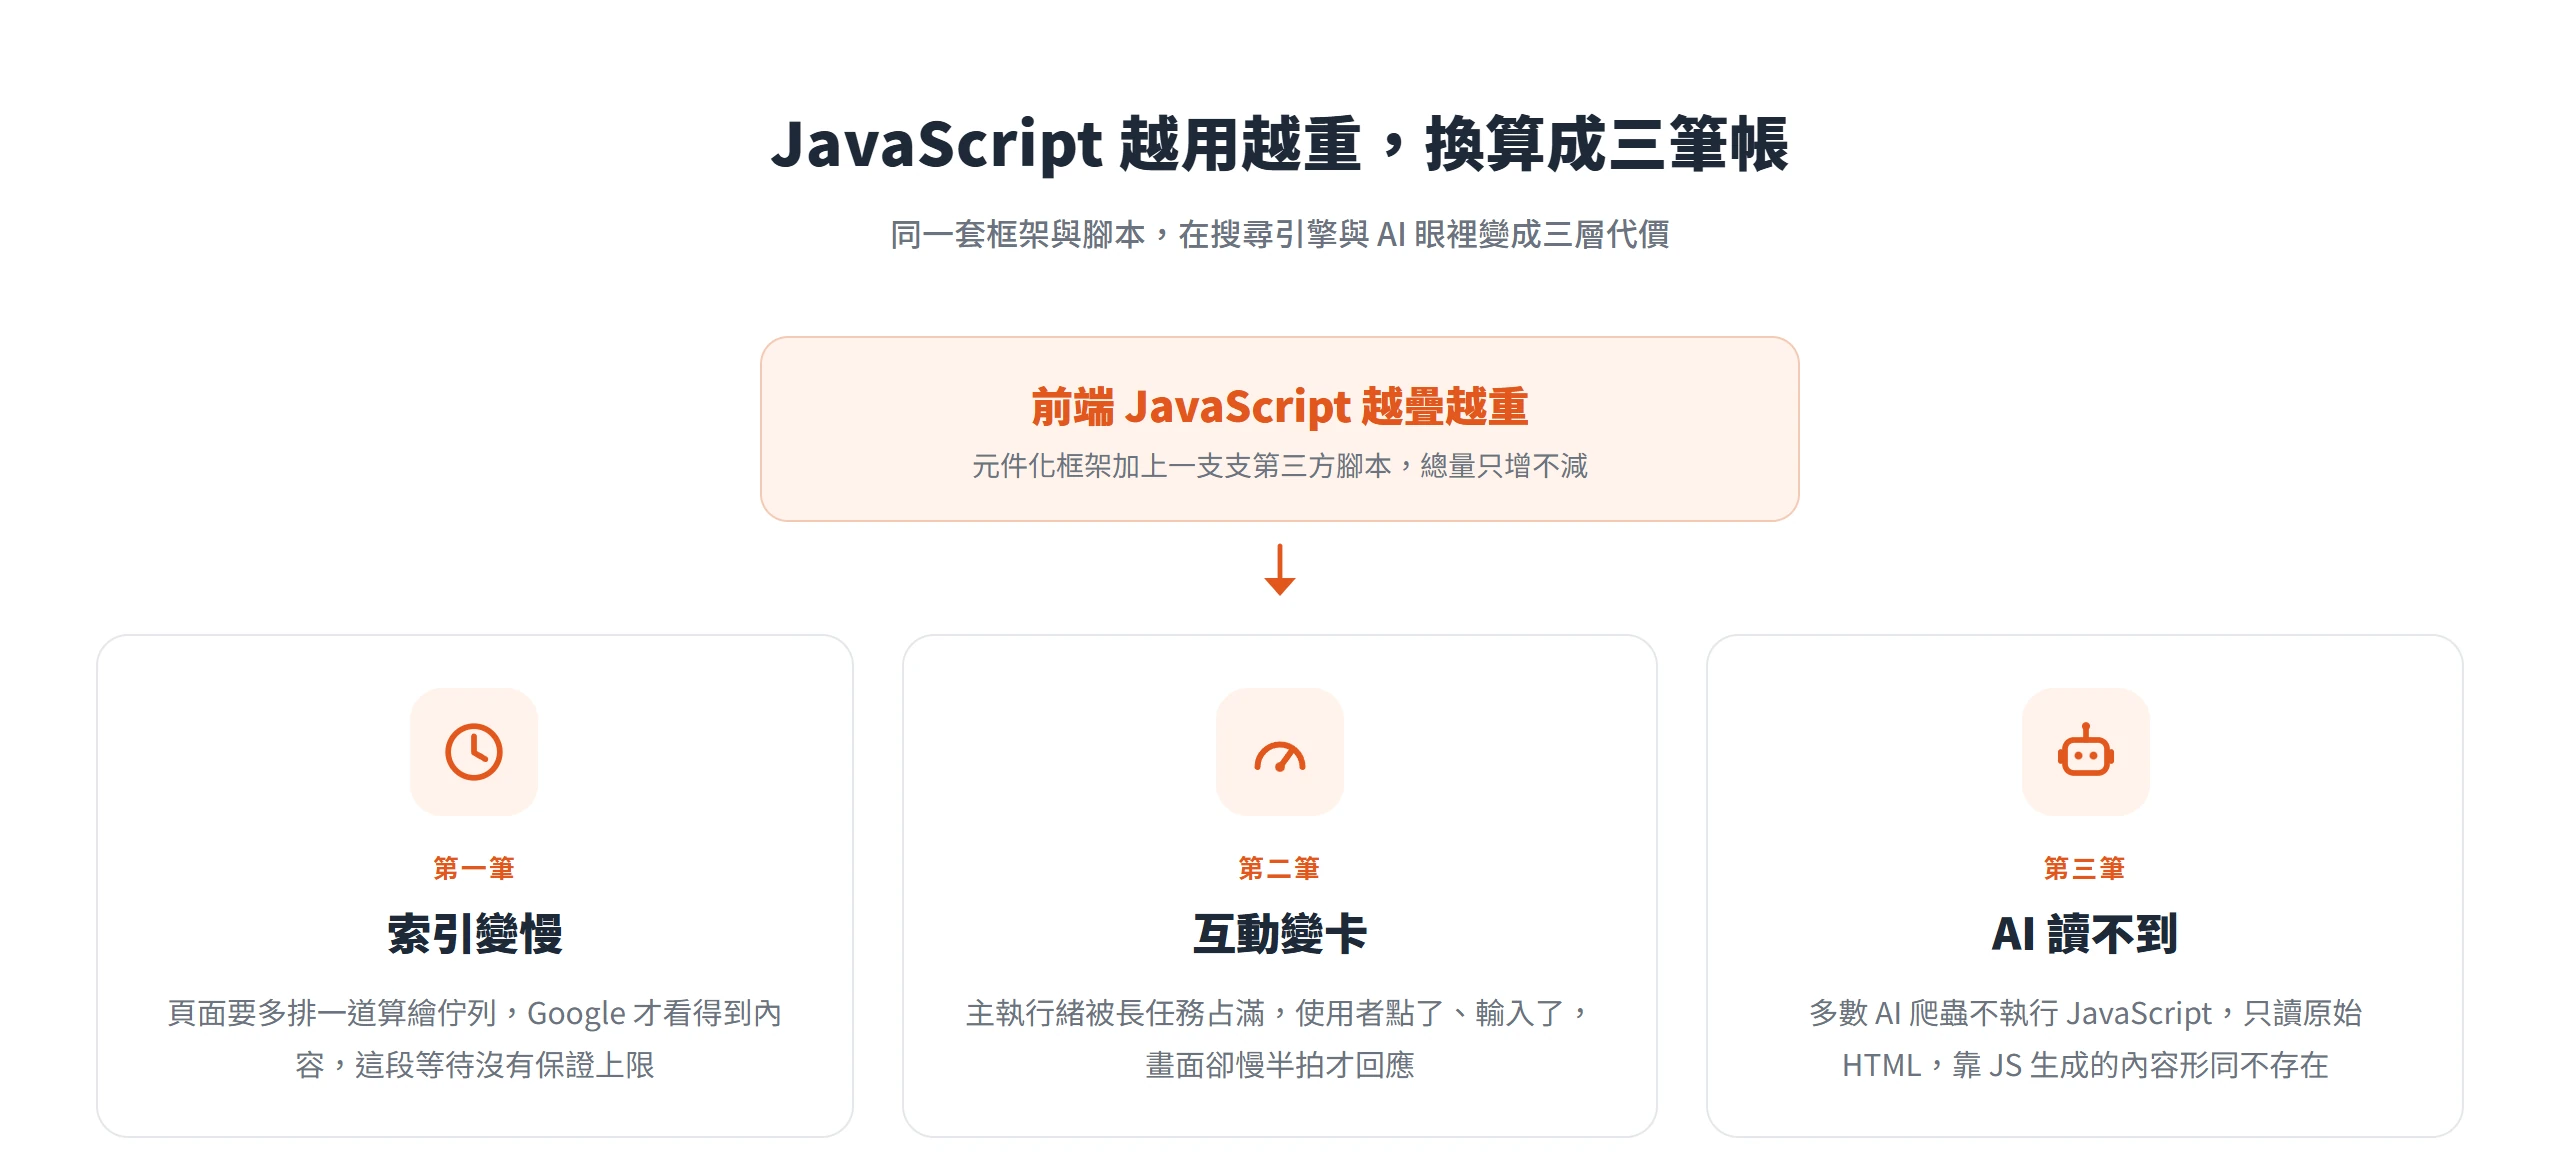
JavaScript 越用越重,不是哪一次架構會議裡有人拍板決定的,而是元件化框架讓功能疊加變得太容易、行銷與分析工具一支一支加上去疊出來的結果。這疊出來的重量最後會換算成三筆帳:Google 要花更久才看到內容、使用者點了畫面卻慢半拍才反應、AI 助理乾脆連讀都讀不到。多數以內容取勝的網站,像部落格、服務頁、電商商品頁,把這幾筆帳算下來通常划不來;但登入後才看得到的工具型應用是明確的例外。
框架元件與第三方腳本疊加養出愈來愈重的前端
JS-heavy 不是抽象詞,它是兩股力量疊加後的結果。一邊是元件化框架讓開發團隊把愈來愈多邏輯放進瀏覽器端執行,一邊是行銷、分析、客服這類第三方腳本一支支疊上去。真正在付代價的是兩邊疊加後的總量,不是哪一邊單獨造成的。
框架元件重複利用帶動開發速度提升
元件化框架被大量採用不是沒有道理。同一組介面邏輯,像商品卡、篩選器、購物車,寫成一個元件後可以在整個網站裡到處複用,狀態管理也集中在一處,不用在每個頁面各寫一份、各修一次。對開發與維運團隊來說,這是實實在在的效率提升,不是跟風。
問題不在於用框架本身,而在於這個效率背後有一筆會自然累積的帳。web.dev 的〈Rendering on the Web〉文件在說明各種算繪策略時直接點出,客戶端算繪(client-side rendering,CSR)最主要的缺點,是所需的 JavaScript 量會隨著應用規模成長而膨脹,而這會直接影響一個頁面的 INP(互動到下一次繪製的時間,衡量使用者點擊、輸入後畫面多快回應)。也就是說,團隊不需要做錯什麼,光是持續加功能、加頁面,JavaScript 的體積就會自己往上疊。
好消息是,這不是無解的宿命。同一份文件也承認,只要花心思把 JavaScript 預算控制在一個緊繃的範圍內,並且盡量減少來回溝通的次數,CSR 的效能表現可以幾乎追平純伺服器端算繪。換句話說,重量疊加是趨勢,但不是必然,關鍵在有沒有人持續在做這件控制預算的工作,而多數團隊在功能愈做愈多之後,往往沒有人回頭做這件事。
行銷追蹤和外掛腳本疊加消耗主執行緒資源
框架之外,還有一塊更容易被忽略的重量,那就是行銷團隊、客服單位、優化團隊各自加上去的第三方腳本。GA4 的追蹤碼、Google Tag Manager、線上客服外掛、A/B 測試工具、好幾組分析像素,這些腳本個別看起來都不大,單獨拿出來測速度看不出什麼問題。
真正麻煩的是它們幾乎只加不減。新專案上線時網站是乾淨的,但之後每一次行銷活動、每一次客服系統評估,都可能再疊一支腳本上去,卻很少有人定期回頭盤點這支還在用嗎、能不能拿掉。每支腳本各自占用主執行緒的時間看起來零散,疊加起來的效果卻不是單純線性相加,一支腳本在執行時,另一支腳本的程式碼可能還在排隊等主執行緒空出來,彼此互相延後。這股元件框架之外的重量,跟主執行緒被占用後使用者體驗變慢直接相關。
算繪佇列會拖慢爬取與索引的時間
三筆帳裡,第一筆最直接。Google Search Central 的 JavaScript SEO 基本說明文件把處理流程拆成三段:Googlebot 先爬取頁面的 HTML 原始碼,判斷這個網址值不值得繼續處理;通過的頁面接著被排進算繪佇列,交給無頭版 Chromium 實際執行裡面的 JavaScript;等算繪跑完,Google 才拿算繪後產生的 HTML 去做索引。對純 HTML 頁面來說,內容爬到的那一刻就已經是完整內容,可以直接進索引;對依賴 JavaScript 才生出內容的頁面,中間硬生生多了一道算繪關卡要排隊等,這是額外插進去的時間差與運算成本。
同一份文件也直接承認,這道算繪佇列的等待時間沒有保證上限。頁面可能只在佇列裡停留幾秒鐘,但也可能拖得比幾秒更久。這代表同一份內容,純 HTML 版本可能爬到就進索引,靠 JavaScript 算繪才會出現的版本,卻要多等一段不確定長度的時間才輪到,這段落差就是這一層代價的核心。
算繪佇列的等待時間沒有保證上限
這段等待有多長,Google 沒有公布固定數字,文件只說可能是幾秒,也可能更久。對規模小、更新不頻繁的網站來說,Google 本來就不會常來爬,從發佈到被看見原本就要等一陣子,內容又得多排一道算繪佇列,這兩段時間疊在一起,就是很多依賴 JavaScript 呈現內容的小型網站,內容明明已經發佈了,卻要好幾天甚至更久才被搜尋引擎看到的常見處境。
正因為這段等待沒有保證上限,Google 在同一份文件裡也建議,伺服器端算繪或預先算繪(pre-rendering,事先把頁面產成完整 HTML,爬蟲與真人拿到同一份)仍然是值得投入的作法,理由很直接,這樣對使用者和爬蟲都比較快。換句話說,連 Google 自己都承認,與其寄望算繪佇列排得快,不如從一開始就少依賴這道關卡。
算繪成本疊加會間接排擠爬取預算
算繪延遲還會連動到另一個概念,叫做檢索預算(crawl budget)。Google Search Central 的檢索預算文件把它定義成 Google 可以且想要爬取的一組網址,由兩塊組成:檢索容量上限(crawl capacity limit),也就是 Google 為了不壓垮伺服器,限制伺服器替它維持連線的總時間,同時考量並行連線數與每條連線的時長;以及檢索需求(crawl demand),也就是 Google 認為這個網站值得花多少檢索資源,會隨網站規模、更新頻率、頁面品質與相關性而變,熱門程度與內容多久沒更新也會影響。
這份文件明確點名,網站回應變慢、回應時間拉長時,Google 就會減少爬取;反過來,Google 若能更快載入並算繪頁面,就可能從同一個網站讀到更多內容。大量的軟性 404(soft 404,指網頁本身回傳正常狀態碼卻沒有實際內容)與重複內容,也是浪費預算的常見原因。這裡要誠實說清楚,文件並沒有點出 JavaScript 算繪會消耗多少檢索預算的具體數字,以下是合理的邏輯推論,不是 Google 明講的統計。算繪本身是額外插入的運算工序,一個網站如果頁面數量龐大、又高度依賴 JavaScript,算繪這道工序就等於讓每個網址在 Google 眼中變得更貴,在同一份檢索預算之下,能被覆蓋到的頁面數量自然可能變少。這個推論成立的前提,是網站規模夠大、頁面數量夠多才會真的感受到差異;頁面本來就不多的網站,這層代價相對不明顯。
主執行緒被佔用後,使用者互動回應變慢的代價
就算 Google 願意等、內容最終真的被索引到,使用者在瀏覽器裡當下的體驗,還是會被同一批 JavaScript 拖慢。這裡談的是核心網站指標(Core Web Vitals)裡跟互動直接相關的 INP(Interaction to Next Paint,互動到下一次繪製),衡量使用者點擊、輕觸、鍵盤輸入之後,畫面多快真正回應。
web.dev 的 INP 說明文件定義 INP,是觀察使用者造訪頁面期間所有點擊、輕觸、鍵盤互動的延遲,取其中最長的一次互動(忽略極端值)當作這次造訪的 INP 值;評估門檻則以實際造訪資料的第 75 百分位數計算,75 百分位不超過 200 毫秒算良好,超過 200 毫秒到 500 毫秒之間算待改善,超過 500 毫秒就是不佳。
這段延遲的主因,幾乎都出在瀏覽器的主執行緒被長任務占滿。web.dev 把單一任務執行時間超過 50 毫秒定義為長任務,一旦長任務正在跑,使用者的點擊或輸入就得排隊等,等的這段時間就算進 INP 裡的輸入延遲。web.dev 也指出,瀏覽器執行指令碼前得先花時間評估它,一支很大的 JavaScript 檔案光是下載完之後的解析、編譯、執行,就可能變成占住主執行緒的長任務,讓瀏覽器忙著處理程式碼,頁面載入期間使用者的點擊與輸入都得等它跑完。框架元件與第三方腳本疊加得愈多,主執行緒上排隊的長任務也愈多,這正是第一節重量怎麼疊上去,最終兌現成使用者體感的地方。
行動裝置和桌面裝置的明顯落差
這件事在行動裝置上被放大得特別明顯。HTTP Archive《2024 年網路年鑑》(Web Almanac)的效能章節實測顯示,2024 年桌面裝置有 97% 的網站 INP 表現良好,行動裝置卻只有 74%,兩者相差 23 個百分點。
差距的成因不是網路速度,是裝置的運算能力。同一支 JavaScript 在開發團隊自己用的高階筆電或桌機上執行起來順暢,換到中低階手機的處理器上,解析與執行同一批程式碼要花更久,使用者感受到的卡頓自然更明顯。這也是為什麼「我自己測起來很順」常常是一種假象,測試機通常是效能遠高於真實使用者裝置的開發機,實際使用者滑到的畫面,反應速度往往跟測到的不是同一回事。
總阻塞時間中位數與最佳實務的落差
把 INP 拆開來看,還有一組更直白的數字可以量化 JavaScript 有多重,叫做總阻塞時間(Total Blocking Time,TBT),量測主執行緒被長任務占用、無法回應輸入的總時間。同一份《2024 年網路年鑑》資料顯示,行動裝置上網站的 TBT 中位數是 1,209 毫秒,年鑑直接點出這是最佳實務值的 6 倍;桌面裝置對照組的 TBT 中位數只有 67 毫秒,落差懸殊。
這組數字說明的是,JavaScript 造成的代價不是一個抽象概念,是可以被量測、可以被拿來跟別人比較的具體時間。裝置效能差距這麼大,也代表代價有多大本身會因為受眾實際使用的裝置而不同。
多數 AI 搜尋爬蟲根本不執行 JavaScript
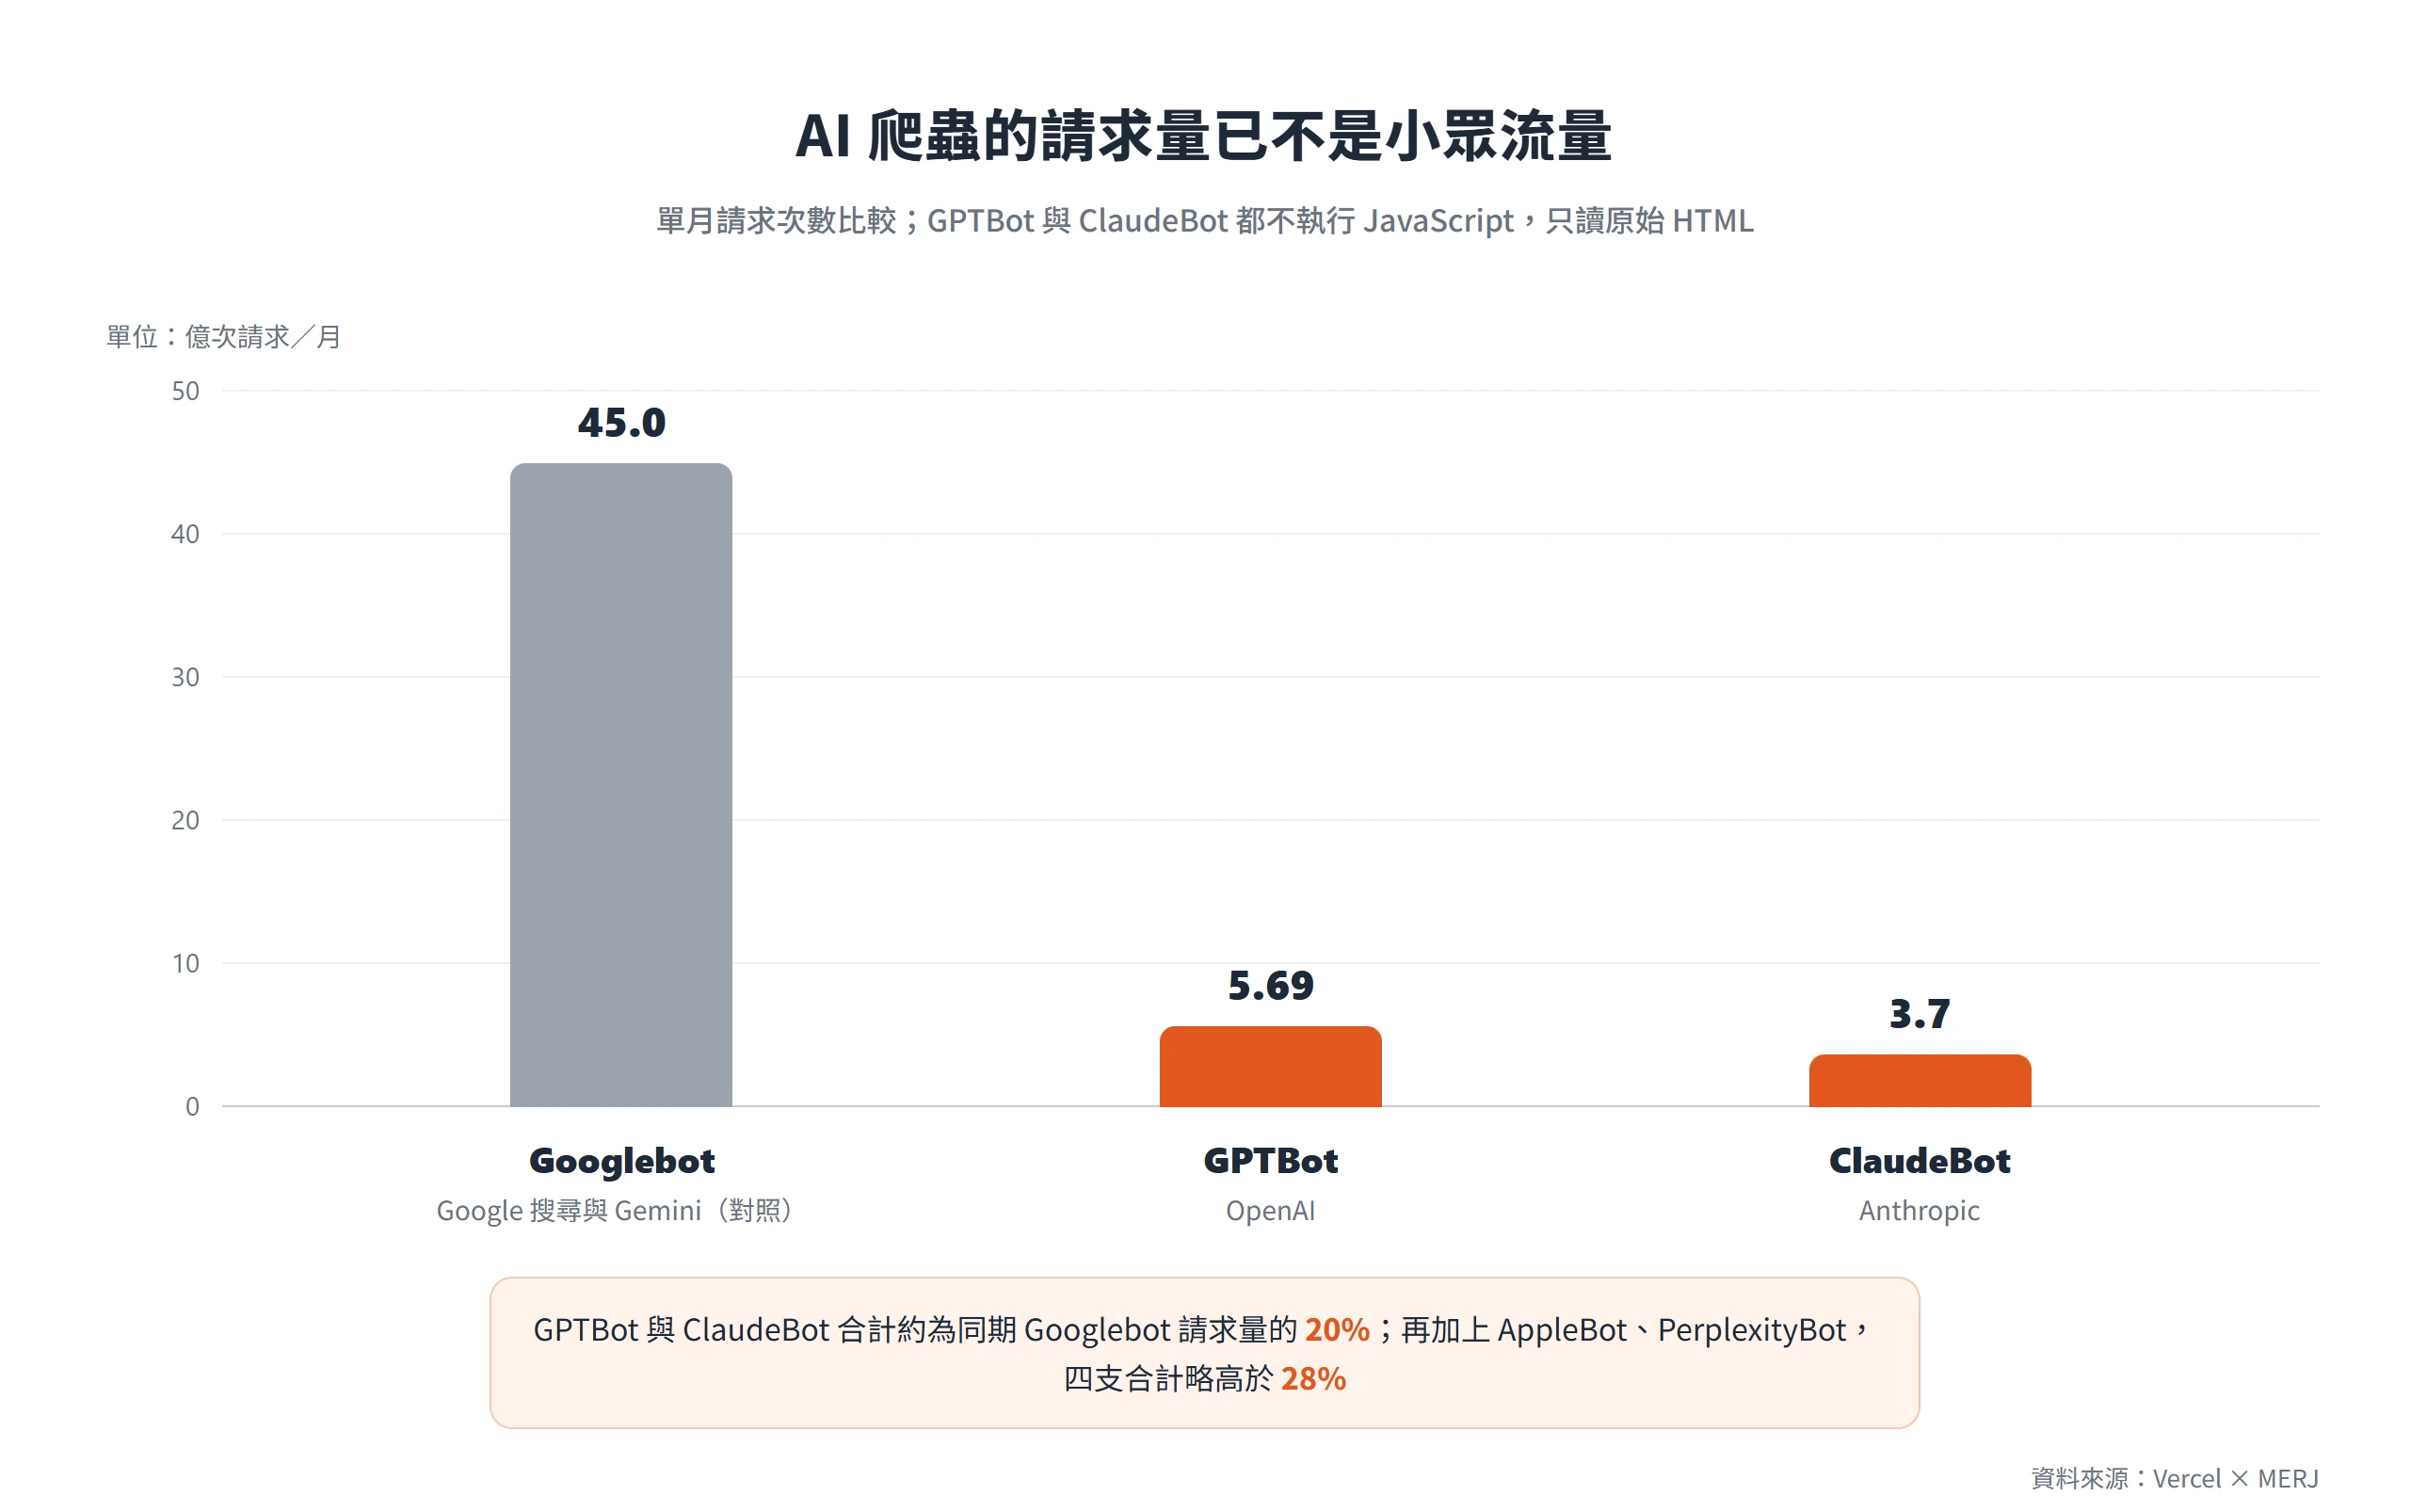
前兩層代價講的都是傳統 Google 搜尋,而且 Google 好歹會花力氣做算繪。第三層代價更嚴重:Vercel 與技術 SEO 顧問機構 MERJ 在 2024 年 12 月發表的分析,根據 Vercel 網路上的真實爬蟲流量指出,OpenAI 的 GPTBot、Anthropic 的 ClaudeBot、PerplexityBot,以及 Meta、ByteDance 旗下的爬蟲,都不執行 JavaScript,只讀原始 HTML,GPTBot 與 ClaudeBot 甚至會把 .js 檔下載下來,卻不會真的去跑;例外是沿用 Googlebot 基礎設施的 Gemini,以及用瀏覽器式爬蟲的 AppleBot。這群爬蟲的規模也不小,GPTBot 當時一個月內在 Vercel 網路上發出 5.69 億次請求、ClaudeBot 有 3.7 億次,合計約為同期 Googlebot 45 億次的 20%,再加上 AppleBot 與 PerplexityBot,四支合計則略高於 Googlebot 請求量的 28%。
這對內容型網站的意義很直接:如果文章正文、產品說明、價格資訊這些核心內容要靠瀏覽器執行 JavaScript 才會出現,對多數 AI 爬蟲來說,這個頁面幾乎等於不存在。對愈來愈多網站在意的生成式引擎優化(GEO,讓內容被 AI 助理引用與呈現)來說,這是決定內容有沒有機會被看到的關鍵門檻,重要性不亞於傳統 SEO 的爬取與索引。
登入後的工具型網站和高互動應用,代價換算方式不同
以上三層代價成立的前提,是這個頁面本來就希望被搜尋引擎與 AI 爬蟲看到。一旦這個前提不成立,整套推論就該反過來看,某些頁面重度依賴 JavaScript 換到的互動體驗,其實是划算的交易,不該被要求硬做成伺服器端算繪。判準不是這個網站用不用框架,而是這個頁面需不需要被搜尋引擎或 AI 索引。
帳號登入後不需要被搜尋引擎看到的頁面
第一種情境是內部系統、會員專屬後台、必須登入才看得到的儀表板。這類頁面本來就擋在登入牆後面,Google 與 AI 爬蟲根本進不去,前面談的算繪佇列、爬取預算、AI 爬蟲讀不讀得到,對它來說都不構成問題,因為它從一開始就不在被索引的競賽裡。
對這類頁面,開發團隊該把資源放在哪裡答案很清楚:互動體驗、操作順暢度、資料即時性,而不是花心思去做伺服器端算繪。硬要把後台儀表板做成對搜尋引擎友善的架構,反而是在解決一個不存在的問題,排擠掉真正該投入的資源。
使用者停留很久的高互動工具型應用
第二種情境是設計畫布、線上試算表、程式碼編輯器這類工具型應用。使用者的使用模式通常是打開一次、停留很久、密集互動,前期載入 JavaScript 的成本會被之後長時間的使用攤平。這類應用追求的是拖曳、即時運算這種當下的回饋速度,跟內容能不能被搜尋到根本是兩件事,拿同一套 SEO 標準去要求它並不合理。
即使是這兩種情境,web.dev 文件先前提到的提醒仍然成立,JavaScript 量會隨應用規模成長而膨脹,控制節制依然重要。差別只在於代價換算的方式不同,對這類頁面來說,重 JavaScript 換到的是划算的互動體驗,不是白白付出的成本;但如果完全不節制,同一頁面內部的效能問題,像操作卡頓、載入過久,還是會直接影響使用者留不留得住,這一點跟需不需要被索引無關,是任何應用都該做好的基本功。
折衷做法能留住互動體驗也降低代價
如果一個頁面確實需要被搜尋引擎與 AI 爬蟲看到,又想保留框架帶來的互動體驗,業界已經有成熟的折衷做法,不是用框架跟放棄 SEO 兩者只能二選一。
第一個方向是伺服器端算繪(server-side rendering,SSR)搭配水合(hydration),先在伺服器端把完整 HTML 送出去,再由瀏覽器端的 JavaScript 接手、把頁面喚醒成可以互動,爬蟲拿到的不是空殼,使用者也照樣享有框架帶來的互動性。
第二個方向是把 JavaScript 拆開來處理,叫程式碼分割(code splitting)與延遲載入(lazy loading)。核心邏輯是,不是所有 JavaScript 都要在頁面第一次載入時就全部送到瀏覽器,把使用者當下真正需要的部分先載入,其餘功能等真的用到再載入,直接減少初次載入要處理的程式碼量,對前面談到的 INP 有直接幫助。
這裡要提醒一個常見誤解。動態算繪(dynamic rendering)是偵測到爬蟲時送出一份伺服器算繪好的 HTML、真人訪客照樣拿用戶端算繪的版本,市面上只替爬蟲產生快照的「預渲染」服務,做的就是這件事。Google Search Central 現行文件把它定位成過去的權宜之計、不是長期解法,也不是建議的做法,理由是同時維護兩套算繪路徑會多出複雜度與資源成本,Google 改建議伺服器端算繪、靜態算繪(static rendering)或水合。只要爬蟲與真人看到的內容相近,Google 一般不會把動態算繪當成偽裝,已經在用的網站不必驚慌,但新專案不該再把它當成首選。
把三層代價攤開來看,JavaScript 本身沒有錯,錯的是把它當成沒有成本的預設選項。算繪佇列讓內容多等一段不確定的時間才被 Google 看到,主執行緒被占滿讓使用者點了卻沒反應,AI 爬蟲乾脆連讀都讀不到,這三筆帳疊起來,對大多數以內容取勝的網站來說,通常划不來。
真正該做的判斷,不是要不要用框架,而是每一個頁面各自回答這個頁面需不需要被看到。需要被看到的內容,伺服器端算繪、程式碼分割這些做法已經很成熟,不必在互動體驗與被搜尋到之間二選一;不需要被索引的登入後應用,大可以把資源全部放在互動體驗上,不必假裝自己在做 SEO。分清楚這條線,才是控制這筆重量帳最划算的做法。