PDF 裡的表格看起來井然有序,其實更像一堆被釘在頁面座標上的文字,每個數字都知道自己落在頁面的哪個位置,卻沒有人記得它屬於第幾欄。這也是 PDF轉Excel 常常轉出一整排錯位資料的原因,轉檔工具讀到的只有座標,欄與列的邊界得靠它自己推測。
推測難免有猜錯的時候。框線不完整的表格,兩欄會被併成一欄;一格裡折成兩行的文字,會被拆到上下兩列;掃描來的 PDF 則更徹底,整頁其實是一張圖片,工具連字都讀不到。每一種狀況的處理方式都不一樣,用錯路線只會越整理越亂。
要避開這些錯位,得先弄清楚它們各自是怎麼發生的。
PDF轉Excel 後表格跑格的三種成因
PDF 檔案裡存的是「這個字放在頁面的哪個座標」,並不是一格一格的表格。Microsoft 的說明也提到,PDF 只記錄文字、圖片與圖形在頁面上的位置,表格存成一組線條,跟格子裡的內容沒有關聯。轉檔工具要把它變回儲存格,得先從文字的位置與頁面上的線條,推測哪裡是欄的邊界、哪裡是列的邊界。推測得準不準,取決於原本的表格留下了多少線索,跑格的狀況也就大致分成三種。
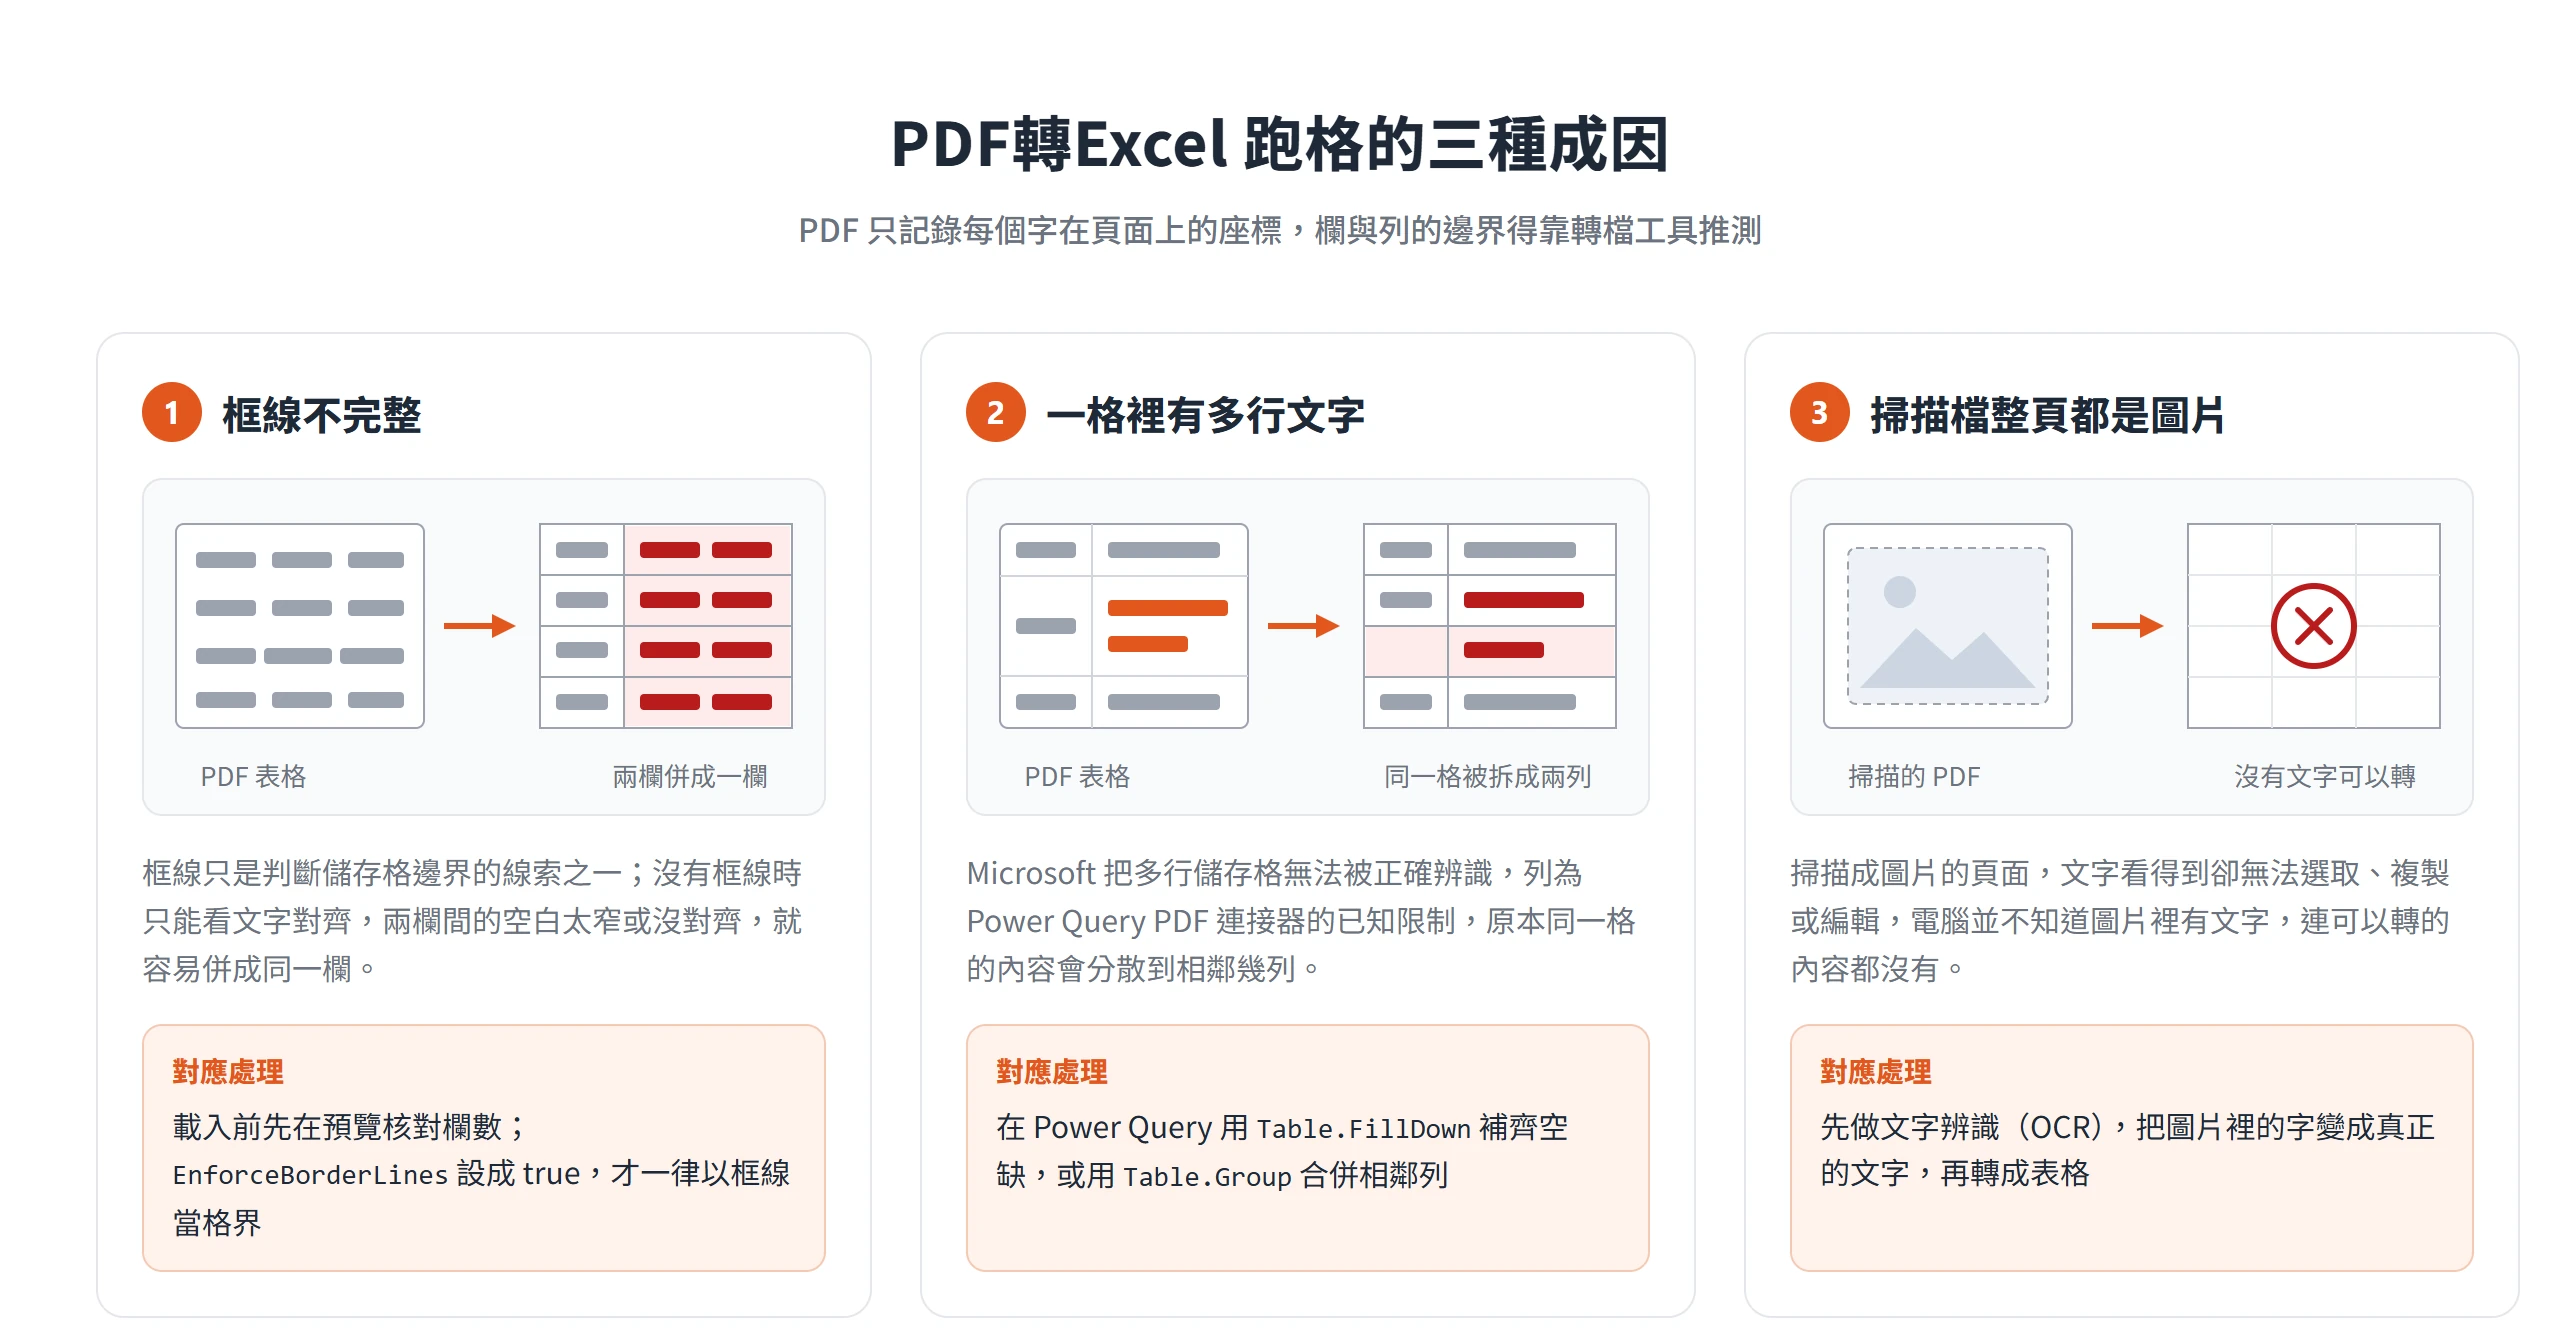
框線不完整,欄界只能靠文字對齊來猜。 Microsoft 的 Power Query 提供 Pdf.Tables 函式,其中有個 EnforceBorderLines 選項,預設值是 false,意思是框線只是判斷儲存格邊界的線索之一,並不保證一定照框線切;要設成 true,才會一律以框線當格界。換句話說,就算表格有框線,工具也可能不照線切。至於完全沒有框線的表格,就只剩文字的對齊位置可以參考,兩欄之間的空白太窄,或某幾列的文字沒有對齊,就容易被併成同一欄。
一格裡有多行文字,常被拆成多列。 Microsoft Learn 的 Power Query PDF 連接器說明,把多行儲存格有時無法被正確辨識,列為這個連接器的已知限制。說明裡建議的補救方式,是用 Table.FillDown 把錯位的資料補到相鄰列,或用 Table.Group 把相鄰列合併起來。從補救方式回推,原本屬於同一格的內容,就是被分散到了相鄰的幾列裡。
掃描檔整頁都是圖片,根本轉不出表格。 Adobe 的說明提到,掃描成 JPG 之類圖片的頁面,文字雖然看得到,卻無法選取、複製或編輯,因為電腦並不知道圖片裡有文字。這類檔案不是轉出來會跑格,而是在文字辨識(OCR)之前,連可以轉的內容都沒有。
三種成因對應的處理方式完全不同,所以動手之前,得先判斷手上這份 PDF 屬於哪一類。
文字型與掃描型 PDF 決定轉檔路線
分辨手上的 PDF 是哪一型,在閱讀器裡試一下就知道。拖曳選取表格裡的字,或搜尋表格裡的某個數字,選得到、搜得到,就是文字型;整頁只能被框選成一張圖,就是掃描型。文字型的檔案多半是電腦軟體直接輸出的,像報表系統匯出的 PDF;掃描型則是紙本用掃描器或手機拍下來再存成 PDF。
有些文件兩種都有。例如前面幾頁是系統匯出的報表,最後夾了幾頁簽回後掃描的附件,這種混合型的 PDF 要按頁分開處理,文字頁走文字型的路線,掃描頁另外先做文字辨識,不要整份一起丟進同一個工具。
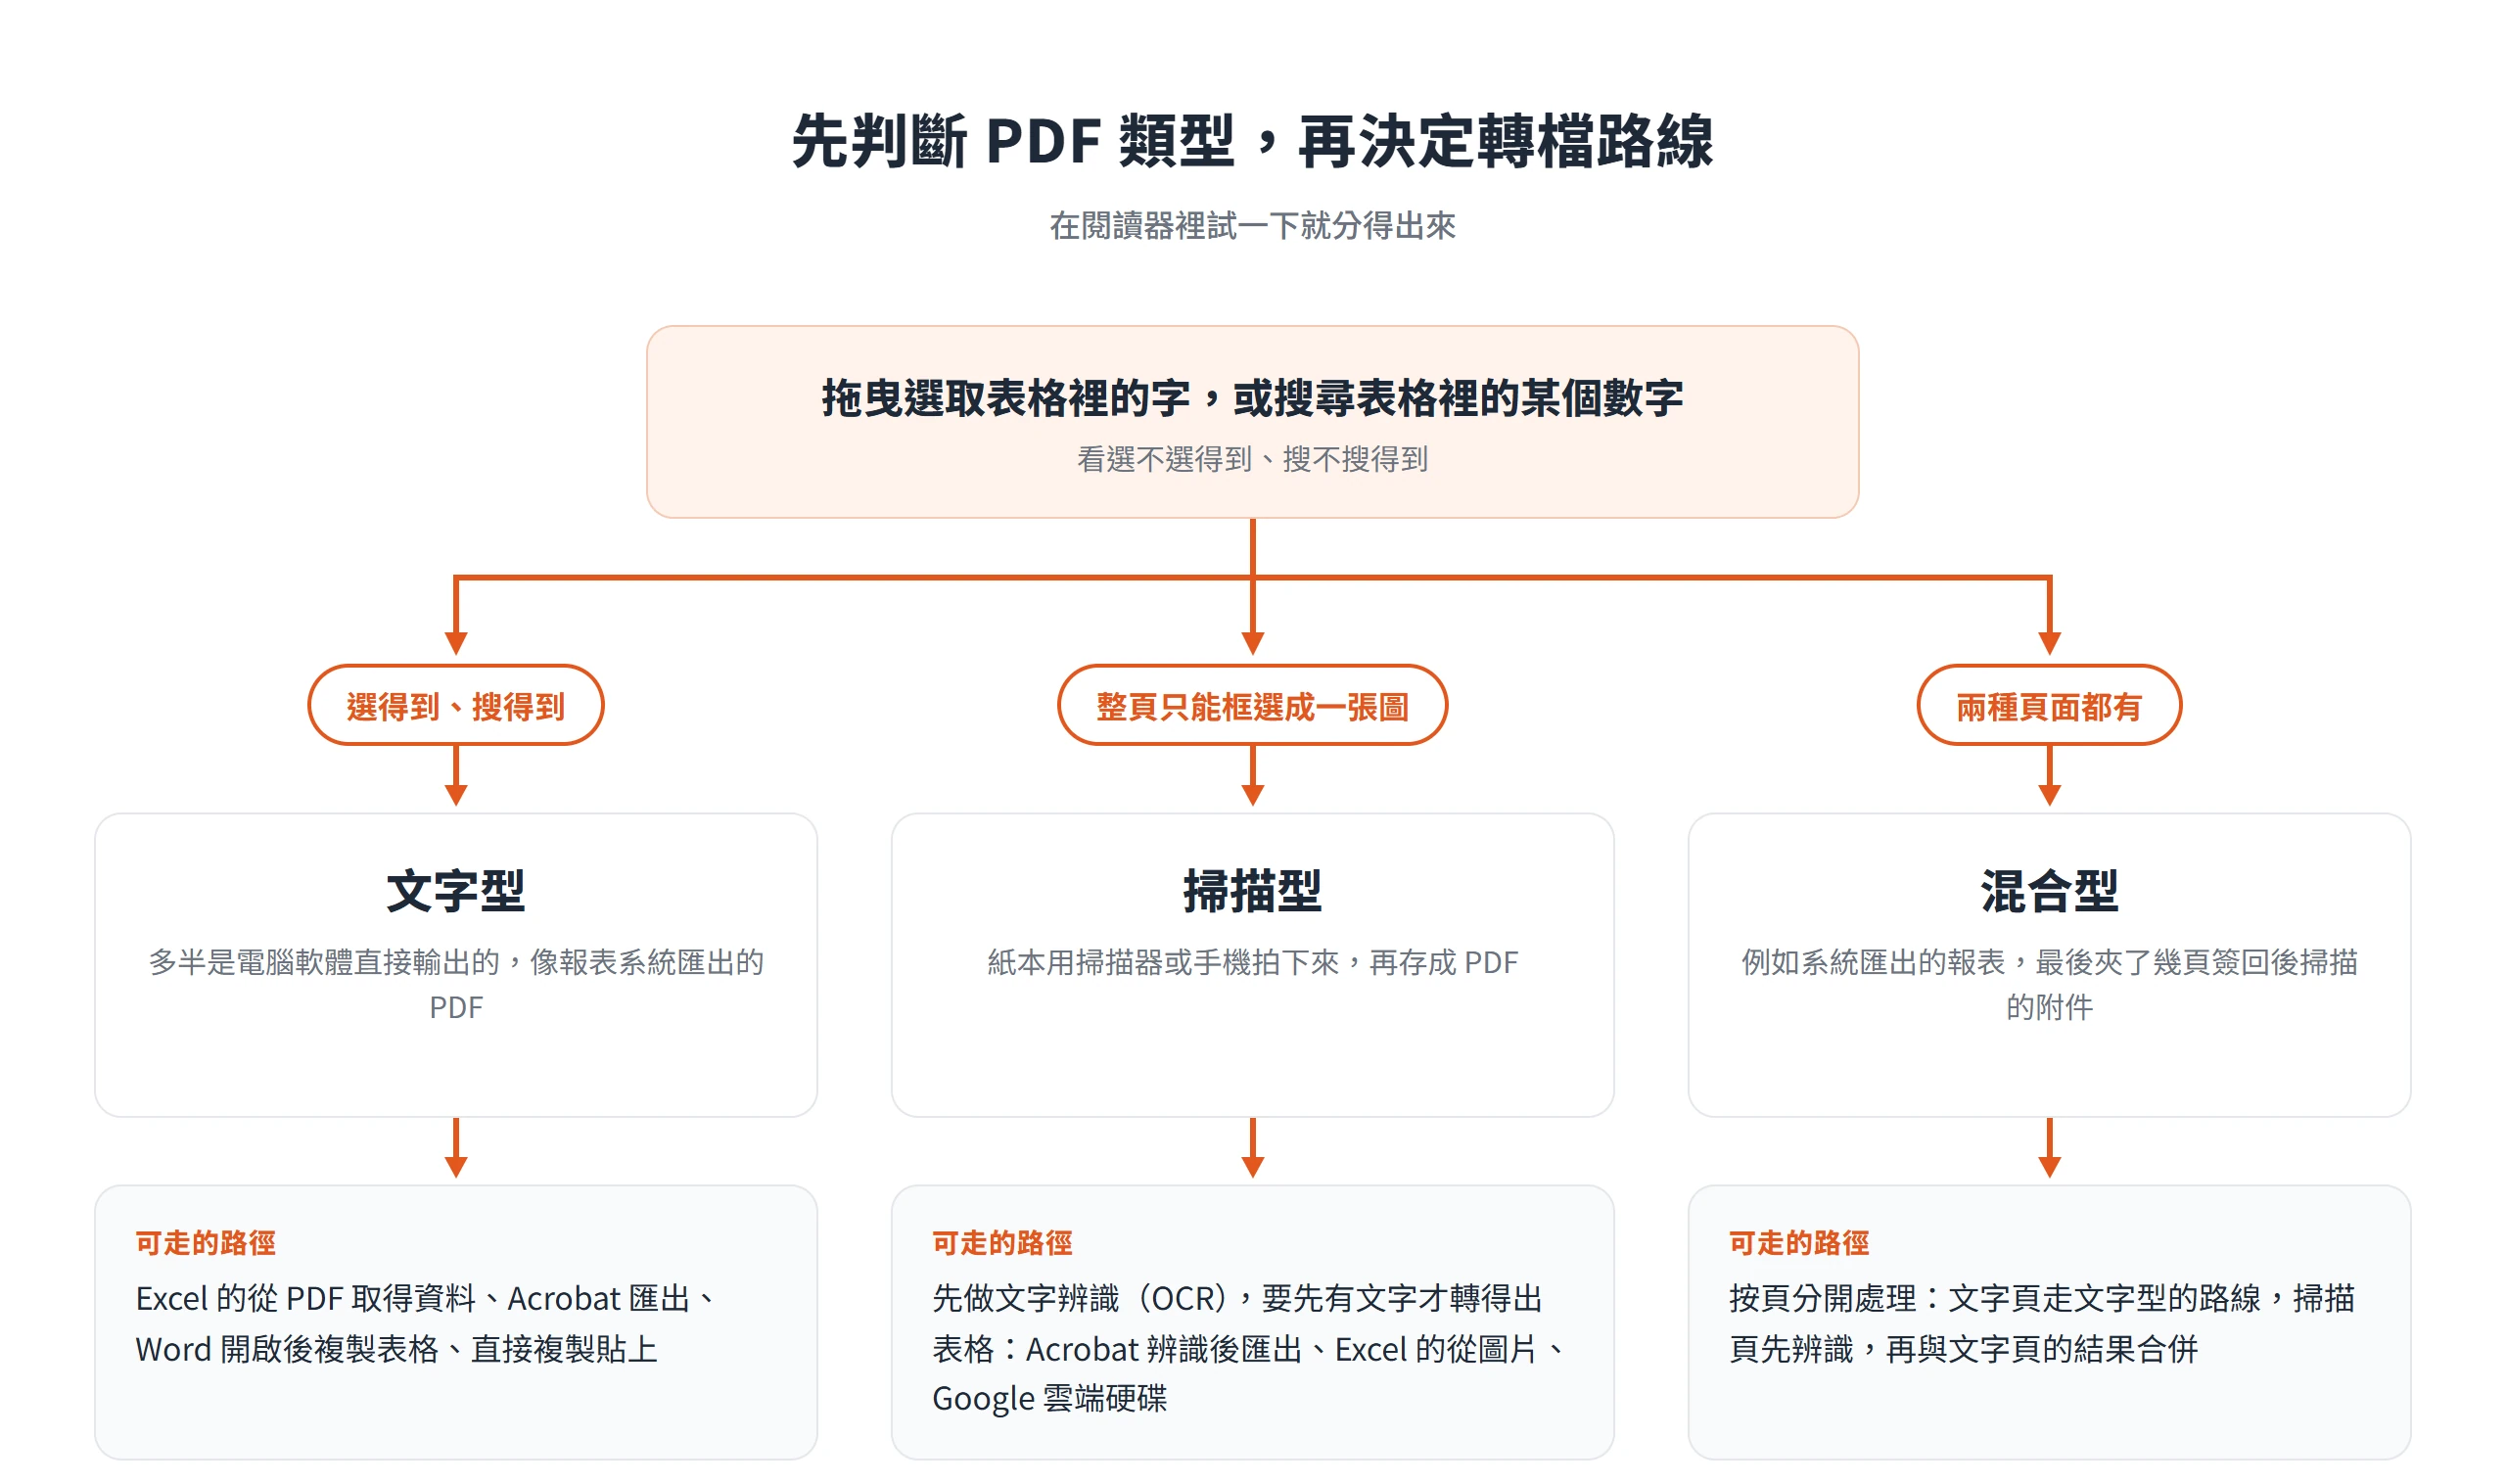
Adobe 的說明指出,掃描檔要轉成 Excel,得先做文字辨識。Acrobat 的流程是 Tools > Scan & OCR > Recognize Text,辨識完再走 Tools > Export PDF,選 Spreadsheet 當輸出格式;另外 Acrobat 匯出時,如果 PDF 含有掃描文字,也會自動執行文字辨識。各類型能走的路徑整理如下:
| PDF 類型 | 可走的路徑 | 需要留意的地方 |
|---|---|---|
| 文字型 | Excel 的從 PDF 取得資料、Acrobat 匯出、Word 開啟後複製表格、直接複製貼上 | 欄列由工具推測,轉完仍要核對 |
| 掃描型 | Acrobat 先辨識文字再匯出、Excel 的從圖片、Google 雲端硬碟轉成 Google 文件 | 要先有文字才轉得出表格,各條路對中文與表格的支援不同 |
| 混合型 | 依頁面性質拆開,文字頁與掃描頁各走各的路徑 | 先辨識掃描頁,再與文字頁的結果合併 |
Excel 內建的從 PDF 取得資料
文字型 PDF 最直接的一條路就在 Excel 裡,不必另外安裝軟體。Windows 版 Excel 的入口是資料 > 取得資料 > 從檔案 > 從 PDF,英文介面則是 Data > Get Data > From File > From PDF。選好 PDF 檔按開啟,會跳出 Navigator 對話方塊,列出可以匯入的表格。
這條路的好處,是資料進到工作表之前多了一道整理的機會。Navigator 選好內容之後,可以直接載入,也可以先進 Power Query 編輯器處理,欄位亂掉時,就在那裡補救,不必等到資料落進儲存格才動手。
在 Navigator 選表格或整頁再載入
Navigator 左邊的清單分成兩類項目。表格項目是工具已經切好欄列的結果,整頁項目則是把整頁內容攤開,點選任一項目,右側都會顯示預覽。一份 PDF 常會偵測出好幾個表格,只勾選需要的那幾個就好,不用全部載入。
載入之前,先在右側預覽看一下欄數對不對。欄數對不上,通常代表工具把兩欄併成一欄,或把一欄拆成兩欄,這時載入後再處理會比較費工。如果要的表格沒有出現在偵測結果裡,可以改選整頁項目,把內容攤開後自己整理。載入的方式有兩種,Load 會直接把資料放進工作表,Load To 則會開啟匯入對話方塊,讓你選擇放進哪一張工作表。
載入前先用 Power Query 清理欄位與頁首
在 Navigator 按 Transform Data 進入編輯器,比載入 Excel 後再手動刪改穩當,因為編輯器裡的每個動作都會被記成一個步驟。下次拿到同樣格式的 PDF,重新套用一次就能得到整理過的結果,不必每次從頭刪列。常見的動作有三個,移除報表的頁首與頁尾列、把第一列提升為標題、修正各欄的資料類型。
前面提到的多行儲存格被拆成多列,也是在這裡處理。Microsoft 的說明指出,這類辨識錯誤可以用介面操作或自訂 M 程式碼清理,Table.FillDown 負責把空缺補齊,Table.Group 負責把相鄰列合併。介面操作同樣做得到這兩件事,不必先學會寫 M 程式碼。
長篇 PDF 的頁數範圍與跨頁表格設定
幾十頁的報表容易逾時,連續頁面的表格也可能被接錯。要處理這類情況,得在公式列或進階編輯器裡修改 Pdf.Tables 的選項。這是少數需要碰公式的地方,只要知道每個選項管什麼就夠了:
StartPage與EndPage:限定要檢查的頁數範圍,預設從第 1 頁到最後一頁。MultiPageTables:控制連續頁面上相似的表格是否自動合併成一張,預設是 true。EnforceBorderLines:控制是否一律以框線當儲存格邊界,預設是 false。Implementation:辨識表格所用的演算法版本,舊版只是為了讓既有的查詢維持相容而保留,依 Microsoft 的說明,新版通常能得到最好的結果。
針對大型 PDF,Microsoft 給了兩個策略。第一個是一次只處理一頁或一小段頁數,再反覆處理,直到跑完整份文件。第二個針對整份 PDF 只有一張超大表格的情況,這時 MultiPageTables 可能累積出很大的中間值,把它關掉有機會改善。
找不到從 PDF 選項時,先查 Office 版本與 .NET 元件
資料功能表裡找不到「從 PDF」,先從 Office 的版本查起。在 Microsoft 整理的 Power Query 資料來源對照表裡,PDF 連接器只標示支援 Microsoft 365 訂閱版,Office 2016 與 Office 2019 的買斷版本都不在其中。因此第一步是確認自己用的是不是 Microsoft 365,確認之後再把 Office 更新到最新版本。
另一種情況是載入時出現訊息,大意是這個連接器需要先安裝一或多個其他元件。Microsoft 的說明指出,PDF 連接器需要 .NET Framework 4.5 或更新的版本,裝好再重新載入即可。如果檢查完版本與更新仍然沒有這個選項,就改走後面的 Acrobat 或 Word 路線,不必在這一步耗費時間。
Acrobat 匯出 Excel,桌面版需付費方案、網頁版免安裝
Acrobat 能處理文字型與掃描型兩種 PDF,Windows 與 Mac 版都有。不過依 Adobe 的方案說明,免費的 Acrobat Reader 主要用來檢視、列印、分享與註解,桌面版要匯出 Excel,得用付費的 Acrobat Standard、Acrobat Pro,或另外訂閱 Acrobat Export PDF。免安裝的線上轉檔頁則是另一個入口,使用條件也不一樣。
Acrobat 的匯出會依 PDF 的內容重建欄與列,這個重建仍然是推測的結果,匯出之後一樣要核對欄位有沒有錯位。要整份匯出還是只匯出選取範圍,就看 PDF 裡真正需要的內容佔多少。
把整份 PDF 匯出成 Excel 活頁簿
依 Adobe 的說明,整份匯出的步驟如下:
- 在 Acrobat 開啟要轉換的 PDF。
- 點選右側窗格的 Export PDF 工具。
- 選擇 Spreadsheet 當作匯出格式。
- 選擇 Microsoft Excel Workbook。
- 按下 Export。
- 替檔案命名,再按 Save 存檔。
Adobe 較新的桌面版說明頁寫的入口不同,改從上方工具列的 Convert 進入,在左側選 Microsoft Excel、從下拉選單選 XLSX,再按 Convert to XLSX 存檔。畫面是哪一種,看手上的 Acrobat 版本而定,兩種入口做的是同一件事。
匯出之前,先用前面的判斷方法確認這份 PDF 是文字型還是掃描型。含有掃描文字的 PDF,Acrobat 在匯出時會自動執行文字辨識,不過繁體中文的掃描表格得先指定辨識語言,否則辨識引擎無法正確讀出文字。
在 Acrobat 只匯出選取的表格範圍
如果 PDF 裡只有一張表要用,其餘都是說明文字,不必整份轉完再一列一列刪。Acrobat 可以用 Select 工具框住要的內容,按右鍵選 Export Selection As,在 Save As Type 清單選擇格式,再按 Save。依 Adobe 的說明,選取後可以存成的格式有 DOCX、DOC、XLSX、RTF、XML、HTML 與 CSV。
這種做法讓工具要處理的版面範圍變小,需要推測的欄列也變少,轉出來夾帶的多餘內容比整份匯出少,跑格的機會自然跟著降低。只想要純資料的話,格式選 CSV 會得到不帶格式的文字檔,再用 Excel 開啟即可。
Acrobat 線上轉檔頁的使用條件
Adobe 另外提供免安裝的網頁版 PDF轉Excel 入口,頁面寫明任何瀏覽器都能使用,Mac、Windows、Linux、iOS 與 Android 都適用。流程是點選 Select a file,或把 PDF 直接拖進頁面,選好檔案後 Acrobat 會自動轉換,轉完就能下載。登入之後,可以分享轉好的 XLSX,也能直接在 Excel 網頁版編輯。
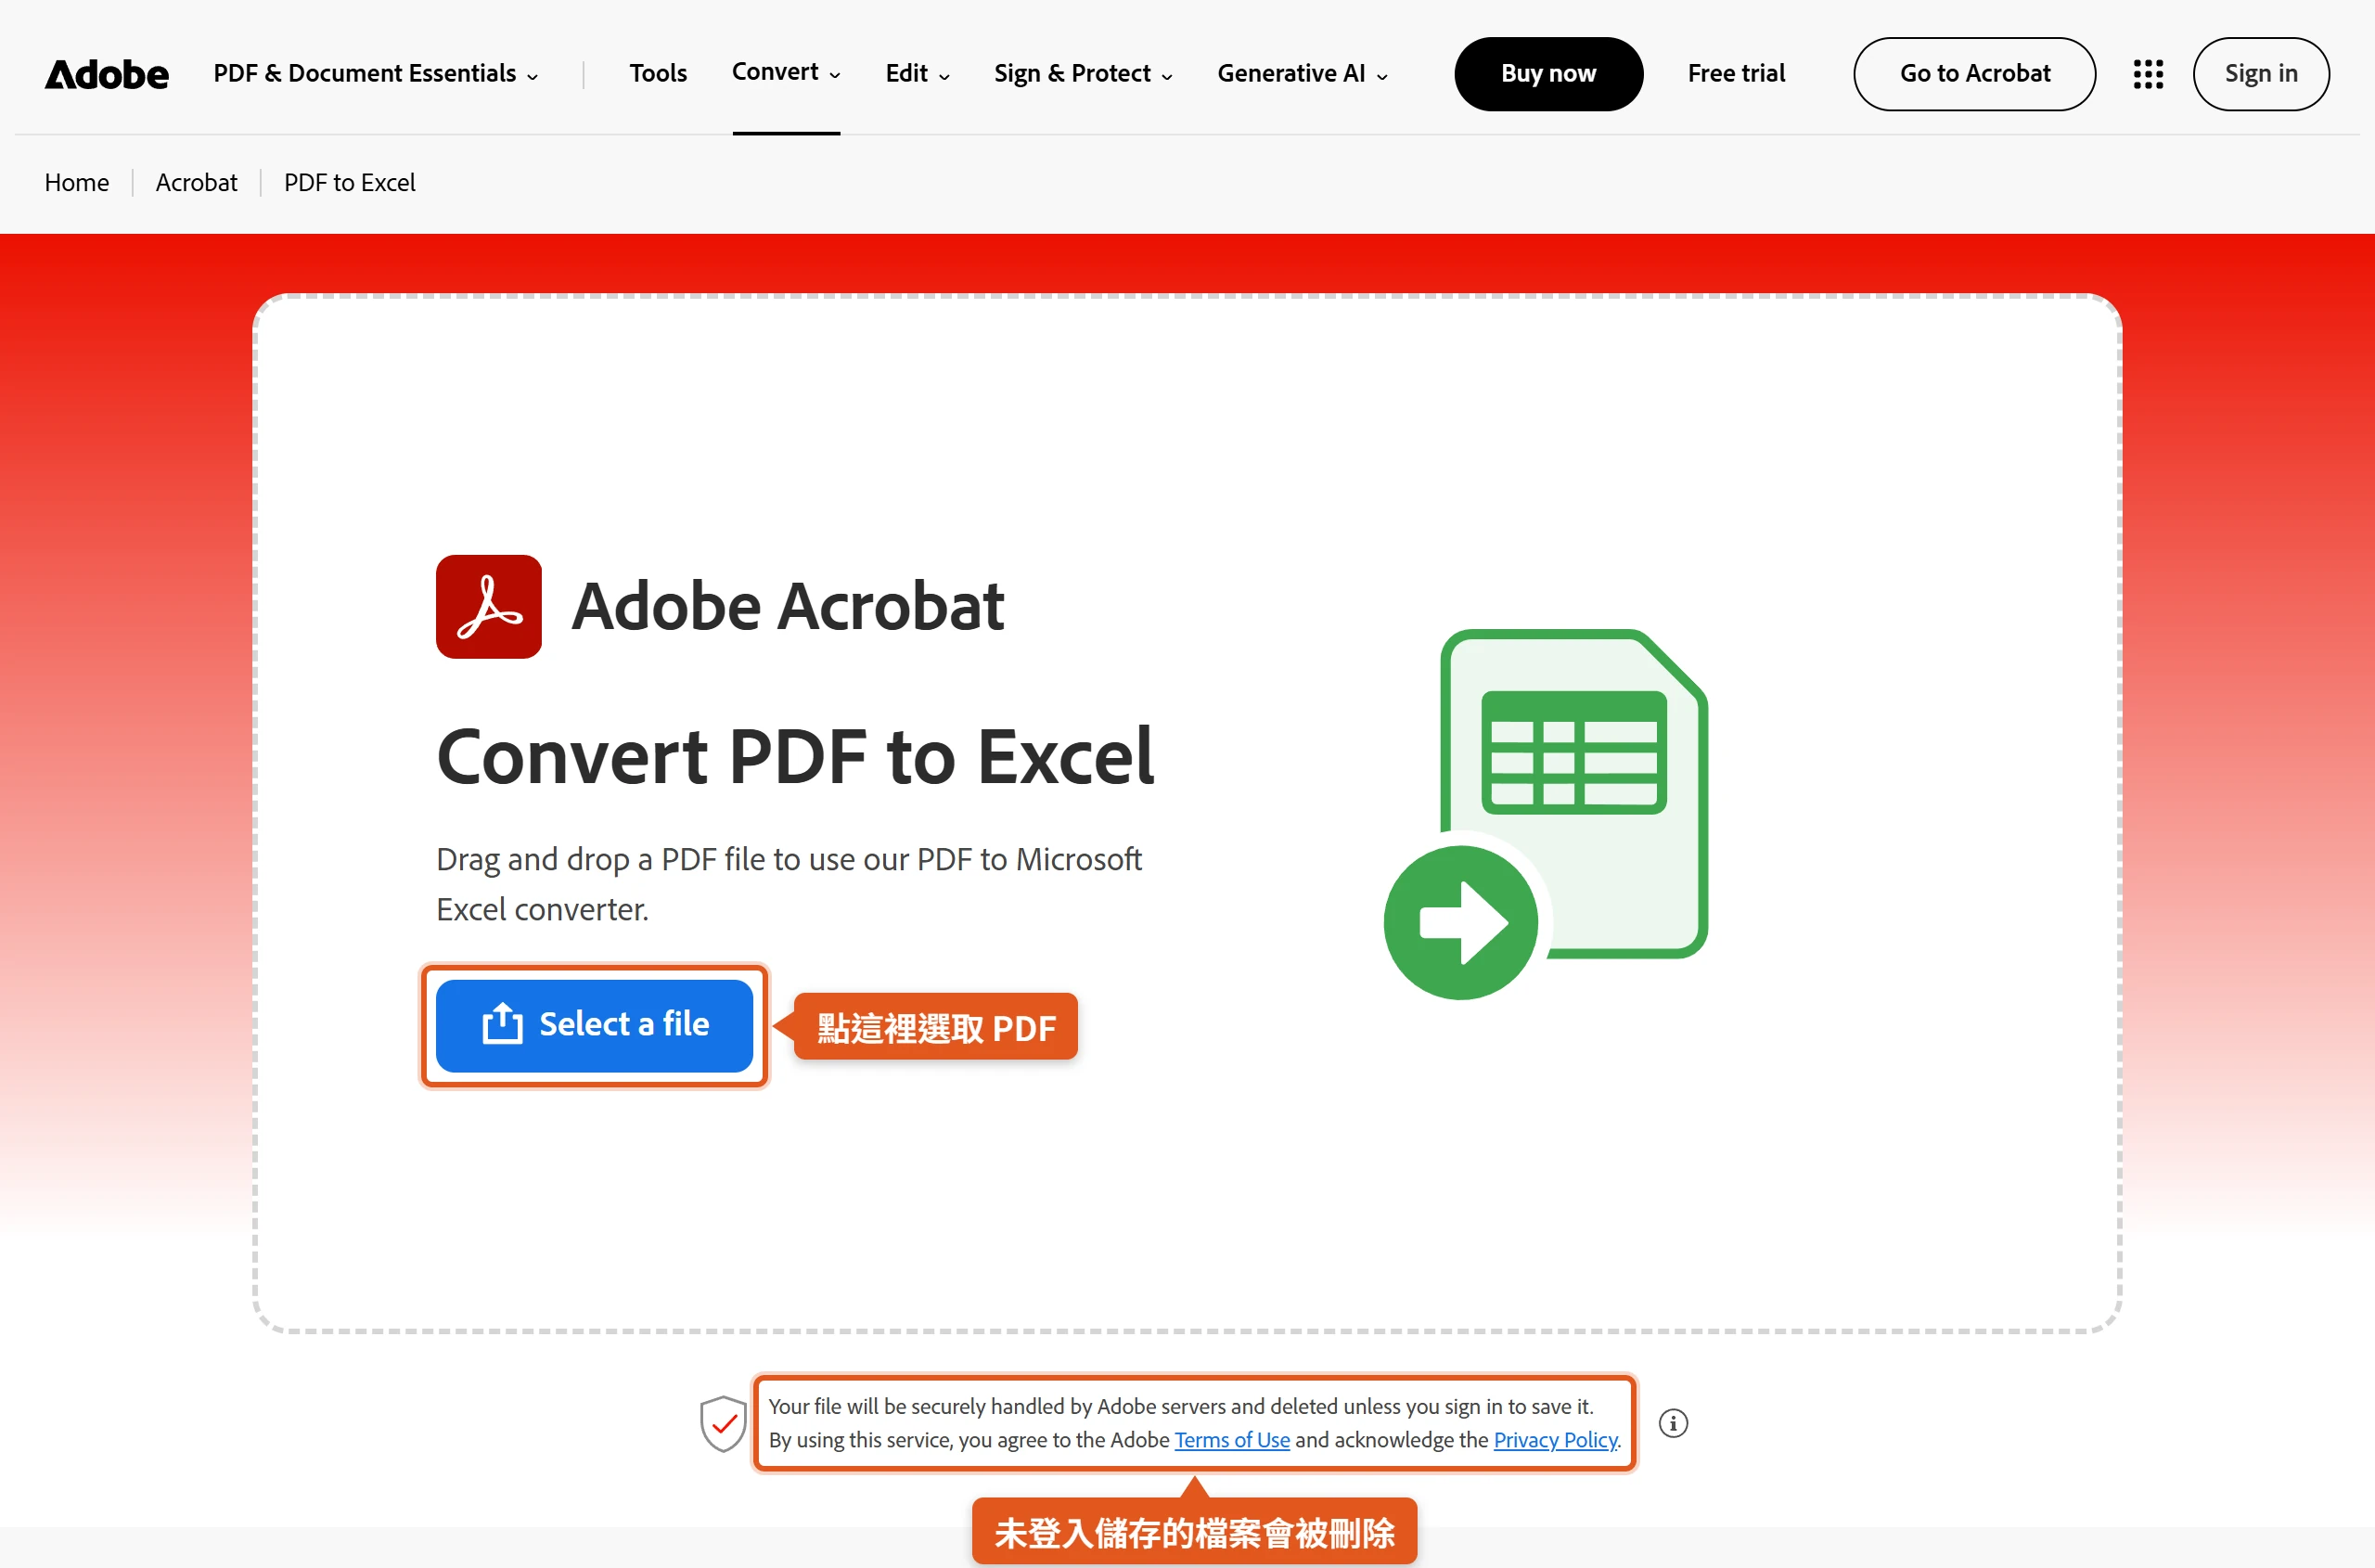
不過線上工具會把檔案上傳到 Adobe 的伺服器處理,等於讓檔案離開自己的電腦,含個資或內部財報的 PDF,要自己斟酌適不適合上傳。頁面提到,沒有登入儲存的檔案會在處理完後刪除;登入的另一個好處,是可以試用 25 種以上的工具。額度與上傳大小限制頁面上沒有寫明,使用前以實際畫面的提示為準。
沒有 Acrobat 時,改用複製貼上或 Word 開啟 PDF
不想碰 Power Query,手邊又沒有 Acrobat 的時候,還有兩條不需要額外軟體的路。第一條是直接在 PDF 閱讀器裡選取表格,複製後貼進 Excel。Microsoft 的說明指出,這樣通常只會得到沒有格式的純文字,所以只適合很小、很單純的表,欄位一多或內容有換行,貼進來多半要重新整理。
第二條是先用 Word 開啟 PDF。Word 開啟 PDF 時,會先複製一份並轉換成可以編輯的文件,判斷哪些內容該變成標題、清單或表格,並盡量保留原本的版面。Microsoft 介紹這項功能的說明頁,列出的適用版本涵蓋 Microsoft 365 與 Word 2016 之後的買斷版。同一份說明也把「有儲存格間距的表格」列為不容易轉好的元素,所以轉完要先檢查表格有沒有走樣,確認沒問題,再把 Word 裡的表格複製進 Excel。
這兩條路有一個共同的限制,就是都不處理掃描檔。掃描檔裡沒有可以複製的文字,所以遇到這類檔案,還是得先做文字辨識。
掃描檔要先做文字辨識才轉得出表格
掃描檔是圖片,不管走哪一條路,第一步都是把圖片裡的字辨識成真正的文字。辨識的品質取決於掃描的品質,解析度太低、頁面歪斜、光線不均,辨識結果都會變差,所以能重新掃描的話,先把原稿掃清楚。
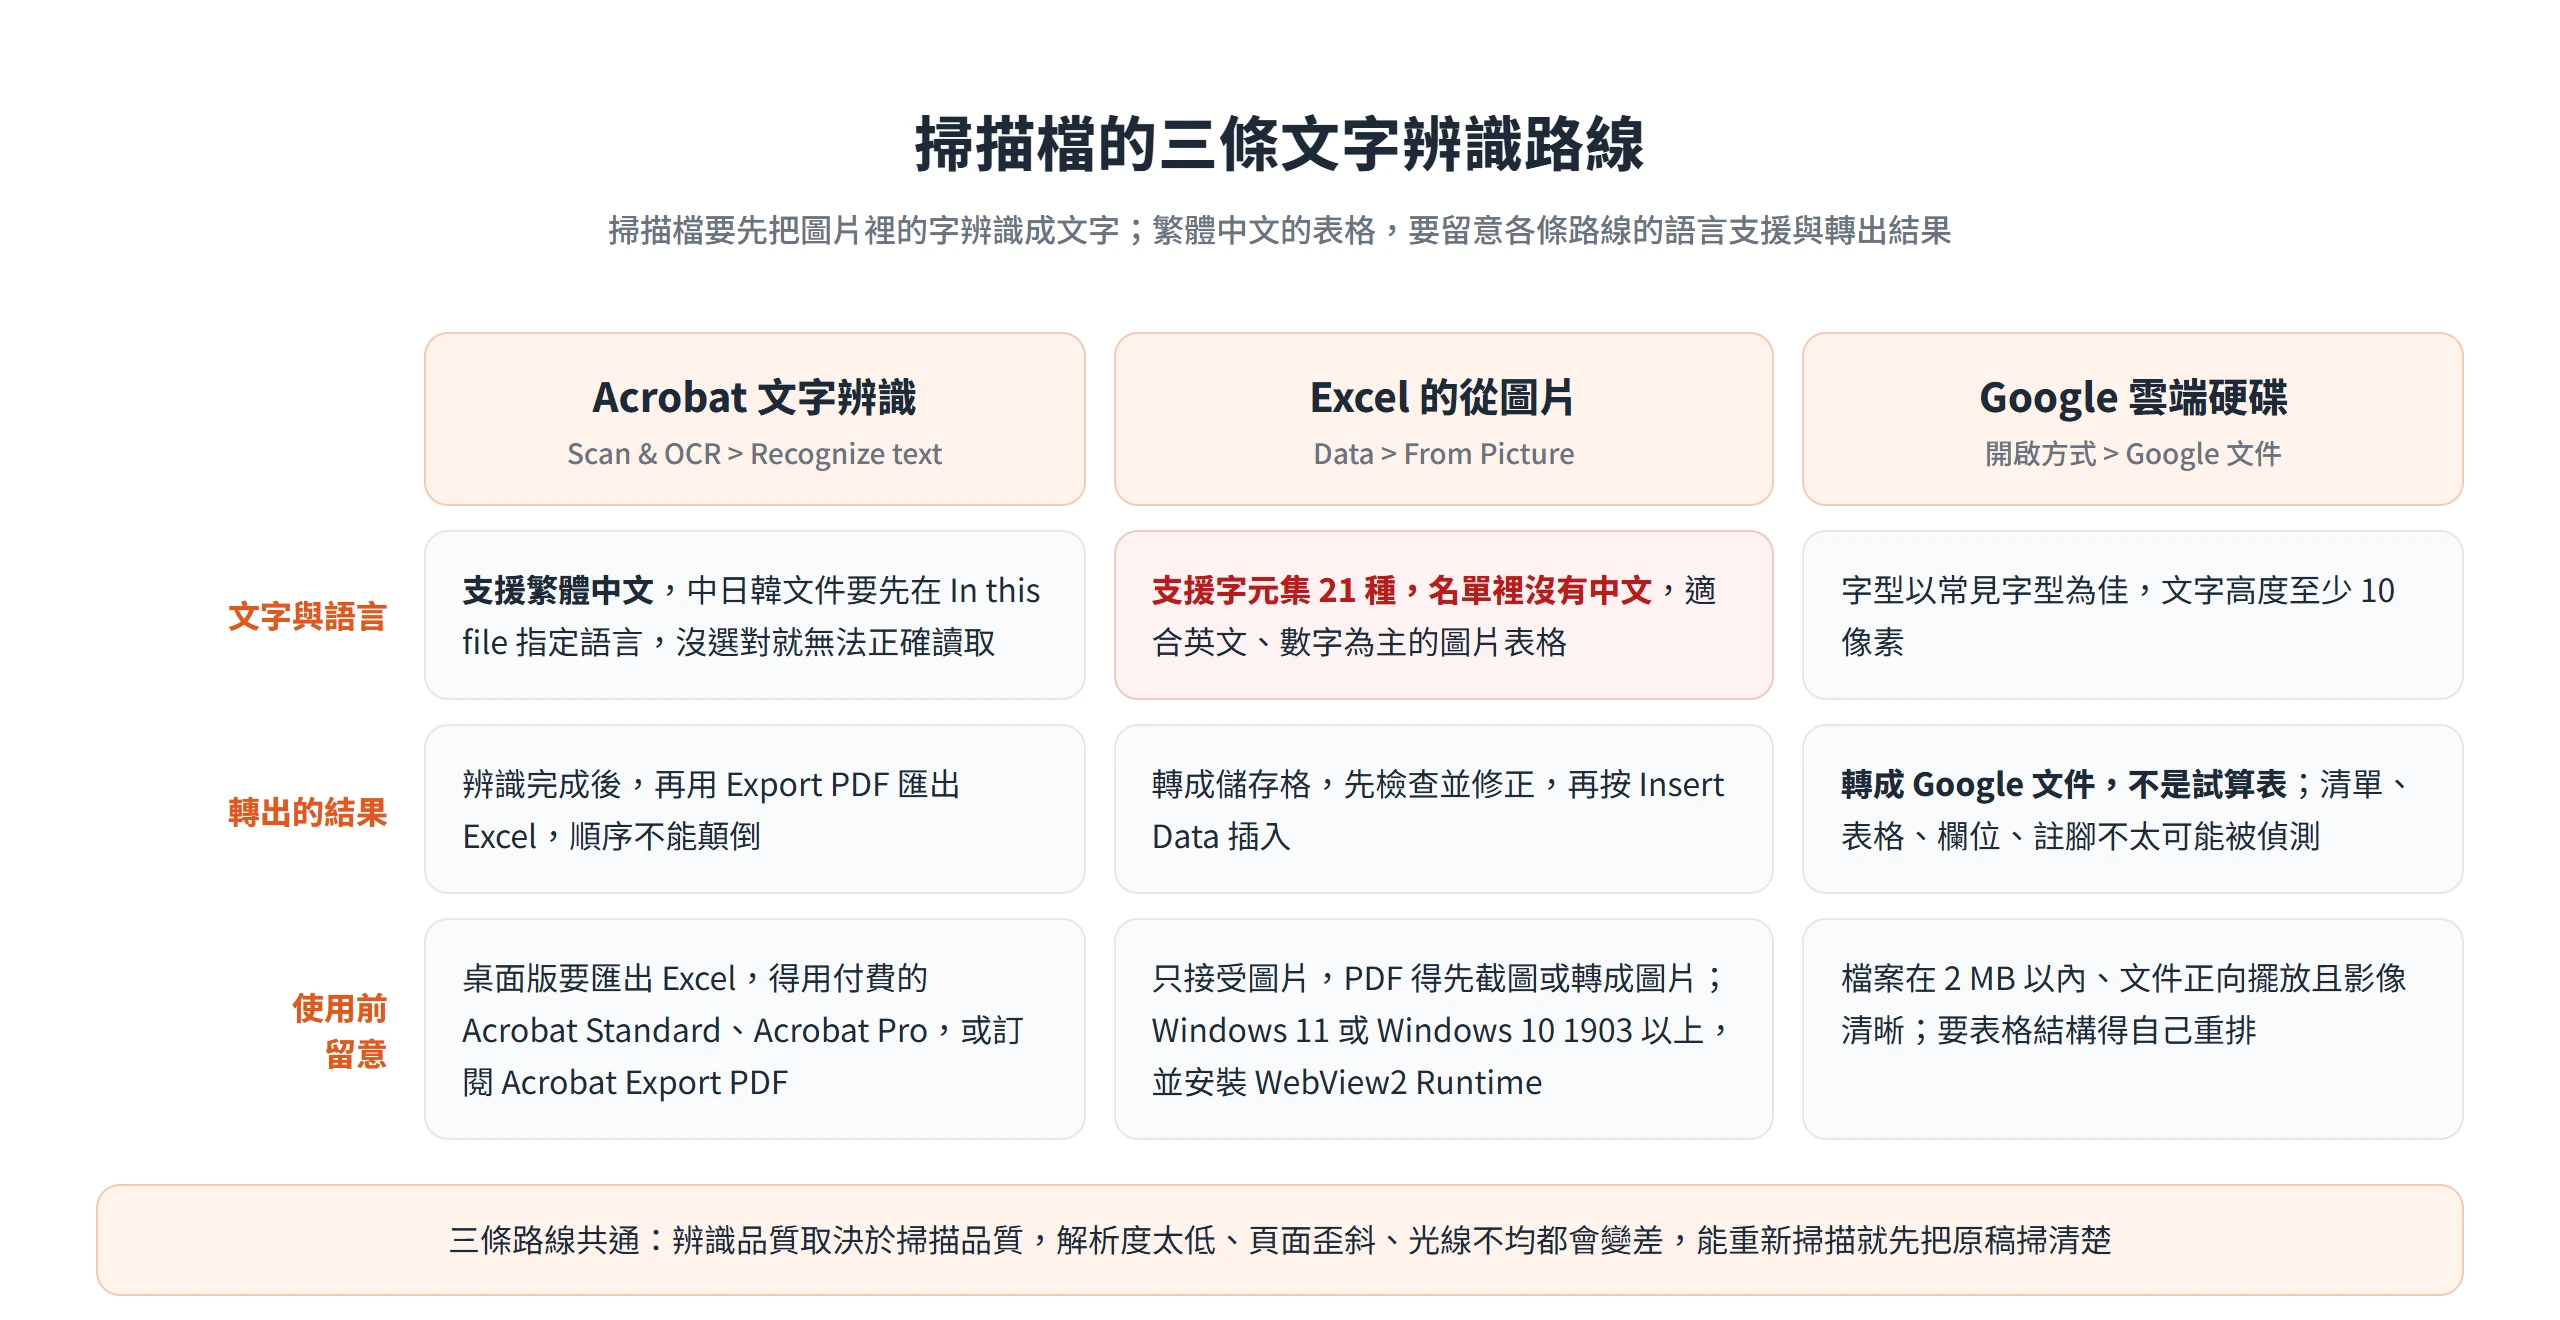
繁體中文的表格尤其需要留意工具的語言支援,三條常見的路線差異不小。
Acrobat 辨識文字時先指定語言
Acrobat 的文字辨識支援繁體中文,不過中文、日文、韓文這類非拉丁語系的文件,要先指定語言再執行。Adobe 的說明寫得很直接,沒有選對語言,辨識引擎就無法正確讀取或轉換文字。設定的位置在 Scan & OCR 窗格的 Recognize text 底下,選 In this file,再從清單選擇語言。
辨識完成之後,才用前面介紹的 Export PDF 匯出 Excel,順序不能顛倒。
Excel 的從圖片功能不支援中文字元集
不少教學會建議用 Excel 的「從圖片」功能(Data From Picture),把圖片裡的表格直接轉成儲存格。不過 Microsoft 的說明列出的支援字元集,是英文、荷蘭文、德文、法文、西班牙文、土耳其文等 21 種,名單裡沒有中文。所以英文、數字為主的圖片表格可以用,繁體中文的表格則不適用。
使用條件上,Windows 版需要 Windows 11,或 Windows 10 1903 以上的版本,並安裝 Microsoft Edge WebView2 Runtime。入口在 Data > From Picture,可以選 Picture From File 或 Picture From Clipboard。這個功能只接受圖片,PDF 得先截圖或轉成圖片檔;圖片內容最好只包含要匯入的資料,拍攝角度正對、不傾斜。辨識完成後,Excel 會讓你先檢查並修正,再按 Insert Data 插入。
Google 雲端硬碟的 OCR 只適合擷取純文字
Google 雲端硬碟也能做文字辨識。在雲端硬碟對 PDF 或圖片按右鍵,選開啟方式 > Google 文件,就會用 OCR 轉成文字,轉出來的是 Google 文件,不是試算表。粗體、斜體、字級、字型與換行大致會保留,但依 Google 的說明,清單、表格、欄位、註腳不太可能被偵測到。
所以這條路只適合擷取純文字。使用時還有幾項條件,檔案需在 2 MB 以內、文字高度至少 10 像素、文件正向擺放且影像清晰,字型以常見字型為佳。需要表格結構的話,轉完仍得自己重排,或改走 Acrobat 的做法。
轉進 Excel 後的欄位與數字整理
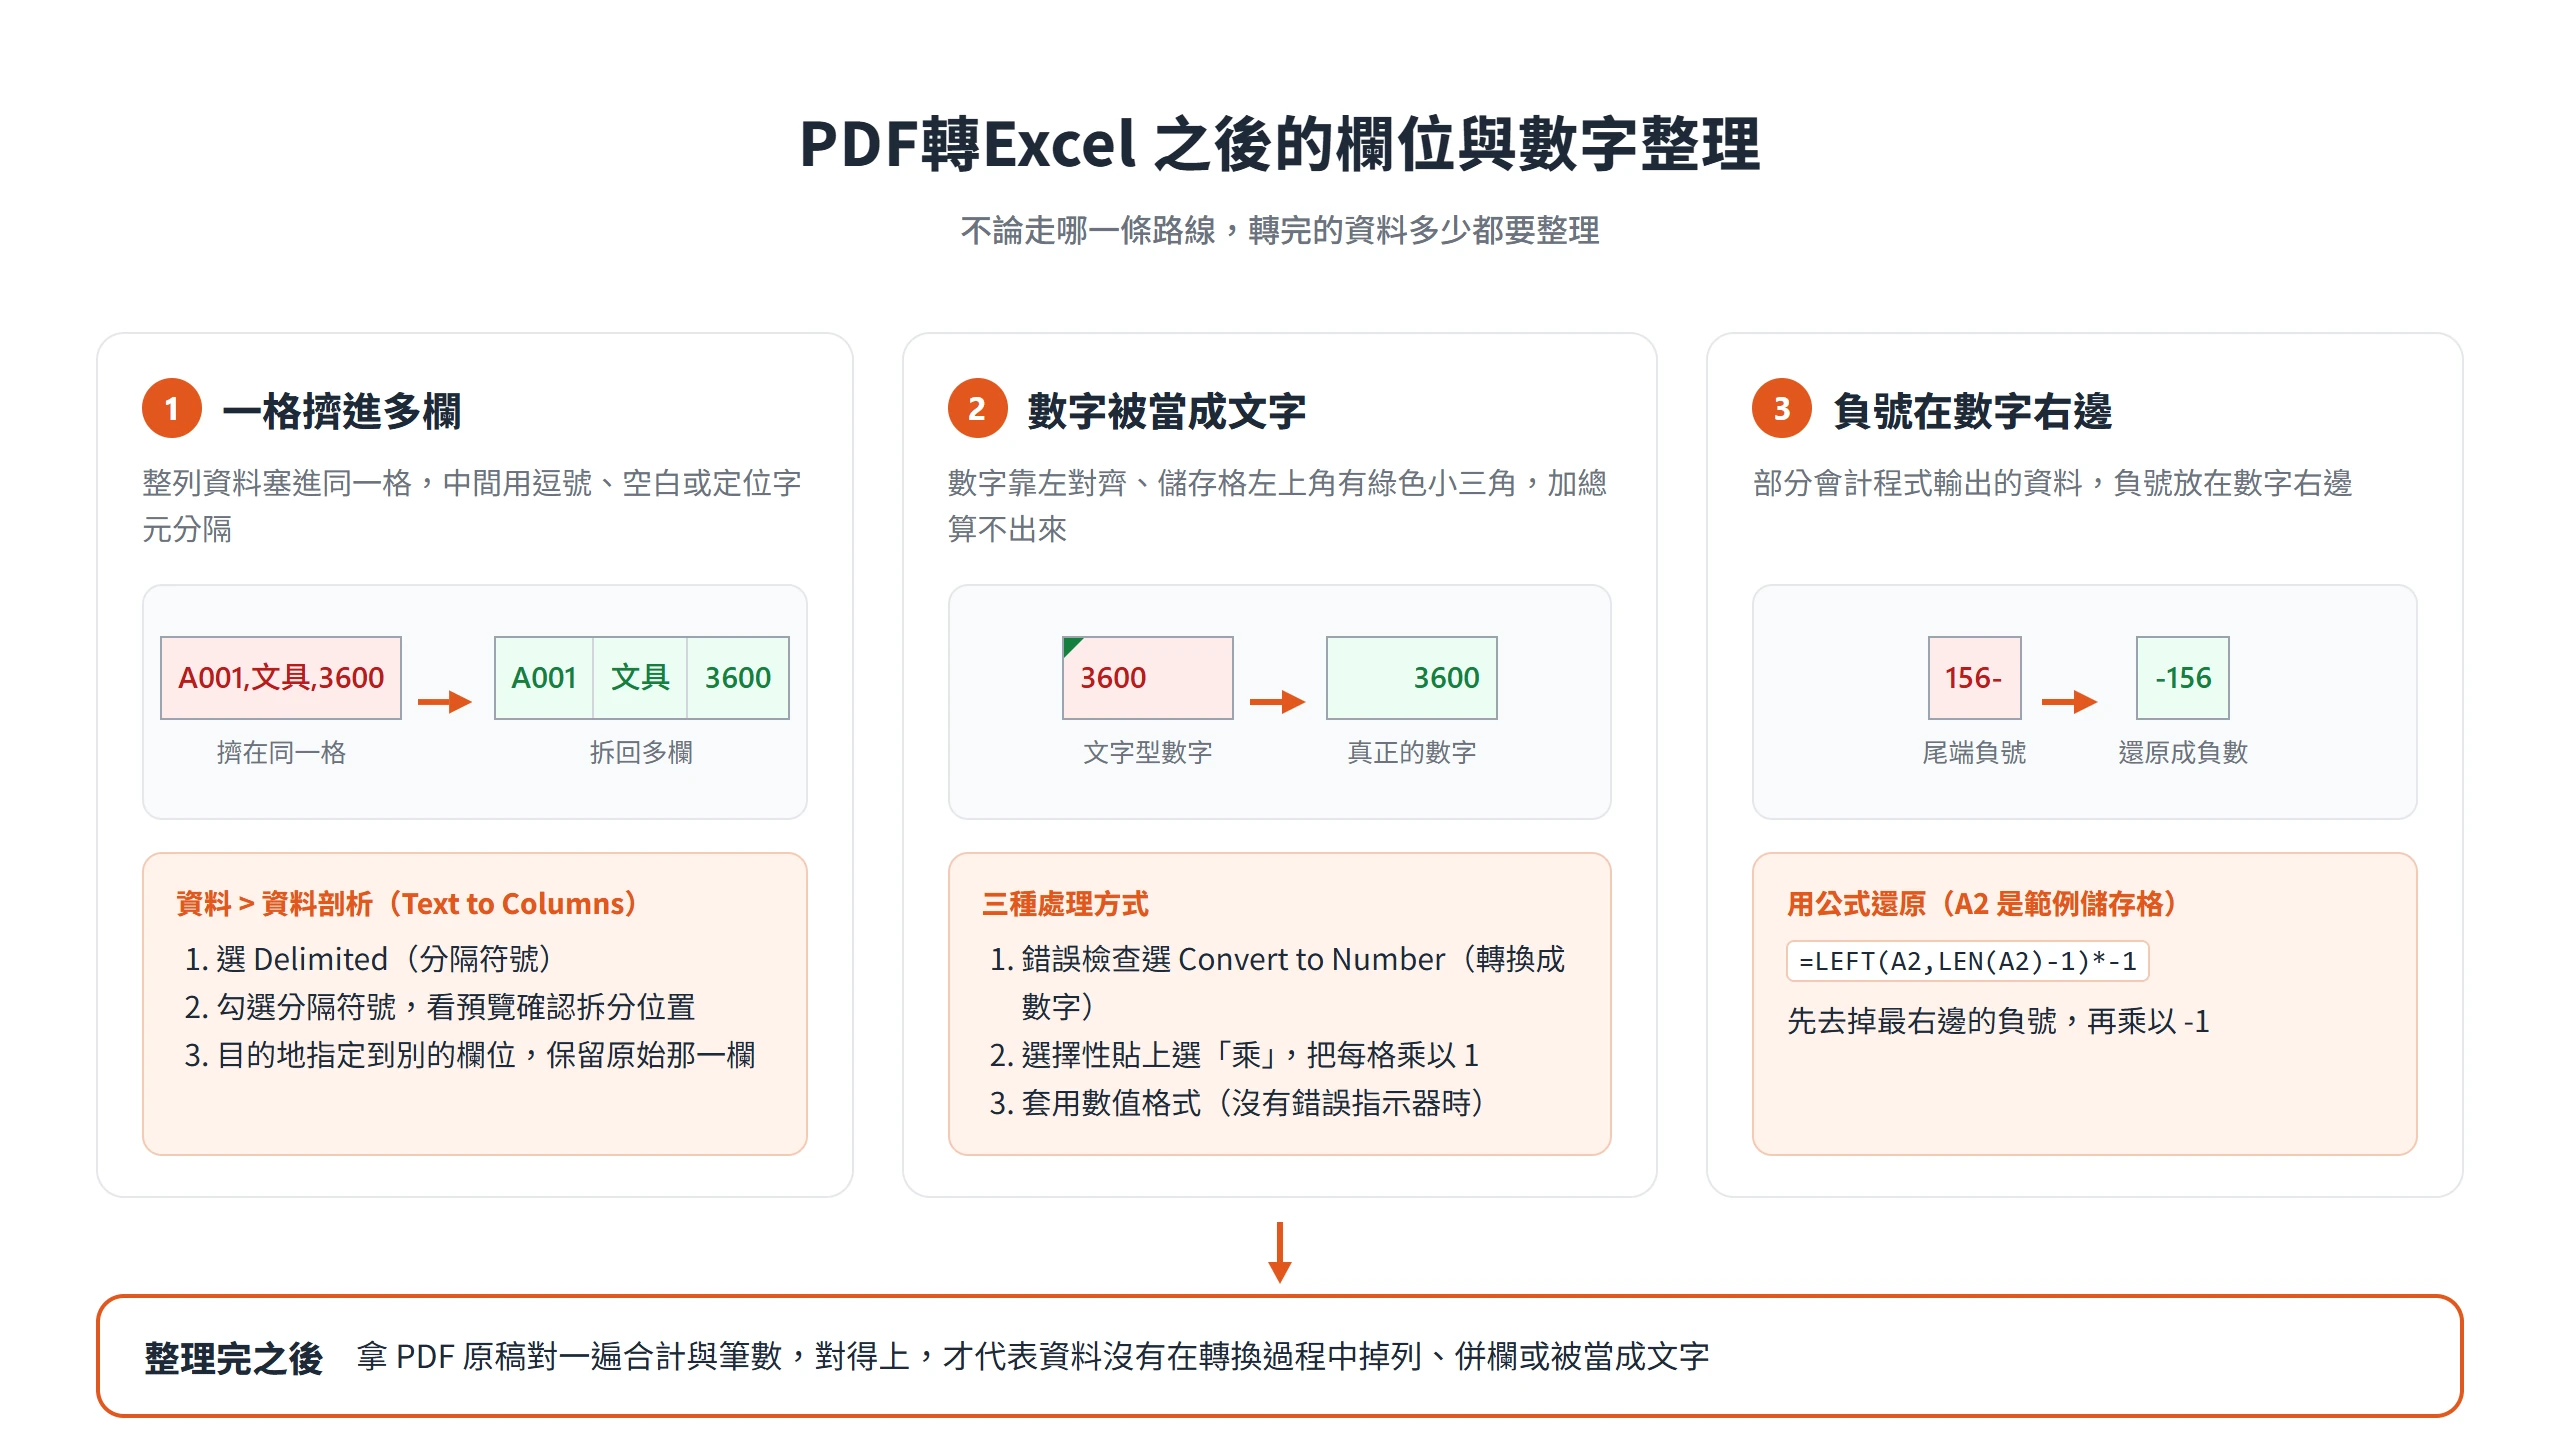
不論走哪一條路,轉完的資料多少都要整理。最常見的善後有兩種,一種是整列資料擠在同一格,另一種是數字被當成文字。
整理完之後,建議拿 PDF 原稿對一遍合計與筆數。加總和筆數對得上,才代表資料沒有在轉換過程中掉列、併欄或被當成文字。
一格擠進多欄時用資料剖析拆開
複製貼上或某些轉檔工具,會把一整列資料塞進同一格。如果資料之間有逗號、空白或定位字元當分隔,可以用資料 > 資料剖析(Text to Columns)拆回多欄。依 Microsoft 的說明,精靈的操作如下:
- 選取要拆分的儲存格或整欄,到資料 > 資料剖析。
- 第一步選 Delimited(分隔符號),按 Next。
- 第二步勾選分隔符號,例如逗號或空白,並看預覽視窗的結果,確認拆分的位置合理。
- 第三步選擇目的地,再按 Finish。
預覽視窗是這個精靈最有用的地方,可以先看拆開後的樣子,不對就換一個分隔符號。目的地則建議指定到別的欄位,避免拆分後的資料覆蓋掉原本的內容,原始那一欄留著,萬一拆錯還可以重來。
文字型數字與尾端負號的轉換
轉進來的金額常常是靠左的「文字」,加總算不出來。辨識的線索有兩個,一是數字靠左對齊,而不是靠右;二是儲存格左上角有綠色小三角,那是 Excel 的錯誤指示器。文字型數字會讓計算與排序出錯,所以轉完的表格只要有金額欄,這一項都該先檢查。
Microsoft 的說明提供三種處理方式:
- 用錯誤檢查:選取受影響的儲存格,點出現的錯誤按鈕,選 Convert to Number(轉換成數字)。
- 用選擇性貼上乘以 1:先在空白儲存格輸入 1 並複製,選取目標範圍,再用選擇性貼上選「乘」,等於把每格內容乘以 1,文字就被強制轉成數字。
- 套用數值格式:沒有錯誤指示器時可以改套數值格式,前提是這些數字沒有多餘的空格或看不見的字元。
另外有一種情況,是部分會計程式輸出的資料把負號放在數字右邊,例如 156-。這種資料可以用公式 =LEFT(A2,LEN(A2)-1)*-1 還原,A2 是範例儲存格,公式先去掉最右邊的負號,再乘以 -1,就能把 156- 還原成 -156。
PDF轉Excel 轉得出來只是第一步,轉完的資料能不能直接拿去加總、排序、做樞紐分析,才決定這份表格有沒有真的派上用場。先判斷 PDF 是文字型還是掃描型,再挑對應的路線,轉完照著拆欄、修正數字格式,錯位與格式問題就能在進入分析之前先處理掉。