
評估要不要用 SPA 架構,常見的問法是「使用者切換頁面順不順、要不要整頁重新整理」;但對內容型網站來說,真正該先問的是「搜尋引擎與 AI 摘要看不看得到這篇內容」。
部落格、媒體站、形象網站存在的目的,就是被搜尋引擎找到、被讀者點進來,也被 AI 工具在整理答案時引用。這件事的確定性,不該讓給瀏覽器端的 JavaScript 有沒有順利執行完。
內容型網站不該整站做成純用戶端算繪的單頁應用
單頁應用(Single Page Application,SPA)與純用戶端算繪(Client-Side Rendering,CSR)是兩件不同的事。SPA 是瀏覽器端用 JavaScript 動態組裝畫面的架構,好處是切換頁面不必整頁重新載入,操作起來像應用程式一樣順;CSR 則是伺服器第一時間只回應一個近乎空白的容器,真正的文字內容要等瀏覽器把整包 JavaScript 下載、執行完才會補上去。內容型網站,包括部落格、媒體站、形象網站,存在的目的是被搜尋引擎找到、被讀者點進來、也被 AI 工具在整理答案時引用,這個目的看的是能見度與可索引性,不是切頁流不流暢。
這篇要反對的不是 SPA 技術本身,是「拿純 CSR 當整站唯一的算繪方式」這個選擇。站內搜尋框、留言區、篩選器、後台儀表板這些本來就不需要被個別網址收錄的局部功能,用 SPA 式的互動完全沒問題;真正扛住排名與 AI 引用的文章頁、分類頁,才是要盯住的對象。
立場也不是全有全無。用 SSR 或 SSG 打底、技術上刻意不靠自然搜尋獲客,或是只在局部元件用 SPA 這幾種情況,都能讓這個立場反過來成立。問題不是 SPA 做不到,而是中間多了一關不完全由自己掌控的排隊,轉譯排進檢索流程的哪個位置,決定了這關風險有多大。
轉譯排在檢索之後,內容曝光多了一層排隊變數
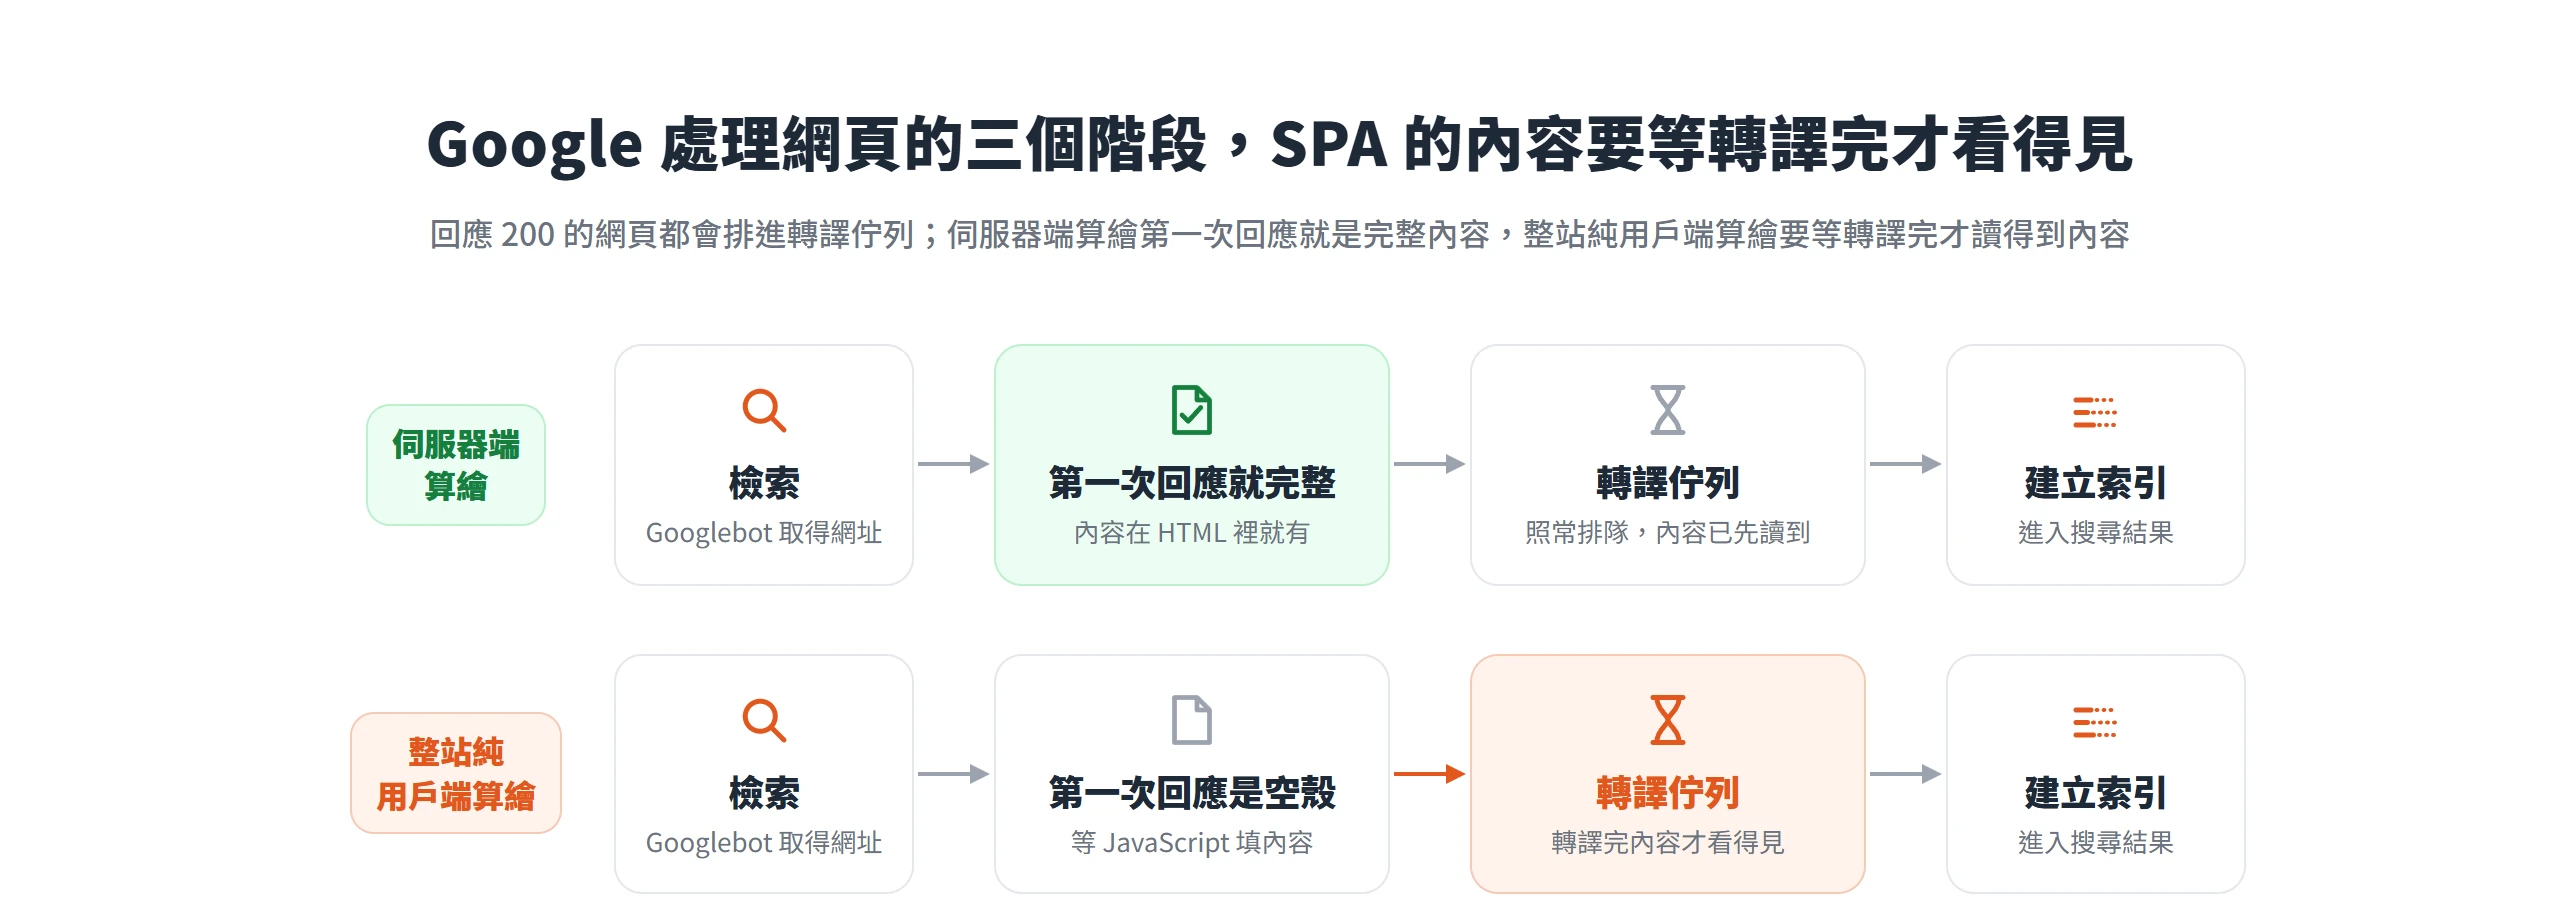
Google 處理一個網頁分成檢索(crawling)、轉譯(rendering)、建立索引(indexing)三個階段,轉譯不是即時的,要排隊等運算資源騰出來。Google 的 JavaScript SEO 文件寫明,回應 200 狀態碼的網頁不論有沒有 JavaScript 都會被排進轉譯佇列,可能只停留幾秒,也可能等更久;差別在於傳統伺服器端算繪的頁面第一次 HTTP 回應就帶著完整內容,檢索階段就讀得到文字,整站純 CSR 的 SPA 第一次回應卻幾乎是空殼,內容得等轉譯跑完才看得見。這不是說 SPA 不會被收錄,而是收錄的時間點與確定性多了一層自己管不到的變數。Google 在 2026 年 3 月更新 JavaScript SEO 基本指南時,拿掉了舊版「為無障礙設計」那段要人用停用 JavaScript 的瀏覽器測試網站的提醒,理由是 Google 轉譯 JavaScript 已經多年;但同一份文件至今仍寫著,伺服器端轉譯或預先轉譯對使用者和檢索器都更快,而且不是所有檢索器都能執行 JavaScript。
內容型網站容易踩到的三個 SPA 爬取陷阱
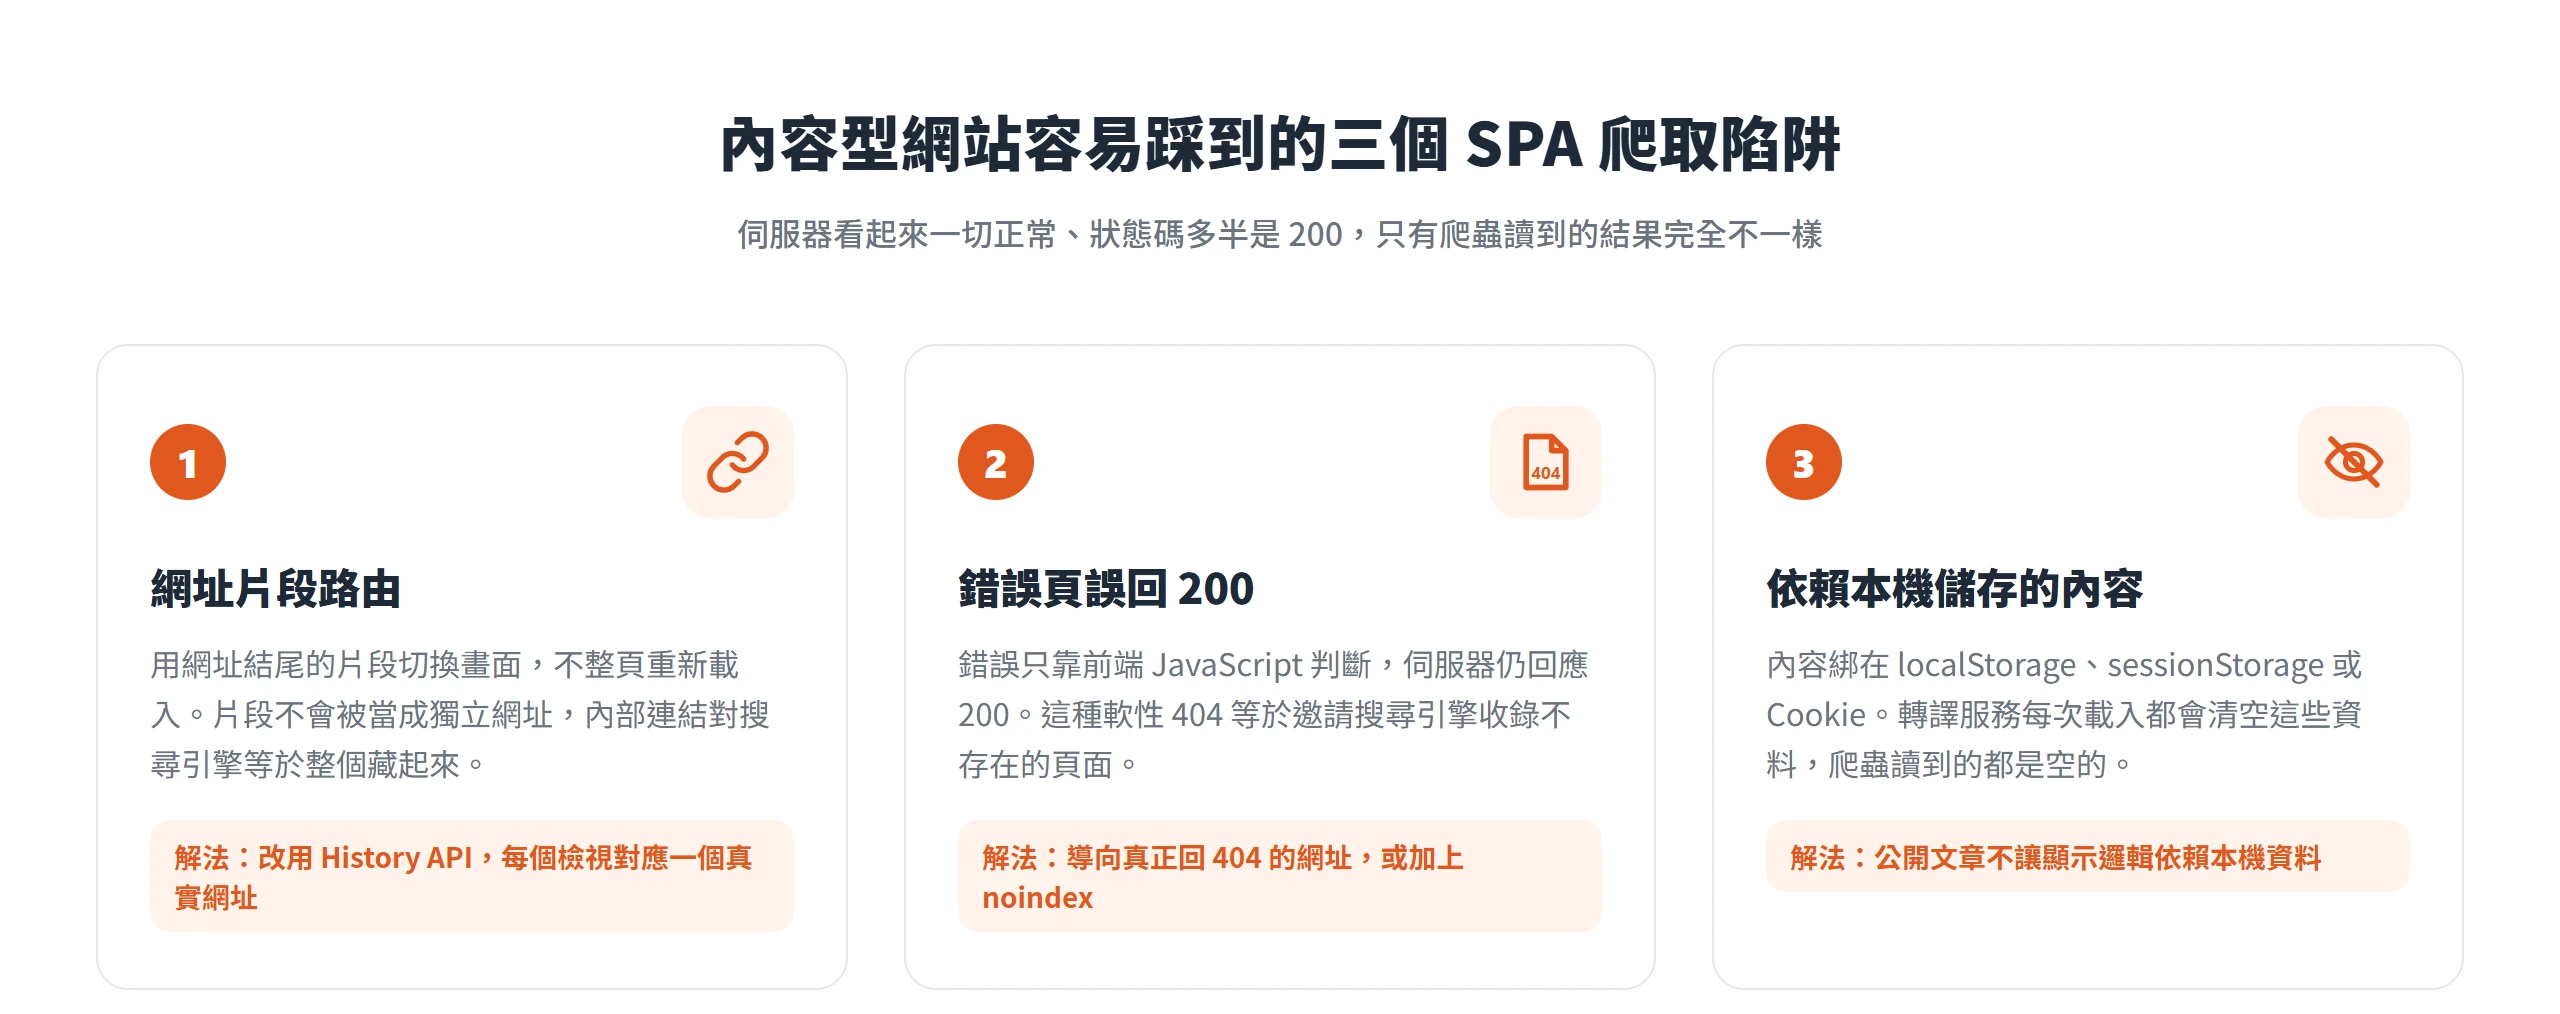
轉譯排隊之外,Google 的文件還點名了幾個 SPA 特別容易踩到的陷阱。這幾個陷阱不是泛泛的疑慮,是 Google Search Central 文件明確點名、也各自給出對應解法的具體技術問題。內容型網站因為靠大量獨立網址承載文章與分類頁,又比一般應用程式更容易踩進去,應用程式介面通常只有少數幾個核心畫面需要被索引,內容站卻是每一篇文章、每個分類都要獨立、可被檢索、可被分享。
這幾個陷阱共通的性質,是伺服器端本身看起來一切正常,網址能訪問、狀態碼多半是 200、頁面上的文字對真人使用者來說也顯示得出來,唯獨對只看第一次 HTTP 回應、或用不同邏輯處理狀態的爬蟲與工具來說,結果完全不一樣。
網址片段路由,連結對搜尋引擎等於隱形
SPA 常見的路由做法之一,是用網址片段(例如網址結尾接一段 #/products)切換畫面內容,不整頁重新載入。Google 的文件寫明,靠片段做檢索的 AJAX 檢索機制自 2015 年起就已棄用,不能指望片段網址在 Googlebot 上正常運作;再加上 Googlebot 只認得出現在 a 元素、且帶有 href 屬性的連結,片段本身不會被當成獨立的可檢索網址。
這代表如果一個內容型網站的文章切換全靠片段路由,每一篇文章、每個分類頁面在搜尋引擎眼中,其實都指向同一個網址;內部連結結構等於對搜尋引擎整個藏起來,再多文章也不會被視為各自獨立、可被檢索的頁面。正確做法是改用瀏覽器原生的 History API,讓每個檢視都對應一個真實、可以直接貼在網址列打開的網址。內容型網站尤其該留意這一點,因為它的核心資產就是一篇篇能被獨立檢索、獨立分享的文章與分類頁,片段路由會直接動搖這個資產的地基。
錯誤頁誤回 200,等於邀請收錄不存在的頁面
SPA 的錯誤處理通常靠用戶端 JavaScript 判斷,例如前端呼叫 API 後發現找不到這篇文章,才在畫面上顯示錯誤訊息。問題是伺服器本身對這個網址的 HTTP 狀態碼,多半還是回應 200,因為伺服器在回應當下根本不知道用戶端之後會判斷成錯誤。Google 的文件把這種情況稱為軟性 404(soft 404),特徵是網頁內容明明是錯誤頁,狀態碼卻宣稱一切正常,結果反而可能被建立索引,甚至出現在搜尋結果裡。
Google 給的解法有 2 種:用 JavaScript 把使用者導向一個伺服器真的會回傳 404 狀態碼的網址,或是用 JavaScript 在錯誤頁加上 noindex 標記,明確告訴搜尋引擎這頁不該被收錄。內容型網站常見的地雷,是文章下架或改了網址之後,舊連結沒有清乾淨;如果只靠前端判斷顯示找不到文章,卻沒有搭配正確的狀態碼或 noindex,時間一久就會在索引裡累積出一堆假頁面,拖累整站的內容品質觀感。
本機儲存的個人化內容,爬蟲每次讀到的都是空的
不少 SPA 會把使用者狀態,或是已經載入過的資料,快取進 localStorage、sessionStorage 或 Cookie 裡,靠這些本機資料決定頁面要顯示什麼內容。Google 的文件明確說明,網路轉譯服務在每一次網頁載入時並不會保留狀態,本機儲存空間與工作階段儲存空間裡的資料,以及 HTTP Cookie,都會在每次網頁載入時被清除。
換句話說,如果一篇文章的內容要靠使用者之前瀏覽過什麼,或任何本機持久化資料才會顯示出來,Googlebot 每一次抓到的都會是空白狀態。內容型網站如果把公開文章的首次載入邏輯,綁在本機儲存的資料上,就會踩到這個雷;會員限定內容需要登入才看得到完整內容是另一回事,但一般想被搜尋引擎收錄的公開文章,不該讓顯示邏輯依賴任何只存在使用者瀏覽器裡的資料。
轉譯排隊與這 3 個爬取陷阱回答的是能不能被索引;就算最後真的被穩定收錄了,整站純 CSR 對讀者體驗的代價還沒算完。
用戶端 JavaScript 愈堆愈多,核心體驗指標跟著吃緊
整站用純 CSR 的 SPA,瀏覽器要先下載、解析、執行完一大包 JavaScript,頁面才會顯示內容、才能回應操作,這直接牽動網站使用體驗核心指標(Core Web Vitals)裡的最大內容繪製(Largest Contentful Paint,LCP,建議 2.5 秒內)與與下一個顯示的內容互動(Interaction to Next Paint,INP,建議 200 毫秒以內)。web.dev 的文件點名,用戶端算繪的 JavaScript 量會隨功能增加而膨脹、拖累 INP,伺服器端算繪或靜態算繪通常能做出較快的首次內容繪製。內容型網站的讀者要看的是文字內容,不是互動密集的應用程式介面,為了 SPA 式的切頁體感犧牲首次顯示內容的速度,對內容站的讀者體驗是淨損失。
這 2 個指標回答的是讀者眼中網站順不順。內容型網站接下來要面對的,是被搜尋收錄之後,能不能進一步被 AI 摘要引用。
被 AI 摘要引用之前,網頁得先被搜尋索引
Google 的 AI 摘要與 AI 模式,不是另外建一套獨立的索引,而是從同一份搜尋索引取用網頁;Google Search Central 的生成式 AI 最佳化指南寫明,Google 搜尋找到並處理網頁的方式,仍是 AI 系統取得網站資料的核心。另一份說明 AI 功能的文件也講得明白,一個網頁必須先被建立索引,並且符合在 Google 搜尋中顯示摘要的資格,遵循搜尋技術相關規定,才有機會在 AI 總覽或 AI 模式裡以輔助連結的形式出現,除此之外沒有其他技術相關規定。
換句話說,前面講的轉譯排隊、三個爬取陷阱、體驗指標,最終收斂到同一個關卡,就是能不能先被穩定索引。SPA 若因為這些原因導致索引不穩定或延遲,受影響的不只是傳統搜尋排名,連能不能被 AI 摘要引用都會一併受阻。對想靠見解內容建立 AI 搜尋能見度的內容型網站來說,這比單純的排名損失更直接。
這個立場成立的前提,是網站真的靠自然搜尋被讀者找到。但技術選型從來不是非黑即白,總有幾種情況會讓它反過來成立。
這個立場反過來成立的三個前提
技術選型該看的是網站實際的商業目標與架構,不是規則本身。以下 3 個前提彼此獨立,任一個成立就足以讓前面的立場反過來,不需要三個同時滿足。
用 SSR/SSG 搭配 hydration 取代純用戶端算繪
前面通篇反對的是「整站純 CSR」,不是反對 SPA 式的互動體感本身。如果技術選型是伺服器端算繪(Server-Side Rendering,SSR)或靜態算繪(Static Site Generation,SSG)打底,再用水合(hydration)讓頁面局部具備互動性,例如採用 Next.js、Nuxt 這類框架的 SSR 或 SSG 模式,伺服器回應給爬蟲與使用者的第一個 HTML 就已經是完整內容,內容不必等轉譯佇列排完才看得見。
這時候用不用 SPA 式框架,已經不是 SEO 風險的來源。前面提到的三個陷阱,片段路由、軟性 404、依賴本機儲存的狀態,大多是純 CSR 才會踩到的雷;用 SSR 或 SSG 打底的專案,通常會走 History API、伺服器端真實狀態碼這些正規做法。web.dev 的文件也明確建議開發者優先考慮伺服器端算繪或靜態算繪,而不是完整重新水合的方式。
網站本來就不靠自然搜尋流量獲客
如果一個內容型網站的流量來源本來就不是自然搜尋,例如內容全部只透過付費會員電子報遞送、不開放公開瀏覽,或是流量主要靠既有社群與既有導流管道,前面講的索引風險,對這個網站的商業目標影響就有限。這種情況下,選 SPA 換取開發效率或互動體感,是合理的取捨。
這個前提要講清楚,不靠自然搜尋是刻意的商業選擇,是先確認流量來源與內容策略之後做出的判斷,不是「反正很多網站都這樣做」這種鬆散的理由。如果一個網站現在確實不靠搜尋導流,但未來想拓展自然搜尋這個管道,前面講的風險就會重新變成要考慮的因素,技術選型最好留一點轉圜空間。
SPA 只用在局部元件,內容本體仍是靜態頁
最後一個前提,是切割清楚「整站架構」與「局部功能」。如果只是站內搜尋框、留言區、篩選器、後台儀表板這類本來就不需要被個別網址收錄的局部功能,用了 SPA 式的用戶端算繪,而真正承載內容的文章頁、分類頁仍然是伺服器端算繪或靜態產生,那就不算前面反對的「內容型網站整站 SPA 化」。
這個前提提醒一件事,問題從來不是要不要用到 SPA 這項技術,而是承載內容本體的那些頁面,算繪方式是什麼。web.dev 的文件也提到部分重新水合(partial rehydration)這種做法,業界常見的島嶼(islands)架構也是同一個思路,僅對頁面中互動性高的部分保留用戶端 JavaScript,其餘大部分維持靜態;web.dev 也坦言這種做法實作不易、在快取上有取捨,但內容本體仍由伺服器產出,不影響可索引性。
整站純 CSR 對內容型網站來說,真正的成本不是體感,是把「內容看不看得見」這件確定的事,交給一個自己管不到的排隊機制。內容要不要等轉譯排隊、錯誤頁的狀態碼對不對、本機儲存的資料轉譯服務讀不讀得到,每一關都多一分不確定,而內容站的價值恰恰建立在被穩定找到這件事上。技術選型該從這裡回頭看,不是先問切頁順不順,而是先問文章頁與分類頁的第一次 HTTP 回應,交出了什麼內容。真正動手評估架構時,把這個問題擺在最前面,答案通常已經很清楚。